


文章目录
JVM运行时数据区
概述
内存是非常重要的系统资源,是硬盘和CPU的中间仓库及桥梁,承载着操作系统和应用程序的实时运行。JM内存布局规定了Java在运行过程中内存申请、分配、管理的策略,保证了JVM的高效稳定运行。不同的JV对于内存的划分方式和管理机制存在着部分差异。结合JVM虚拟机规范,来探讨一下经典的JVM内存布局。
下图是JVM基本的结构,其中运行时数据区绿色部分是线程私有的,蓝色部分是线程共享的。
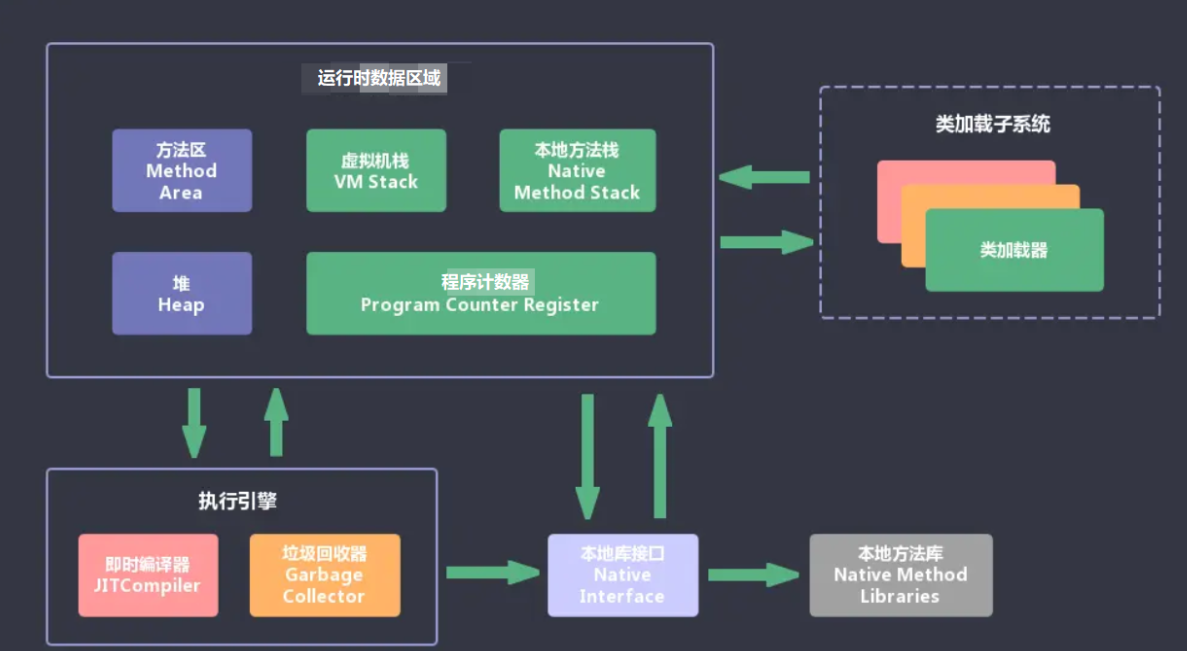
具体的运行时数据区域(基于JDK1.8)如下图所示:
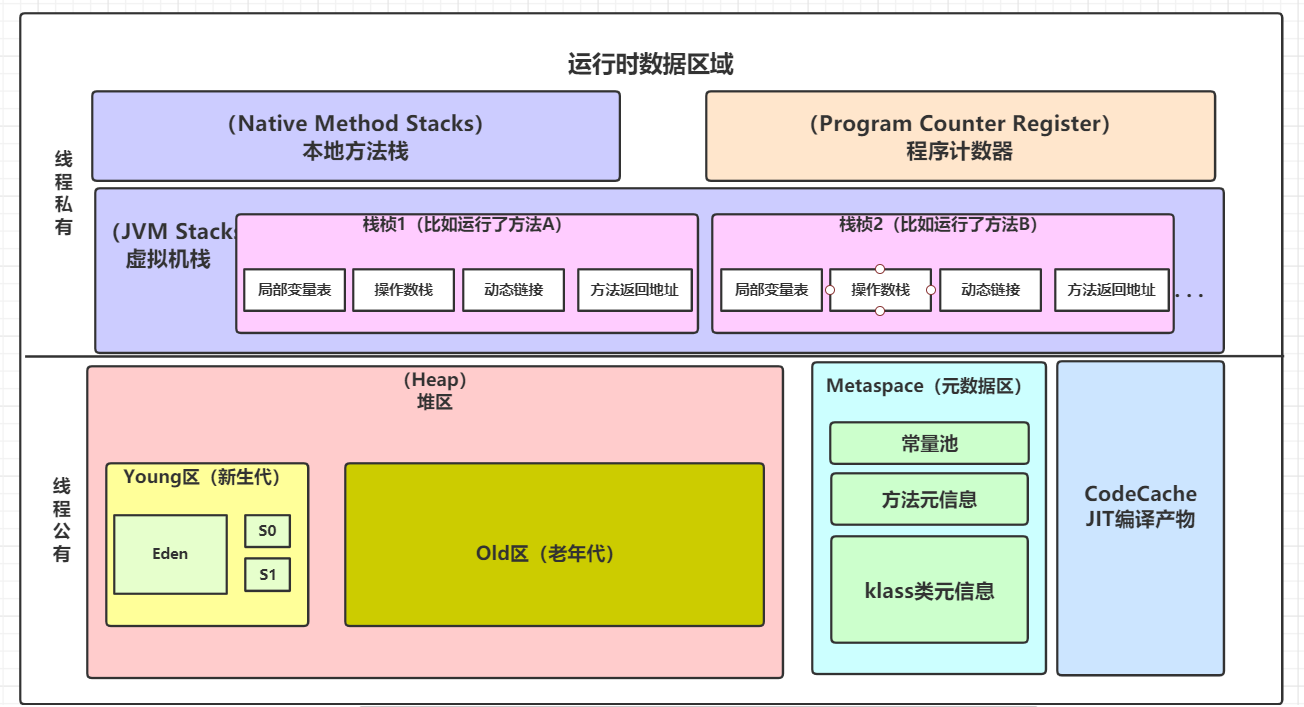
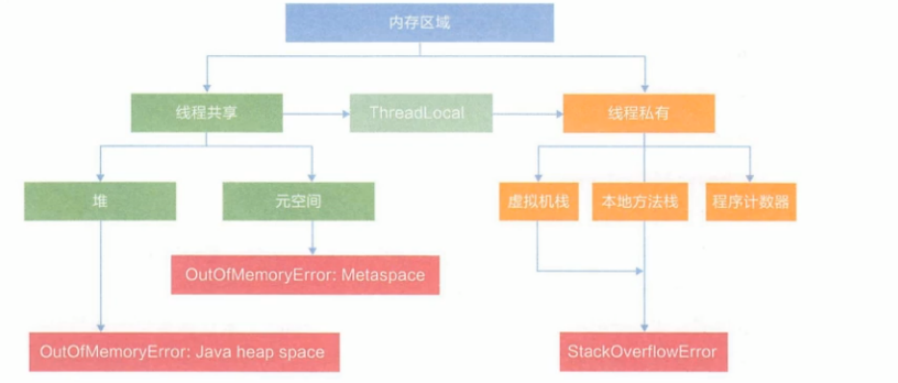
Java虚拟机定义了若干种程序运行期间会使用到的运行时数据区,其中有一些会随着虚拟机启动而创建,随着虚拟机退出而销毁(堆、方法区)。另外一些则是与线程一一对应的,这些与线程对应的数据区域会随着线程开始和结束而创建和销毁(虚拟机栈、本地方法栈、程序计数器)。
- 每个线程私有:程序计数器、本地方法栈、虚拟机栈。
- 线程间共享:堆、堆外内存(永久代或元空间、代码缓存)
一个进程对应一个JVM实例,一个JVM实例只有一个 Runtime实例。 即为运行时环境,对应我们这里的运行时数据区。
线程与JVM
- 线程是一个程序里的运行单元。JVM允许一个应用有多个线程并行的执行。
- 在 Hotspot VM里,每个线程都与操作系统的本地线程直接映射。
- 当一个Java线程准备好执行以后,此时一个操作系统的本地线程也同时创建。Java线程执行终止后,本地线程也会回收。
- 操作系统负责所有线程的安排调度到任何一个可用的CPU上。一旦本地线程初始化成功,它就会调用Java线程中的run()方法。
- 当JVM中的最后一个非守护线程被销毁时,JVM相应的也可以停止了
如果你使用 jconsole或者是任何一个调试工具,都能看到在后台有许多线程在运行。这些后台线程不包括调用 public static void main(string[] args)的main线程以及所有这个main线程自己创建的线程。
这些主要的后台系统线程(守护线程)在 Hotspot VM里主要是以下几个:
- 虚拟机线程: 这种线程的操作是需要JVM达到安全点才会出现。这些操作必须在不同的线程中发生的原因是他们都需要JVM达到安全点,这样堆才不会变化。这种线程的执行类型包括“stop-the-world”的垃圾收集,线程栈收集,线程挂起以及偏向锁撤销。
- 周期任务线程: 这种线程是时间周期事件的体现(比如中断),他们一般用于周期性操作的调度执行。
- GC线程: 这种线程对在Jw里不同种类的垃圾收集行为提供了支持。
- 编译线程: 这种线程在运行时会将字节码编译成到本地代码。
- 信号调度线程: 这种线程接收信号并发送给JVM,在它内部通过调用适当的方法进行处理。
官方文档说明
https://docs.oracle.com/javase/specs/jvms/se8/html/index.html
程序计数器(PC Register)
JVM中的程序计数寄存器(Program Counter Register)中,Register的命名源于CPU的寄存器,寄存器存储指令相关的现场信息。CPU只有把数据装载到寄存器才能够运行。
这里,并非是广义上所指的物理寄存器,或许将其翻译为Pc计数器(或指令计数器)会更加贴切,并且也不容易引起一些不必要的误会。JVM中的Pc寄存器是对物理PC寄存器的一种抽象模拟。
作用
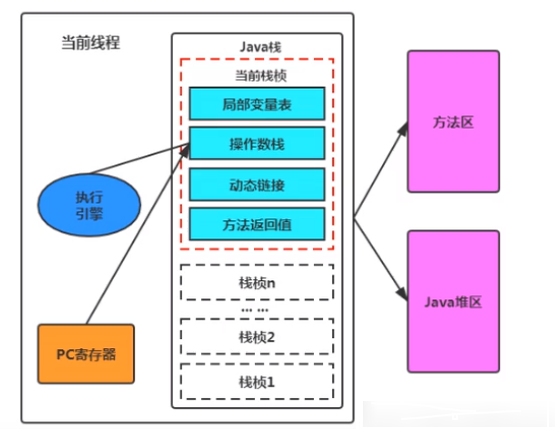
PC寄存器用来存储指向下一条字节码指令的地址,也即将要执行的指令代码。由执行引擎读取下一条指令。
特点
- 它是一块很小的内存空间,几乎可以忽略不记。也是运行速度最快的存储区域。
- 在JVM规范中,每个线程都有它自己的程序计数器,是线程私有的,生命周期与线程的生命周期保持一致。
- 任何时间一个线程都只有一个方法在执行,也就是所谓的当前方法。程序计数器会存储下一条的字节码指令地址:或者,如果是在执行 native方法,则是未指定值(undefined)
- 它是程序控制流的指示器,分支、循环、跳转、异常处理、线程恢复等基础功能都需要依赖这个计数器来完成。
- 字节码解释器工作时就是通过改变这个计数器的值来选取下一条需要执行的字节码指令。
- 它是唯一一个在Java虚拟机规范中没有规定任何 OutotMemoryerror情况的区域
示例
package RunningDateArea.PCRegister;

public class PCRegisterTest {
    public static void main(String[] args) {
        int i = 10;
        int j = 20;
        int k = i + j;

        String s = "abc";
        System.out.println(i);
        System.out.println(k);
    }
}
反解析看一下
javap -v PCRegisterTest.class
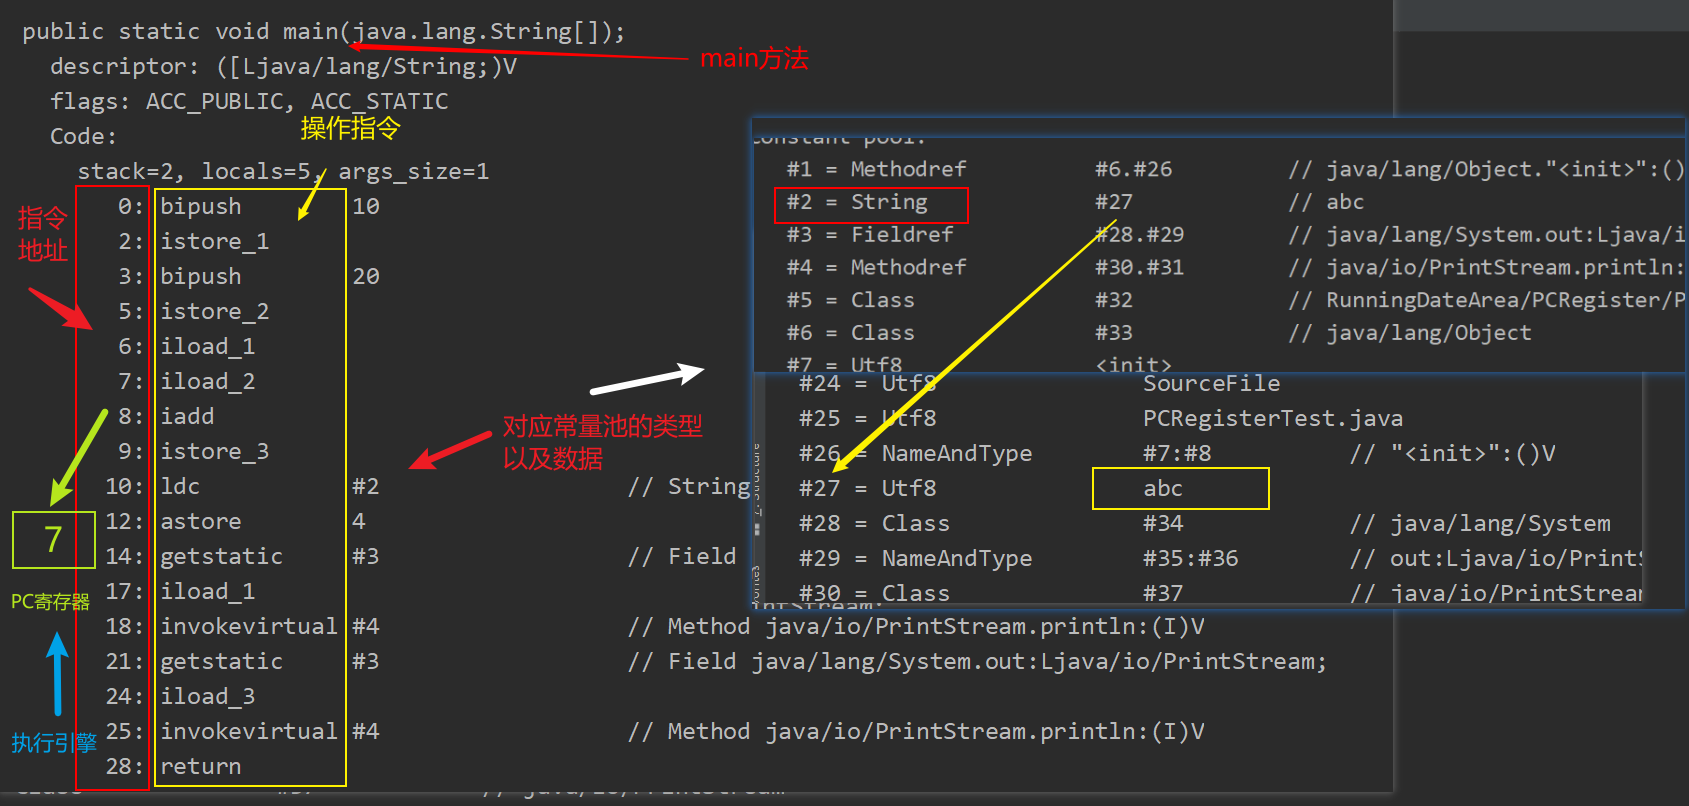
可以看到Code部分是写好程序翻译成的字节码的形式:
第一列是指令地址(偏移地址),第二列是操作指令,第三列是对应常量池的数据
PC寄存器存的就是指令地址,执行引擎读取PC寄存器的值,执行相应的字节码指令,操作局部变量表,操作数栈,运算操作等,还要转化为机器指令,供CPU执行
问题
使用PC寄存器存储字节码指令地址有什么用呢?为什么使用PC寄存器记录当前线程的执行地址呢?(同一问题两种问法)
因为CPU需要不停的切换各个线程,这时候切换回来以后,就得知道接着从哪开始继续执行。
JVM的字节码解释器就需要通过改变PC寄存器的值来明确下一条应该执行什么样的字节码指令。
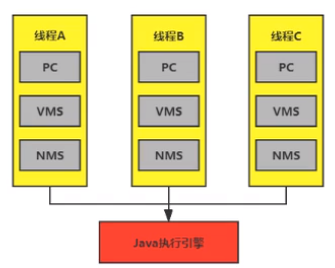
Pc寄存器为什么会被设定为线程私有
如果线程共享一个PC寄存器,就会发生覆盖,切换之后无法回到原本线程该执行的字节码指令
我们都知道所谓的多线程在一个特定的时间段内只会执行其中某一个线程的方法,CPU会不停地做任务切换,这样必然导致经常中断或恢复,如何保证分毫无差呢?为了能够准确地记录各个线程正在执行的当前字节码指令地址,最好的办法自然是为每一个线程都分配一个pc寄存器,这样一来各个线程之间便可以进行独立计算,从而不会出现相互干扰的情况。
由于CPU时间片轮限制,众多线程在并发执行过程中,任何一个确定的时刻,一个处理器或者多核处理器中的一个内核,只会执行某个线程中的一条指令这样必然导致经常中断或恢复,如何保证分毫无差呢?每个线程在创建后,都会产生自己的程序计数器和栈帧,程序计数器在各个线程之间互不影响。
虚拟机栈(JVM Stack)
由于跨平台性的设计,Java的指令都是根据栈来设计的。不同平台CpU架构不同,所以不能设计为基于寄存器的。
优点是跨平台,指令集小,编译器容易实现,缺点是性能下降,实现同样的功能需要更多的指令。
**栈是运行时的单位,而堆是存储的单位。**即:栈解决程序的运行问题,即程序如何执行,或者说如何处理数据。堆解决的是数据存储的问题,即数据怎么放、放在哪儿。(堆放对象,栈放基础类型的数据和对象的引用)
与线程关系
每个线程在创建时都会创建一个虚拟机栈,其内部保存一个个的栈桢(Stack frame)是线程私有的。
生命周期:
生命周期和线程一致
作用:
主管Java程序的运行,它保存方法的局部变量(8种基本数据类型、对象的引用地址)、部分结果,并参与方法的调用和返回。
特点
- 栈是一种快速有效的分配存储方式,访问速度仅次于程序计数器。
- JVM直接对Java栈的操作只有两个
- 每个方法执行,伴随着进栈(入栈、压栈)
- 执行维束后的出栈工作
- 对于栈来说不存在垃圾回收问题(GC),但存在内存溢出(OOM)
溢出问题
Java虚拟机规范允许Java栈的大小是动态的或者是固定不变的,但无论哪种都可能会出现错误(JVM的错误Error)
- 如果采用固定大小的Java虚拟机栈,那每一个线程的Java虚拟机栈容量可以在线程创建的时候独立选定。如果线程请求分配的栈容量超过Java虚拟机栈允许的最大容量,Java虚拟机将会抛出一个StackOverflowError异常。
- 如果Java虚拟机栈可以动态扩展,并且在尝试扩展的时候无法中请到足够的内存,或者在创建新的线程时没有足够的内存去创建对应的虚拟机栈,那Java虚拟机将会抛出一个 OutofMemoryError异常。
public class StackOverflowErrorTest {
    /**
     * 演示StackOverflowError,主要由于递归深度过深,栈桢太多超出虚拟机栈内存大小引起的
     * @param args
     */
    private static int count = 1;
    public static void main(String[] args) {
        System.out.println(count);
        count++;
        main(args);
    }
}
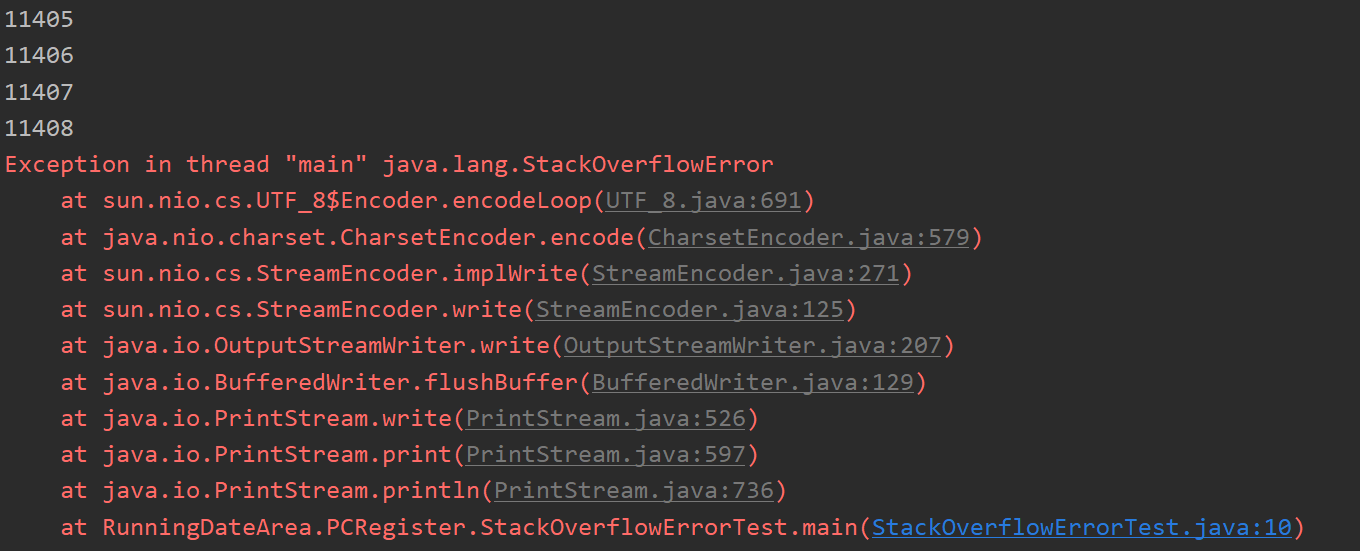
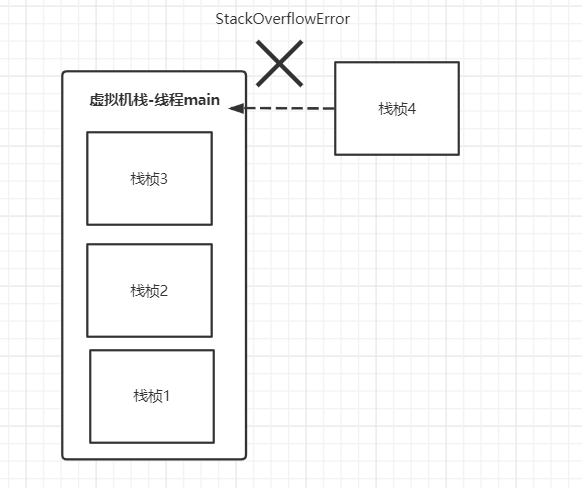
主要原因是使用了递归,主要由于递归深度过深,栈桢太多超出虚拟机栈内存大小引起的,示意图如下,
设置栈大小 -Xss
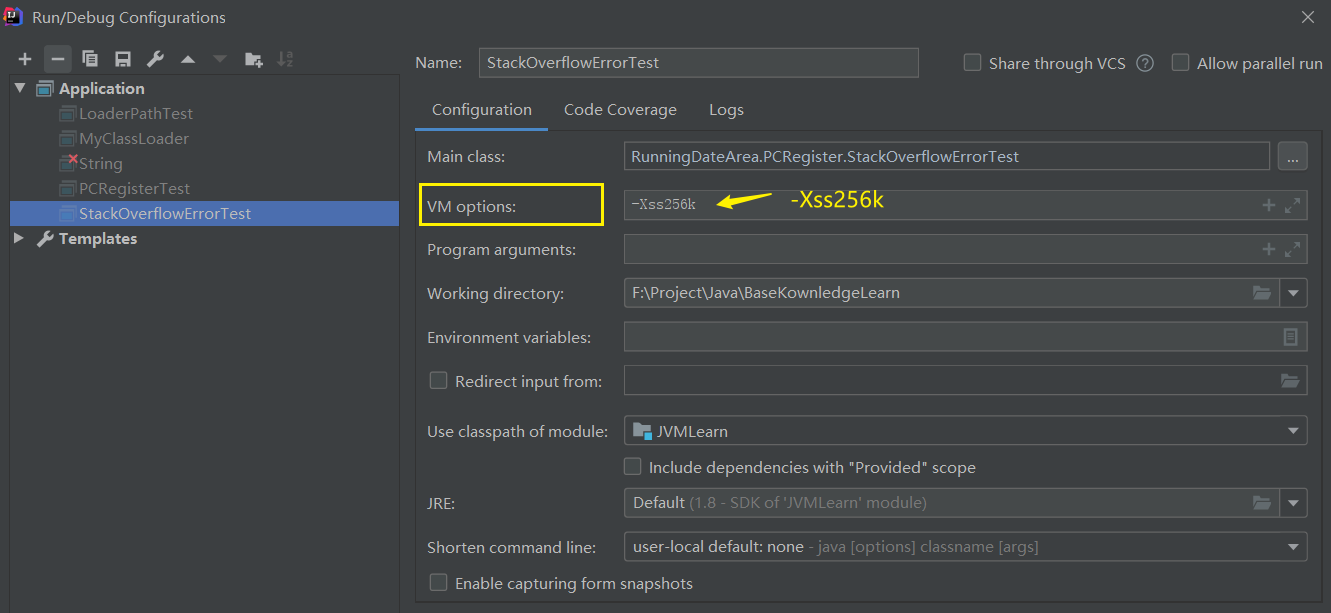
我们可以使用参数-Xss选项来设置线程的最大栈空间,栈的大小直接决定了函数调用的最大可达深度。
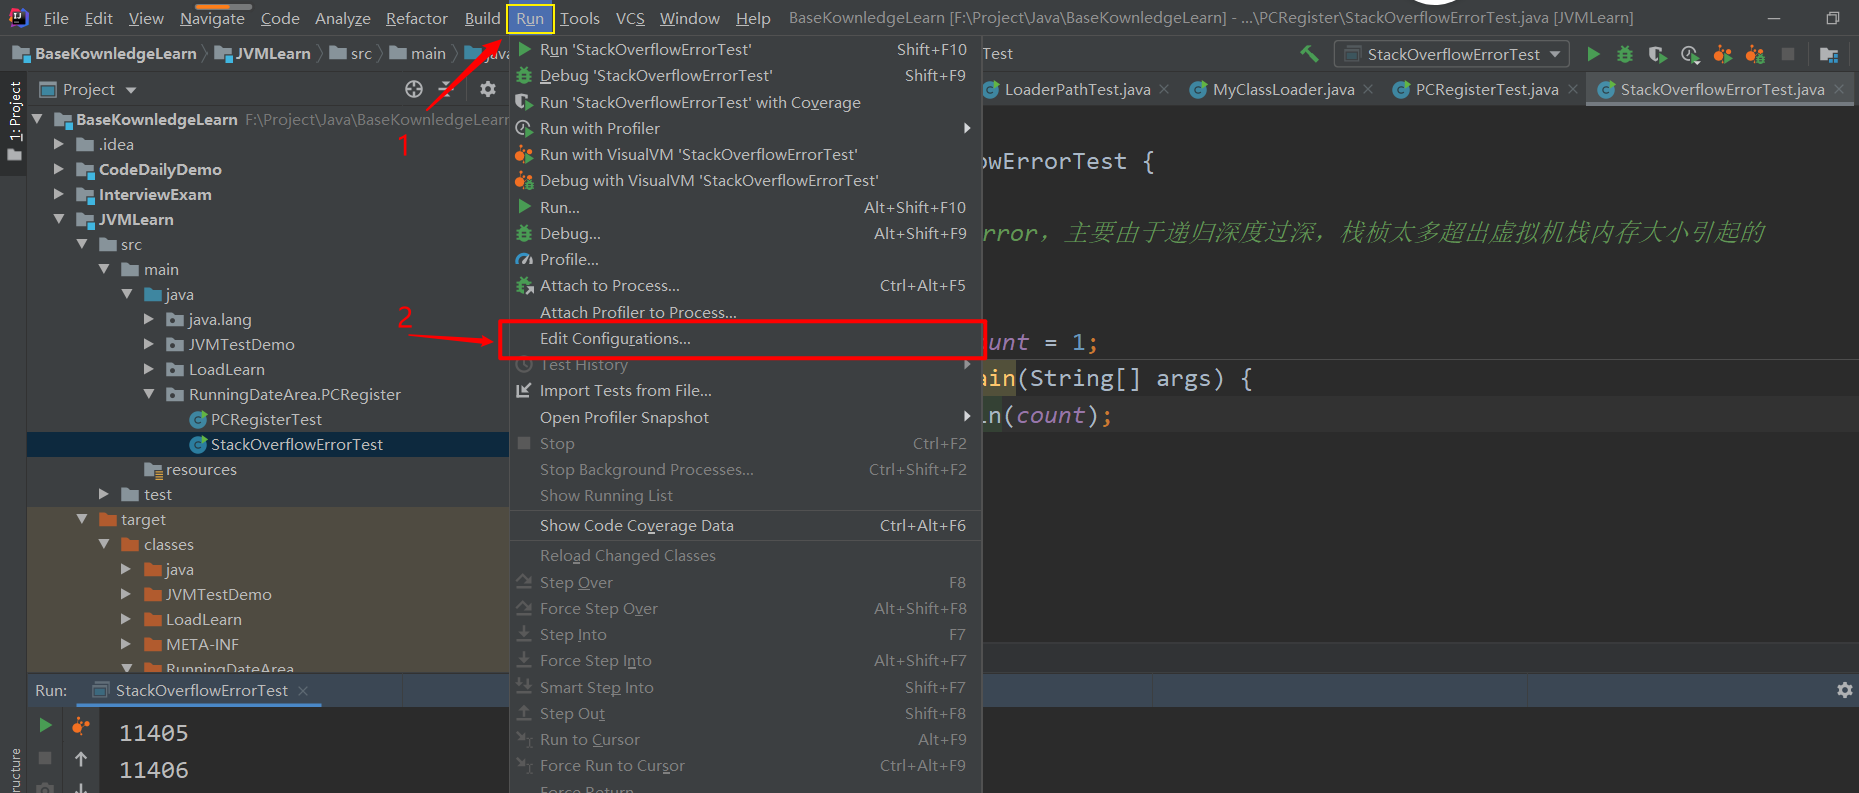
可以在idea的VM option使用设置:
这里演示把虚拟机栈的大小改小
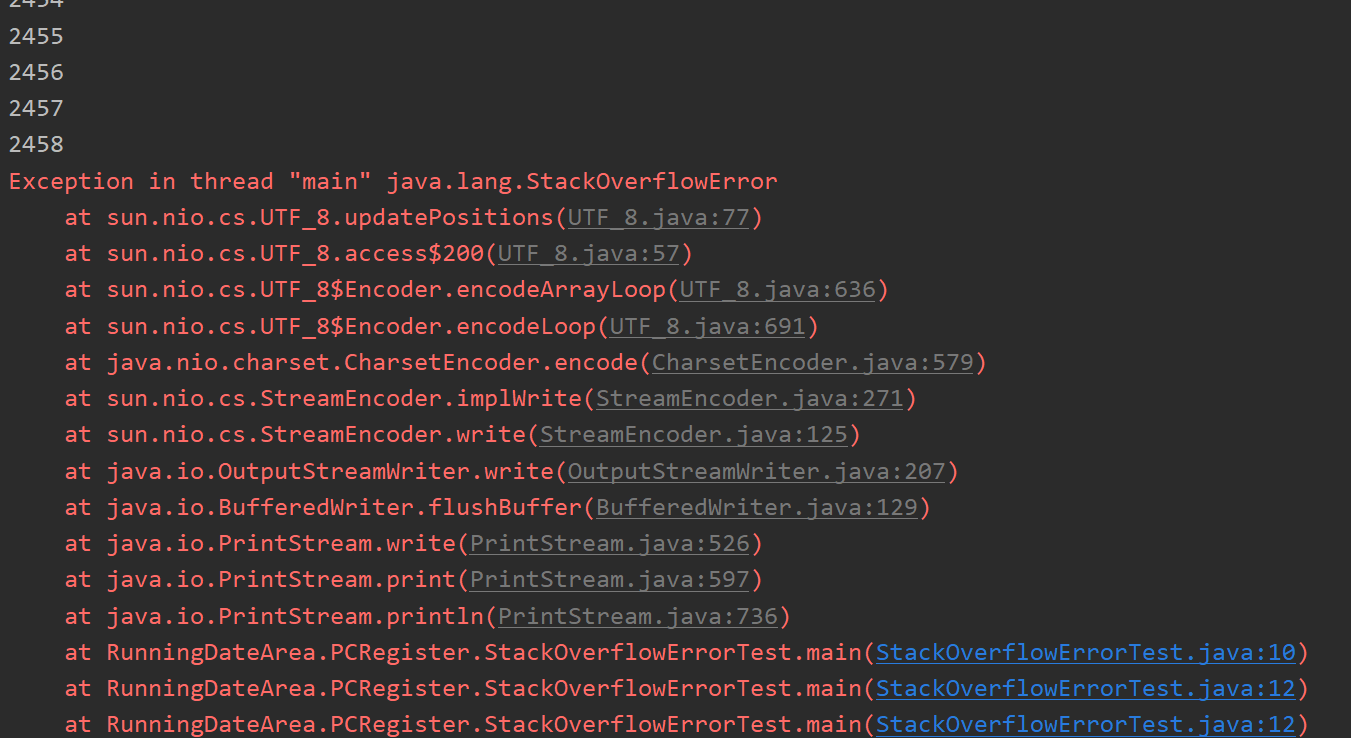
再运行刚才的代码,发现递归的层数明显变小
栈桢
- **每个线程都有自己的栈,栈中的数据都是以栈帧(Stack Frame)**的格式存在。
- 在这个线程上正在执行的每个方法都各自对应一个栈栈(Stack Frame)。
- 栈帧是一个内存区块,是一个数据集,维系着方法执行过程中的各种数据信息。
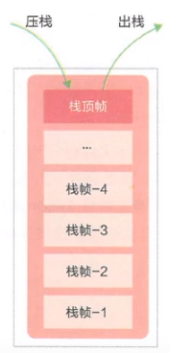
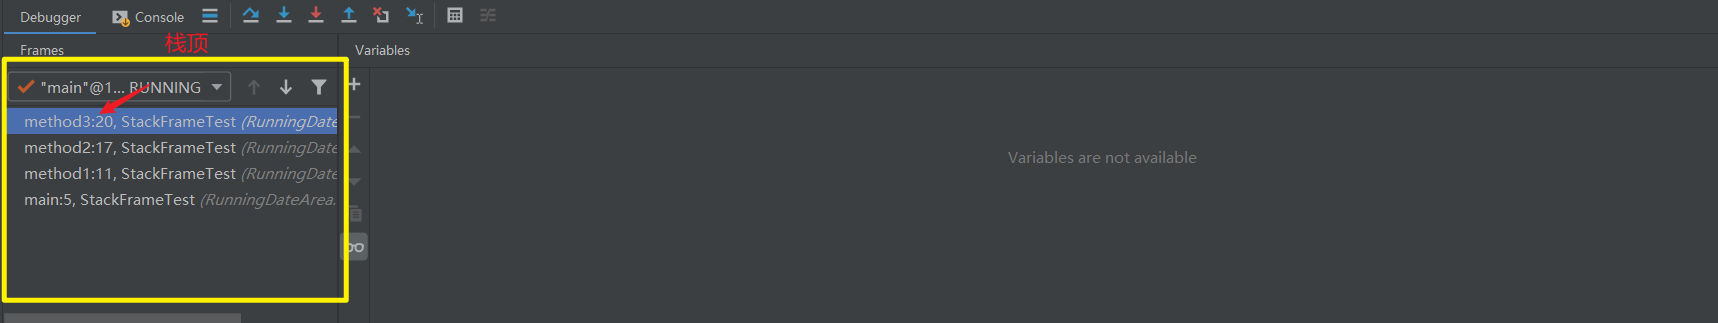
JVM直接对Java栈的操作只有两个,就是对栈帧的压栈和出栈,遵循“先进后出”/“后进先出”原则。
- 在一条活动线程中,一个时间点上,只会有一个活动的栈帧。即只有当前正在执行的方法的栈帧(栈顶栈帧)是有效的,这个栈帧被称为当前栈帧(Current Frame),与当前栈帧相对应的方法就是当前方法(Current Method),定义这个方法的类就是当前类(Current Class)
- 执行引擎运行的所有字节码指令只针对当前栈帧进行操作。
- 如果在该方法中调用了其他方法,对应的新的栈帧会被创建出来,放在栈的顶端,成为新的当前帧。
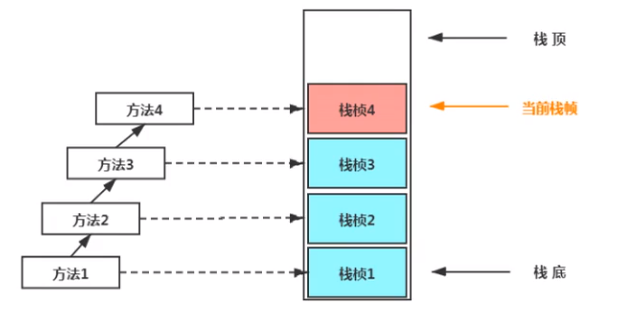
可以利用idea的debug功能查看方法相关的压栈、进栈
栈运行原理:
- 不同线程中所包含的栈帧是不允许存在相互引用的,即不可能在一个栈帧之中引用另外一个线程的栈帧。
- 如果当前方法调用了其他方法,方法返回之际,当前栈帧会传回此方法的执行结果给前一个栈帧,接着,虚拟机会丢弃当前栈帧,使得前一个栈帧重新成为当前栈帧。
- Java方法有两种返回函数的方式,一种是正常的函数返回,使用 return指令;另外一种是抛出异常(未处理)。不管使用哪种方式,都会导致栈帧被弹出。
内部结构:
- 局部变量表(Local Variables)
- 操作数栈(Operand Stack)(或表达式栈)
- 动态链接(Dynamic Linking)(或指向运行时常量池的方法引用)
- 方法返回地址(Return Address)(或方法正常退出或者异常退出的定义)
- 一些附加信息
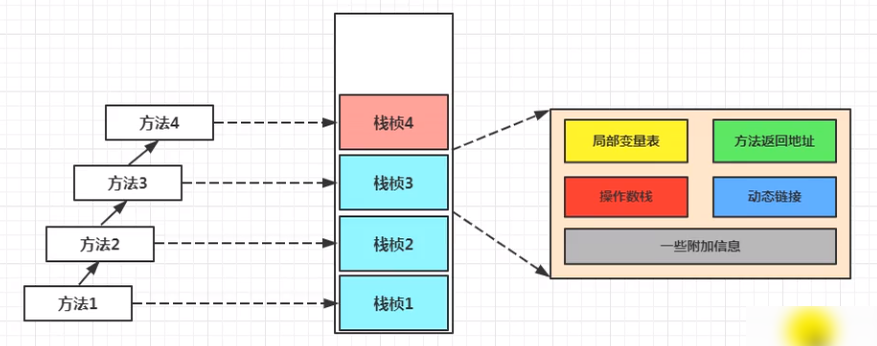
局部变量表(Local Variables)
局部变量表也被称之为局部变量数组或本地变量表
- 定义为一个数字数组,主要用于存储方法参数和定义在方法体内的局部变量,这些数据类型包括各类基本数据类型、对象引用(reference),以及returnAddress类型。
- 由于局部变量表是建立在线程的栈上,是线程的私有数据,因此不存在数据安全问题
- 局部变量表所需的容量大小是在编译期确定下来的,并保存在方法的Code属性的 maximum local variables数据项中。在方法运行期间是不会改变局部变量表的大小的。
方法嵌套调用的次数由栈的大小决定。一般来说,栈越大,方法嵌套调用次数越多。对一个函数而言,它的参数和局部变量越多,使得局部变量表膨胀,它的栈帧就越大,以满足方法调用所需传递的信息增大的需求。进而函数调用就会占用更多的栈空间,导致其嵌套调用次数就会减少。
局部变量表的变量只在当前方法调用中有效。在方法执行时,虚拟机通过使用局部变量表完成参数值到参数变量列表的传递过程。当方法调用结束后,随着方法栈帧的销毁,局部变量表也会随之销毁
局部变量表,最基本的存储单元是slot(变量槽)
-
参数值的存放总是在局部变量数组的 index0开始,到数组长度-1的索引结束
-
在局部变量表里,32位以内的类型只占用一个slot(包括returnAddress类型),64位的类型(long和 double)占用两个slot。
- byte、short、char在存储前被转换为int,boolean也被转换为int,0表示false,非0表示true
- long和 double则占据两个slot。
-
JVM会为局部变量表中的每一个slot都分配一个访问索引,通过这个索引即可成功访问到局部变量表中指定的局部变量值
-
当一个实例方法被调用的时候,它的方法参数和方法体内部定义的局部变量将会按照顺被复制到局部变量表中的每一个slot上
-
如果需要访问局部变量表中一个64bit的局部变量值时,只需要使用前一个索引即可。(比如:访问long或 double类型变量)
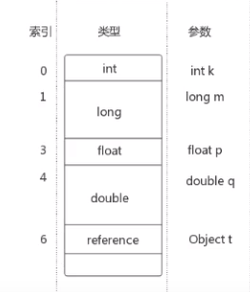
- 如果当前帧是由构造方法或者实例方法创建的,那么该对象引用this将会存放在 index为0的slot处,其余的参数按照参数表顺序继续排列
栈帧中的局部变量表中的槽位是可以重用的,如果一个局部变量过了其作用域,那么在其作用域之后申明的新的局部变量就很有可能会复用过期局部变量的槽位,从而达到节省资源的目的
变量
按数据类型划分:1、基本数据类型 2、引用数据类型
按在类中声明位置分:
1、成员变量:在使用前,都经历过默认初始化赋值
- 类变量:Linking的 prepare阶段:给类变量默认赋值 ----》initial阶段:给类变量显式赋值即静态代码块赋值
- 实例变量:随着对象的创建,会在堆空间中分配实例变量空间,并进默认赋值
2、局部变量:在使用前,必须要进行显式赋值的!否则,编译不通过
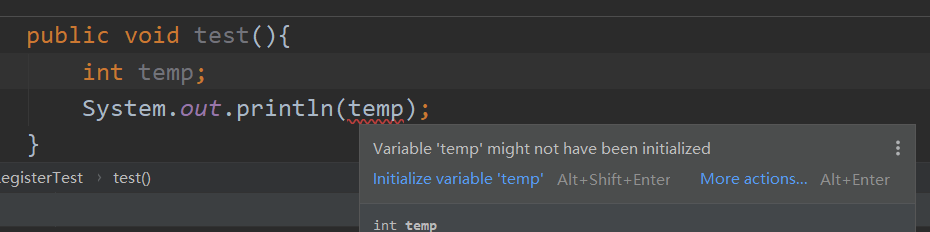
扩展(栈的引用变量与堆的垃圾回收有关)
-
在栈帧中,与性能调优关系最为密切的部分就是前面提到的局部变量表在方法执行时,虚拟机使用局部变量表完成方法的传递。(引用对应堆的对象,不合理的引用变量作用域会影响堆的垃圾回收)
-
局部变量表中的变量也是重要的垃圾回收根节点,只要被局部变量表中直接或间接引用的对象都不会被回收。(可达性的根节点)
操作数栈(Operand Stack)
操作数栈,主要用于保存计算过程的中间结果,同时作为计算过程中变量临时的存储空间。
在方法执行过程中,根据字节码指令,往栈中写入数据或提取数据,即入栈(push)/出栈(pop)。
- 某些字节码指令将值压入操作数栈,其余的字节码指令将操作数取出栈。使用它们后再把结果压入栈
- 比如:执行复制、交换、求和等操作
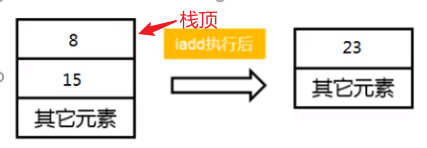
-
操作数栈就是 JVM 执行引擎的一个工作区,当一个方法刚开始执行的时候,一个新的栈帧也会随之被创建出来,这个方法的操作数栈是空的。
-
每一个操作数栈都会拥有一个明确的栈深度用于存储数值,其所需的最大深度在编译期就定义好了,保存在方法的Code属性中,为max_stack的值
Code: stack=2, locals=5, args_size=1 # 栈大小为2,局部变量长度为5 -
栈中的任何一个元素都是可以任意的Java数据类型
- 32bit的类型占用一个栈单位深度
- 64bit的类型占用两个栈单位深度
-
操作数栈并非采用访问索引的方式来进行数据访问的,而是只能通过标准的入栈(push)和出栈(pop)操作来完成一次数据访问。
-
如果被调用的方法带有返回值的话,其返回值将会被压入当前栈帧的操作数栈中,并更新PC奇存器中下一条需要执行的字节码指令。
-
另外,我们说Java虚拟机的解释引擎是基于栈的执行引擎,其中的栈指的就是操作数栈。
示例:
public class OperandStackTest {
    public void testAddOperation(){
        //byte,short,char、boolean:都以int型来保存
        byte i = 15;
        int j = 8;
        int k = i - j;
    }
}
通过使用javap反解析拿到字节码如下
public void testAddOperation();
    descriptor: ()V
    flags: ACC_PUBLIC
    Code:
      stack=2, locals=4, args_size=1		# 局部变量长度为4,操作数栈长度为2
         0: bipush        15
         2: istore_1
         3: bipush        8
         5: istore_2
         6: iload_1
         7: iload_2
         8: isub
         9: istore_3
        10: return
执行过程大致如下所示,指令开头的b、s、i 分别代表操作的类型是byte、short、int,黄色部分代表正在执行的指令
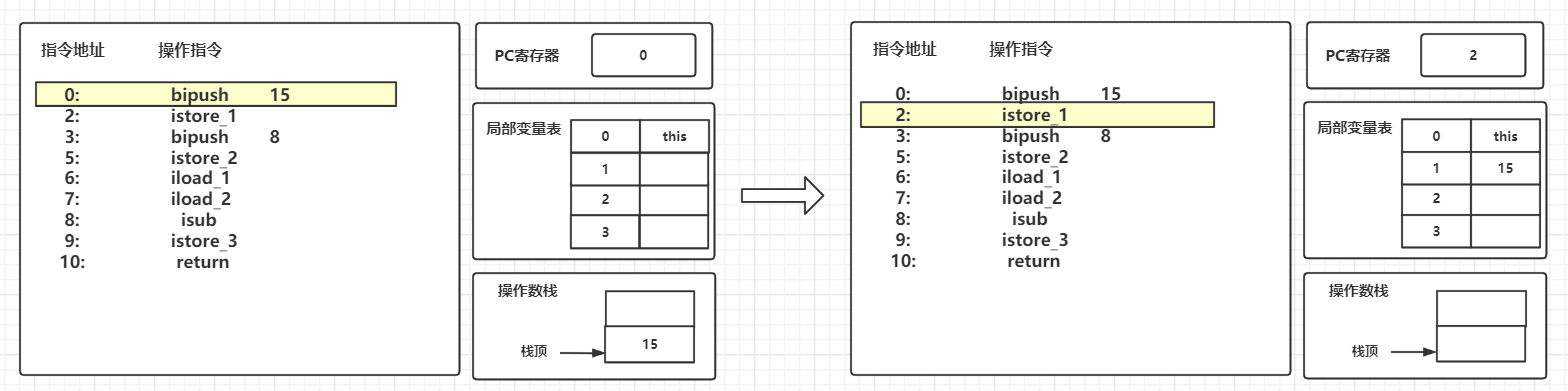
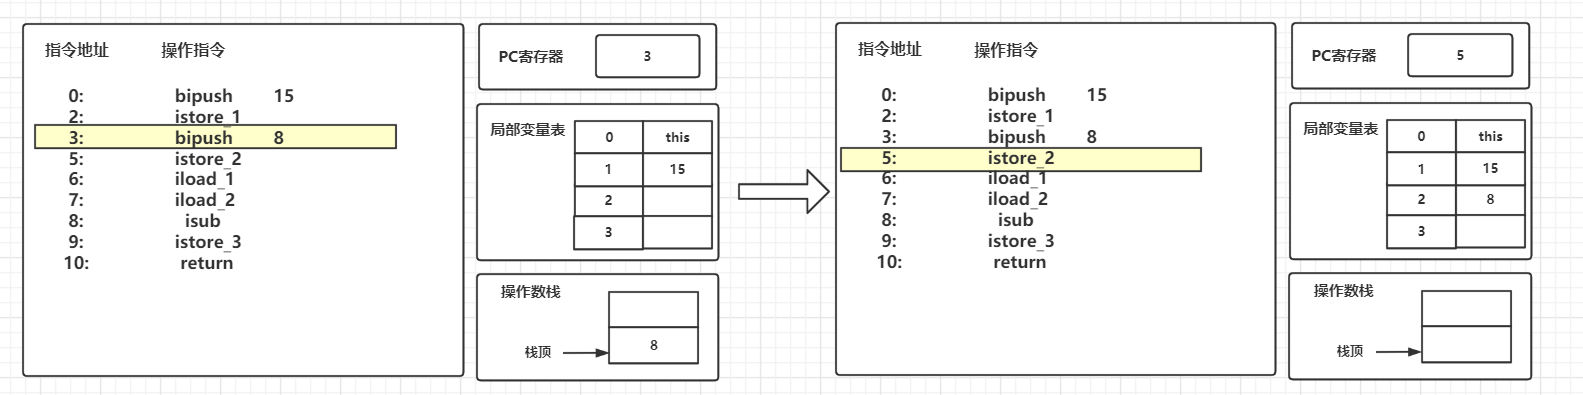
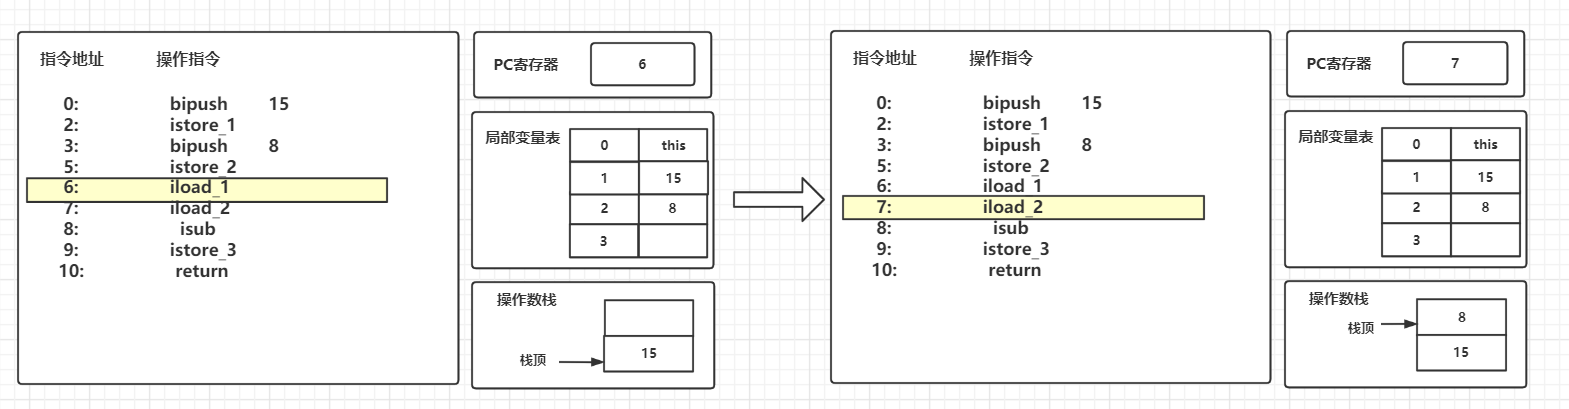
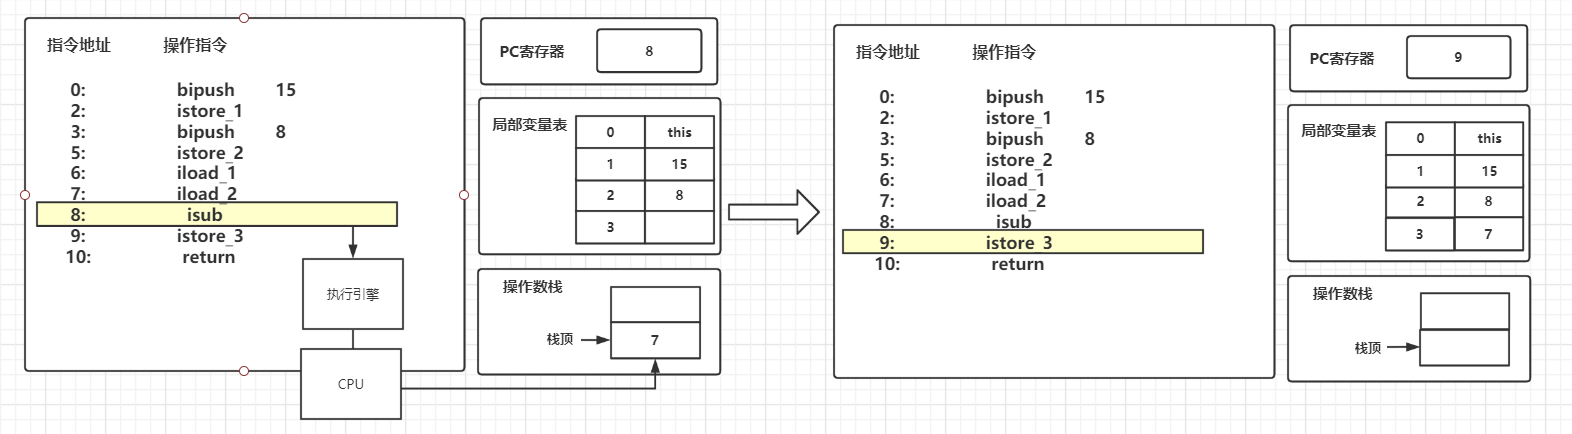
栈顶缓存
前而提过,基于栈式架构的虚拟机所使用的零地址指令更加紧凑,但完成一项操作的时候必然需要使用更多的入栈和出栈指令,这同时也就意味着将需要更多的指令分派(instruction dispatch)次数和内存读/写次数。
由于操作数是存储在内存中的,因此频繁地执行内存读/写操作必然会影响执行速度。为了解决这个问题,HotSpot VM的设计者们提出了栈顶缓存(Tos,Top-of-Stack Cashing)技术**,将栈顶元素全部缓存在物理CpU的寄存器中,以此降低对内存的读/写次数,提升执行引擎的执行效率。**
动态链接(Dynamic Linking)
每一个栈帧内部都包含一个指向运行时常量池中该栈帧所属方法的引用。包含这个引用的目的就是为了支持当前方法的代码能够实现动态链接(Dynamic Linking)。比如:invokedynamic指令
在Java源文件被编译到字节码文件中时,所有的变量和方法引用都作为符号引用(Symbolic Reference)保存在 class文件的常量池里。比如:描述一个方法调用了另外的其他方法时,就是通过常量池中指向方法的符号引用来表示的,那么**动态链接的作用就是为了将这些符号引用转换为调用方法的直接引用。**比如下图的#2、#3都算是符号引用
在JVM中,将符号引用转换为调用方法的直接引用与方法的绑定机制相关。
-
静态链接:
当一个字节码文件被装载进JVM内部时,如果被调用的目标方法在编译期可知运行期保持不变时,这种信况下将调用方法的符号引用转换为直接引用的
-
动态链接:
如果被调用的方法在编译期无法被确定下来,也就是说,只能够在程序运行期将调用方法的符号引用转换为直接引用,由于这种引用转换过程具备动态性,因此也就被称之为动态链接。
对应的方法的绑定机制为:早期绑定(Early Binding)和晚期绑定(Late Binding)。绑定是一个字段、方法或者类在符号引用被替换为直接引用的过程,这仅仅发生一次。
-
早期绑定:
早期绑定就是指被调用的目标方法如果在编译期可知,且运行期保持不变时即可将这个方法与所属的类型进行绑定,这样一来,由于明确了被调用的目标方法究竞是哪一个,因此也就可以使用静态链接的方式将符号引用转换为直接引用。
-
晚期绑定:
如果被调用的方法在编译期无法被确定下来,只能够在程序运行期根据实际的类型绑定相关的方法,这种绑定方式也就被称之为晚期绑定。
上述说了那么多,无非就是JVM要想在运行时确定到底要调用哪个字段、方法、类,比如一个方法的参数是一个接口类型,那根本不知道到时候传入的是哪个实现类,想要确定具体是哪个,则需要动态链接和晚期绑定来确定。
Java中任何一个普通的方法其实都具备虚函数的特征,它们相当于c++语中的虚函数(C++中则需要使用关键字 virtual来显式定义)。如果在Java程序中不希望某个方法拥有虚函数的特征时,则可以使用关键字final来标记这个方法。
- 非虚方法(基本上就是不能被重写的方法):
- 如果方法在编译期就确定了具体的调用版木,这个版本在运行时是不可变的。这样的方法称为非虚方法。
- 静态方法、私有方法、final方法、实例构造器(无法重写的)、super调用的父类方法都是非虚方法。
- 其他方法称为虚方法。
虚拟机中提供了以下几条方法调用指令
- 普通调用指令:
- 1.invokestatic: 调用静态方法,解析阶段确定唯一方法版本
- 2.invokespecial: 调用
<init>方法、私有及父类方法,解析阶段确定唯一方法版本 - 3.invokevirtual:调用所有虚方法(还有final修饰的,但为非虚方法)
- 4.invokeinterface:调用接口方法
- 动态调用指令
- 5.invokedynamic:动态解析出需要调用的方法,然后执行(Java7出现,Java8的lambda应用)
前四条指令固化在虚拟机内部,方法的调用执行不可人为干预,而 invokedynamic指令则支持由用户确定方法版本。其中 invokestatic指令和invokespecial指令调用的方法称为非虚方法,其余的(final修饰的除外)称为虚方法。
Java语言方法重写的本质:(动态分派)
- 找到操作数栈顶的第一个元素所执行的对象的实际类型,记作C
- 如果在类型 C 中找到与常量中的描述符合简单名称都相符的方法,则进行访问权限校验,如果通过则返回这个方法的直接引用,查找过程结束;如果不通过,则返回java.lang.IllegalAccessError异常。
- 否则,按照继承关系从下往上依次对 C 的各个父类进行第2步的搜索和验证过程。
- 如果始终没有找到合适的方法,则抛出java.lang.AbstractMethodError异常
IllegalAccessError介绍:
程序试图访问或修改一个属性或调用一个方法,这个属性或方法,你没有权限访问。一般的,这个会引起编译器异常。这个错误如果发生在运行时,就说明一个类发生了不兼容的改变。
-
在面向对象的编程中,会很频繁的使用到动态分派,如果在每次动态分派的过程中都要重新在类的方法元数据中搜索合适的目标的话就可能影响到执行效率。因此,为了提高性能,JVM 采用在类的方法区建立一个虚方法表(virtual method table)(非虚方法不会出现在表中)来实现。使用索引表来代替查找。
-
每个类中都有一个虚方法表,表中存放着各个方法的实际入口
-
那么虚方法表什么时候被创建?
- 虚方法表会在类加载的链接阶段(解析阶段)被创建并开始初始化,类的变量初始值准备完成之后,JVM会把该类的方法表也初始化完毕。
来看简单关系的一个虚方法表,Son继承自Father并重写了hardChoice方法
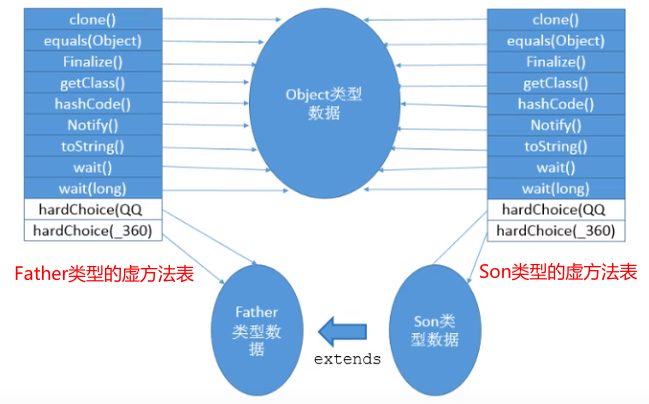
从动态链接到虚表:这些设计就是为了实现多态的映射问题
Java方法调用面临两个新的问题是方法重载和方法重写,方法重载使用的技术叫符号毁坏,方法重写的技术叫做动态派发。Java中的所有方法都支持重写,要实现在运行时动态确定调用的具体方法就需要一张方法表,这张方法表记录当前对象所对应的类含有的所有方法包括父类的方法。方法调用的时候需要从子类方法开始搜索这张表,如果子类未找到就到父类找,再父类。。。;符号毁坏沿用了C++的解决方法,就是给方法重命名如method+参数个数(args) 这样方法就唯一了。所以核心问题还是方法重写,也就是动态分派,也是java的性能瓶颈,因为C++只有virtual方法才会产生动态派发。
要处理好动态分派,一种可能的实现方式是专门开辟一个区,单独管理所有方法,可以按照稳定性对于该对象的所有方法(当然包括父类方法)进行稳定性排序,使相同方法聚集在一起。(方法区)
方法返回地址(Return Address)
即存放调用者的pc寄存器的值。(由于线程私有,一个线程内多个方法用的是一个PC,调用完之后要正确执行剩下的指令就需要恢复PC的值)
比如方法A调用方法B,此时A执行到指令地址为16,那么B方法执行结束后,会将17交给执行引擎,执行引擎并接着执行对应位置的指令。
**关于方法返回值如何传递:**比如方法A调用方法B,B方法通过ireturn(或lreturn、freturn、dreturn和areturn),把栈顶的元素弹出,A方法(假设是实例方法)通过aload_0和invokevirtual取到该栈顶元素,并存到A栈桢的局部变量表里。
一个方法的结束,有两种方式:
-
正常执行完成
-
出现未处理的异常,非正常退出
无论通过哪种方式退出,在方法退出后都返回到该方法被调用的位置。方法正常退出时,**调用者的pc计数器的值作为返回地址,即调用该方法的指令的下一条指令的地址。**而通过异常退出的,返回地址是要通过异常表来确定,栈帧中一般不会保存这部分信息。
本质上,方法的退出就是当前栈帧出栈的过程。此时,需要恢复上层方法的局部变量表、操作数栈、将返回值压入调用者栈帧的操作数栈、设置PC寄存器值等,让调用者方法继续执行下去。
正常完成出口和异常完成出口的区别在于:通过异常完成出口退出的不会给他的上层调用者产生任何的返回值。
这里详细说明,这两种方法结束方式:
1、执行引擎遇到任意一个方法返回的字节码指令(return),会有返回值传递给上层的方法调用者,简称正常完成出口:
- 一个方法在正常调用完成之后究竟需要使用哪一个返回指令还需要根据方法返回值的实际数据类型而定。
- 在字节码指令中,返回指令包含 ireturn(当返回值是 boolean、byte、char、short和int类型时使用)、lreturn、freturn、dreturn和areturn,另外还有一个 return指令供声明为void的方法、实例初始化方法、类和接口的初始化方法使用。
2、在方法执行的过程中遇到了异常(Exception),并且这个异常没有在方法内进行处理,也就是只要在本方法的异常表中没有搜索到匹配的异常处理器,就会导致方法退出。简称异常完成出口
方法执行过程中抛出异常时的异常处理,存储在一个异常处理表,方便在发生异常的时候找到处理异常的代码。
异常处理表:
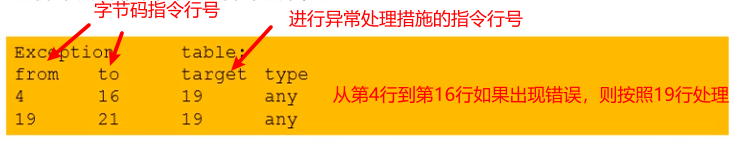
附加信息
栈帧中还允许携带与Java虚拟机实现相关的一些附加信息。例如,对程序调试提供支持的信息。
面试题
1、举例栈溢出的情况
如果虚拟机栈大小固定,报错信息是StackOverflowError,由于递归深度过深,栈桢创建过多超过虚拟机栈的内存大小导致,可以通过-Xss设置
2、调整栈大小,就能保证不出现溢出吗?
不能,只能增加虚拟机栈可存在栈桢数
3、分配的栈内存越大越好吗
不是,内存空间是有限的,栈大了,可能堆就小了,或者允许的线程数少了,不一定能提高性能
4、垃圾回收是否会涉及到虚拟机栈?
虚拟机栈不会发生GC,只存在OOM的错误
5、方法中定义的局部变量是否线程安全?
具体问题具体分析,可能不会发生,可能会发生线程安全问题(多数)
本地方法栈(Native Method Stack)
Java虚拟机栈用于管理Java方法的调用,而本地方法栈用于管理本地方法的调用。
- 本地方法栈,也是线程私有的
- 允许被实现成固定或者是可动态扩展的内存大小。(在内存溢出方面是相同)
- 如果线程请求分配的栈容量超过本地方法栈允许的最大容量,Java虚拟机将会抛出一个
StackOverflowError异常 - 如果本地方法栈可以动态扩展,并且在尝试扩展的时候无法申请到足够的内存,或者在创建新的线程时没有足够的内存去创建对应的本地方法栈,那么Java虚拟机将会抛出一个
OutOfMemoryError异常。
- 如果线程请求分配的栈容量超过本地方法栈允许的最大容量,Java虚拟机将会抛出一个
- 本地方法是使用C语言实现的。
- 它的具体做法是 Native Method Stack中登记 Native方法,在Execution Engine执行时加载本地方法库。
当某个线程调用一个本地方法时,它就进入了一个全新的并且不再受虚拟机限制的世界。它和虚拟机拥有同样的权限。(既可以访问虚拟机的内存,也可以访问操作系统内存)
- 本地方法可以通过本地方法接口来访问虚拟机内部的运行时数据区。
- 它甚至可以直接使用本地处理器的寄存器
- 直接从本地内存的堆中分配任意数量的内存
并不是所有的JM都支持本地方法。因为Java虚拟机规范并没有明确要求本地方法栈的使用语言、具体实现方式、数据结构等。如果J产品不打算支持 native方法,也可以无需实现本地方法栈。
在 Hotspot VM中,有本地方法栈的设计,而其他JVM不一定有。
堆(Heap)
一个 JVM 实例只存在一个堆内存,堆也是Java内存管理的核心区域。
**Java堆区在 JVM启动的时候即被创建,其空间大小也就确定了。是 JVM管理的最大一块内存空间。**堆内存的大小可以通过参数调节。
所有的线程共享Java堆,在这里还可以划分线程私有的缓冲区(Thread Local Allocation Buffer,TLAB)
《Java虚拟机规范》规定:
-
堆可以处于物理上不连续的内存空间中,但在逻辑上它应该被视为连续的。
-
所有的对象实例以及数组都应当在运行时分配在堆上(实际上是绝大多数,栈也可以分配)。(The heap is the run-time data area from which memory for all class instances and arrays is allocated)
- 实际上:“几乎”所有的对象实例都在这里分配内存。(逃逸分析如果没有发生逃逸,可以在堆中分配,还有标量替换)
-
数组和对象可能永远不会存储在栈上,因为栈帧中保存引用,这个引用指向对象或者数组在堆中的位置。
-
在方法结束后,堆中的对象不会马上被移除,仅仅在垃圾收集的时候才会被移除。
-
堆,是GC(Garbage Collection,垃圾收集器)执行垃圾回收的重点区域
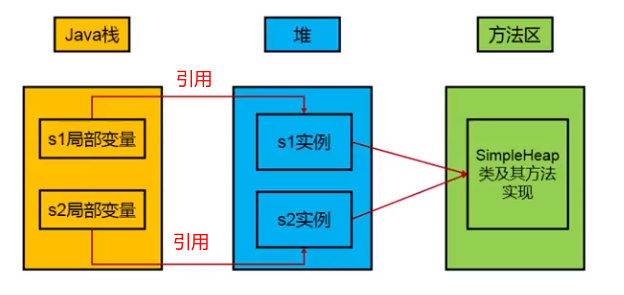
简单示例:
public class SimpleHeap {
    private int id;

    public SimpleHeap(int id) {
        this.id = id;
    }

    public static void main(String[] args) {
        SimpleHeap s1 = new SimpleHeap(1);
        SimpleHeap s2 = new SimpleHeap(1);

        int[] arr = new int[10];

        Object[] arr1 = new Object[10];
    }
}
内存细分
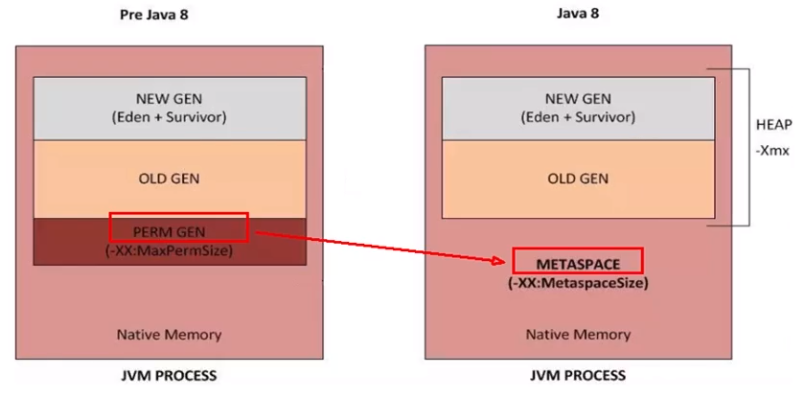
现代垃圾收集器大部分都基于分代收集理论设计,堆空间细分为:
(约定:新生区=新生代=年轻代;养老区=老年区=老年代;永久区=永久代)
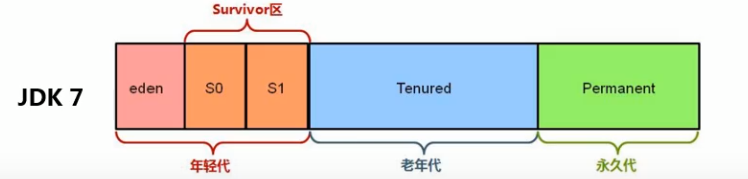
Java7及之前堆内存逻辑上分为三部分:年轻代+老年代+永久代
- Young Generation Space 年轻代 Young/New
- 又被划分为Eden区和 Survivor区
- Tenure generation space 老年代 old/Tenure
- Permanent Space 永久代 Perm
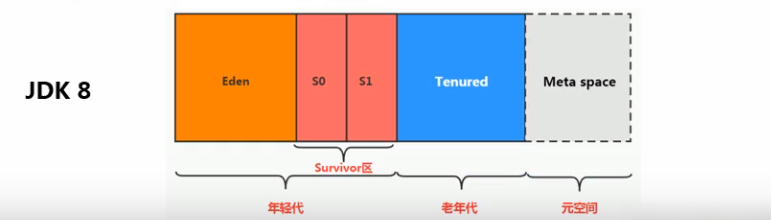
Java8及之后堆内存逻辑上分为三部分:年轻代+老年代+元空间
- Young Generation Space 年轻代 Young/New
- 又被划分为Eden区和 Survivor区
- Tenure generation space 老年代 old/Tenure
- Meta Space 元空间 Meta
设置堆大小 -Xms -Xmx
Java堆区用于存储 Java 对象实例,那么堆的大小(年轻代+老年代)在 JVM 启动时就已经设定好了,可以通过选项-Xmx和-Xms来进行设置。(更多的设置在后面会讲到)
-Xms则用于表示堆区的起始内存,等价于-XX:InitialHeapSize;-X 是jvm运行参数,ms 是memory start-Xmx用于表示堆区的最大内存,等价于-XX:MaxHeapSize; -X 是jvm运行参数,ms 是memory max
一旦堆区中的内存大小超过所指定的最大内存时,将会抛出OutOfMemoryError异常
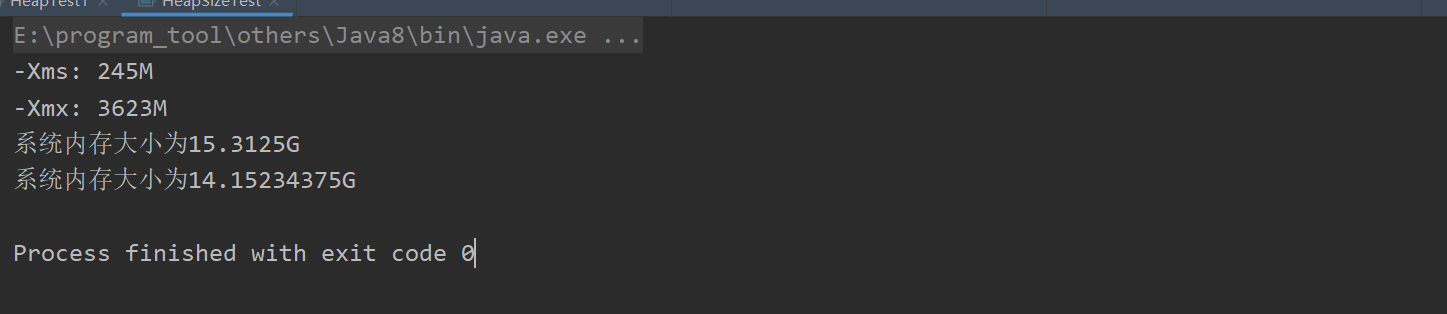
默认堆空间大小:
- 初始内存大小:物理电脑内存大小/64
- 最大内存大小:物理电脑内存大小/4
public class HeapSizeTest {
    public static void main(String[] args) {
        // 返回JVM堆空间内存总量(单位为MB)
        long initialMemory = Runtime.getRuntime().totalMemory() / 1024 / 1024;
        // 返回JVM可以使用的最大堆内存量(单位为MB)
        long maxMemory = Runtime.getRuntime().maxMemory() / 1024 / 1024;

        System.out.println("-Xms: " + initialMemory + "M");
        System.out.println("-Xmx: " + maxMemory + "M");

        System.out.println("系统内存大小为" + initialMemory * 64 / 1024.0 + "G");
        System.out.println("系统内存大小为" + maxMemory * 4 / 1024.0 + "G");
    }
}
手动设置:如-Xms600m -Xmx600m
开发中建议将初始雄内存和最大的雄内存设置成相同的值。
1、可以通过以下命令查看分配情况(需要保证进程存活)
jps	# 查看进程
jstat -gc [进程号]
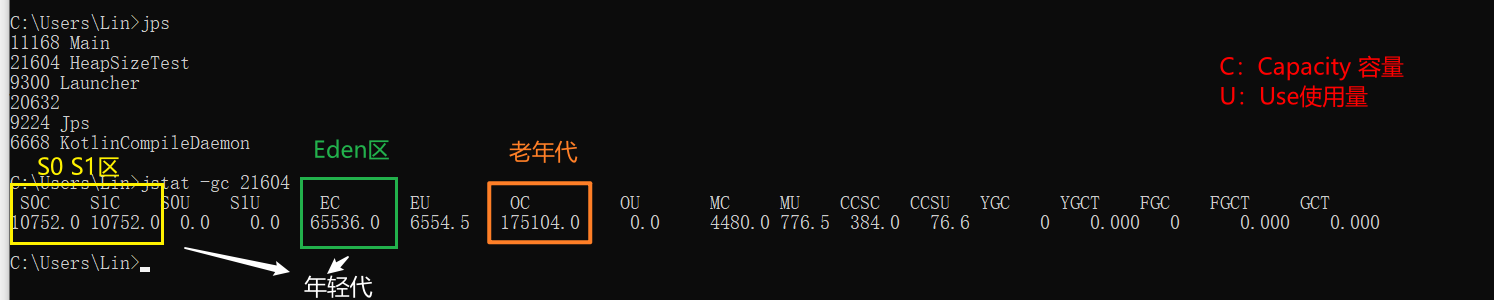
年轻代+老年代实际上用了256MB,而Runtime.getRuntime().totalMemory()只告诉是245MB,是因为没有算其中一个survivor区
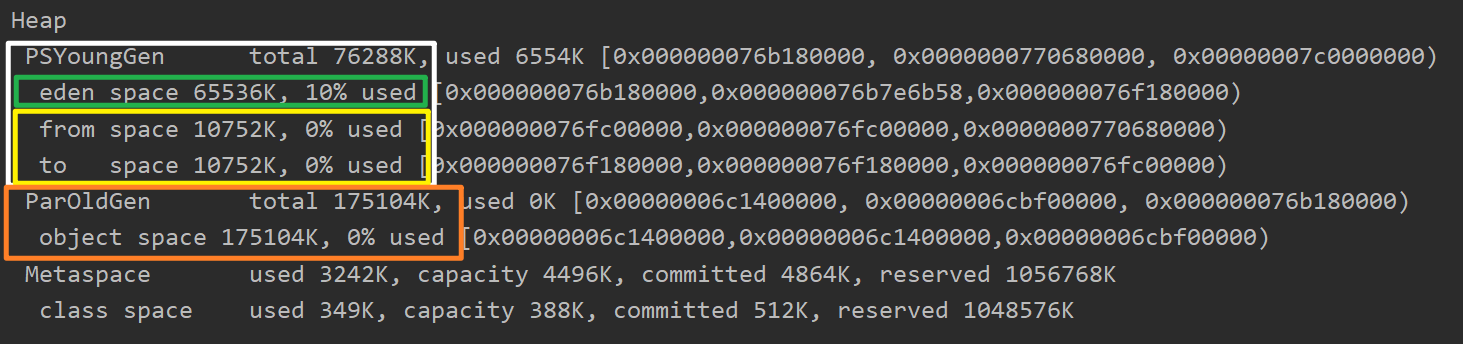
2、也可以通过-XX:+PrintGCDetails在程序直接输出
溢出问题
OutOfMemoryError主要由于堆中对象过多,超出堆的限制(虚拟机栈局部变量表的引用还没失效,GC不认为是垃圾对象无法回收,当老年代无法再容纳要分配进来的对象时,报OOM)
public class HeapOOMTest {
    public static void main(String[] args) {
        ArrayList<Picture> list = new ArrayList<>();

        while(true){
            list.add(new Picture(new Random().nextInt(1024*1024)));
        }
    }
}

class Picture{
    private byte[] pixels;

    public Picture(int length) {
        this.pixels = new byte[length];
    }
}
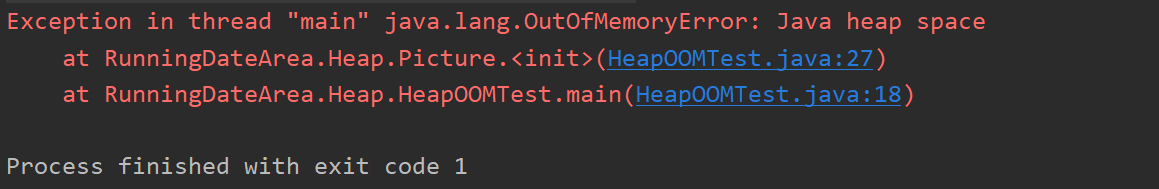
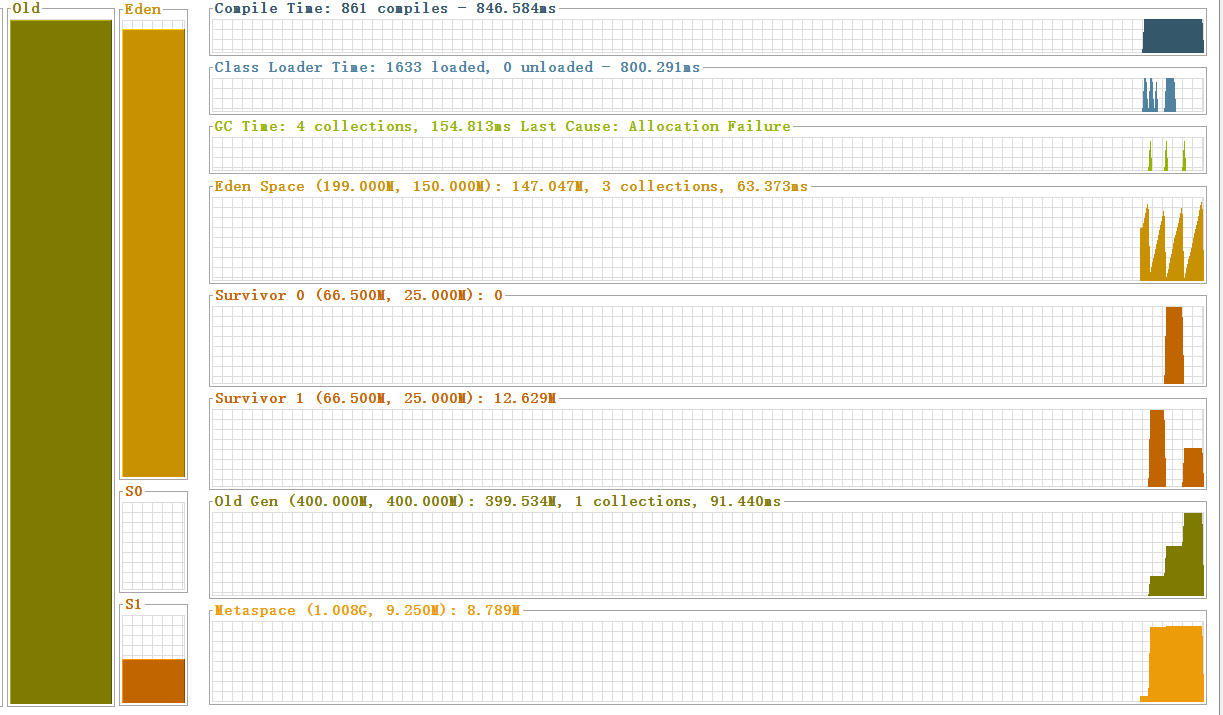
注:堆的OOM主要是由于往老年代分配对象时,老年代发生Full GC后,容量仍然无法达到需要的大小
如何解决OOM
1、要解决OOM异常或 heap space的异常,一般的手段是首先通过内存映像分析工具(如 Eclipse Memory Analyzer)对dump出来的堆转储快照进行分析,重点是确认内存中的对象是否是必要的,也就是要先分清楚到底是出现了内存泄漏(Memory Leak)还是内存溢出(Memory Overflow)。
2、如果是内存泄漏,可进一步通过工具査看泄漏对象到 GC Roots的引用链。于是就能找到泄漏对象是通过怎样的路径与GC Roots相关联并导致垃圾收集器无法自动回收它们的。掌握了泄漏对象的类型信息,以及 GC Roots引用链的信息,就可以比较准确地定位出泄漏代码的位置。java导致内存泄露的原因很明确:长生命周期的对象持有短生命周期对象的引用就很可能发生内存泄露,尽管短生命周期对象已经不再需要,但是因为长生命周期对象持有它的引用而导致不能被回收,这就是java中内存泄露的发生场景。
3、如果不存在内存泄漏,换句话说就是内存中的对象确实都还必须存活着,那就应当检查虚拟机的堆参数(-Xmx与-Xms),与机器物理内存对比看是否还可以调大,从代码上检査是否存在某些对象生命周期过长、持有状态时间过长的情况,尝试减少程序运行期的内存消耗。
分代
存储在中的 Java 对象可以被划分为两类
- 一类是生命周期较短的瞬时对象,这类对象的创建和消亡都非常迅速
- 另外一类对象的生命周期却非常长,在某些极端的情况下还能够与JM的生命周期保持一致。
Java堆区进一步细分的话,可以划分为年轻代(YoungGen)和老年代(olden)
- 其中年轻代又可以划分为Eden空间、Survivor0空间和 Survivor1空间(有时也叫做from区、to区)。
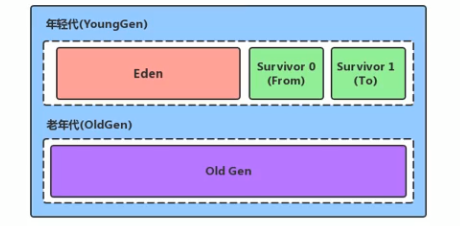
年轻代和老年代在堆结构占比为 1:2,这个参数在实际开发一般不会调。这里说一下,配置新生代与老年代在堆结构的占比的方法。
-
默认
-XX:NewRatio=2,表示新生代占1,老年代占2,新生代占整个堆的1/3 -
示例:可以修改
-XX:NewRatio=4,表示新生代占1,老年代占4,新生代占整个堆的1/5
在年轻代,Eden空间、Survivor0空间和 Survivor1空间的默认占比为8:1:1
-
默认
-XX:SurvivorRatio=8,表示Eden占8,S0与S1各占1 -
示例:可以修改
-XX:SurvivorRatio=4,表示Eden占4,S0与S1各占1 -
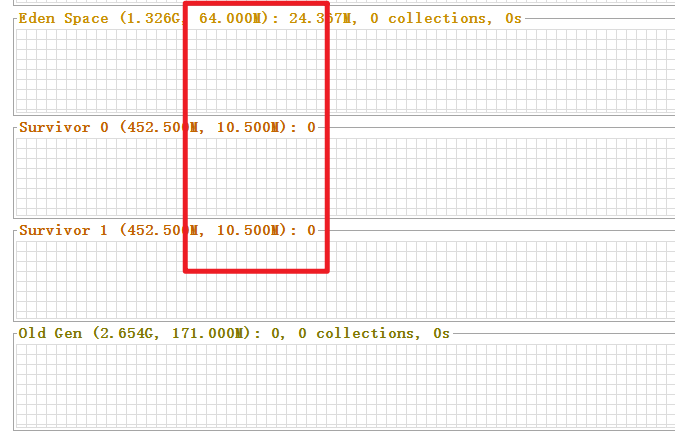
默认情况下,实际上并不是严格的8:1:1,如下图看到的是64:10.5:10.5 约为6:1:1
-XX:-UseAdaptiveSizePolicy即使关闭自适应内存大小也还是6:1:1
-
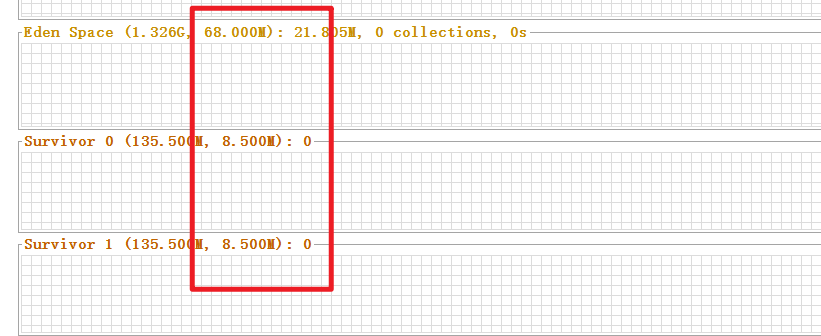
- 如果要想真正意义上的8:1:1,必须显示的声明
-XX:SurvivorRatio=8
- 如果要想真正意义上的8:1:1,必须显示的声明
几乎所有的Java对象(除了个别大对象)都是在Eden区被new出来的。
绝大部分的Java对象的销毁都在新生代进行的。
- IBM公司的专门研究表明,新生代中80%的对象都是“朝生夕死”的。
可以使用选项-Xmn设置新生代最大内存大小,这个参数一般不设置
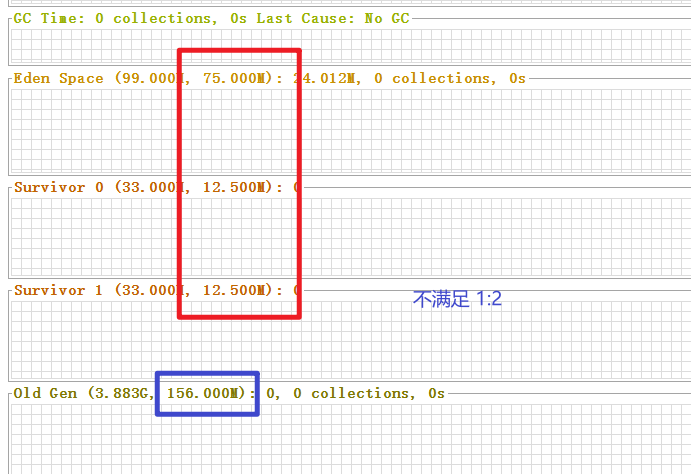
- 设置
-Xmn100m,可以看到年轻代:老年代不满足1:2的关系了
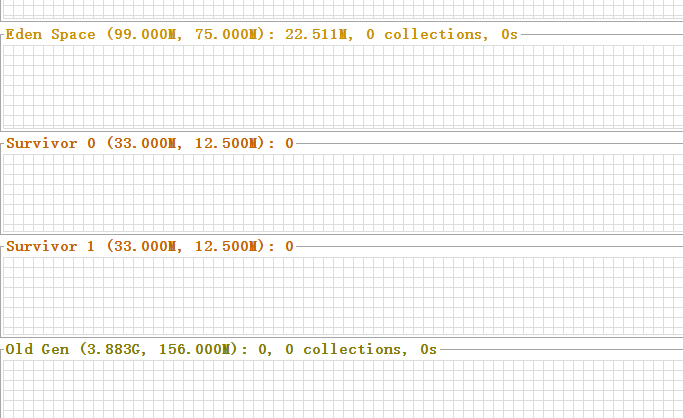
-Xmn100m -XX:NewRatio=3再设置比例关系,发现一点用都没有。结论是按-Xmn设置的为准
为什么需要把Java堆分代?不分代就不能正常工作了吗?
经研究,不同对象的生命周期不同。70%-99%的对象是临时对象。
- 新生代:有Eden、两块大小相同的 Survivor构成to总为空
- 老年代:存放新生代中经历多次GC仍然存活的对象。
其实不分代完全可以,分代的唯一理由就是优化GC性能。如果没有分代,那所有的对象都在一块,就如同把一个学校把所有学生都分到一个班上,这样肯定不如分班管理效率高。GC的时候要找到哪些对象没用,这样就会对堆的所有区域进行扫描。而很多对象都是朝生夕死的,如果分代的话,把新创建的对象放到某一地方,当GC的时候先把这块存储“朝生夕死”对象的区域进行回收,这样就会腾出很大的空间出来。
对象分配过程
为新对象分配内存是一件非常严谨和复杂的任务,JVM 的设计者们不仅需要考虑内存如何分配、在哪里分配等问题,并且由于内存分配算法与内存回收算法密切相关,所以还需要考虑GC执行完内存回收后是否会在内存空间中产生内存碎片。
- new的对象先放伊甸园区。此区有大小限制
- 当伊甸园的空间填满时,程序又需要创建对象,JVM的垃圾回收器将对伊甸园区进行垃圾回收(Minor GC),将伊甸园区中的不再被其他对象所引用的对象进行销毁。再加载新的对象放到伊甸园区
- 然后将伊甸园中的剩余对象移动到幸存者0区
- 如果再次触发垃圾回收,此时上次幸存下来的放到幸存者0区的,如果没有回收,就会放到幸存者1区
- 如果再次经历垃圾回收,此时会重新放回幸存者0区,接着再去幸存者1区。
- 啥时候能去养老区呢?可以设置次数。默认是15次
- 可以设置参数
-XX:MaxTenuringThreshold=<N>进行设置,其中N是阈值
- 可以设置参数
图示如下:
1、new的对象先放伊甸园区(非大对象)
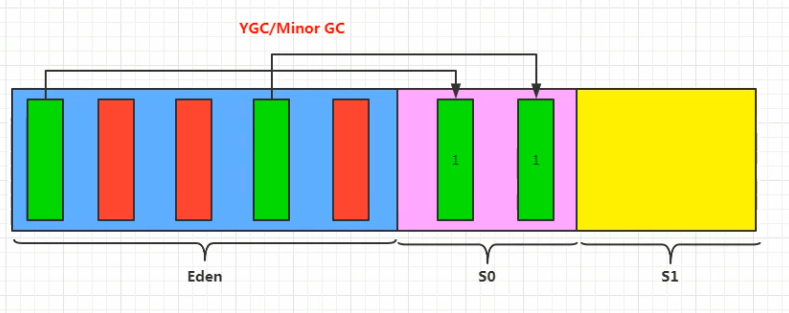
2、当需要new对象,但Eden区满,则会触发Minor GC,扫描Eden区和from区(from区和to区是为了区分s0区和s1区哪个是需要进行扫描回收的区,哪个是存放复制对象的区;实际上from和to在s0和s1中轮流交替),将存活对象复制到to区,再把要new的对象放入Eden区
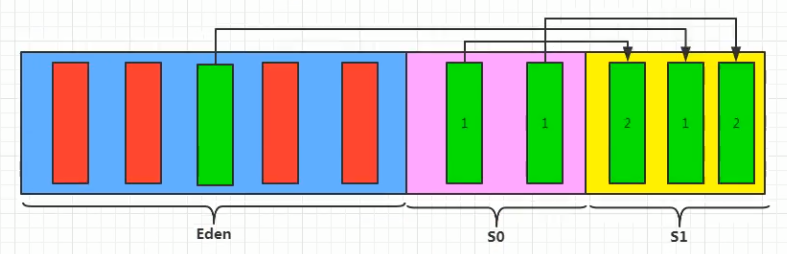
3、当to区的对象存活计数超过15,发生“晋升”,移到老年代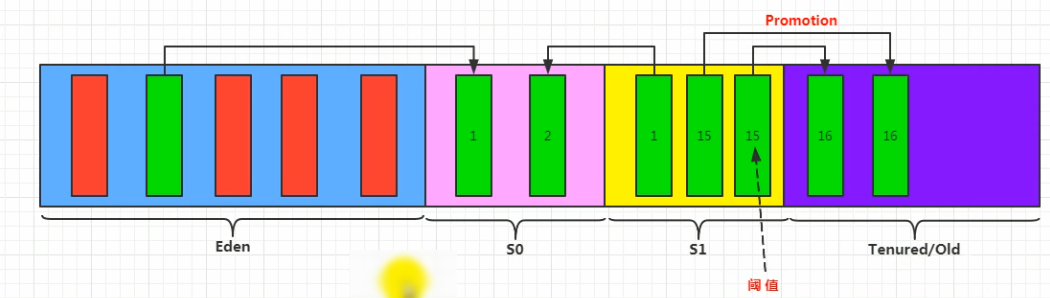
流程图如下:
[外链图片转存失败,源站可能有防盗链机制,建议将图片保存下来直接上传(img-M7ft2IZs-1592274735667)(https://gitee.com/zero049/MyNoteImages/raw/master/堆分配对象过程1.png)]
总结:
1、针对幸存者s0,s1区的总结:复制之后有交换,谁空谁是t0
2、关于垃圾回收:频繁在年轻代收集,很少在老年代收集,几乎不在永久区/元空间收集
内存分配策略(或对象提升(Promotion)规则)
如果对象在Eden出生并经过第一次 Minora后仍然存活,并且能被 Survivor容纳的话,将被移动到 Survivor空间中,并将对象年龄设为上对象在Survivor区中每熬过一次 Minor GC,年龄就增加1岁,当它的年龄增加到一定程度(默认为15岁,其实每个JVM、每个GC都有所不同)时,就会被晋升到老年代中。对象晋升老年代的年龄阈值,可以通过选项-XX:MaxTenuringThreshold来设置。
除此之外,针对不同年龄段的对象分配原则如下所示:
-
优先分配到Eden
-
大对象直接分配到老年代(需要占用大量连续内存空间的java对象是大对象,比如很长的字符串和数组。)
- 虚拟机设置了一个
-XX:PretenureSizeThreshold参数,令大于这个设置的对象直接在老年代分配。目的就是为了防止大对象在Eden空间和Survivor空间来回大量复制。(当这个大对象是朝生夕死的,就非常影响性能了,首先存入的时候可能发生Minor GC 和 Major GC)
- 虚拟机设置了一个
-
长期存活的对象分配到老年代(上述说的超过年龄阈值,放入老年代)
-
动态对象年龄判断(不一定要达到上面所说的阈值,也可以放入老年代)
- 如果 Survivor 区中相同年龄的存活对象大小的总和大于 Survivor 空间的一半,年龄大于或等于该年龄的对象可以直接进入老年代,无须等到
MaxTenuringThreshold中要求的年龄。比如,Survivor空间有一半以上的对象年龄为5,那就把年龄大于等于5的对象放入老年代。这样做好的好处在于避免了对象多次from与to之间来回复制,提高效率。
- 如果 Survivor 区中相同年龄的存活对象大小的总和大于 Survivor 空间的一半,年龄大于或等于该年龄的对象可以直接进入老年代,无须等到
-
空间分配担保机制(JDK1.7以后默认开启)
-
在发生Minor GC之前虚拟机会先检查老年代最大可用的连续空间是否大于新生代对象的总空间。如果这个条件成立,那么Minor GC可以确保是安全的。如果不成立,虚拟机会查看HandlePromotionFailure设置值是否允许担保失败。如果允许,虚拟机会继续检查老年代最大可用的连续空间是否大于历次Minor GC升入老年代对象的平均大小(因为事先不知道存活对象的内存空间,所以取了平均值)。若果大于,虚拟机会尝试进行一次Minor GC,但是这次Minor GC存在风险。如果小于,或者HandlePromotionFailure不允许担保,那这次也要改为Full GC。
-
-XX:+HandlePromotionFailure参数在JDK 1.6以后就被废弃了。JDK 1.6 以后,只要判断**“老年代可用空间”> “新生代对象总和”,或者“老年代可用空间”> “历次Minor GC升入老年代对象的平均大小”**,上述两个条件满足一个,就可以直接进行Minor GC,不需要提前触发Full GC了。(JDK1.7以后默认开启)
-
TLAB(Thread Local Allocation Buffer)
什么是TLAB
- 从内存模型而不是垃圾收集的角度,对Eden域继续进行划分,JVM 为每个线程分配了一个私有缓存区域,它包含在Eden空间内。
- 多线程同时分配内存时,使用TLAB可以避免一系列的非线程安全问题,同时还能够提升内存分配的吞吐量,因此我们可以将这种内存分配方式称之为快速分配策略。
- 据我所知所有 openJDK衍生出来的JM都提供了TLAB的设计。
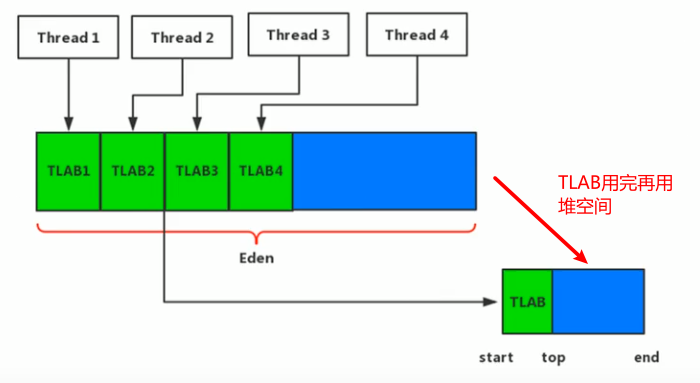
为什么要有TLAB(多线程下线程安全与效率的问题)
- 堆区是线程共享区域,任何线程都可以访问到堆区中的共享数据
- 由于对象实例的创建在 JVM 中非常频繁,因此在并发环境下从堆区中划分内存空间是线程不安全的
- 为避免多个线程操作同一地址,需要使用加锁等机制,进而影响分配速度
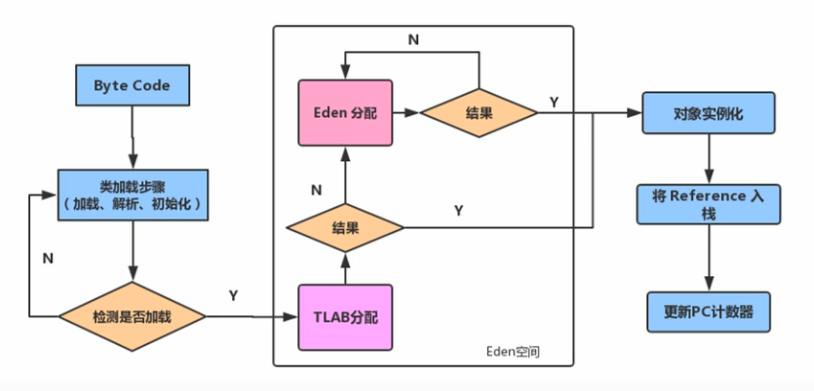
TLAB说明:
- 尽管不是所有的对象实例都能够在TLAB中成功分配内存,但JM确实是将TLAB作为内存分配的首选。
- 在程序中,开发人员可以通过选项
-XX:+/-UseTLAB设置是否开启TLAB空间。(通过jinfo -flag UseTLAB [进程号]看到默认是开启的) - 默认情况下,TLAB空间的内存非常小,仅占有整个Eden空间的1%,当然我们可以通过选项
-XX:TLABWasteTargetPercent设置TLAB空间所占用Eden空间的百分比大小 - 一旦对象在TLAB空间分配内存失败时,JVM就会尝试着通过使用加锁机制确保数据操作的原子性,从而直接在Eden空间中分配内存。(退回不用TLAB的处理策略)
堆空间常用的JVM参数设置
以-X开头的选项是非标准的(不保证在所有VM实现上都受支持),并且在JDK的后续版本中可能会更改。
使用-XX指定的选项不稳定。
-XX:+ 打开option参数
-XX:- 关闭option参数
-XX: = 设置。数字可以包括兆字节的“m”或“M”,千字节的“k”或“K”以及千兆字节的“g”或“G”(例如,32k与32768相同)。也可以用于指定文件,路径或命令列表
1、-Xms[内存大小]
设置初始堆内存空间大小(默认为物理内存的1/64)
2、-Xmx[内存大小]
最大堆空间内存(默认为物理内存的1/4)
3、-Xmn[内存大小] (不常用)
设置新生代的大小(初始值及最大值)
4、-XX:NewRatio=[N]
配置新生代与老年代在堆结构的占比,老年代:年轻代 = N
5、-XX:SurvivorRatio=[N]
设置新生代中Eden和S0/S1空间的比例,过大导致Minor GC失去意义(S0/S1太小,一旦Minor GC就往 Old区存),过小则Minor GC频繁发生
6、-XX:+PrintGCDetails
输出详细的GC处理日志,如要打印gc简要信息-XX:PrintGC
7、-XX:MaxTenuringThreshold=[N]
设置新生代垃极的最大年龄为N
8、-XX:+PrintFLagsInitial
查看所有的参数的默认初始值
9、-XX:+PrintFLagsFinal
查看所有的参数的最终值(可能会存在修改,不厚是初始值)
但是通常可以通过下面的命令去查某个JVM进程的参数设置
jps
jinfo -flag [参数名] [进程号]
堆是分配对象存储的唯一选择吗?(逃逸分析)
对堆的优化主要在于一个OOM和Major/Full GC(STW),但毕竟还是因为在堆中管理对象出现的问题,那么就提出了能不能不在堆中分配对象的技术,尝试突破上述的局限性。
在《深入理解Java虛拟机》中关于Java堆内存有这样一段描述:随着 JIT 编译期的发展与==逃逸分析技术逐渐成熟,栈上分配、标量替换优化技术==将会导致一些微妙的变化,所有的对象都分配到堆上也渐渐变得不那么“绝对”了
在Java虚拟机中,对象是在Java堆中分配内存的,这是一个普遍的常识。但是,有种特殊情况,那就是**如果经过逃逸分析(Escape Analysis)后发现,一个对象并没有逃逸出方法的话,那么就可能被优化成栈上分配。**JVM允许将线程私有的对象打散分配在栈上,而不是分配在堆上。分配在栈上的好处是可以在函数调用结束后自行销毁,而不需要垃圾回收器的介入,从而提高系统性能。
此外,前面提到的基于 OpenJDK深度定制的 TaoBaovM,其中创新的GCIH(GC invisible heap)技术实现off-heap,将生命周期较长的Java对象从heap中移至heap外,并且GC不能管理GCIH内部的Java对象,以此达到降低GC的回收频率和提升GC的回收效率的目的。
如何将堆上的对象分配到栈,需要使用逃逸分析手段
这是一种可以有效减少Java程序中同步负载和内存堆分配压力的跨函数全局数据流分析算法。
通过逃逸分析,Java HotSpot编译器能够分析出一个新的对象的引用的使用范围从而决定是否要将这个对象分配到堆上
逃逸分析的基本行为就是分析对象动态作用域
-
当一个对象在方法中被定义后,对象只在方法内部使用,则认为没有发生逃逸。
-
当一个对象在方法中被定义后,它被外部方法所引用,则认为发生逃逸。例如作为调用参数传递到其他地方中
例如:
下面的代码别的方法可以拿到这个sb对象,并对sb对象进行操作,那么这个sb就是逃逸出了方法**(可以被别的方法使用改变)**
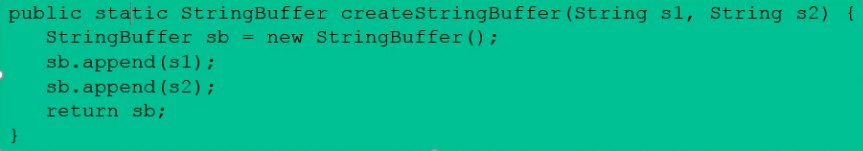
上述代码如果想要 StringBuffer sb不逃出方法,可以这样写:(不会被其他方法使用和改变,对象仅在本方法内使用)
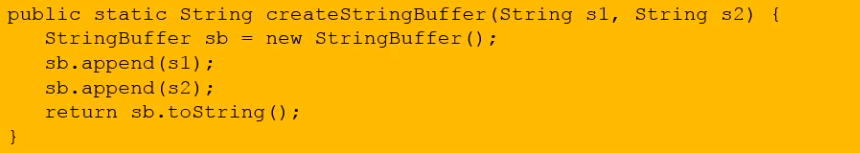
没有发生逃逸的对象,则可以分配到栈上,随着方法执行的结束,栈空间就被移除。
在 JDK6u23版本之后,Hotspot中默认就已经开启了逃逸分析(需要和标量替换同时使用才生效,标量替换也是默认开启的),通过如下设置关闭。
-XX:-DoEscapeAnalysis
使用逃逸分析,执行引擎可以对代码做如下优化:
一、栈上分配。(HotSpot并没有去实现)将堆分配转化为栈分配。如果一个对象在子程序中被分配,要使指向该对象的指针永远不会逃逸,对象可能是栈分配的候选,而不是堆分配。(可以明确的说,目前所有对象实例都分配在堆中)
- JIT 编译器在编译期间根据逃逸分析的结果,发现如果一个对象并没有逃逸出方法的话,就可能被优化成栈上分配。分配完成后,继续在调用栈内执行,最后线程结束,栈空间被回收,局部变量对象也被回收。这样就无须进行垃圾回收了。
**二、同步省略。**如果一个对象被发现只能从一个线程被访问到,那么对于这个对象的操作可以不考虑同步。
-
线程同步的代价是相当高的,同步的后果是降低并发性和性能。
-
在动态编译同步块的时候,JIT 编译器可以借助逃逸分析来判断同步块所使用的对象是否只能够被一个线程访问而没有被发布到其他线程。如果没有,那么JIT 编译器在编译这个同步块的时候就会取消对这部分代码的同步。这样就能大大提高并发性和性能。这个取消同步的过程就叫同步省略,也叫锁消除。
-
举例:
下面的方法,多线程环境下,每个线程都new 了一个hollis(相当于线程私有),锁的对象完全不是同一个
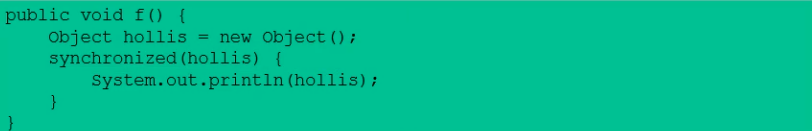
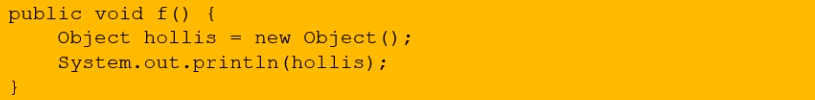
代码中对hollis这个对象进行加锁,但是hollis对象的生命周期只在 f() 方法中,并不会被其他线程所访问到,所以在 JIT 编译阶段就会被优化掉。优化成:
**三、分离对象或标量替换。**有的对象可能不需要作为一个连续的内存结构存在也可以被访问到,那么对象的部分(或全部)可以不存储在内存,而是存储在CPU寄存器中。
-
标量(scalar)是指一个无法再分解成更小的数据的数据。Java中的原始数据类型就是标量。
-
相对的,那些还可以分解的数据叫做聚合量(Aggregate),Java中的对象就是聚合量,因为他可以分解成其他聚合量和标量。
-
在 JIT 编译阶段,如果经过逃逸分析,发现一个对象不会被外界访问的话,那么经过JIT优化,就会把这个对象拆解成若干个其中包含的若干个成员变量来代替。这个过程就是标量替换。
-
参数
-XX:+EliminateAllocations开启了标量替换(默认打开),允许将对象打散分配在栈上 -
示例:
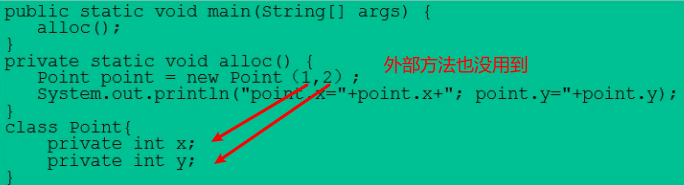
以上代码,经过标量替换后,就会变成:

可以看到,Point这个聚合量经过逃逸分析后,发现他并没有逃逸,就被替换成两个聚合量了。那么标量替换有什么好处呢?就是可以大大减少堆内存的占用。因为一旦不需要创建对象了,那么就不再需要分配堆内存了。标量替换为栈上分配提供了很好的基础。
参数
- 参数
-server:启动 Server模式,因为在 Server模式下,才可以启用逃逸分析。HotSpot默认是启动 - 参数
-XX:+DoEscapeAnalysis:启用逃逸分析 - 参数
-XX:+EliminateAllocations:开启了标量替换(默认打开),允许将对象打散分配在栈上,比如对象拥有id和name两个字段,那么这两个字段将会被视为两个独立的局部变量进行分配。
逃逸分析总结:
这项技术到如今也并不是十分成熟的。
其根本原因就是无法保证逃逸分析的性能消耗一定能高于他的消耗。虽然经过逃逸分析可以做标量替换、栈上分配、和锁消除。但是逃逸分析自身也是需要进行一系列复杂的分析的,这其实也是一个相对耗时的过程。
虽然这项技术并不十分成熟,但是它也是即时编译器优化技术中一个十分重要的手段。
注意到有一些观点,认为通过逃逸分析,JVM会在栈上分配那些不会逃逸的对象,这在理论上是可行的,但是取决于JVM设计者的选择。据我所知,Oracle Hotspot VM中并未这么做,这一点在逃逸分析相关的文档里已经说明,所以可以明确所有的对象实例都是创建在堆上
方法区(Method Area)
《Java虚拟机规范》中明确说明:“尽管所有的方法区在逻辑上是属于堆的一部分,但一些简单的实现可能不会选择去进行垃圾收集或者进行压缩。”但对于 HotSpot VM而言,方法区还有一个别名叫做Non-Heap(非堆),目的就是要和堆分开。
所以,方法区看作是一块独立于Java堆的内存空间。
- 方法区(Method area)与Java堆一样,是各个线程共享的内存区域。
- 方法区在J启动的时候被创建,并且它的实际的物理内存空间中和Java堆区一样都可以是不连续的。
- 方法区的大小,跟堆空间一样,可以选择固定大小或者可扩展。
- 方法区的大小决定了系统可以保存多少个类,如果系统定义了太多的类,导致方法区溢出,虚拟机同样会抛出内存溢出错误:
java.lang.OutOfMemmoryteError:PermGen space或者java.lang.OutOfMemoryError:Metaspace- 比如 加载大量的第三方的jar包;
- Tomcat部署的工程过多(30-50)
- 大量动态的生成反射类
- 关闭JVM就会释放这个区域的内存
示例:
public class MethodAreaTest1 {
    public static void main(String[] args) {
        System.out.println("Start.....");
        try {
            Thread.sleep(1000000000);
        } catch (InterruptedException e) {
            e.printStackTrace();
        }
        System.out.println("End.....");
    }
}
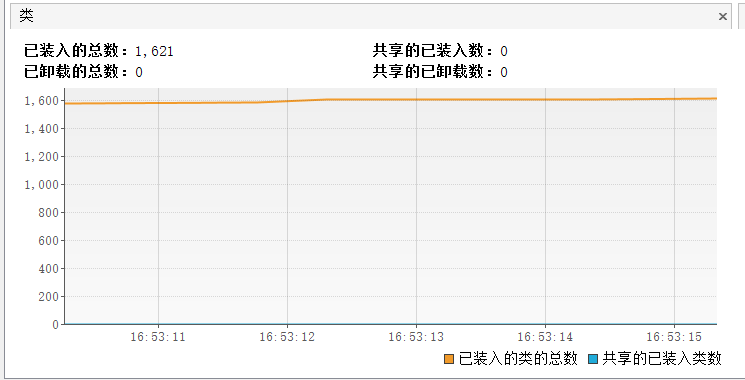
可以看到如此简单的程序加载了1600+的类
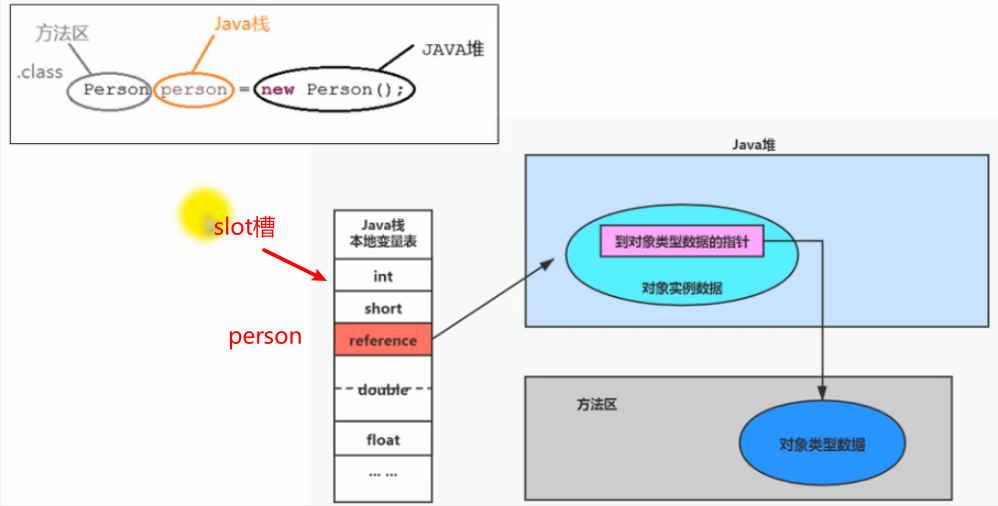
栈、堆、方法区的交互关系
HopSpot JVM实现模型如下图所示
HotSpot中方法区的演进
在jdk7及以前,习惯上把方法区,称为永久代。jk8开始,使用元空间取代了永久代。(本地内存)
本质上,方法区和永久代并不等价。仅是对 HotSpot而言的。《Java虚拟机规范》对如何实现方法区,不做统一要求。例如:BEA JRockit/IBM J9中不存在永久代的概念。
现在来看,当年使用永久代,不是好的idea。导致Java程序更容易OOM(使用的是分配给JVM内的内存,容易超过-XX:MaxPermsize上限)
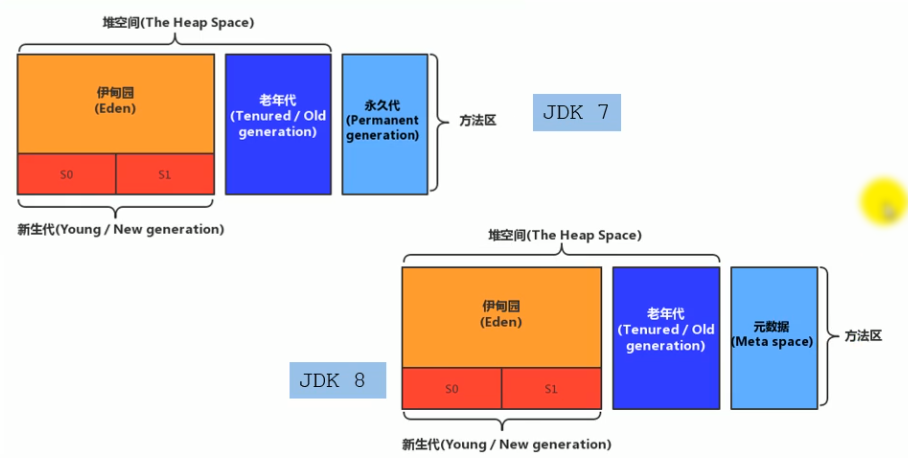
而到了JDK8,终于完全废弃了永久代的概念,改用与 JRockit、J9一样在本地内存中实现的元空间(Metaspace)来代替
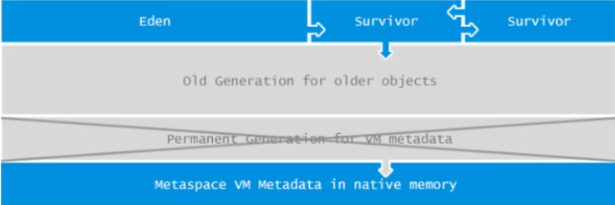
元空间的本质和永久代类似,都是对 JVM 规范中方法区的实现。不过元空间与永久代最大的区别在于:元空间不在虚拟机设置的内存中,而是使用本地内存。
永久代、元空间二者并不只是名字变了,内部结构也调整了。
根据《Java虚拟机规范》的规定,如果方法区无法满足新的内存分配需求时,将抛出OOM异常。
设置方法区大小 -XX:MaxMetaSpace
方法区的大小不必是固定的,JVM可以根据应用的需要动态调整。
- jdk7及以前
- 通过
-XX:PermSize来设置永久代初始分配空间。默认值是20.75M -XX:MaxPerSize来设定永久代最大可分配空间。32位机器默认是64M,64位机器模式是82M- 当 JVM 加载的类信息容量超过了这个值,会报异常 OutOfMemoryError:Permgen space
- 通过
- jdk8
- 默认值依赖于平台。windows下:
- 通过
-XX:MetaspaceSize来设置元空间初始分配空间。默认值是20.75M -XX:MaxMetaspaceSize来设定元空间最大可分配空间。默认值是-1,即没有限制(本地内存大小)
- 通过
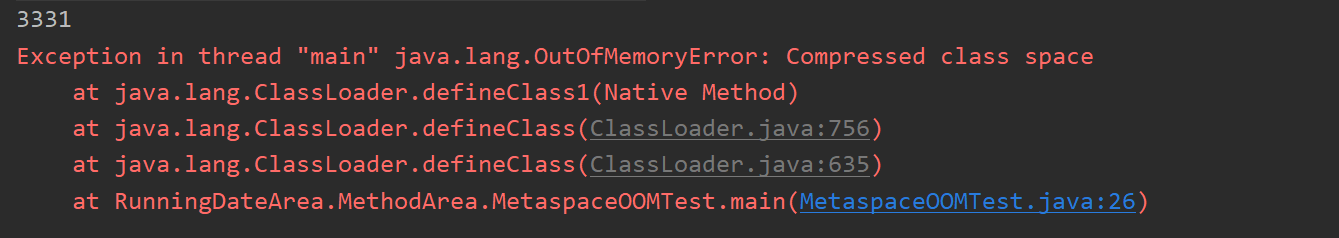
- 与永久代不同,如果不指定大小,默认情况下,虚拟机会耗尽所有的可用系统内存。如果元数据区发生溢出,虚拟机一样会抛出异常 OutOfMemoryError:Metaspace(未优化,优化后可能是Compressed class space)
-XX:MetaspaceSize:设置初始的元空间大小。对于一个64位的服务器端JVM来说,其默认的-XX:MetaspaceSize值为21MB。这就是初始的高水位线,一旦触及这个水位线,Full GC将会被触发并卸载没用的类(即这些类对应的类加载器不再存活)然后这个高水位线将会重置。新的高水位线的值取决于GC后释放了多少元空间。如果释放的空间不足,那么在不超过 MaxMetaspaceSize时,适当提高该值。如果释放空间过多,则适当降低该值。- 如果初始化的高水位线设置过低,上述高水位线调整情况会发生很多次。通过垃圾回收器的日志可以观察到Full GC多次调用。为了避免频繁地GC,建议将
-XX:MetaspaceSize设置为一个相对较高的值
- 默认值依赖于平台。windows下:
溢出问题
方法区发生OOM
看下面的示例,不需要完全看懂,就是生成100000个类
public class MetaspaceOOMTest extends ClassLoader {
    public static void main(String[] args) {
        int j = 0;
        try {
            MetaspaceOOMTest test = new MetaspaceOOMTest();
            for (int i = 0; i < 100000; i++) {
                //创建ClassWriter对象,用于生成类的二进制信息
                ClassWriter classWriter = new ClassWriter(0);
                //指明版本号(不同版本字节码可能不同),修饰符,类名,包名,父类,接口
                classWriter.visit(Opcodes.V1_8, Opcodes.ACC_PUBLIC, "Class" + i, null, "java/lang/Object", null);
                //返回byte[]
                byte[] code = classWriter.toByteArray();
                //类的加载
                test.defineClass("Class" + i, code, 0, code.length);
                j++;
            }
        } finally {
            System.out.println(j);
        }
    }
}
设置JVM参数
-XX:MetaspaceSize=10m -XX:MaxMetaspaceSize=10m
报错信息是Compress class space并不是Metaspace,原因是Compress class space是Metaspace的优化版本(jdk1.8也分很多版本)
方法区的结构
java代码与方法区的关系如下图所示
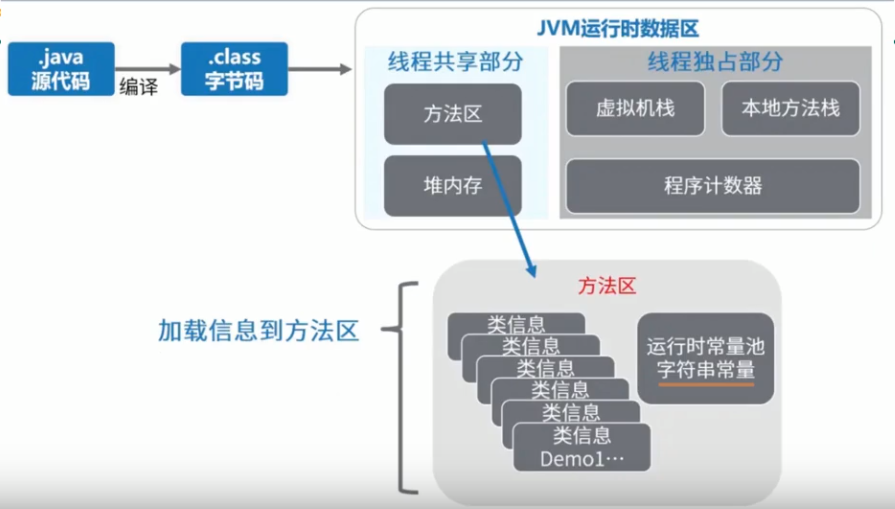
《深入理解Java虚拟机》书中对方法区(Method area)存储内容描述如下:
它用于存储已被虚拟机加载的类型信息、常量、静态变量、即时编译器编译后的代码缓存等
方法区存储主要包括以下内容:这里介绍最经典方法区的设计(不同JDK版本可能不同,只挑选比较有代表性的设计)
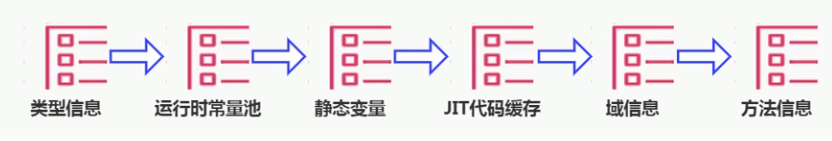
类型信息
(关于这个类的信息)
对每个加载的类型(类class、接口 interface、枚举enum、注解 annotation),JVM必须在方法区中存储以下类型信息:
- 这个类型的完整有效名称(全名=包名.类名)
- 这个类型直接父类的完整有效名(对于 interface或是java.lang.Object,都没有父类)
- 这个类的修饰符(public,abstract,final的某个子集)
- 这个类型直接接口的一个有序列表
运行时常量池
要弄清楚方法区,需要理解清楚 ClassFile,因为加载类的信息都在方法区
要弄清楚方法区的运行时常量池,需要理解清楚ClassFile中的常量池
- 方法区,内部包含了运行时常量池(class文件的常量池加载到方法区后)
- 字节码文件,内部包含了常量池
常量池
一个有效的字节码文件中除了包含类的版本信息、字段、方法以及接口等描述信息外,还包含一项信息那就是常量池表(Constant pool Table),包括各种字面量和对类型域和方法的符号引用(各种 #数字)
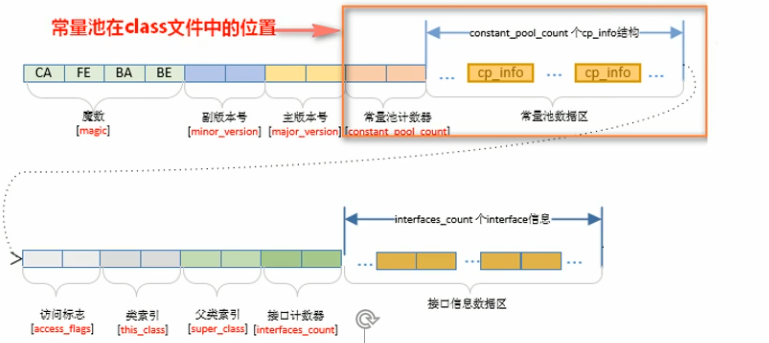
几种在常量池内存储的数据类型包括:
- 数量值
- 字符串值
- 类引用
- 字段引用
- 方法引用
作用:提高数据的复用性,每个对象对于同样的数据的使用,在一些情况只需要用一份数据即可(常量池中)
常量池,可以看做是一张表,虚拟机指令根据这张常量表找到要执行的类名、方法名、参数类型、字面量等类型。
运行时常量池
运行时常量池(Runtime Constant pool)是方法区的一部分。
常量池表(Constant pool tab]e)是Class文件的一部分,用于存放编译期生成的各种字面量与符号引用,这部分内容将在类加载后存放到方法区的运行时常量池中。
- 运行时常量池,在加载类和接口到虚拟机后,就会创建对应的运行时常量池。
- JVM 为每个已加载的类型(类或接口)都维护一个常量池。池中的数据项像数组项一样,是通过索引访问的。
- 运行时常量池中包含多种不同的常量,包括编译期就已经明确的数值字面量,也包括到运行期解析后才能够获得的方法或者字段引用。此时不再是常量池中的符号地址了,这里换为真实地址。
- 运行时常量池,相对于Class文件常量池的另一重要特征是:具备动态性。(不光是常量池的东西)
- 运行时常量池类似于传统编程语言中的符号表(symbol table),但是它所包含的数据却比符号表要更加丰富一些。
- 当创建类或接口的运行时常量池时,如果构造运行时常量池所需的内存空间超过了方法区所能提供的最大值,则JVM会抛 OutOfMemoryError异常。
域(Field)信息
(关于这个类内的属性的信息)
- JVM必须在方法区中保存类型的所有域的相关信息以及域的声明顺序。
- 域的相关信息包括:域名称、域类型、域修饰符(public,private,protected,static,fina1,volatile,transient的某个子集)
方法(Method)信息
(关于这个类内的方法的信息)
JVM必须保存所有方法的以下信息,同域信息一样包括声明顺序:
- 方法名称
- 方法的返回类型(或void)
- 方法参数的数量和类型(按顺序)
- 方法的修饰符(public,private,protected,static,final,synchronized,native,abstract的一个子集)
- 方法的字节码(bytecodes)、操作数栈、局部变量表及大小(abstract和native方法除外)
- 异常表(abstract和 native方法除外)
- 每个异常处理的开始位置、结束位置、代码处理在程序计数器中的偏移地址、被捕获的异常类的常量池索引
示例
public class MethodAreaDemo {
    private int index;
    public static String str;

    public void test1(){
        int count = 20;
        System.out.println(count);
    }

    public static int test2(){
        int result = 0;
        return result;
    }
}
进行反解析输出
javap -v -p MethodAreaDemo.class > test.txt
查看相应信息
Classfile /F:/Project/Java/BaseKownledgeLearn/JVMLearn/target/classes/RunningDateArea/MethodArea/MethodAreaDemo.class
  Last modified 2020-6-5; size 847 bytes
  MD5 checksum b7a5e6de838df6ba3351abac162df0d6
  Compiled from "MethodAreaDemo.java"
      //注意不会有ClassLoader的信息,因为class文件本身就还没被类加载器加载
      //类信息
public class RunningDateArea.MethodArea.MethodAreaDemo
  minor version: 0
  major version: 52
  flags: ACC_PUBLIC, ACC_SUPER		//修饰符

      // 常量池
Constant pool:
   #1 = Methodref          #7.#30         // java/lang/Object."<init>":()V
   #2 = Fieldref           #31.#32        // java/lang/System.out:Ljava/io/PrintStream;
   #3 = Methodref          #33.#34        // java/io/PrintStream.println:(I)V
   #4 = Class              #35            // java/lang/Exception
   #5 = Methodref          #4.#36         // java/lang/Exception.printStackTrace:()V
   #6 = Class              #37            // RunningDateArea/MethodArea/MethodAreaDemo
   #7 = Class              #38            // java/lang/Object
   #8 = Utf8               index
   #9 = Utf8               I
  #10 = Utf8               str
  #11 = Utf8               Ljava/lang/String;
  #12 = Utf8               <init>
  #13 = Utf8               ()V
  #14 = Utf8               Code
  #15 = Utf8               LineNumberTable
  #16 = Utf8               LocalVariableTable
  #17 = Utf8               this
  #18 = Utf8               LRunningDateArea/MethodArea/MethodAreaDemo;
  #19 = Utf8               test1
  #20 = Utf8               count
  #21 = Utf8               test2
  #22 = Utf8               ()I
  #23 = Utf8               e
  #24 = Utf8               Ljava/lang/Exception;
  #25 = Utf8               result
  #26 = Utf8               StackMapTable
  #27 = Class              #35            // java/lang/Exception
  #28 = Utf8               SourceFile
  #29 = Utf8               MethodAreaDemo.java
  #30 = NameAndType        #12:#13        // "<init>":()V
  #31 = Class              #39            // java/lang/System
  #32 = NameAndType        #40:#41        // out:Ljava/io/PrintStream;
  #33 = Class              #42            // java/io/PrintStream
  #34 = NameAndType        #43:#44        // println:(I)V
  #35 = Utf8               java/lang/Exception
  #36 = NameAndType        #45:#13        // printStackTrace:()V
  #37 = Utf8               RunningDateArea/MethodArea/MethodAreaDemo
  #38 = Utf8               java/lang/Object
  #39 = Utf8               java/lang/System
  #40 = Utf8               out
  #41 = Utf8               Ljava/io/PrintStream;
  #42 = Utf8               java/io/PrintStream
  #43 = Utf8               println
  #44 = Utf8               (I)V
  #45 = Utf8               printStackTrace
{
      // 域信息
  private int index;
    descriptor: I
    flags: ACC_PRIVATE

  public static java.lang.String str;
    descriptor: Ljava/lang/String;
    flags: ACC_PUBLIC, ACC_STATIC

	// 默认的空参构造方法
  public RunningDateArea.MethodArea.MethodAreaDemo();
    descriptor: ()V
    flags: ACC_PUBLIC
    Code:
      stack=1, locals=1, args_size=1
         0: aload_0
         1: invokespecial #1                  // Method java/lang/Object."<init>":()V
         4: return
      LineNumberTable:
        line 8: 0
      LocalVariableTable:
        Start  Length  Slot  Name   Signature
            0       5     0  this   LRunningDateArea/MethodArea/MethodAreaDemo;
// 方法信息
  public void test1();
    descriptor: ()V
    flags: ACC_PUBLIC
    Code:
      stack=2, locals=2, args_size=1		// 操作数栈 2,局部变量表 2,参数长度 1
         0: bipush        20
         2: istore_1
         3: getstatic     #2                  // Field java/lang/System.out:Ljava/io/PrintStream;
         6: iload_1
         7: invokevirtual #3                  // Method java/io/PrintStream.println:(I)V
        10: return
      LineNumberTable:
        line 13: 0
        line 14: 3
        line 15: 10
      LocalVariableTable:
        Start  Length  Slot  Name   Signature
            0      11     0  this   LRunningDateArea/MethodArea/MethodAreaDemo;
            3       8     1 count   I

  public static int test2();
    descriptor: ()I
    flags: ACC_PUBLIC, ACC_STATIC
    Code:
      stack=2, locals=2, args_size=0
         0: iconst_0
         1: istore_0
         2: getstatic     #2                  // Field java/lang/System.out:Ljava/io/PrintStream;
         5: iload_0
         6: invokevirtual #3                  // Method java/io/PrintStream.println:(I)V
         9: goto          17
        12: astore_1
        13: aload_1
        14: invokevirtual #5                  // Method java/lang/Exception.printStackTrace:()V
        17: iload_0
        18: ireturn
      Exception table:			// 异常表
         from    to  target type
             2     9    12   Class java/lang/Exception
      LineNumberTable:
        line 18: 0
        line 20: 2
        line 23: 9
        line 21: 12
        line 22: 13
        line 24: 17
      LocalVariableTable:
        Start  Length  Slot  Name   Signature
           13       4     1     e   Ljava/lang/Exception;
            2      17     0 result   I
      StackMapTable: number_of_entries = 2
        frame_type = 255 /* full_frame */
          offset_delta = 12
          locals = [ int ]
          stack = [ class java/lang/Exception ]
        frame_type = 4 /* same */
}
SourceFile: "MethodAreaDemo.java"
non-final的类变量
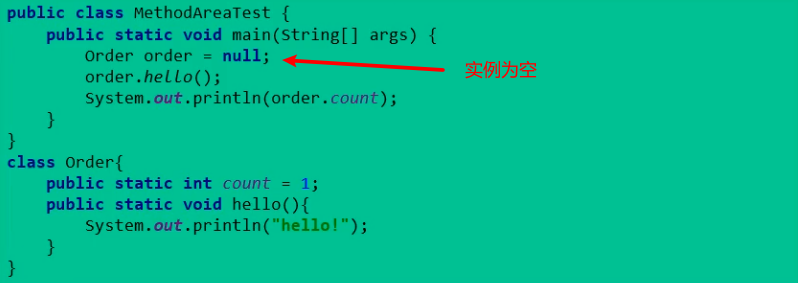
- 静态变量和类关联在一起,随着类的加载而加载,它们成为类数据在逻辑上的一部分。
- 类变量被类的所有实例共享,即使没有类实例时你也可以访问它
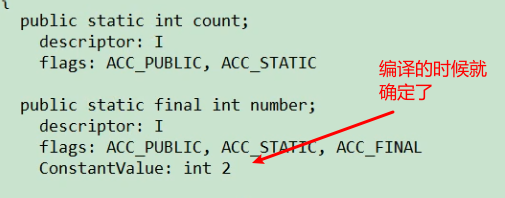
static final:全局常量
被声明为final 的类变量的处理方法则不同,每个全局常量在编译的时候就会被分配了
public class{
    public static int count = 1;
    public static final int number = 2;
}
方法区的演进过程
1.首先明确:只有 HotSpot才有永久代。
BEA JRockit、IBM J9等来说,是不存在永久代的概念的。原则上如何实现方法区属于虚拟机实现细节,不受《ava虚拟机规范》管束,并不要求统一。
2.Hotspot中方法区的变化:
| 版本 | 描述 |
|---|---|
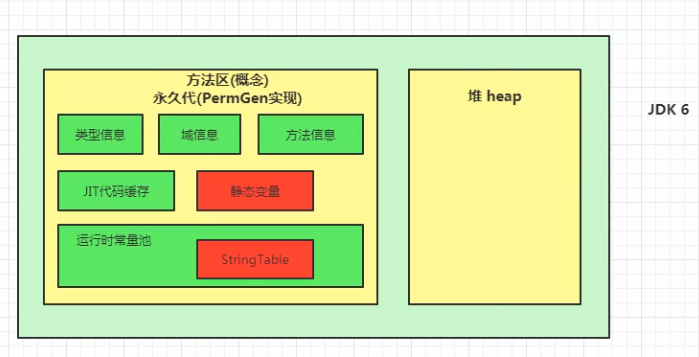
| jdk1.6及之前 | 有永久代(permanent generation),静态变量存放在永久代上 |
| jdk1.7 | 有永久代,但已经逐步“去永久代”,字符串常量池、静态变量移除,保存在堆中 |
| jdk1.8 | 无永久代,类型信息、字段、方法、常量保存在本地内存的元空间,但字符串常量池、静态变量仍在堆 |
具体区别如下图:
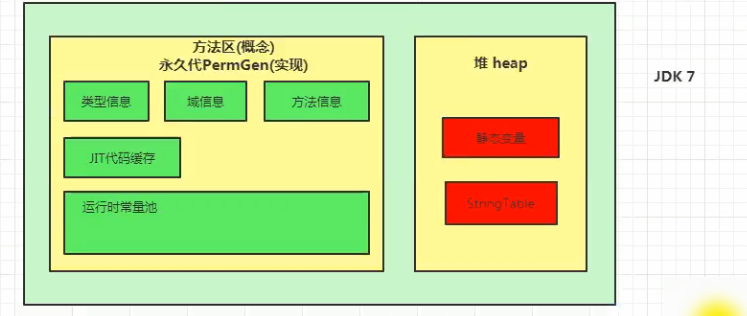
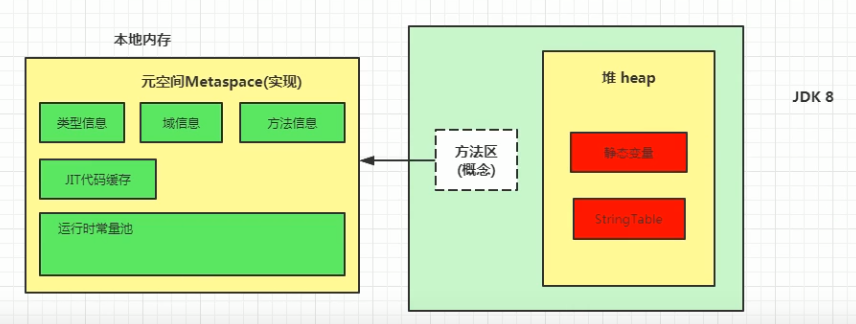
随着Java8的到来,HotSpot VM中再也见不到永久代了。但是这并不意味着类的元数据信息也消失了。这些数据被移到了一个与堆不相连的本地内存区域,这个区域叫做元空间(Metaspace)。
由于类的元数据分配在本地内存中,元空间的最大可分配空间就是系统可用内存空间
永久代为什么要被元空间替换?
官方文档说因为JRockit也没有,所以咱们HotSpot与JRockit整合那也不要永久代了(= =),确实JRockit在考虑兼容性的时候是最快的JVM,那么下面解释下为什么要用元空间替换
-
为永久代设置空间大小是很难确定的
-
在某些场景下,如果动态加载类过多,容易产生Perm区的OOM。比如某个实际Web工程中,因为功能点比较多,在运行过程中,要不断动态加载很多类,经常出现致命错误。(Full GC导致的STW影响性能和体验和OOM直接就宕机了)
-
而元空间和永久代之间最大的区别在于:元空间并不在虚拟机中,而是使用本地内存。(元空间就基本不会因为自己触发Full GC和OOM的问题了)
因此,默认情况下,元空间的大小仅受本地内存限制。
-
-
对永久代进行调优是很困难的。Full GC进行常量和类的判断回收条件是非常复杂的,耗时多
StringTable(字符串常量池)为什么要调整?
jdk7中将 StringTable放到了堆空间中。因为永久代的回收效率很低,在Full GC的时候才会触发。而Full GC是老年代的空间不足、永久代不足时才会触发。
这就导致 StringTable回收效率不高。而我们开发中会有大量的字符串被创建,回收效率低,导致永久代内存不足。放到堆里,能及时回收内存。
注意:字符串常量池存的不是对象,而是对象的引用
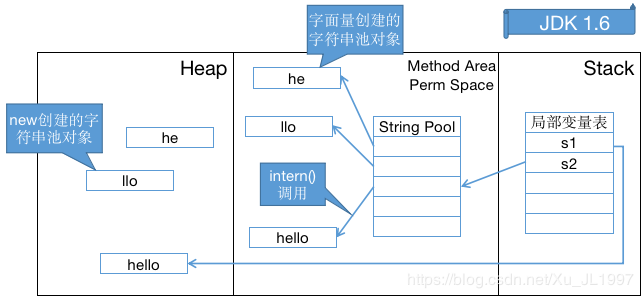
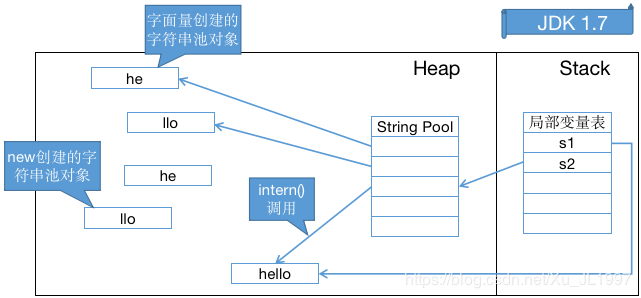
看一道比较常见的面试题,下面的代码创建了多少个 String 对象?
String s1 = new String("he") + new String("llo");
String s2 = s1.intern();

System.out.println(s1 == s2);
// 在 JDK 1.6 下输出是 false,创建了 6 个对象
// 在 JDK 1.7 之后的版本输出是 true,创建了 5 个对象
// 当然我们这里没有考虑GC,但这些对象确实存在或存在过
1、在 JDK 1.6 中,调用 intern() 首先会在字符串池中寻找 equal() 相等的字符串,假如字符串存在就返回该字符串在字符串池中的引用;假如字符串不存在,虚拟机会重新在永久代上创建一个实例,将 StringTable 的一个表项指向这个新创建的实例。
2、在 JDK 1.7 中,由于字符串池不在永久代了,intern() 做了一些修改,更方便地利用堆中的对象。字符串存在时和 JDK 1.6一样,但是字符串不存在时不再需要重新创建实例,可以直接指向堆上的实例。
方法区垃圾回收
有些人认为方法区(如 Hotspot虚拟机中的元空间或者永久代)是没有垃圾收集行为的,其实不然。
《Java虚拟机规范》对方法区的约束是非常宽松的,提到过可以不要求虚拟机在方法区中实现垃圾收集。事实上也确实有未实现或未能完整实现方法区类型卸载的收集器存在。
事实上也确实有未实现或未能完整实现方法区类型卸载的收集器存在(如JDK11时期的ZGC收集器就不支持类卸载)。
一般来说这个区域的回收效果比较难令人满意,尤其是类型的卸载,条件相当苛刻。但是这部分区域的回收有时又确实是必要的。以前Sun公司的Bug列表中,曾出现过的若干个严重的Bug就是由于低版本的 HotSpot虚拟机对此区域未完全回收而导致内存泄漏。
方法区的垃圾收集主要回收两部分内容:常量池中废弃的常量和不再使用的类型
先来说说方法区内常量池之中主要存放的两大类常量:字面量和符号引用
对于字面量和String和字符串常量池确实很容易混淆,可以查看https://www.zhihu.com/question/29884421加深记忆
- 字面量比较接近]ava语言层次的常量概念,如文本字符串、被声明为final的常量值等。
- 对于整数字面量来说,如果值在 -32768~32767 都会直接嵌入指令中,而不会保存在常量区。对于 long、double 都有一些类似的情况,比如long l = 1L、double d = 1.0,都找不到对应的常量项。
- 如果使用 final 修饰变量,将其定义成类常量(注意不是在方法体内定义的局部常量),可以在常量池中找到对应的CONSTANT_Integer
- 对于字符串的“字面量”,比如
String str = "Hello";中"Hello"就是字面量,而“Hello”本体还是和所有对象一样,创建在Heap堆区,而"Hello"的一个引用会被存到同样在Non Heap区的字符串常量池(String Pool)里。。也就是说,对字面量进行垃圾回收,实质上就是对堆中的对象进行垃圾回收,只不过可能不是局部变量表进行维护的而已
- 符号引用则属于编译原理方面的概念,包括下面三类常量
- 1、类和接口的全限定名
- 2、字段的名称和描述符
- 3、方法的名称和描述符
- Hotspot虚拟机对常量池的回收策略是很明确的,只要常量池中的常量没有被任何地方引用,就可以被回收。
- 判定一个常量是否“废弃”还是相对简单,而要判定一个类型是否属于“不再被使用的类”的条件就比较苛刻了。需要同时满足下面三个条件:
- 该类所有的实例都己经被回收,也就是Java堆中不存在该类及其任何派生子类的实例。
- 加载该类的类加载器己经被回收,这个条件除非是经过精心设计的可替换类加载器的场景,如OSGi、JSP的重加载等,否则通常是很难达成的
- 该类对应的java.lang.Class对象没有在任何地方被引用,无法在任何地方通过反射访问该类的方法。
- Java虚拟机被允许对满足上述三个条件的无用类进行回收,这里说的仅仅是“被允许”,而并不是和对象一样,没有引用了就必然会回收。关于是否要对类型进行回收Hotspot,虚拟机提供了
-Xnoclassgc参数进行控制,还可以使用-verbose:class以及XX:+ TraceClass-Loading、-XX:+TraceClassUnLoading查看类加载和卸载信息
在大量使用反射、动态代理、CGLib等字节码框架,动态生成JSP以及OSGi这类频繁自定义类加载器的场景中,通常都需要Java虚拟机具备类型卸载的能力,以保证不会对方法区造成过大的内存压力
面试题
- 说一下JVM内存模型吧,有哪些区?分别干什么的?
- Java8的内存分代改进
- JVM内存分哪几个区,每个区的作用是什么?
- JVM内存分布/内存结构?栈和堆的区别?堆的结构?为什么两个 survivor区?
- Eden和 Survior的比例分配
- JVM内存分区,为什么要有新生代和老年代
- 什么时候对象会进入老年代?
效果比较难令人满意,尤其是类型的卸载,条件相当苛刻。但是这部分区域的回收有时又确实是必要的**。以前Sun公司的Bug列表中,曾出现过的若干个严重的Bug就是由于低版本的 HotSpot虚拟机对此区域未完全回收而导致内存泄漏。
方法区的垃圾收集主要回收两部分内容:常量池中废弃的常量和不再使用的类型
先来说说方法区内常量池之中主要存放的两大类常量:字面量和符号引用
对于字面量和String和字符串常量池确实很容易混淆,可以查看https://www.zhihu.com/question/29884421加深记忆
- 字面量比较接近]ava语言层次的常量概念,如文本字符串、被声明为final的常量值等。
- 对于整数字面量来说,如果值在 -32768~32767 都会直接嵌入指令中,而不会保存在常量区。对于 long、double 都有一些类似的情况,比如long l = 1L、double d = 1.0,都找不到对应的常量项。
- 如果使用 final 修饰变量,将其定义成类常量(注意不是在方法体内定义的局部常量),可以在常量池中找到对应的CONSTANT_Integer
- 对于字符串的“字面量”,比如
String str = "Hello";中"Hello"就是字面量,而“Hello”本体还是和所有对象一样,创建在Heap堆区,而"Hello"的一个引用会被存到同样在Non Heap区的字符串常量池(String Pool)里。。也就是说,对字面量进行垃圾回收,实质上就是对堆中的对象进行垃圾回收,只不过可能不是局部变量表进行维护的而已
- 符号引用则属于编译原理方面的概念,包括下面三类常量
- 1、类和接口的全限定名
- 2、字段的名称和描述符
- 3、方法的名称和描述符
- Hotspot虚拟机对常量池的回收策略是很明确的,只要常量池中的常量没有被任何地方引用,就可以被回收。
- 判定一个常量是否“废弃”还是相对简单,而要判定一个类型是否属于“不再被使用的类”的条件就比较苛刻了。需要同时满足下面三个条件:
- 该类所有的实例都己经被回收,也就是Java堆中不存在该类及其任何派生子类的实例。
- 加载该类的类加载器己经被回收,这个条件除非是经过精心设计的可替换类加载器的场景,如OSGi、JSP的重加载等,否则通常是很难达成的
- 该类对应的java.lang.Class对象没有在任何地方被引用,无法在任何地方通过反射访问该类的方法。
- Java虚拟机被允许对满足上述三个条件的无用类进行回收,这里说的仅仅是“被允许”,而并不是和对象一样,没有引用了就必然会回收。关于是否要对类型进行回收Hotspot,虚拟机提供了
-Xnoclassgc参数进行控制,还可以使用-verbose:class以及XX:+ TraceClass-Loading、-XX:+TraceClassUnLoading查看类加载和卸载信息
在大量使用反射、动态代理、CGLib等字节码框架,动态生成JSP以及OSGi这类频繁自定义类加载器的场景中,通常都需要Java虚拟机具备类型卸载的能力,以保证不会对方法区造成过大的内存压力
面试题
- 说一下JVM内存模型吧,有哪些区?分别干什么的?
- Java8的内存分代改进
- JVM内存分哪几个区,每个区的作用是什么?
- JVM内存分布/内存结构?栈和堆的区别?堆的结构?为什么两个 survivor区?
- Eden和 Survior的比例分配
- JVM内存分区,为什么要有新生代和老年代
- 什么时候对象会进入老年代?
- jvm的永久代中会发生垃圾回收吗?

 1140


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


