pandas组队学习-Task6 缺失值处理

Python Pandas中的高级数据插值方法 插值法是一种通过已知数据点来推算未知数据点的数学方法。在数据分析中,插值法主要用于填补缺失值。与直接删除缺失值或使用简单的均值填充不同,插值法能够根据数据的趋势和特征推测出更加合理的缺失值。Pandas中提供了函数来实现多种插值方法,可以选择线性插值、多项式插值、样条插值等方式来处理缺失值。选择插值法处理缺失值的原因:数据完整性:插值法可以根据已有的数据推测出合理的缺失值,确保数据的连续性和完整性。减少数据丢失:与删除含缺失值的行或列不同,插值法可以保留尽可能多的数据。 阅读详情

目录

1. 学习内容

2. 准备工作

3. 发现缺失值并统计缺失值的情况

3.1 观察具体位置上是否出现缺失值

3.2 缺失值的统计

3.3 缺失值数据的筛选与过滤

3.3.1 找出某列缺失值所在的行数据

3.3.2 找出所有值都非缺失的行数据

3.4 缺失值符号介绍

3.4.1 旧体系的符号

3.4.2 新体系的数据类型和符号

3.5 convert_dtypes()方法

4. 缺失数据的运算与分组

4.1 运算

4.2 分组(groupby)

5. 缺失值的填充与删除

5.1 填充fillna()方法

5.1.1 值填充与前后向填充

5.1.2 用统计量进行填充

5.1.3 删除dropna()方法

6. 插值方法interpolate()

6.1 线性插值

6.1.1 与索引无关的线性插值(默认)

6.1.2 与索引有关的插值

6.1.3 与时序有关的插值

6.2 高级插值法(了解)

6.3 interpolate()中的限制参数

7. 问题与练习

7.1 问题

7.2 练习

1. 学习内容

1. 学习如何发现缺失值并统计缺失值的情况

2. 学习pandas中对缺失值的各种表示方式

3. 利用填充、删除和插值方法来处理缺失值

本项目参见https://github.com/datawhalechina/team-learning/tree/master/Pandas%E6%95%99%E7%A8%8B%EF%BC%88%E4%B8%8A%EF%BC%89

2. 准备工作

import pandas as pd
import numpy as np
df = pd.read_csv('data/table_missing.csv')
df.head()
  School Class      ID Gender   Address  Height  Weight  Math Physics
0    S_1   C_1     NaN      M  street_1     173     NaN  34.0      A+
1    S_1   C_1     NaN      F  street_2     192     NaN  32.5      B+
2    S_1   C_1  1103.0      M  street_2     186     NaN  87.2      B+
3    S_1   NaN     NaN      F  street_2     167    81.0  80.4     NaN
4    S_1   C_1  1105.0    NaN  street_4     159    64.0  84.8      A-

3. 发现缺失值并统计缺失值的情况

3.1 观察具体位置上是否出现缺失值

isna()和notna()将会统计表格每一列的缺失值情况。前者缺失值记为True,非缺失值记为False;后者恰好相反。

df['Physics'].isna().head()
0    False
1    False
2    False
3     True
4    False
Name: Physics, dtype: bool

3.2 缺失值的统计

由于布尔值True等于1,False等于0。因此可以在isna()和notna()后面再加上sum()方法来统计各个列的缺失值个数。

df.isna().sum()
School      0
Class       4
ID          6
Gender      7
Address     0
Height      0
Weight     13
Math        5
Physics     4
dtype: int64

或者还可以使用info()方法来进行统计。

df.info()
<class 'pandas.core.frame.DataFrame'>
RangeIndex: 35 entries, 0 to 34
Data columns (total 9 columns):
 #   Column   Non-Null Count  Dtype  
---  ------   --------------  -----  
 0   School   35 non-null     object 
 1   Class    31 non-null     object 
 2   ID       29 non-null     float64
 3   Gender   28 non-null     object 
 4   Address  35 non-null     object 
 5   Height   35 non-null     int64  
 6   Weight   22 non-null     float64
 7   Math     30 non-null     float64
 8   Physics  31 non-null     object 
dtypes: float64(3), int64(1), object(5)
memory usage: 2.6+ KB

3.3 缺失值数据的筛选与过滤

3.3.1 找出某列缺失值所在的行数据

df[df['Physics'].isna()]
   School Class      ID Gender   Address  Height  Weight  Math Physics
3     S_1   NaN     NaN      F  street_2     167    81.0  80.4     NaN
8     S_1   C_2  1204.0      F  street_5     162    63.0  33.8     NaN
13    S_1   C_3  1304.0    NaN  street_2     195    70.0  85.2     NaN
22    S_2   C_2  2203.0      M  street_4     155    91.0  73.8     NaN
df[df.loc[:, ['Weight', 'Math']].isna().all(1)]
   School Class      ID Gender   Address  Height  Weight  Math Physics
20    S_2   C_2  2201.0      M  street_5     193     NaN   NaN       B

3.3.2 找出所有值都非缺失的行数据

df[df.notna().all(1)]
   School Class      ID Gender   Address  Height  Weight  Math Physics
5     S_1   C_2  1201.0      M  street_5     159    68.0  97.0      A-
6     S_1   C_2  1202.0      F  street_4     176    94.0  63.5      B-
12    S_1   C_3  1303.0      M  street_7     188    82.0  49.7       B
17    S_2   C_1  2103.0      M  street_4     157    61.0  52.5      B-
21    S_2   C_2  2202.0      F  street_7     194    77.0  68.5      B+
25    S_2   C_3  2301.0      F  street_4     157    78.0  72.3      B+
27    S_2   C_3  2303.0      F  street_7     190    99.0  65.9       C
28    S_2   C_3  2304.0      F  street_6     164    81.0  95.5      A-
29    S_2   C_3  2305.0      M  street_4     187    73.0  48.9       B

3.4 缺失值符号介绍

3.4.1 旧体系的符号

在pandas 1.0版本之前,pandas中对于缺失值的表示有三种不同的方式。它们分别是:np.nan,None和pd.NaT。

np.nan是一种很特殊的空值,它不等于任何其他常见的空值(0,None),甚至也不等于它自己。对于表格而言,可以用equals()方法来判断两个表格是否相等。其中,在遇到同一位置的值均为np.nan时会自动忽略,从而避免对结果造成影响。np.nan虽然是空值,但是在numpy中,它是属于浮点类型的。因此,只要读入的数据集中某整数类型的列存在np.nan,则这一列数据会被强制转换为浮点型。另外,np.nan对应的布尔值为True。如果刚读入的数据中某列为布尔类型,且其中存在np.nan则np.nan会被记为True而非False。但是,如果数据在导入后某位置被修改为np.nan,则该位置会变成np.nan而非True。在所有的表格读取后,无论列是存放什么类型的数据,默认的缺失值全为np.nan类型。因此整型列转为浮点;而字符由于无法转化为浮点,因此只能归并为object类型('O'),原来是浮点型的则类型不变。

None等于自身且布尔值等于False。布尔类型值无论是导入时就是None还是之后被修改为None,都会将其自动变为False。数值型无论是导入时就是None还是之后被修改为None,都会将其自动变为np.nan。只有对象类型不会对None进行修改。equals()方法不会略过None。

pd.NaT是针对时间序列的缺失值,是Pandas的内置类型,可以完全看做时序版本的np.nan(因此一些性质与np.nan是一样的)。它与自己不等,而且使用equals是也会被跳过。datetime类型的数据在被修改为None后,会将其自动变为pd.NaT。

s_time = pd.Series([pd.Timestamp('20120101')] * 5)
s_time[2] = None
s_time[3] = np.nan
s_time
0   2012-01-01
1   2012-01-01
2          NaT
3          NaT
4   2012-01-01
dtype: datetime64[ns]
s = pd.Series([True,False],dtype='bool')
s[1] = pd.NaT
s
0    True
1    True
dtype: bool

这些缺失值符号都有自己独有的特点而且在一些情况下会彼此相互转化。这样就使很多数据分析工作变得混乱。

3.4.2 新体系的数据类型和符号

从pandas 1.0开始,诞生了一个新的数据类型Nullable和新的缺失值符号pd.NA。这么做的目的就是为了应对上述空值彼此存在的混乱情况。在新的数据类型体系中,数据若被修改为空值(np.nan,None和pd.NaT)都会被一律转换为pd.NA。

Nullable类型中又包含新的数据类型,它们是:整型(Int),布尔型(boolean)和字符串类型(string)。

其中,string类型是pandas 1.0的一大创新,目的之一就是为了区分开原本含糊不清的object类型。它本质上也属于Nullable类型,因为它不会因为含有缺失而改变类型。此外,和object类型的一点重要区别就在于,在调用字符方法后,string类型返回的是Nullable类型,而object则会根据缺失类型和数据类型而改变。

pd.NA具有以下性质:

首先,对于逻辑运算,如果运算结果依赖pd.NA的取值,则结果为pd.NA,否则的话可以视为pd.NA并没有参与运算。

print(True & pd.NA)
print(True | pd.NA)
print(False & pd.NA)
print(False | pd.NA)
<NA>
True
False
<NA>

另外,pd.NA是不能被强制转化为bool类型的,否则会报错。

最后,对于算数运算,除了以下两种情况,所有的算数运算(加减乘除,比较大小,指对数,幂运算)结果都是pd.NA。

print(pd.NA ** 0)
print(1 ** pd.NA)
1
1

3.5 convert_dtypes()方法

这个方法在读取数据时,会把数据列转为Nullable类型,是配合新体系诞生的方法。

pd.read_csv('data/table_missing.csv').dtypes
School      object
Class       object
ID         float64
Gender      object
Address     object
Height       int64
Weight     float64
Math       float64
Physics     object
dtype: object
pd.read_csv('data/table_missing.csv').convert_dtypes().dtypes
School      string
Class       string
ID           Int64
Gender      string
Address     string
Height       Int64
Weight       Int64
Math       float64
Physics     string
dtype: object

4. 缺失数据的运算与分组

4.1 运算

加法视为0,乘法视为1,累计计算则无视。

4.2 分组(groupby)

缺失值被自动忽略,不论该列是否为Nullable类型。

df_g = pd.DataFrame({'one':['A','B','C','D', np.nan], 'two':np.random.randn(5)})
df_g
   one       two
0    A -0.274225
1    B  0.682027
2    C  0.556510
3    D  0.993260
4  NaN  0.350107
df_g.groupby('one').groups
{'A': Int64Index([0], dtype='int64'),
 'B': Int64Index([1], dtype='int64'),
 'C': Int64Index([2], dtype='int64'),
 'D': Int64Index([3], dtype='int64')}

5. 缺失值的填充与删除

5.1 填充fillna()方法

5.1.1 值填充与前后向填充

fillna()如果传入某个值则会将所有空值替换为该值。fillna()还可以调整method参数变为前向覆盖填充和后向覆盖填充。另外,前向填充和后向填充也有专门的方法ffill()和bfill()。

df['Physics'].fillna('missing', inplace = False).head()
0         A+
1         B+
2         B+
3    missing
4         A-
Name: Physics, dtype: object
df['Physics'].fillna(method = 'ffill', inplace = False).head()
0    A+
1    B+
2    B+
3    B+
4    A-
Name: Physics, dtype: object
df['Physics'].fillna(method = 'bfill', inplace = False).head()
0    A+
1    B+
2    B+
3    A-
4    A-
Name: Physics, dtype: object
df['Physics'].ffill(inplace = False).head()
0    A+
1    B+
2    B+
3    B+
4    A-
Name: Physics, dtype: object
df['Physics'].bfill(inplace = False).head()
0    A+
1    B+
2    B+
3    A-
4    A-
Name: Physics, dtype: object

5.1.2 用统计量进行填充

df_f = pd.DataFrame({'A':[1, 3, np.nan], 'B':[2, 4, np.nan], 'C':[3, 5, np.nan]})
df_f.fillna(df_f.mean(), inplace = False)
     A    B    C
0  1.0  2.0  3.0
1  3.0  4.0  5.0
2  2.0  3.0  4.0
df_f.fillna(df_f.mean()[['A', 'B']], inplace = False)
     A    B    C
0  1.0  2.0  3.0
1  3.0  4.0  5.0
2  2.0  3.0  NaN

5.1.3 删除dropna()方法

df_d = pd.DataFrame({'A':[np.nan, np.nan, np.nan], 'B':[np.nan, 3, 2], 'C':[3, 2, 1]})
df_d
    A    B  C
0 NaN  NaN  3
1 NaN  3.0  2
2 NaN  2.0  1

dropna()方法有3个常用的参数:axis(控制删除行还是列),how(指定逻辑使用all还是any)和subset(指定删除范围)。

df_d.dropna(axis = 0)
Empty DataFrame
Columns: [A, B, C]
Index: []
df_d.dropna(axis = 1)
   C
0  3
1  2
2  1
df_d.dropna(axis = 1, how = 'all')
     B  C
0  NaN  3
1  3.0  2
2  2.0  1
df_d.dropna(axis = 0, subset = ['B', 'C'])
    A    B  C
1 NaN  3.0  2
2 NaN  2.0  1

6. 插值方法interpolate()

6.1 线性插值

6.1.1 与索引无关的线性插值(默认)

s = pd.Series([1, 10, 15, -5, -2, np.nan, np.nan, 28])
s
0     1.0
1    10.0
2    15.0
3    -5.0
4    -2.0
5     NaN
6     NaN
7    28.0
dtype: float64
s.interpolate()
0     1.0
1    10.0
2    15.0
3    -5.0
4    -2.0
5     8.0
6    18.0
7    28.0
dtype: float64

6.1.2 与索引有关的插值

s = pd.Series([1, 10, 15, -5, -2, np.nan, np.nan, 28])
s.index = np.sort(np.random.randint(50, 300, 8))
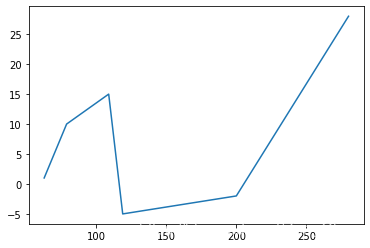
s.interpolate(method = 'index').plot()
6.1.3 与时序有关的插值

s_t = pd.Series([0, np.nan, 10], 
                index = [pd.Timestamp('2012-05-01'), 
                         pd.Timestamp('2012-05-07'), 
                         pd.Timestamp('2012-06-03')])
s_t
2012-05-01     0.0
2012-05-07     NaN
2012-06-03    10.0
dtype: float64
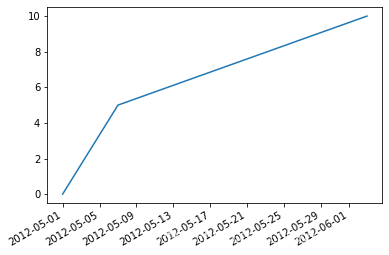
s_t.interpolate().plot()


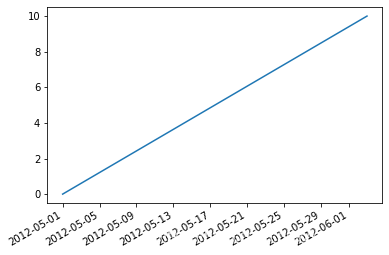
s_t.interpolate(method = 'time').plot()
6.2 高级插值法(了解)

ser = pd.Series(np.arange(1, 10.1, .25) ** 2 + np.random.randn(37))
missing = np.array([4, 13, 14, 15, 16, 17, 18, 20, 29])
ser[missing] = np.nan
methods = ['linear', 'quadratic', 'cubic']
df = pd.DataFrame({m: ser.interpolate(method = m) for m in methods})
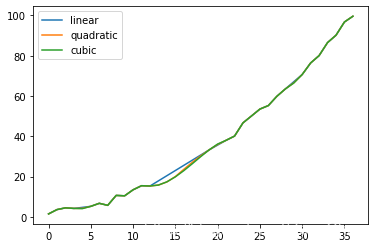
df.plot()
6.3 interpolate()中的限制参数

常用的限制参数有:limit参数(指定插入几个值), limit_direction参数(指定插值方向)和 limit_area参数(限制插值区域)。limit_direction可以选为forward,backward和both,默认为前向。limit_area可选为inside和outside,默认为None。

7. 问题与练习

7.1 问题

【问题一】 如何删除缺失值占比超过25%的列?

在统计缺失值个数的时候将sum()中传入参数axis=0。然后再将结果除以表格长度就能得到每列缺失值占比。将满足条件的列删除即可。
【问题二】 什么是Nullable类型?请谈谈为什么要引入这个设计?

Nullable类型是为了应对旧体系的缺失值在使用时存在的混乱情况而诞生的类型。这样在将某些值修改为缺失值后就会防止将整个列进行强制类型转换。
【问题三】 对于一份有缺失值的数据,可以采取哪些策略或方法深化对它的了解?

统计缺失值比例以及分布情况,必要时还需要作图。

7.2 练习

略。

数据挖掘算法原理与实践:数据预处理(第一关-第五关) 第1关:标准化 # -*- coding: utf-8 -*- from sklearn.preprocessing import scale,MaxAbsScaler,MinMaxScaler #实现数据预处理方法 def Preprocessing(x,y): ''' x(ndarray):处理 数据 y(str):y等于'z_score'使用z_score方法 y等于'minmax'使用MinMaxScaler方法 y等于'max 阅读详情

相关推荐

Task 2 组队学习之数据清洗及特征处理

第二章:数据清洗及特征处理 我们拿到的数据通常是不干净的,所谓的不干净,就是数据中有缺失值,有一些异常点等,需要经过一定的处理才能继续做后面的分析或建模,所以拿到数据的第一步是进行数据清洗,本章我们将学习缺失值、重复值、字符串和数据转换等操作,将数据清洗成可以分析或建模的亚子 2.1 缺失值观察与处理 我们拿到的数据经常会有很多缺失值,比如我们可以看到Cabin列存在NaN,那其他列还有没有缺失值,这些缺失值要怎么处理呢 2.1.1 任务一:缺失值观察 请查看每个特征缺失值个数 方法一: Train_d

秃头菜鸟的博客 454

scipy之数据插值详解

有时候我们需要通过几个离散点的数据和标签,来预测其他没有数据值的离散点,这时候我们可以使用插值算法来实现,这篇文章主要介绍了数据的插值算法有哪些,并且通过scipy库详细的介绍了,如何来使用它实现数据插值

修炼之路 5727

SPSS_Process—简单&平行&链式中介模型

本篇文章介绍采用SPSS的插件Process对简单中介、链式中介、平行中介模型进行检验的操作方法及结果解读。

m0_54401011的博客 4万+

专业进阶:Python 中 Scipy 的稀疏矩阵与高级插值

在前几篇文章中,我们已经深入了解了Scipy库的基础功能和在数值计算、优化、信号处理等领域的应用。本文将进一步探讨Scipy库中的高级功能,专注于稀疏矩阵处理和高级插值技术。这些功能在实际数据分析中具有广泛的应用,能够处理大规模、高维度的数据集,并在空间数据插值等场景中发挥重要作用。

theskylife的博客 1973

信创迁移实战:在银河麒麟V10-SP1上为Milvus离线部署Docker(附SP1专属避坑指南)

本文详细介绍了在银河麒麟V10-SP1 x86_64环境下离线部署Docker的全流程,特别针对该版本特有的自定义目录安装失败问题提供深度分析和解决方案。通过实战验证的步骤和避坑指南,帮助用户在信创项目中顺利完成Milvus等应用的容器化部署。

weixin_30687051的博客 531

深入解析MATLAB四旋翼仿真案例asbQuadcopter的核心模块与优化技巧

本文深入解析了MATLAB/Simulink中的四旋翼无人机官方案例asbQuadcopter,详细拆解了其指令、传感器、控制器、本体与环境等核心模块的工作原理。重点探讨了经典的PID双环控制结构、传感器噪声模拟、模型替换方法以及系统化的PID参数调优技巧,旨在帮助用户从“开箱即用”过渡到深度定制与优化,构建更精准的仿真模型。

weixin_29171087的博客 359

高阶插值——三次插值及实现

转自:https://blog.youkuaiyun.com/messi_cyc/article/details/78096649双三次插值接着双线性插值,此次为双三次插值(Bi-cubic interpolation),前面我们知道双线性插值是周边的四个点进行计算,这次双三次是通过计算周边的16个点进行插值的。Bicubicinterpolation solves for the value at a ne...

wp1351553202的博客 5062

SAP-PM设备模块-PM主数据之维护策略

预防性维护的一种计划方式,需要先建立维护策略什么情况下需要创建维护策略?

TRUIXIANG的博客 2569

DataWhale组队学习pandas task02

Datawhale pandas组队学习 task02(下:练习)

weixin_40876195的博客 1044

TCN(Temporal Convolutional Networks)时序卷积网络详解及代码

TCN(Temporal Convolutional Networks)时序卷积网络详解及代码

zhulewen的博客 7883

SAP GUI 字段遮罩功能详解及实现

默认情况下,系统使用作为掩码模式,遮罩整个字段内容长度;对于货币金额类型,掩码后会保留小数位并在整数位部分全部显示为,如****.**若需自定义掩码模式,可利用以下方式:维护“Maintain Masking Pattern”节点,在其中定义新的掩码方式(如:只露出后四位,其他位以X替代等);实现 BAdI(或类似命名,具体以系统版本为准)的方法,通过 ABAP 代码读取原始值,并依据业务逻辑生成掩码字符串返回,动态替换界面输出值;

2007 年 ~ 2025 年,深耕 SAP 技术 18 年 706

pandas组队学习-task07

import numpy as np import pandas as pd path = r'C:\Users\yongx\Desktop\data' 缺失值的统计和删除 缺失数据的统计 通过使用isna和isnull来查看每个单元格是否有缺失,同时结合mean函数求得每列缺失值的比例. 针对某列或某行统计缺失值时使用Series上的isna或notna而进行布尔索引 同时对若干个列检索全部缺失或存在缺失的行时通过使用isna,notna和all,any函数的组合实现对应功能 df = pd.re

qq_41834327的博客 329

信捷PLC XD5系列运动控制(10轴)编程应用篇

项目PLC采用XD5-60T10-E,36DI 24DO 晶体管输出,支持10路脉冲输出功能。TMR指令定时器时基可以自己设定,这点比其他品牌PLC方便。ZRN指令我们需要上升沿指令触发。 5、变址寻址 该说不说这个变址寻址是真的强,比西门子指针、三菱的变址寄存器Z 、V都要更加灵活。 7、特殊寄存器:时钟 8、如何建立PLC通讯...............

RXXW_Dor的博客 1万+

Datawhale--组队学习第12期--pandas基础学习---Task06缺失值处理

第6章 缺失数据 在接下来的两章中,会接触到数据预处理中比较麻烦的类型,即缺失数据和文本数据(尤其是混杂型文本) Pandas在步入1.0后,对数据类型也做出了新的尝试,尤其是Nullable类型和String类型,了解这些可能在未来成为主流的新特性是必要的 import pandas as pd import numpy as np df = pd.read_csv('data/table_mi...

weixin_44064434的博客 715

uniapp - [微信小程序 | 安卓苹果app] 详细实现接入天地图完整流程,提供显示地图、IP 属地定位 / 用户定位的城市名称、用户定位的经纬度超多功能(复制运行示例代码,详细注释及常见问题)

uni-app,微信小程序,安卓app,苹果app,App端,支付宝小程序,nvue,天地图,国家天地图api,接入使用天地图,uniApp小程序端接入天地图,uniapp安卓苹果app端接入天地图,微信小程序平台如何引入天地图,天地图Api使用教程,如何在uniapp里集成天地图,使用天地图获取当前定位,天地图api教程,天地图官方文档,天地图详细使用教程,Uniapp项目如何使用天地图,项目引入天地图配置及使用教程,使用天地图获取用户定位,天地图获取用户当前位置信息(经纬度),如何通过天地图拿到用户定位

🏆 前端领域优质创作者 1万+

怀旧版电脑GBC模拟器

再现原版GBC掌机的界面,电脑运行连游戏界面都一样大小,很怀旧,很真实,(英文版)强烈推荐,很小的文件,很难才找到的。

pandas组队学习-Task2 pandas的各种索引操作

1.学习内容 1.了解pandas支持的各种索引操作 2.了解pandas对索引的设置 3.了解pandas的索引函数 4.利用pandas的索引操作对数据进行处理和抽样 本项目参见https://github.com/datawhalechina/team-learning/tree/master/Pandas%E6%95%99%E7%A8%8B%EF%BC%88%E4%B8...

Zee_Chao的博客 1978

C# WinForm 基于DirectShow.dll编写的程序,可边预览边保存视频,音频和图片

基于微软的DirectShow.dll的二次开发1.自动识别连接的摄像头跟麦克风且可以对其进行选择(默认选中第一个)2.可录制wmv和avi两种格式的视频并且都带有音频,avi可以录制的分辨率和帧数进行选择,wmv默认进行了淸晰度优化如不喜欢可去除代码中有相关提示3.可在预览点开之后进行拍照,也可边录制视频边拍照4.添加了视频和音频的压缩功能(酌情使用)这次二次开发发现C#对DirectShow的相关信息太少,这次做完也不敢藏私共享出来,还望大家指正

pandas组队学习-Task1 pandas的基本操作

1.学习内容 1.了解如何用pandas保存和读取不同文件类型的数据 2.了解如何使用pandas的两个基本数据结构及其操作 本项目参见https://github.com/datawhalechina/team-learning/tree/master/Pandas%E6%95%99%E7%A8%8B%EF%BC%88%E4%B8%8A%EF%BC%89 2.准备工作 首先,需...

Zee_Chao的博客 1410

OV9734 DATASHEET,完整规格书

OV9734完整规格书,包括电气参数,尺寸规格,寄存器配置表等

TMS_WebGMaps_1.9.8.0_Full_Source

TMS_WebGMaps_1.9.8.0_Full_Source 全源码 delphi cbuilder

pandas组队学习-Task7 文本数据(string类型)处理

1.学习内容 1.了解string类型与object类型的区别 2.学会string类型的各种处理方式 本项目参见https://github.com/datawhalechina/team-learning/tree/master/Pandas%E6%95%99%E7%A8%8B%EF%BC%88%E4%B8%8A%EF%BC%89 2.准备工作 import pandas as pd import numpy as np 3.string类型的性质与转换 3.1string类...

Zee_Chao的博客 533

Datawhale组队学习(Pandas) task7-缺失数据

缺失值的统计和删除 缺失信息的统计 # 查看每个单元格是否有缺失 isna()或isnull() df = pd.read_csv('data/learn_pandas.csv',usecols=['Grade', 'Name', 'Gender', 'Height','Weight', 'Transfer']) df.isna().head() Grade Name Gender Height Weight

mintminty的博客 303

Datawhale组队学习(Pandas) task2-pandas基础

写在前面 看了很多小伙伴task1的笔记,感觉很棒的同时也深受启发,学习过程不仅仅是教材等资料的理解和重复,更应该是自己的思考、串联、发问、尝试,这样才能学得深刻~ 但因为前者更容易,所以自己常常陷入那种效率不太高的努力陷阱中。那以后的打卡笔记就不做一个搬运工+补充工了,多记录自己的思考和尝试。 import numpy as np import pandas as pd pd.__version__ '1.1.5' 1. 文件读取和写入 1.1 文件读取 1.1.1 读取my_csv, my_tab

mintminty的博客 554

pandas组队学习task06

import numpy as np import pandas as pd 关系型连接 连接的基本概念 把两张相关的表按照某一个或某一组键连接起来即为连接表,关系型连接中,键常用on表示并且十分重要.同时连接的形式也十分重要,pandas中关系型连接函数有merge和join,其中提供how参数代表连接形式, 左连接left:以左边的键为准,若右边键在左边存在则添加到左边,否则处理为缺失值. 右连接right:类似于左连接 内连接inner:只合并左右表同时出现的键. 外连接outer:在内连接的基

qq_41834327的博客 215

datawhale6月组队学习-task01

datawhale6月组队学习-task01 1.数据加载 利用kaggle网站的泰坦尼克号数据集进行学习分析 下载网址: https://www.kaggle.com/c/titanic/overview # 导入相关库 import numpy as np import pandas as pd import os 1.1 加载数据 (1) 使用相对路径载入数据 # 相对路径载入 os.getcwd() #查看当前工作目录,将数据集复制到这里 train_data = pd.read_csv('tr

qq_42537973的博客 169

Pandas基础学习 Task01:Pandas基础(知识梳理脑图+全部资源教程)

Pandas基础学习 现在学习喜欢用脑图的方式,知识点清晰明了,易于查找和复习,希望也可以帮助大家梳理知识脉络。

RexT1的博客 703

Pandas基础学习(下) Task01:缺失数据(知识梳理脑图+全部资源教程)

之前跟随Pandas(上)学习,收获良多,这次开了下的组队学习,迫不及待的加入了。Datawhale是一个很好的开源组织,会组织很多免费的知识学习。 附上本次组队学习的计划和教程资料,即使没有当时加入组队学习,有兴趣的话从现在开始学习也不晚哦~ 现在学习喜欢用脑图的方式,知识点清晰明了,易于查找和复习,希望也可以帮助大家梳理知识脉络。

RexT1的博客 514

Datawhale组队学习(Pandas) task6-连接

第六章 连接 目录1. 关系型连接1.1 连接基本概念1.2 值连接1.3 索引连接2. 方向连接2.1 concat2.2 序列与表的合并3. 类连接操作3.1 比较3.2 组合Ex1:美国疫情数据集Ex2:实现join函数 1. 关系型连接 1.1 连接基本概念 将两张相关的表按照某一个或某一组键连接起来,关键要素是键和连接形式,其中连接形式包含: 左连接 left:以左边的键为准,若右表中的键 出现于左表,则将改键添加到左表。否则处理为缺失值。 右连接 right:类似处理 内连接 inner:.

mintminty的博客 317

pandas组队学习-Task3 分组方法groupby()和它的小伙伴们

目录 1.学习内容 2.什么是SAC过程 3.准备工作 4.groupby()方法 4.1一般用法 4.1.1按某一列分组 4.1.2按多列分组 4.1.3查看每一组的容量和分成的组数 4.1.4遍历每一组 4.1.5level参数和axis参数 4.2groupby对象的特点 4.2.1可用的方法 4.2.2head()方法和firtst()方...

Zee_Chao的博客 1370
上一篇: 第十周:支持向量机(SVM)
下一篇: CS224N(NLP)组队学习-L1 Introduction and Word Vectors
Zee_Chao
博客等级 码龄11年 168粉丝 135原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值