


从 ChatGPT、DeepSeek 到 Qwen(通义千问)、GLM(智谱)、Claude…… 大模型(LLM)早已突破“聊天工具”的局限,成为 AI 领域的核心引擎,更是技术人提升竞争力的关键抓手。
无论你是算法、后端、前端还是全栈工程师,哪怕是零基础小白,掌握大模型开发与应用,都能在未来的技术浪潮中抢占先机。但面对网上碎片化的知识、繁杂的框架和晦涩的论文,很多人都会陷入迷茫:
“我零基础,能学会大模型吗?”“该从哪里开始学?先啃原理还是直接上手做项目?”“学完能落地吗?有没有清晰的路径可遵循?”
别急!这篇文章专为小白和程序员打造,整理了从入门到实战的12个月完整学习路线,每个阶段都有明确目标、核心重点和可落地的项目,帮你避开弯路,稳步成长,看完建议收藏备用~

🧭 总体学习框架(小白友好版)
整个学习路线分为4个阶段,循序渐进、由浅入深,从基础铺垫到工程实战,拒绝“空中楼阁”,确保每一个阶段都能“看得见成长、做得出项目”,哪怕是零基础小白,也能跟着节奏稳步推进。
| 阶段 | 时间 | 核心目标 | 核心学习主题 |
|---|---|---|---|
| 🌱 基础夯实期 | 0–2个月 | 告别小白,搭建大模型学习基础 | Python、数学基础、深度学习、Transformer核心 |
| ⚙️ 框架掌握期 | 3–5个月 | 从“会用”到“懂原理”,掌握主流工具 | Prompt工程、LangChain、RAG、Agent |
| 🔧 实战进阶期 | 6–9个月 | 动手微调模型,实现工程化部署 | LoRA微调、模型优化、部署、向量数据库 |
| 🧩 高阶突破期 | 9–12个月 | 突破单一模态,实现系统化落地 | 多模态模型、RLHF、云端部署与工程化 |
------
🌱 阶段1:基础夯实期(0–2个月)—— 小白入门关键期
很多小白一上来就想“直接上手调模型”,结果越学越懵——没有数学和编程基础,后续的框架、微调、部署都会变成“黑箱”,学完也只会“复制粘贴代码”,无法真正理解原理。这一阶段的核心的是“打牢地基”,不用追求速度,重点在于“吃透基础”。
🎯 核心学习重点(小白可直接照学)
- 数学三件套(不用啃透,够用就好):线性代数(重点掌握矩阵运算、求导,是理解神经网络的核心)、概率统计(分布、似然函数,看懂模型训练逻辑),不用死记硬背公式,重点理解“怎么用”。
- Python数据与AI工具链(必学):NumPy(数组运算)、Pandas(数据处理)、Matplotlib(可视化),这三个是AI学习的“基本功”,建议结合小案例练习,比如用Pandas处理简单数据集。
- 深度学习基础:搞懂神经网络的基本结构、反向传播、梯度下降的核心逻辑,知道“模型是怎么学习的”,不用深入推导公式,重点理解原理。
- Transformer核心机制(重中之重):这是所有大模型的“底层架构”,重点掌握自注意力、多头注意力、位置编码,建议结合可视化教程学习,比如“The Illustrated Transformer”,比啃论文更易理解。
💡 小白友好型实践任务(必做,避免眼高手低)
- 用 PyTorch 复现一个简单的 Transformer(不用追求复杂,能跑通即可,重点理解结构);
- 训练一个 MNIST 图像分类模型(入门级深度学习项目,能快速建立信心,熟悉模型训练流程)。
📘 推荐资源卡(小白避坑首选)
- 入门书籍:《深度学习》(Ian Goodfellow,俗称“花书”,基础薄弱可先看前3章);
- 视频课程:吴恩达《Deep Learning Specialization》(B站有中文翻译,通俗易懂,小白必看);
- 可视化资源:The Illustrated Transformer(图文结合,轻松理解Transformer原理);
- 补充:优快云站内“Python AI入门”系列文章(贴合国内小白学习习惯,可搭配练习)。
💡 小提示:这一阶段不用追求“快”,每天花1-2小时,2个月足够打牢基础,避免后续返工。
------
⚙️ 阶段2:框架掌握期(3–5个月)—— 从“会用”到“懂原理”
基础打牢后,就可以进入“实战入门”阶段了。这一阶段的核心是“学以致用”,掌握大模型的核心原理和主流框架,不再是“只会看”,而是能“动手用”,甚至能理解“为什么这么用”,为后续的微调、部署打下基础。
🎯 核心学习重点
1️⃣ 大模型核心原理(不用啃论文,抓重点)
- 解析主流架构:Transformer、GPT、BERT、MoE的核心区别,知道“不同模型适合做什么”(比如GPT适合生成,BERT适合理解);
- 搞懂预训练与微调的区别:预训练是“让模型学会通用知识”,微调是“让模型适配具体任务”;
- 区分生成式与判别式模型:简单来说,生成式模型能“创造内容”(比如ChatGPT),判别式模型能“判断内容”(比如垃圾邮件识别)。
2️⃣ Prompt 工程(小白也能快速上手,性价比最高)
Prompt工程是“不用调模型,也能提升大模型效果”的核心技巧,也是程序员快速落地大模型应用的关键,重点掌握这4点:
- Prompt四要素:角色、目标、方案、输出格式(比如“你是一名Python工程师,帮我写一段读取Excel的代码,要求简洁高效,输出格式为Python代码块”);
- 核心技巧:Zero-shot(零样本)、Few-shot(少样本)、Chain-of-Thought(思维链,适合复杂问题,比如数学计算、逻辑推理);
- 进阶技巧:Prompt自调优、结构化Prompt、约束性Prompt(避免模型输出杂乱)。
3️⃣ LangChain 框架(大模型应用开发必备)
LangChain是目前最主流的大模型应用开发框架,能帮我们快速整合大模型、数据库、工具,不用从零开发,重点掌握:
- 核心组件:Chains(链条,串联多个任务)、Memory(记忆,实现多轮对话)、Agents(智能体,让模型自主调用工具)、Function Calling(函数调用,连接外部工具);
- 实战场景:问答系统、文档摘要、SQL生成(比如用LangChain连接数据库,通过自然语言生成SQL查询语句)。
4️⃣ RAG 技术(检索增强生成,落地必备)
RAG是解决大模型“知识滞后”“胡言乱语”的关键技术,也是企业级大模型应用的核心,重点掌握:
- 核心流程:数据提取 → 向量化 → 检索 → 生成(简单来说,就是让模型先“查资料”,再“回答问题”);
- 常用工具:Chroma(轻量易用,适合小白)、Milvus(企业级,支持大规模数据)、FAISS(Facebook开源,速度快);
- 应用场景:企业知识库问答、信息检索增强(比如搭建一个公司内部的知识库助手,让员工快速查询规章制度)。
📘 推荐资源卡
- LangChain 官方文档(中文版本,小白易读,重点看“快速入门”和“核心组件”);
- OpenAI Cookbook(包含大量Prompt工程、LangChain实战案例,可直接复制代码练习);
- HuggingFace Transformers(大模型开发必备库,官方教程通俗易懂,可搭配Colab练习);
- 补充:优快云站内“LangChain实战”系列教程(结合国内场景,比如搭建中文知识库)。
🧪 实战项目(必做,提升动手能力)
- 🔹 用 LangChain + Chroma 构建中文知识库问答系统(比如搭建一个“个人笔记问答助手”,能查询自己的笔记内容);
- 🔹 设计一个多轮对话 Agent(比如“Python助手”,能回答Python编程问题、生成代码、调试代码)。
💡 小提示:这一阶段可以多逛优快云、GitHub,借鉴别人的实战项目,先“复制粘贴”理解逻辑,再修改成自己的项目,快速提升动手能力。
------
🔧 阶段3:实战进阶期(6–9个月)—— 动手“造”自己的模型
经过前两个阶段的学习,你已经掌握了基础和框架,接下来就进入“高阶实战”阶段——微调自己的模型,实现工程化部署,真正从“使用者”变成“开发者”。这一阶段的核心是“动手实践”,重点突破“微调”和“部署”两个难点。
🎯 核心学习重点
🔹 微调技术(核心重点,落地关键)
微调是让通用大模型(比如Qwen2、Llama3)适配具体场景的关键,小白不用追求“全量微调”(算力要求高),重点掌握轻量化微调:
- 轻量化微调方法:LoRA、QLoRA、Prefix Tuning、P-Tuning(其中LoRA最常用,算力要求低,小白易上手);
- 微调流程:数据准备与增强(重点是“高质量数据”,数据决定微调效果)、超参数设置(不用死记,多试几次就能找到规律)、评估与验证(判断微调后的模型效果);
- 常用框架:HuggingFace(小白首选,工具齐全)、LLaMA-Factory(专门用于Llama系列模型微调,操作简单)、DeepSpeed(适合大规模微调,提升速度)。
🔹 模型优化与部署
微调后的模型,需要优化性能、实现部署,才能真正落地使用,重点掌握:
- 模型优化:分布式训练(数据并行、模型并行,解决算力不足问题)、混合精度训练(FP16 / FP32,提升训练速度,减少显存占用)、模型压缩与蒸馏(减小模型体积,提升推理速度);
- 部署相关:Docker(容器化部署,避免环境冲突,小白必学)、Ollama(轻量部署工具,能快速部署本地大模型)、Dify(低代码部署平台,不用写复杂代码,快速搭建AI助手)。
🔹 工程化工具(程序员必备)
- Docker:掌握基本命令,能打包模型和环境,实现“一次构建,到处运行”;
- API接口开发:FastAPI(轻量高效,适合开发模型API)、Gradio(快速搭建可视化界面,方便展示模型效果)。
📘 推荐资源卡
- HuggingFace 官方课程(重点看“微调”和“部署”模块,有详细的代码案例);
- DeepSpeed 文档(重点学习混合精度训练和分布式训练,解决算力问题);
- LLaMA Factory GitHub(star数量多,教程详细,小白可直接跟着练);
- 补充:优快云站内“大模型微调实战”“Docker部署大模型”系列文章(贴合国内开发者需求)。
🧪 实战项目(落地性强,可放简历)
- 微调 Qwen2 / Llama3 模型(用LoRA方法,结合自己的数据集,比如微调一个“行业问答模型”);
- 构建并部署一个 AI 助手(基于 Dify 或 FastAPI + Gradio,实现可视化界面,能正常调用微调后的模型)。
💡 小提示:这一阶段可以尝试将自己的项目上传到GitHub,记录开发过程,既能复盘总结,也能为简历加分,吸引企业关注。
------
🧩 阶段4:高阶突破期(9–12个月)—— 多模态与系统化落地
单一的文本大模型已经无法满足实际需求,多模态(图文、音视频)才是大模型的未来趋势。这一阶段的核心是“突破单一模态”,掌握多模态模型的原理和应用,实现大模型的系统化、工程化落地,成为真正的大模型开发者。
🎯 核心学习重点
🔹 多模态模型(重点)
- 主流多模态模型:CLIP(图文匹配,基础模型)、BLIP(图文生成)、LLaVA(视觉问答,能看图回答问题)、Stable Diffusion(文生图,热门应用);
- 核心原理:搞懂“不同模态(文本、图像)如何统一表示”,不用深入推导公式,重点理解“模型如何实现图文联动”。
🔹 跨模态任务
- 常见任务:图文匹配(判断图片和文本是否匹配)、视觉问答(VQA,看图回答问题)、文生图/图生文(比如输入“一只可爱的猫咪”,生成对应的图片);
- 实战重点:学会调用多模态模型的API,结合LangChain等框架,搭建多模态应用。
🔹 强化学习与模型优化
- RLHF(基于人类反馈的强化学习):让模型输出更符合人类需求,重点理解核心流程,不用深入实现;
- 进阶优化:蒸馏、剪枝、量化(进一步提升模型速度,减小体积,适配不同部署场景)。
🔹 云端部署与系统化
企业级应用需要系统化部署,重点掌握:
- 容器化与编排:Docker + K8S(实现模型的规模化部署、负载均衡);
- 云平台部署:AWS、阿里云、腾讯云(利用云服务器部署模型,解决本地算力不足问题);
- 系统化设计:学会搭建完整的大模型应用架构(数据层、模型层、接口层、前端层)。
📘 推荐资源卡
- OpenAI 技术博客(重点看多模态相关文章,了解前沿趋势);
- 《Diffusion Models Explained》(通俗易懂,理解文生图模型原理);
- LLaVA GitHub(多模态模型实战案例,可直接复现);
- 补充:云平台官方文档(阿里云、腾讯云,有详细的大模型部署教程)。
🧪 实战项目(高阶,提升竞争力)
- 复现 BLIP 图生文模型(结合自己的数据集,生成符合需求的图文内容);
- 构建多模态 AI 助手(结合视觉和文本,比如“看图识物+问答”,能识别图片内容并回答相关问题)。
------
🧱 小白/程序员专属执行与成长建议(避坑关键)
很多人学大模型半途而废,不是因为难,而是因为没有科学的学习方法。结合优快云众多开发者的经验,整理了5条实用建议,帮你坚持下去:
- 以输出为导向,拒绝“无效学习”:每学完一个模块,一定要做一个小项目(哪怕是简单的Demo),比如学完Prompt工程,就写10个高质量Prompt;学完LangChain,就搭建一个简单的问答系统。输出是检验学习效果的最好方式。
- 记录与复盘,形成自己的知识体系:将每天的学习笔记、代码、项目心得同步到GitHub、Notion或优快云博客,每周复盘一次,总结不足,避免“学了就忘”。
- 构建学习闭环,高效提升:遵循“阅读论文/教程 → 复现代码 → 写总结 → 分享”的闭环,比如看完一篇Transformer相关的文章,复现代码,写一篇总结发布到优快云,既能加深理解,也能和其他开发者交流。
- 参与社区,借力成长:加入LangChain中文群、HuggingFace论坛、优快云 AI圈,遇到问题及时提问,借鉴别人的学习经验和项目思路,避免闭门造车。很多时候,别人的一句提示,就能帮你避开很多弯路。
- 关注前沿趋势,保持学习热情:大模型技术更新很快,持续关注DeepSeek、Qwen(通义千问)、智谱、Anthropic等厂商的更新,了解最新的模型和技术,避免学“过时”的内容。
------
💬 写在最后(致小白和程序员)
学习大模型,从来都不是“一蹴而就”的事情,也不需要“天赋异禀”——哪怕你是零基础小白,哪怕你是非算法背景的程序员,只要跟着这份路线,循序渐进、脚踏实地,每天坚持学习,12个月就能从“小白”成长为能独立开发、部署大模型应用的开发者。
记住:学习大模型,不只是“看懂论文、记住知识点”,更重要的是“亲手造出能跑的模型、能落地的应用”。
愿这份收藏级学习路线,能成为你通往AI世界的清晰地图,帮助你在大模型的浪潮中,抓住机遇、实现成长,成为更具竞争力的技术人!
最后
对于正在迷茫择业、想转行提升,或是刚入门的程序员、编程小白来说,有一个问题几乎人人都在问:未来10年,什么领域的职业发展潜力最大?
答案只有一个:人工智能(尤其是大模型方向)
当下,人工智能行业正处于爆发式增长期,其中大模型相关岗位更是供不应求,薪资待遇直接拉满——字节跳动作为AI领域的头部玩家,给硕士毕业的优质AI人才(含大模型相关方向)开出的月基础工资高达5万—6万元;即便是非“人才计划”的普通应聘者,月基础工资也能稳定在4万元左右。
再看阿里、腾讯两大互联网大厂,非“人才计划”的AI相关岗位应聘者,月基础工资也约有3万元,远超其他行业同资历岗位的薪资水平,对于程序员、小白来说,无疑是绝佳的转型和提升赛道。
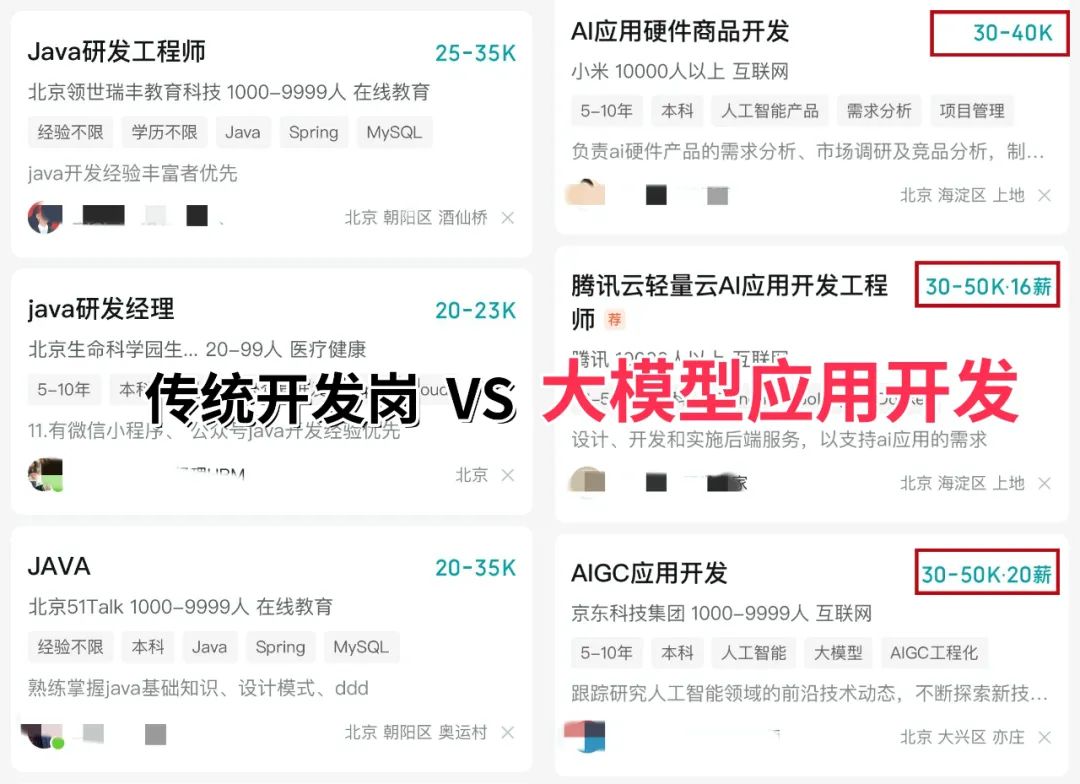
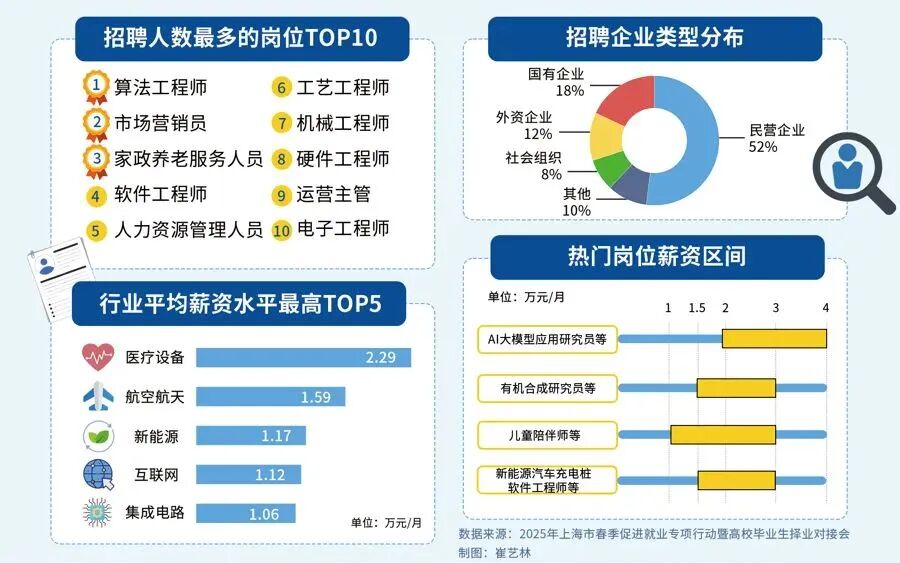
对于想入局大模型、抢占未来10年行业红利的程序员和小白来说,现在正是最好的学习时机:行业缺口大、大厂需求旺、薪资天花板高,只要找准学习方向,稳步提升技能,就能轻松摆脱“低薪困境”,抓住AI时代的职业机遇。
如果你还不知道从何开始,我自己整理一套全网最全最细的大模型零基础教程,我也是一路自学走过来的,很清楚小白前期学习的痛楚,你要是没有方向还没有好的资源,根本学不到东西!
下面是我整理的大模型学习资源,希望能帮到你。

👇👇扫码免费领取全部内容👇👇

最后
1、大模型学习路线

2、从0到进阶大模型学习视频教程
从入门到进阶这里都有,跟着老师学习事半功倍。

3、 入门必看大模型学习书籍&文档.pdf(书面上的技术书籍确实太多了,这些是我精选出来的,还有很多不在图里)

4、 AI大模型最新行业报告
2026最新行业报告,针对不同行业的现状、趋势、问题、机会等进行系统地调研和评估,以了解哪些行业更适合引入大模型的技术和应用,以及在哪些方面可以发挥大模型的优势。

5、面试试题/经验

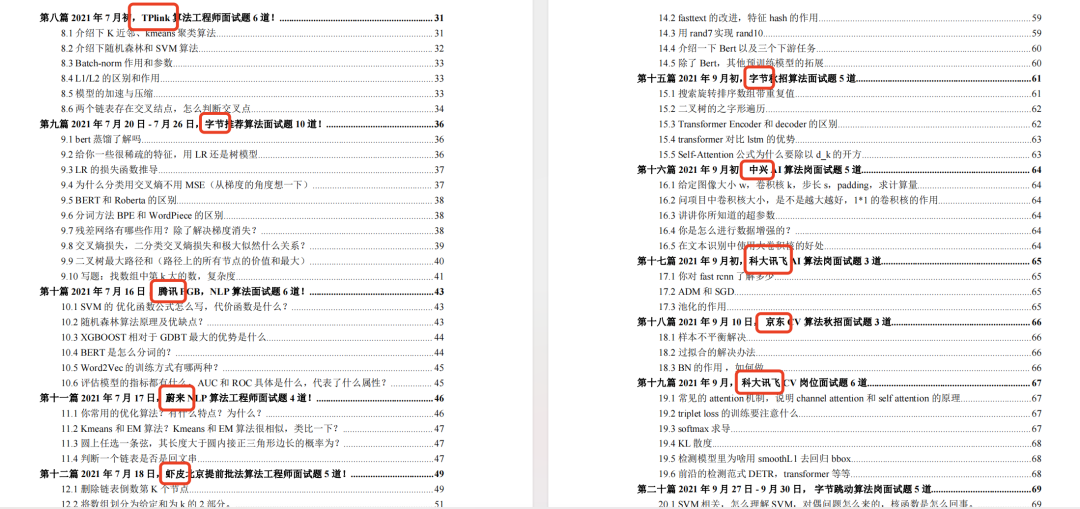
【大厂 AI 岗位面经分享(107 道)】
【AI 大模型面试真题(102 道)】
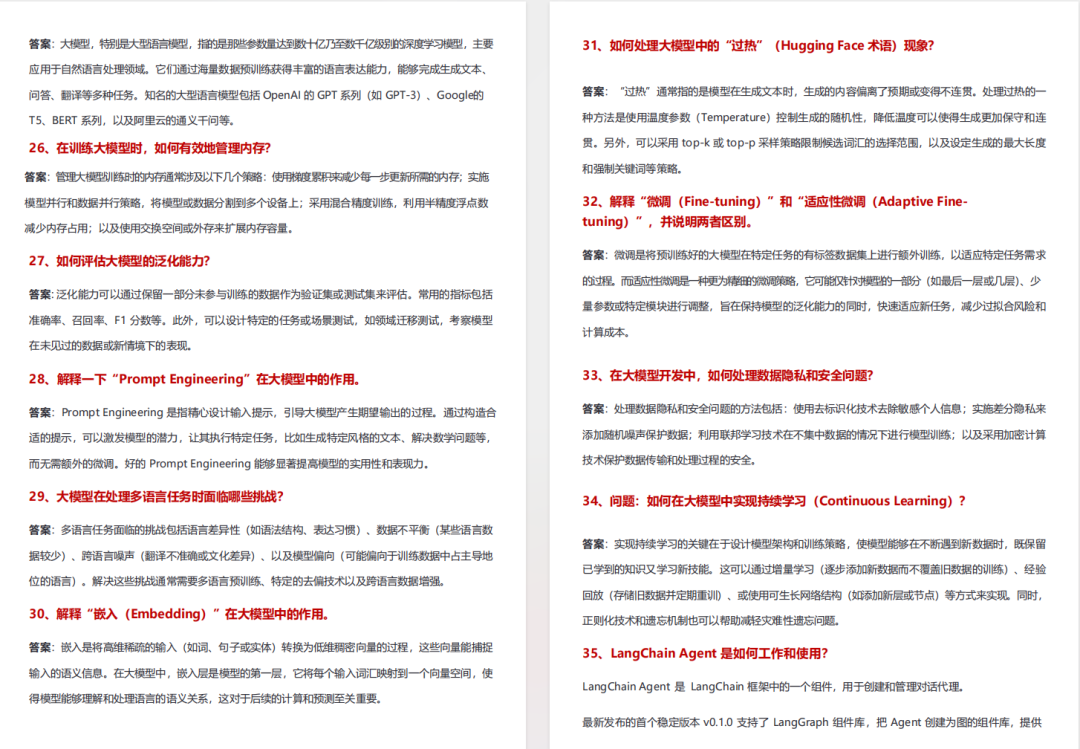
【LLMs 面试真题(97 道)】
6、大模型项目实战&配套源码

适用人群

四阶段学习规划(共90天,可落地执行)
第一阶段(10天):初阶应用
该阶段让大家对大模型 AI有一个最前沿的认识,对大模型 AI 的理解超过 95% 的人,可以在相关讨论时发表高级、不跟风、又接地气的见解,别人只会和 AI 聊天,而你能调教 AI,并能用代码将大模型和业务衔接。
- 大模型 AI 能干什么?
- 大模型是怎样获得「智能」的?
- 用好 AI 的核心心法
- 大模型应用业务架构
- 大模型应用技术架构
- 代码示例:向 GPT-3.5 灌入新知识
- 提示工程的意义和核心思想
- Prompt 典型构成
- 指令调优方法论
- 思维链和思维树
- Prompt 攻击和防范
- …
第二阶段(30天):高阶应用
该阶段我们正式进入大模型 AI 进阶实战学习,学会构造私有知识库,扩展 AI 的能力。快速开发一个完整的基于 agent 对话机器人。掌握功能最强的大模型开发框架,抓住最新的技术进展,适合 Python 和 JavaScript 程序员。
- 为什么要做 RAG
- 搭建一个简单的 ChatPDF
- 检索的基础概念
- 什么是向量表示(Embeddings)
- 向量数据库与向量检索
- 基于向量检索的 RAG
- 搭建 RAG 系统的扩展知识
- 混合检索与 RAG-Fusion 简介
- 向量模型本地部署
- …
第三阶段(30天):模型训练
恭喜你,如果学到这里,你基本可以找到一份大模型 AI相关的工作,自己也能训练 GPT 了!通过微调,训练自己的垂直大模型,能独立训练开源多模态大模型,掌握更多技术方案。
到此为止,大概2个月的时间。你已经成为了一名“AI小子”。那么你还想往下探索吗?
- 为什么要做 RAG
- 什么是模型
- 什么是模型训练
- 求解器 & 损失函数简介
- 小实验2:手写一个简单的神经网络并训练它
- 什么是训练/预训练/微调/轻量化微调
- Transformer结构简介
- 轻量化微调
- 实验数据集的构建
- …
第四阶段(20天):商业闭环
对全球大模型从性能、吞吐量、成本等方面有一定的认知,可以在云端和本地等多种环境下部署大模型,找到适合自己的项目/创业方向,做一名被 AI 武装的产品经理。
-
硬件选型
-
带你了解全球大模型
-
使用国产大模型服务
-
搭建 OpenAI 代理
-
热身:基于阿里云 PAI 部署 Stable Diffusion
-
在本地计算机运行大模型
-
大模型的私有化部署
-
基于 vLLM 部署大模型
-
案例:如何优雅地在阿里云私有部署开源大模型
-
部署一套开源 LLM 项目
-
内容安全
-
互联网信息服务算法备案
-
…
👇👇扫码免费领取全部内容👇👇
3、这些资料真的有用吗?
这份资料由我和鲁为民博士(北京清华大学学士和美国加州理工学院博士)共同整理,现任上海殷泊信息科技CEO,其创立的MoPaaS云平台获Forrester全球’强劲表现者’认证,服务航天科工、国家电网等1000+企业,以第一作者在IEEE Transactions发表论文50+篇,获NASA JPL火星探测系统强化学习专利等35项中美专利。本套AI大模型课程由清华大学-加州理工双料博士、吴文俊人工智能奖得主鲁为民教授领衔研发。
资料内容涵盖了从入门到进阶的各类视频教程和实战项目,无论你是小白还是有些技术基础的技术人员,这份资料都绝对能帮助你提升薪资待遇,转行大模型岗位。


这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】
 5487


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


