梳理MySQL数据逻辑和元数据的技巧

数据治理之数据梳理与建模 一般有用 看1 一、什么是数据模型二、数据模型的类型概念模型概念模型的3个基本要素概念模型的用途逻辑模型逻辑模型的特征逻辑模型的用途物理模型物理模型特征物理模型用途三、什么是数据梳理数据梳理两种流程自上而下梳理数据域梳理数据主题梳理数据实体梳理设计数据模型优缺点自下而上梳理需求分析展现分析逻辑数据建模优缺点四、数据建模技术和方法ER模型五、数据建模与数据治理数据模型和数据治理的关系数据模型VS元数据数据模型VS... 阅读详情

MySQL元数据概览

TABLES

查看表注释、行数

SELECT
  `TABLE_NAME`       -- 表名
  ,`TABLE_TYPE`      -- 表类型
  ,`TABLE_COMMENT`   -- 表注释
  ,`TABLE_ROWS`      -- 行数
  ,`AVG_ROW_LENGTH`  -- 平均行长
  ,`CREATE_TIME`     -- 创建时间
  ,`UPDATE_TIME`     -- 更新时间
FROM `information_schema`.`TABLES`
WHERE `TABLE_SCHEMA`='库名';

COLUMNS

查看列注释

SELECT
  `COLUMN_NAME`     -- 列名
  ,`COLUMN_DEFAULT` -- 列默认值
  ,`IS_NULLABLE`    -- 是否允许NULL
  ,`COLUMN_TYPE`    -- 类型
  ,`COLUMN_KEY`     -- 列键
  ,`COLUMN_COMMENT` -- 列注释
FROM `information_schema`.`COLUMNS`
WHERE `TABLE_SCHEMA`='库名'
  AND `TABLE_NAME`='表名';

查看表的主键、时间字段、列数、注释缺失数量

SELECT
 `TABLE_NAME` -- 表名
 ,COUNT(1) -- 列数
 ,TRIM("," FROM GROUP_CONCAT(DISTINCT IF(`COLUMN_KEY`='PRI',`COLUMN_NAME`,""))) -- 主键
 ,TRIM("," FROM GROUP_CONCAT(DISTINCT IF(`DATA_TYPE` IN ('timestamp','datetime'),`COLUMN_NAME`,""))) -- 时间字段
 ,SUM(ISNULL(`COLUMN_COMMENT`))+SUM(IF(COLUMN_COMMENT='',1,0)) -- 注释缺失数量
FROM `information_schema`.`COLUMNS`
WHERE `TABLE_SCHEMA`='库名'
GROUP BY `TABLE_NAME`;

GROUP_CONCAT为连接字符串的聚合函数,默认连接符是英文逗号

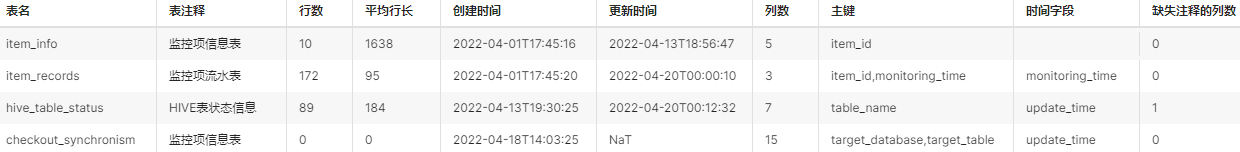
联TABLES和COLUMNS

SELECT
  a.`TABLE_NAME` AS `表名`
  ,a.`TABLE_COMMENT` AS `表注释`
  ,a.`TABLE_ROWS` AS `行数`
  ,a.`AVG_ROW_LENGTH` AS `平均行长`
  ,a.`CREATE_TIME` AS `创建时间`
  ,a.`UPDATE_TIME` AS `更新时间`
  ,b.`col_cnt` AS `列数`
  ,b.`pk` AS `主键`
  ,b.`t` AS `时间字段`
  ,b.`null_cnt` AS `缺失注释的列数`
FROM `information_schema`.`TABLES` a
INNER JOIN (
  SELECT
    `TABLE_NAME`
    ,COUNT(1) AS `col_cnt`
    ,TRIM("," FROM GROUP_CONCAT(DISTINCT IF(`COLUMN_KEY`='PRI',`COLUMN_NAME`,""))) AS `pk`
    ,TRIM("," FROM GROUP_CONCAT(DISTINCT IF(`DATA_TYPE` IN ('timestamp','datetime'),`COLUMN_NAME`,""))) AS `t`
    ,SUM(ISNULL(`COLUMN_COMMENT`))+SUM(IF(COLUMN_COMMENT='',1,0)) AS `null_cnt`
  FROM `information_schema`.`COLUMNS`
  WHERE `TABLE_SCHEMA`='库名'
  GROUP BY `TABLE_NAME`
)b ON b.`TABLE_NAME`=a.`TABLE_NAME`
WHERE `TABLE_TYPE`='BASE TABLE';

效果
查建表语句

单表

SHOW CREATE TABLE `表名`;

导出某个库的全部建表语句

mysqldump --no-data '库名' -u'root' -p > 文件名.sql

E-R图

利用一些数据库工具来创建 E-R图,下面以 DBeaver 为例

批量表抽样,查看具体数据(Python程序)

from pymysql import Connection  # conda install pymysql
import pandas as pd  # conda install pandas openpyxl


class Mysql:
    def __init__(self, **kwargs):
        self.db = Connection(
            user=kwargs.pop('user', 'root'),
            password=kwargs.pop('password'),
            host=kwargs.pop('host', 'localhost'),
            database=kwargs.pop('database'),
            port=kwargs.pop('port', 3306),
            charset=kwargs.pop('charset', 'UTF8'))

    def __del__(self):
        self.db.close()

    def db2sheets(self, queries, prefix):
        """
        保存为多sheets的Excel文件
        :param queries: 字典{sheet名:sql}
        :param prefix: 文件名前缀
        """
        writer = pd.ExcelWriter(prefix.replace('.xlsx', '') + '.xlsx')
        for sheet_name, query in queries.items():
            df = pd.read_sql_query(query, self.db)
            # if 'url' in df.columns:df['url'] = "'" + df['url']
            df.to_excel(writer, sheet_name=sheet_name, index=False)
        writer.save()


if __name__ == '__main__':
    db = '库名'
    # 批量的表,粘到这里
    tables = '''
    tb1
    tb2
    tb3
    '''.strip().split()
    # 抽样SQL(可选择乱序或正序)
    _queries = {t: 'SELECT * FROM {} ORDER BY RAND() LIMIT 99'.format(t) for t in tables}
    # _queries = {t: 'SELECT * FROM {} LIMIT 99'.format(t) for t in tables}
    # 导出为Excel
    Mysql(pwd='密码', database=db).db2sheets(_queries, db)

Clawith:轻量级数据血缘与元数据管理工具的核心架构与部署实践 数据血缘是数据治理领域的核心概念,它描述了数据在系统内从源头到最终消费端的完整流动路径与转换过程。其基本原理是通过解析数据处理任务(如ETL、SQL作业)的依赖关系和逻辑,自动构建数据实体(如表、字段)间的依赖图谱。掌握数据血缘对于保障数据质量、实现影响分析、加速问题排查具有关键的技术价值,是构建可观测、可信任数据架构的基石。在实际应用场景中,尤其是在Hive、Flink等大数据生态和DolphinScheduler、Airflow等调度系统中,自动、准确地采集与维护血缘面临诸多挑战。本文聚焦的Clawit 阅读详情

相关推荐

MySQL数据库

MySQL 基础知识点摘要 查询语句区别 WHERE vs HAVING:WHERE在分组前过滤行,不能直接使用聚合函数;HAVING在分组后过滤分组数据,可使用聚合函数 UNION vs UNION ALL:UNION自动去重但性能较慢,UNION ALL保留所有记录且性能更快 IN vs EXISTS:IN先执行子查询再匹配,适合主查询结果集大;EXISTS主查询每行执行子查询,适合主查询结果集小 数据操作区别 DELETE:删除指定行,记录日志,不重置自增ID,空间标记为可重用 TRUNCATE:清空

weixin_54017681的博客 382

MySQL中根据某个指定字段不同值的情况取不同的字段进行排序

MySQL中根据某个指定字段不同值的情况取不同的字段进行排序

baidu_38287567的博客 2181

企业级数据库设计实战:从MySQL表结构到可扩展架构

数据库设计是构建稳定、高效应用系统的核心技术基础,其核心在于将业务逻辑转化为规范化的数据模型。从概念上讲,它遵循范式理论以减少冗余,同时结合反范式设计优化查询性能,体现了在数据一致性与读取效率间的工程权衡。在技术价值层面,良好的数据库设计直接支撑系统的高并发处理能力、易于维护的代码结构以及平滑的业务扩展。特别是在内容管理系统、用户权限体系等常见应用场景中,合理的表结构、索引策略与字段定义是保障系统长期健康运行的基石。本文以企业站构建为具体案例,深入探讨了用户权限、内容管理、操作日志等核心模块的设计,并针对V

weixin_34152820的博客 606

mysql一些小知识点

因此,在进行select查询时,如果查询到的值有为空的时候,在where语句中我们就需要再做一。在sql中的意思是 a / b 的余数,如果某个字段需要是偶数或者奇数时就可以使用mod。expr为一个表达式,表达式expr结果为ture,返回v1的值,为flase返回v2。函数是一个字符串函数,它返回具有指定长度的字符串的左边部分。个额外的条件判断 ,比如:'name is null';mod(id,2)=1 是指id是奇数。mod(id,2)=0 是指id是偶数。语法结构是if(exer,v1,v2)

渴望飞翔的小白 750

手把手教你为DataEase添加自定义数据源:以ODPS为例的插件开发指南

本文是一份详细的DataEase插件开发实战指南,以接入阿里云ODPS为例,手把手教你如何为DataEase数据可视化平台添加自定义数据源。文章深入解读了DataEase的插件化架构与核心扩展点,包括如何定义数据源类型、编写核心查询提供者(QueryProvider)以及集成前端配置表单,旨在帮助开发者掌握平台扩展能力,以支持企业内部特有的数据存储系统。

weixin_28559803的博客 342

CTF实战:SQL注入与MISC杂项解题思路与自动化技巧

SQL注入作为Web安全的核心漏洞之一,其原理在于攻击者通过构造恶意输入,干扰应用程序与数据库的正常交互逻辑,从而执行非预期的SQL命令。这种技术不仅考验对数据库结构和查询语法的深刻理解,更在渗透测试与CTF竞赛中具有极高的实战价值。在CTF竞赛场景下,面对无回显的布尔盲注或时间盲注,选手需要掌握从判断注入类型、猜解数据库结构到最终获取敏感数据的完整链条,并熟练运用自动化工具与手工调试相结合的策略。同时,MISC(杂项)题目作为竞赛的另一大板块,常涉及文件分析、隐写术与编码转换,要求选手具备快速信息收集和脚

weixin_30521161的博客 393

元数据管理、治理、系统、建设方案、范例等

如果想建设好元数据系统,需要理解元数据系统的相关概念,如数据、数据模型、元数据、元模型、ETL、数据血缘等等。首先,要清楚数据的定义、数据模型的定义。数据一般是对客观事物描述的抽象,在数据库维度,数据是数据记录的简称,例如,个人的基本信息、产品信息等。数据模型是数据特征的抽象,它从抽象层次上描述了系统的静态特征、动态行为和约束条件,为数据库系统的信息表示与操作提供一个抽象的框架。数据模型所描述的内容有三部分,分别是数据结构、数据操作和数据约束。

爱是与世界平行 9759

银河麒麟V10 SP1 x86_64架构下离线部署全栈开发环境:Java8+Mysql5.7+Tomcat8实战指南

本文详细介绍了在银河麒麟V10 SP1 x86_64架构下离线部署全栈开发环境的实战指南,包括Java8、Mysql5.7和Tomcat8的安装与配置。通过步骤详解和常见问题排查,帮助开发者在国产操作系统上高效搭建稳定可靠的开发环境,特别适合政务系统和企业级应用部署。

weixin_29230901的博客 374

加入新公司,怎样快速熟悉业务和项目?

很多新人进入一家新公司后,最头疼的就是如何快速了解公司的业务和项目架构,或者说不要求快速,即便有足够的时间,也很难在庞大的业务中整理出思绪。当然,如果你碰到一个特别热心的老员工,事无巨细地给你讲,随时在你身边答疑解惑,那可能还好。但很可惜,我没有碰到这样的人,在加入新公司后,带我的人几乎没花时间给我讲项目,也没给我安排可以熟悉项目的任务。就这样的一个多月时...

xingduan5153的博客 1万+

华为云Stack 8.X 流量模型分析(一)

​ 当内部需要提供对外服务时(如对外发布Web网站),外部地址发起主动连接,由路由器或者防火墙上的网关接收这个连接,然后将连接转换到内部,此过程是由带有公网IP的网关替代内部服务来接收外部的连接,然后在内部做地址转换,此转换称为DNAT,主要用于内部服务对外发布。​ 内部地址要访问公网上的服务时(如Web访问),内部地址会主动发起连接,由路由器或者防火墙上的网关对内部地址做个地址转换,将内部地址的私有IP转换为公网的公有IP,网关的这个地址转换称为SNAT,主要用于内部共享IP访问外部。

Ciyaso的博客 3247

脑电分析:为什么大脑信号会“变同步”?——事件相关同步化与去同步化 (ERS/ERD) 全景解析

脑电分析中的事件相关同步化(ERS)和去同步化(ERD)是研究大脑动态节律的重要方法,反映特定任务下脑电频段能量的变化。ERD表示神经元活动分散(功率下降),提示脑区活跃处理信息;ERS则反映神经元同步(功率增强),常与静息状态相关。本文详解了ERS/ERD的生理机制、计算流程(包括基线校正和功率谱分析),并提供了Python实现示例,展示如何通过Welch法和STFT进行时频分析,生成ERD/ERS热力图。该技术广泛应用于运动想象脑机接口、癫痫检测等领域,为理解大脑功能状态提供了量化工具。

qq_32516809的博客 1398

Flowable7.x学习笔记(五)Vue3+SpringBoot3实现流程定义管理方案梳理以及静态界面搭建

完整静态界面代码如下,方便大家cv// 定义响应式数据 processName 收集查询条件 【流程名称】// 定义响应式数据 currentPage 收集当前页码// 定义响应式数据 pageSize 收集每页显示的条数// 定义响应式数据 total 收集总数据条数// 监听 currentPage 和 pageSize 的变化,防止非法值})// 重置查询条件// 表格列定义{ label: '流程名称', prop: 'name', align: 'center' },

持续学习ing 2559

ADS使用Smith圆图进行阻抗匹配

在处理RF系统的实际应用问题时,总会遇到一些非常困难的工作,对各部分级联电路的不同阻抗进行匹配就是其中之一。一般情况下,需要进行匹配的电路包括天线与低噪声放大器(LNA)之间的匹配、功率放大器输出(RFOUT)与天线之间的匹配、LNA/VCO输出与混频器输入之间的匹配。匹配的目的是为了保证信号或能量有效地从“信号源”传送到“负载”。 阻抗匹配(impedance matching) 信号源内阻与所接传输线的特性阻抗大小相等且相位相同,或传输线的特性阻抗与所接负载阻抗的大小相等且相位相同,分别称为传输线的输

红茶绿茶和奶茶的博客 3万+

mysql文档--架构体系--《Mysql底层探索》-文档架构首页

中存在很多其他的文章,一定要细心阅读以及理解!!!

阿丹的博客 178

易灵思Ti60F100 FPGA的HyperRAM实战:从硬件连接到Native接口时序调试

本文详细介绍了易灵思Ti60F100 FPGA内置HyperRAM控制器的实战应用。文章从硬件设计要点(如400MHz+信号完整性、等长匹配)切入,重点解析了如何通过Interface Designer配置高效的Native接口,并分享了其时序详解与调试技巧,为开发者提供了一份从硬件连接到软件调试的深度指南。

weixin_29168153的博客 459

生成模型实战 | 基于Transformer生成音乐

本文介绍了基于Transformer架构的音乐生成方法,将音乐视为一系列事件序列进行处理。与将音乐表示为多维图像的MuseGAN不同,该方法使用类似GPT的仅解码器模型,基于先前事件预测下一个音乐事件。模型使用MIDI格式的钢琴音乐数据,通过分词处理将音符转换为note-on、note-off、time-shift和velocity四种事件类型,共388个独特词元,映射为索引序列后输入网络。训练完成后,可通过调整温度参数控制生成音乐的新颖性,从而创作出风格类似训练数据且连贯逼真的音乐作品。

盼小辉丶的博客 5900

选择适合的元数据同步模式,核心是**匹配“源系统特性”与“业务对同步时效性的需求”**,需从3个关键维度评估,最终锁定最优模式

- **核心动作**: - 上线发布:制定上线计划(如选择低峰期),同步全量用户(如发操作指南); - 运行监控:跟踪产品数据(如日活、功能使用率、数据准确性),监控系统稳定性(如是否出现数据延迟); - 迭代优化:基于用户反馈和业务变化,梳理下一轮需求(例:“用户希望新增‘异常原因智能分析’功能”),进入下一个设计周期。 - **关键产出**:《上线报告》、产品运营数据看板、下一轮需求清单。

[Blog][Domain] programb.blog.youkuaiyun.com 141

【kafka】控制台默认不能发送大数据 4096 4095 4129

1.概述 因为某些原因,需要做一个测试,然后我想往topic中,发送一条消息,然后再消费它。但是消息有点大,一条消息是36K. 消费者 [root@1 kafka]# bin/kafka-console-consumer.sh --zookeeper localhost:2181 --topic xxx.devicealarm | grep 网络攻击 生产者,生产者发送了一个消息消息是一个json,json中有这个数据特征 网络攻击 [root@1 kafka]# bin/kafka-console-p

九师兄 587

AI辅助MySQL数据库设计:从概念到落地的避坑指南

数据库设计是软件工程中的核心环节,它涉及将业务需求转化为规范化的数据模型。其基本原理包括实体关系建模、范式化理论以及索引优化策略,旨在保障数据一致性、完整性和查询性能。在技术价值层面,良好的数据库设计能显著提升系统可扩展性、降低维护成本,并为复杂业务场景提供稳定支撑。随着AI编程工具的普及,开发者常面临如何将AI生成的数据库方案转化为可落地、可扩展的物理结构的挑战。本文聚焦于企业级应用场景,通过解析字段类型选择、关系建模、索引优化等常见陷阱,提供一套结合AI辅助的务实设计流程与审查清单,帮助开发者在MySQ

weixin_30527323的博客 309

PD详解 扩展消息——Source_Capabilities_Extended Message

PD的协议层分为控制消息,数据消息还有扩展消息,今天大师匈讲一下扩展消息中的source_cap_extended。这个消息在扩展消息中算是比较关键的东西。 扩展消息中的source_cap_extended 大师匈先上图,然后逐一解释; 上面的图表说了source_cap_ext中包含了哪些内容。 我们注意到在source_cap扩展消息中是以字节为单位的,并不是像source_cap中以一个object为单位,当然有注意到PD标准spec中说明的扩展消息的话,那里有说明,在header之后的字节

大师匈的博客 3521

精雕软件(JDpaint) 5.5 绿色版

精雕软件(JDpaint) 5.5 绿色版精雕软件(JDpaint) 5.5 绿色版精雕软件(JDpaint) 5.5 绿色版

用户画像数据存储在什么数据库_用户画像系统数据架构及开发流程

用户画像在用户研究、个性化营销、推荐应用等领域起着非常重要的作用,那么如何自己搭建一套用户画像系统呢?这里给出一种参考方案,首先我们需要搭建一套数据仓库,它会对原始日志进行处理、清洗、加工、汇总。而用户画像是基于数据仓库构建的应用系统,它基于对用户的维度进行分类,建立画像模型。用户画像系统会与线上数据进行对接,同时与Web进行交互,更好地支撑运营人员、数据分析人员的工作。如下为常见的用户...

weixin_30735701的博客 2111

迈瑞BS系列全自动生化分析仪LIS协议接口手册(内含HL7和ASTM)

迈瑞BS系列全自动生化分析仪LIS协议接口手册,内含HL7和ASTM)

MySQL-事务,索引,视图的整理

核心问题:脏读(读未提交数据)、不可重复读(同一事务多次读结果不一致)、幻读(结果集行数变化),隔离级别越高,问题解决越彻底,但并发性能越低。关键操作:开启(START TRANSACTION/BEGIN)、提交(COMMIT,永久生效)、回滚(ROLLBACK,撤销未提交操作);三者协同关系:事务保证数据操作的可靠性,索引优化数据查询的效率,视图简化数据访问的方式,共同支撑数据库的 “高效、安全、易用”;按约束特性:唯一索引(允许 NULL,多个)、主键索引(不允许 NULL,1 个,默认聚集索引);

2202_75439040的博客 412

VC中sqlite的使用

在VC中对sqlite的使用,实现数据库大批数据的快速插入,读取数据库中的数据在ListCtrl中显示

汉书HE8,好用的汇编代码编写工具

汉书HE8,好用的汇编代码编写工具早期编写汇编代码所用功能强大

如何建设数据中台?

建设数据中台,本质上是要减少数据的重复建设,提高数据的共享能力,做好数据的连接,对应的就是 OneData、OneService 和 OneEntity 三个方法论。OneData 要求数仓所有数据只加工一次,对应到数仓的设计层面,要求有统一的维度,对于明细层数据,相同粒度的度量只加工一次,对于汇总层的数据,相同粒度的指标只存在一份。OneService 是统一查询服务,原先数据开发和应用开发的边...

jessicaiu的博客 1904

数据治理到底能不能干

为什么是脏活、累活?1. 源数据烟囱式开发:业务繁多、数据库多而乱,系统与系统之间错综复杂数据库种类:架构经历多次变迁,切换不完全,需要从Mysql、oracle、hbase甚至excle表中跨库、跨实例、跨种类才能获得有效业务数据数据结构混乱:同一字段,类型、命名都不一致文档缺失:无数据库文档或文档陈旧2. 变迁系统版本升级:每一次升级都只是掩盖之前的错误,数据治理需要...

数据一哥,公众号:数据社 7888

MySQL从入门到精通:构建数据库立体认知体系与实战进阶路径

最近在帮一个刚转行做后端的朋友梳理技术栈,他问了我一个很有意思的问题:“都说 MySQL 是后端必学,网上教程也多,但我跟着装完、建个表、写两句 SQL 之后,就不知道下一步该学什么了。从‘会用’到‘精通’,中间到底隔着什么?” 这个问题很典型。很多人把 MySQL 学习路径简化成了“安装 -> 写 SQL”,结果就是工作几年,对数据库的理解还停留在 CRUD(增删改查)层面,遇到慢查询、死锁、数据不一致就束手无策。真正的“精通”,不是背下所有命令,而是建立起一套从单机到集群、从开发到运维、从表象到原

diankui6178的博客 552

如何在3天内构建企业级数据治理系统:OpenMetadata实战指南

在数据爆炸的时代,企业面临的最大挑战不是数据收集,而是数据理解。当业务报表出现异常时,数据团队常常需要花费数天时间追踪问题源头。OpenMetadata作为开源的数据治理平台,为您提供了从数据发现到血缘追踪的完整解决方案,让数据治理变得简单高效。 OpenMetadata是一个开放的数据上下文平台,专为构建可信的数据语义和业务上下文而设计。它连接数据源、提取元数据、构建数据血缘,并提供统一的搜索

gitblog_00234的博客 192
上一篇: 离线数仓DIM层和DWD层,联表后表和字段命名规则
下一篇: 统计HIVE字段行数、NULL行数、字段重复行数
小基基o_O
博客等级 码龄9年 4414粉丝 467原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包

打赏作者

小基基o_O

您的鼓励是我创作的巨大动力

¥1 ¥2 ¥4 ¥6 ¥10 ¥20
扫码支付:¥1
获取中
扫码支付

您的余额不足,请更换扫码支付或充值

打赏作者

实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值