图解并行思想HIVE获取消费金额topN的用户ID

Hive(四)——电商交易项目案例 电商交易项目案例 Sdate定义了日期的分类,将每天分别赋予所属的月份、星期、季度等属性, 字段分别为日期、年月、年、月、日、周几、第几周、季度、旬、半月; Stock定义了订单表头,字段分别为订单号、交易位置、交易日期; StockDetail文件定义了订单明细,该表和Stock以交易号进行关联, 字段分别为订单号、行号、货品、数量、价格、金额; CREATE TABLE 阅读详情

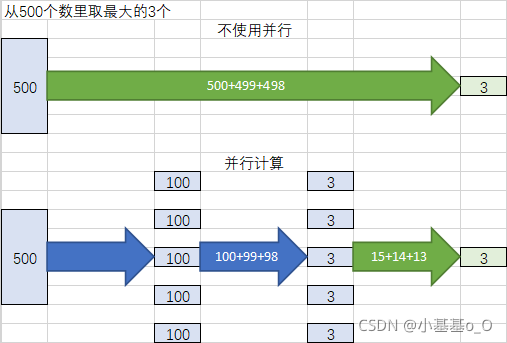
并行思想

  • 不使用并行,时间消耗约1500
  • 使用并行,并行度设为5,把500切成5个100
    分别从每个100找最大的3个,得到15个
    从这15个里找最大的3个
    时间消耗约300(≈5倍)

场景

从10亿用户中 获取 消费前5000的 用户ID

uidamount
123.48
27888.33
…
1000000000367.55

错误方案

  • 全局排序速度较慢
SELECT uid,amount FROM t ORDER BY amount DESC LIMIT 5000;

可行方案

  1. 按用户ID取余进行分区(此处设40)
  2. 分区内(并行)排序
  3. 筛选各分区topN
  4. 全局排序选取topN
WITH
-- 按用户ID取余进行分区(各分区并行排序)
t1 AS (
    SELECT
        uid,
        amount,
        RANK() OVER (PARTITION BY (uid % 40) ORDER BY amount DESC)r
    FROM t
),
-- 筛选各分区topN
t2 AS (
    SELECT uid,amount FROM t1 WHERE r <= 5000
)
-- 全局排序选取topN
SELECT uid,amount FROM t2 ORDER BY amount DESC LIMIT 5000;
用户消费行为分析(MapReduce实现,Hive分析) 一、题目要求 数据来自CDNow网站的一份用户购买CD明细,本数据集共有 6 万条 左右数据,数据为 CDNow 网站 1997年1月至1998年6月的用户行为 数据 阅读详情

相关推荐

hive-使用开窗函数实现百分比、topN、前百分比

问题2:SQL 有一个订单表A,分别有order_id(订单id)、user_id(用户id)、amt(金额)三个字段, 用sql实现以下功能: i. 求订单总量为top3的用户及交易笔数,同时求出其交易笔数占全量订单笔数的占比。 ii. 求每个用户top3交易金额的订单。 iii. 求订单总量从大到小排名在50%之前的用户。 ------------------------------------------------------ -- i. 求订单总量为t...

weixin_36190755的博客 9504

Hive查询各自区组的money排名前十的账号

有一个账号表如下,请写出SQL语句,查询各自区组的money排名前十的账号(分组取前10) 1)建表(MySQL) CREATE TABLE `test_ten_account` ( `dist_id` int COMMENT '区组id', `account` string COMMENT '账号', `gold` int COMMENT '金币' ) row format delimited fields terminated by ','; insert int

鸭梨的博客 2026

20道Hive SQL经典训练提升题

20道经典hive sql基础面试题

数据与算法架构提升之路专栏 3243

电商交易数据分析(hive版)

05年项目使用spark+hadoop,最近公司分享给小伙伴们,就整理出文档供大家学习交流。整理hdfs+hive+spark stream+spark sql实战系列,有些数据是网上搜索下载的,同时整理时也参考其他博文以及《spark实战》

架构师老狼 2870

免费升级哨兵2号分辨率!用SRCNN深度学习模型实现10米→2.5米超分重建

本文详细介绍了如何利用SRCNN深度学习模型,将哨兵2号遥感影像的分辨率从10米免费提升至2.5米。文章提供了从数据准备、模型训练到部署应用的全流程实战指南,旨在通过AI应用技术,为农业监测、城市规划等领域提供更高精度的影像数据支持。

coffee的博客 524

AI工程化之生成式UI & A2UI(二)

本文介绍了生成式UI框架A2UI的架构设计与核心实现。项目采用AI协作开发模式,通过ATDD(AI驱动的测试驱动开发)确保代码质量。前端SDK基于zustand实现框架无关的状态管理,包含协议解析器、存储管理、渲染器等核心模块。重点展示了基础store构建、A2UI协议解析器的实现过程,包括mock数据准备、测试用例生成和可视化调试。项目采用monorepo管理,利用vite实现高效开发构建。整个系统设计遵循模块化原则,通过清晰的接口定义实现各组件解耦,为后续功能扩展打下基础。

qq_34306228的博客 407

hive电子商务消费行为分析

在store有多少employee。

weixin_63713552的博客 558

Windows下ArduPilot SITL仿真环境搭建与QGC地面站联调全攻略

软件在环仿真(SITL)是无人机开发中的关键一环,它通过将飞控固件运行在PC上,用数学模型模拟传感器数据,实现无硬件依赖的飞行逻辑验证。这项技术不仅降低了试错成本,更为地面站开发、自动化测试和任务规划提供了安全可控的试验场。在工程实践中,MAVLink协议作为飞控与地面站之间的通信桥梁,贯穿仿真、遥测与指令控制全程。结合QGroundControl(QGC)这一主流地面站,开发者可以直观地观察飞行状态、规划航点并记录日志。本文以Windows原生环境为例,详细介绍ArduPilot SITL的搭建流程、MA

weixin_31858171的博客 319

Hive-Hbase练习之统计用户历史消费金额

需求 假定Hive的person表存储用户当天消费的金额信息,HBase的table2表存储用户历史消费 的金额信息。 现person表有记录name=1,account=100,表示用户1在当天消费金额为100元。 table2表有记录key=1,cf:cid=1000,表示用户1的历史消息记录金额为1000元。 基于某些业务要求,要求开发Spark应用程序实现如下功能: 根据用户名累计用户的历...

fa124607857的博客 1127

Autosar诊断实战系列23-NRC优先级解析

NRC分类,优先级判断逻辑及测试注意事项介绍。

initiallizer的博客 2619

Open3D 可视化(1)——简单可视化【2026最新版】

简单可视化,博客长期更新,本文最新更新时间为:2026年5月10日。

点云侠的博客 5688

C#上位机性能优化全攻略:彻底解决界面卡顿+多线程死锁+PLC数据延迟,产线实测稳定运行2年

一开始我们用的是网上找的零散优化代码,根本满足不了要求,后来花了2个月的时间,把之前27条产线的代码整理、重构、优化,做了一套这套方案上线后,连续稳定运行2年零3个月:界面响应时间稳定在50ms以内,多线程死锁率持续为0,PLC数据延迟稳定在150ms以内,系统可用率≥99.99%,帮客户一年省下了超过480万的停线损失、罚款损失和人工成本,客户第二年就把剩下的22条产线也全部交给我们做了,还介绍了3家同行。

这里只有干货:从 Modbus 通信到 MES 对接,从 YOLO 训练到工控机部署,带你搞定工业软件开发全流程。 294

Hive实现topN

一、需求 查询每个产品top3的用户信息,初始数据表如下 uid pid user9 e user2 a user14 e user6 b user12 a ... ... ... ... 二、实现 #每个产品对应的每个用户的浏览量 select pid,uid,count(uid) as cnt from visit2 group by pid,uid order b...

qq_40727267的博客 1024

STM32声源定位:实现声源定位的嵌入式解决方案

通过以上代码,我们可以获取麦克风音频信号样本,并使用交叉相关法计算声源的位置。然而,我可以帮助您解答有关STM32声源定位的问题,提供相关的代码和指导。获取了麦克风音频信号后,我们可以使用信号处理算法来计算声源的位置。该算法通过计算不同麦克风之间的信号延迟来确定声源的方向。首先,我们需要获取每个麦克风的音频信号。声源定位是一项重要的技术,可以帮助我们确定声音的来源位置。在嵌入式系统中,使用STM32微控制器可以实现精确的声源定位。声源定位的基本原理是通过多个麦克风阵列接收到的声音信号来计算声源的位置。

UplKubernetes的博客 2582

【YOLOv11】006、YOLOv11数据增强策略:Mosaic、MixUp等增强技术原理解析

摘要:YOLOv11在产线缺陷检测中遇到小尺寸瑕疵漏检问题,暴露了训练数据过于"干净"的缺陷。数据增强的核心是提升模型泛化能力,而非简单扩充数据。Mosaic增强通过多图拼接迫使模型处理多尺度目标,需注意边界框裁剪细节;MixUp通过线性插值使决策边界更平滑,但需避免类别冲突。自适应增强策略应随训练进度动态调整强度。实际应用中,需针对小目标、类别不平衡等场景调整增强参数,并确保验证与推理流程一致。数据增强应针对性解决具体问题,而非盲目尝试组合。

企鹅码农的专属播客,分享10多年的实战案例和经验解读,包含YOLO、RT-DETR、AI等各个工作领域。 368

hive 之实战统计地区产品点击TOPN

目录 1.数据准备 2.安装sqoop 3.使用sqoop将mysql中数据抽到hive 4.求每个区域点击Top3的产品 1.数据准备 1.1产品信息表,存放在msyql关系型数据库 sql脚本百度网盘链接: 链接:https://pan.baidu.com/s/1dT8Rt2L49VMoi6OY3qCE2g 提取码:bhbx 1.2城市信息表,存放在mysql关系...

君永夜 1253

复分析 阿尔福斯(Ahlfors) 第三版答案 英文

答案分为十章,有部分习题没有答案,全英文复分析阿尔福斯(Ahlfors) 第三版答案

hive语句练习—用户订单分布

用户订单分布 按照用户id进行分组,统计订单时间以及地域的分布情况 订单指标: 第一次下单时间, 最近一次下单时间, 首单距今时间, 尾单距今时间, 近30天订单数量(不含退拒 近30天订单金额(不含退拒) 近60天订单数量(不含退拒) 近60天订单金额(不含退拒) 近90天订单数量(不含退拒) 近90天订单金额(不含退拒) 近30天订单数量(含退拒) 近30天订单金额(含退拒) 近60天购买次数(含退拒) 近60天购买金额(含退拒) 近90天购买次数(含退拒) 近90天购买金额(含退拒) 近90天的客单价

balalaxstar的博客 748

Statistics and Machine Learning Toolbox

Statistics and Machine Learning Toolbox(带书签),MATLAB统计学习工具

怀旧版电脑GBC模拟器

再现原版GBC掌机的界面,电脑运行连游戏界面都一样大小,很怀旧,很真实,(英文版)强烈推荐,很小的文件,很难才找到的。

hive udf 分组取top1_Hive分组取TOPN数据

1、ROW_NUMBER,RANK(),DENSE_RANK()语法格式:row_number() OVER (partition by COL1 order by COL2 desc ) rankpartition by:类似hive的建表,分区的意思;order by :排序,默认是升序,加desc降序;rank:表示别名表示根据COL1分组,在分组内部根据 COL2排序,而此函数计算的值...

weixin_30983209的博客 246

hive获取每组数据最大值

hive 分组top N 案例01 获取历史数据中每个用户最近时间的一条数据 select itcode, time from (select itoode, time, row_number() over(partion by itcode order by time desc) rn from tb_his ) where ...

风逍遥-ygq 9201

hive之求累计值

最近做项目真是忙到昏厥,抽个空写篇博客吧,保持良好的学习习惯~ 今天要写的是工作中经常遇到的求累计值的问题。 从订单表中取出orderid,uid,time,ciiamount,数据格式如下: 现需要计算每个uid每天累计的成交金额。 SQL代码如下: --汇总每个uid每天的订单成交金额 USE edw_htl; DROP TABLE IF EXISTS tmp_linshi_c...

数据小白的进阶之路 1万+

HiveSQL实战 -- 电子商务消费行为分析(附源码和数据)

一、前言Hive 学习过程中的一个练习项目,如果不妥的地方或者更好的建议,欢迎指出!我们主要进行一下一些练习:数据结构数据清洗基于Hive的数据分析二、项目需求首先和大家讲一下这个项目的...

a934079371的博客 3312

Hive高级查询

1)配置查询头信息 在hive-site.xml hive.cli.print.header true &lt;/property hive.cli.print.current.db true 2)基本查询 -》全表查询 select * from empt; -》查询指定列 select empt.empno,empt.empname from empt; -》列别名 select e...

weixin_42898914的博客 304

Hive求截止到当前日期累计消费金额或使用次数

说明 经常遇到这种类型的问题:求截止到当前日期(或在此日期之前),某用户的累计消费金额或者累计使用次数。 只要遇到截止到当前日期为止,就要想到窗口函数,因为最后求的是累积消费金额,就要使用sum(金额字段) over(partition by 用户 order by 日期字段)。 场景题 下面是力扣的一道SQL题,以此题为例: activity 表: 编写一个 SQL 查询,同时报告每组玩家和日期,以及玩家到目前为止玩了多少游戏。也就是说,在此日期之前玩家所玩的游戏总数。最终结果如下: SQL SELE

FlatTiger的博客 2965
上一篇: 图解Spark商品关联分析
下一篇: Emoji表情分类整理,写blog速查用
小基基o_O
博客等级 码龄9年 4414粉丝 467原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包

打赏作者

小基基o_O

您的鼓励是我创作的巨大动力

¥1 ¥2 ¥4 ¥6 ¥10 ¥20
扫码支付:¥1
获取中
扫码支付

您的余额不足,请更换扫码支付或充值

打赏作者

实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值