


场景
购物蓝分析(market basket analysis):
在一个数据集中找出项之间的关系
例如,购买手机的顾客,有10%也买手机壳
关联算法
SparkSQL粗分析
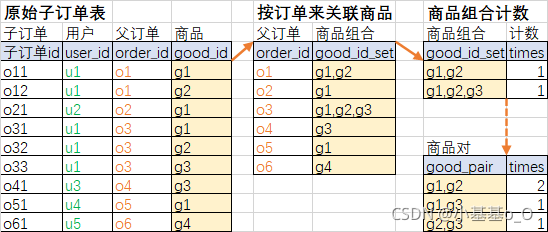
大致原理
import org.apache.spark.sql.SparkSession
import org.apache.spark.{SparkConf, SparkContext}
//创建SparkContext对象
val c0: SparkConf = new SparkConf().setAppName("a0").setMaster("local")
val sc: SparkContext = new SparkContext(c0)
//创建SparkSession对象
val c1: SparkConf = new SparkConf().setAppName("a1").setMaster("local")
val spark: SparkSession = SparkSession.builder().config(c1).getOrCreate()
//隐式转换支持
import spark.implicits._
//原始子订单表
sc.makeRDD(Seq(
  ("u1", "o1", "g1"),
  ("u1", "o1", "g2"),
  ("u2", "o2", "g1"),
  ("u1", "o3", "g1"),
  ("u1", "o3", "g2"),
  ("u1", "o3", "g3"),
  ("u3", "o4", "g3"),
  ("u4", "o5", "g1"),
  ("u5", "o6", "g4"),
)).toDF("user_id", "order_id", "good_id").createTempView("t0")
//按订单关联
spark.sql(
  """
    |SELECT COLLECT_SET(good_id)good_set FROM t0
    |GROUP BY user_id
    |HAVING SIZE(good_set) > 1
    |""".stripMargin).createTempView("t1")
spark.sql(
  """
    |SELECT good_set,count(good_set)c FROM t1
    |GROUP BY good_set
    |ORDER BY c DESC
    |""".stripMargin).show
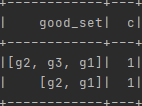
SQL计算结果略为粗糙
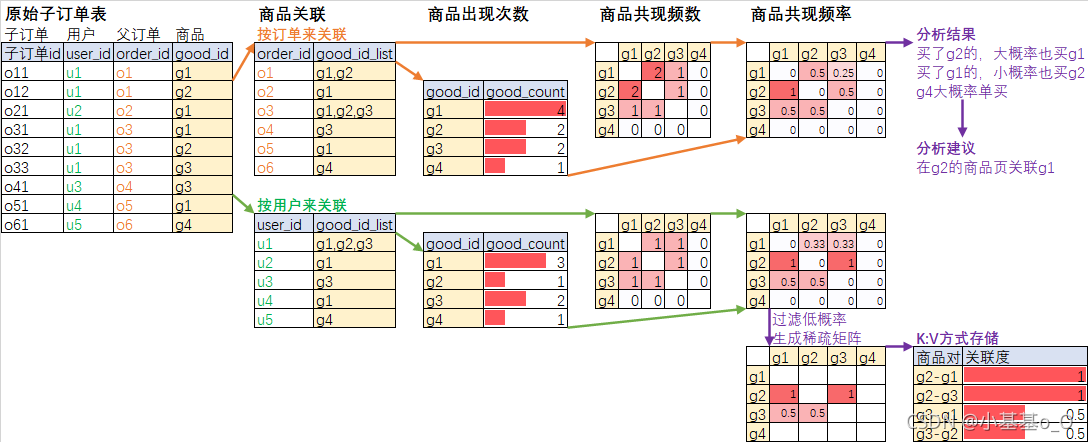
共现频数
大致原理
import org.apache.spark.sql.SparkSession
import org.apache.spark.{SparkConf, SparkContext}
//创建SparkContext对象
val c0: SparkConf = new SparkConf().setAppName("a0").setMaster("local")
val sc: SparkContext = new SparkContext(c0)
//创建SparkSession对象
val c1: SparkConf = new SparkConf().setAppName("a1").setMaster("local")
val spark: SparkSession = SparkSession.builder().config(c1).getOrCreate()
//隐式转换支持
import spark.implicits._
//子订单表(模拟HIVE:SELECT order_id,good_id FROM dwd_order_detail)
sc.makeRDD(Seq(
  ("o1", "g1"),
  ("o1", "g2"),
  ("o2", "g1"),
  ("o3", "g1"),
  ("o3", "g2"),
  ("o3", "g3"),
  ("o4", "g3"),
  ("o5", "g1"),
  ("o6", "g4"),
)).toDF("order_id", "good_id").createTempView("dwd_order_detail")
//按订单关联商品
val df = spark.sql(
  """
    |SELECT COLLECT_SET(good_id) FROM dwd_order_detail
    |GROUP BY order_id
    |""".stripMargin).toDF("items") //下面模型默认输入列名叫items
df.show
/*
+------------+
|       items|
+------------+
|        [g3]|
|        [g4]|
|    [g2, g1]|
|[g2, g3, g1]|
|        [g1]|
|        [g1]|
+------------+
*/
//共现频数模型
import org.apache.spark.ml.fpm.FPGrowth
val fpGrowth = new FPGrowth().setMinSupport(0).setMinConfidence(0)
val model = fpGrowth.fit(df)
println(model)
/*
FPGrowthModel: uid=fpgrowth_352773cafc93, numTrainingRecords=6
*/
//商品共现频数
model.freqItemsets.show
/*
+------------+----+
|       items|freq|
+------------+----+
|        [g1]|   4|
|        [g2]|   2|
|    [g2, g1]|   2|
|        [g3]|   2|
|    [g3, g2]|   1|
|[g3, g2, g1]|   1|
|    [g3, g1]|   1|
|        [g4]|   1|
+------------+----+
*/
//商品关联规则
model.associationRules.show
/*
+----------+----------+----------+----+
|antecedent|consequent|confidence|lift|
+----------+----------+----------+----+
|  [g3, g1]|      [g2]|       1.0| 3.0|
|      [g2]|      [g1]|       1.0| 1.5|
|      [g2]|      [g3]|       0.5| 1.5|
|  [g2, g1]|      [g3]|       0.5| 1.5|
|  [g3, g2]|      [g1]|       1.0| 1.5|
|      [g1]|      [g2]|       0.5| 1.5|
|      [g1]|      [g3]|      0.25|0.75|
|      [g3]|      [g2]|       0.5| 1.5|
|      [g3]|      [g1]|       0.5|0.75|
+----------+----------+----------+----+
*/
//预测
model.transform(Seq(
  "g1",
  "g2",
  "g3",
  "g4",
  "g1 g2",
  "g1 g3",
  "g2 g3",
).map(_.split(" ")).toDF("items")).show
/*
+--------+----------+
|   items|prediction|
+--------+----------+
|    [g1]|  [g2, g3]|
|    [g2]|  [g1, g3]|
|    [g3]|  [g2, g1]|
|    [g4]|        []|
|[g1, g2]|      [g3]|
|[g1, g3]|      [g2]|
|[g2, g3]|      [g1]|
+--------+----------+
*/
用户总数(上面是按用户关联;如果按订单关联,那就是订单总数)
N
=
n
u
m
T
r
a
i
n
i
n
g
R
e
c
o
r
d
s
=
6
N=numTrainingRecords=6
N=numTrainingRecords=6
置信度
C
o
n
f
i
d
e
n
c
e
g
3
→
g
1
=
F
r
e
q
g
1
∩
g
3
F
r
e
q
g
3
=
1
2
Confidence_{g3 \rightarrow g1}=\frac{Freq_{g1 \cap g3}}{Freq_{g3}}=\frac{1}{2}
Confidenceg3→g1=Freqg3Freqg1∩g3=21
C
o
n
f
i
d
e
n
c
e
g
1
→
g
3
=
F
r
e
q
g
1
∩
g
3
F
r
e
q
g
1
=
1
4
Confidence_{g1 \rightarrow g3}=\frac{Freq_{g1 \cap g3}}{Freq_{g1}}=\frac{1}{4}
Confidenceg1→g3=Freqg1Freqg1∩g3=41
支持度
S
u
p
p
o
r
t
g
1
∩
g
3
=
F
r
e
q
g
1
∩
g
3
N
=
1
6
Support_{g1 \cap g3}=\frac{Freq_{g1 \cap g3}}{N}=\frac{1}{6}
Supportg1∩g3=NFreqg1∩g3=61
S
u
p
p
o
r
t
g
1
=
F
r
e
q
g
1
N
=
4
6
Support_{g1}=\frac{Freq_{g1}}{N}=\frac{4}{6}
Supportg1=NFreqg1=64
S
u
p
p
o
r
t
g
3
=
F
r
e
q
g
3
N
=
2
6
Support_{g3}=\frac{Freq_{g3}}{N}=\frac{2}{6}
Supportg3=NFreqg3=62
提升(通常认为:大于1有效用,小于1无效用)
L
i
f
t
g
1
,
g
3
=
S
u
p
p
o
r
t
g
1
∩
g
3
S
u
p
p
o
r
t
g
1
×
S
u
p
p
o
r
t
g
3
=
3
4
Lift_{g1 , g3}=\frac{Support_{g1 \cap g3}}{Support_{g1} \times Support_{g3}}=\frac{3}{4}
Liftg1,g3=Supportg1×Supportg3Supportg1∩g3=43
L
i
f
t
g
1
,
g
2
=
F
r
e
q
g
1
∩
g
2
×
N
F
r
e
q
g
1
×
F
r
e
q
g
2
=
2
×
6
4
×
2
=
3
2
Lift_{g1 , g2}=\frac{Freq_{g1 \cap g2} \times N}{Freq_{g1} \times Freq_{g2}}=\frac{2 \times 6}{4 \times 2}=\frac{3}{2}
Liftg1,g2=Freqg1×Freqg2Freqg1∩g2×N=4×22×6=23
词向量
词向量可以算出商品之间的相似度,但不确定是什么关系,是互补品还是替代品?
import org.apache.spark.sql.SparkSession
import org.apache.spark.{SparkConf, SparkContext}
//创建SparkContext对象
val c0: SparkConf = new SparkConf().setAppName("a0").setMaster("local")
val sc: SparkContext = new SparkContext(c0)
//创建SparkSession对象
val c1: SparkConf = new SparkConf().setAppName("a1").setMaster("local")
val spark: SparkSession = SparkSession.builder().config(c1).getOrCreate()
//隐式转换支持
import spark.implicits._
//子订单表(模拟HIVE:SELECT user_id,good_id FROM dwd_order_detail)
sc.makeRDD(Seq(
  ("u1", "g1"),("u1", "g2"),("u1", "g1"),("u1", "g2"),("u1", "g3"),
  ("u2", "g1"),("u2", "g3"),("u2", "g2"),
  ("u3", "g4"),("u3", "g5"),("u3", "g4"),
  ("u4", "g5"),("u4", "g4"),
  ("u5", "g5"),("u5", "g4"),("u5", "g4"),("u5", "g4"),("u5", "g4"),("u5", "g5"),
)).toDF("user_id", "good_id").createTempView("dwd_order_detail")
//按用户关联商品
val df = spark.sql(
  """
    |SELECT COLLECT_LIST(good_id) FROM dwd_order_detail
    |GROUP BY user_id
    |""".stripMargin).toDF("goods") //下面模型默认输入列名叫items
//词向量模型
import org.apache.spark.ml.feature.Word2Vec
val word2Vec = new Word2Vec()
  .setInputCol("goods") //输入列名称
  .setOutputCol("result") //输出列名称
  .setVectorSize(20) //词向量维度
  .setWindowSize(4) //词窗大小
  .setMinCount(0) //最低词频门槛
  .setMaxIter(20) //最大训练迭代次数
val model = word2Vec.fit(df)
//计算余弦相似度来关联商品
val goods = spark.sql(
  "SELECT DISTINCT(good_id)goods FROM dwd_order_detail ORDER BY goods"
).rdd.map(_.getString(0)).collect.iterator
for (good <- goods) {
  println(good)
  model.findSynonyms(good, 4).show(false)
}
某次打印结果

矩阵分解提取商品隐语义
// 参数
val rank = 5 //矩阵分解的秩
val topN = 3 //每个商品召回相近商品的个数
// 创建SparkSession对象
import org.apache.spark.sql.SparkSession
val spark: SparkSession = SparkSession.builder()
  .master("local").appName("a0").getOrCreate()
// 隐式转换支持
import spark.implicits._
// 创建数据
val df = Seq(
  (1, 1, 5), (1, 2, 3), (1, 3, 1), (1, 4, 5), (1, 6, 2),
  (2, 1, 5), (2, 2, 3), (2, 5, 4), (2, 6, 2), (2, 7, 1),
  (3, 2, 3), (3, 3, 1), (3, 4, 4), (3, 5, 5), (3, 7, 1),
  (4, 2, 3), (4, 4, 5), (4, 7, 1),
  (5, 1, 5), (5, 4, 4), (5, 5, 4), (5, 6, 2),
  (6, 1, 5), (6, 3, 1), (6, 6, 4), (6, 7, 4),
  (7, 1, 5), (7, 4, 1), (7, 5, 1), (7, 7, 5),
  (8, 1, 5), (8, 2, 3), (8, 5, 2), (8, 6, 5),
).toDF("user", "item", "rating")
// Alternating Least Squares (ALS) matrix factorization
import org.apache.spark.ml.recommendation.ALS
val als = new ALS().setRank(rank)
val model = als.fit(df)
// 物品特征
val itemFactors = model.itemFactors.rdd.map(a => (a.getInt(0), a.getSeq[Float](1)))
// 余弦相似度
val matrix = itemFactors.cartesian(itemFactors).filter(a => a._1._1 != a._2._1)
matrix.foreach(println)
val sparseMatrix = matrix.map({
  case ((a, b), (c, d)) =>
    val bd = b.zip(d).map(t => t._1 * t._2).sum
    val bb = math.sqrt(b.map(math.pow(_, 2)).sum)
    val dd = math.sqrt(d.map(math.pow(_, 2)).sum)
    val cosineSimilarity = bd / (bb * dd)
    (a, (c, cosineSimilarity))
}).groupByKey.mapValues(_.toArray.sortBy(-_._2).take(topN).toList)
sparseMatrix.sortByKey().foreach(println)
某次打印结果:

标签
| 规则 | 说明 |
|---|---|
| 商品类目 | 一级类目、二级类目、三级类目 |
| 品牌 | 品牌、母品牌、子品牌 |
| 商品规格 | 重量、体积、衣服尺寸 |
| 价格 | |
| 价格 除以 商品规格 | 元/kg |
| 弹性 | 价格弹性、需求弹性;奢侈品、必需品 |
| 使用周期 | 5年、1年、1个月、1天 |
| 保质期 | 3年、1年、1个月、1天、2小时 |
| 保存 | 常温、冷藏、避光、密封、干燥 |
| 使用次数 | 一次性、非一次性 |
| 颜色 | 赤橙黄绿青蓝紫 |
| 地域 | 南方、北方、沿海、内陆 |
| … |

 325


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


