


架构
简单架构图
每个Region Server有多个Region
每个Region有多个Store
每个Store有多个StoreFile
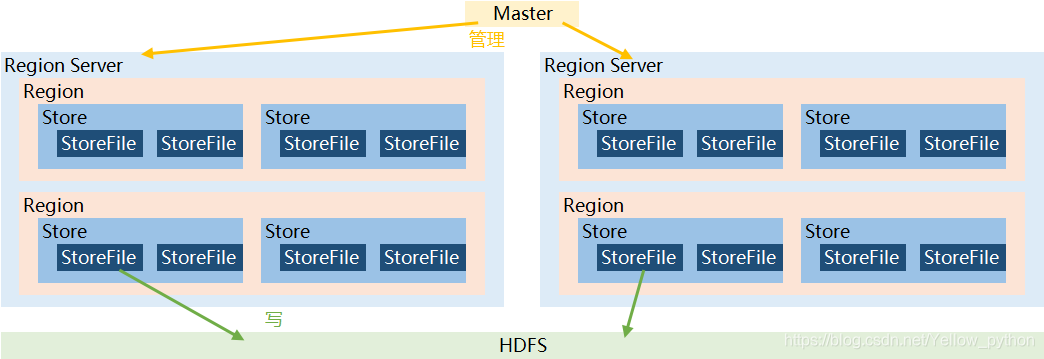
Master是Region Server的管理者
实现类:HMaster
Region Server是Region的管理者
实现类:HRegionServer
对Region操作,例如:Region切分…
Client
详细架构图

StoreFile保存实际数据的物理文件
以HFile的形式存储在HDFS上
其中数据是有序的
MemStore写缓存
HFile中的数据 要求有序
数据会先存MemStore并排序,然后等待时机刷写HFile
每次刷写都会形成一个新的HFile
写数据流程

PUT- 客户端访问Zookeeper:请问hbase:meta表位于哪个RegionServer
- Zookeeper返回信息:hbase:meta表所在的Region Server
- 访问对应的RegionServer,获取hbase:meta
- 根据读请求的
namespace:table/rowkey,查询目标在哪个RegionServer的哪个Region中 - 将该table的region信息以及meta表的位置信息缓存在客户端的MetaCache,方便下次访问
- 与目标RegionServer进行通讯
- 将数据顺序写入(追加)到WAL
- 将数据写入对应的MemStore,并排序
- 向客户端发送ack
- 等到MemStore的刷写时机后,将数据刷写StoreFile
hbase:meta
hbase:meta表保存了 含所有region的 列表
hbase:meta的位置 被储存在Zookeeper中
WAL
数据要经MemStore排序后才能刷写HFile,内存中的数据容易丢失
对此,数据会先写到Write-Ahead LogFile,然后再写入MemStore
在系统故障的时,可通过该日志文件重建数据
MemStore Flush
| MemStore刷写时机 | 说明 |
|---|---|
| MemStore级别 | 某个MemStore的大小达到(默认128M) |
| HRegion级别 | Region中所有MemStore总大小达到(默认512M) |
| HRegionServer级别 | RegionServer中所有MemStore总大小达到(默认 j a v a _ h e a p × 0.4 × 0.95 java\_heap \times 0.4 \times 0.95 java_heap×0.4×0.95) |
| HLog级别 | 当WAL文件的数量超过(默认32;新版已经废弃?) |
| 定期刷写 | (默认1小时) |
| 手动刷写 | flush 表名或flush 区域名分别对一个或多个Region进行刷写 |
读数据流程

GET:Table/RowKey- 客户端访问Zookeeper
- Zookeeper返回信息:hbase:meta表位于哪个RegionServer
- 访问对应的RegionServer的hbase:meta表
- 根据读
Table/RowKey查询出目标数据位于哪个RegionServer中的哪个Region中 - 将该table的region信息和meta表的位置信息缓存在客户端的MetaCache,以便下次访问
- 与目标RegionServer进行通讯
- 在BlockCache(读缓存)查询目标数据
- MemStore中查询目标数据,如果BlockCache中未查到相应数据则扫描对应的HFile文件,HFile中扫描到的数据块写入BlockCache,并将查到的 所有数据 进行合并
- 将合并后的最终结果返回给客户端
StoreFile Compaction(HBase文件合并精简)
MemStore每次刷写都会生成一个新HFile
同一字段不同版本(timestamp)和不同类型操作(Put/Delete)的数据可能分布在不同的HFile
查询时需要遍历所有的HFile,太多HFile会降低效率
为减少HFile个数,清理 过期的 和 删的 数据,会进行StoreFile Compaction
Compaction分两种:Minor Compaction和Major Compaction

| en | 🔉 | cn |
|---|---|---|
| compaction | kəmˈpækʃən | n. 压紧;精简;密封;凝结 |
| minor | ˈmaɪnər | adj. 未成年的;次要的;较小的;n. 未成年人;vi. 辅修 |
| major | ˈmeɪdʒər | adj. 主要的;重要的;主修的;n. [人类] 成年人;主修科目;vi. 主修 |
分区
Region Split(Region自动切分机制)
默认情况下,每个Table起初只有一个Region,随着数据的不断写入,Region会自动进行切分

预分区
- 每一个Region维护着Start Row与End Row
如果某数据符合某个Region的RowKey范围,则该数据交给这个Region维护 - 预先将数据所要投放的分区大致地规划好,可以提高HBase性能
create 'yy','f1',SPLITS=>['11','22']

RowKey设计
主要目的 :让数据均匀分布在所有Region,减少数据倾斜
| 设计原则 | 说明 | 备注 |
|---|---|---|
| 长度 | RowKey不能太长,一般<16字节 | RowKey过长会浪费磁盘空间 |
| 唯一性 | 两条数据的RowKey不能相同 | |
| 均匀分布 | 保证数据分散存储 |
| 设计方案 | e.g. |
|---|---|
| hash、散列值 | 原RowKey为1001,SHA-1 后变成dd01903921ea24941c26a48f2cec24e0bb0e8cc7 |
| 反转 | 20170524000001=>10000042507102 |
| 随机值 | 20170524000001=>ae86_20170524000001 |

 773


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


