


1、手写中文分词极简代码
- 徒手编写Scala中文分词【贝叶斯网络+动态规划】
- 点击此处可查看中文分词算法原理
- 用法:传入自定义词典(格式
Map[String, Int])创建对象,然后cut即可
import scala.collection.mutable
import scala.math.log10

class Tokenizer(var w2f: Map[String, Int]) {
  var total: Int = w2f.values.sum
  var maxLen: Int = w2f.keys.map(_.length).max
  val reEng = "[a-zA-Z]+"
  val reNum = "[0-9]+%?|[0-9]+[.][0-9]+%?"

  def cut(clause: String): mutable.ListBuffer[String] = {
    // 句子长度
    val len = clause.length
    // 有向无环图
    val DAG: mutable.Map[Int, mutable.ListBuffer[Int]] = mutable.Map()
    // 词图扫描
    for (head <- 0 until len) {
      val tail = len.min(head + maxLen)
      DAG.update(head, mutable.ListBuffer(head))
      for (mid <- (head + 2) until (tail + 1)) {
        val word = clause slice(head, mid)
        // 词库匹配
        if (w2f.contains(word)) DAG(head).append(mid - 1)
        // 英文匹配
        else if (word.matches(reEng)) DAG(head).append(mid - 1)
        // 数字匹配
        else if (word.matches(reNum)) DAG(head).append(mid - 1)
      }
    }
    // 最短路径
    val route: mutable.Map[Int, (Double, Int)] = mutable.Map(len -> (0.0, 0))
    // 概率对数总值
    val logTotal: Double = log10(total)
    // 动态规划
    for (idx <- Range(len - 1, -1, -1)) {
      var maxStatus: (Double, Int) = (-9e99, 0)
      for (x <- DAG(idx)) {
        val freq: Int = w2f.getOrElse(clause.slice(idx, x + 1), 1)
        val logFreq: Double = log10(freq)
        val lastStatus: Double = route(x + 1)._1
        val status: Double = logFreq - logTotal + lastStatus
        if (status > maxStatus._1) {
          maxStatus = (status, x)
        }
      }
      route.update(idx, maxStatus)
    }
    // 分词列表
    val words: mutable.ListBuffer[String] = mutable.ListBuffer()
    // 根据最短路径取词
    var x: Int = 0
    while (x < len) {
      val y: Int = route(x)._2 + 1
      val l_word: String = clause.slice(x, y)
      words.append(l_word)
      x = y
    }
    return words
  }
}
object Hello {
  def main(args: Array[String]): Unit = {
    val w2f = Map("空调" -> 2, "调和" -> 2, "和风" -> 2, "风扇" -> 2, "和" -> 2)
    val tk: Tokenizer = new Tokenizer(w2f)
    println(tk.cut("空调和风扇abc123"))
  }
}
-
分词结果
-
ListBuffer(空调, 和, 风扇, a, bc, 1, 23)
object Hello {
  def main(args: Array[String]): Unit = {
    val w2f = Map("空调" -> 2, "调和" -> 2, "和风" -> 2, "风扇" -> 2, "和" -> 2)
    val tk: Tokenizer = new Tokenizer(w2f)
    val a1 = List("空调和风扇", "空调和风99km", "99km", "空调风扇")
    val a2 = a1.flatMap(tk.cut)
    val a3 = a2.groupBy(e => e)
    val a4 = a3.map(kv => (kv._1, kv._2.length))
    println(a4.toList.sortBy(x => x._2).reverse)
  }
}
-
中文词频统计
-
List((空调,3), (风扇,2), (km,2), (99,2), (和风,1), (和,1))
2、中文分词+Spark词频统计
注意:分词器要继承序列化
class Tokenizer(var w2f: Map[String, Int]) extends Serializable {

  import scala.collection.mutable
  import scala.math.log10

  var total: Int = w2f.values.sum
  var maxLen: Int = w2f.keys.map(_.length).max
  val reEng = "[a-zA-Z]+"
  val reNum = "[0-9]+%?|[0-9]+[.][0-9]+%?"

  def cut(clause: String): mutable.ListBuffer[String] = {
    // 句子长度
    val len = clause.length
    // 有向无环图
    val DAG: mutable.Map[Int, mutable.ListBuffer[Int]] = mutable.Map()
    // 词图扫描
    for (head <- 0 until len) {
      val tail = len.min(head + maxLen)
      DAG.update(head, mutable.ListBuffer(head))
      for (mid <- (head + 2) until (tail + 1)) {
        val word = clause slice(head, mid)
        // 词库匹配
        if (w2f.contains(word)) DAG(head).append(mid - 1)
        // 英文匹配
        else if (word.matches(reEng)) DAG(head).append(mid - 1)
        // 数字匹配
        else if (word.matches(reNum)) DAG(head).append(mid - 1)
      }
    }
    // 最短路径
    val route: mutable.Map[Int, (Double, Int)] = mutable.Map(len -> (0.0, 0))
    // 概率对数总值
    val logTotal: Double = log10(total)
    // 动态规划
    for (idx <- Range(len - 1, -1, -1)) {
      var maxStatus: (Double, Int) = (-9e99, 0)
      for (x <- DAG(idx)) {
        val freq: Int = w2f.getOrElse(clause.slice(idx, x + 1), 1)
        val logFreq: Double = log10(freq)
        val lastStatus: Double = route(x + 1)._1
        val status: Double = logFreq - logTotal + lastStatus
        if (status > maxStatus._1) {
          maxStatus = (status, x)
        }
      }
      route.update(idx, maxStatus)
    }
    // 分词列表
    val words: mutable.ListBuffer[String] = mutable.ListBuffer()
    // 根据最短路径取词
    var x: Int = 0
    while (x < len) {
      val y: Int = route(x)._2 + 1
      val l_word: String = clause.slice(x, y)
      words.append(l_word)
      x = y
    }
    return words
  }
}

object Hello {
  def main(args: Array[String]): Unit = {
    // 创建SparkContext对象,传入SparkConf配置
    import org.apache.spark.{SparkContext, SparkConf}
    val conf = new SparkConf().setAppName("a").setMaster("local[2]")
    val sc = new SparkContext(conf)
    // 创建中文分词器
    val w2f = Map("空调" -> 2, "调和" -> 2, "和风" -> 2, "风扇" -> 2, "和" -> 2)
    val tk: Tokenizer = new Tokenizer(w2f)
    // 制作第一个RDD
    val r = sc.makeRDD(Seq("空调和风扇", "空调和风99km", "99km", "空调风扇"))
    // 中文分词、词频统计、降序
    print(r.flatMap(tk.cut).map((_, 1)).reduceByKey(_ + _).collect.sortBy(~_._2).toList)
    // 关闭连接
    sc.stop()
  }
}
结果打印
List((空调,3), (km,2), (99,2), (风扇,2), (和风,1), (和,1))
3、中文分词+Spark文本分类
继承
org.apache.spark.ml.feature.Tokenizer,重写createTransformFunc
import org.apache.spark.ml.feature.Tokenizer

class Jieba(var w2f: Map[String, Int]) extends Tokenizer {

  import scala.collection.mutable
  import scala.math.log10

  var total: Int = w2f.values.sum
  var maxLen: Int = w2f.keys.map(_.length).max
  val reEng = "[a-zA-Z]+"
  val reNum = "[0-9]+%?|[0-9]+[.][0-9]+%?"

  def cut(clause: String): Seq[String] = {
    // 句子长度
    val len = clause.length
    // 有向无环图
    val DAG: mutable.Map[Int, mutable.ListBuffer[Int]] = mutable.Map()
    // 词图扫描
    for (head <- 0 until len) {
      val tail = len.min(head + maxLen)
      DAG.update(head, mutable.ListBuffer(head))
      for (mid <- (head + 2) until (tail + 1)) {
        val word = clause slice(head, mid)
        // 词库匹配
        if (w2f.contains(word)) DAG(head).append(mid - 1)
        // 英文匹配
        else if (word.matches(reEng)) DAG(head).append(mid - 1)
        // 数字匹配
        else if (word.matches(reNum)) DAG(head).append(mid - 1)
      }
    }
    // 最短路径
    val route: mutable.Map[Int, (Double, Int)] = mutable.Map(len -> (0.0, 0))
    // 概率对数总值
    val logTotal: Double = log10(total)
    // 动态规划
    for (idx <- Range(len - 1, -1, -1)) {
      var maxStatus: (Double, Int) = (-9e99, 0)
      for (x <- DAG(idx)) {
        val freq: Int = w2f.getOrElse(clause.slice(idx, x + 1), 1)
        val logFreq: Double = log10(freq)
        val lastStatus: Double = route(x + 1)._1
        val status: Double = logFreq - logTotal + lastStatus
        if (status > maxStatus._1) {
          maxStatus = (status, x)
        }
      }
      route.update(idx, maxStatus)
    }
    // 分词列表
    val words: mutable.ListBuffer[String] = mutable.ListBuffer()
    // 根据最短路径取词
    var x: Int = 0
    while (x < len) {
      val y: Int = route(x)._2 + 1
      val l_word: String = clause.slice(x, y)
      words.append(l_word)
      x = y
    }
    words
  }

  override protected def createTransformFunc: String => Seq[String] = {
    cut
  }
}

object Hello {
  def main(args: Array[String]): Unit = {
    //创建SparkSession对象
    import org.apache.spark.sql.SparkSession
    val spark: SparkSession = SparkSession.builder()
      .master("local[*]").appName("a1").getOrCreate()
    //隐式转换支持
    import spark.implicits._
    // 中分分词器
    val jieba = new Jieba(
      """
        |优秀 好味 精彩 软滑 白嫩 干货 超神 醍醐灌顶 不要不要的 普通 一般般 无感 中规中矩
        |乏味 中立 还行 可以可以 难吃 金玉其外 发货慢 无语 弱鸡 呵呵 水货 渣渣 超鬼
        |""".stripMargin.split("\\s").filter(_.nonEmpty).map((_, 2)).toMap
    )
    // 创建数据
    val label = Seq(("好评", 0), ("中评", 1), ("差评", 2))
    val sentenceDf = Seq(
      ("好评", "优秀好味精彩软滑白嫩干货超神醍醐灌顶不要不要的"),
      ("中评", "普通一般般无感中规中矩乏味中立还行可以可以"),
      ("差评", "难吃金玉其外发货慢无语弱鸡呵呵水货渣渣超鬼"),
    ).toDF("comment", "sentence")
    val yx = sentenceDf.join(label.toDF("comment", "label"), "comment")
    // 特征工程
    import org.apache.spark.ml.feature.{HashingTF, IDF}
    // 分词
    val tokenizer = jieba.setInputCol("sentence").setOutputCol("words")
    val wordsDf = tokenizer.transform(yx)
    // 编码
    val hashingTF = new HashingTF()
      .setInputCol("words").setOutputCol("rawFeatures").setNumFeatures(10)
    val hashingDf = hashingTF.transform(wordsDf)
    // TF-IDF训练+转换
    val idf = new IDF().setInputCol("rawFeatures").setOutputCol("features")
    val idfModel = idf.fit(hashingDf)
    val tfidfDf = idfModel.transform(hashingDf)
    tfidfDf.show(numRows = 9, truncate = false)
    // 逻辑回归
    import org.apache.spark.ml.classification.LogisticRegression
    val lr = new LogisticRegression()
      .setFeaturesCol("features")
      .setLabelCol("label")
      .setPredictionCol("prediction")
      .setProbabilityCol("Probability")
    // 逻辑回归拟合
    val fittedLr = lr.fit(tfidfDf)
    // 预测
    val prediction = fittedLr.transform(
      idfModel.transform(
        hashingTF.transform(
          tokenizer.transform(
            Seq("无感乏味", "呵呵渣渣", "干货好味").toDF("sentence")
          )
        )
      )
    )
    prediction
      .join(label.toDF("predictedComment", "prediction"), "prediction")
      .select("sentence", "words", "predictedComment").show()
  }
}
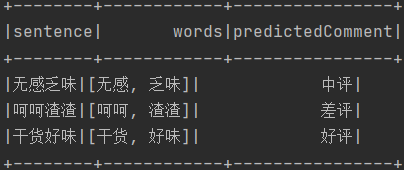
结果打印
4、HMM分词(不带词典)
import scala.collection.mutable

class HmmTokenizer {
  val minDouble: Double = Double.MinValue
  val PrevStatus: Map[Char, String] = Map(
    'B' -> "ES",
    'M' -> "MB",
    'S' -> "SE",
    'E' -> "BM")
  val startP: Map[Char, Double] = Map(
    'B' -> -0.26268660809250016,
    'E' -> minDouble,
    'M' -> minDouble,
    'S' -> -1.4652633398537678)
  val transP: Map[Char, Map[Char, Double]] = Map(
    'B' -> Map('E' -> -0.51082562376599, 'M' -> -0.916290731874155),
    'E' -> Map('B' -> -0.5897149736854513, 'S' -> -0.8085250474669937),
    'M' -> Map('E' -> -0.33344856811948514, 'M' -> -1.2603623820268226),
    'S' -> Map('B' -> -0.7211965654669841, 'S' -> -0.6658631448798212)
  )
  val emitP: Map[Char, mutable.Map[Char, Double]] = Map(
    'B' -> mutable.Map(),
    'E' -> mutable.Map(),
    'M' -> mutable.Map(),
    'S' -> mutable.Map())
  val states: Array[Char] = Array('B', 'M', 'E', 'S')

  def viterbi(obs: String): mutable.ListBuffer[Char] = {
    val V: mutable.ListBuffer[mutable.Map[Char, Double]] = mutable.ListBuffer(mutable.Map())
    var path: mutable.Map[Char, mutable.ListBuffer[Char]] = mutable.Map()
    for (y: Char <- states) {
      V.head.update(y, startP(y) + emitP(y).getOrElse(obs(0), minDouble))
      path.update(y, mutable.ListBuffer(y))
    }
    for (t <- 1 until obs.length) {
      V.append(mutable.Map())
      val newPath: mutable.Map[Char, mutable.ListBuffer[Char]] = mutable.Map()
      for (y: Char <- states) {
        val emP = emitP(y).getOrElse(obs(t), minDouble)
        val probState: mutable.ListBuffer[(Double, Char)] = mutable.ListBuffer()
        for (y0 <- PrevStatus(y)) {
          probState.append((V(t - 1)(y0) + transP(y0).getOrElse(y, minDouble) + emP, y0))
        }
        val (prob, state): (Double, Char) = probState.max
        V(t)(y) = prob
        newPath(y) = path(state) ++ mutable.ListBuffer(y)
      }
      path = newPath
    }
    val probE = V(obs.length - 1)('E')
    val probS = V(obs.length - 1)('S')
    if (probE > probS) path('E') else path('S')
  }

  def cut_without_dict(clause: String): mutable.ListBuffer[String] = {
    val posList = viterbi(clause)
    var (begin, nextI) = (0, 0)
    val words: mutable.ListBuffer[String] = mutable.ListBuffer()
    for (i <- 0 until clause.length) {
      val pos = posList(i)
      if (pos == 'B') {
        begin = i
      }
      else if (pos == 'E') {
        words.append(clause.slice(begin, i + 1))
        nextI = i + 1
      }
      else if (pos == 'S') {
        words.append(clause.slice(i, i + 1))
        nextI = i + 1
      }
    }
    if (nextI < clause.length) {
      words.append(clause.substring(nextI))
    }
    words
  }
}
测试
object Hello {
  def main(args: Array[String]): Unit = {
    val hmm: HmmTokenizer = new HmmTokenizer
    hmm.emitP('B')('南') = -5.5
    hmm.emitP('M')('南') = -9.9
    hmm.emitP('E')('南') = -9.9
    hmm.emitP('S')('南') = -9.9
    hmm.emitP('B')('门') = -6.6
    hmm.emitP('M')('门') = -9.9
    hmm.emitP('E')('门') = -4.4
    hmm.emitP('S')('门') = -9.9
    hmm.emitP('B')('大') = -9.9
    hmm.emitP('M')('大') = -8.8
    hmm.emitP('E')('大') = -3.3
    hmm.emitP('S')('大') = -9.9
    hmm.emitP('B')('的') = -9.9
    hmm.emitP('M')('的') = -9.9
    hmm.emitP('E')('的') = -9.9
    hmm.emitP('S')('的') = -1.1
    println(hmm.emitP)                          // ListBuffer(B, E, S, B, M, E)
    println(hmm.cut_without_dict("南大的南大门")) // ListBuffer(南大, 的, 南大门)
  }
}
5、HMM分词
import scala.collection.mutable
import scala.math.log10

class Hmm {
  val minDouble: Double = Double.MinValue
  val PrevStatus: Map[Char, String] = Map(
    'B' -> "ES",
    'M' -> "MB",
    'S' -> "SE",
    'E' -> "BM")
  val startP: Map[Char, Double] = Map(
    'B' -> -0.26268660809250016,
    'E' -> minDouble,
    'M' -> minDouble,
    'S' -> -1.4652633398537678)
  val transP: Map[Char, Map[Char, Double]] = Map(
    'B' -> Map('E' -> -0.51082562376599, 'M' -> -0.916290731874155),
    'E' -> Map('B' -> -0.5897149736854513, 'S' -> -0.8085250474669937),
    'M' -> Map('E' -> -0.33344856811948514, 'M' -> -1.2603623820268226),
    'S' -> Map('B' -> -0.7211965654669841, 'S' -> -0.6658631448798212)
  )
  val emitP: Map[Char, mutable.Map[Char, Double]] = Map(
    'B' -> mutable.Map(),
    'E' -> mutable.Map(),
    'M' -> mutable.Map(),
    'S' -> mutable.Map())
  val states: Array[Char] = Array('B', 'M', 'E', 'S')

  def viterbi(obs: String): mutable.ListBuffer[Char] = {
    val V: mutable.ListBuffer[mutable.Map[Char, Double]] = mutable.ListBuffer(mutable.Map())
    var path: mutable.Map[Char, mutable.ListBuffer[Char]] = mutable.Map()
    for (y: Char <- states) {
      V.head.update(y, startP(y) + emitP(y).getOrElse(obs(0), minDouble))
      path.update(y, mutable.ListBuffer(y))
    }
    for (t <- 1 until obs.length) {
      V.append(mutable.Map())
      val newPath: mutable.Map[Char, mutable.ListBuffer[Char]] = mutable.Map()
      for (y: Char <- states) {
        val emP = emitP(y).getOrElse(obs(t), minDouble)
        val probState: mutable.ListBuffer[(Double, Char)] = mutable.ListBuffer()
        for (y0 <- PrevStatus(y)) {
          probState.append((V(t - 1)(y0) + transP(y0).getOrElse(y, minDouble) + emP, y0))
        }
        val (prob, state): (Double, Char) = probState.max
        V(t)(y) = prob
        newPath(y) = path(state) ++ mutable.ListBuffer(y)
      }
      path = newPath
    }
    val probE = V(obs.length - 1)('E')
    val probS = V(obs.length - 1)('S')
    if (probE > probS) path('E') else path('S')
  }

  def cutWithoutDict(clause: String): mutable.ListBuffer[String] = {
    val posList = viterbi(clause)
    var (begin, nextI) = (0, 0)
    val words: mutable.ListBuffer[String] = mutable.ListBuffer()
    for (i <- 0 until clause.length) {
      val pos = posList(i)
      if (pos == 'B') {
        begin = i
      }
      else if (pos == 'E') {
        words.append(clause.slice(begin, i + 1))
        nextI = i + 1
      }
      else if (pos == 'S') {
        words.append(clause.slice(i, i + 1))
        nextI = i + 1
      }
    }
    if (nextI < clause.length) {
      words.append(clause.substring(nextI))
    }
    words
  }
}

class Tokenizer(var w2f: Map[String, Int]) extends Hmm {
  var total: Int = w2f.values.sum
  var maxLen: Int = w2f.keys.map(_.length).max
  val reEng = "[a-zA-Z]+"
  val reNum = "[0-9]+%?|[0-9]+[.][0-9]+%?"

  def calculate(clause: String): mutable.Map[Int, (Double, Int)] = {
    // 句子长度
    val len = clause.length
    // 有向无环图
    val DAG: mutable.Map[Int, mutable.ListBuffer[Int]] = mutable.Map()
    // 词图扫描
    for (head <- 0 until len) {
      val tail = len.min(head + maxLen)
      DAG.update(head, mutable.ListBuffer(head))
      for (mid <- (head + 2) until (tail + 1)) {
        val word = clause slice(head, mid)
        // 词库匹配
        if (w2f.contains(word)) DAG(head).append(mid - 1)
        // 英文匹配
        else if (word.matches(reEng)) DAG(head).append(mid - 1)
        // 数字匹配
        else if (word.matches(reNum)) DAG(head).append(mid - 1)
      }
    }
    // 最短路径
    val route: mutable.Map[Int, (Double, Int)] = mutable.Map(len -> (0.0, 0))
    // 概率对数总值
    val logTotal: Double = log10(total)
    // 动态规划
    for (idx <- Range(len - 1, -1, -1)) {
      var maxStatus: (Double, Int) = (-9e99, 0)
      for (x <- DAG(idx)) {
        val freq: Int = w2f.getOrElse(clause.slice(idx, x + 1), 1)
        val logFreq: Double = log10(freq)
        val lastStatus: Double = route(x + 1)._1
        val status: Double = logFreq - logTotal + lastStatus
        if (status > maxStatus._1) {
          maxStatus = (status, x)
        }
      }
      route.update(idx, maxStatus)
    }
    route
  }

  def cutHmm(clause: String): mutable.ListBuffer[String] = {
    // 句子长度
    val len = clause.length
    // 计算最短路径
    val route: mutable.Map[Int, (Double, Int)] = calculate(clause)
    // 分词列表
    val words: mutable.ListBuffer[String] = mutable.ListBuffer()
    // 根据最短路径取词
    var x: Int = 0
    var buf = ""
    while (x < len) {
      val y = route(x)._2 + 1
      val lWord = clause.slice(x, y)
      if (y - x == 1) {
        buf += lWord
      } else {
        if (buf.nonEmpty) {
          if (buf.length == 1) {
            words.append(buf)
          } else {
            words.appendAll(cutWithoutDict(buf))
          }
          buf = ""
        }
        words.append(lWord)
      }
      x = y
    }
    if (buf.nonEmpty) {
      if (buf.length == 1) {
        words.append(buf)
      } else {
        words.appendAll(cutWithoutDict(buf))
      }
    }
    words
  }

  def cut(clause: String): mutable.ListBuffer[String] = {
    // 句子长度
    val len = clause.length
    // 计算最短路径
    val route: mutable.Map[Int, (Double, Int)] = calculate(clause)
    // 分词列表
    val words: mutable.ListBuffer[String] = mutable.ListBuffer()
    // 根据最短路径取词
    var x: Int = 0
    while (x < len) {
      val y: Int = route(x)._2 + 1
      val lWord: String = clause.slice(x, y)
      words.append(lWord)
      x = y
    }
    words
  }
}

object Hello {
  def main(args: Array[String]): Unit = {
    val w2f = Map("空调" -> 2, "调和" -> 2, "和风" -> 2, "风扇" -> 2, "和" -> 2)
    val tk: Tokenizer = new Tokenizer(w2f)
    tk.emitP('B')('南') = -5.5
    tk.emitP('M')('南') = -9.9
    tk.emitP('E')('南') = -9.9
    tk.emitP('S')('南') = -9.9
    tk.emitP('B')('门') = -6.6
    tk.emitP('M')('门') = -9.9
    tk.emitP('E')('门') = -4.4
    tk.emitP('S')('门') = -9.9
    tk.emitP('B')('大') = -9.9
    tk.emitP('M')('大') = -8.8
    tk.emitP('E')('大') = -3.3
    tk.emitP('S')('大') = -9.9
    tk.emitP('B')('的') = -9.9
    tk.emitP('M')('的') = -9.9
    tk.emitP('E')('的') = -9.9
    tk.emitP('S')('的') = -1.1
    println(tk.cut("南门的大门空调和风扇99元"))
    // ListBuffer(南, 门, 的, 大, 门, 空调, 和, 风扇, 99, 元)
    println(tk.cutHmm("南门的大门空调和风扇99元"))
    // ListBuffer(南门, 的, 大门, 空调, 和, 风扇, 99, 元)
  }
}

 5059


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


