大数据(4d)Kafka安装和基本命令

BIgData 命令操作 查看 ps -ef | grep 名称 hive Zookeeper 开启与关闭 全部 开启 zkstart-all.sh 逐个节点关闭 zkServer.sh stop 时间同步 联网 ntpdate ntp4.aliyun.com 启动 HDFS 启动 start-all.sh 关闭 sto... 阅读详情

概述

  • Kafka:基于发布/订阅模式的 分布式的 消息队列
  • 主用场景:大数据实时处理、流量削峰、实时数仓
  • 官方教学:http://kafka.apache.org/documentation/

基础架构
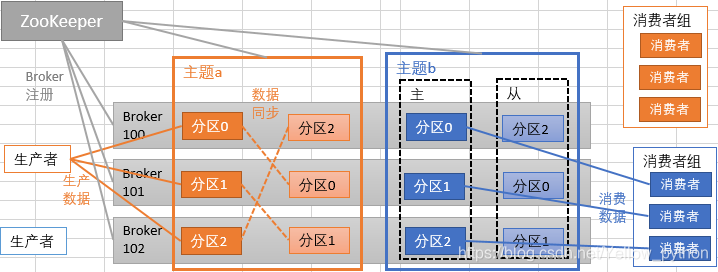
英文名译名说明
Producer生产者生产消息
Consumer消费者消费消息
Consumer Group消费者组由多个Consumer组成
是逻辑上的一个订阅者
Broker经纪人一台kafka服务器就是一个Broker
一个集群由多个Broker组成
一个Broker可以容纳多个topic的partition
Topic主题可以理解为一个存放消息的逻辑上的队列
一个topic可以分布到多个Broker
Partition分区一个topic可以分存多个partition
每个partition是一个有序的队列
Replica复制品数据副本
Leader首领对接生产者和消费者
Follower追随者实时同步leader的数据
leader故障时,某follower会成为新的leader

Kafka2.7.0安装

  1. 免密登录
  2. 环境变量
  3. 安装JDK1.8和ZooKeeper3.5.7
集群规划服务名hadoop100hadoop101hadoop102
ZooKeeperQuorumPeerMain111
KafkaKafka111

1、解压、改名

tar -zxf kafka_2.13-2.7.0.tgz -C /opt/
cd /opt/
mv kafka_2.13-2.7.0 kafka
ll

2、主要配置

版块参数说明
服务器基础broker.idbroker 编号,唯一的,每台机都不同
服务器基础delete.topic.enable是否允许删主题
(旧版默认false,新版默认true,所以本文不配置)
套接字num.network.threads处理网络请求的线程数
套接字num.io.threads处理磁盘IO的线程数
套接字socket.send.buffer.bytes发送套接字的缓冲区字节数
套接字socket.receive.buffer.bytes接收套接字的缓冲区字节数
套接字socket.request.max.bytes套接字接收请求的最大字节数
日志log.dirs日志存放的路径
日志num.partitions每个主题的默认分区数
日志num.recovery.threads.per.data.dir每个数据目录 启动时日志恢复 和 关闭时刷新 的线程数
日志保留log.retention.hours基于时间的日志保留策略(小时)
日志保留log.retention.bytes基于大小的日志保留策略(字节)
日志存储log.segment.bytes日志片段最大字节数
日志保留log.retention.check.interval.ms检查日志片段的周期(毫秒)
ZooKeeperzookeeper.connectZookeeper集群地址(逗号分隔)
  • delete.topic.enable旧版有新版没,已经默认允许删主题,所以此处不用配
  • 本文只配log.dirs(60行)和zookeeper.connect(123行)
vi $KAFKA_HOME/config/server.properties
log.dirs=/opt/kafka/logs
zookeeper.connect=hadoop100:2181,hadoop101:2181,hadoop102:2181/kafka
mkdir $KAFKA_HOME/logs

细节:/kafka表示在ZooKeeper集群根目录下创建名为kafka的节点,后续节点会在这个/kafka下创建

3、文件分发

rsync -a $KAFKA_HOME/ hadoop101:$KAFKA_HOME/
rsync -a $KAFKA_HOME/ hadoop102:$KAFKA_HOME/

然后修改每台机(貌似不能直接用ssh+vi)的broker.id,此处分别设为【100、101、102】

vi $KAFKA_HOME/config/server.properties

4、集群启停

先启动ZooKeeper集群,再启动Kafka集群

kafka-server-start.sh -daemon $KAFKA_HOME/config/server.properties
ssh hadoop101 "kafka-server-start.sh -daemon $KAFKA_HOME/config/server.properties"
ssh hadoop102 "kafka-server-start.sh -daemon $KAFKA_HOME/config/server.properties"
kafka-server-stop.sh
ssh hadoop101 "kafka-server-stop.sh"
ssh hadoop102 "kafka-server-stop.sh"

5、群起脚本

https://blog.youkuaiyun.com/Yellow_python/article/details/115862167

Kafka命令

参数说明备注
--topic主题名称
--replication-factor副本数
--partitions分区数
--zookeeperZooKeeper集群地址正在弃用
--bootstrap-server和--zookeeper类似,指Kafka集群地址建议使用

1、创建主题

kafka-topics.sh --create \
--zookeeper ZK地址:2181/kafka \
--replication-factor 副本数 \
--partitions 分区数 \
--topic 主题名称

2、查看有哪些主题

kafka-topics.sh --zookeeper ZK地址:2181/kafka --list

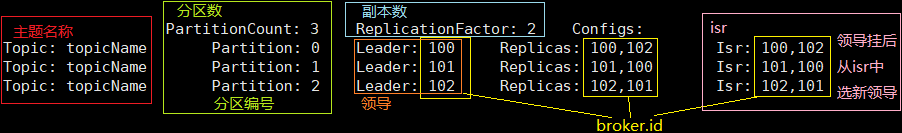
3、查看某主题的描述(附图!)

kafka-topics.sh --describe \
--zookeeper ZK地址:2181/kafka \
--topic 主题名称
4、生产和消费
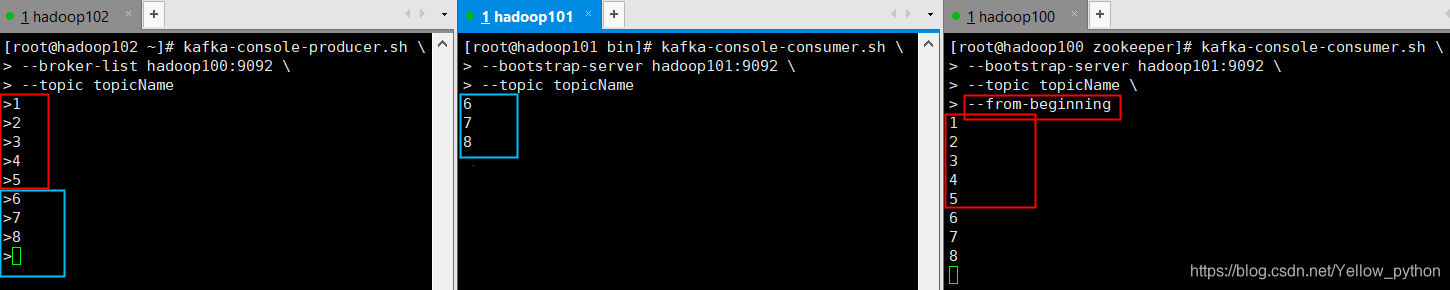
4.1、生产

kafka-console-producer.sh \
--broker-list Kafka地址:9092 \
--topic 主题名称

4.2、消费

  • --from-beginning会把主题以往所有数据都读取出来
  • --group指定消费者组
kafka-console-consumer.sh \
--bootstrap-server Kafka地址:9092 \
--topic 主题名称 \
--from-beginning \
--group 消费者组名称

5、使 Leader 负载均衡

kafka-preferred-replica-election.sh --zookeeper ZK地址:2181/kafka

6、修改主题(增大分区数)

可以增大分区数,不能减少

kafka-topics.sh --zookeeper ZK地址:2181/kafka --alter --topic 主题名 --partitions 6

7、删除主题

kafka-topics.sh --delete \
--zookeeper ZK地址:2181/kafka \
--topic 主题名

8、消费者组 的查看和删除

查看消费者组

kafka-consumer-groups.sh \
--describe \
--all-groups \
-all-topics \
--bootstrap-server hadoop102:9092

--delete --group删除消费者组

kafka-consumer-groups.sh \
--delete --group G1 \
--bootstrap-server hadoop102:9092

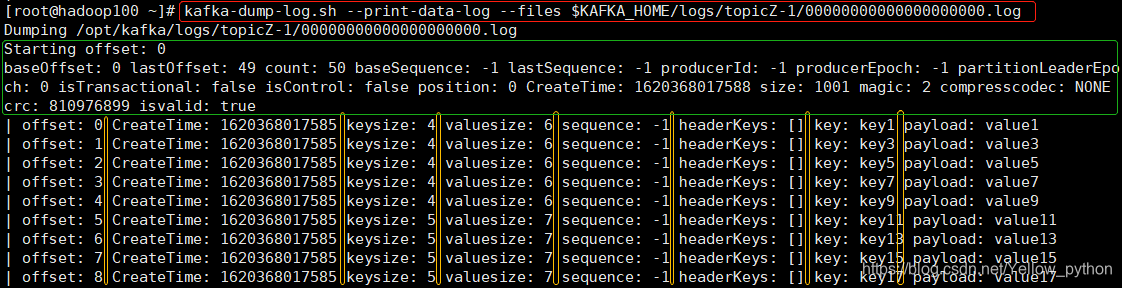
9、查看生产的内容

查看消息内容

kafka-dump-log.sh \
--print-data-log \
--files $KAFKA_HOME/logs/主题名-分区号/片段偏移量.log

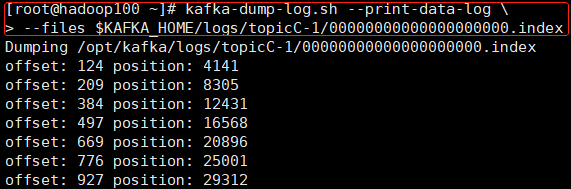
查看索引

kafka-dump-log.sh \
--print-data-log \
--files $KAFKA_HOME/logs/主题名-分区号/片段偏移量.index

查看消息内容

查看索引
新增:Kafka3版本集群部署

1、环境变量

# Kafka
export KAFKA_HOME=/opt/module/kafka
export PATH=$PATH:$KAFKA_HOME/bin

2、解压

tar -zxvf kafka_2.12-3.0.0.tgz
mv kafka_2.12-3.0.0 $KAFKA_HOME

3、配置

cd $KAFKA_HOME/config/
vim server.properties

修改内容(其中broker.id每台不一样)

broker.id=0
log.dirs=/opt/module/kafka/datas
zookeeper.connect=hadoop105:2181,hadoop106:2181,hadoop107:2181/kafka

4、分发,分发后修改每台机的broker.id

rsync.py $KAFKA_HOME

5、先启动ZooKeeper集群,然后每台机启动Kafka

kafka-server-start.sh -daemon config/server.properties

6、创建主题

kafka-topics.sh --bootstrap-server hadoop105:9092 \
--create --partitions 3 --replication-factor 1 --topic temp01

7、查看主题列表

kafka-topics.sh --bootstrap-server hadoop105:9092 --list

8、生产

kafka-console-producer.sh --bootstrap-server hadoop105:9092 --topic temp01

9、消费

kafka-console-consumer.sh --bootstrap-server hadoop105:9092 --topic temp01
大数据实时计算---Kafka介绍(上) 在介绍大数据实时计算介绍之前,我们先介绍大数据使用的消息中间件Kafka,在大数据中经常会被用到。 Kafka基本概念 Kafka集群的搭建 Kafka集群的操作 ApacheKafka的概念 我们从三个方面去理解什么是kafka Apache Kafka 是一个消息队列(生产者消费者模式) Apache Kafka 目标:构建企业中统一的、高通量、低延时的消息平台。 大多的是消息队列(... 阅读详情

相关推荐

大数据Kafka(六):安装Kafka-Eagle

在开发工作中,当业务前提不复杂时,可以使用Kafka命令来进行一些集群的管理工作。但如果业务变得复杂,例如 :我们需要增加group、topic分区,此时,我们再使用命令行就感觉很不方便,此时,如果使用一个可视化的工具帮助我们完成日常的管理工作,将会大大提高对于Kafka集群管理的效率,而且我们使用工具来监控消费者在Kafka中消费情况。

Lansonli(蓝深李)的博客 2103

大数据(4c)Kafka理论知识

帅气的目录1、基础理论1.1、什么是消息队列1.2、消息队列的两种模式1.3、高可用原理2、Kafka概述3、 1、基础理论 1.1、什么是消息队列 Message Queue 消息的传输过程中保存消息的容器 应用场景:程序解耦、异步消息、流量削锋… 1.2、消息队列的两种模式 点对点模式(消费者主动拉取数据,拉取成功后删除队列上的数据) 一个消息 只能有一个消费者可以消费 发布/订阅模式(消费者消费数据之后,队列上的数据不会被清除) 1.3、高可用原理 High Availability

ArYe 1635

大数据Kafka(三):Kafka的集群搭建以及shell启动命令脚本编写

为了方便将来进行一键启动、关闭Kafka,我们可以编写一个shell脚本来操作。将来只要执行一次该脚本就可以快速启动/关闭Kafka。Kafka的所有执行脚本都在这里。例如:启动Kafka服务器、创建Topic、生产者、消费者程序等等。Kafka的所有日志文件,如果Kafka出现一些问题,需要到该目录中去查看异常信息。或者通过 zookeeper查看 brokers节点目录下, 是否有三个ids。运行Kafka所需要的所有JAR包。Kafka的所有配置文件。Kafka的网站帮助文件。

Lansonli(蓝深李)的博客 3254

Postgresql vacuum最佳实践

Postgresql作为世界上最先进的HTAP数据库,以其超高在线事务处理及分析性能和强大的功能被广泛应用与各行各业中。但其实它也并不完美,说到postgres,不得不提那个让人一直头疼的问题,也是数据库使用者锁诟病最多的地方:vacuum。那么为什么会有vacuum这个东西呢?它是做什么用的呢? 我们先来聊聊postgresql的mvcc机制,我们知道,postgresql是没有undo...

数据库架构之美 1万+

华为P30/pro (ELE-AL00) 鸿蒙4.2降级 EMUI 9

分享

m0_52356707的博客 1万+

vivado Block Design 设计 .tcl 文件使用,导出,修改,添加方式

在vivado中生成 Block Design可以导出tcl文件进行保存(体积小),或者在别的版本vivado中打开(版本互通),这是一个非常好的功能。另外GitHub中很多项目都是采用这种方式上传的,学会如何使用可以快速修改历程项目。

2203_75345038的博客 2494

kafka安装与集群部署(for Linux)(八)

分别在 hadoop103 和 hadoop104 上修改配置文件/opt/module/kafka/config/server.properties。因为 Zookeeper 集群当中记录着 Kafka 集群相关信息,Zookeeper 集群一旦先停止,Kafka 集群就没有办法再获取停止进程的信息,只能手动杀死 Kafka 进程了(kill -9 端口)。(1)在/etc/profile.d/my_env.sh 文件中增加 kafka 环境变量配置。kafka在整个集群中的身份唯一标识,不能重复。

s980629的博客 2031

STM32MP157+AD7606BSTZ四通道IEPE传感器控制器实战(附电路图)

本文详细介绍了基于STM32MP157和AD7606BSTZ的四通道IEPE传感器控制器设计实战,涵盖硬件架构、数据采集芯片对比、关键电路设计及信号处理算法。通过双核协同工作和优化算法,实现高精度振动监测与故障诊断,适用于工业机械状态监测等场景。

weixin_29171129的博客 368

python中kafka的安装和使用教程

Kafka是一个分布式流处理系统,流处理系统使它可以像消息队列一样publish(发布)或者subscribe(订阅)消息,分布式提供了容错性,并发处理消息的机制。kafka运行在集群上,集群包含一个或多个服务器。kafka把消息存在topic中,每一条消息包含键值(key),值(value)和时间戳(timestamp)。

菜鸡小白的成长记录 8146

STM32外部中断EXTI原理与飞控实时应用实战

外部中断(EXTI)是嵌入式系统中实现事件驱动和实时响应的核心机制,其本质是将外部电平变化转化为可调度的CPU中断事件。基于ARM Cortex-M NVIC架构,EXTI通过GPIO-EXTI-NVIC三级硬件通路实现低延迟信号捕获,具备边沿触发、优先级管理与挂起控制等关键能力。在四轴飞控、工业传感器、人机交互等对毫秒级响应有强需求的场景中,EXTI显著优于轮询方式,兼顾实时性与CPU资源效率。实际开发需严格遵循SYSCFG映射→EXTI配置→NVIC使能的时序逻辑,并规避常见陷阱如中断号误配、伪触发、低

weixin_36382073的博客 66

Host是如何与EC通信的

EC中有三个寄存器,分别为状态寄存器EC_SC、命令寄存器EC_SC和数据寄存器EC_DATA。而状态寄存器和命令寄存器同属于一个寄存器,这几个寄存器遵循着ACPI EC规范。host可以根据ACPI协议规范来与EC进行通信。 以下是个寄存器的详细介绍。 EC状态寄存器(EC_SC(R)),该寄存器是一个只读寄存器,它反映了此时EC接口的状态。下图为该寄存器表。 EC状态寄存器表中各位的具体含义: OBF(Output Buffer is Full),该状态位置1...

qq_30135687的博客 3699

kafka-eagle查询不到kafka信息

一般搭建kafka监控的时候kafka和zk都已经搭建好了这里需要主意一个地方 1.kafka需要开启JMX端口 找到kafka安装路径,进入到bin文件夹,修改下面的地方。 vi kafka-server-start.sh if [ "x$KAFKA_HEAP_OPTS" = "x" ]; then export KAFKA_HEAP_OPTS="-server -Xms2G -Xmx2G -XX:PermSize=128m -XX:+UseG1GC -XX:...

奔跑入坑大数据 3076

Sigrity Power DC Package Multi-Resistor Compact ET Model Extraction模式提取封装基板电热阻模型

DIE(定义DIE的参数):material设置为silicon(硅),Attach material(贴片的材料,设置为Die Attach),Attach thickness(贴片的材料的厚度,厚度设置为0.001mm,点击ok。Cap为覆盖材料,Material定义材料类型,thickness定义厚度,length和width定义长宽,Adhesive Material为胶的材料,Adhesive Material为胶的厚度,本例不定义,跳过即可。

weixin_54787054的博客 440

SQLserver通过OGG for bigdata对接Kafka

1. OGG五大进程的功能 Manager进程是GoldenGate的控制进程,运行在源端和目标端上。它主要作用有以下几个方面:启动、监控、重启Goldengate的其他进程,报告错误及事件,分配数据存储空间,发布阀值报告等。在目标端和源端有且只有一个manager进程 Extract运行在数据库源端,负责从源端数据表或者日志中捕获数据。Extract的作用可以按照阶段来划分为: – 初...

Gain_TF的博客 1944

【碳排放数据集】全球近实时网格化二氧化碳排放数据集GRACED

【碳排放数据集】全球近实时网格化二氧化碳排放数据集GRACED

WW、forever的博客 146

超详细!Linux 服务器 6 大核心性能测试(附自动脚本 + 结果分析秘籍)---Linux 服务器性能测试文档

本文档旨在提供 Linux 服务器的 CPU、内存和磁盘性能测试方案,包括详细的测试大纲、操作步骤以及一键化测试脚本,帮助管理员快速评估服务器性能状况。通过以上测试方案,可以全面评估 Linux 服务器的 CPU、内存和磁盘性能,为系统优化、容量规划和问题排查提供重要参考依据。使用 sysbench 进行 CPU 基准测试。使用 sysbench 测试内存读写性能。使用 fio 工具进行更全面的磁盘测试。使用 dd 命令测试磁盘顺序读写性能。使用 dd 命令测试内存读写速度。记录磁盘 IO 性能。

jundao1997的专栏 381

kafka学习01-基本安装和使用

kafka学习01

qq_44768571的博客 1117

STM32F407中文手册

STM32f407中文手册 本参考手册面向应用开发人员,提供有关使用 STM32F405xx/07xx、STM32F415xx/17xx、 STM32F42xxx 和 STM32F43xxx 微控制器存储器与外设的完整信息。STM32F405xx/07xx、STM32F415xx/17xx、STM32F42xxx 和 STM32F43xxx 构成一个微 控制器系列,各产品具有不同的存储器大小、封装和外设。有关订购信息以及器件的机械与电气特性,请参见数据手册。有关 ARM Cortex™-M4F 内核的信息,请参见《Cortex™-M4F 技术参考手册》。

【快速入门】Kafka的安装部署

前提:在安装Kafka前要确保你的集群中有zookeeper我的三台服务器分别是bigdata01,bigdata02,bigdata03,并且修改了本机的hosts文件!

song的博客 4957

OV9734 DATASHEET,完整规格书

OV9734完整规格书,包括电气参数,尺寸规格,寄存器配置表等

LinePhone3.2.7(android端最新版本) sip客户端

SIP客户端For android:LinePhone3.2.7(最新版本),官网地址:http://www.linphone.org/

Kafka在Windows和CentOS的安装实践

Kafka是一个分布式的基于发布/订阅模式的消息队列(Message Queue),主要应用于大数据实时处理领域;支持分区的、多副本,基于zookeeper协调的分布式消息系统

风雨无阻学习之路 1469

jdk-8u144-linux-x64.tar.gz.

该资源为搭建Linux系统Java环境用,资源的后缀为tar.gz格式的压缩包

摸鱼大数据——Kafka——Kafka的shell命令使用

Kafka本质上就是一个消息队列的中间件的产品,主要负责消息数据的传递。也就说学习Kafka 也就是学习如何使用Kafka生产数据,以及如何使用Kafka来消费数据。

weixin_65694308的博客 1626

kafka基础【kafka的概述、安装、命令行操作】

一 kafka概述 1 kafka定义 kafka是一个分布式的基于发布/订阅模式的消息队列(Message Queue)。类似于一个有顺序的缓冲区,将访问的信息缓冲起来,减少服务器的压力,主要应用于大数据实时处理领域。 点对点模式:一对一,消费者主动拉取数据,消息收到后消息清除。消息生产者生产消息发送到Queue中,然后消息消费者从Queue中取出并且消费消息。消息被消费以后,queue中不再有存储,所以消息消费者不可能消费到已经被消费的消息。Queue支持存在多个消费者,但是对一个消息而言,只会有一个

weixin_43923463的博客 2560

D012 复制粘贴玩大数据之Dockerfile安装Kafka集群

0x00 教程内容 0x01 Dockerfile文件的编写 1. 编写Dockerfile文件 2. 编写Dockerfile文件的关键点 3. 完整的Dockerfile文件参考 0x02 校验Kafka前准备工作 1. 环境及资源准备 0x03 校验Kafka是否安装成功 1. 修改生成容器脚本 2. 生成镜像 3. 生成容器 4. 启动Kafka 0xFF 总结

邵奈一的博客 1120

kafka 在Linux上的安装部署

通过以上步骤,我们在 Linux 系统上成功安装和部署了 Kafka。在实际应用中,可以根据具体的业务需求进一步配置和优化 Kafka,如设置更复杂的安全机制、调整性能参数等。希望本教程对大家有所帮助,让大家能够顺利开启 Kafka 之旅。

m0_56341622的博客 5161

大数据开发之Kafka和Kafka Restful Proxy的入门教程

消费者会定期将自己消费分区的offset提交给__consumer_offsets,key是consumerGroupId+topic+分区号,value就是当前offset的值,并且kafka会定期清理topic里的消息仅保留最新的那条数据,通过如下公式可以选出consumer消费的offset要提交到__consumer_offsets的哪个分区。新消费组中的消费者在启动以后,默认会从当前分区的最后⼀条消息的offset+1开始消费(消费新消息)。可以通过以下的设置,让新的消费者第⼀次从头开始消费。

刻苦的樊同学 1563

【大数据】Kafka-3.5.0安装

Kafka传统定义:是一个分布式的基于发布/订阅模式的消息队列(Message Queue),主要应用于大数据实时处理领域。发布/订阅模式:消息的发布者不会将消息直接发送给特定的订阅者,而是将发布的消息分为不同的类别,订阅者只接收感兴趣的消息Kafka最新定义:是一个开源的分布式事件流平台 (Event StreamingPlatform),被数千家公司用于高性能数据管道、流分析、数据集成和关键任务应用。

YG15165的博客 908

Kafka 安装教程

Kafka 是一种高性能、分布式的消息队列系统,广泛应用于大数据实时处理场景中。本文将详细介绍如何在 Linux 环境中安装和配置 Kafka,希望对初学者有所帮助。至此,我们成功在 Linux 系统上安装并配置了 Kafka,并进行了简单的消息收发测试。

m0_70691645的博客 1843
上一篇: 大数据(1c)集群环境变量,持续更
下一篇: 大数据(7e)Scala方法和函数的简化过程
小基基o_O
博客等级 码龄9年 4414粉丝 467原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包

打赏作者

小基基o_O

您的鼓励是我创作的巨大动力

¥1 ¥2 ¥4 ¥6 ¥10 ¥20
扫码支付:¥1
获取中
扫码支付

您的余额不足,请更换扫码支付或充值

打赏作者

实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值