大数据(1c)集群环境变量,持续更

基于Flink+Kafka+Hadoop+Hive的智能物流大数据平台实战指南 大数据技术栈的核心在于构建端到端的数据处理链路,其原理是通过分布式架构对海量数据进行采集、存储、计算与分析。实时计算与离线批处理相结合的技术方案,为业务决策提供了从即时响应到深度洞察的全面支持,具有极高的技术价值。在物流、电商、金融等众多领域,此类架构被广泛应用于实时监控、智能分析与报表生成等场景。本文聚焦于一个典型的智能物流大数据分析平台,详细拆解了如何整合Flink、Kafka、Hadoop和Hive这四大核心组件,构建从数据实时接入到可视化展示的完整实战系统,涵盖了环境部署、功能验证及常见问题排查的全 阅读详情

阅读本文前,请先配置好集群免密登录

1、环境变量文件

vim /etc/profile.d/custom.sh
# Big Data:大数据根目录
export B_HOME=/opt
# Java
export JAVA_HOME=$B_HOME/jdk
export PATH=$PATH:$JAVA_HOME/bin
# Zookeeper
export ZOOKEEPER_HOME=$B_HOME/zookeeper
export PATH=$PATH:$ZOOKEEPER_HOME/bin
# Hadoop
export HADOOP_HOME=$B_HOME/hadoop
export PATH=$PATH:$HADOOP_HOME/bin:$HADOOP_HOME/sbin
# HIVE
export HIVE_HOME=$B_HOME/hive
export PATH=$PATH:$HIVE_HOME/bin
# Spark
export SPARK_HOME=$B_HOME/spark
export PATH=$PATH:$SPARK_HOME/bin
# Kafka
export KAFKA_HOME=$B_HOME/kafka
export PATH=$PATH:$KAFKA_HOME/bin
# Flume
export FLUME_HOME=$B_HOME/flume
export PATH=$PATH:$FLUME_HOME/bin
# Sqoop
export SQOOP_HOME=$B_HOME/sqoop
export PATH=$PATH:$SQOOP_HOME/bin
# HBase
export HBASE_HOME=$B_HOME/hbase
export PATH=$PATH:$HBASE_HOME/bin
# Scala
export SCALA_HOME=$B_HOME/scala
export PATH=$PATH:$SCALA_HOME/bin
# Flink
export FLINK_HOME=$B_HOME/flink
# Phoenix
export PHOENIX_HOME=$B_HOME/phoenix
export PHOENIX_CLASSPATH=$PHOENIX_HOME
export PATH=$PATH:$PHOENIX_HOME/bin
# ElasticSearch
export ES_HOME=$B_HOME/elasticsearch
# Maven
export MAVEN_HOME=$B_HOME/maven
export PATH=$PATH:$MAVEN_HOME/bin
# Atlas
export ATLAS_HOME=$B_HOME/atlas
# DolphinScheduler
#export DOLPHINSCHEDULER_HOME=$B_HOME/dolphinscheduler

用户为root时需要添加下面变量

# Hadoop user
export HDFS_NAMENODE_USER=root
export HDFS_DATANODE_USER=root
export HDFS_SECONDARYNAMENODE_USER=root
export YARN_RESOURCEMANAGER_USER=root
export YARN_NODEMANAGER_USER=root
# SecondaryNameNode
export HDFS_SECONDARYNAMENODE_USER=root
# Hadoop high availability
export HDFS_JOURNALNODE_USER=root
export HDFS_ZKFC_USER=root

2、集群hosts配置

https://yellow520.blog.youkuaiyun.com/article/details/113073636

3、集群环境变量source脚本

脚本的功能:一键 分发环境配置文件 并 使其生效(有点小bug)

3.1、Python版(root用户可用)

touch /usr/bin/source.py
chmod 777 /usr/bin/source.py
vim /usr/bin/source.py
#!/usr/bin/python2
import os, re, socket

# file name
f = 'custom.sh'
# command
source = 'source /etc/profile.d/' + f

hostname = socket.gethostname()
with open('/etc/hosts') as fr:
    for h in re.findall('hadoop[0-9]+', fr.read()):
        if h == hostname:
            os.system(source)
        else:
            os.system('rsync -a /etc/profile.d/{} {}:/etc/profile.d/'.format(f, h))
            os.system('ssh {} "{}"'.format(h, source))

3.2、bash版(非root用户可用)

cd ~
touch source.sh
vim source.sh
#!/usr/bin/bash

for h in $(cat /etc/hosts | grep -oE 'hadoop[0-9]+')
do
    sudo rsync -a /etc/profile.d/custom.sh $h:/etc/profile.d/
done

source /etc/profile.d/custom.sh

使用方法

source ~/source.sh

4、补充

CentOS7系统目录结构基础知识
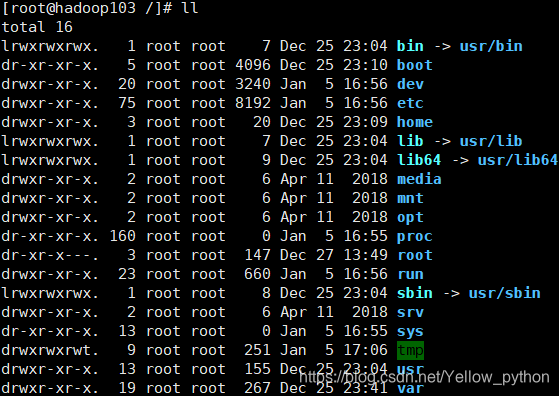
常用目录全称说明备注
usrUnix Shared ResourcesUnix共享资源bin和sbin都在这里面
自写脚本放到此处,可在任意目录调用
binbinaries二进制文件存放常用指令,如:ls、pwd、python2
sbinSuper User Binaries超级用户的二进制文件存放系统管理员使用的程序和指令
如:init、reboot
etcetcetera存放系统管理所需的配置文件如:profile、sudoers
root系统管理员的用户主目录
home普通用户的主目录
optoptional额外软件所摆放的目录
默认是空的
比如可以把Hadoop装到这个目录下
tmptemporary存放临时文件
基于MPI的并行FFT算法实现——C语言高性能计算实战项目 在高性能计算领域,随着数据规模的持续增长和对实时性要求的提升,单机串行处理已难以满足现代科学计算任务的需求。MPI(Message Passing Interface)作为分布式内存系统中最主流的并行编程模型之一,为跨多节点、多核心的协同计算提供了标准化的通信接口。其核心优势在于能够有效管理分布在不同物理主机上的进程,并通过高效的点对点与集体通信机制实现大规模并行任务的协调执行。 阅读详情

相关推荐

CCS20实战入门:第一个工程搭建示例

通过实际操作演示如何在ccs20中创建并配置首个开发项目,涵盖环境设置与基础调试步骤,帮助新手快速上手ccs20集成开发环境,提升嵌入式开发效率。

weixin_31185473的博客 888

大数据4V+1C 的特征

大数据4V+1C 的特征 1、数据量大(Volume) 2、多样(Variety) 3、快速(Velocity) 4、价值密度低(Value) 5、复杂度(Complexity)

weixin_47059755的博客 2341

利用ArcGIS的模型构建器实现批量投影栅格和批量克里金插值

博主要批量投影几百个栅格,但是ArcGIS中的投影栅格的批处理工具需要手动一条条设置参数,还是麻烦,因此学习了使用模型构建器(ModelBuilder)来批量投影栅格,可以导入需投影栅格的文件夹,然后迭代投影,并按栅格原名逐个输出到指定目录。 1.在工具箱里构建模型 在arctool box里右键点击空白处,选择【添加工具箱】,点击ArcGIS默认工作目录的工具箱进行添加,然后Toolbox就会被添加到ArcToolbox页面,右键点击Toolbox,选择“新建”-“模型” 2.编写模型 (1).

qq_36958801的博客 1万+

Hadoop集群搭建和配置

Hadoop是一个由Apache基金会所开发的分布式系统基础架构,它允许用户在不了解分布式底层细节的情况下,开发分布式程序,并充分利用集群的威力进行高速运算和存储。Hadoop起源于Apache Nutch项目,该项目是Apache Lucene的子项目之一。Hadoop的命名来源于其创始人Doug Cutting儿子的玩具大象。

2302_80048824的博客 1387

OpenWRT使用4G/5G无线网卡模块上网

将4G/5G开发板插入设备,终端输入lsusb或lspci,看设备是否识别到4G/5G模块。

1万+

使用LSTM实现自动调制识别(RML2018.01a)

目录一、LSTM的代码实现1.1 导入包1.2 数据读取及数据集划分1.3 数据预处理1.4 构建LSTM模型 本文基于RML2018.01a大型数据集,给出LSTM的信号识别的实现方式(附代码) RML2018.01a数据集信息如下: 模型 传送门 CNN/ResNet 使用CNN/ResNet实现自动调制识别(RML2018.01a) LSTM 使用LSTM实现自动调制识别(RML2018.01a)) 一、LSTM的代码实现 1.1 导入包 import numpy as np

QAQIknow的博客 6124

Hadoop集群搭建、简介、部署、准备工作及环境变量配置

Hadoop集群搭建

北极熊的博客 844

基于STM32、HAL库的W25Q01JVZEIQ TR FLASH存储器驱动应用程序设计

1Gb (128MB),分为512个可擦除块(block),每个块256KB。:块擦除约30-50ms,芯片擦除约30s。:标准SPI (支持1/2/4线模式)// 初始化CS引脚为高电平。// 擦除扇区(4KB)// 初始化Flash。/* 状态寄存器位 *//* 指令定义 *//* 超时定义 *//* 函数声明 */

corlin6688的博客 268

大数据和云计算

大数据和云计算 私聊可以提供pdf 目录大数据和云计算01、2、3、4、5、6、7、8、 0 1、人们通常最熟悉结构化数据的分析。除了半结构化、“准”结构化和非结构化这三种基本数据类型以外,还有一种重要的数据类型为元数据,它主要由( ),能够添加到数据集中。 A、人工输入 B、机器生成 C、自然产生 D、分析计算 2、数据多样性指的是大数据解决方案需要支持多种( )、不同类型的数据。数据多样性给企业带来的挑战包括数据聚合、数据交换、数据处理和数据存储等。 A.不同大小 B.不同方向 C.不同格

Destiny_159的博客 6877

输入失调电压Vos你搞明白了吗

输入失调电压Vos与温度

HW-BASE的博客 2416

Open3D (C++) 计算点云坐标最值及其索引

使用C++版本的Open3D计算点云最值点及其对应的下标索引

点云侠的博客 731

大数据原理和应用

习题答案: 第一章: 1. 简述大数据的概念。 答:自2012年以来,“大数据”一词越来越引起人们的关注。但是,目前为止,在学术研究领域和产业界中,大数据并没有一个标准的定义。在维克托·迈尔-舍恩伯格编写的《大数据时代》一书中大数据指不用随机分析法(抽样调查)这样捷径,而采用所有数据进行分析处理。而麦肯锡全球研究所则定义大数据为一种规模大到在获取、存储、管理、分析方面大大超出了传统数据库软件工具能力范围的数据集合,具有海量的数据规模、快速的数据流转、多样的数据类型和价值密度低四大特征。通常来说,大数据是指数

m0_65257784的博客 2597

visio安装包

Microsoft Office Visio 是一款专业的制图软件。利用经过更新的形状、协作工具和数据链接图表,创建专业级图表以简化复杂的信息。

*大数据集群环境搭建

本文介绍了大数据环境中的三种部署模式:单机、分布式和集群模式,重点阐述了集群模式的架构设计(主从/主备)及环境搭建方法。详细说明了集群搭建的5个关键步骤:修改主机名和IP、配置主机名映射、关闭防火墙服务、实现SSH免密登录以及配置时间同步服务。其中特别强调了网络配置的规范要求和各环节的必要性,如静态IP设置、hosts文件配置、防火墙关闭等,为构建稳定可靠的大数据集群环境提供了系统化的操作指南。

Lown_1的博客 1033

数学建模模型总结

这是本人在两年内准备参加数学建模竞赛搜集到的模型资料,已经经过了本人的筛选和整理,希望能够对准备参加数学建模竞赛的学弟学妹们提供一些帮助!

jre9下载 jdk9

(Java SE Runtime Environment 9.0) 9.0u175 官方最新版 【x86|x64】

ZooKeeper集群环境搭建

ZooKeeper集群由多个服务器节点组成,其中包括一个Leader节点和多个Follower节点。Leader节点负责处理所有客户端请求,并将数据同步到Follower节点。当Leader节点出现故障时,Follower节点会通过选举机制选举出新的Leader节点。ZooKeeper集群的主要特点包括:高性能:ZooKeeper采用基于内存的数据结构和高效的通信协议,具有很高的性能和低延迟。可靠性:ZooKeeper通过数据复制和选举机制来实现容错能力,即使部分节点出现故障,集群仍然可用。

默默发展,无声壮大~ 4618

大数据平台环境搭建_大数据平台搭建(1),2024年最新你想学的都在这里

以下操作先在主机hadoop7上配置,配置完成后进入 /usr/local/hadoop-2.7.3/etc/hadoop目录下使用scp命令将配置好的hadoop-2.7.3和jdk1.8.0_144相关文件复制到hadoop8和hadoop9的 /usr/local/hadoop-2.7.3/etc/hadoop目录下。将修改好的mapreduce组件和Yarn组件配置文件用scp命令复制到hadoop8和hadoop9的 /usr/local/hadoop-2.7.3/etc/hadoop目录下。

2401_84181309的博客 677

HBase集群环境搭建与测试

HBase集群由多个RegionServer节点和一个或多个HMaster节点组成。HMaster节点负责管理元数据(例如表的位置、分区等),并协调集群中的各个节点。RegionServer节点负责存储和处理数据,并与HMaster节点通信以获取元数据信息。可靠性:HBase采用数据副本和RegionServer读写分离等机制来实现容错和恢复能力,即使部分节点出现故障,集群仍然可用。高性能:HBase通过将表分割成不同的Region来进行水平扩展,可以处理海量数据并具有很高的读写性能。

默默发展,无声壮大~ 2547

《PySpark大数据分析实战》-11.Spark on YARN模式安装Hadoop

大家好!今天为大家分享的是《PySpark大数据分析实战》第2章第4节的内容:Spark on YARN模式安装Hadoop。

wux_labs的博客 1823

2024年大数据最全Hadoop大数据集群搭建(超详细)_hadoop集群搭建(2),2024年最新总结2024年180道大数据开发岗面试题

PATHJAVAHOMElibdtjar修改完成之后记得使用命令source /etc/profile,使修改生效。

2401_84164527的博客 1026

《PySpark大数据分析实战》-09.Spark独立集群安装

大家好!今天为大家分享的是《PySpark大数据分析实战》第2章第3节的内容:Spark独立集群安装。

wux_labs的博客 1479

大数据流式计算第一课---从Storm开始

大数据流式计算第一课—从Storm开始## **前言** ## 大数据(Big Data)又称为巨量资料,指需要新处理模式才能具有更强的决策力、洞察力和流程优化能力的海量、高增长率和多样化的信息资产。“大数据”概念最早由维克托·迈尔·舍恩伯格和肯尼斯·库克耶在编写《大数据时代》中提出,指不用随机分析法(抽样调查)的捷径,而是采用所有数据进行分析处理。大数据有4V特点,即Volume(大量)

fanleehao的博客 1197

flink on yarn(1),2024年最新今年大数据开发面试必问的这些技术面

Apache Flink以其独特的流处理和批处理一体化模型,以及高效的内存执行速度和出色的容错机制,成为大数据处理领域的佼佼者。通过合理的安装和配置,Flink on Yarn将为大数据处理带来前所未有的速度和稳定性,助力企业在实时分析和离线计算方面取得更大的成功。在flink的conf目录下,修改 flink-conf.yaml 文件添加的内容如下classloader.check leaked classloader: false。以per job 运行文件。刷新环境变量,使其生效。

2401_84160325的博客 666

flink on yarn(2),大数据开发语言基础教程

然后,根据集群的实际情况修改Flink的配置文件(如flink-conf.yaml),设置相关的参数,如Yarn集群的地址、任务的并行度等。接下来,将Flink的相关文件(如jar包和配置文件)上传到集群的指定位置,并配置环境变量以便在集群中运行Flink命令。在这种模式下,每次提交作业时,Flink都会为其创建一个独立的集群,并根据作业的需求动态分配资源。在实时处理方面,Flink展现了无与伦比的优势。Flink会根据作业的需求和Yarn集群的资源状况,动态地创建和管理集群,确保作业的顺利执行。

2401_84160325的博客 506

大数据技术实战:从Hadoop+Spark部署到端到端数据处理管道搭建

大数据技术体系是应对海量、多源、高速数据挑战的核心解决方案,其核心原理在于通过分布式计算框架对数据进行并行处理。从经典的MapReduce分而治之模型,到基于内存计算的Spark DAG执行引擎,技术演进大幅提升了数据处理效率。在工程实践中,构建完整的数据处理链路具有重要价值,能够支撑实时分析、用户画像等应用场景。本文以Hadoop和Spark为核心,通过部署伪分布式集群和编写数据分析程序,演示如何搭建从数据采集、存储、计算到可视化的实战管道,并融入数据治理与生产环境最佳实践,为构建企业级数据平台提供可落地

weixin_34062469的博客 467

分布式消息流处理平台kafka(一)-kafka单机、集群环境搭建流程及使用入门

自带了zookeeper服务, 不需要额外搭建zookeeper集群服务,如果不想使用也可以使用自己搭建的zookeeper集群。下面主要介绍如何使用自带了zookeeper服务来搭建zookeeper集群主要就是修改$KAFKA_HOME/config/zookeeper.properties, 如果是自己搭建的zookeeper集群, 修改的就是zoo.cfg配置文件, 修改配置文件如下主要就是配置每台zookeeper节点的dataDir参数和增加集群配置,如下。

最爱嫣夜来 3785
上一篇: 大数据(3h)HIVE引擎更换
下一篇: 大数据(4d)Kafka安装和基本命令
小基基o_O
博客等级 码龄9年 4414粉丝 467原创
评论 3
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包

打赏作者

小基基o_O

您的鼓励是我创作的巨大动力

¥1 ¥2 ¥4 ¥6 ¥10 ¥20
扫码支付:¥1
获取中
扫码支付

您的余额不足,请更换扫码支付或充值

打赏作者

实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值