


1.SpringDataJpa
1.1.SpringDataJpa的概念
它是JPA规范的再次封装抽象,底层使用了Hibernate的JPA技术实现,引用JPQL的查询语句 ,属于JavaSpring的生成体系中的一部分。SpringDataJpa上手简单,使用起来方便,开发效率高,使开发人员不需要关心和配置更多的东西。并且SpringDataJpa对对象的支持非常好,还十分的灵活。
1.2.SpringDataJpa的结构
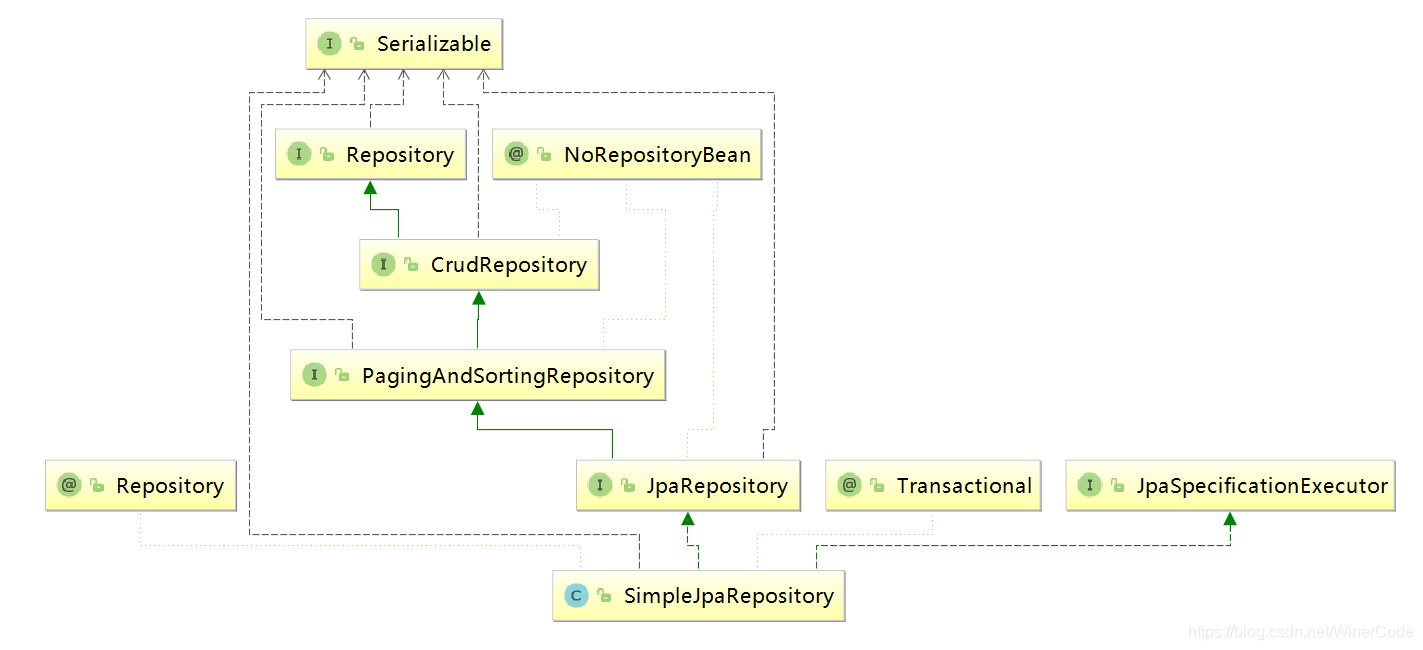
通过Intellij Idea,打开SimpleJpaRepository.java文件,单击鼠标右键show diagrams,就可以以图表的形式打开与查询类的关系层次图)。图中的实线表示继承(extends),虚线表示的是实现(implement)
2.SpringDataJPA集成项目的创建
2.1 创建maven结构项目并引入所需要的包
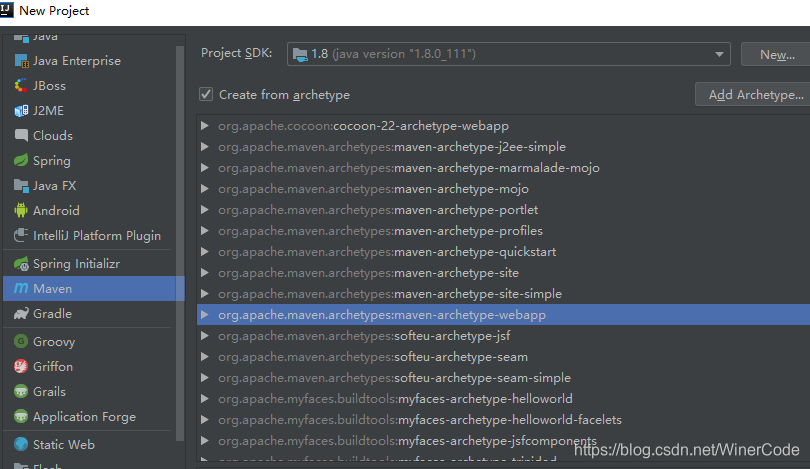
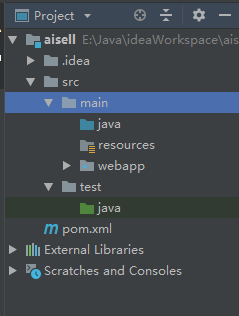
2.2 配置applicationContext.xml文件
2.2.1 导入资源文件
2.2.2 配置DataSource
2.2.3 配置entityManagerFactory
2.2.4 开启事物扫描支持
2.2.5 SpringDataJpa的扫描
2.3 准备一个用来存放类的Domain包
2.3.1 父类:BaseDomain
package cn.itsource.pss.domain;

import javax.persistence.GeneratedValue;
import javax.persistence.Id;
import javax.persistence.MappedSuperclass;

@MappedSuperclass
// 在JPA里面就表示是父类,不持久化到表
public class BaseDomain {
    @Id
    @GeneratedValue
    protected Long id;
    public Long getId() {
        return id;
    }
    public void setId(Long id) {
        this.id = id;
    }
}
2.3.2 子类:Employee
@Entity
@Table(name="employee")
public class Employee extends  BaseDomain {

    private String username;
    private String password;
    private String email;
    private Integer age;
   //省略getter,setter与toString(注意:Alt+Insert可以自动生成)
}
2.4 完成Repository的功能
package cn.itsource.pss.repository;

import cn.itsource.pss.domain.Employee;
import org.springframework.data.jpa.repository.JpaRepository;

/**
 * 必需继续JpaRepository<1v,2v>
 *     1v:代表你要操作的是哪一个domain对象
 *     2v:这个domain对象的主键的类型
 */
public interface EmployeeRepository extends JpaRepository<Employee, Long> {
}
2.5 测试集成是否成功
package cn.itsource.repository;

import cn.itsource.pss.domain.Employee;
...
@RunWith(SpringJUnit4ClassRunner.class)
@ContextConfiguration("classpath:applicationContext.xml")
public class EmployeeRepositoryTest  {
    @Autowired
    private EmployeeRepository employeeRepository;
    @Test
    public void testFind() throws Exception{
        List<Employee> emps = employeeRepository.findAll();
        for (Employee emp :emps){
            System.out.println(emp);
        }
    }
}
3.JpaRepository的基本功能
3.1普通的CRUD
//获取所有数据
@Test
public void testFindAll() throws Exception{
    List<Employee> emps = employeeRepository.findAll();
    for (Employee emp :emps){
        System.out.println(emp);
    }
}
//根据id到一条数据
@Test
public void testFindOne() throws Exception{
    Employee employee = employeeRepository.findOne(1L);
    System.out.println(employee);
}

//添加与修改都使用save(主要看对象有没有id)
@Test
public void testSave() throws Exception{
    Employee employee = new Employee();
    //employee.setId(103L);
    employee.setUsername("张三");
    employee.setPassword("1234");
    employee.setEmail("zhangsha@163.com");
    employeeRepository.save(employee);
}
//删除数据
@Test
public void testDelete() throws Exception{
    employeeRepository.delete(103L);
}
//得到总条数
@Test
public void testCount(){
    System.out.println(employeeRepository.count());
}
3.2分页排序功能
//进行分页功能
@Test
public void testPage() {
    //1.需要先创建一个page对象(注意:页数是从0开始计算【0就是第1页】)
    Pageable pageable = new PageRequest(0, 10);
    //2.进行查询
    Page<Employee> page = employeeRepository.findAll(pageable);
    System.out.println(page.getTotalElements()); //总条数
    System.out.println(page.getTotalPages()); //总页数
    System.out.println(page.getContent()); //当前页数据
    System.out.println(page.getNumber()); //第几页
    System.out.println(page.getNumberOfElements()); //当前页有多少个数据
    System.out.println(page.getSize()); //每页条数
}

//进行排序功能
@Test
public void testSort() {
    //排序 :第一个参数是排序的规则(DESC/ASC)  后面参数是排序的字符
    Sort sort = new Sort(Sort.Direction.DESC,"username");
    List<Employee> emps = employeeRepository.findAll(sort);
    for (Employee emp : emps) {
        System.out.println(emp);
    }
}

//分页与排序的集成
@Test
public void testPageAndSort() {
    //排序 :第一个参数是排序的规则(DESC/ASC)  后面参数是排序的字符
    Sort sort = new Sort(Sort.Direction.DESC,"username");
    Pageable pageable = new PageRequest(0, 10,sort);
    //2.进行查询
    Page<Employee> page = employeeRepository.findAll(pageable);
    for (Employee employee : page) {
        System.out.println(employee);
    }
}
3.3根据条件进行查询
按照规范创建查询方法,一般按照java驼峰式书写规范加一些特定关键字,例如我们想通过员工的名来获取到对应的员工的对象。
public interface EmployeeRepository extends JpaRepository<Employee, Long> {
    //根据名称模糊查询
    List<Employee> findByUsernameLike(String username);
    //根据名称进行查询
    List<Employee> findByUsername(String username);
}
这种方案看起来有意思,但是功能它都只针对简单的单表查询(而且如果条件太多,这个名称还是比较麻烦),如果遇到复杂的查询,还有方案就显得力不从心了。
3.4@Query注解查询
在Respository方法中一定要按照查询方法的命名规则,其实是比较麻烦的如果我们想不遵循 查询方法的命名规则,还可以使用@Query的方法进行查询。
只需要将@Query定义在Respository的方法之上即可。
例如:根据用户名和密码拿到相应的员工
根据参数顺序
@Query("select o from cn.itsource.pss.domain.Employee o where  o.username like ?1 and o.email like ?2")
List<Employee> query02(String username,String email);

根据参数名称
@Query("select o from cn.itsource.pss.domain.Employee o where  o.username like :username and o.email like :email")
List<Employee> query03(@Param("username") String username,@Param("email")  String email);
Query的注解注入非常灵活,在开发中也经常使用到(只是写JPQL/SQL有点麻烦)。
4.JpaSpecificationExecutor的认识
JpaSpecificationExecutor(JPA规则执行者)是JPA2.0提供的Criteria API的使用封装,可以用于动态生成Query来满足我们业务中的各种复杂场景。
Spring Data JPA为我们提供了JpaSpecificationExecutor接口,只要简单实现toPredicate方法就可以实现复杂的查询。
4.1单个条件的查询
@Test
public void testFind() {
    /**
*官方解释:
     * Root<T> root:代表了可以查询和操作的实体对象的根,
     *              可以通过它的 Path<Y> get(String attributeName); 这个方法拿到我们要操作的字段
     *              注意:只可以拿到对应的T的字段(Employee)
     * CriteriaQuery<?> query:代表一个specific的顶层查询对象
     *              包含查询的各个部分,比如select,from,where,group by ,order by 等
     *              简单理解 就是它提供 了查询ROOT的方法(where,select,having)
     * CriteriaBuilder cb:用来构建CriteriaQuery的构建器对象(相当于条件或者说条件组合)
     *              构造好后以Predicate的形式返回
     */
/**
* 非官方理解:
 * 查询的时候就需要给一个标准(规范)
 *  -》 根据规范(这个规范我们可以先简单理解为查询的条件)进行查询
 *
 *      Root:查询哪个表(定位到表和字段-> 用于拿到表中的字段)
 *            可以查询和操作的实体的根
 *              Root接口:代表Criteria查询的根对象,Criteria查询的查询根定义了实体类型,能为将来导航获得想要的结果,它与SQL查询中的FROM子句类似
 *             Root<Employee> 相当于 from Employee
 *             Root<Product> 相当于  from Product
 *      CriteriaQuery:查询哪些字段,排序是什么(主要是把多个查询的条件连系起来)
 *      CriteriaBuilder:字段之间是什么关系,如何生成一个查询条件,每一个查询条件都是什么方式
 *                      主要判断关系(和这个字段是相等,大于,小于like等)
 *      Predicate(Expression):单独每一条查询条件的详细描述 整个 where xxx=xx and yyy=yy ...
 */
    List<Employee> emps = employeeRepository.findAll(
            new Specification<Employee>() {
                @Override
                public Predicate toPredicate(Root<Employee> root, CriteriaQuery<?> query, CriteriaBuilder cb) {
                    Path path = root.get("username");//拿到要做查询的字段
                    Predicate p = cb.like(path, "%1%");//like代表做模糊查询,后面就是它的条件值
                    return p;
                }
            }
    );
    for (Employee emp : emps) {
        System.out.println(emp);
    }
}
4.2多个条件查询
@Test
public void testFind02() {
    Specification spec = new Specification<Employee>() {
        @Override
        public Predicate toPredicate(Root root, CriteriaQuery query, CriteriaBuilder cb) {
            //加上第一个条件: username like '%1%'
            Path path1 = root.get("username");
            Predicate p1 = cb.like(path1, "%1%");
            //加上第二个条件: email like '%2%'
            Path path2 = root.get("email");
            Predicate p2 = cb.like(path2,"%2%");
            //加上第二个条件: age < 20
            Path path3 = root.get("age");
            Predicate p3 = cb.lt(path3, 20);
           //下面是加上or的条件的方案
           //Predicate p3 = cb.or(p1,p2);

            //把两个查询条件放到query对象中去(条件使用where)
            CriteriaQuery where = query.where(p1, p2, p3);
            //返回查询条件
            return where.getRestriction();
        }
    };

    List<Employee> emps = employeeRepository.findAll(spec);
    for (Employee emp : emps) {
        System.out.println(emp);
    }

}
4.3条件查询+分页排序
@Test
public void testFind03() {
    Specification spec = new Specification<Employee>() {
        @Override
        public Predicate toPredicate(Root root, CriteriaQuery query, CriteriaBuilder cb) {
            //加上条件: username like '%1%'
            Path path1 = root.get("username");
            Predicate p1 = cb.and(cb.like(path1, "%1%"));
            //把两个查询条件放到query对象中去(条件使用where)
            CriteriaQuery where = query.where(p1);
            //返回查询条件
            return where.getRestriction();
        }
    };

    //排序 :第一个参数是排序的规则(DESC/ASC)  后面参数是排序的字符
    Sort sort = new Sort(Sort.Direction.DESC,"username");
    Pageable pageable = new PageRequest(0, 10,sort);

    Page<Employee> page = employeeRepository.findAll(spec, pageable);
    for (Employee emp : page) {
        System.out.println(emp);
    }
}
JpaSpecificationExecutor功能也是非常强大的,可以让我们不写一句SQL即可完成相应的查询功能。在外面也很不少公司使用这种方法,然后直接可以进行功能的抽取。
不过这个方案在设计上理解不是很容易,而且代码还比较臃肿烦杂。
5.jpa-spec插件
这是一个动态生成Query功能的一个封装版,如果我们使用这个插件,在完成查询与分页的时候功能会简单不少。
基于Spring Data Jpa的动态查询库 https://github.com/wenhao/jpa-spec
5.1功能介绍
- 兼容Spring Data Jpa 和JPA2.1接口。
- Equal/NotEqual/Like/NotLike/In/NotIn支持可变参数, Equal/NotEqual 支持空(Null)值。
- 每个条件支持关联查询。
- 支持自定义条件查询。
- 条件构建器。
- 支持分页和排序。
5.2功能测试
5.2.1单个条件查询
@Test
public void testSpecFind01() {
    Specification<Employee> spec = Specifications.<Employee>and().like("username", "%1%").build();
    List<Employee> emps = employeeRepository.findAll(spec);
    for (Employee emp : emps) {
        System.out.println(emp);
    }
}
5.2.2多个条件查询
@Test
public void testSpecFind02() {
    Specification<Employee> spec = Specifications.<Employee>and().like("username", "%1%")
            .like("email","%2%").lt("age", 20).build();
    List<Employee> emps = employeeRepository.findAll(spec);
    for (Employee emp : emps) {
        System.out.println(emp);
    }
}
5.2.3条件+排序分页功能
//条件集成+分页
@Test
public void testSpecFind03() {
    Specification<Employee> spec = Specifications.<Employee>and().like("username", "%1%").build();
    //排序 :第一个参数是排序的规则(DESC/ASC)  后面参数是排序的字符
    Sort sort = new Sort(Sort.Direction.DESC,"username");
    Pageable pageable = new PageRequest(0, 10,sort);

    Page<Employee> page = employeeRepository.findAll(spec, pageable);
    for (Employee emp : page) {
        System.out.println(emp);
    }
}
6.Query查询条件
6.1BaseQuery:公共的分页条件
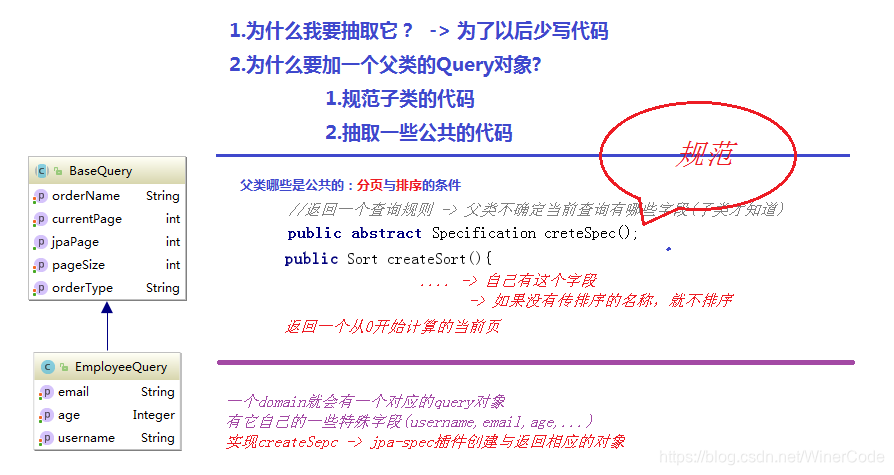
父类BaseQuery,主要写分页内容,排序方法及定义获取查询条件的方法
package cn.itsource.pss.query;
/**
 * 公共的条件与规范
 */
public abstract class BaseQuery {

    //当前页(从1开始)
    private int currentPage = 1;
    //每页条数
    private int pageSize = 10;

    //排序方式 ASC/DESC
    private String orderByType ="ASC";
    //排序字段
    private String orderByName;

    public int getCurrentPage() {
        return currentPage;
    }
    /**
     * 专门准备的方法,因为前台用户传的是从第1页开始,而我们后台分页又是从0开的
     * @return
     */
    public int getJpaPage() {
        return currentPage - 1;
    }

    public void setCurrentPage(int currentPage) {
        this.currentPage = currentPage;
    }
    public int getPageSize() {
        return pageSize;
    }

    public void setPageSize(int pageSize) {
        this.pageSize = pageSize;
    }
    public String getOrderByType() {
        return orderByType;
    }

    public void setOrderByType(String orderByType) {
        this.orderByType = orderByType;
    }

    public String getOrderByName() {
        return orderByName;
    }

    public void setOrderByName(String orderByName) {
        this.orderByName = orderByName;
    }
}
6.2EmployeeQuery:Employee特有的一些条件
子类EmployeeQuery,主要写对象上的字段及实现的父类的方法
package cn.itsource.pss.query;

public class EmployeeQuery extends BaseQuery {

    private String username;//姓名
    private String email;//邮件
    private Integer age;//年龄

    public String getUsername() {
        return username;
    }
    public void setUsername(String username) {
        this.username = username;
    }
    public String getEmail() {
        return email;
    }
    public void setEmail(String email) {
        this.email = email;
    }
    public Integer getAge() {
        return age;
    }

    public void setAge(Integer age) {
        this.age = age;
    }
}
6.3功能测试
//根据Query对象进行查询
@Test
public void testSpecFindByQuery() {
    //创建模块一个Query对象
    EmployeeQuery baseQuery = new EmployeeQuery();
//下面的都是测试的条件,可以任何放开进行测试
    //baseQuery.setUsername("1");
    //baseQuery.setAge(20);
    //baseQuery.setEmail("2");
    //baseQuery.setOrderByName("username");
    //baseQuery.setOrderByType("DESC");
    //baseQuery.setCurrentPage(2);
    //baseQuery.setPageSize(5);

	//like(条件boolean值,字段,值)
    Specification<Employee> spec = Specifications.<Employee>and()
            .like(StringUtils.isNotBlank(baseQuery.getUsername()), "username","%"+baseQuery.getUsername()+"%")
            .like(StringUtils.isNotBlank(baseQuery.getEmail()), "email","%"+baseQuery.getEmail()+"%")
            .lt(baseQuery.getAge()!=null, "age",baseQuery.getAge())
            .build();


    //这里确定是否需要排序
    Sort sort = null;
    if(baseQuery.getOrderByName()!=null){
        Sort.Direction desc = "DESC".equals(baseQuery.getOrderByType())?Sort.Direction.DESC:Sort.Direction.ASC;
        sort = new Sort(desc,baseQuery.getOrderByName());
    }
    Pageable pageable = new PageRequest(baseQuery.getJpaPage(), baseQuery.getPageSize(),sort);

    Page<Employee> page = employeeRepository.findAll(spec, pageable);
    for (Employee emp : page) {
        System.out.println(emp);
    }
}
通过上面的功能测试,我们已经知道如果前台传数据过来,后面的查询应该怎么处理了。但是大家也应该发现了,除了创建Specification对象这一,分页排序的部分每次查询的代码都应该是一样的,所以我们现在需要做的就是把代码开始进行功能抽取。
6.4创建Specification的流程放到Query里
BaseQuery中添加抽象方法
public abstract class BaseQuery {
...
//拿到查询的条件对象(由子类实现)
	public abstract Specification createSpecification();
//拿到排序的数据
	public Sort createSort() {
    		Sort sort = null;
    		if (StringUtils.isNotBlank(orderByName)) {
        		Sort.Direction type=  "ASC".equals(orderByType.toUpperCase())? Sort.Direction.ASC:Sort.Direction.DESC;
       		 sort = new Sort(type,orderByName);
    		}
    		return sort;
	}
...
}

EmployeeQuery中实现相应方法
(以后每一个Query要做高级查询都写在这个位置)
public class EmployeeQuery extends BaseQuery {
    ...
@Override
	public Specification createSpecification() {
    	//根据条件把数据返回即可
   	return  Specifications.<Employee>and()
            .like(StringUtils.isNotBlank(username), "username","%"+username+"%")
            .like(StringUtils.isNotBlank(email), "email","%"+email+"%")
            .lt(age!=null, "age",age)
            .build();
	}
...
}


 5114


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


