长短期记忆(LSTM)相关知识

白话--长短期记忆(LSTM)的几个步骤,附代码! 文章目录1. 什么是LSTM2. 输⼊⻔、遗忘⻔和输出⻔3. 候选记忆细胞4. 记忆细胞5. 隐藏状态6. LSTM与GRU的区别7. LSTM可以使用别的激活函数吗?8. 代码实现9. 参考文献 1. 什么是LSTM 在你阅读这篇文章时候,你都是基于自己已经拥有的对先前所见词的理解来推断当前词的真实含义。我们不会将所有的东西都全部丢弃,然后用空白的大脑进行思考。我们的思想拥有持久性。LSTM就是... 阅读详情


上一篇文章中,提到RNN难以学习到长期依赖关系,后来有人提出了RNN的改进版本LSTM很大程度上改善了长期依赖问题。

长期依赖在序列数据中是很常见的,考虑到下面这句话“I grew up in France… I speak fluent French.”,现在需要语言模型通过现有以前的文字信息预测该句话的最后一个词,模型结构的可能如下图所示:

在这里插入图片描述

需要通过以前文字语境来预测出最后一个词是French,则需要依赖于开头部分语境中的单词France。LSTM可以很容易的学习到这种长期依赖,这得益于其内部三个特殊的门结构。

LSTM结构

RNN结构如下图所示:

在这里插入图片描述

LSTM基于RNN,做出了些调整,修改后的结构如图所示:

在这里插入图片描述

很明显可以看到两个区别,一方面是细胞单元内部的结构变复杂了,另一方面相邻细胞单元之间的依赖关系从一个变为了两个。

具体来说,LSTM使用上图中三个黄色σ方框(σ代表Sigmoid运算)代表的遗忘门、输入门和输出门来控制细胞状态。

遗忘门

遗忘门控制前一步记忆单元中的信息以多大程度被遗忘掉,主要决定决定细胞状态 C 需要丢弃哪些信息。遗忘门在细胞单元中的位置,如下图黄色方框所示:

在这里插入图片描述

其中遗忘门的输出结果 f f f的计算公式为:
f t = σ ( W f ⋅ [ h t − 1 ,    x t ] + b f ) f_t=\sigma(W_f\cdot[h_{t-1},\;x_t]+b_f) ft​=σ(Wf​⋅[ht−1​,xt​]+bf​)
式子中: W f W_f Wf​是遗忘门的权重矩阵, [ h t − 1 ,    x t ] [h_{t-1},\;x_t] [ht−1​,xt​]表示把两个向量连接成一个更长的向量, b f b_f bf​是遗忘门的偏置项, σ \sigma σ 表示Sigmoid函数,最终得到一个介于0与1之间的输出值。

其中 W f ⋅ [ h t − 1 ,    x t ] + b f W_f\cdot[h_{t-1},\;x_t]+b_f Wf​⋅[ht−1​,xt​]+bf​ 可以理解为:
[ W f ] [ h t − 1 x t ] = [ W f h W f x ] [ h t − 1 x t ] = W f h h t − 1 + W f x x t \begin{aligned} \begin{bmatrix}W_f\end{bmatrix}\begin{bmatrix}\mathbf{}h_{t-1}\\ \mathbf{}x_t\end{bmatrix}&= \begin{bmatrix}W_{fh}&W_{fx}\end{bmatrix}\begin{bmatrix}\mathbf{}h_{t-1}\\ \mathbf{}x_t\end{bmatrix}\\ &=W_{fh}\mathbf{}h_{t-1}+W_{fx}\mathbf{}x_t \end{aligned} [Wf​​][ht−1​xt​​]​=[Wfh​​Wfx​​][ht−1​xt​​]=Wfh​ht−1​+Wfx​xt​​
也就是遗忘门通过查看 h ( t − 1 ) h_{(t-1)} h(t−1)​和 x t x_t xt​的信息计算得到一个介于0与1之间的向量,该向量中的数值决定从上一个单元输入到此单元的状态 C t − 1 C_{t-1} Ct−1​ 中有多少信息需要保留或丢弃,0表示不保留,1表示都保留。至于这个细胞状态 C t − 1 C_{t-1} Ct−1​代表什么,后面会有相关的解释说明。

输入门

决定给细胞状态C添加哪些新的信息

接下来是决定给细胞状态C添加哪些新的信息。这一步又分为两个步骤:

1,首先,利用 h t − 1 h_{t-1} ht−1​和 x t x_t xt​通过输入门的运算来决定更新哪些信息,输入门的位置如下图中的黄色σ方框所示:

在这里插入图片描述

输入门的运算如下:
i t = σ ( W i ⋅ [ h t − 1 , x t ] + b i ) \mathbf{}i_t=\sigma(W_i\cdot[\mathbf{}h_{t-1},\mathbf{x}_t]+\mathbf{}b_i) it​=σ(Wi​⋅[ht−1​,xt​]+bi​)
2,然后,利用 h t − 1 h_{t-1} ht−1​和 x t x_t xt​通过一个tanh层得到新的候选细胞信息 C ~ t \tilde{C}_t C~t​,这些信息可能会被更新到细胞信息中,涉及的运算如下:
C ~ t = tanh ⁡ ( W c ⋅ [ h t − 1 , x t ] + b c ) \tilde{C}_t=\tanh(W_c\cdot[\mathbf{}h_{t-1},\mathbf{}x_t]+\mathbf{}b_c) C~t​=tanh(Wc​⋅[ht−1​,xt​]+bc​)

更新旧的细胞信息

通过上面的两个步骤,得到了新的信息,接下来就是更新旧的细胞信息,变为新的细胞信息。更新的规则就是通过遗忘门的选择来忘记旧细胞信息的一部分,通过输入门的选择来添加候选细胞信息 C ~ t \tilde{C}_t C~t​的一部分得到新的细胞信息。如下图所示:

在这里插入图片描述

相关的计算如下:
C t = f t ∗ C t − 1 + i t ∗ C ~ t \mathbf{}C_t=f_t*{\mathbf{}C_{t-1}}+i_t*{\mathbf{}\tilde{C}_t} Ct​=ft​∗Ct−1​+it​∗C~t​
通过这样的方式,我们就把LSTM关于当前的记忆 C ~ t \tilde{C}_t C~t​和长期的记忆 C t − 1 C_{t-1} Ct−1​组合在一起,形成了新的单元状态。由于遗忘门的控制,它可以保存很久很久之前的信息,由于输入门的控制,它又可以避免当前无关紧要的内容加入记忆。

输出门

更新完细胞状态后需要根据输入的 h t − 1 h_{t-1} ht−1​和 x t x_t xt​来决定输出细胞状态C的哪些特征,这里需要将输入经过一个称为输出门的Sigmoid函数,其位置如下图黄色方框所示:

在这里插入图片描述

经过Sigmoid表示的门之后,还需要经过一个tanh函数来得到取值范围在 -1~1 之间的向量,该向量与输出门得到的输出结果相乘就得到了最终该RNN单元的输出 h t h_t ht​。涉及的计算如下:
o t = σ ( W o ⋅ [ h t − 1 , x t ] + b o ) h t = o t ∗ tanh ⁡ ( c t ) \mathbf{}o_t=\sigma(W_o\cdot[\mathbf{}h_{t-1},\mathbf{}x_t]+\mathbf{}b_o) \\ \mathbf{}h_t=\mathbf{}o_t* \tanh(\mathbf{}c_t) ot​=σ(Wo​⋅[ht−1​,xt​]+bo​)ht​=ot​∗tanh(ct​)

LSTM小结

如何实现长期依赖?

当输入序列没有重要信息时,LSTM遗忘门的值接近为1,输入门接近0,此时过去的记忆会被保存,从而实现了长期记忆;

当输入的序列中出现了重要信息时,LSTM会将其存入记忆中,此时输入门的值会接近于1;

当输入序列出现重要信息,且该信息意味着之前的记忆不再重要的时候,输入门接近1,遗忘门接近0,这样旧的记忆被遗忘,新的重要信息被记忆。

经过这样的设计,整个网络更容易学习到序列之间的长期依赖。

如何避免梯度消失/爆炸?

在LSTM中,状态 C 是通过累加的方式来计算的,不像RNN中的累乘的形式,这样的话,它的的导数也不是乘积的形式,这样就不会发生梯度消失的情况了。

双向LSTM(Bi-LSTM)

上面介绍的是单向的LSTM,只能根据先前的序列推导未来的信息,但是有时候在给定时间 t 之后的未来的信息,可以帮助推断时刻 t 的信息。例如在语言识别中,当前识别到的字可能取决于未来的几个字的发音。因此,在某些任务中,双向的 LSTM 要比单向的 LSTM 的表现要好。

双向LSTM(Bi-LSTM)的隐藏层要保存两个值, A 参与正向计算, A’ 参与反向计算。最终的输出值 y 取决于 A 和 A’,网络结构如下图所示:

在这里插入图片描述

以 t = 2 t=2 t=2为例,输入 x 2 x_2 x2​, A 2 A_2 A2​是正向计算的结果, A ’ 2 A’_2 A’2​是反向计算的结果,输出 y 2 y_2 y2​同时取决于 A 2 , A ’ 2 A_2,A’_2 A2​,A’2​。

GRU

GRU(Gated Recurrent Unit)作为LSTM的一种变体,与LSTM有两个不同点:

(1)GRU将LSTM中的两个信息流简化成一个信息流,输入只有一个 h t \boldsymbol h_t ht​。

(2)GRU将遗忘门和输入门合成了一个单一的更新门,还引入了一个重置门。

如下图所示:
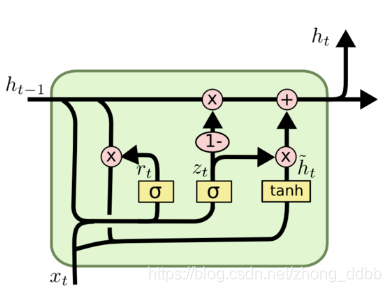
在这里插入图片描述

主要运算过程如下:
r t = σ ( W r ⋅ [ h t − 1 , x t ] ) z t = σ ( W z ⋅ [ h t − 1 , x t ] ) h ~ t = tanh ⁡ ( W ⋅ [ r t ∗ h t − 1 , x t ] ) h t = ( 1 − z t ) ∗ h t − 1 + z t ∗ h ~ t \begin{aligned} &r_t = \sigma(W_r\cdot[h_{t-1},x_t]) \\ &z_t = \sigma(W_z\cdot[h_{t-1},x_t]) \\ &\tilde h_t = \tanh(W \cdot[r_t * h_{t-1},x_t]) \\ & h_t = (1-z_t)*h_{t-1} + z_t*\tilde h_t \end{aligned} ​rt​=σ(Wr​⋅[ht−1​,xt​])zt​=σ(Wz​⋅[ht−1​,xt​])h~t​=tanh(W⋅[rt​∗ht−1​,xt​])ht​=(1−zt​)∗ht−1​+zt​∗h~t​​
相当于简化了LSTM,运算速度提高了很多,并且应用效果也没有差很多。

参考文章:

  1. LSTM原理详解

  2. 理解LSTM(通俗易懂版)

  3. NLP面试题目汇总1-5

机器学习——长短期记忆(LSTM) 阅读详情

相关推荐

【人工智能99问】长短期记忆网络(LSTM)的结构和原理是什么?(12/99)

LSTM通过细胞状态和门控机制,突破了传统RNN的局限,成为处理序列数据的核心模型之一。尽管结构复杂,但其对长距离依赖的捕捉能力使其在NLP、时间序列等领域不可或缺,至今仍是许多实际应用的基础模型。

EnHengNa的博客 1249

动手学深度学习(四十)——长短期记忆网络(LSTM)

文章目录一、长短期记忆网络(LSTM)1.1 门控记忆单元1.2 输入门、遗忘门与输出门1.3候选记忆单元1.4 记忆单元1.5 隐藏状态二、从零实现LSTM2.1 初始化模型参数2.2 定义网络模型2.3 训练和预测2.4 简洁实现小结练习 一、长短期记忆网络(LSTM)   最早用来处理隐变量模型存在的长期信息保存和短期输入跳跃问题的方法(long short-term memory LSTM)。其拥有许多门控循环单元相同的属性。LSTM比GRU更复杂,但是其比GRU早诞生20年左右。 1.1 门控记忆

Liu Feng's Blog 5379

双向长短期记忆网络(Bi-LSTM)

在开始之前,首先区分下均命名为RNN,新手很容易混淆的两大神经网络:循环神经网络(Recurrent Neural Network,RNN)和递归神经网络(Recurssion Neural Network,RNN)。 递归神经网络(RNN)是空间上的展开,处理的是树状结构的信息,模型结构如下: 循环神经网络(RNN)是时间上的展开,擅长处理以时间序列数据作为输入的预测问题, 其原因在于 RNN 的网络结构可以处理时间序列数据之间的相关性。模型结构如图所示,包括输入层 x、隐藏层 h、输出层 o,在隐藏层

reedci的博客 5万+

长短时记忆网络(Long Short Term Memory,LSTM)详解

长短时记忆网络(LSTM)基本原理与基于Pytorch的实现方法。

weixin_60737527的博客 1万+

时间序列预测(十)——长短期记忆网络(LSTM)

长短期记忆网络(LSTM, Long Short-Term Memory)是一种专门设计用来解决时间序列数据的循环神经网络(RNN)。LSTM的主要优势是能够,适用于处理长期记忆(长期依赖)的问题,同时在训练过程中避免了传统RNN常见的问题。在时间序列预测中,LSTM网络非常适合处理具有长期相关性的输入数据,例如气温变化、股票价格、驾驶员行为数据等。LSTM可以通过记忆单元和门控机制来决定哪些信息需要“记住”,哪些需要“遗忘”。

qq_47885795的博客 6128

简单介绍长短期记忆网络 - LSTM

简单说明了循环神经网络RNN的一些不足,对长短期记忆网络-LSTM的一个简单介绍

qq_43226867的博客 7227

RNN-LSTM-GRU以及bi-LSTM

这篇笔记参考了陶将大佬的文章,下周的专业英语课要讲一篇论文,其中用到了LSTM,赶紧恶补 一起来看看吧~ LSTM(Long Short-Term Memory)长短期记忆网络,是一种时间递归神经网络,适合于处理和预测时间序列中间隔和延迟相对较长的重要事件。LSTM是解决循环神经网络RNN结构中存在的“梯度消失”问题而提出的,是一种特殊的循环神经网络。最常见的一个例子就是:当我们要预测“the clouds are in the (…)"的时候, 这种情况下,相关的信息和预测的词位置之间的间隔很小,RNN会

是木子啦~ 1878

长短期记忆网络(LSTM):深度学习中的记忆单元

长短期记忆网络(LSTM):深度学习中的记忆单元 作者:禅与计算机程序设计艺术 1. 背景介绍 长短期记忆网络(LSTM)是一种特殊的循环神经网络(RNN)架构,它能够学习长期依赖关系。相比于传统的RNN,LSTM引入了一些特殊的结构,如记忆单元、遗忘门、输入门和输

AI天才研究院 1659

【亲测免费】 MATLAB中LSTM时序分类的用法与实战

MATLAB中LSTM时序分类的用法与实战 去发现同类优质开源项目:https://gitcode.com/ 简介 本资源文件详细介绍了如何在MATLAB中使用长短期记忆网络(LSTM)进行时序分类。LSTM是一种适用于处理和预测时间序列数据的重要神经网络,特别适合于处理和预测时间序列中间隔和延迟相对较长的重要事件。 内容概述 LSTM基础知识: LSTM(Long Short-Term M...

gitblog_06500的博客 1082

长短时记忆网络LSTM原理与代码实例讲解

在机器学习领域,序列数据是一种常见的数据类型,例如文本、语音、时间序列等等。序列数据中的每个元素都与其前后的元素相关联,这种依赖关系需要被模型捕捉到才能进行有效的预测。不同序列的长度可能不同,这使得传统的机器学习模型难以处理。序列数据中某些重要的信息可能相隔很远,传统的机器学习模型难以捕捉到这种长期依赖关系。研究人员正在不断探索更强大的 LSTM 变体,例如双向 LSTM、卷积 LSTM 等等。LSTM 可以与其他深度学习模型结合,例如卷积神经网络、注意力机制等等,以构建更强大的模型。

AI天才研究院 1681

长短期记忆网络 (LSTM) 简介

本文对 LSTM 进行了简要介绍。我们先看一下上下文。我们将介绍经典的递归神经网络,以及为什么训练它们是有问题的。随后,Hochreiter 和 Schmidhuber 在他们 1997 年的工作中介绍了长短期记忆网络。我们还将直观地介绍为什么 LSTM 解决了机器学习中传统上存在的循环段梯度消失问题。

gongdiwudu的专栏 3540

3D模型一目了然,带你领略算法背后的逻辑

LSTM

qq_25467441的博客 247

深入解析长短期记忆网络(LSTM)

本文还有配套的精品资源,点击获取 简介:长短期记忆网络(LSTM)是一种优化的循环神经网络(RNN),设计用于处理序列数据,其独特的门控机制有效缓解了传统RNN面临的梯度消失问题。本文章详细介绍了LSTM的基本结构、工作流程,以及其在处理长期依赖序列任务中的优势和潜在缺点。同时,文章还探讨了LSTM在多个实际应用领域的应用,并对GRU等相关变体进行了简要介绍。 1...

weixin_42602368的博客 2895

长短期记忆人工神经网络(LSTM)网络学习资料

一、人工神经网络模型的分类: 1、27种神经网络的图解 地址:https://baijiahao.baidu.com/s?id=1590362274035183205&wfr=spider&for=pc 从中了解到在众多神经网络模型中选择LSTM的原因。 二、三篇既讲解了长短期记忆人工神经网络的理论又展示了编程的博文: 1、LSTM(长短期记忆网络)及其tensor...

SweeNeil 2242

实验5 振幅调制(集成乘法器幅度调制电路)

目录5-1 振荡调制的基本工作原理一.振幅调制和调幅波1.普通调幅波(AM)(1)调幅波的表达式、波形(2)调幅波的频谱2.抑制载波双边带调幅(DSB)3.抑制载波单边带调幅(SSB)二.普通调幅波的产生电路三.抑制载波调幅的产生电路5-2 振幅调制实验电路 5-1 振荡调制的基本工作原理 根据电磁波理论知道,只有频率较高的振荡才能被天线有效地辐射。但是人的讲话声音变换为相应电信号的频率较低,不适于直接从天线上辐射。因此,为了传递信息,就必须将要传递的信息“记载”到高频振荡上去。这一“记载”过程称为调

胡毛毛的博客 3万+

Delta并联机械手-Codesys实现以及正解逆解研究

由于Codesys的Robotics模块有Delta并联机械手的运动模型,因此借助Codesys的机械手运动模型,研究自己的正解逆解算法。

weixin_42386991的博客 5561

动手学深度学习 - 现代递归神经网络 - 10.1 长短期记忆(LSTM)

本文介绍了长短期记忆网络(LSTM)的核心机制及其实现。LSTM通过精心设计的门控结构(输入门、遗忘门、输出门)和记忆单元,有效解决了RNN在处理长序列时的梯度消失问题。文章详细解析了LSTM的数学公式和工作原理,包括状态更新、信息流动路径和隐藏状态计算。同时展示了从零开始构建LSTM的过程,以及与PyTorch简洁实现的对比。实验结果表明,LSTM能够学习文本生成等任务,展现出良好的记忆能力和泛化性能。LSTM为后续更先进的序列模型(如GRU、Transformer)奠定了基础。

tang7mj的博客 1032

使用kmplot在线进行生存分析

欢迎关注”生信修炼手册”!kmplot是一个生存分析的在线工具,最初是设计用来对肝癌中的miRNA进行生存分析,对应的文章发表在scientific reports上,链接如下https...

庐州月光的博客 1万+

长短期记忆网络(Long Short-Term Memory,LSTM)及其变体双向LSTM和GRU

LSTM(Long Short-Term Memory)长短期记忆网络,是一种时间递归神经网络,适合于处理和预测时间序列中间隔和延迟相对较长的重要事件。LSTM是解决循环神经网络RNN结构中存在的“梯度消失”问题而提出的,是一种特殊的循环神经网络。

陶将的博客 8万+

小蔺的米哈游数据分析师之路——MYSQL篇

作为新人,记录自己mysql学习历程

weixin_47070228的博客 433

【OpenClaw企业级智能体实战】第10篇:医疗行业OpenClaw实战:病历自动书写、医保智能审核与患者随访管理(附HIPAA合规配置+完整代码)

医疗行业正面临“效率提升需求”与“合规监管红线”的双重矛盾:病历书写占据医生30%-50%工作时间,医保审核效率低下,患者随访工作量巨大,但医疗数据“不出域”“责任不转移”的要求又限制了AI落地。本文基于华为云、腾讯云安全规范及中关村科金、复旦大学附属中山医院等真实实践,拆解OpenClaw在医疗场景的五大核心应用(病历自动书写、医保智能审核、患者随访管理、科研文献综述、医学影像预处理),提供私有化部署架构、HIPAA合规配置模板、完整实操流程及可直接运行的代码。

专注于人工智能、软件开发、工控自动化、工厂数字化及智能化等领域,希望和大家共同进步! 438

Python异常检测 - LSTM(长短期记忆网络)

在时间序列分析中,异常值检测是一个重要的任务,它可以帮助我们发现数据中的异常情况,比如突发的异常波动、异常值等。

qq_40821260的博客 1982

labview高低拼接的理解

计算机的一个字节由8位组成,无符号的8位整形表示的范围为0~255,范围太小了,所以用双字节,即16位整形表示更大范围的数字0 ~65535。2.labview中的高低拼接实质是高8位字节左移8位与低8位字节相加,结果是双字节整形。

qwerqwerdhr的博客 834

神经网络学习笔记(三)——长短期记忆网络LSTM

长短期记忆网络 LSTM 文章目录长短期记忆网络 LSTM一、概述二、背景三、LSTM原理3.1 模型结构3.2 前向传播3.3 反向传播3.4 LSTM的变体3.4.1 Peephole Connection3.4.2 Coupled四、LSTM的简单使用五、总结 一、概述   长短期记忆网络——通常被称为LSTM,是一种特殊的RNN,能够学习长期依赖性。由Hochreiter和Schmidhuber(1997)提出,并且在接下来的工作中被许多人改进和推广。LSTM 在各种各样的问题上表现非常出色,现在被

weixin_43886056的博客 8215

【2DWT:2维离散小波变换(附Pytorch代码)】

图像信号具有非平稳特性,无法使用一种确定的数学模型来描述,而小波变换的多分辨率分析特性很好地解决了这个问题。小波变化的多分辨率特性使其既可以高效描述图像的平坦区域(低频信息、全局信息),也可以有效处理图像信号的局部突变(高频信息,即图像的边缘轮廓等部分)。小波变换在空域和频域同时具有良好的局部性,使其可以很好地聚焦到图像的任意细节。

NorthSmile的博客 1万+

万字长文:YOLOv5+RK3588 NPU多线程加速全攻略——从理论到部署的终极优化

RK3588 NPU多线程加速优化教程摘要 本教程深入讲解了如何利用线程池技术优化RK3588 NPU上的YOLO目标检测模型推理性能。RK3588内置3个NPU核心,理论算力达6TOPS,为多线程优化提供了硬件基础。教程详细解析了线程池的核心组件(任务队列、工作线程、同步机制)和实现架构,包括类设计、初始化流程、工作线程逻辑(任务获取、NPU推理、结果存储三个阶段)以及任务提交/获取机制。通过预分配模型实例、线程绑定、流量控制等优化手段,实现了从单线程28FPS到多线程120FPS的显著性能提升,为边缘A

LXY_LOVE36的博客 1101
上一篇: 循环神经网络(RNN)相关知识
下一篇: NLP基础:n-gram语言模型和神经网络语言模型
VariableX
博客等级 码龄7年 142粉丝 62原创
评论 1
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值