Huffman赫夫曼编码的工作原理

详解Huffman压缩原理和c++代码实现 目录    一、为什么用Huffman压缩        1、文件在计算机中存储形式 和 常见的读写方式        2、Huffman    二、Huffman的实现        编码篇        1、统计频率        2、建立Huffman树        3、获取Huffman编码表        4、编码        译码篇        1、获取Huffman译码表   ... 阅读详情

谈到压缩这玩意儿,大家可能会想到 忘记压缩密码 将巨大文档变成一个神秘的小文件,而且你还通过这个小文件来恢复这个巨大文档。但是,大家一定都想过,为什么压缩能这么神奇呢?


首先抛开那些什么二叉树,二分查找的。假如让人帮忙复述这一段话:


  •  
中华人民共和国于公元2008年在北京举办了奥林匹克运动会。


他可能会说成:


  •  
中国2008年在北京举办了奥运会。


一下子短了将近一半!这是怎么回事儿啊?


我们都知道,中国就是指中华人民共和国,奥运会就是指奥林匹克运动会。而公元2008年,即使不加公元,人们也会明白你的意思。所以,这其实就是用一些固定的短语(例如中国)来替代比较长的名词(中华人民共和国)。这种方法在压缩算法中叫做字典。


但是,让机器来做这件事就难多了,因为机器对什么汉语英语一窍不通,更不知道什么中国美国。他无法理解短语、句子,连字是什么他也不关心。所以,我们要想让机器能恢复你的大文档,就必须给他一本厚厚的‘字典’ (当然,机器也不喜欢背字典),这本字典中包含着这个文档中用到的名词,以及比这个名词更短的短语。所以,压缩文件中的内容实际上是:


  •  
字典 和 被字典替换过的新句子(比原句子更短)


而字典看起来像是这样:


  •  
  •  
  •  
  •  
  •  
  •  
  •  
第一个: 短语: 中国  对应的名词: 中华人民共和国
第二个: 短语: 奥运会  对应的名词: 奥林匹克运动会
......


因为机器不理解短语,不关心名词,我们也可以在短语上做点手脚,让他变得更短。机器最喜欢的是数字,所以,我们可以将短语都替换成数字。这时候,字典变成了这样:


  •  
  •  
  •  
  •  
  •  
  •  
  •  
第一个: 短语: 1   对应的名词: 中华人民共和国
第二个: 短语: 2   对应的名词: 奥林匹克运动会
......


所以,我们可以对照着字典,将原来很长的句子替换成这个:


原句(真长):

  •  
中华人民共和国于公元2008年在北京举办了奥林匹克运动会。


字典:

  •  
  •  
  •  
  •  
  •  
  •  
  •  
第一个: 短语: 1   对应的名词: 中华人民共和国
第二个: 短语: 2   对应的名词: 奥林匹克运动会
......


替换后:

  •  
1 于公元2008年在北京举办了 2。


好像有点复杂,其实也没什么难的。在我们进入什么完全二叉树、二进制位前先消化一下:
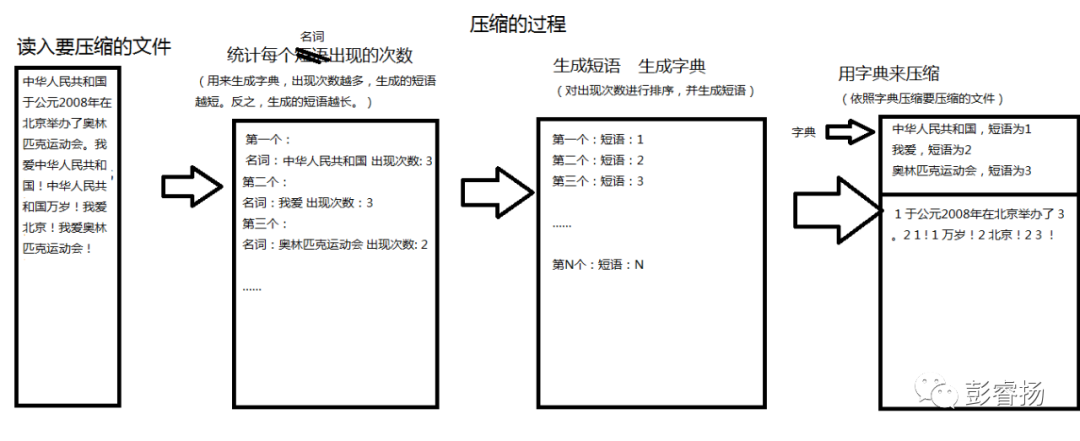
 

图片


(如果大家有不懂的地方,可以在后台直接问我,我收到消息后会慢慢慢慢回复。)


大家了解了基本知识,现在我们来解析一下压缩算法中的元老——huffman编码吧。


huffman编码的核心思想有两个,一个是刚才我们了解的字典,一个是二叉树。


二叉树可以想象成一棵倒过来的树,他由树枝和树叶组成,每一个树枝树叶上都有一个数字。


每一根树枝上可以有树枝,也可以有树叶。但是,同一根树枝上树枝树叶的总和不能大于二,换句话说,一根树枝上最多只能有两个东西(或者叫做节点 node,节点泛指树枝树叶。)


父节点是有孩子的,他是一根树枝,子节点是指父节点的孩子,他既可以是树枝也可以是树叶。


啊,是不是晕了?看张图片吧。
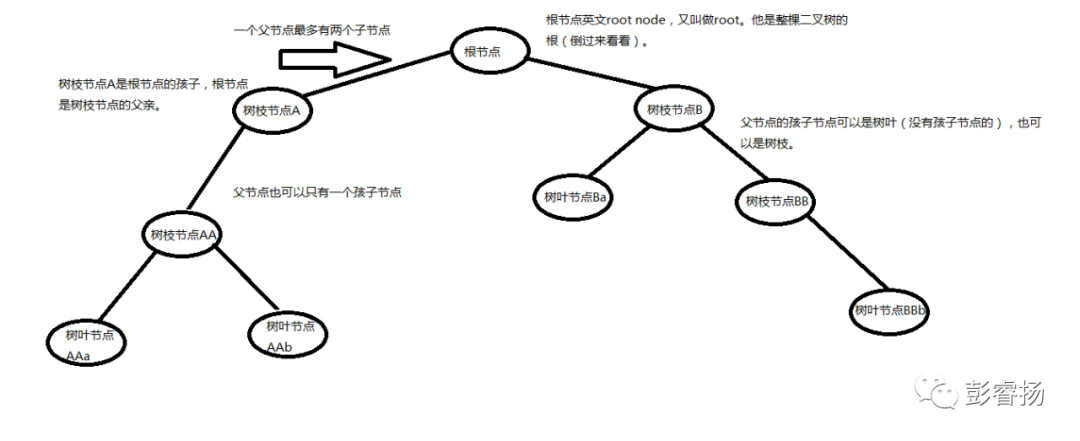
 

图片


为什么要设计成这个样子呢?


大家有没有玩过猜数字游戏(就是《Python编程:从入门到实践》那本书所说的作者小时候做的游戏),程序从1-100之间找一个随机数,然后让你猜,并告诉你猜的太大、太小或者猜对了。大家试试玩这个游戏,找一下最快的方式。


最快的方式类似于这样:
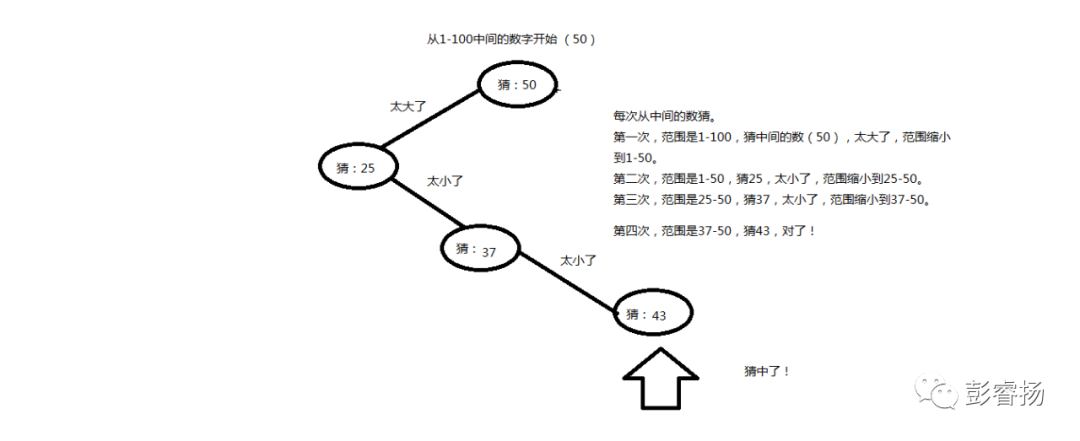
 

图片


没错,这就是二叉查找——每次寻找范围中间的那个数字,并且不断比较,最终找到结果。二叉树是为查找而生的,他的查找速度很快,完全是二叉查找的功劳。


说的太远了,我们继续回来说huffman编码。


huffman编码会先初始化一个字典,这是一个表格,里面有名词以及他的出现次数。他读取出要被压缩的文件,并填完这个表格。


然后,他按出现的次数由大到小排列一个列表,里面只有名词的内容。


最关键的一步,他将出现次数最大的作为根节点,第二大的是根节点左边的孩子节点,第三大的是根节点右边的孩子节点。


第四大的是第二大的左边的孩子节点,还是画张图片吧。


huffman怎么分配短语呢?是这样的,他按照每个位来编码,根节点的编码为1,根左节点的编码为11,根右节点的编码为10(注意是二进制数),etc.
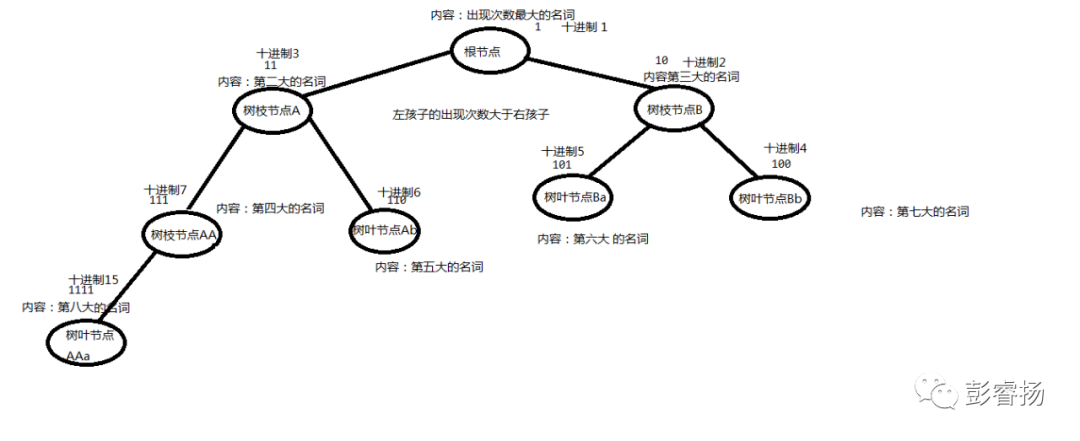


图片

所以,我们用huffman编码将最开始那句话编码下,就变成了:


  •  
1 于公元2008年在北京举办了 2 。3 1 !1 万岁!3 北京!3 2 !


后面是字典。。。 


压缩算法绝对不止huffman一种,这是一种十分简单的算法,相信大家看了这篇文章,应该都懂了吧……(没有自信的)

[数据结构] 二叉树--赫夫曼数的建立、编码与解码 #include <iostream> #include <string> using namespace std; class HuffNode { public: unsigned int weight; unsigned int parent, Lchild, Rchild; }; class HuffManTree { private: void MakeTree(); void SelectMin(int pos, int *s1, in 阅读详情

相关推荐

Dynamics 365从入门到精通:一站式掌握微软智能商业应用平台

很多新手学Dynamics 365时,容易陷入“死记功能”的误区,其实这款平台的核心价值不是“功能多全”,而是“能适配企业业务流程,通过生态集成提升效率”。先从具体业务场景入手,理解每个功能的实际价值;再通过生态集成拓展系统能力;最后通过开发实现定制化,满足企业的特殊需求。按照这个思路,新手不用害怕复杂,一步步落地实战,3个月就能从“入门”到“能独立负责项目”。如果在学习过程中遇到具体问题(比如部署报错、数据迁移失败),欢迎在评论区留言,我会结合实战经验帮你解答!

这里只有干货:从 Modbus 通信到 MES 对接,从 YOLO 训练到工控机部署,带你搞定工业软件开发全流程。 1039

【数据结构与算法】赫夫曼编码

一,基本介绍 二,原理剖析 三,思路分析 四,数据压缩 五,数据解压 六,文件压缩 七,文件解压 八,注意事项

qq_48848473的博客 2925

VS2019中C++动态链接库(DLL)的创建与调用

VS2019中C++动态链接库(DLL)的创建与调用,及一些进阶技巧。

qq_42232522的博客 7562

哈夫曼编码(Huffman Coding)原理详解

哈夫曼编码(Huffman Coding)原理详解

chenyfan_blog 8万+

LabVIEW多设备采集实战:1个程序同时控制3个RS485 Modbus仪表

本文详细介绍了如何使用LabVIEW实现多设备RS485 Modbus同步采集,涵盖硬件架构设计、多线程通信框架搭建、数据帧解析技巧及性能优化策略。通过实际项目案例,展示如何解决端口冲突、数据解析错误等工业自动化常见问题,提升采集系统实时性与可靠性。

qsc901234的博客 298

ZYNQ程序固化实战:从BOOT.bin生成到QSPI/SD卡双启动模式详解

本文详细解析了ZYNQ 7000系列程序固化的完整流程,重点解决了程序断电丢失问题。通过实战演示,从生成BOOT.bin文件到配置QSPI与SD卡双启动模式,逐步指导开发者实现程序在外部存储中的永久驻留,确保产品脱离调试器独立运行。

weixin_29193259的博客 516

哈夫曼编码原理

哈夫曼编码原理 参考: 百度百科 哈夫曼(huffman)树和哈夫曼编码 关于哈夫曼树编码 1. 简介 定义 哈夫曼编码(Huffman Coding),又称霍夫曼编码,是Huffman于1952年提出的一种编码方式,是一种可变字长编码(VLC)。该方法完全依据字符出现概率进行构造的平均长度最短的编码,因此也称之为最佳编码。 应用 得益于哈夫曼编码可以得到一个平均长度最短的码文,因此应用场景很多,在此列举三个: apache负载均衡的按权重请求策略的底层算法 路由器的路由算法 zip文件的

xk_moving的博客 1万+

『言善信』Fiddler工具 — 1、Fiddler介绍与安装

文章目录1、Fiddler简介2、Fiddler功能3、Fiddler工作原理4、Fiddler安装 1、Fiddler简介 Fiddler是强大的抓包工具之一,它能记录所有客户端和服务器之间的HTTP和HTTPS请求,是web调试的利器。 Fiddler是位于客户端和服务端之间的HTTP代理,它的原理是以web代理服务器的形式进行工作的,使用的代理地址是:127.0.0.1,端口默认为8888,我们也可以通过设置进行修改。 Fiddler可以抓取支持HTTP代理的任意程序的数据包,如果要抓取https会

繁华似锦Fighting 1463

【数据压缩】Huffman原理与代码实现

Huffman算法也是一种无损压缩算法,但与上篇文章LZW压缩算法不同,Huffman需要得到每种字符出现概率的先验知识。通过计算字符序列中每种字符出现的频率,为每种字符进行唯一的编码设计,使得频率高的字符占的位数短,而频率低的字符长,来达到压缩的目的。通常可以节省20%~90%的空间,很大程度上依赖数据的特性!Huffman编码是变长编码,即每种字符对应的编码长度不唯一。 前缀码:任何一个字符的编码都不是同一字符集中另一种字符编码的前缀。Huffman编码为最优前缀码,即压缩后数据量最小。 -------

勿在浮砂筑高台 1万+

要理解成本中心与利润中心的根本区别与适用场景,需从 “责任范围、考核核心、管理目标” 三个核心维度切入,同时明确二者在企业管理体系中的联动关系

摘要: 成本中心与利润核心区别在于责任范围、考核目标和管理权限。成本中心仅对成本负责(如生产、行政部门),考核成本控制能力;利润中心需同时管控成本与收入(如独立产品线、区域分公司),以利润为核心指标。选择标准取决于单元是否拥有收入决策权:无收入权的支持/执行部门设为成本中心,能独立经营、核算盈亏的单元设为利润中心。二者协同运作,成本中心为利润中心提供基础支持,利润中心的需求动态影响成本中心资源配置,共同实现企业整体目标。划分本质是确保考核指标与责任范围匹配,避免管理失效。

金牌架构师 656

BOSS直聘数据采集、解析处理、分析与可视化实战

招聘和求职是一对永恒的话题,不论什么时候都有招聘或者是求职的需求,找不找得到工作可能最主要的就是匹配度是否高,待遇福利是否诱人,如今互联网的快速发展,找工作的方式早已发生了翻天覆地的变化,从以往的面对面形式的招聘简历投递和面试方式,变成了电子简历网络直接投递、远程面试录用的形式,便捷性大大提升,需求的快速增长,促生了一批互联网招聘类的企业,诸如:51job、BOSS直聘、拉勾网等等,为了能...

Together_CZ的博客 9022

Huffman树与文件压缩的原理

Huffman树与文件压缩 1、Huffman树的简单介绍 Huffman树,又称为最优二叉树,是加权路径长度最短的二叉树。 下面,我要用一个简单的数组构造一棵Huffman树: a[]={0,1,2,3,4,5,6,7,8,9}; 从图片里我们可以看到数组里面的元素都成了Huffman树的叶子节点(它总是从数组里面找到最小的两个元素开始构造,再把两个数之和放回数组,重复上述过程...

飞奔的蜗牛 4310

代谢组数据分析(二十一):通过MetaboAnalystR标准化构建sPLSDA预测模型

本文介绍了如何使用R语言中的MetaboAnalystR包和mixOmics包进行代谢组学数据的标准化和sPLSDA分析。MetaboAnalystR包用于数据预处理,包括数据初始化、清洗、补足、过滤和标准化等步骤,以确保数据质量。mixOmics包则用于sPLSDA分析,通过Lasso惩罚进行变量选择,并建立分类模型。文章详细说明了安装和加载相关R包的步骤,并提供了数据导入和预处理的代码示例。最后,强调了数据预处理的重要性,以确保后续分析的准确性和可靠性。

专注生信领域 2426

Java之数据结构与算法:赫夫曼树和赫夫曼编码

哈夫曼树和哈夫曼编码哈夫曼树介绍路径和路径长度节点的权及带权路径长度树的权及带权路径长度哈夫曼树的创建创建步骤思路代码实现结果完整代码:哈夫曼编码介绍实践通信领域中信息的几种处理方式定长编码变长编码哈夫曼编码创建哈夫曼树思路代码实现结果完整代码 哈夫曼树 介绍     给定n个权值作为n个叶子节点,构造一棵二叉树,若该树的带权路径长度(wpl)达到最小,就称这种二叉树为哈夫曼树(Huffman Tree),也称为最优二叉树。 路径和路径长度   &

陈煜杰 279

IEM模型,地表粗糙度模拟

利用微波反演土壤水分时候,利用IEM模型可以实现对随机地表的模拟

C# WinForm 基于DirectShow.dll编写的程序,可边预览边保存视频,音频和图片

基于微软的DirectShow.dll的二次开发1.自动识别连接的摄像头跟麦克风且可以对其进行选择(默认选中第一个)2.可录制wmv和avi两种格式的视频并且都带有音频,avi可以录制的分辨率和帧数进行选择,wmv默认进行了淸晰度优化如不喜欢可去除代码中有相关提示3.可在预览点开之后进行拍照,也可边录制视频边拍照4.添加了视频和音频的压缩功能(酌情使用)这次二次开发发现C#对DirectShow的相关信息太少,这次做完也不敢藏私共享出来,还望大家指正

赫夫曼编码

1、基本介绍 赫夫曼编码也翻译为 哈夫曼编码(Huffman Coding),又称霍夫曼编码,是一种编码方式, 属于一种程序算法 赫夫曼编码是赫哈夫曼树在电讯通信中的经典的应用之一。 赫夫曼编码广泛地用于数据文件压缩。其压缩率通常在20%~90%之间 赫夫曼码是可变字长编码(VLC)的一种。Huffman于1952年提出一种编码方法,称之为最佳编码 2、原理剖析 通信领域中信息的处理方式1-定长编码 i like like like java do you like a java //

技术积累,技术分享 6265

华为的C语言编程规范.pdf

华为技术有限公司内部技术规范。本规范制定了编写C语言程序的基本原则、规则和建议。从代码的清晰、简洁、可测试、安全、程序效率、可移植各个方面对C语言编程作出了具体指导。

数据结构与算法——赫夫曼编码

(1)赫夫曼编码也翻译为 哈夫曼编码(Huffman Coding),又称霍夫曼编码,是一种编码方式。属于一种程序算法。赫夫曼编码是赫夫曼树在电信通讯中经典的应用之一。(2)赫夫曼编码被广泛地应用于数据文件压缩。其压缩率通常在20%~90%之间。(3)赫夫曼编码是可变字长编码(VLC)的一种。Huffman于1952年提出一种编码方式,称为最佳编码。

weixin_45942515的博客 1565

怀旧版电脑GBC模拟器

再现原版GBC掌机的界面,电脑运行连游戏界面都一样大小,很怀旧,很真实,(英文版)强烈推荐,很小的文件,很难才找到的。

赫夫曼树的应用:赫夫曼编码(Java版实现)

赫夫曼编码 1、基本介绍 赫夫曼编码也翻译为:哈夫曼编码(Huffman Coding),又称霍夫曼编码,是一种编码方式,。也属于一种程序算法!赫夫曼码是可变字长编码(VLC)的一种。Huffman于1952 年提出一种编码方法,称之为最佳编码。 需要了解的是赫夫曼编码是赫哈夫曼树在电讯通信中的经典的应用之一。另外赫夫曼编码也广泛地用于数据文件压缩。其压缩率通常在20%~90%之间,大大减少了我们存储文件的空间。 2、通信领域中信息处理的三种方式 方式1:定长编码。言外之意就是根据信息原有的长度和字符进行进

laizhenghua的博客 531

霍夫曼编码(Huffman Coding)原理及MATLAB程序实现

霍夫曼编码(Huffman Coding)是一种编码方法,哈夫曼编码是可变字长编码(VLC)的一种。Huffman于1952年提出一种编码方法,该方法完全依据字符出现概率来构造异字头的平均长度最短的码字,是可变字长编码(VLC)的一种,有时称之为最佳编码,一般就叫做Huffman编码(有时也称为霍夫曼编码)。 霍夫曼编码使用变长编码表对源符号(如文件中的一个字母)进行编码,其中变长编码表是通过一

C_1_2_3的博客 1万+

稀疏自编码与其他压缩技术的比较

1.背景介绍 稀疏自编码(Sparse Autoencoder)是一种深度学习算法,主要用于处理稀疏数据。稀疏数据是指数据中很多元素为零或者接近零的数据。稀疏自编码可以用于图像压缩、文本压缩等领域。在本文中,我们将对稀疏自编码与其他压缩技术进行比较,以便更好地理解其优缺点和适用场景。 2.核心概念与联系 2.1稀疏自编码 稀疏自编码是一种深度学习算法,主要用于处理稀疏数据。它的核心思想是通...

AI天才研究院 396

哈夫曼压缩算法——编码原理

哈夫曼编码 介绍 哈夫曼树(HuffManTree)是用来压缩数据的一种数据结构,它适合压缩数据重复率较高的情况。 文本A:123456789,这串文本重复率为0,因为每个字符都是唯一的,没有重复率而言; 文本B:111222334,这串文本重复率明显较A高,适合用哈夫曼树压缩。 问题与分析 现在想把“aaaabbbccdeefffgggg”这个字符串保存到硬盘上,如果直接保存,它会占用多大空间? 回顾一下,每个英文字母都可以用一个ASCII码表示,例如 a=97,b=98,…… 而每个ASCII码是 1

qq_44676331的博客 1798

Huffman 算法原理及代码实现

Huffman 算法原理 前缀码 在一个字符集中,任何一个字符的编码都不是另一个字符编码的前缀,即前缀码。 例如,有两个码字 111 与 1111,那么这两个码字就不符合前缀码的规则,因为 111 是 1111 的前缀。放到二叉树里来讲,只用叶子节点编码的码字才是前缀码,如果同时使用 中间节点和叶子节点编码,那结果就不是前缀码。因为压缩中经过编码的码字全部是前 缀码,所以在对照码表解压的时候,碰到哪个码字就是哪个码字,不用担心出现某个字 符的编码是另一个字符的编码的前缀的情况,该意识一定要具备。 .

jenie的专栏 3098

性能优化--哈夫曼算法原理

大家都知道,使用哈夫曼压缩能达到无损压缩,也就是说。保证了原图质量的同时,能够降低图片的大小。这是什么原理呢?首先我们需要了解的是Android系统加载图片使用的是Skia加载库,当然这个库的底层还是是用的jpeg对图片进行压缩处理,但是为了能够适配低端的手机(这里的低端是指以前的硬件配置不高的手机,CPU和内存在手机上都非常吃紧 性能差),由于哈夫曼算法非常吃CPU,被迫用了其他的算法。所以Sk...

qinbin2015的博客 2056

huffman压缩

文件压缩是在不丢失有用信息的前提下,缩减数据量以减少存储空间,提高传输、存储火绒处理效率,同时可以对数据加密保护(加密算法),增强数据在传输过程中的安全性有损压缩,可能丢失一些信息,不能还原到与源文件一样的,适合图片压缩,压缩率会更好无损压缩,压缩后的压缩文件可以被还原成与源文件完全相同的格式。

m0_73284013的博客 1462

文件压缩---huffman算法

万年历online项目链接点击这里本篇文章主要包含4个方面: 1.哈夫曼算法实现压缩的原理 2.具体压缩及解压过程思路阐述 3.项目中遇到的问题 4.项目扩展一、原理简述: huffman算法实现文件压缩的主要原理是通过huffman编码来重新表示字符,使得出现频率高的字符编码短,出现少的字符编码长。当用编码表示原文件时,总体的bit位时相对减少的。但当大部分字符出现的频率都差不多

Fly_bit的博客 1434
上一篇: 空指针 - segmentation fault: 栈中的临时变量
下一篇: RISC-V 架构指令集手册 第一册 无特权指令集 中文翻译
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值