MongoDB小课堂: 索引核心机制深度剖析与高效应用实践指南

解决2020R2,2022R1等版本的SCDM无法编辑草图尺寸的问题 阅读详情

背景:索引的核心价值与基础原理


索引本质:对指定字段预排序的数据结构(B-tree),通过空间换时间优化查询性能
搜索时间复杂度优化至 O(log n)

关键优势:

  • 查询性能提升 10~1000 倍(取决于数据规模)
  • 排序操作可直接利用索引顺序,避免全表扫描

以用户银行账户集合为例,文档结构包含字段:

  • name(客户姓名)
  • currency(账户货币种类)
  • balance(账户余额)

性能瓶颈与解决方案

原始数据存储结构(无序):
Bob → Sam → Alice → Bob 
  • 问题场景:查询 name: "Alice" 需遍历所有文档(时间复杂度 O(n))
  • 索引作用:构建排序映射(时间复杂度 O(log n))

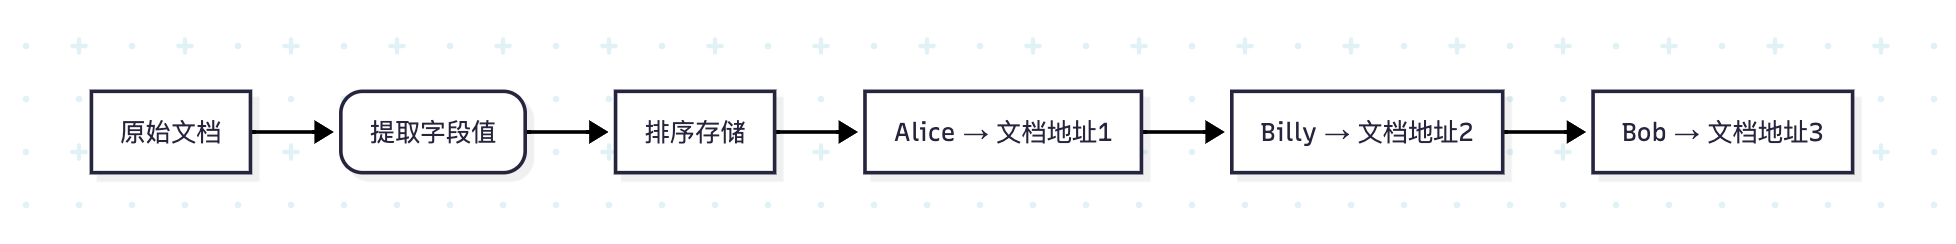
索引创建流程:

  1. 提取目标字段值(如 name)
  2. 对值排序(字母序:Alice → Billy → Bob)
  3. 每个值关联指向原始文档存储地址的指针

在这里插入图片描述

索引的性能价值对比

场景时间复杂度百万文档查询耗时性能影响
无索引(COLLSCAN)O(n)秒级~分钟级线性劣化,资源消耗高
有索引(IXSCAN)O(log n)毫秒级查询加速 10~1000 倍

趋势结论:数据量每增加一个数量级,无索引查询耗时成倍增长,索引优化效果更显著。

索引类型与核心特性


索引分类与创建方法

类型适用场景创建代码(Mongo Shell)说明
单键索引单字段查询/排序db.accounts.createIndex({ name: 1 })索引名称自动生成:name_1
复合键索引多字段组合查询/排序db.accounts.createIndex({ name: 1, balance: -1 })索引名称:name_1_balance_-1
多键索引数组字段元素查询db.accounts.createIndex({ currencies: 1 })–

复合键索引的核心规则:前缀子查询

  • 定义:索引 { a:1, b:1, c:1 } 仅支持以下查询:
    • { a: value }
    • { a: value, b: value }
    • { a: value, b: value, c: value }
  • 不支持的场景:
    • 非前缀字段查询(如 { b: value } 或 { c: value })。
    • 跳前缀查询(如 { b: value, c: value })。
  • 示例:
    • 索引 {name:1, currency:1, balance:1} 可加速 {name:"Alice"} 或 {name:"Alice", currency:"CNY"}。
    • 无法加速 {balance:100} 或 {currency:"USD", balance:100}(非前缀组合)。

复合键索引的前缀子查询规则(简注:索引生效的前提条件),前缀子查询规则:

  • 复合索引仅支持从左到右连续字段的查询:

    索引字段有效查询字段无效查询字段
    A-B-CA / A-B / A-B-CB / C / B-C
  • 示例

    // 索引定义:{ name:1, currency:1, balance:1 }
    // ✅ 有效查询(前缀匹配)
    db.accounts.find({ name: "Alice" })                         // 使用第一个字段
    db.accounts.find({ name: "Alice", currency: "CNY" })        // 使用前两个字段
    //  ❌ 无效查询(非前缀)
    db.accounts.find({ balance: 100 })                          // 缺失前缀字段
    db.accounts.find({ currency: "USD", balance: 100 })         // 跳过前缀字段 
    
  • 多键索引(数组字段)

    // 为数组字段 currency 创建索引 
    db.accounts.createIndex({ currency: 1 }) 
    
  • 存储机制:数组每个元素单独作为索引键

  • 数据结构示例:

    GBP → 指向 Alice 文档地址  
    USD → 指向 Alice 文档地址  
    EUR → 指向 Bob 文档地址 
    

索引管理操作


// 查看索引 
db.accounts.getIndexes()  // 包含默认 _id 索引
 
// 删除索引 
db.accounts.dropIndex("name_1")                 // 按名称删除
db.accounts.dropIndex({ name:1, balance:-1 })   // 按定义删除
 
// 重建索引(需先删后建)
db.accounts.reIndex()
// 或
db.accounts.dropIndex("old_index");
db.accounts.createIndex({ newField: 1 }, { name: "new_index" });

要点

  • 复合键索引字段顺序 = 查询频率优先级
  • 唯一性+稀疏性组合解决非空字段约束问题
  • TTL索引仅支持单键索引,后台清理存在延迟

索引设计最佳实践

  • 前缀匹配优先:复合键字段顺序按查询频率从高到低排列。
  • 避免过度索引:索引增加写入开销(需维护数据结构)
  • 覆盖查询优化:优先返回索引字段,消除 FETCH 阶段

四大高级特性


1 ) 唯一性(Unique)

db.accounts.createIndex({ balance: 1 }, { unique: true })
// 规则:字段值必须唯一,缺失字段视为 null(仅允许一篇文档缺失)
  • 默认唯一索引:_id 字段自动创建
  • 冲突规则:
    • 字段值重复的文档会导致创建失败
    • 缺失字段处理:多篇文档缺失该字段时触发唯一性冲突(值视为 null)

2 ) 稀疏性(Sparse)

db.accounts.createIndex({ balance: 1 }, { sparse: true })
// 规则:仅索引包含该字段的文档(节省存储空间)
  • 节省空间:缺失字段的文档不加入索引
  • 复合索引规则:仅当文档缺失所有索引字段时被排除

3 )唯一性+稀疏性组合

  • 允许缺省字段且不触发唯一性约束(常用场景:可选唯一字段)
    db.accounts.createIndex(
      { balance: 1 }, 
      { unique: true, sparse: true }  // 关键组合 
    );
    
    // 可插入多篇无 balance 文档 
    db.accounts.insert({ name: "Doc3" });  // 成功
    db.accounts.insert({ name: "Doc4" });  // 成功 
    

4 ) TTL生存时间索引

db.accounts.createIndex({ lastAccess: 1 }, { expireAfterSeconds: 20 })
// 规则:自动删除过期文档(适用于会话/日志)
// 插入文档(自动过期删除)
db.accounts.insert({
  name: "Temp",
  lastAccess: new Date()  // 插入时间戳
});
// 20 秒后文档自动删除 
  • 字段要求:日期类型或日期数组
  • 数组处理:取最小日期值判断过期
  • 删除机制:后台线程执行,存在延迟

特性组合最佳实践:

// 唯一性+稀疏性 → 处理可选唯一字段
db.accounts.createIndex({ balance: 1 }, { unique: true, sparse: true })

索引效果分析与性能验证


使用 explain() 方法分析查询执行计划:

// 分析未使用索引的查询 
db.accounts.find({ balance: 100 }).explain("executionStats")

关键执行阶段解析:

执行阶段 (stage)含义性能影响
COLLSCAN全集合扫描严重性能瓶颈
IXSCAN索引扫描高效
FETCH根据指针获取完整文档可优化项

索引优化示例:

// 案例1:索引覆盖查询(避免 FETCH 阶段)
db.accounts.find({ name: "Alice" }, { _id: 0, name: 1 })
 
// 案例2:索引加速排序 
db.accounts.find().sort({ name: 1, balance: -1 })
// 若匹配复合索引 {name:1, balance:-1} 则无 SORT 阶段 

性能对比:

  • 全表扫描 (COLLSCAN):强制内存排序,资源消耗高
  • 索引扫描 (IXSCAN):直接按索引顺序返回结果

性能分析:explain() 命令

  • 场景对比:
    查询类型winningPlan.stage性能
    无索引字段查询COLLSCAN(全表扫描)低效(O(n))
    索引字段查询IXSCAN(索引扫描)高效(O(log n))
    索引覆盖查询(仅返回索引字段)IXSCAN(无 FETCH 阶段)最优
  • 示例:
    // 低效查询(无索引)  
    db.accountsWithIndex.find({ balance: 100 }).explain();  
    // 输出: "winningPlan.stage": "COLLSCAN"  
    
    // 高效查询(使用索引)  
    db.accountsWithIndex.find({ name: "Alice" }).explain();  
    // 输出: "winningPlan.stage": "IXSCAN"  
    

案例:性能验证与优化实战


案例1:Explain分析索引效果

// 无索引查询 → COLLSCAN(全表扫描)
db.accounts.find({ balance: 100 }).explain("executionStats")
/* 输出关键指标:
"executionStats": {
  "executionTimeMillis": 120,   // 耗时高 
  "totalDocsExamined": 1000000, // 扫描所有文档
  "stage": "COLLSCAN"           // 性能瓶颈 
}
*/
 
// 有索引查询 → IXSCAN(索引扫描)
db.accounts.find({ name: "Alice" }).explain("executionStats")

/* 输出:
"executionStats": {
  "executionTimeMillis": 2,     // 毫秒级响应
  "totalDocsExamined": 1,       // 仅扫描匹配文档
  "stage": "IXSCAN",             
  "indexName": "name_1"         
}
*/

2 ) 案例2:索引覆盖查询(简注:避免FETCH阶段)

// 仅返回索引字段 → 直接读取索引数据 
db.accounts.find({ name: "Alice" }, { _id: 0, name: 1 })
// 执行计划显示无 FETCH 阶段(性能最优)

3 ) 案例3:复合索引加速排序

// 索引匹配排序条件 
db.accounts.find().sort({ name: 1, balance: -1 })
// 若存在索引 {name:1, balance:-1} → 直接复用索引顺序 
 
// 索引不匹配 → 触发内存排序
db.accounts.find().sort({ name: 1, balance: 1 }) // 出现 SORT 阶段 

4 ) 案例4:NestJS中实现索引(TypeORM)

typeorm 示例

import { Entity, Column, Index } from 'typeorm';
 
@Entity()
export class Account {
  @Column()
  @Index()  // 单字段索引 
  name: string;
 
  @Column('simple-array')
  @Index({ sparse: true })  // 数组稀疏索引
  currencies: string[];
 
  @Column()
  @Index('IDX_BALANCE', { unique: true }) // 唯一索引 
  balance: number;
 
  @Column({ type: 'timestamp' })
  @Index('IDX_LAST_ACCESS', { expireAfterSeconds: 3600 }) // TTL索引
  lastAccess: Date;
}

mogoose 示例

// 使用 Mongoose 在 NestJS 中创建索引  
import { Prop, Schema, SchemaFactory } from '@nestjs/mongoose';  

@Schema()  
export class Account {  
  @Prop({ required: true })  
  name: string;  

  @Prop({ type: [String] })  
  currency: string[];  

  @Prop()  
  balance: number;  

  @Prop({ type: Date })  
  lastAccess: Date;  
}  

export const AccountSchema = SchemaFactory.createForClass(Account);  

// 添加索引  
AccountSchema.index({ name: 1 }); // 单键索引  
AccountSchema.index({ name: 1, balance: -1 }); // 复合键索引  
AccountSchema.index({ lastAccess: 1 }, { expireAfterSeconds: 20 }); // TTL索引  

要点

  • explain() 的 stage 字段是性能关键指标(优先 IXSCAN)
  • 索引覆盖查询可减少 50% 以上 I/O 开销
  • 复合索引字段顺序必须与排序方向一致

5 ) 原生 SQL 索引操作对比

-- 创建单字段索引 (MySQL)
CREATE INDEX idx_name ON accounts(name);
 
-- 创建复合索引 (PostgreSQL)
CREATE INDEX idx_name_currency ON accounts(name, currency);
 
-- 创建唯一约束 (SQL Server)
CREATE UNIQUE INDEX uq_balance ON accounts(balance);

索引最佳实践与生产建议


核心特性总结

特性适用场景生产环境建议
复合键索引多字段组合查询字段顺序按查询频率排列
唯一性+稀疏性可选唯一字段(如手机号)优先使用组合特性
TTL索引临时数据(会话/日志)设置合理过期时间
  • 索引本质: 排序后的字段-地址映射表(B-Tree),将查询复杂度从 O(n) 降至 O(log n)
  • 复合键索引: 必须遵循前缀子查询规则,非前缀查询无法优化
  • 索引代价: 占用存储空间,降低写入速度(需更新索引),需权衡读写比例
  • 特性组合: 唯一性+稀疏性 是处理可选唯一字段的最佳实践,TTL 索引适用于临时数据场景

索引选择原则

  • 优先为高频查询字段创建索引
  • 复合索引字段顺序 = 查询频率排序
  • 避免全集合扫描 (COLLSCAN)

索引代价平衡矩阵

优势代价缓解策略
查询性能提升 10~1000 倍占用额外磁盘/内存空间定期清理无用索引
避免全表扫描(COLLSCAN)降低写入速度(维护索引成本)读写分离架构
加速排序操作增加代码复杂度使用 explain() 持续监控

生产环境最佳实践

  • 唯一性+稀疏性组合:{ unique: true, sparse: true }
  • TTL 索引用于日志/会话等临时数据
  • 设计阶段
    • 为高频查询字段创建索引
    • 复合索引字段 ≤ 3 个(避免过度索引)
  • 运维阶段
    • 每月执行 db.collection.stats() 分析索引大小
    • 使用 Performance Advisor(Atlas工具)自动推荐索引
  • 监控告警
    • 设置慢查询阈值(db.setProfilingLevel(1, { slowms: 100 }))
    • 当 COLLSCAN 比例 > 5% 时触发告警

终极原则:

  • 索引不是越多越好 – 每新增一个索引,写入速度下降 10%~15%
  • 通过 executionStats 持续验证索引收益,动态调整策略

要点

  • 索引提升读性能,代价是写延迟
  • TTL索引删除存在延迟(异步线程)
  • 唯一性约束对缺失字段的处理需特别注意
YOLOv11改进 | 特殊场景检测篇 | 利用图像去雾网络UnfogNet改进yolov11图像雾天检测能力(全网独家首发改进) 本文给大家带来的改进机制是利用UnfogNet超轻量化图像去雾网络,我将该网络结合YOLOv11针对图像进行去雾检测(也适用于一些模糊场景),我将该网络结构和YOLOv11的网络进行结合同时该网络的结构的参数量非常的小,我们将其添加到模型里增加的计算量和参数量基本可以忽略不计这是非常难得的,因为其也算是一种图像增强算法,同时本文的内容不影响其它的模块改进可以作为工作量凑近大家的论文里,非常的适用,图像去雾检测为群友最近提出的需要的改进。欢迎大家订阅我的专栏一起学习YOLO! 阅读详情

相关推荐

西门子Simotion运动控制

SIMOTION

rjimhcd的博客 3025

Mac下MySQL的配置和修改密码以及忘记密码后的重置密码

1 ) Mac下MySQL的配置和修改密码 2 ) 忘记并重置密码 启动MySQL服务,通过 $ps aux | grep mysql 判断是否启动该服务,若未启动,则到 系统偏好设置/MySQL面板 启动服务 软件默认会安装到:/usr/local/mysql 目录,进入这个目录下的bin目录:$cd /usr/local/mysql/bin 执行 $./mysql -u root -p 通过初始密码登录MySQL 通...

Wang的专栏 6259

机器学习——先验概率、后验概率、全概率公式、贝叶斯公式

先验概率(prior probability)是指根据以往经验和分析得到的概率,如全概率公式,它往往作为"由因求果"问题中的"因"出现的概率。后验概率是指在得到“结果”的信息后重新修正的概率,是“执果寻因”问题中的"果"。贝叶斯公式就是当已知结果,问导致这个结果的第 i 原因的可能性是多少。

fortune_cookie的博客 1万+

mysql数据库的一些简单的sql语句 内连接 - 表的关联查询

# 创建一个user表 create table users( id int primary key auto_increment, name varchar(20), dpt_id int ); # 向user表中插入数据 insert into users values (null,'刘备',1), (null,'关羽',2), (null,'赵

Wang的专栏 4264

Cadence Sigrity PowerDC实战:如何用PCB电热混合仿真解决散热难题(附详细配置步骤)

本文详细介绍了如何利用Cadence Sigrity PowerDC进行PCB电热混合仿真,以解决高功率密度设计中的散热难题。文章通过解析电热耦合原理,并附上详细的配置步骤与实战技巧,指导硬件工程师同步优化电气性能与热管理,从而在设计源头提升产品可靠性与效率。

weixin_29292535的博客 199

webpack性能优化-optimization.splitChunks.chunks中的“all“、“async“和“initial“

最初,chunks(以及内部导入的模块)是通过内部 webpack 图谱中的父子关系关联的。CommonsChunkPlugin 曾被用来避免他们之间的重复依赖,但是不可能再做进一步的优化。 ——摘自 webpack 从 webpack v4 开始,移除了 CommonsChunkPlugin,取而代之的是 optimization.splitChunks。 而关于 optimization.splitChunks 中的chunks,webpack 官方文档却没有很好的进行举例解释,只说明了 async.

程序员秋风的博客 3138

数据库、数据库类型、RDBMS以及MySQL

什么是数据库 数据库 就是按一定的结构来组织、存储和管理数据的仓库 可以很方便的进行crud, 能提供多个用户共享、具有尽可能小的冗余度、与应用程序批次独立的数据集合。 其他持久储存缺点:文件操作(不灵活) 数据库类型 包括 : 关系型 和 非关系型 【关系型】 MySQL MariaDB PostgreSQL Microsoft SQL Server Oracle数据库 Sybase 【...

Wang的专栏 4039

超级详细!!!新手使用AutoDL跑深度学习(MixVPR项目)的学习记录

新手第一次在AutoDL上跑深度学习的实验,遇到一些问题,简单记录一下。如果大家发现问题,欢迎和我讨论。

weixin_45152283的博客 5万+

Eggjs笔记:Eggjs集成ElasticSearch及CRUD操作

相关文档 https://www.elastic.co/guide/index.html https://www.elastic.co/guide/en/elasticsearch/client https://www.elastic.co/guide/en/elasticsearch/client/javascript-api/current/configuration.html https://www.elastic.co/guide/en/elasticsearch/client/javascrip

Wang的专栏 3530

OPC UA协议深度解析 + C#跨平台实战:无缝对接西门子S7-1200/1500 PLC

本文完成了OPC UA协议深度解析→西门子PLC服务端配置→C#跨平台客户端开发→全平台部署拆解OPC UA核心模型与安全机制,从原理层面理解工业标准化通信逻辑基于官方SDK开发工业级客户端,支持读写、订阅、证书管理、心跳保活核心功能实现Windows、Linux、统信UOS全平台兼容,满足工控系统国产化改造刚需提供完整的优化方案与踩坑指南,可直接落地商用项目。

这里只有干货:从 Modbus 通信到 MES 对接,从 YOLO 训练到工控机部署,带你搞定工业软件开发全流程。 520

【Windows Server 2019】活动目录 (Active Directory) ——将计算机加入域和脱离域

博文介绍了如何将计算机加入AD域和脱离AD域,包括加入域,验证客户机加入到域后的信息,使用域账户用户在客户机上登录,使用本地账户用户在计算机上登录,脱离域。

VMware, Windows, Linux, Cisco, Container, Kubernetes, Kali 6170

Redis: 集群高可用之故障转移和集群迁移

若要检查源和目标是否数据统一,还可选择阿里配套工具RedisFullCheck。3.4 使用 RedisFullCheck 工具检查。下载官方编译好的工具包,直接解压后就能使用。故障转移,包括自动故障转移和手动故障转移。运行之后,就给一个反馈结果,如果是。1.2 原集群与目标集群结构不一致。1.1 原集群与目标集群结构一致。2 ) 手动故障转移。

Wang的专栏 2918

第十四节《OpenCascade集成Qt》

将 OpenCascade 与 Qt 集成是开发图形界面应用的常见需求。通过将 OpenCascade 的几何建模与 Qt 的图形用户界面(GUI)功能结合,可以创建强大而灵活的 CAD 或建模工具。OpenCascade 提供了与 Qt 的集成接口,允许你在 Qt 应用程序中嵌入 OpenCascade 的视图,执行几何操作,并与用户进行交互。以下是 OpenCascade 与 Qt 集成的详细步骤:首先,确保已安装 OpenCascade 和 Qt。你可以从 OpenCascade 官方网站或通过包管理

yumeiguo的博客 597

Python笔记:基于Django框架的数据库设计

概述 需要根据《项目建议书》、《需求说明书》、界面原型、各种标准规范对数据库进行设计, 我们目前先参考这一设计图 结构设计 1 ) 找实体 实体是实体-关系模型的基本对象, 是现实世界中各种事物的抽象。 凡是可以相互区 开并可以被识 的事、物、概念等对象均可认为是实体。 基本的实体列表如下: 会员 类别 商品 订单 订单详情 收货地址 商品评论 商品图片 友情链接 站内公告 … ...

Wang的专栏 2772

STM32F407中文手册

STM32f407中文手册 本参考手册面向应用开发人员,提供有关使用 STM32F405xx/07xx、STM32F415xx/17xx、 STM32F42xxx 和 STM32F43xxx 微控制器存储器与外设的完整信息。STM32F405xx/07xx、STM32F415xx/17xx、STM32F42xxx 和 STM32F43xxx 构成一个微 控制器系列,各产品具有不同的存储器大小、封装和外设。有关订购信息以及器件的机械与电气特性,请参见数据手册。有关 ARM Cortex™-M4F 内核的信息,请参见《Cortex™-M4F 技术参考手册》。

锂电池充电器电路设计 里面有电路

锂电池充电器电路设计 里面有电路 3.7V升压到5V电路设计。

Elastic Stack梳理:集群搭建指南之高可用架构与实战部署

本文介绍了Elasticsearch分布式架构和Cerebro监控工具的部署策略。主要内容包括: ES集群角色划分(主节点、数据节点、协调节点)及功能说明 Cerebro监控工具的独立部署方法和访问方式 集群拓扑规划示例,包含节点IP分配和架构拓扑图 各类型节点的配置原则和数量计算公式 高可用主节点配置要点及示例配置 生产环境优化建议,包括分片规划、硬件配置和安全措施 文章提供了完整的集群部署方案,涵盖从基础概念到具体实施的各个环节,适用于不同规模的ES集群建设。

Wang的专栏 2545

Outlook Express 6 (OE6) for Win7/Win8/Win10

英文版 Outlook Express6.0, 兼容Win7/Win10/WinXP,解压就可用。

Redis: 集群环境搭建,集群状态检查,分析主从日志,查看集群信息

当从节点获得足够多的选票时,它就会成为新的主节点,并增加自己的configEpoch来更新槽位配置。在Redis集群中,纪元的更新通常是由节点间的通信和状态变更触发的。例如,当某个节点接收到来自其他节点的状态变更通知时,它会比较通知中的纪元与自己的纪元。如果通知中的纪元更大,则更新自己的纪元。确保集群状态的一致性:通过递增的纪元,集群中的节点可以确保它们对集群状态的认知是一致的。通过递增的纪元版本号,集群中的节点可以确保它们对集群状态的认知是一致的,并解决可能出现的配置冲突问题。4 )纪元的更新机制。

Wang的专栏 2466

汉书HE8,好用的汇编代码编写工具

汉书HE8,好用的汇编代码编写工具早期编写汇编代码所用功能强大

MySQL: 数据库性能的决定性因素之从双十一大促高并发场景看系统瓶颈与优化路径

电商大促期间,数据库面临高并发写入、连接数暴增、慢查询积压等核心挑战。本文分析了锁竞争、主从延迟等关键性能瓶颈,并提出多种优化方案:1)使用乐观锁通过版本号控制库存超卖;2)CAS机制实现无锁并发;3)分布式锁协调多节点操作。这些方案在保证数据一致性的同时提升吞吐量,适用于库存扣减、订单创建等典型场景,有效解决数据库扩展难题。

Wang的专栏 2426

Redis: Sentinel哨兵监控架构及环境搭建

在主从模式下,我们通过从节点只读模式提高了系统的并发能力并发不断增加,只需要扩展从节点即可,只要主从服务器之间,网络连接正常主服务器就会将写入自己的数据同步更新给从服务器,从而保证主从服务器的数据相同在这种架构下,它仍然是有一些缺点的,比如说它的可靠性保证不是很好,因为主从模式下,主节点故障了便无法提供写入的服务现在,我们通过哨兵来解决这个问题然后,主节点其实写的压力也是并没有被释放的包括主从之间的数据是相同的,它还有数据冗余一个问题后面集群也会解决这个问题。

Wang的专栏 2181

MongoDB小课堂: 高级查询操作符与游标管理综合指南之深度整合逻辑操作符、字段处理、数组查询与游标控制的最佳实践

MongoDB查询操作符与游标管理摘要 本文整合了MongoDB常用查询操作符和游标管理的关键知识点: 比较操作符: $in和$nin用于多值匹配,注意$nin会包含字段缺失文档 结合$exists可处理字段缺失问题 逻辑操作符: $and可简写为逗号分隔条件 $or可用$in优化等值查询性能 $not和$nor需谨慎处理字段缺失 字段操作符: $exists检查字段存在性 $type支持按BSON类型筛选 数组操作符: $all要求包含所有指定元素 $elemMatch匹配满足条件的数组元素 正则表达式:

Wang的专栏 2145

Redis: 集群测试和集群原理

Redis Cluster 没有单机那种 16个数据库 (0 - 15) 数据库的概念了,就是我们已经看不到数据库了。而是分成了 16384 个 slots (槽位) ,每个节点负责其中一部分槽位,槽位的信息存储于每个节点中。2 ) 16384 个 slots (槽位)那我们客户端这边是怎么来操作集群的呢?1 ) SET/GET 命令。2 ) 开启从节点只读模式。

Wang的专栏 2102

Eggjs笔记:详解Mongoose的聚合管道以及populate实现关联查询

基于mongodb的聚合管道 此处忽略之前mongodb在eggjs中需要配置的步骤,前文已有说明,现在开始在controller中调用(应该封装到service中的,仅作为示例) const result = await this.app.mongo.aggregate('order', { pipeline: [ { $lookup: {...

Wang的专栏 2096

MySQL: 数据库监控核心要素与实施策略

数据库监控是确保系统稳定的关键,涵盖服务可用性、性能、主从复制和资源使用等方面。核心监控包括:通过真实连接和查询验证数据库可用性;跟踪QPS、TPS和并发线程数等性能指标;监控主从复制的链路状态和延迟;以及关注磁盘空间等服务器资源。实现方案包括网络连接验证、读写测试和连接数阈值监控。性能监控需持续记录数据趋势,并采用精准方法检测阻塞事务和复制延迟。全面的数据库监控能有效预防故障,保障系统稳定运行。

Wang的专栏 2096

MySQL: 索引优化策略详解:核心原则、高级应用与维护实践

本文介绍了数据库索引优化的核心策略。第一部分重点讲解高效索引设计原则:禁止在索引列使用表达式或函数;合理使用前缀索引以平衡选择性和存储空间;设计联合索引时应优先考虑高频查询、高选择性和小宽度列;以及利用覆盖索引减少回表查询。第二部分探讨索引的高级应用,特别强调通过合理设计索引优化排序操作。文章指出索引列顺序需与ORDER BY完全一致,并分析了InnoDB与MyISAM存储引擎在排序支持上的差异。通过实际SQL示例展示了索引优化前后的性能差异,为数据库性能调优提供了实用指导。

Wang的专栏 2061

屏幕不止一种:OLED、LCD1602字符屏、TFT/IPS图形屏和串口屏怎么用,这与TTY和PTY又有什么关系

要图像、要曲线、要一块比现在更大的画面,面前的屏就不止一种了。OLED、LCD1602字符屏、TFT/IPS图形屏和串口屏怎么用,又该按什么来挑?这与TTY和PTY又有什么关系?

Lxx_Zw的博客 318

5个陷阱和解决方案:MongoDB源码中自动化测试平台的数

在现代软件工程实践中,自动化测试平台扮演着至关重要的角色,它确保了系统的稳定性和迭代的可靠性。然而,随着业务数据量的快速增长以及并发写入需求的不断上升,基于MongoDB构建的自动化测试平台常常面临性能瓶颈和数据一致性问题。本文将围绕MongoDB源码中一个关键模块——,通过一行一行代码的解读,揭示其设计原理、性能调优点及常见陷阱,适合希望深入理解数据库实现机制的高级工程师。

wuchangjian的专栏 175

用Ai8051帮我写一个FX3UPLC 程序

用Ai8051帮我写一个FX3UPLC 程序AI这个需求我得先跟您确认清楚,因为"用Ai8051U写一个FX3U PLC程序"这个说法本身存在歧义,我不能凭猜测直接给您出一套代码。

czhaii的专栏 303
上一篇: MongoDB小课堂: 聚合管道操作全面指南与实战解析
下一篇: MongoDB小课堂: 深度掌握$lookup聚合——从基础语法到高级关联查询实战指南
Wang's Blog
博客等级 码龄12年 7438粉丝 2421原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包

打赏作者

Wang's Blog

你的鼓励将是我创作的最大动力

¥1 ¥2 ¥4 ¥6 ¥10 ¥20
扫码支付:¥1
获取中
扫码支付

您的余额不足,请更换扫码支付或充值

打赏作者

实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值