从大数据到图计算-Graph On Big Data

技术解读 | TuGraph图分析引擎技术剖析 借助TuGraph的 C++ 图分析引擎 API ,用户可以对不同数据来源的图数据快速导出一个待处理的复杂子图,然后在该子图上运行诸如BFS、PageRank、LPA、WCC等迭代式图算法,最后根据运行结果做出相应的对策。参数模块作用于分析引擎中的Standalone模式,用于对图的一般信息(如数据来源,算法名称,数据输入、输出路径,顶点个数等)以及根据不同数据来源、不同算法所配置的不同信息参数进行接受和整理,传输给图算法及各个模块,同时将最终结果模块化展示。一般分为预处理、算法过程、结果分析三个阶段。 阅读详情

-背景-

自2003年Google的三篇大数据领域经典论文GFS、MapReduce和BigTable发表以来,大数据领域取得了长足的发展。尤其是开源大数据领域各种优秀的开源大数据引擎层出不穷,先后出现了Hadoop、Hive、Storm、Spark、Flink以及Presto等多种优秀的开源项目。从应用场景上覆盖了离线计算、流式计算、OLAP查询以及流批一体等多种计算形态,针对大数据的处理技术日益完善和多样化。

这些大数据引擎主要处理的是表模型的数据,即将要处理的数据以表模型来建模,然后进行加工处理。表模型虽然相对简单,易于理解,然后也存在局限性,尤其是在处理复杂关系的运算和表达上存在着比较大的困难。表模型主要通过Join的方式来处理表之间的关联关系,Join的方式会带来大量的shuffle,增加运行资源。尤其是当关联度数比较高时,Join方式的弊端会更加明显。另外对于复杂关系的描述比如最短路径、k-hop等通过表模型语言SQL也很难表达。

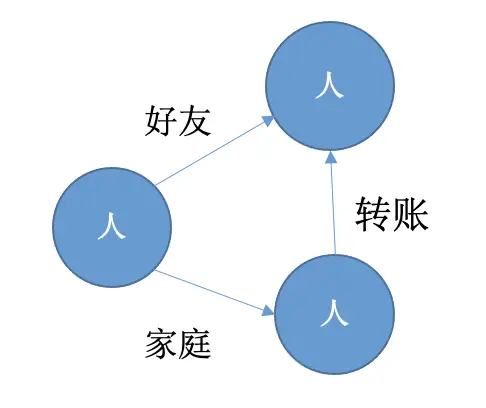
图模型作为一种以点和边作为基本单元定义的数据模型天然可以描述关联关系。在图模型里面以点代表实体,以边代表关系。比如在人际关系图里面,每一个人可以用一个点来表示,人和人之间的关系通过边来表示,人与人之间可以存在各种各样的复杂关系,这些关系都可以通过不同的边来表示。基于图模型一方面可以很好的描述复杂关系以及复杂关系的运算,另外一方面图的存储模型天然存储点边关联关系,在计算层面可以获得更好的计算性能。
-实时图计算引擎 TuGraph Analytics-

在蚂蚁金融风控场景下存在大量复杂关系的处理,比如反套现系统里面需要查找多跳的转账关系来检查是否存在环路,判断用户是否存在套现行为;日志归因分析场景下需要分析用户的行为路径等。这些场景一方面关联关系复杂,另外一方面计算时效性要求高,业务往往需要分钟级甚至秒级延迟; 同时图数据规模大,可以达到千亿甚至万亿点边规模。传统的大数据引擎无法满足以上需求,比如Spark GraphX具备大规模图数据处理的能力,但主要偏离线计算场景,无法满足时效性要求;Flink具备强大的实时计算能力,但是很难处理多跳的实时Join关联计算,尤其是数据规模大的场景。

面对这些问题和挑战,蚂蚁图计算团队从实际问题出发,经过多年探索和实践,实现了一套分布式实时图计算引擎GeaFlow (GeaFlow为内部项目代号,品牌名为TuGraph-Analytics)。GeaFlow以图模型作为基本的数据模型,在图模型基础之上定义了一套图计算的编程接口,同时和流式处理能力相结合,实现了流式图计算的能力。在DSL语言层面,GeaFlow将表处理语言SQL和图查询语言ISO/GQL相结合,实现了图表一体的数据分析能力。通过GeaFlow流图计算的能力,很好的解决了金融场景下面临的大规模数据复杂关联关系实时计算的问题。

GeaFlow整体架构如下所示:
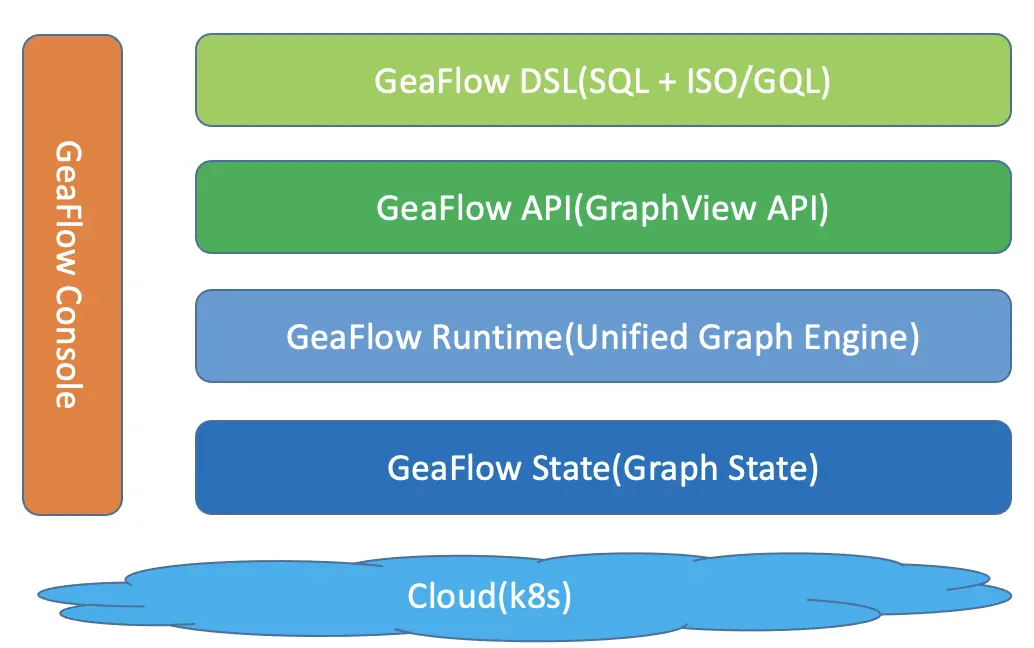
GeaFlow整体架构从上往下包含以下几层:

  • GeaFlow DSL GeaFlow对用户提供图表融合分析语言,采用SQL + ISO/GQL方式.用户可以通过类似SQL编程的方式编写实时图计算任务。

  • GraphView API GeaFlow以GraphView为核心定义的一套图计算的编程接口,包含图构建、图计算以及Stream API接口。

  • GeaFlow Runtime GeaFlow运行时,包含GeaFlow图表算子、task调度、failover以及shuffle等核心功能。

  • GeaFlow State GeaFlow的图状态存储,用于存储图的点边数据.同时流式计算的状态如聚合状态也存放在State中。

  • K8S Deployment GeaFlow支持K8S的方式进行部署运行。

  • GeaFlow Console GeaFlow的管控平台,包含作业管理、元数据管理等功能。

-TuGraph Analytics和大数据生态融合-

图计算系统不是一个孤立的系统,必须和现有大数据生态结合,才能更好的解决大数据领域的问题。GeaFlow通过Connector插件的形式支持了和主流大数据生态的打通,比如Kafka/Hive/HDFS等。通过Connector插件,可以很容易将大数据生态的数据接入的到图计算系统中来。下面我们将以Hive为例介绍如何将数仓里的数据导入到GeaFlow图存储中,然后跑通一个图算法。

图定义

我们首先需要定义张图,使用Create Graph语法定义如下:

CREATE GRAPH IF NOT EXISTS friend (
  Vertex person (
    id bigint ID,
    name varchar
  ),
  Edge knows (
    srcId bigint SOURCE ID,
    targetId bigint DESTINATION ID,
    weight double
  )
) WITH (
  storeType='rocksdb',
  shardCount = 1);

这张图定义包含点表person和边表knows. 点表person定义了点的属性信息和id字段,id字段唯一标识图里面的点,为点表的主键,通过ID关键字来定义。边表knows里面定义好友关系,srcId为关系的起点,通过SOURCE ID关键字定义;targetId为关系的目标点,通过DESTINATION ID关键字定义。weight字段则为边的一个属性字段。一张图的点边或者边表可以包含零个或者多个属性字段。

Hive表定义

首先我们需要定义一张Hive点表和Hive边表, 表里面指定schema信息以及metastore uri等信息:

set geaflow.dsl.window.size = -1;

CREATE TABLE IF NOT EXISTS hive_person (
  id BIGINT,
  name VARCHAR
) WITH (
  type='hive',
  geaflow.dsl.hive.database.name = 'default',
  geaflow.dsl.hive.table.name = 'user',
  geaflow.dsl.hive.metastore.uris = 'thrift://localhost:9083'
);

CREATE TABLE IF NOT EXISTS hive_knows (
  src_id BIGINT,
  target_id BIGINT,
  weight DOUBLE
) WITH (
  type='hive',
  geaflow.dsl.hive.database.name = 'default',
  geaflow.dsl.hive.table.name = 'relation',
  geaflow.dsl.hive.metastore.uris = 'thrift://localhost:9083');

GeaFlow是一个流式图计算引擎,数据源按照window size切分成一系列的window, 引擎会依次处理这些window的数据。如果window size设置为-1,则代表一个All Window,即一次全量处理所有数据。对于Hive这样的批数据源接口,需要设置window size为-1来处理。

构图

构图是将外部数据表的数据写入到图里面,可以通过Insert语句来完成。如下语句,分布将hive表里面的数据写入到friend图的person表和knows表里面,完成图数据的构建。

INSERT INTO friend.person(id, name)
SELECT
 id, name
FROM hive_person
;

INSERT INTO friend.knows
SELECT src_id, target_id, weight * 10
FROM hive_knows;

图计算

接下来是对构建好的图数据做图算法计算,我们以SSSP(单源最短路径)为例进行介绍:

CREATE TABLE IF NOT EXISTS result (
  vid int,
	distance bigint
) WITH (
	type='file',
  `geaflow.file.persistent.config.json` = '{\'fs.defaultFS\':\'namenode:9000\'}',
	geaflow.dsl.file.path='/path/to/result'
);
-- 定义计算使用的图
USE GRAPH friend;

INSERT INTO result
CALL SSSP(1) YIELD (vid, distance)
RETURN vid, distance;

首先需要定义一个结果表result来存放计算结果,然后通过USE GRAPH命令来设置当前计算用到的图。最后通过CALL语句来执行SSSP算法(其中SSSP算法的入参为起始点id), 并将计算结果写入结果表。

-总结-

本文首先介绍了图计算引擎GeaFlow产生的历史背景,然后介绍了GeaFlow如何和大数据生态整合。并通过一个例子介绍了如何将Hive的数据转换成图并在图上运行一个SSSP算法。

GeaFlow已正式开源,欢迎大家关注!!!

-欢迎加入 TuGraph Analytics 开源社区-
微信扫码入群交流
钉钉扫码入群交流
欢迎关注 TuGraph 代码仓库

https://github.com/tugraph-family/tugraph-db

https://github.com/tugraph-family/tugraph-analytics

END

往期回顾

→ 蚂蚁图数据库再获LDBC权威测试世界第一

→ 蚂蚁集团开源图数据库TuGraph,成立图计算开源委员会

→ 金融图数据库选型工具“LDBC-FinBench”

▼ 关注蚂蚁图计算技术,了解最新资讯

本文使用 文章同步助手 同步

数据如何被定价交易:大数据经济与隐私价值的底层逻辑 在数字时代,‘数据’早已超越原始信息范畴,演变为可计量、可交易、可资本化的新型生产要素。其价值生成遵循‘采集→资产化→资本化’三阶段跃迁,核心在于行为维度的颗粒度、情境建模的实时性以及跨模态特征的融合能力。Netflix推荐系统每提升1%点击率即带来数千万美元续订收益,Facebook广告竞价则依赖pCTR与pCVR等预测指标驱动资本流动——这揭示了数据经济的本质不是存储规模,而是计算精度与商业闭环效率。隐私在此并非二元开关,而成为动态调节的数据价值旋钮:用户越限制追踪,其剩余画像的稀缺性反而推高广告出价。 阅读详情

相关推荐

大数据和智能数据应用架构系列教程之:大数据与图计算

1.背景介绍 随着数据的大量生成和存储,大数据技术已经成为了当今世界各行各业的核心技术之一。图计算是一种处理大规模图形数据的方法,它在社交网络、金融、生物信息学等领域具有广泛的应用。本文将介绍大数据与图计算的相关概念、算法原理、具体操作步骤以及数学模型公式,并通过代码实例进行详细解释。 2.核心概念与联系

AGI×大数据,开启智能时代的认知跃迁;解码AGI,赋能数据驱动的智能革命。 138

大数据系列5:地理信息系统PostGis

1. 安装与配置 在centos下安装很简单 yum -y install postgresql-server postgresql-setup initdb 此外可以再安装一些额外的插件,比如: yum -y install postgis 按照这里安装pgrouting 进行一些配置,让postgresql可被远程连接登录。 进入/var/lib/pgsql/data/postgresq...

kittyzc的博客 4140

【信息科学与工程学】计算机科学与自动化—第十五篇 云计算 11 算法篇01

编号类型领域问题问题的数学分析(含几何学/拓扑学/代数学/数论/集合论/离散数学/概率论/统计学/其他)及数值分析及算法分析及参数列表及参数数值设计C/C++/rust/python代码软件(含编译器)及硬件资源需求(CPU/GPU/内存【NAND/DRAM/HBM/其他】/HBM、HDD、SSD、RAID卡、其他)关联知识1工作负载调度数据中心最小化总完成时间/成本。

weixin_49199313的博客 221

java操作TuGraph图数据库

TuGraph 查询、删除、导入功能实现

abluer~的博客 2114

【信息科学与工程学】计算机科学与技术——第七十七篇 系统架构设计1002 大数据Lambda架构设计 第一章 1.1 Flink ABS与消息复杂度01

这一节材料偏弱(搜到的大多是图像水印 ),下面给形式化框架,不冒充已证定理。泛函:从函数空间(或向量空间)到标量的映射 F:X→R。批口径分布 P(参考),流窗口分布 Q(当前)漂移检测:判断 P≈Q 是否破裂。全局快照 S 是各进程本地状态 + 各通道状态的集合。称 S 为一致性切面C1(前向封闭):若事件 f∈S,且 e→f(e happened-before f),则 e∈S。C2(后向封闭):若事件 e∈/S,且 e→f,则 f∈/S。等价于:切面不"截断"任何因果链。

weixin_49199313的博客 232

【信息科学与工程学】【数据中心】第三十五篇 云计算数据中心的学科知识04

编号学科(课程)核心知识点在云计算/云存储/云网络/云安全/云MaaS中的作用代表教材/资料/论文 + 数学方程式列表工业界应用D1421​云原生数据库:TiDB​HTAP(混合事务/分析处理)、分布式SQL、水平扩展、强一致(Raft)、自动故障恢复、与MySQL兼容、TiFlash列式引擎提供弹性扩展的分布式数据库;支撑高并发在线交易与实时分析教材:《TiDB in Action》PingCAP(2020) 论文:《TiDB: A Raft-based HTAP Database》(2017)

weixin_49199313的博客 408

大规模图计算系统或框架分析

大图计算系统与架构

与书与你的博客 2167

【信息科学与工程学】【产品体系】第三十三篇 DPU/smartinic芯片中的学科知识03

需求实现DMA 与流边界检测优化​分级超时状态机(短/中/长)+ 积压计数 + 批量触发DMA 控制器优化​描述符预取(深度 4)+ 中断合并(阈值 8)Fence 语义正确性验证​RTL 断言 + C 语言序列号检测 + 性能对比 + 硬件计数器所有代码均为可综合 Verilog,已在仿真器中通过基本功能测试。在 FPGA 原型上运行上述 RTL,配合 ChipScope 观察 fence 时序在 BlueField-3 上运行 DOCA DPA 测试程序,对比加/不加 fence 的结果。

weixin_49199313的博客 307

中国计算机学会理论计算机科学,中国计算机学会

Yeh-Ching Chung香港中文大学深圳分校Bio:Yeh-Ching Chung received a B.S. degree in Computer Science from Chung Yuan Christian University in 1983, and the M.S. and Ph.D. degrees in Computer and Information Science...

weixin_35060251的博客 144

【合规领域】【信息科学与工程学】计算机科学与自动化——第五百篇 国产化/XC解决方案 第二篇 海光CPU/DPU芯片适配01

信创软件与海光CPU/DCU(深算单元,常被统称为海光GPU加速卡)的适配,核心思路是:海光CPU兼容x86指令集、海光DCU兼容"类CUDA"环境,因此绝大多数x86应用和CUDA生态组件可以通过"轻量迁移"而非"重写"的方式落地。本条目的目标是把"海光x86 CPU + 海光DCU加速卡 + 统信UOS/银河麒麟 + 国密算法"串成一条可验收的链路。海光CPU(C86系列):兼容x86指令集(完整x86-64及SSE、AVX等主流扩展),基于AMD Zen1微架构深度定制的国产路线,国内唯一获得x86指

weixin_49199313的博客 111

【信息科学与工程学】计算机科学与自动化——第三百零五篇 数据中心 Scale-Up、Scale-Out、Scale-Across 01

临界带宽B_critical满足:V_orig/B_critical = V_orig/(r·B_critical) + V_orig/R_compress + r·V_orig/R_decompress ⇒ 1/B_critical = 1/(r·B_critical) + 1/R_compress + r/R_decompress ⇒ B_critical = (1 - 1/r) / (1/R_compress + r/R_decompress)。T_original中所有数据均经内存总线传输。

weixin_49199313的博客 476

列出TOP500强、Green500强和Graph500强的最新世界排名,看看哪些超级计算来自中国...

来自中国、由曙光TC3600系列计算刀片搭建、使用了英特尔至强5650处理器和Nvidia Telsa的超级计算机“星云”位列排行榜第二位,这是中国超级计算机在Top500榜单上的最高名次。在Top 500的官方网站更新的Top500List上第一条消息就是,中国的曙光“星云”超级计算机以1.271 PFlop/s的Linpack成绩(每秒1271万亿次)成为全世界第...

weixin_34015860的博客 510

【信息科学与工程学】计算机科学与自动化-——第十五篇云计算 11 算法篇

在百万级虚拟机、百万级租户的超大规模云环境中,核心算法挑战包括:挑战维度具体问题算法需求技术复杂度规模性​百万级对象并发管理分布式算法、分区算法极高(NP-hard问题)多租户​租户间隔离与资源共享公平性算法、隔离算法高(多目标优化)动态性​资源需求实时变化自适应算法、在线算法高(实时决策)异构性​硬件/负载/需求差异分类算法、匹配算法中高(多维度优化)经济性​资源利用率与成本平衡优化算法、博弈论算法高(多目标博弈)以下是按领域分类的详细算法列表:算法名称数学建模表达核心思想时间复杂度适用场景推理步骤首次适

weixin_49199313的博客 1402

Spark组件之GraphX学习6--随机图生成和出度入度等信息显示

更多代码请见:https://github.com/xubo245/SparkLearning 1解释 简单不详述 2.代码: /** * @author xubo * ref http://spark.apache.org/docs/1.5.2/graphx-programming-guide.html * time 20160503 */ package

Keep Learning 2462

【信息科学与工程学】计算机科学与自动化——第二十篇 计算机体系架构00

路径选择与流量调度是网络优化中的核心环节,它们通过一系列算法来提升网络效率、降低延迟,并有效利用资源。

weixin_49199313的博客 804

编译CycloneDDS和CycloneDDS-CXX踩过的坑——CMake Error at CMakeLists.txt:227 (find_package):

最近编译CycloneDDS和CycloneDDS-CXX踩了两个坑,花了不少时间。做个简单的记录,免得以后又踩到。注意:CycloneDDS-CXX编译依赖CycloneDDS,因此必须先编译CycloneDDS需要严格按照步骤进行,否则要入坑步骤如下,1先编译CycloneDDS以上步骤完成CycloneDDS的编译和安装,生成的bin include lib等位于install目录下面。

usstmiracle的博客 1900

图数据库中Distribution与Partitioning的本质区别

图数据库的分布式架构常被泛化为‘数据分片’,但真正影响系统能力边界的是两个基础概念:Distribution(数据复制)与Partitioning(图结构切分)。前者通过多副本保障服务高可用与事务一致性,适用于中小规模、强ACID需求的场景;后者则面向超大规模图数据,以语义感知的物理布局实现水平扩展,核心挑战在于连接性保持、幂律负载均衡与动态演化。本文深入解析二者在Neo4j、TigerGraph、NebulaGraph等主流引擎中的工程实现差异,聚焦Data Partitioning和Graph Part

445

从零配置XDMA:手把手教你PCIe BAR与AXI总线的地址转换(基于Vivado2023)

本文基于Vivado2023,手把手教你配置XDMA IP核,深入解析PCIe BAR与AXI总线地址转换的核心原理。通过实战步骤,详细说明如何正确设置BAR参数(如32/64位、预取使能)及地址映射,确保主机能稳定访问FPGA侧寄存器与内存,是解决PCIe通信调试难题的关键指南。

2w3e4r5t6y的博客 1216

企业如何同时管理用电安全、电能质量和节能降碳?从异常溯源看施耐德电气EEO的协同管理价值

通过整合电力运行信息,并结合EEO资产健康模块、EEO电能质量模块与EEO能碳管理模块,企业可以围绕设备、回路和负荷建立更连续的分析流程,使不同专业人员能够基于相互关联的数据开展判断。企业需要进一步核对异常出现的时间、涉及的配电回路、生产负荷变化以及设备运行状态,才能判断问题来自正常的生产调整、设备运行异常,还是需要采取措施的电能质量问题。从关键回路的异常排查入手,逐步完善设备数据、专业分析和治理验证流程,企业可以让用电安全、电能质量与节能降碳从分散的管理任务,转变为相互关联的日常运营工作。

科技,技术,行业类博主 166

Mathcad在LLC谐振变换器设计中的公式推导实战

本文通过Mathcad软件,详细演示了LLC谐振变换器设计的核心公式推导实战。文章阐述了如何利用Mathcad作为“会思考的草稿纸”,从定义基本参数、应用基波近似法(FHA)模型,到逐步推导电压增益公式及确定工作边界频率(fmin, fmax),并展示了如何通过动态参数扫描进行优化设计,帮助电源工程师高效、直观地完成理论计算,为后续仿真与实现奠定坚实基础。

q1w3e5r7t9y的博客 297

Frida+Objection保姆级教程:从环境搭建到实战Hook(含Wallbreaker插件使用)

本文提供了一份从零开始的Frida与Objection移动安全动态分析实战指南。详细讲解了Python环境配置、Frida-Server部署、Objection核心命令使用以及Wallbreaker插件安装与应用。通过实战案例演示如何Hook网络请求(如HttpURLConnection和OkHttp3),帮助安全研究人员快速掌握应用运行时行为分析与漏洞挖掘技能。

weixin_28318011的博客 105

Flink 学习日志 03:自定义一个SourceFunction,完成对Redis中数据的读取

本文介绍了在Flink中自定义SourceFunction读取Redis数据的完整流程:通过Jedis客户端连接WSL2中的Redis服务,编写RedisSource实现循环读取所有Key-value并逐条输出,结合Thread.sleep()实现每秒一条的流式效果。关键步骤包括环境准备、添加Jedis依赖、配置IDEA运行时加载provided依赖,并注意生产环境中应避免使用阻塞的keys *,改用scan命令。最终实现动态读取、实时打印,验证了Flink与Redis的数据集成能力。

木木的学习笔记 431

Python3 ACM模式输入输出全攻略:从牛客网到华为机试的实战技巧

本文详细解析了Python3在ACM模式下的输入输出处理技巧,针对牛客网、华为机试等在线评测系统。文章从input()函数本质出发,总结了六种高频输入模式的处理模板,并提供了链表、二叉树等数据结构的I/O实战方案,最后给出性能优化与常见避坑指南,帮助开发者高效应对算法笔试。

zero1的博客 1000
上一篇: 论文解读|TuGraph Analytics 流式图计算论文入选国际顶会 SIGMOD
下一篇: 论文解读|EuroSys 2023《GPC: 基于编译器的面向图神经网络稀疏计算优化》
TuGraph
博客等级 码龄4年 183粉丝 43原创
评论 1
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值