


从 Word 数据标准中自动提取字段表:一套可配置的 Markdown 整理方案
在数据治理和信息化项目建设中,我们经常面对这样的场景:几十个业务模块、上百张字段定义表,全部写在 Word 标准文档里。人工复制粘贴不仅枯燥,还极易出错——漏表、错挂、版本混用,几乎每次都会出现。
本文介绍一套轻量级的提取工具,它不做整篇 Word 转换,只做一件事:把结构明确的字段表,按业务模块自动提取并整理成 Markdown。工具本身是可配置的,章节名称、字段列、路径规则都集中在 JSON 配置文件中,不同项目不必重写整套解析逻辑。
🔗 项目地址:https://github.com/NCX-ThsPool/data-pipe/tree/main/word-standard-table-extractor
第一部分:为什么需要这一层整理
1. 数据库、Excel 和 Word 各管一层
在数据标准维护工作中,我们通常同时使用多种载体,它们的职责各不相同:
| 层次 | 常见载体 | 主要作用 |
|---|---|---|
| 数据承载层 | PostgreSQL、对象存储 | 保存结构化数据、文件及其关联关系 |
| 目录维护层 | Excel | 维护数据库目录、schema、处理状态和对应关系 |
| 标准解释层 | Word | 说明业务背景、字段规范、汇交要求 |
| 中间整理层 | Markdown | 保留标题和表格关系,供人工复核和后续处理 |
PostgreSQL 负责结构化存储,图片、文件等非结构化数据放在对象存储中,数据库只保存路径和标识。Excel 更像是数据库的“目录地图”,用来盘点层级、表名、状态和缺项。而 Word 面向项目人员和审核人员,把业务背景、汇交要求和字段规范讲清楚。
问题往往出现在三者衔接的位置。某个补充标准可能只新增两三张表,但这些表仍要匹配到既有 Excel 目录和数据库结构。数据量虽小,业务层级却没有减少,人工复制反而容易因为“看起来不复杂”而跳过核查。
2. 为什么先整理成 Markdown
这里没有直接从 Word 写入 Excel 或数据库,而是先生成 Markdown,主要基于四点考虑:
- 保留长业务标题:Markdown 不受 Excel 工作表名称长度和非法字符的限制;
- 标题与表格关系清晰:同一业务模块下可以连续保存多张字段表,层级关系一目了然;
- 适合版本管理:文本格式便于全文检索、版本对比和 Git 管理,字段增删比二进制文件更容易检查;
- 保留人工复核层:在进入 Excel 或数据库之前,保留一次人工复核机会,避免错误直接污染正式结构。
Markdown 在这套流程里不是最终成果,而是 Word 与结构化处理之间的暂存层。确认无误后,可以继续生成数据字典 Excel、SQL 建表草案,或与 PostgreSQL 系统表进行核对。
3. 需要恢复的三层关系
以一段虚构标准为例:
1.1 示例城市道路基础数据
1.1.1 执行标准
1.1.2 成果构成
1.1.3 数据汇交要求
1.1.4 数据内容与编码
1.1.5 字段结构定义
1.1.5.1 道路中心线字段结构
1.1.5.2 道路节点字段结构
1.1.6 其他情况说明
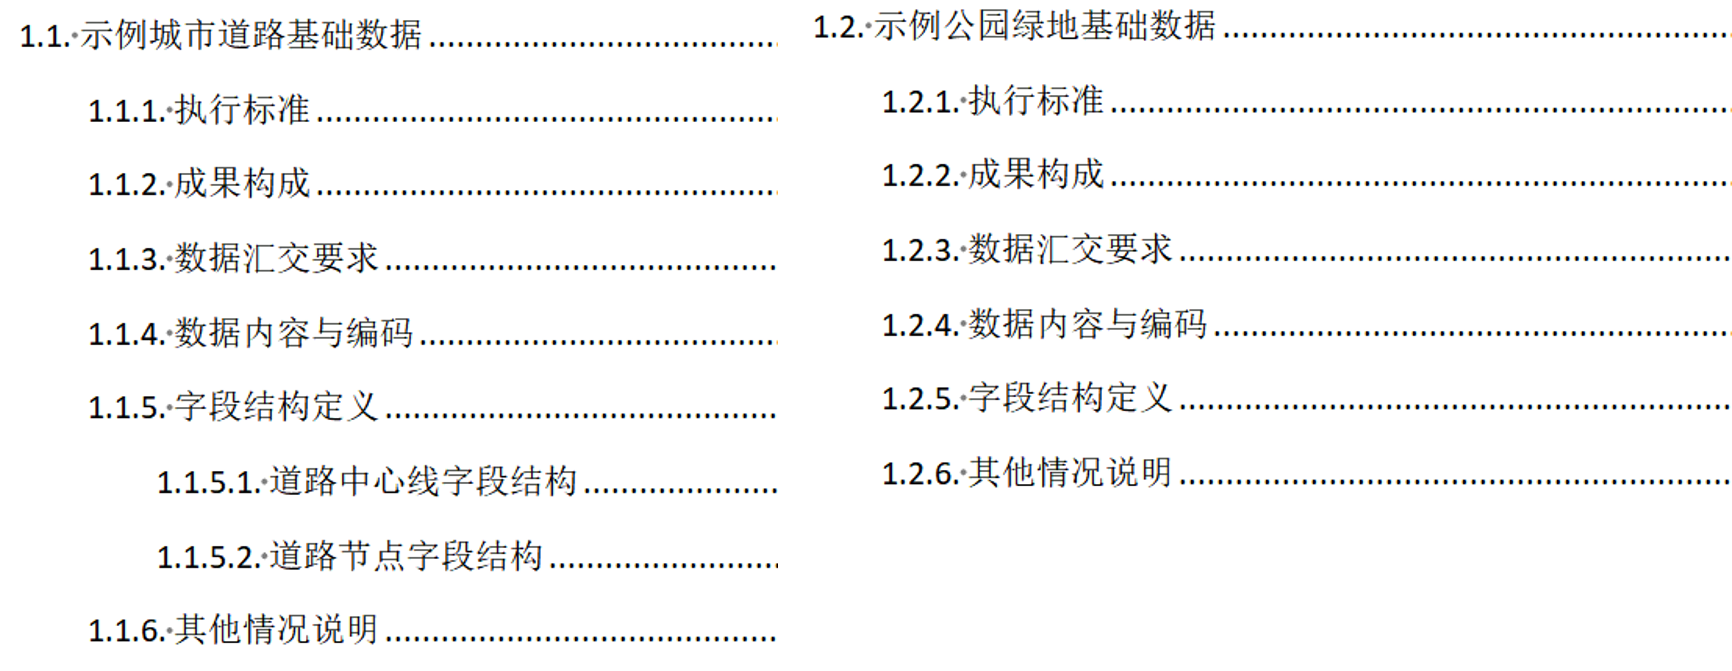
每张目标表需要恢复以下三层关系:
| 层次 | 示例 | 输出用途 |
|---|---|---|
| 业务总标题 | 示例城市道路基础数据 | Markdown 文件名和一级标题 |
| 目标章节 | 字段结构定义 | 限定允许提取表格的范围 |
| 子表标题 | 道路中心线字段结构 | Markdown 二级标题 |
总标题不是简单取“表格前最近的标题”。程序先从目标章节向前查找同级的“执行标准”或“标准依据”,再取该锚点的直接上级标题。这样取得的是业务模块,而不是某张子表的名称。
子表标题只使用目标章节的直接下一级大纲标题。如果章节内有表格却没有下一级标题,则输出为“表1”“表2”,不会把“字段结构见下表”一类说明句当成正式表名。
4. 目标表格不能只按列数判断
Word 中可能同时存在成果构成表、要素编码表、字段表和说明附表。只看“有几列”并不能确认表格用途,可靠的判断至少需要两个条件:
- 表格位于配置指定的目标章节内;
- 表头能匹配当前模块规则中的必需列。
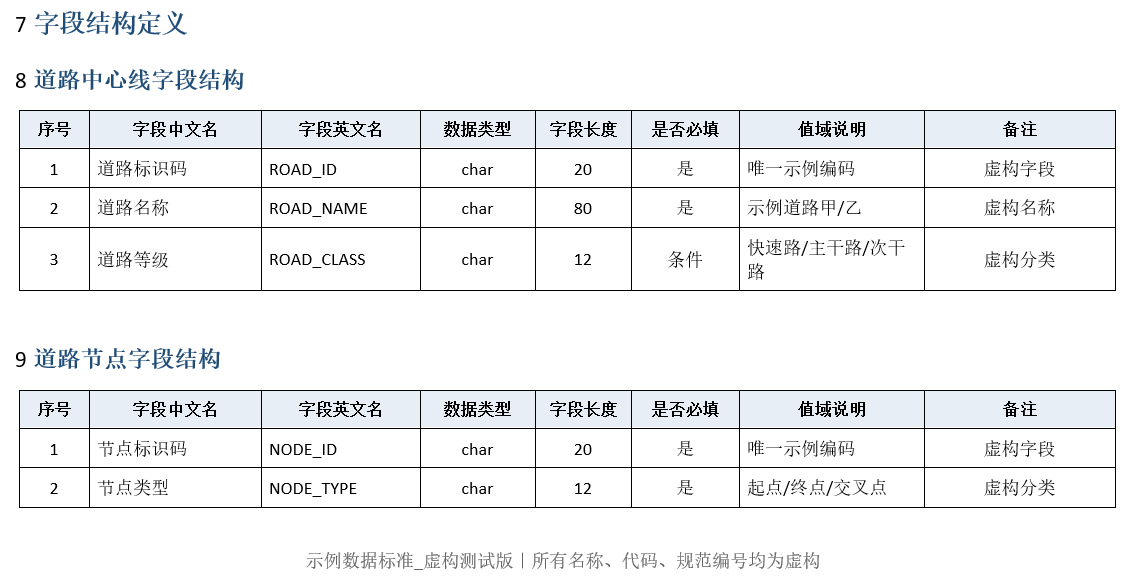
新版示例使用 8 列输出结构:
| 序号 | 字段中文名 | 字段英文名 | 数据类型 | 字段长度 | 是否必填 | 值域说明 | 备注 |
|---|---|---|---|---|---|---|---|
| 1 | 道路标识码 | ROAD_ID | char | 20 | 是 | 唯一示例编码 | 虚构字段 |
其中前 6 列为必需列,“值域说明”和“备注”为可选列。因此 6、7、8 列表都能识别,缺少的可选列会在 Markdown 中补为空值。
旧版“数据属性项定义”十列表也未被删除。脚本保留了独立的兼容规则,可继续识别“字段名称、字段代码、类型、长度、小数、值域、约束、备注、共享开放”等列。新旧规则各自使用自己的章节名和输出列,不会把十列表强行裁成八列。
5. 小体量补充数据最容易出现哪些问题
在长期实践中,我们发现小体量补充数据的处理最容易踩坑:
| 常见做法 | 隐患 |
|---|---|
| 在 Word 中逐表复制 | 漏表、重复复制、跨模块复制错误 |
| 取表格前最近一段作为表名 | 把普通说明误认成子表名称 |
| 只按列数识别字段表 | 章节外同结构附表混入结果 |
| 每张表直接创建 Excel 工作表 | 长名称被截断,非法字符或同名导致失败 |
| 解析完成后直接写数据库 | 缺少人工复核层,错误进入正式结构 |
| 使用真实标准片段写博客 | 泄露项目名、地名、字段代码或内部目录 |
工具的价值不在于少复制几次,而在于把“表格属于哪里”转换成可检查的规则。
6. 公开测试文档怎样处理保密问题
配套的《示例数据标准_虚构测试版.docx》使用完全虚构的模块名、字段代码和标准编号。测试时保留 Word 的层级结构和异常情况,但不保留任何真实项目内容。

- ✅ 可保留:标题层级、表格列结构、自动编号、合并说明行、空章节、多表挂接
- ❌ 需替换:项目名称、建设单位、处室、真实地名、业务表名、字段代码、共享策略、内部路径、未公开标准编号
测试文档采用 A4 竖版,共设置 6 组案例:
| 案例 | 测试内容 | 预期结果 |
|---|---|---|
| 1 | 一个目标章节下有两个直接子标题和两张表 | 两张表挂到同一业务文件,各自保留子表名 |
| 2 | 表前没有子标题,章节外另放一张同结构干扰表 | 目标表命名为“表1”,干扰表被忽略 |
| 3 | 存在目标章节但没有字段表 | 不为该业务生成 Markdown |
| 4 | 使用“属性字段说明”章节别名,一个子标题下有两张表 | 两张表使用同一大纲子标题,普通段落不参与命名 |
本轮回归结果如下:
Word 正文表格总数:20
识别到目标章节:6
章节内标准字段表:7
章节外标准字段表(已忽略):1
无标准字段表的目标章节:1
未匹配总标题的表格:0
未匹配下一级子标题的表格:1
提取字段记录总数:19
生成 Markdown 文件数:5
第二部分:代码思路与使用方法
1. 文件组成
| 文件 | 用途 |
|---|---|
src/docx_table_extractor/ | 按功能拆分的正式提取包 |
config/extraction_rules.json | 章节、列名、别名和默认相对路径 |
data/samples/示例数据标准_虚构测试版.docx | A4 竖版虚构测试文档 |
docs/ | 架构、配置和技术说明 |
运行环境只需要 Python 3.10+ 和 python-docx:
python -m pip install -e .
2. 程序为什么要混合读取段落和表格
Document.paragraphs 与 Document.tables 会分别返回段落和表格。分开读取之后,表格原本位于哪个标题后面就无法判断。因此程序直接遍历 Word 正文 XML,把段落和表格放入同一个有序列表:
def iter_document_blocks(document):
    for child in document.element.body.iterchildren():
        if isinstance(child, CT_P):
            yield Paragraph(child, document)
        elif isinstance(child, CT_Tbl):
            yield Table(child, document)
后续标题、章节边界和表格都使用同一个 block_index。这一步解决的是位置关系,不是文本格式转换。
3. Word 自动编号为什么要单独解析
Word 界面中看到的 1.1.5.1 往往不在 paragraph.text 里。真正的编号层级保存在段落属性中:
<w:numPr>
  <w:ilvl w:val="3"/>
  <w:numId w:val="90"/>
</w:numPr>
numId 表示使用哪一套编号,ilvl 表示该编号中的层级。脚本同时检查:
Heading 1、标题 1等标题样式;- 段落或样式中的
outlineLvl; - 自动多级编号的
numId + ilvl; - 样式继承链中的编号和大纲属性。
即使标题样式仍是 Normal,只要 Word 写入了真实多级编号,层级仍可恢复。
4. 章节边界怎样限制提取范围
找到“字段结构定义”以后,程序向后查找同一编号体系中的下一个同级或更高级标题,并把它作为章节终点。表格只有落在起止范围内,才会继续匹配表头。
def find_section_end(headings, section_heading, block_count):
    for heading in headings:
        if heading.block_index <= section_heading.block_index:
            continue
        if not is_same_hierarchy(heading, section_heading):
            continue
        if heading.level <= section_heading.level:
            return heading.block_index
    return block_count
因此,“其他情况说明”中的同结构表不会混入字段结果。程序仍会统计这类章节外表格,用于提醒维护人员检查文档结构。
5. 章节名、列名和列数集中在 JSON 配置
每类目标模块由 JSON 中的一条规则描述,启动时再转换为 ModuleRule:
{
  "name": "字段结构",
  "section_titles": ["字段结构定义", "属性字段说明"],
  "execution_titles": ["执行标准", "标准依据"],
  "output_headers": [
    "序号", "字段中文名", "字段英文名", "数据类型",
    "字段长度", "是否必填", "值域说明", "备注"
  ],
  "required_headers": [
    "序号", "字段中文名", "字段英文名",
    "数据类型", "字段长度", "是否必填"
  ],
  "header_aliases": {
    "字段名称": "字段中文名",
    "字段代码": "字段英文名",
    "类型": "数据类型",
    "长度": "字段长度",
    "约束": "是否必填",
    "值域": "值域说明"
  }
}
各字段的作用如下:
| 配置项 | 作用 |
|---|---|
name | 统计信息和 Markdown 来源说明中的规则名称 |
section_titles | 可识别的目标章节名称,可同时配置新名称和别名 |
execution_titles | 用于定位业务总标题的同级锚点名称 |
output_headers | Markdown 输出列及顺序 |
required_headers | 识别表格时必须存在的列 |
header_aliases | 把历史列名、简称或不同单位写法映射为标准列名 |
serial_header | 序号列名称;单元格自动编号无法读取时用于顺序补齐 |
[!TIP]
required_headers不宜等同于全部输出列。把“备注、值域、共享说明”等可能缺失的列设为可选列,更适合兼容历史标准;字段名称、字段代码和数据类型等关键列仍应保持必需。
6. 怎样增加另一类模块
如果还要从“成果文件清单”章节提取 6 列文件表,可以新增一条规则:
{
  "name": "成果文件清单",
  "section_titles": ["成果文件清单", "汇交文件列表"],
  "execution_titles": ["执行标准", "编制依据"],
  "output_headers": [
    "序号", "成果名称", "文件格式",
    "存储位置", "是否必交", "备注"
  ],
  "required_headers": [
    "序号", "成果名称", "文件格式", "是否必交"
  ],
  "header_aliases": {
    "序号": "序号",
    "文件名称": "成果名称",
    "格式": "文件格式",
    "目录": "存储位置",
    "必交": "是否必交",
    "备注": "备注"
  }
}
新增规则后,正文顺序读取、自动编号解析、章节边界、总标题定位、子标题挂接、文件名清理和 Markdown 写出逻辑都可以继续复用。
7. 主 Word、补充 Word 和输出路径怎样配置
路径统一写在 config/extraction_rules.json,并且只能使用仓库相对路径:
{
  "paths": {
    "input_file": "data/input/main_standard.docx",
    "supplement_files": [
      "data/supplement/supplement_01.docx",
      "data/supplement/supplement_02.docx"
    ],
    "output_dir": "data/output/current"
  }
}
需要长期重复执行时修改 JSON;临时处理时使用命令行参数。无论从哪个目录启动,路径都按仓库根目录解析。
只处理一份 Word:
python scripts\extract.py `
  "data/input/main_standard.docx" `
  -o "data/output/current"
同时处理主 Word 和两份补充 Word:
python scripts\extract.py `
  "data/input/main_standard.docx" `
  --supplement "data/supplement/supplement_01.docx" `
  --supplement "data/supplement/supplement_02.docx" `
  -o "data/output/current"
--supplement 可以重复填写。多文档模式会生成独立子目录:
data/output/current/
├── 01_主文档_main_standard/
├── 02_补充文档_supplement_01/
└── 03_补充文档_supplement_02/
这样处理的原因是不同 Word 可能出现相同业务标题。如果全部直接写到同一目录,后处理的文件可能覆盖前一份结果。需要跨文档合并时,应先保留来源目录,再按业务主键做显式合并。
8. 子表名称怎样自定义
默认规则只认目标章节的直接下一级大纲标题:
字段结构定义
└── 道路中心线字段结构
    └── 字段表
若实际标准把表名写成普通段落,例如“(1)道路中心线属性表”,可以增加受限回退规则,但不建议无条件取表格前最近段落。至少应限制:
- 段落位于目标章节内;
- 位于表格前且中间没有其他表格;
- 文本长度不超过设定值;
- 符合“表 x”“(x)”“属性表”“字段结构”等固定模式。
TABLE_LABEL_PATTERN = re.compile(
    r"^(?:表\s*\d+|(\d+)|\(\d+\))"
    r".{1,60}(?:属性表|字段结构|字段说明)$"
)
普通正文的写法比大纲标题更自由,回退规则越宽,误把说明句当表名的概率越高。新标准如果能够调整,最好直接要求子表名称使用真实大纲标题或统一题注样式。
9. 表格数据怎样清理
程序在写出 Markdown 前还处理了几类 Word 特有情况:
- 表头位于前 3 行时仍可识别;
- 历史列名通过
header_aliases映射到标准列; - 分页重复表头不会被当成字段记录;
- Word 自动编号导致序号单元格文本为空时,按有效数据行补齐;
- 横向合并的“注:……”说明行不会作为字段导出;
- 单元格内换行转换为
<br>; - Markdown 表格中的竖线和反斜杠会转义;
- Windows 文件名中的非法字符、保留名称、超长名称和同名冲突会统一处理。
10. 修改配置后的检查方法
每次调整章节名或字段列,不要只看程序是否报错。至少应记录以下统计:
- 目标章节数量是否与 Word 目录一致;
- 章节内字段表数量是否符合预期;
- 章节外同结构表是否被忽略;
- 空章节数量是否合理;
- 未匹配总标题和子标题的数量是否突然增加;
- 字段记录总数是否与上一版本出现异常差异;
- 生成的 Markdown 文件数是否与业务模块数量大致对应。
建议先运行虚构测试文档,再处理内部正式材料。若修改了 ModuleRule,应同步增加对应的虚构案例,而不是使用真实项目片段验证。这样既能形成稳定回归测试,也能避免测试文件、代码仓库和博客内容带出业务信息。
结语
这套方法没有代替 Word、Excel 或数据库。它只在三者之间增加了一层可复核的结构:Word 继续负责解释标准,Markdown 负责恢复和检查关系,Excel 与数据库再承担目录维护和正式存储。
对于多模块标准和零散补充数据,这一层通常能挡住最费时间的错挂、漏表和版本混用问题。如果你也经常被 Word 文档中的字段表折腾得焦头烂额,不妨试试这套方案。
🔗 项目地址:https://github.com/NCX-ThsPool/data-pipe/tree/main/word-standard-table-extractor



 421


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


