PDF文档解析新突破:图表识别、公式还原、手写字体处理,让AI真正读懂复杂文档!

PDF文件解析 PDF是英文Portable Document Format缩写,就是可移植的意思,它是以PostScript语言图象模型为基础,无论在哪种打印机上都可保证精确的颜色和准确的打印效果,PostScript咱也不懂,估计和SVG的原理差不多吧。 阅读详情

要想LLM大模型性能更佳,我们需要喂给模型看得懂的高质量数据。那有没有一种方法,能让我们把各种文档“读懂”,再喂给大模型使用呢?

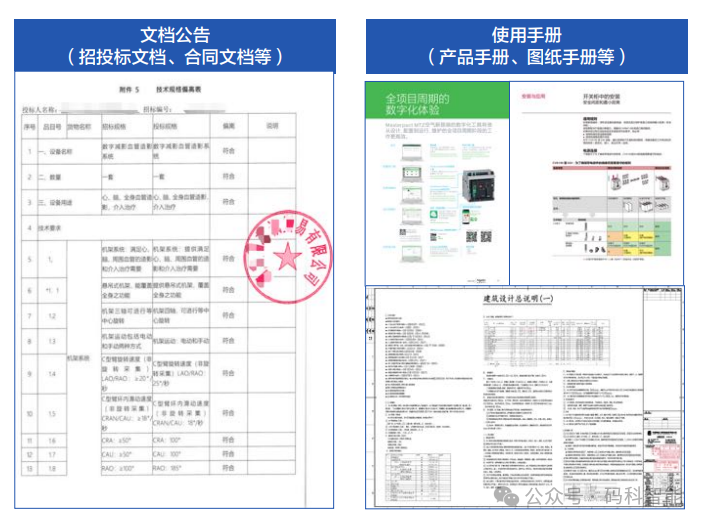
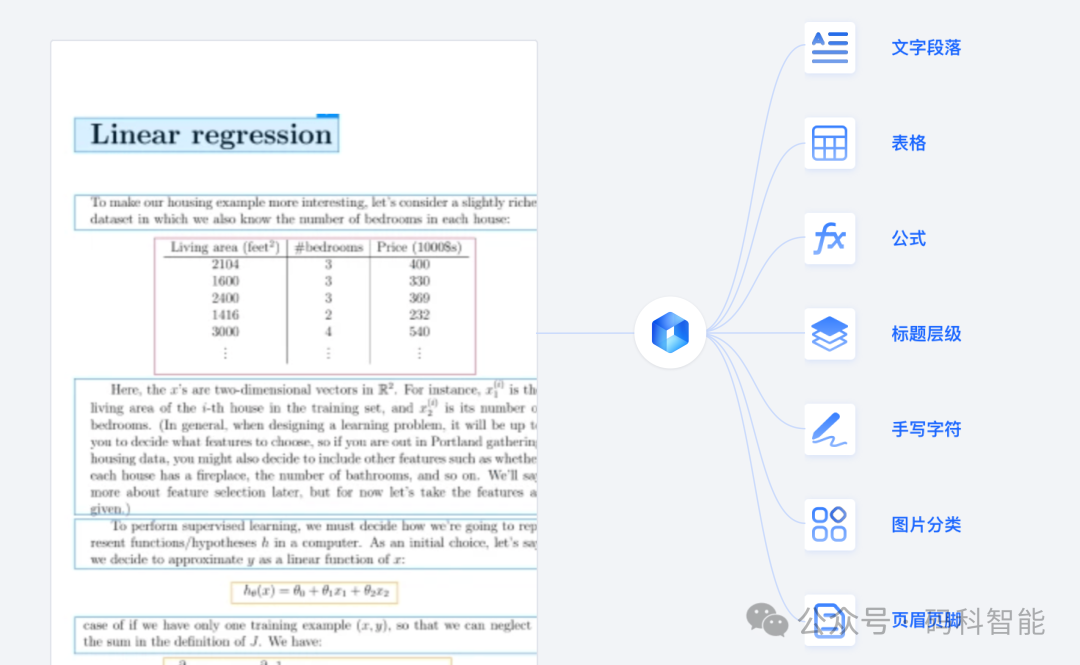
如果你用传统OCR工具直接从PDF中提取文本,结果往往是乱序、缺失、格式错乱。因为实际文档中常包含公式、表格、手写批注、文字段落等各种难以提取的元素。
图片

图1. 覆盖全面,支持公式、手写体、图表内容的解析

我们调研并实测了一批当前主流的开源模型,包括更适用于论文解析的Nougat,专精于表格数据提取的MinerU,针对手写体优化的GOT-OCR,适用于技术文档的Marker,擅长处理复杂多语言混排文档的Surya,专门处理政府招标文档表格的Camelot,以及擅长金融类表格分析的TATR。
图片

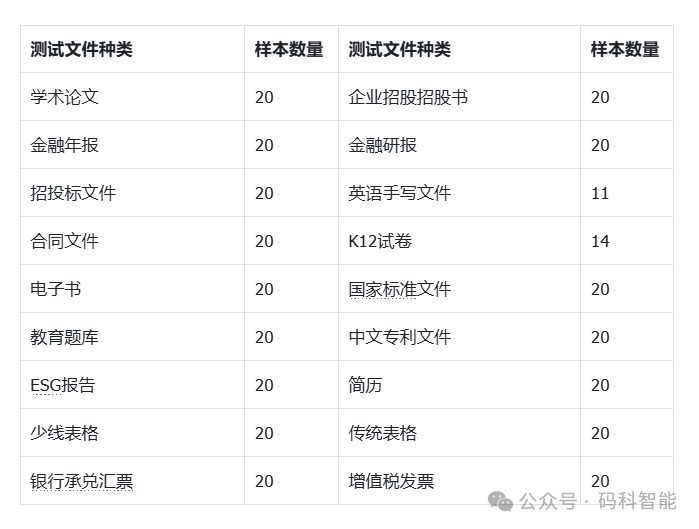
图2. 测试文件种类二十余种

上述模型各有优势,对于标准化文档已经够用了。但面对真实业务场景下的复杂文档,比如学术论文、财报、合同、工程图纸、试卷等,尤其涉及到文档中的复杂表格内容,模型往往就错误百出了。
Reducto Document Ingestion API

一、什么样的文档解析工具才真正好用?

结合实际业务中的需求:能够识别文档中的所有信息,将文档解析为Markdown格式,并按常见的阅读顺序进行还原,从而赋能下游各类大语言模型任务。我们总结出理想中的文档解析引擎应具备以下几个核心能力:

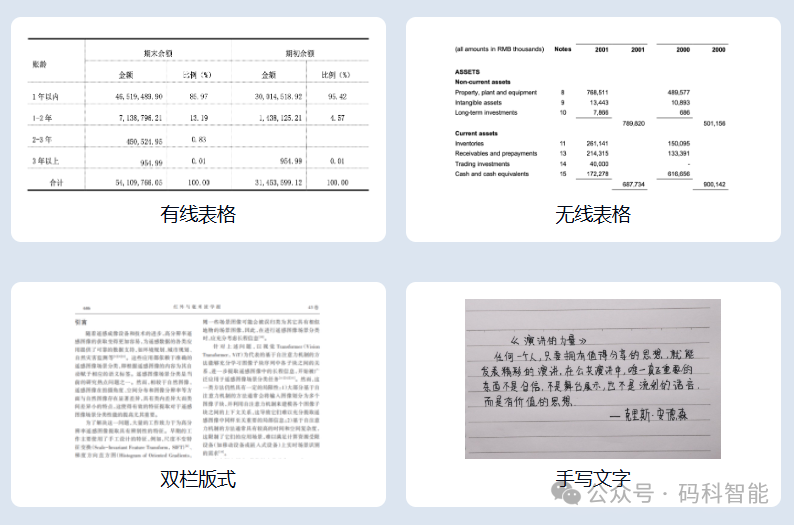
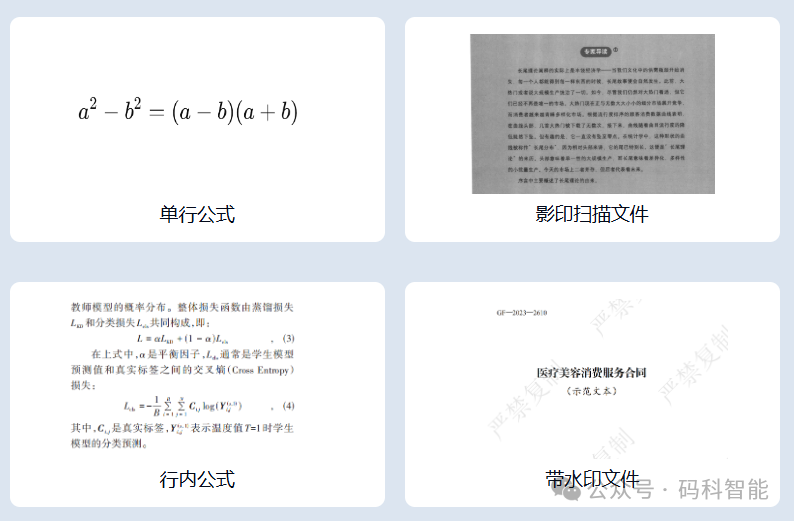
✅ 识别能力覆盖全面:具有各类常见文档的识别解析能力,对有线无线表格、章节、标题、列表、公式、手写体、扫描件全部精准识别并结构化输出;
图片

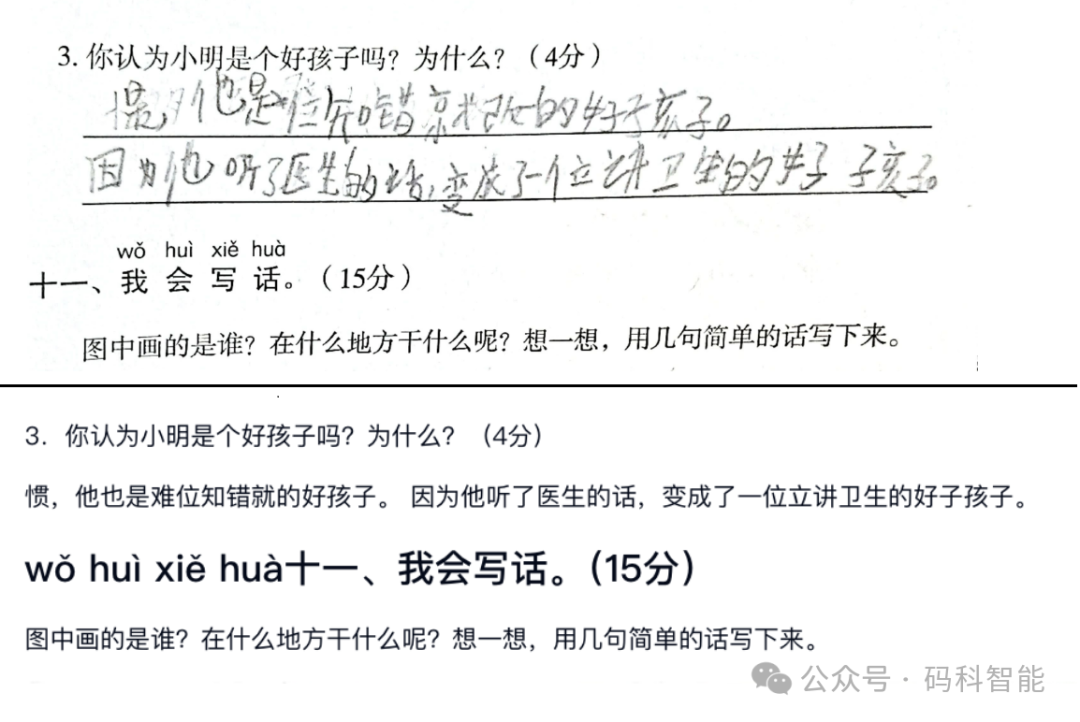
图3. 试卷的手写体识别,上半图是凌乱的手写字

✅ 表格识别强大:支持跨行合并、嵌套表格、带注释的复杂表格,100页文档1.5秒搞定;
图片

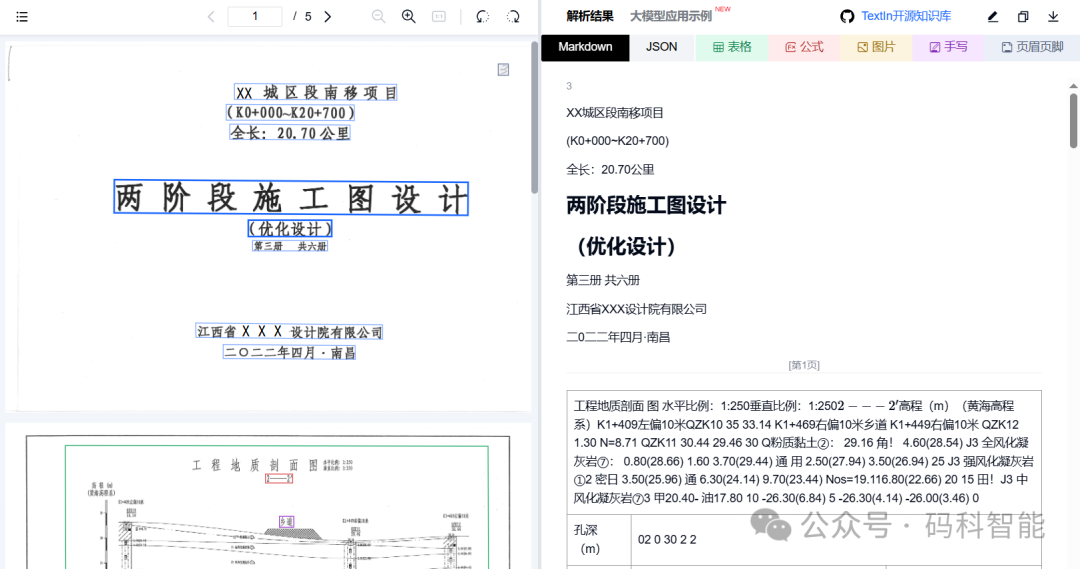
✅ 输入输出灵活:输入:在线可用、API调用实时响应、本地部署也支持,一次性可处理万页以上的数据;输出:Markdown / JSON 格式输出,便于下游模型使用;
图片

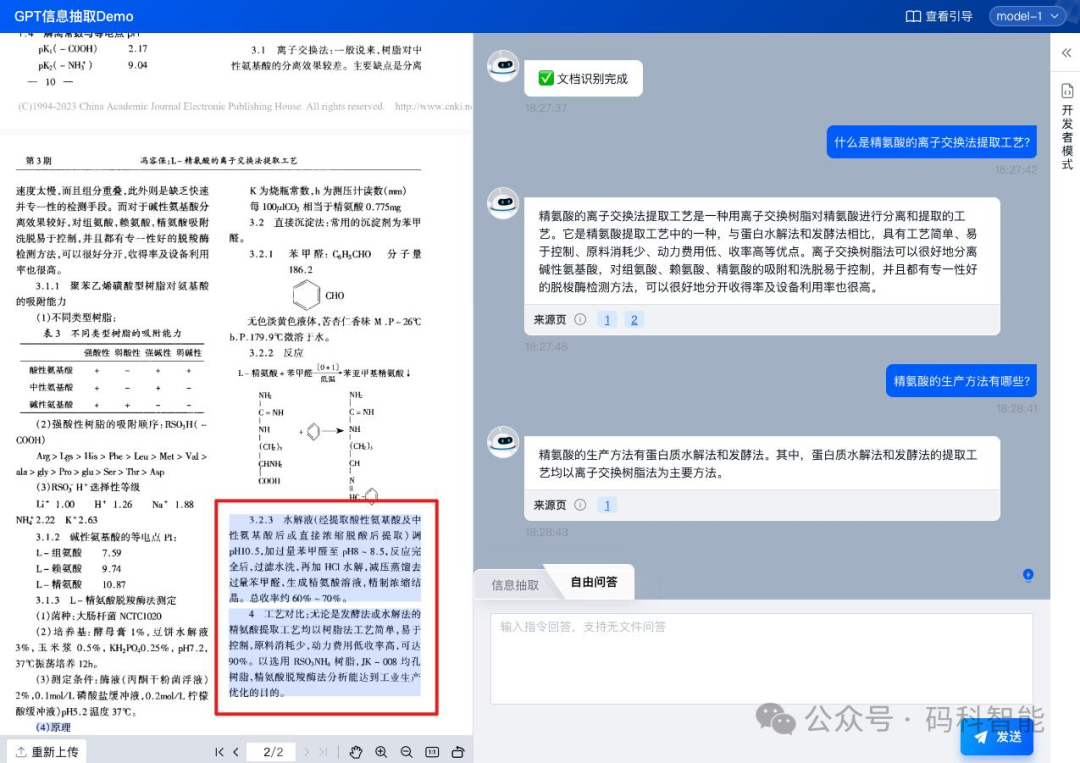
✅ 可溯源:抽取出来的内容可以溯源到原文位置,对长文档校验非常关键。同时能直接与文档问答,针对特定内容交互理解。
图片

✅ 一次搞定多种格式:支持 PDF / Word / DOCX / HTML / JPG / PNG 等格式;
图片

二、实战测评:基于真实样本的全方位评估

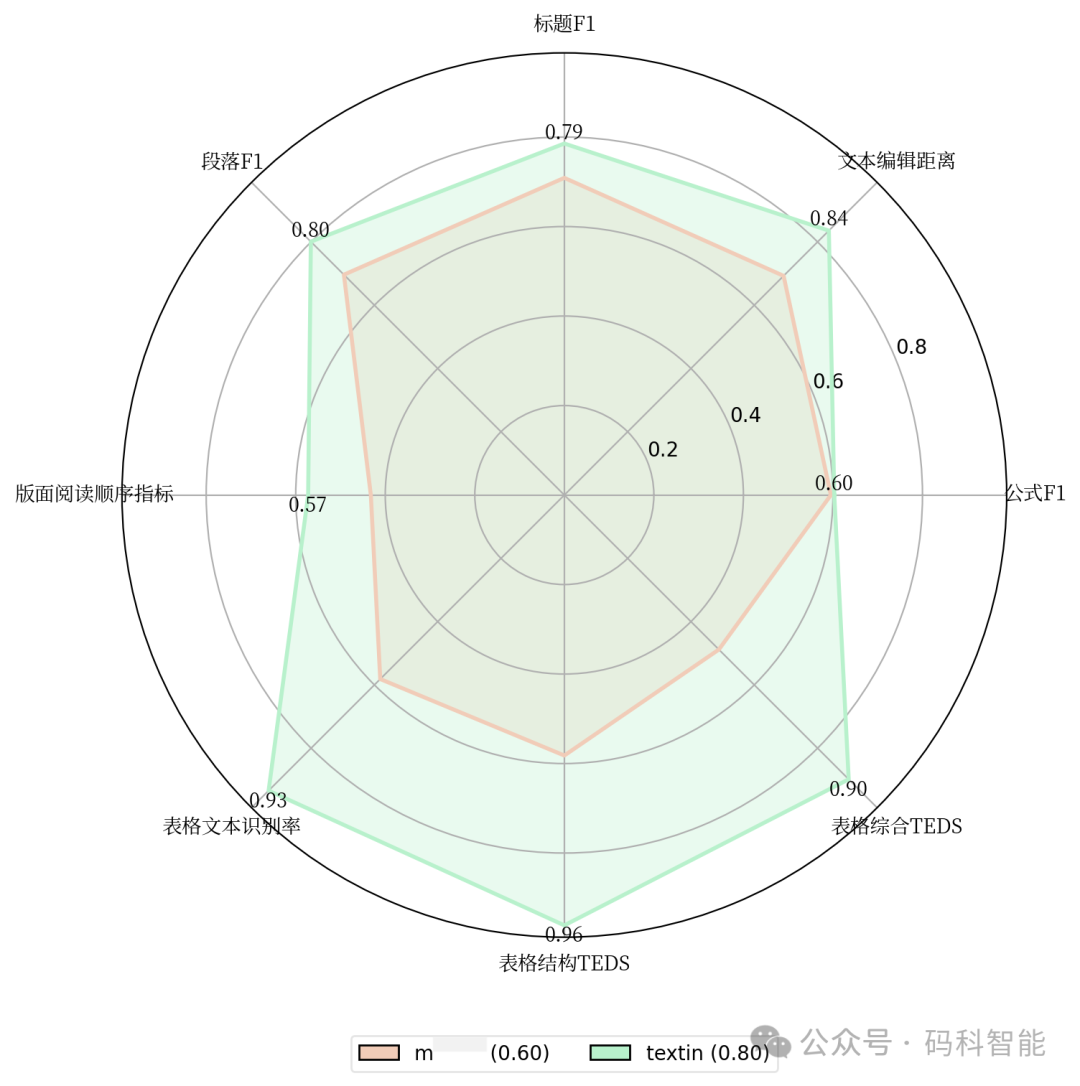
测评指标中分了6个维度,针对标题、段落、文本、阅读顺序、公式、表格进行定量测评。基于前文提到的大量真实样本,从多个维度评估了解析效果:

  • 文件类型:PDF 扫描件、图像文件、电子文档;

  • 内容种类:印刷体 + 手写字体,涵盖中英文;

  • 场景分布:学术论文、商业报告、教育试卷、政府公文、工程图纸等。

最终我们找到了一个相对综合表现较好的文档解析工具 TextIn ParseX 。

点击快速体验https://cc.co/16YSST

图片

它不是简单的OCR,也不是普通的PDF转Markdown工具,而是一个专为LLM定制的通用文档解析服务。在多项测试中,TextIn ParseX 表现稳定,尤其在表格识别方面尤为突出,但公式识别相对一般。
图片

三、别让文档成为LLM落地的瓶颈很多人低估了文档解析的重要性。但实际上,文档质量决定了AI理解的上限。如果你正在构建 RAG、Agent 或知识库系统,可以考虑将TextIn ParseX作为你的文档预处理引擎。

因为你需要的不只是一个“能跑”的工具,而是一个稳定、准确、快速、可持续迭代的文档理解工具。你可以点击链接快速体验,直接上传文档进行测试。如需深度测试或大批量处理,也支持本地部署。

文章转载自TextIn合作博主——码科智能,未经允许,请勿转发

【工具分享篇三】PDF公式提取教程(三) PDF公式提取教程(三)Mathpix免费次数获取及其平替LaTeX在线编辑器 阅读详情

相关推荐

PDF 文件的解析

PDF 文件的解析识别文字及表格

小张学AI 1604

PDF解析

PDF是一种查看方便但解析起来非常不方便的工具,不理解为什么到现在还没对这个问题从源头优化一下。对PDF文件的解析,一般分成对pdf文本等内容的解析、将pdf转化成图像再解析这两种。 一、pdf 解析文本 公认比较好用的pip库是pdfplumber,此外fitz也可以,经费够可以调pdflux这种服务商。fitz仅处理文本,pdfplumber还可以处理表格。 1.1 pdfplumber解析文本 PDFPlumber是基于 PDFMiner 构建...

北落师门XY的博客 1万+

【01】Canoe零基础手把手教学 --- Canoe安装

Canoe零基础手把手教学

jaytinlove的博客 7752

大模型下开源文档解析工具总结及技术思考

本文介绍了一些常见的文档解析工具和实现方法以及文本分割模型在文档解析中的充当的角色,并提供了相关技术实现思路。当然,如果粗糙的进行文档处理也是可以的,常见的有,基于LangChain的文档处理方式,但其底层技术很多都是上述文档parser工具的集成。在面对复杂文档,解析时还是存在一定的困难,基于布局的多模态版面分析是值得研究的点。虽然目前百模支撑的上下文长度能cover一本书的长度,但真正落地实施起来效果一般。

2301_78285120的博客 1829

FreeModbus源码详解

本篇按照FreeModbus协议栈的工作流程,对源代码进行总结解析;FreeModbus协议栈作为从机,等待主机传送的数据,当从机接收到一帧完整的报文后,对报文进行解析,然后响应主机,发送报文给主机,实现主机和从机之间的通信; 1:demo.c中三个函数,完成协议栈的准备工作; eMBInit()函数:(mb.c) /*函数功能: *1:实现RTU模式和ASCALL模式的协议栈初始化; *2

2万+

MQL5教程 01 MT5有关EA的操作、MetaEditor 工具栏主要功能

MQL5教程 01 MT5有关EA的操作、MetaEditor 工具栏主要功能

weixin_42830015的博客 3982

PDF 转 AI 知识库?让文档 “开口说话“ 的秘密一定要知道

当企业手握数百页的产品手册、技术文档和业务资料时,如何让 AI 真正 "读懂" 这些 PDF 文档,而不是简单地识别文字?这个问题正困扰着越来越多希望搭建智能问答系统的企业。传统 OCR 工具只能提取文字表面,却无法还原文档的结构逻辑和语义关系,导致 AI 客服答非所问、检索效率低下。而 TextIn xParse 文档解析工具的出现,正在改变这一局面 —— 它不仅能精准识别 PDF 中的文字、表格、公式,更能构建 "文档树",让 AI 像人类一样理解文档的层次结构。

TextIn智能文档云平台的官方博客 657

linux redis7 完整的集群搭建过程

一。安装: 1.1 说明: Redis官方只提供了源码,并没有提供经过编译之后的安装包。 因此,安装Redis,要先编译、后安装。(即源码安装方式) 注意:需要联网安装 1.2 安装编译的工具: yum install gcc gcc-c++ -y 1.3 下载tar包,上传到linux服务器,解压配置环境变量 1.4 cd +解压的目录下:编译 make 注意:如果编译失败,请重新进行解压编译,...

m0_38028438的博客 719

惊艳效果展示:OpenDataLab MinerU将复杂PDF转为结构化数据

本文介绍了如何在星图GPU平台上自动化部署OpenDataLab MinerU 智能文档理解镜像,高效实现复杂PDF(如学术论文、财务报表、手写笔记等)向结构化数据(Markdown/JSON)的精准转换,典型应用于科研文献整理、合同关键信息提取及财报自动化解析等场景。

weixin_32098457的博客 301

智元机器人开源具身仿真框架 Genie Sim 入门教程

GenieSim是AgiBot推出的具身智能仿真框架,提供完整闭环开发管道,包括轨迹生成、模型训练和基准测试。框架支持Docker容器化部署,要求Ubuntu 22.04和NVIDIA硬件环境。主要功能涵盖: 支持12种基准测试任务 提供ADER评估框架 集成UniVLA/RDT等基线模型 支持PICO/键盘遥操作 具备轨迹记录回放功能 提供完整API控制接口 开发者可通过Hugging Face获取场景资产,使用标准化ROS主题与仿真环境交互。框架特别优化了碰撞检测和抓取物理模拟,适用于从简单抓取到复杂操

2506_90492529的博客 2538

《30天入门 SAP BTP 开发》教程的目录和使用说明,建议收藏

本教程分为两部分:第一部分为SAP BTP入门系列,包含从基础概念到操作步骤的系统性学习内容,建议零基础用户按顺序学习;第二部分为专题文章集合,涵盖SAP BTP的多个技术点,适合已有基础的用户按需查阅。教程包含账号申请、Global Account操作、Java应用开发、AI工具使用等丰富内容,同时解答常见问题并提供实战案例。所有文章均附带详细链接,便于读者系统学习或针对性查阅。

2007 年 ~ 2025 年,深耕 SAP 技术 18 年 4385

告别OCR局限!MinerU智能文档理解在复杂排版中的惊艳表现

本文介绍了如何在星图GPU平台上自动化部署OpenDataLab MinerU智能文档理解镜像,实现复杂文档的高效解析。该镜像基于先进的InternVL架构,能够精准识别多栏排版、表格和图表等复杂结构,特别适用于学术论文、财务报表等专业文档的智能处理,大幅提升办公自动化效率。

weixin_32661831的博客 407

Allegro Design Entry HDL(OrCAD Capture HDL)原理图是设计快速入门图文教程

Allegro Design Entry HDL是Cadence公司开发的原理图设计工具,也可与Allegro PCB设计工具无缝对接,虽然板级开发中不如Design Entry CIS(又名 OrCAD Capture CIS)的使用那么广泛,但是由于Design Entry HDL支持芯片的开发,所以有不少公司尤其是芯片背景公司,选择使用Design Entry HDL进行原理图设计。两个原理图开发工具的使用方法大同小异,本文简单介绍使用Allegro Design Entry HDL开始一个新的设计,

fydar的博客 4120

PDF-Parser-1.0实战:快速将PDF转为可编辑文本

本文介绍了如何在星图GPU平台上自动化部署PDF-Parser-1.0文档理解模型,实现PDF到可编辑文本的高精度转换。该镜像专为中文文档优化,支持布局分析、表格识别与公式还原,典型应用于科研文献知识库构建、合同关键条款提取等场景,大幅提升文档处理效率。

weixin_36078669的博客 97

python中有趣的库 freegames 的详细使用

freegames 是一个包含多个简单 Python 游戏的开源库,适合初学者学习 Python 编程和游戏开发。以下是 freegames 的详细介绍和用法示例。

数据知道的博客 3万+

visio安装包

Microsoft Office Visio 是一款专业的制图软件。利用经过更新的形状、协作工具和数据链接图表,创建专业级图表以简化复杂的信息。

DeepSeek-OCR-2在LaTeX文档处理中的惊艳表现

本文介绍了如何在星图GPU平台上自动化部署DeepSeek-OCR-2镜像,高效实现LaTeX学术文档的精准OCR转换。该镜像可将PDF格式的数学论文自动识别为结构完整、公式保真的LaTeX代码,广泛应用于科研文献数字化、学术协作写作与教学材料复用等场景。

weixin_31591833的博客 319

C# WinForm 基于DirectShow.dll编写的程序,可边预览边保存视频,音频和图片

基于微软的DirectShow.dll的二次开发1.自动识别连接的摄像头跟麦克风且可以对其进行选择(默认选中第一个)2.可录制wmv和avi两种格式的视频并且都带有音频,avi可以录制的分辨率和帧数进行选择,wmv默认进行了淸晰度优化如不喜欢可去除代码中有相关提示3.可在预览点开之后进行拍照,也可边录制视频边拍照4.添加了视频和音频的压缩功能(酌情使用)这次二次开发发现C#对DirectShow的相关信息太少,这次做完也不敢藏私共享出来,还望大家指正

数学建模竞赛利器:DeepSeek-OCR公式识别实战应用

本文介绍了如何在星图GPU平台上自动化部署🏮 DeepSeek-OCR · 万象识界镜像,高效实现数学公式识别与LaTeX代码生成。该方案专为数学建模竞赛设计,可快速将PDF扫描件、手写笔记及跨页论文中的复杂公式转化为可编译、可计算的结构化表达,显著提升文献处理与模型推导效率。

weixin_29363791的博客 252

廖雪峰Python教程[完整版]

廖雪峰的python教程整理的,已经排好版了,而且还是完整的,适合小白

android 蓝牙通讯demo

android 下蓝牙通讯demo,实现了发现蓝牙,使能蓝牙,通过蓝牙发送消息。

免费神器!DeepSeek-OCR-2快速识别图片中的文字

本文介绍了如何在星图GPU平台上自动化部署DeepSeek-OCR-2镜像,实现高精度文档图像文字识别。该镜像开箱即用,支持PDF与图片输入,可快速将扫描合同、发票、教材截图等转化为可编辑文本,显著提升法务、教育及科研人员的文档处理效率。

weixin_35755640的博客 296

深求·墨鉴实战落地:学术论文PDF图片→结构化Markdown,Obsidian直连教程

本文介绍了如何在星图GPU平台上自动化部署🖋️ 深求·墨鉴 (DeepSeek-OCR-2)镜像,高效实现学术论文PDF截图到结构化Markdown的智能解析。该镜像专精于保留标题层级、LaTeX公式与表格语义,可直连Obsidian构建可检索、可双链的知识笔记,显著提升科研文献整理效率。

weixin_42499004的博客 291

告别传统OCR瓶颈|用PaddleOCR-VL-WEB实现端到端结构化信息提取

本文介绍了如何在星图GPU平台上自动化部署PaddleOCR-VL-WEB镜像,实现对发票、简历等文档的端到端结构化信息提取。用户无需编码即可快速搭建AI识别服务,广泛应用于财务报销、HR信息录入等场景,显著提升文档处理效率。

weixin_36197669的博客 605

Qwen3-VL长文档结构解析:自动划分章节、表格与引用关系

Qwen3-VL通过超长上下文支持与多模态融合,实现对复杂PDF文档的自动章节划分、表格识别和引用关系还原,兼具OCR精度与语义理解深度,适用于合同、手册等企业级知识处理场景。

weixin_42465140的博客 528

DeepSeek-OCR 2对比测评:传统OCR工具可以退休了?

本文介绍了如何在星图GPU平台上自动化部署🏮 DeepSeek-OCR · 万象识界镜像,实现高精度文档智能解析。该镜像可精准还原复杂PDF、扫描件中的表格结构、手写批注与多栏排版,并直出可编辑的Markdown格式,广泛应用于合同审查、财报分析与学术论文处理等场景。

weixin_42360846的博客 113

如何高效解析复杂CAD图纸?试试PaddleOCR-VL-WEB大模型镜像

本文介绍了如何在星图GPU平台上自动化部署PaddleOCR-VL-WEB镜像,实现对复杂CAD图纸的高效解析。基于该平台的强大算力支持,用户可快速搭建文档理解环境,应用于机械设计、建筑图纸数字化等场景,精准提取文本、表格及技术参数,显著提升工程信息处理效率。

weixin_42611310的博客 589

Qwen3-VL中文OCR优化:古代汉字与专业术语识别准确率大幅提升

Qwen3-VL通过融合视觉与语言模型,显著提升古代汉字和专业术语的识别能力。其支持长上下文、结构化解析与多领域词典,使古籍、医疗、司法等复杂文档的数字化更高效精准,推动OCR从转录工具迈向智能阅读。

weixin_32661831的博客 698

MinerU新闻年报提取:企业信息抽取实战落地案例

本文介绍了如何在星图GPU平台上自动化部署MinerU 2.5-1.2B 深度学习 PDF 提取镜像,高效实现企业年报等复杂PDF文档的关键信息抽取。该镜像可精准识别多栏布局、跨页表格与数学公式,输出结构化Markdown,广泛应用于金融尽调、行业研究与投资分析等场景。

weixin_33750664的博客 656

从扫描件到结构化数据|PaddleOCR-VL-WEB助力精准文档解析

本文介绍了如何在星图GPU平台上自动化部署PaddleOCR-VL-WEB镜像,实现对扫描件的精准文档解析。基于该平台,用户可快速搭建文档理解系统,应用于合同条款提取、财务报表数据识别等场景,将非结构化文档高效转化为可编辑的结构化数据。

weixin_35886636的博客 104
上一篇: TextIn ParseX重磅功能更新:支持切换公式输出形式、表格解析优化、新增电子档PDF去印章
下一篇: AI帮大忙!这个判卷/去印/建题库/的减负神器,老师一定要知道
TextIn智能文档云平台
博客等级 码龄2年 366粉丝 363原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值