


ShowMeAI日报系列全新升级!覆盖AI人工智能 工具&框架 | 项目&代码 | 博文&分享 | 数据&资源 | 研究&论文 等方向。点击查看 历史文章列表,在公众号内订阅话题 #ShowMeAI资讯日报,可接收每日最新推送。点击 专题合辑&电子月刊 快速浏览各专题全集。点击 这里 回复关键字 日报 免费获取AI电子月刊与资料包。
1.工具&框架

工具库:ClearML - 开源的机器学习工具包,自带简洁美观的可视化界面
tags: [机器学习,建模,可视化,工具包]
该工具可用于简化机器学习开发、运维流程,自动完成实验跟踪与结果记录,并提供了灵活多变的数据管理方案。
GitHub: https://github.com/allegroai/clearml


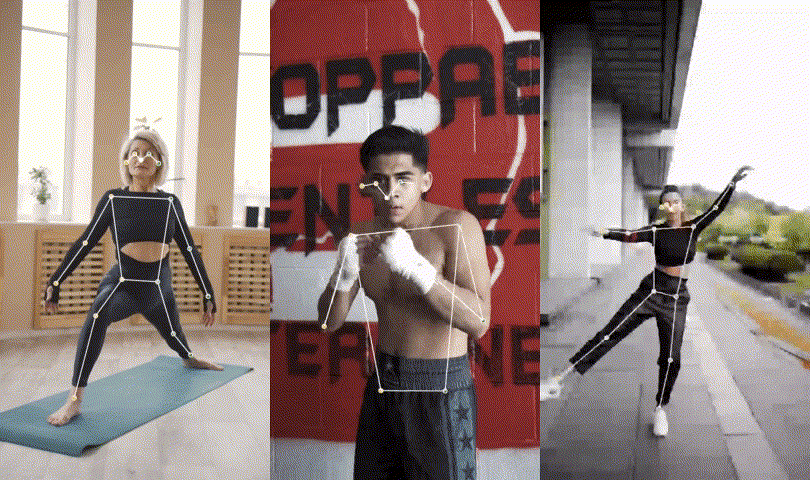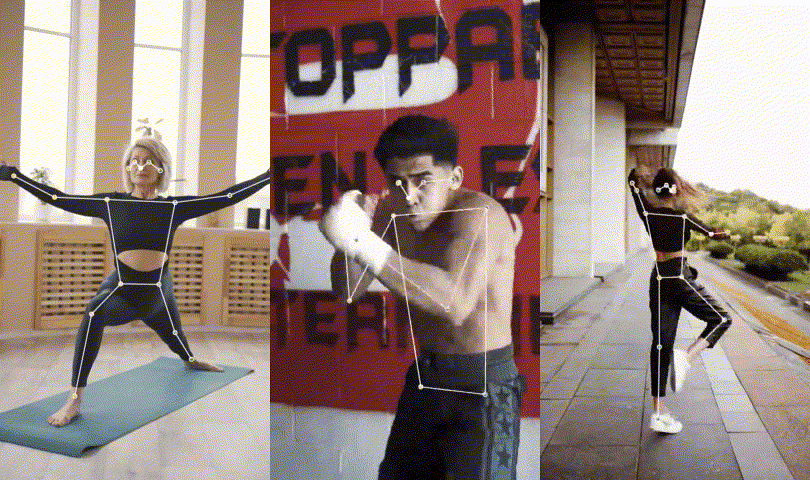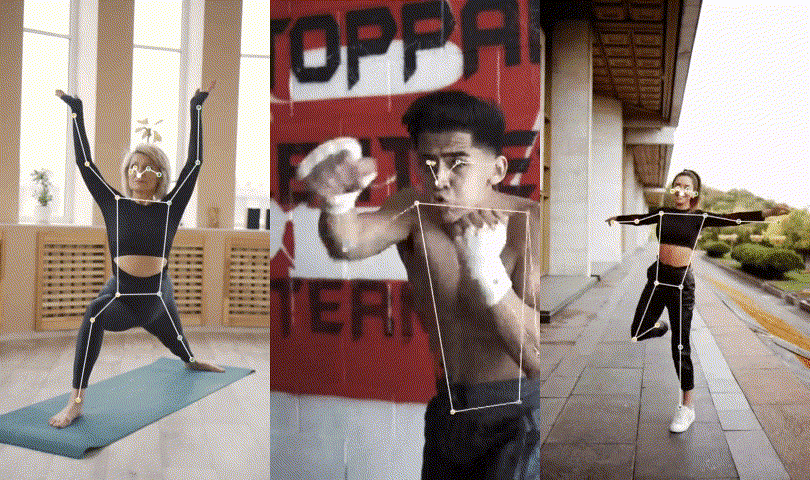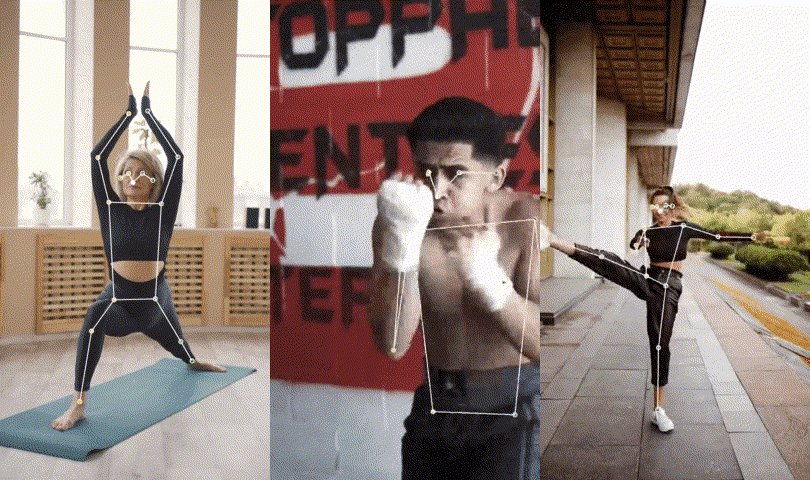
工具库:Movenet.Pytorch - 用PyTorch重写的MoveNet人体关键点检测
tags: [关键点检测,pytorch,MoveNet]
‘Movenet.Pytorch - A Pytorch implementation of MoveNet from Google. Include training code and pre-trained model.’ by Mr.Fire
GitHub: https://github.com/fire717/movenet.pytorch

工具:Beekeeper Studio - 跨平台 SQL 编辑器
tags: [SQL编辑器,工具]
Beekeeper Studio提供 SQL 语法高亮、自动补全、数据表内容筛选与过滤、连接 Web 数据库、存储历史查询记录等功能。支持 SQLite、MySQL、MariaDB、Postgres 等主流数据库,并兼容 Windows、macOS、Linux 等桌面操作系统。
GitHub: https://github.com/beekeeper-studio/beekeeper-studio


工具:Think(云策文档) - 开源知识管理工具
tags: [知识管理,工具]
Think内置知识库、思维导图、文档模板、在线编辑器等多种工具。可通过独立的知识库空间,结构化地组织在线协作文档,实现知识的积累与沉淀,促进知识的复用与流通。
GitHub: https://github.com/fantasticit/think


工具:dashy - 高度可定制化、自托管的服务器启动页构建工具
tags: [服务器启动页,定制化,自托管]
dashy自带可视化编辑器、状态检测系统,并拥有各类丰富的组件及主题。可为不同应用快速搭建一个服务器管理面板,并基于各种组件、图标、主题,完成自定义配置,项目内置身份验证、状态监测、搜索、备份、可视化配置、多语言支持等功能。
GitHub: https://github.com/Lissy93/dashy


2.项目&代码

代码:各种注意力机制的PyTorch实现
tags: [注意力机制,pytorch]
’External-Attention-pytorch - Pytorch implementation of various Attention Mechanism’ by xmu-xiaoma66
GitHub: https://github.com/xmu-xiaoma666/External-Attention-pytorch


3.博文&分享

分享:Machine Learning Interview - 机器学习面试题库
tags: [机器学习,面试,题库]
收录了世界各大互联网公司的机器学习面试题。包括概率与统计、大数据、AB 测试、机器学习与深度学习领域的速查表、面试准备、学习指南、项目用例、面试经验等内容。
GitHub: https://github.com/khangich/machine-learning-interview

分享:《剑指 Offer》 Python, Java, C++ 解题代码,LeetBook《图解算法数据结构》配套代码
tags: [数据结构,算法,剑指offer,LeetCode]
GitHub: https://github.com/krahets/LeetCode-Book

4.数据&资源

数据集:internet-dataset - 通过搜索引擎获取的各种数据集
tags: [互联网数据,搜索引擎,数据集]
数据集整体数据量将近 50G,其中包括域名、网页、反向索引等数据。
GitHub: https://github.com/RimoChan/internet-dataset

5.研究&论文

可以点击 这里 回复关键字 日报,免费获取整理好的6月论文合辑。
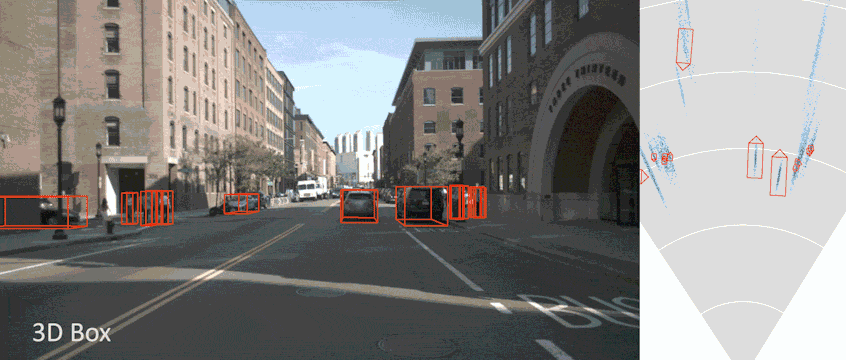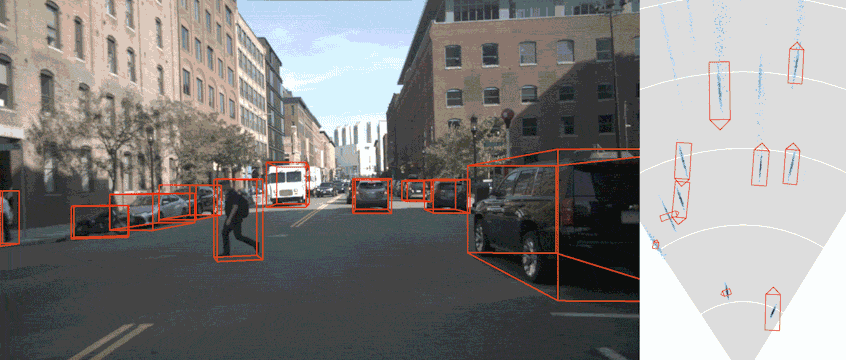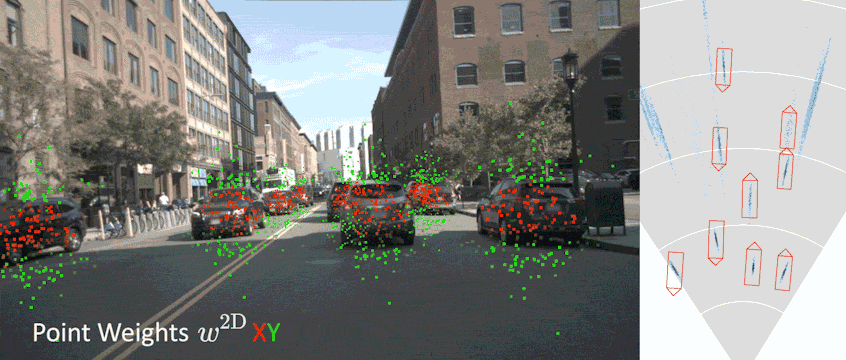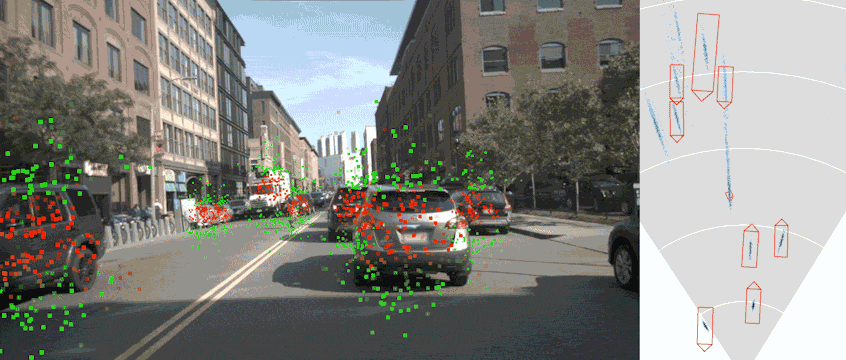
论文:EPro-PnP: Generalized End-to-End Probabilistic Perspective-n-Points for Monocular Object Pose Estimation
论文标题:EPro-PnP: Generalized End-to-End Probabilistic Perspective-n-Points for Monocular Object Pose Estimation
论文时间:CVPR 2022
所属领域:计算机视觉
对应任务:3D Object Detection,6D Pose Estimation using RGB,object-detection,三维物体检测,使用RGB进行6维姿势估计,物体检测
论文地址:https://arxiv.org/abs/2203.13254
代码实现:https://github.com/tjiiv-cprg/epro-pnp
论文作者:Hansheng Chen, Pichao Wang, Fan Wang, Wei Tian, Lu Xiong, Hao Li
论文简介:The 2D-3D coordinates and corresponding weights are treated as intermediate variables learned by minimizing the KL divergence between the predicted and target pose distribution./2D-3D坐标和相应的权重被视为中间变量,通过最小化预测和目标姿势分布之间的KL散度来学习。
论文摘要:Locating 3D objects from a single RGB image via Perspective-n-Points (PnP) is a long-standing problem in computer vision. Driven by end-to-end deep learning, recent studies suggest interpreting PnP as a differentiable layer, so that 2D-3D point correspondences can be partly learned by backpropagating the gradient w.r.t. object pose. Yet, learning the entire set of unrestricted 2D-3D points from scratch fails to converge with existing approaches, since the deterministic pose is inherently non-differentiable. In this paper, we propose the EPro-PnP, a probabilistic PnP layer for general end-to-end pose estimation, which outputs a distribution of pose on the SE(3) manifold, essentially bringing categorical Softmax to the continuous domain. The 2D-3D coordinates and corresponding weights are treated as intermediate variables learned by minimizing the KL divergence between the predicted and target pose distribution. The underlying principle unifies the existing approaches and resembles the attention mechanism. EPro-PnP significantly outperforms competitive baselines, closing the gap between PnP-based method and the task-specific leaders on the LineMOD 6DoF pose estimation and nuScenes 3D object detection benchmarks.
通过Perspective-n-Points(PnP)从单一的RGB图像中定位3D物体是计算机视觉中一个长期存在的问题。在端到端深度学习的驱动下,最近的研究建议将PnP解释为一个可微分层,这样就可以通过反向传播物体姿势的梯度来部分地学习2D-3D点对应关系。然而,从头开始学习整个无限制的2D-3D点集在现有的方法中无法收敛,因为确定的姿势本身就是不可微分的。在本文中,我们提出了Pro-PnP,一个用于一般端到端姿势估计的概率PnP层,它输出SE(3)流形上的姿势分布,本质上是将分类的Softmax带到连续域。2D-3D坐标和相应的权重被视为中间变量,通过最小化预测和目标姿势分布之间的KL散度来学习。其基本原理统一了现有的方法,类似于注意力机制。EPro-PnP明显优于竞争基准,在LineMOD 6DoF姿势估计和nuScenes三维物体检测基准上缩小了基于PnP的方法与特定任务领导者之间的差距。


论文:EdgeNeXt: Efficiently Amalgamated CNN-Transformer Architecture for Mobile Vision Applications
论文标题:EdgeNeXt: Efficiently Amalgamated CNN-Transformer Architecture for Mobile Vision Applications
论文时间:21 Jun 2022
所属领域:计算机视觉
对应任务:Byronfex,Image Classification,Object Detection,Semantic Segmentation,图像分类,物体检测,语义分割
论文地址:https://arxiv.org/abs/2206.10589
代码实现:https://github.com/mmaaz60/EdgeNeXt
论文作者:Muhammad Maaz, Abdelrahman Shaker, Hisham Cholakkal, Salman Khan, Syed Waqas Zamir, Rao Muhammad Anwer, Fahad Shahbaz Khan
论文简介:Our EdgeNeXt model with 1. 3M parameters achieves 71. 2% top-1 accuracy on ImageNet-1K, outperforming MobileViT with an absolute gain of 2. 2% with 28% reduction in FLOPs./我们的EdgeNeXt模型用1.3M的参数在ImageNet-1K上实现了71. 2%的top-1准确性,比MobileViT的绝对收益高出2.2%,FLOPs减少28%。
论文摘要:In the pursuit of achieving ever-increasing accuracy, large and complex neural networks are usually developed. Such models demand high computational resources and therefore cannot be deployed on edge devices. It is of great interest to build resource-efficient general purpose networks due to their usefulness in several application areas. In this work, we strive to effectively combine the strengths of both CNN and Transformer models and propose a new efficient hybrid architecture EdgeNeXt. Specifically in EdgeNeXt, we introduce split depth-wise transpose attention (SDTA) encoder that splits input tensors into multiple channel groups and utilizes depth-wise convolution along with self-attention across channel dimensions to implicitly increase the receptive field and encode multi-scale features. Our extensive experiments on classification, detection and segmentation tasks, reveal the merits of the proposed approach, outperforming state-of-the-art methods with comparatively lower compute requirements. Our EdgeNeXt model with 1.3M parameters achieves 71.2% top-1 accuracy on ImageNet-1K, outperforming MobileViT with an absolute gain of 2.2% with 28% reduction in FLOPs. Further, our EdgeNeXt model with 5.6M parameters achieves 79.4% top-1 accuracy on ImageNet-1K. The code and models are publicly available at https://github.com/mmaaz60/EdgeNeXt
为了追求不断提高的准确性,通常会开发大型复杂的神经网络。这种模型需要高计算资源,因此不能部署在边缘设备上。由于其在多个应用领域的实用性,建立资源效率高的通用网络是非常有意义的。在这项工作中,我们努力有效地结合CNN和Transformer模型的优势,并提出了一个新的高效混合架构EdgeNeXt。具体来说,在EdgeNeXt中,我们引入了分割深度转置注意力(SDTA)编码器,将输入张量分割成多个通道组,并利用深度卷积以及跨通道维度的自我注意力来隐含地增加感受野和编码多尺度特征。我们对分类、检测和分割任务进行了广泛的实验,揭示了所提出的方法的优点,以相对较低的计算要求超越了最先进的方法。我们的EdgeNeXt模型有130万个参数,在ImageNet-1K上达到了71.2%的top-1准确率,比MobileViT的绝对收益高2.2%,FLOPs减少28%。此外,我们的EdgeNeXt模型有5.6M的参数,在ImageNet-1K上达到了79.4%的最高准确率。这些代码和模型可在 https://github.com/mmaaz60/EdgeNeXt 公开获取。


论文:RegionCLIP: Region-based Language-Image Pretraining
论文标题:RegionCLIP: Region-based Language-Image Pretraining
论文时间:CVPR 2022
所属领域:计算机视觉
对应任务:Image Classification,object-detection,Object Detection,Transfer Learning,图像分类,物体检测,迁移学习
论文地址:https://arxiv.org/abs/2112.09106
代码实现:https://github.com/microsoft/regionclip
论文作者:Yiwu Zhong, Jianwei Yang, Pengchuan Zhang, Chunyuan Li, Noel Codella, Liunian Harold Li, Luowei Zhou, Xiyang Dai, Lu Yuan, Yin Li, Jianfeng Gao
论文简介:However, we show that directly applying such models to recognize image regions for object detection leads to poor performance due to a domain shift: CLIP was trained to match an image as a whole to a text description, without capturing the fine-grained alignment between image regions and text spans./然而,我们表明,直接应用这样的模型来识别图像区域进行物体检测,会因为领域变化而导致性能不佳。CLIP被训练为将图像整体与文本描述相匹配,而没有捕捉到图像区域和文本跨度之间的细粒度对齐。
论文摘要:Contrastive language-image pretraining (CLIP) using image-text pairs has achieved impressive results on image classification in both zero-shot and transfer learning settings. However, we show that directly applying such models to recognize image regions for object detection leads to poor performance due to a domain shift: CLIP was trained to match an image as a whole to a text description, without capturing the fine-grained alignment between image regions and text spans. To mitigate this issue, we propose a new method called RegionCLIP that significantly extends CLIP to learn region-level visual representations, thus enabling fine-grained alignment between image regions and textual concepts. Our method leverages a CLIP model to match image regions with template captions and then pretrains our model to align these region-text pairs in the feature space. When transferring our pretrained model to the open-vocabulary object detection tasks, our method significantly outperforms the state of the art by 3.8 AP50 and 2.2 AP for novel categories on COCO and LVIS datasets, respectively. Moreoever, the learned region representations support zero-shot inference for object detection, showing promising results on both COCO and LVIS datasets. Our code is available at https://github.com/microsoft/RegionCLIP
使用图像-文本对的对比性语言-图像预训练(CLIP)在零样本和迁移学习设置中的图像分类上取得了令人印象深刻的结果。然而,我们表明,由于领域的转移,直接应用这种模型来识别图像区域进行物体检测会导致性能不佳。CLIP被训练成将图像作为一个整体与文本描述相匹配,而没有捕捉到图像区域和文本跨度之间的细粒度对齐。为了缓解这个问题,我们提出了一种叫做RegionCLIP的新方法,它极大地扩展了CLIP来学习区域级的视觉表征,从而使图像区域和文本概念之间的细粒度对齐。我们的方法利用CLIP模型将图像区域与模板说明相匹配,然后预训练我们的模型在特征空间中对齐这些区域-文本对。当把我们的预训练模型迁移到开放词汇的物体检测任务中时,我们的方法在COCO和LVIS数据集的新类别上分别以3.8AP50和2.2AP的成绩大大超过了现有技术水平。此外,学习到的区域表征支持物体检测的零样本推断,在COCO和LVIS数据集上都显示出很好的效果。我们的代码可在 https://github.com/microsoft/RegionCLIP 获取。


论文:Nocturne: a scalable driving benchmark for bringing multi-agent learning one step closer to the real world
论文标题:Nocturne: a scalable driving benchmark for bringing multi-agent learning one step closer to the real world
论文时间:20 Jun 2022
对应任务:Imitation Learning,模仿学习
论文地址:https://arxiv.org/abs/2206.09889
代码实现:https://github.com/facebookresearch/nocturne
论文作者:Eugene Vinitsky, Nathan Lichtlé, Xiaomeng Yang, Brandon Amos, Jakob Foerster
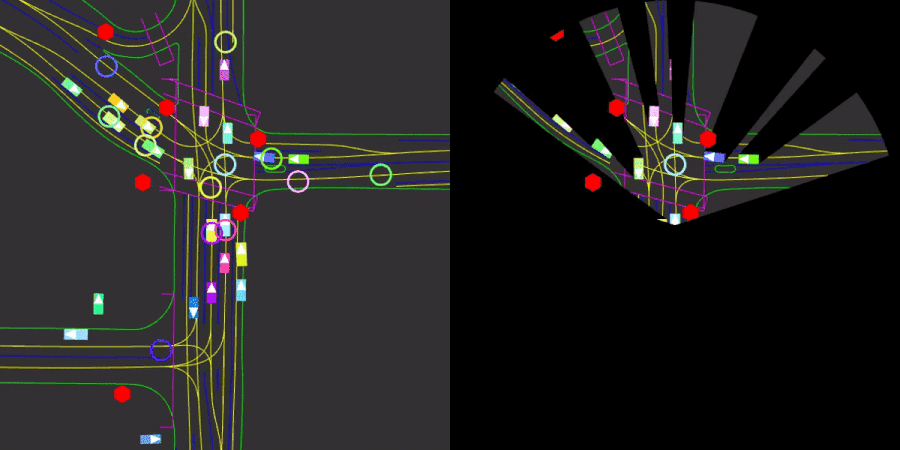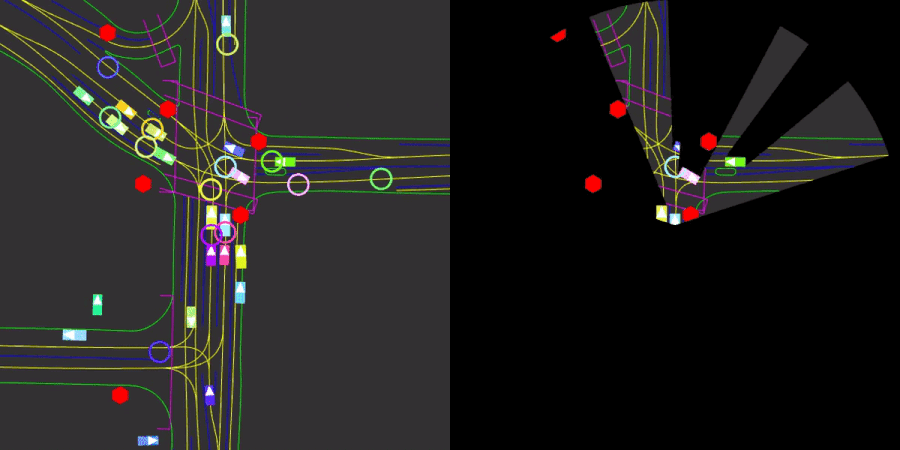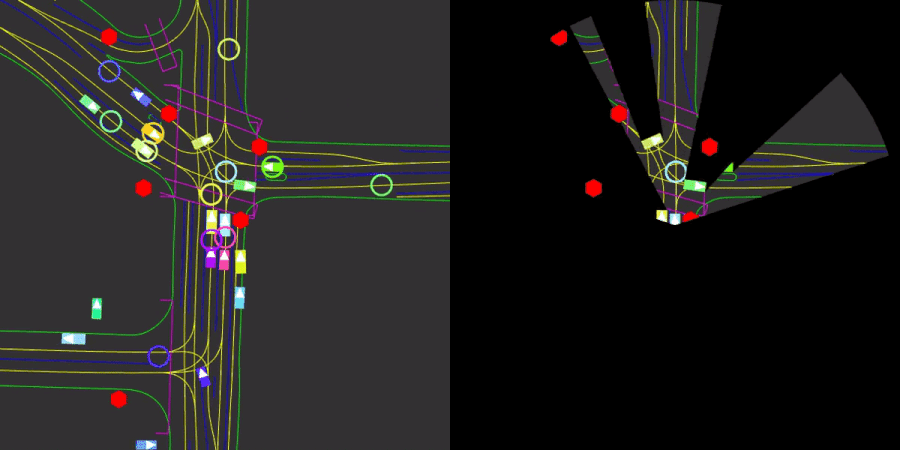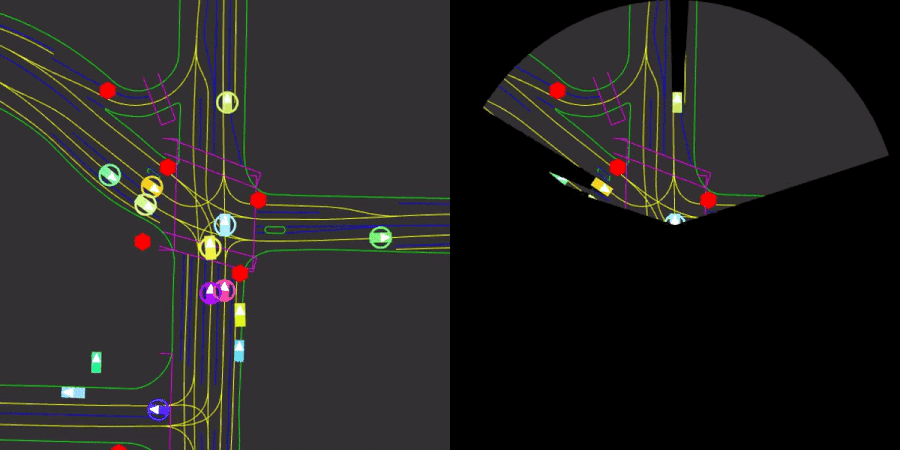
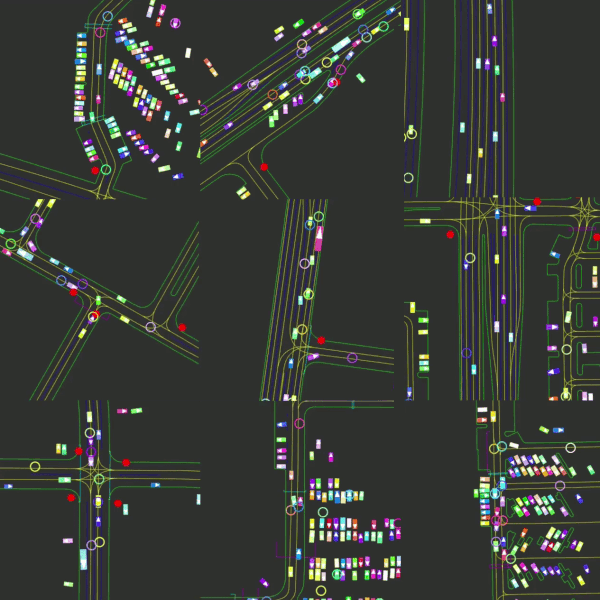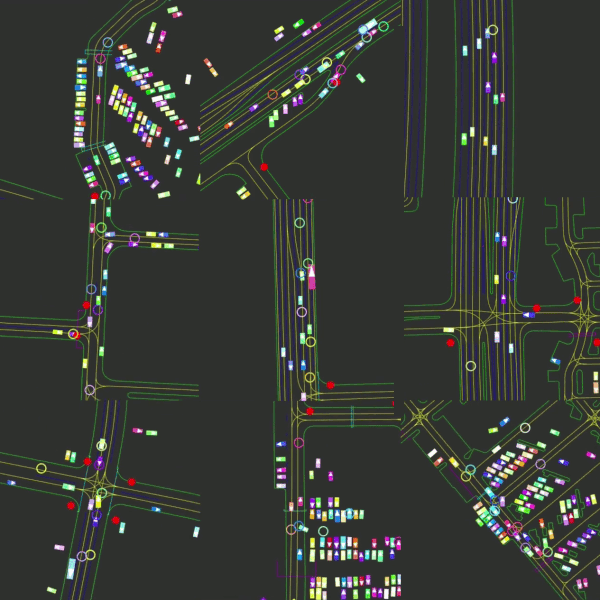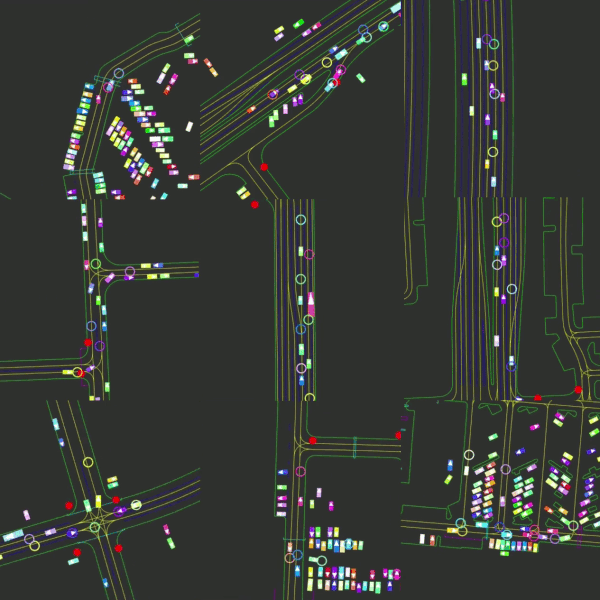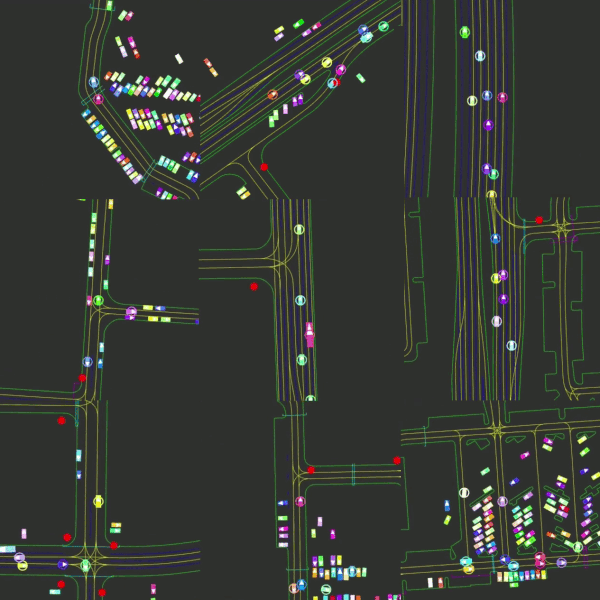
论文简介:We introduce \textit{Nocturne}, a new 2D driving simulator for investigating multi-agent coordination under partial observability./我们介绍了Nocturne,一个新的二维驾驶模拟器,用于研究部分可观察性下的多Agent协调。
论文摘要:We introduce \textit{Nocturne}, a new 2D driving simulator for investigating multi-agent coordination under partial observability. The focus of Nocturne is to enable research into inference and theory of mind in real-world multi-agent settings without the computational overhead of computer vision and feature extraction from images. Agents in this simulator only observe an obstructed view of the scene, mimicking human visual sensing constraints. Unlike existing benchmarks that are bottlenecked by rendering human-like observations directly using a camera input, Nocturne uses efficient intersection methods to compute a vectorized set of visible features in a C++ back-end, allowing the simulator to run at 2000+ steps-per-second. Using open-source trajectory and map data, we construct a simulator to load and replay arbitrary trajectories and scenes from real-world driving data. Using this environment, we benchmark reinforcement-learning and imitation-learning agents and demonstrate that the agents are quite far from human-level coordination ability and deviate significantly from the expert trajectories.
我们介绍了Nocturne,这是一个新的二维驾驶模拟器,用于研究部分可观察性下的多Agent协调。Nocturne的重点是在没有计算机视觉和图像特征提取的计算开销的情况下,在现实世界的多Agent环境中进行推理和思维理论的研究。该模拟器中的代理只观察场景的遮挡视图,模仿人类的视觉感应限制。与现有的基准不同,Nocturne使用高效的交叉方法来计算C++后端可见特征的矢量集,使模拟器能够以每秒2000多步的速度运行。利用开源的轨迹和地图数据,我们构建了一个模拟器来加载和重放真实世界驾驶数据中的任意轨迹和场景。利用这个环境,我们对强化学习和模仿学习的代理进行了基准测试,并证明这些代理与人类水平的协调能力相差甚远,并明显偏离专家的轨迹。

论文:Voxel-MAE: Masked Autoencoders for Pre-training Large-scale Point Clouds
论文标题:Voxel-MAE: Masked Autoencoders for Pre-training Large-scale Point Clouds
论文时间:20 Jun 2022
所属领域:计算机视觉
对应任务:3D Object Detection,object-detection,Object Detection,Self-Supervised Learning,3D物体检测,物体检测,自监督学习
论文地址:https://arxiv.org/abs/2206.09900
代码实现:https://github.com/chaytonmin/voxel-mae
论文作者:Chen Min, Dawei Zhao, Liang Xiao, Yiming Nie, Bin Dai
论文简介:As the point clouds in 3D object detection is large-scale, it is impossible to reconstruct the input point clouds./由于三维物体检测中的点云是大规模的,不可能对输入的点云进行重构。
论文摘要:Mask-based pre-training has achieved great success for self-supervised learning in image, video and language, without manually annotated supervision. However, as information redundant data, it has not yet been studied in the field of 3D object detection. As the point clouds in 3D object detection is large-scale, it is impossible to reconstruct the input point clouds. In this paper, we propose a mask voxel classification network for large-scale point clouds pre-training. Our key idea is to divide the point clouds into voxel representations and classify whether the voxel contains point clouds. This simple strategy makes the network to be voxel-aware of the object shape, thus improving the performance of 3D object detection. Extensive experiments show great effectiveness of our pre-trained model with 3D object detectors (SECOND, CenterPoint, and PV-RCNN) on three popular datasets (KITTI, Waymo, and nuScenes). Codes are publicly available at https://github.com/chaytonmin/voxel-mae.
基于Mask/掩码的预训练在图像、视频和语言的自监督学习中取得了巨大的成功,不需要人工标注监督。然而,作为信息冗余的数据,它在三维物体检测领域还没有被研究。由于三维物体检测中的点云是大规模的,不可能对输入的点云进行重构。在本文中,我们提出了一个用于大规模点云预训练的掩码体素分类网络。我们的关键思想是将点云划分为体素表征,并对体素是否包含点云进行分类。这种简单的策略使得网络对物体形状具有体素感知能力,从而提高了三维物体检测的性能。广泛的实验表明,我们的预训练模型与三维物体检测器(SECOND、CenterPoint和PV-RCNN)在三个流行的数据集(KITTI、Waymo和nuScenes)上的效果非常好。代码可在 https://github.com/chaytonmin/voxel-mae 上公开获取。


论文:Global Context Vision Transformers
论文标题:Global Context Vision Transformers
论文时间:20 Jun 2022
所属领域:计算机视觉
对应任务:Image Classification,Inductive Bias,Instance Segmentation,object-detection,Object Detection,Semantic Segmentation,图像分类,归纳偏置,实例分割,物体检测,语义分割
论文地址:https://arxiv.org/abs/2206.09959
代码实现:https://github.com/nvlabs/gcvit
论文作者:Ali Hatamizadeh, Hongxu Yin, Jan Kautz, Pavlo Molchanov
论文简介:We propose global context vision transformer (GC ViT), a novel architecture that enhances parameter and compute utilization./我们提出了全局上下文视觉transformer(GC ViT),这是一种能提高参数和计算利用率的新型架构。
论文摘要:We propose global context vision transformer (GC ViT), a novel architecture that enhances parameter and compute utilization. Our method leverages global context self-attention modules, joint with local self-attention, to effectively yet efficiently model both long and short-range spatial interactions, without the need for expensive operations such as computing attention masks or shifting local windows. In addition, we address the issue of lack of the inductive bias in ViTs via proposing to use a modified fused inverted residual blocks in our architecture. Our proposed GC ViT achieves state-of-the-art results across image classification, object detection and semantic segmentation tasks. On ImageNet-1K dataset for classification, the base, small and tiny variants of GC ViT with 28M, 51M and 90M parameters achieve 83.2%, 83.9% and 84.4% Top-1 accuracy, respectively, surpassing comparably-sized prior art such as CNN-based ConvNeXt and ViT-based Swin Transformer by a large margin. Pre-trained GC ViT backbones in downstream tasks of object detection, instance segmentation, and semantic segmentation using MS COCO and ADE20K datasets outperform prior work consistently, sometimes by large margins. Code available at https://github.com/nvlabs/gcvit
我们提出了全局上下文视觉transformer(GC ViT),这是一种新型的架构,可以提高参数和计算的利用率。我们的方法利用全局上下文自我注意模块,与局部自我注意相结合,有效地对长距离和短距离的空间互动进行建模,而不需要进行昂贵(计算)的操作,如计算注意掩码或滑动局部窗口。此外,我们通过建议在我们的架构中使用改进的融合倒置残差块来解决ViTs中缺乏归纳偏置的问题。我们提出的GC ViT在图像分类、物体检测和语义分割任务中取得了最先进的成果。在ImageNet-1K数据集的分类中,具有28M、51M和90M参数的GC ViT的基础、小型和微型变体分别达到83.2%、83.9%和84.4%的Top-1准确率,大大超过了基于CNN的ConvNeXt和基于ViT的Swin Transformer等规模相当的现有技术。在使用MS COCO和ADE20K数据集进行对象检测、实例分割和语义分割的下游任务中,预先训练的GC ViT骨干一直优于先前的工作,甚至超出很多。代码可在 https://github.com/nvlabs/gcvit 获取。


论文:EnvPool: A Highly Parallel Reinforcement Learning Environment Execution Engine
论文标题:EnvPool: A Highly Parallel Reinforcement Learning Environment Execution Engine
论文时间:21 Jun 2022
所属领域:强化学习
对应任务:reinforcement-learning,强化学习
论文地址:https://arxiv.org/abs/2206.10558
代码实现:https://github.com/sail-sg/envpool , https://github.com/vwxyzjn/envpool-cleanrl , https://github.com/vwxyzjn/cleanrl , https://github.com/Denys88/rl_games
论文作者:Jiayi Weng, Min Lin, Shengyi Huang, Bo Liu, Denys Makoviichuk, Viktor Makoviychuk, Zichen Liu, Yufan Song, Ting Luo, Yukun Jiang, Zhongwen Xu, Shuicheng Yan
论文简介:On a high-end machine, EnvPool achieves 1 million frames per second for the environment execution on Atari environments and 3 million frames per second on MuJoCo environments./在一台高端机器上,EnvPool在Atari环境下的执行速度达到每秒100万帧,在MuJoCo环境下达到每秒300万帧。
论文摘要:There has been significant progress in developing reinforcement learning (RL) training systems. Past works such as IMPALA, Apex, Seed RL, Sample Factory, and others aim to improve the system’s overall throughput. In this paper, we try to address a common bottleneck in the RL training system, i.e., parallel environment execution, which is often the slowest part of the whole system but receives little attention. With a curated design for paralleling RL environments, we have improved the RL environment simulation speed across different hardware setups, ranging from a laptop, and a modest workstation, to a high-end machine like NVIDIA DGX-A100. On a high-end machine, EnvPool achieves 1 million frames per second for the environment execution on Atari environments and 3 million frames per second on MuJoCo environments. When running on a laptop, the speed of EnvPool is 2.8 times of the Python subprocess. Moreover, great compatibility with existing RL training libraries has been demonstrated in the open-sourced community, including CleanRL, rl_games, DeepMind Acme, etc. Finally, EnvPool allows researchers to iterate their ideas at a much faster pace and has the great potential to become the de facto RL environment execution engine. Example runs show that it takes only 5 minutes to train Atari Pong and MuJoCo Ant, both on a laptop. EnvPool has already been open-sourced at https://github.com/sail-sg/envpool.
在开发强化学习(RL)训练系统方面已经取得了重大进展。过去的工作,如IMPALA、Apex、Seed RL、Sample Factory等,旨在提高系统的整体吞吐量。在本文中,我们试图解决RL训练系统中的一个常见瓶颈,即并行环境执行,这往往是整个系统中最慢的部分,但却很少受到关注。通过对RL环境的并行化设计,我们在不同的硬件设置上提高了RL环境的模拟速度,从笔记本电脑、普通的工作站到NVIDIA DGX-A100这样的高端机器。在高端机器上,EnvPool在Atari环境下的执行速度达到每秒100万帧,在MuJoCo环境下达到每秒300万帧。在笔记本电脑上运行时,EnvPool的速度是Python子进程的2.8倍。此外,与现有RL训练库的极大兼容性已在开源社区得到证明,包括CleanRL、rl_games、DeepMind Acme等。最后,EnvPool允许研究人员以更快的速度迭代他们的想法,并具有成为事实上的RL环境执行引擎的巨大潜力。运行实例表明,在笔记本电脑上训练Atari Pong和MuJoCo Ant只需要5分钟。EnvPool已经在https://github.com/sail-sg/envpool 上开源了。


论文:How Well Do Sparse Imagenet Models Transfer?
论文标题:How Well Do Sparse Imagenet Models Transfer?
论文时间:CVPR 2022
所属领域:计算机视觉
对应任务:Transfer Learning,迁移学习
论文地址:https://arxiv.org/abs/2111.13445
代码实现:https://github.com/neuralmagic/deepsparse
论文作者:Eugenia Iofinova, Alexandra Peste, Mark Kurtz, Dan Alistarh
论文简介:Transfer learning is a classic paradigm by which models pretrained on large “upstream” datasets are adapted to yield good results on “downstream” specialized datasets./迁移学习是一种经典范式,通过这种范式,在大型 "上游 "数据集上预训练的模型被调整为在 "下游 "专门数据集上产生良好的结果。
论文摘要:Transfer learning is a classic paradigm by which models pretrained on large “upstream” datasets are adapted to yield good results on “downstream” specialized datasets. Generally, more accurate models on the “upstream” dataset tend to provide better transfer accuracy “downstream”. In this work, we perform an in-depth investigation of this phenomenon in the context of convolutional neural networks (CNNs) trained on the ImageNet dataset, which have been pruned - that is, compressed by sparsifying their connections. We consider transfer using unstructured pruned models obtained by applying several state-of-the-art pruning methods, including magnitude-based, second-order, re-growth, lottery-ticket, and regularization approaches, in the context of twelve standard transfer tasks. In a nutshell, our study shows that sparse models can match or even outperform the transfer performance of dense models, even at high sparsities, and, while doing so, can lead to significant inference and even training speedups. At the same time, we observe and analyze significant differences in the behaviour of different pruning methods.
迁移学习是一个经典的范式,通过对大型 "上游 "数据集的预训练,使模型在 "下游 "专业数据集上产生良好的结果。一般来说,在 "上游 "数据集上更准确的模型往往能在 "下游 "提供更好的迁移精度。在这项工作中,我们在ImageNet数据集上训练的卷积神经网络(CNN)的背景下对这一现象进行了深入调查,这些卷积神经网络已经被修剪过,也就是说,通过疏散连接来压缩模型。我们考虑使用非结构化的修剪模型进行迁移,这些模型是通过应用几种最先进的修剪方法获得的,包括基于量级的、二阶的、再生长的、抽签的和正则化的方法,在12个标准迁移任务的背景下。简而言之,我们的研究表明,稀疏模型可以匹配甚至超越密集模型的迁移性能,即使是在高稀疏度的情况下,而且,在这样做的同时,可以导致显著的推理甚至训练速度的提高。同时,我们观察并分析了不同剪枝方法的行为的显著差异。


我们是 ShowMeAI,致力于传播AI优质内容,分享行业解决方案,用知识加速每一次技术成长!点击查看 历史文章列表,在公众号内订阅话题 #ShowMeAI资讯日报,可接收每日最新推送。点击 专题合辑&电子月刊 快速浏览各专题全集。点击 这里 回复关键字 日报 免费获取AI电子月刊与资料包。


 280


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


