基于 SelectDB 实现 Hive 数据湖统一分析:洋钱罐全球一体化探索分析平台升级实践

Excel 数据分析常用函数汇总 很多传统行业的数据分析师只要求掌握 Excel 即可,会 SPSS / SAS 是加分项。哪怕在数据分析岗位很多的互联网行业,Excel 依旧是不可替代的基础工具。Excel 是数据分析最常用、最基础的工具。大量传统行业(商贸、工厂、门店进销存)的数据分析师,熟练掌握 Excel + SQL 就可以完成绝大多数日常工作。对于初学者,不用一上来就啃 Python、R 这类编程语言,Excel 自带的函数、透视表、可视化插件足够支撑大部分统计、核对、报表需求; 阅读详情

摘要:瓴岳科技原数据平台基于 Hive 与 StarRocks、Spark 多引擎协同架构,随着数据规模增长,在性能与易用性上逐渐面临瓶颈。通过引入阿里云 SelectDB,构建湖仓一体化探索分析平台,在无需迁移数据的前提下实现对 Hive 数据湖的透明加速,显著提升查询性能并简化架构,完成从多引擎协同向统一分析平台的升级。

瓴岳科技是一家以大数据与人工智能为核心的数字科技集团,旗下拥有国内产品洋钱罐与印尼市场产品 Easy Cash,致力于为全球用户提供卓越的金融科技服务。截至 2025 年,公司已服务全球超 114 家金融机构,拥有逾 1.81 亿注册用户,累计交易额突破 5400 亿元。

原数据平台采用 Hive 数据湖与多计算引擎(StarRocks / Spark)协同模式,其中 StarRocks 在部分场景中承担查询加速的能力。随着业务全球化与数据规模的迅猛增长,对查询体验及查询性能提出更高要求,原有架构在易用性、查询性能和扩展性方面逐渐暴露出瓶颈。

  • 平台接入复杂:原有架构在 Hive 之上提供 StarRocks、Spark 等多套计算引擎供业务方按需选用,但不同引擎间 SQL 方言不统一、最佳实践差异大,且查询结果一致性难以保障,导致用户接入使用过程复杂。
  • 查询性能受限:尽管平台已经将跨计算引擎兼容的查询自动路由至 StarRocks 进行加速,但核心探索分析场景下,复杂查询的 P95 响应时间仍高达 300 秒,严重制约数据探索效率与业务决策速度。
  • 数据处理链路维护难:数据导入导出过程依赖独立的物理机资源,需通过额外的数据 ETL 工具,对大量数据进行多轮加工处理,整体链路维护复杂且存在单点故障风险。
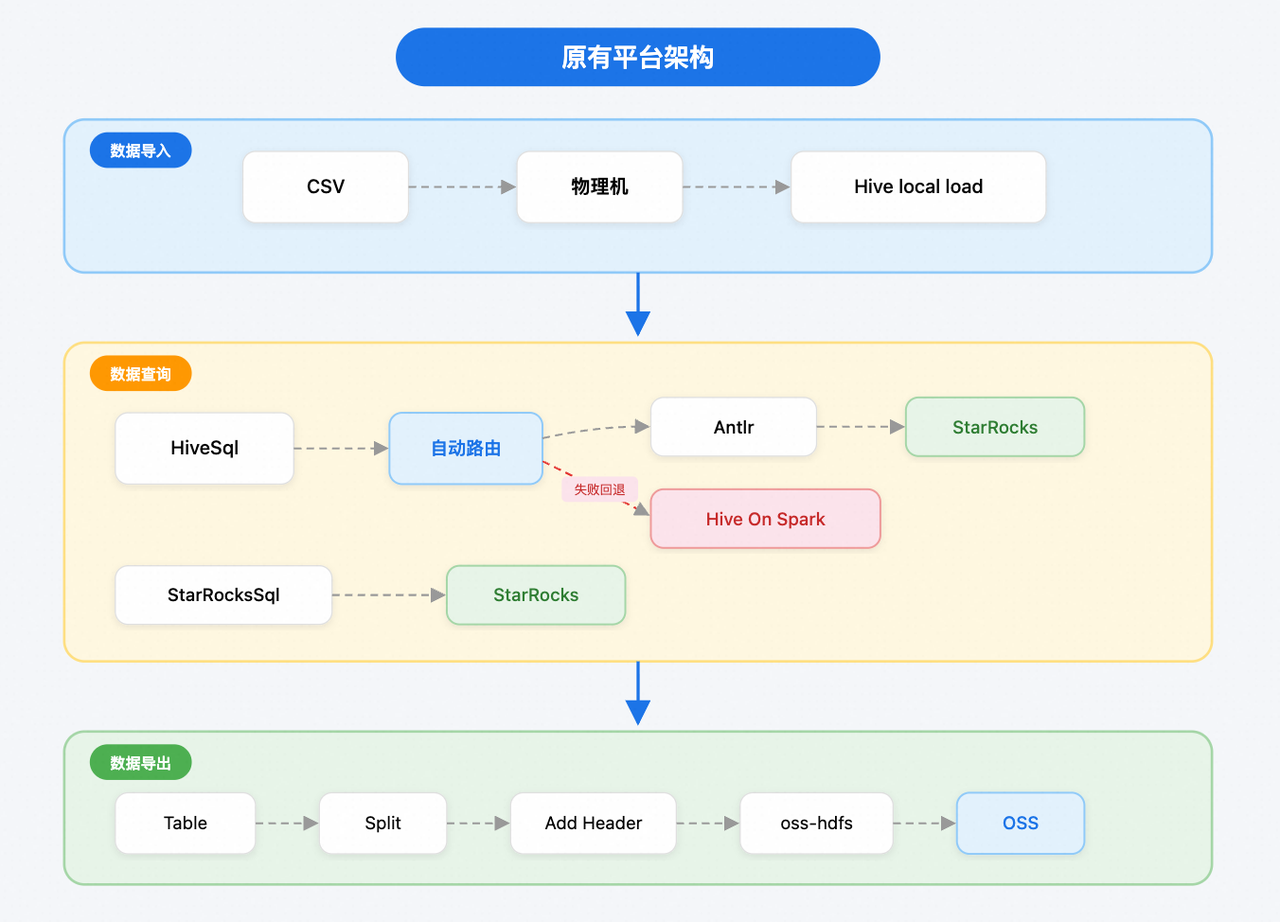
原有架构.PNG

因此,团队目前亟需构建一个能够兼容现有 Hive 生态的统一查询入口(即屏蔽底层多引擎差异,统一以 Hive SQL 作为访问方式),又能提供较 StarRocks 更优的极速查询体验,以支持洋钱罐团队从数据探索到可视化分析的全球一体化探索分析平台演进。

为什么选择阿里云 SelectDB?

2025 年 3 月,在评估多个技术方案后,瓴岳科技团队最终将SelectDB 全新湖仓一体架构确定为核心破局方案。其不仅在查询加速能力上更胜于 StarRocks,更从架构层面实现统一查询入口与数据湖能力的全面释放,提供了面向数据湖的统一分析能力。其核心能力主要体现在:

  • Hive 透明加速能力:SelectDB 通过 Hive Catalog 直接对接 Hive 数据湖,无需任何数据迁移;同时高度兼容 Hive SQL 方言,查询结果与原引擎保持一致。使平台在不改变数据存储形态的前提下实现统一查询入口与业务无感切换,从而实现数据不动、查询升级。
  • 极致查询性能:基于对 Hive 的高度兼容性,更多业务查询可无缝路由至高性能的 SelectDB 计算引擎。在无需额外数据导入的前提下,相较原有 StarRocks 架构进一步释放查询性能,支撑高频交互式分析场景,平台整体查询效率可实现大幅提升。
  • 湖仓一体与存算分离:云原生存算分离架构与湖仓数据互通能力,使数据持续沉淀于 Hive,而计算统一收敛至 SelectDB,形成统一的湖仓分析架构,既能灵活应对业务峰谷,也显著降低数据链路复杂度与运维成本。

基于以上优势,团队正式立项引入 SelectDB。在落地过程中,为确保平滑过渡,我们构建了完整的线上 SQL 回放与结果一致性验证体系,并与 SelectDB 技术团队紧密协作,针对 Hive Catalog 的查询性能与兼容性进行了深度优化。历经两个月开发与两周灰度测试,新平台已在国内和印尼两地全面上线。

阿里云数据库 SelectDB 植根于开源 Apache Doris 的坚实基础,深度融合云随需而用的特性,依托阿里云基础设施,构建起云原生存算分离的全新架构,面向企业海量数据的实时分析需求,提供极速实时、湖仓融合统一、简单易用的云上数仓服务。阿里云 selectdb 的链接:https://www.aliyun.com/product/selectdb?utm_content=g_1000410296

基于 SelectDB 全新探索分析平台

新平台的核心是基于 SelectDB 云服务搭建的存算分离架构。计算层由 SelectDB 替换原有 StarRocks,作为统一的高性能查询引擎,存储层则继续沿用 Hive。通过 SelectDB 的 Hive Catalog 功能,实现了对 Hive 数据的“所见即所得”查询,无需复杂的数据同步。
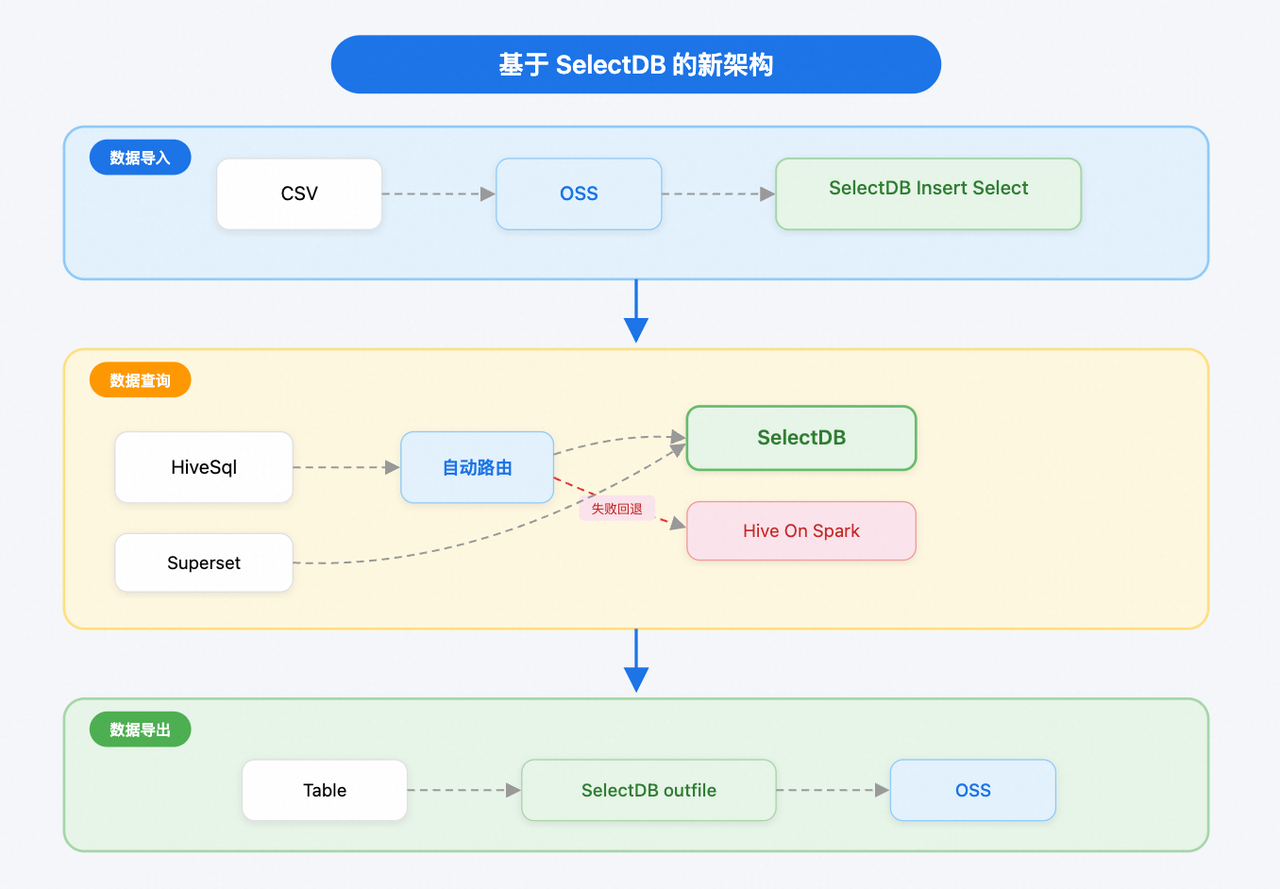
基于 SelectDB 全新探索分析平台.PNG

新平台架构清晰覆盖数据全生命周期,具体可分为以下三层:

  • 数据导入:优化 CSV 导入流程,从依赖物理机与 Hive 命令的复杂链路,转变为数据直传对象存储(OSS),由 SelectDB 通过 INSERT INTO SELECT 方式高效写入 Hive,实现服务与物理机解耦,并支持 K8s 弹性伸缩。
  • 数据查询:统一查询语言为 Hive SQL,并构建智能自动路由策略。路由基于函数兼容性判断、集群负载情况及表扫描量(超过 5TB 则保护性回退)三个核心策略,使查询路由比例从 60%提升至 95%,是探索分析整体性能提升的关键。
  • 数据导出:利用 SelectDB 的 OUTFILE 功能,将原先需要创建临时表、手动拆分文件、补全文件头等多步复杂操作,简化为一步到位的导出指令,导出 P95 时间从 300 秒优化至 20 秒。

总而言之,该架构下无需数据迁移即实现资源的弹性伸缩,且数据只在 Hive 中存储一份,省掉耗时且冗余的数据同步过程,极大简化了数据流转链路。目前,SelectDB 集群计算资源超 1000 Core,缓存数据量超 100 TB,日均查询量超 500 万次,P95 响应时间相比之前的 StarRocks 降低 90%+ 至 20 秒。

该方案提供了一种面向 Hive 数据湖的统一分析平台升级路径,可为具备类似数据架构的企业提供参考借鉴。尤其适用于已构建 Hive 数据湖、存在多引擎协同且平台复杂度较高,并面临数据规模持续增长的数据团队,具备良好的通用性与可复制性。

核心实践及优化经验

01 Hive 方言兼容:实现平滑迁移与高效查询

为确保用户无需改变查询习惯,平滑无感迁移至 SelectDB,我们在 Hive 方言兼容性上实施了一套完整方案。

关键措施

在 Hive 方言兼容性方面,我们采取了多项措施,实现了 98% 的 Hive 方言兼容性,为业务无感迁移奠定了基础。

  • 函数回测:建立了包含 100+ 个核心用例的回测框架,可在 5 分钟内完成全量运行。该框架确保了开发流程的质量:任何对 SelectDB 修改都需通过修改前后的回测对比,保证每次迭代都正向演进。
  • Hive UDF 验证:针对数十个关键业务 UDF,进行了集中的注册兼容性测试与结果验证。结果表明,绝大多数 UDF 可无缝迁移,仅少数涉及 Bitmap 函数或动态参数等高级特性的 UDF 尚待支持。
  • 线上 SQL 回放:建立了自动化流程,每天回放前一天的线上 SQL,对比 SelectDB 与 Hive 的执行结果。任何不一致案例都会与 SelectDB 技术团队协同分析解决,提前化解潜在的数据差异风险。
  • 标准数据集性能验证:基于线上数千条 SQL 的统计,构建了包含 20 个标准数据集,通过多轮性能验证。最终结果显示,其中约 12 个数据集的性能超越了 StarRocks,并符合上线标准。
底层实现逻辑

SelectDB 通过sql_dialect与serde_dialect核心参数控制方言转换。流程如下:

  1. SQL 语句通过SQL dialect发送到sqloglot(一款开源 SQL 转换器)进行方言改写。
  2. 改写后的 SQL 会被传送至 SelectDB 的 nereids 进行语法解析。
  3. 解析器生成逻辑计划,经优化器转化为物理执行计划,分发至各后端节点(BE)执行。
  4. 最终,serde_dialect参数控制结果集的展示格式(如小数位数、布尔值形式等),确保输出符合预期。

通过这两个参数,SelectDB 实现了完整的方案转换逻辑,确保了查询的兼容性和执行效率。
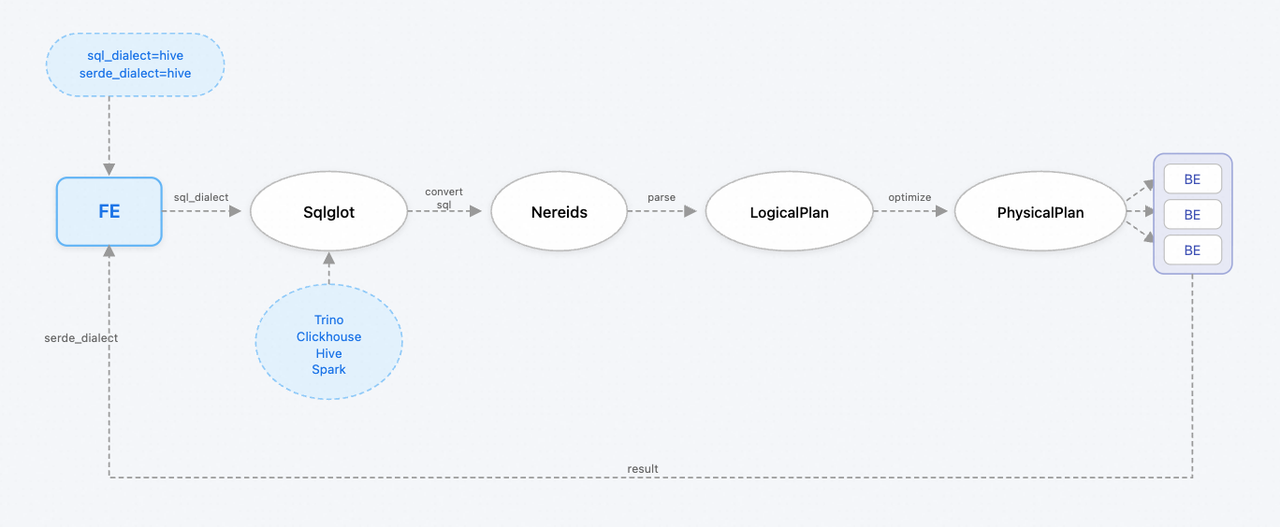
底层实现逻辑.png

02 智能查询路由:兼顾性能与稳定

  1. 在统一入口下,我们设计了三层智能路由策略,在提升性能的同时保障集群稳定:

  2. 兼容性判断:优先判断 SQL 中使用的函数或语法是否被 SelectDB 支持。得益于 98%的兼容率,绝大多数查询可直达 SelectDB。不兼容时将进行回退至 Hive on Spark。

  3. 资源监控:实时感知 SelectDB 集群负载。在集群繁忙时,将查询自动回退,避免过载。

  4. 过载保护:当单表扫描量预估超过 5TB 时,查询将被回退,以保障 SelectDB 集群资源稳定运行。

这些回退策略将在查询日志中明确记录,用户可据此判断当前的集群资源状态或识别不兼容的函数,并进行相应的修改。

通过以上策略的实施,自动路由的上线使我们的路由比例从原先的 60% 提升至 95%。
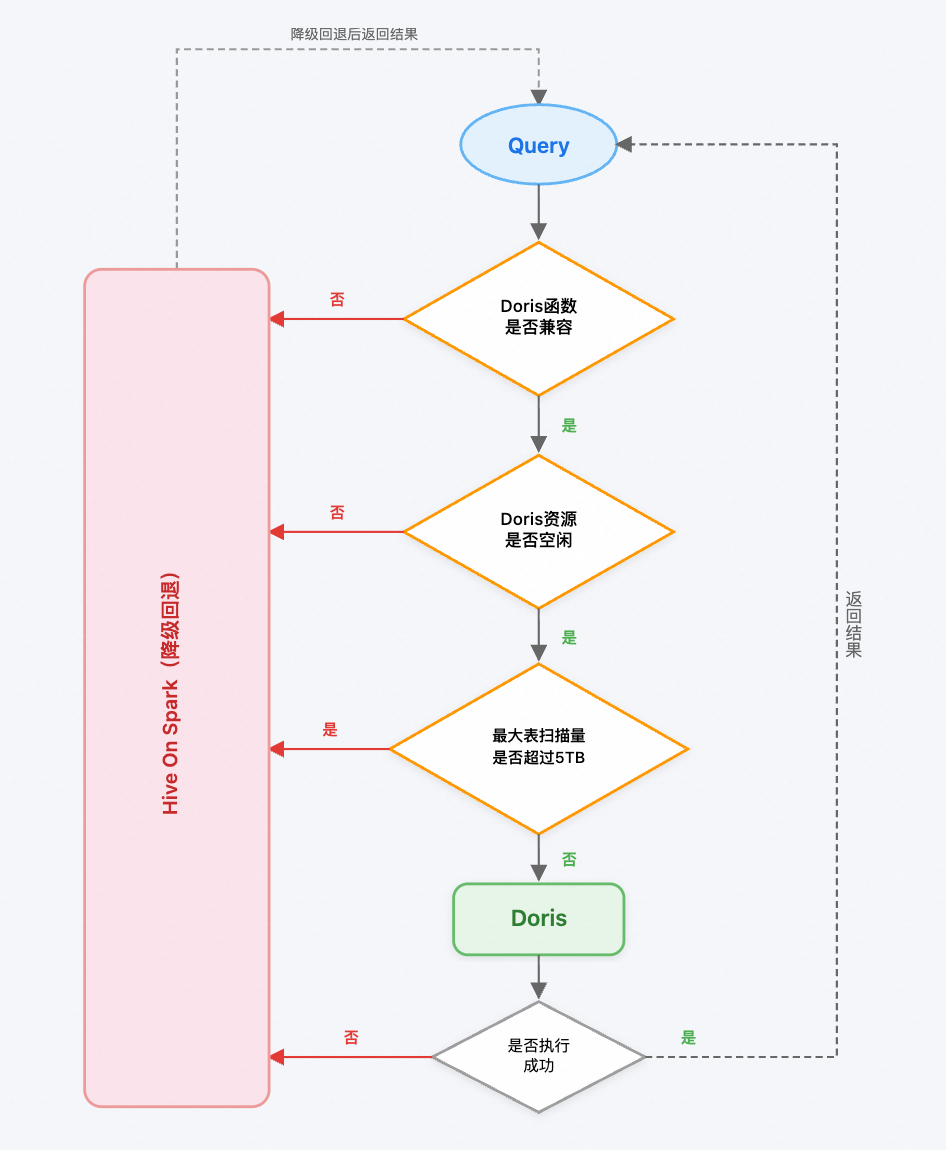
02  智能查询路由:兼顾性能与稳定.png

03 Hive 数据加速,查询性能数量级提升

在 SelectDB on Hive 架构下,我们通过多层缓存机制实现了查询性能的数量级提升,核心场景查询从分钟级缩短至秒级。

缓存机制与配置

目前,集群缓存总容量超过 100TB,命中率长期保持在 90% 以上,这意味着大多数场景都能有效利用缓存资源。而关键配置在于 Hive Catalog 的精细化缓存控制:通过设置不同的 TTL,我们平衡了数据新鲜度与缓存效率。用户也可通过REFRESH命令主动刷新缓存。

CREATE CATALOG hive_catalog PROPERTIES (
    "type" = "hms",
    "schema.cache.ttl-second" = "60",
    "partition.cache.ttl-second" = "0",
    "hive.metastore.uris" = "thrift://127.0.0.1:9083",
    "get_schema_from_table" = "true",
    "file.meta.cache.ttl-second" = "0"
);

以 LDFI 数据为例,我们首先将 Parquet 文件拆分为多个块(Block)。查询时,系统首先在本地磁盘的 LRU 缓存中寻找这些数据块。若命中,则直接返回;若未命中,则从 HDFS 读取,并在查询完成后异步缓存至本地 LRU,供后续使用。
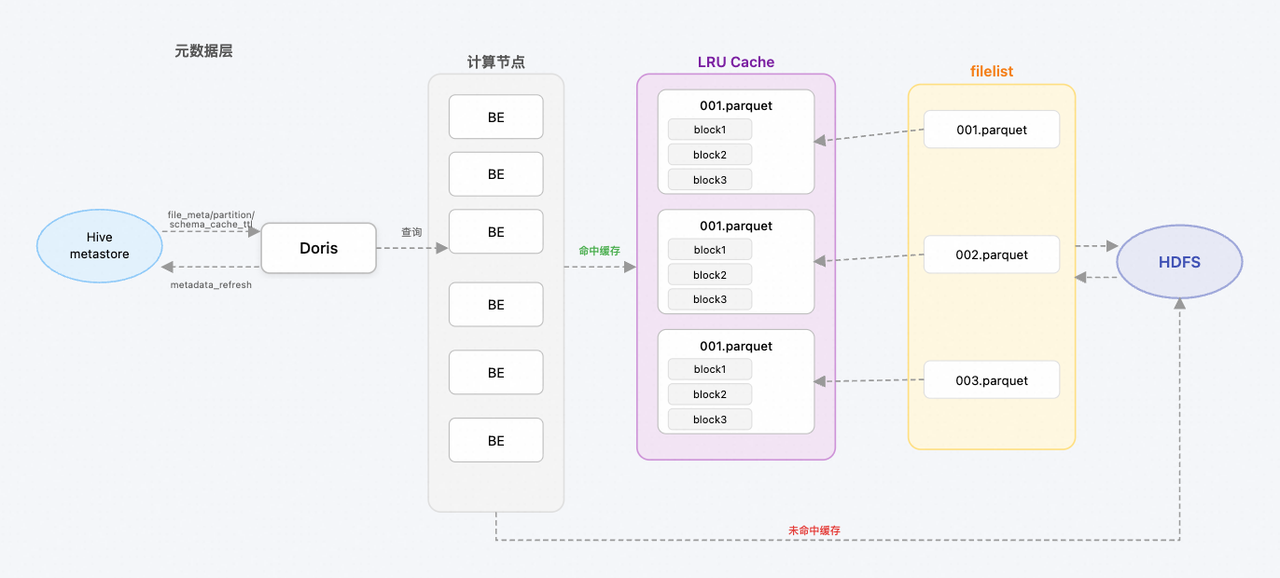
03 Hive 数据加速,查询性能数量级提升.png

04 全链路优化提速

除此之外,SelectDB 的引入使文件上传、数据导出、DQC 等方面的性能都得到巨大的性能提升,具体来看:

  • 在数据导入方面:SelectDB 通过 INSERT INTO hive_table SELECT * FROM OSS_FILE 命令,可将 CSV 经 OSS 直接高效写入 Hive 表,导入 P95 时间从 200 秒优化至 30 秒。
  • 在数据导出方面,利用 SelectDB 原生的OUTFILE功能,将此前繁琐的导出流程(涉及创建临时表、手动拆分文件、补全表头等)简化为一步指令,使导出P95 时间从 300 秒降至 20 秒。
  • 在数据质量检查上(DQC)上,SelectDB on Hive 通过任务分组与并发控制,高效调度大量校验任务,使 DQC 任务执行 P95 时间从原来的 2600 秒(约 43 分钟)骤降至 25 秒,提升超百倍。同时,为避免超大校验任务挤占集群资源,设计了降级方案,可自动切换至 Spark 引擎。

结束语

通过引入阿里云 SelectDB 构建新一代探索分析平台,不仅实现了性能的显著提升,更完成了从“多引擎协同 + 查询加速”到“湖仓一体 + 统一分析平台”的关键演进。成功构建了一个兼容现有生态、查询极速、体验流畅的全球一体化探索分析平台。未来,瓴岳科技将会进一步探索 SelectDB 的能力:

  • 应用异步物化视图:
    • 面向报表与看板场景,提供开箱即用的数据集加速能力,极大提升查询性能。
    • 依托 SelectDB 内置智能调度引擎,实现增量数据的自动化、定时化更新,保障数据时效性。
    • 支持自动查询路由,用户查询无需改写即可命中最优物化视图,实现透明加速。
  • 推行 Serverless:
    • 通过 Serverless 产品形态,实时应对业务流量潮汐,实现资源秒级按需分配,显著降低成本。
    • 面向高优先级批处理任务,通过自动资源扩容,保障大数据量作业稳定高效完成,提升平台 SLA。
  • 探索 AI 应用:
    • 在 ChatBI 场景探索向量混合检索,增强自然语言交互的数据探索能力与智能水平。
    • 在 Data Agent 领域集成 SelectDB MCP,打造基于统一数据服务的智能体生态,赋能自动化分析与决策。
每天10分钟,混剪视频Agent产出50条爆款,单月变现6位数(喂饭级教程) 混剪视频是指将多个视频片段、图片或音频素材进行剪辑组合,创造出新的视频内容。随着Coze上线联动剪映功能,混剪视频制作正在进入自动化时代,为创作者带来巨大便利。高效自动化处理:AI可以自动完成琐碎的剪辑工作,让创作者省下大量时间专注于项目策划和创意。批量素材产出:特别适用于抖音、小红书和视频号等平台上的养生、科普、心理、疗愈等垂直领域,可以自动化批量生产图片和视频素材。引流获客:通过优质内容吸引目标受众知识变现:通过教学传授技术工具变现:将搭建好的工作流作为产品销售。 阅读详情

相关推荐

基于java的汉服商城管理系统设计与实现的详细项目实例

本文介绍了一个基于Java的汉服商城管理系统设计与实现项目。该项目采用三层架构设计,包含用户模块、商品管理、订单处理、支付结算等核心功能,支持多角色权限控制和响应式前端界面。 系统创新点包括: 专业化的汉服商品管理,支持多规格属性组合 高并发订单处理机制,确保库存实时同步 个性化智能推荐算法提升用户体验 细粒度权限控制保障系统安全 项目采用SpringBoot+MyBatis技术栈,前端使用React框架实现跨设备兼容。数据库设计包含用户表、商品表、订单表等10个核心表,通过事务管理确保数据一致性。 系统解

优质创作者: 人工智能技术领域 对于有一定基础的 MATLAB和Python带具体需求都可以详谈 MATLAB和Python可以提供代码调试服务加油 谢谢 你的鼓励是我前行的动力 谢谢支持 加油 谢谢 804

瓴岳科技洋钱罐 SelectDB Hive 透明加速:湖仓一体化探索分析平台升级实践

通过 Hive Catalog 直接对接 Hive 数据湖,无需数据迁移,并对 Hive SQL 方言高度兼容。

SelectDB 281

Altium Designer实战:手把手教你设计智能车竞赛疯狂电路组赛道(附封装库)

本文详细介绍了使用Altium Designer软件进行智能车竞赛“疯狂电路”组赛道设计的全流程实战指南。从理解比赛规则、搭建设计环境、创建专用元器件封装库,到电路布局、路径规划及设计输出验证,手把手教你高效完成符合计分标准的赛道图纸设计,并附上实用的封装库管理方法。

alice7model的博客 1321

MariaDB远程运维教程:Debian安装、Prometheus监控与公网连接

本文分享在Debian 12上部署MariaDB并配置Prometheus监控的实践:通过添加官方APT源安装MariaDB,安全初始化后,使用mysqld_exporter采集性能指标,实现对数据库连接、资源与运行状态的实时监控。重点解决远程故障排查时的访问延迟问题,提前建立稳定监控与远程接入能力,提升运维效率。

2401_84813926的博客 1万+

HMC5883L磁力计在STM32F4上的I2C驱动与数据校准实战

本文详细介绍了HMC5883L磁力计在STM32F4平台上的I2C驱动开发与数据校准实战。通过解析寄存器配置、数据读取处理和椭圆拟合校准算法,帮助开发者实现精准的地磁测量,特别适用于无人机导航和机器人系统中的航向确定与陀螺仪漂移修正。

2y3u4i5o6p的博客 1037

一人公司 CEO × Accio Work:最大能效实战指南

作为一人公司 CEO,你需要同时扮演市场、销售、运营、财务、产品等多个角色。Accio Work 本质上就是你的。

华盛AI的博客 2096

【大数据处理与分析】数据仓库Hive:09 Hive 编程实践

本文介绍Hive的数据类型(基本类型与ARRAY、MAP、STRUCT集合类型)和基本操作,并通过WordCount实例说明Hive编程比MapReduce更简洁易用。

Morse_Chen的博客 238

某头部金融APP防护机制逆向实录:从反调试到TEE加密的全链路攻防拆解

金融APP安全防护体系深度破解分析 本文详细拆解了某头部金融APP的三重防御机制破解过程。首先通过Frida绕过反调试技术,包括ptrace自我绑定、TracerPid检测和debuggerd监控;随后针对12种Root检测方法(如su文件检查、Magisk检测等)进行环境伪装,通过Hook系统调用伪造安全环境;最后逆向分析TEE加密模块,解密关键接口参数。整个破解过程涉及静态分析、动态调试和代码注入技术,揭示了金融级APP安全防护的实现原理与突破方法(注:所有操作均获授权,仅用于安全研究)。

专注于Python爬虫开发,分享爬虫技巧、项目实战与反爬经验,使用Scrapy、BeautifulSoup等工具,解决数据抓取难题。 1399

私有化云手机部署平台|六边云支持内网 ADB、自定义镜像、弹性扩缩容

自动化测试最头疼的就是环境漂移:A 机装了证书、框架、业务包,B 机是纯净原版,测试结果不可复现。自定义镜像能力就是用来解决这个问题。启动一台基础云手机实例;配置系统参数、安装证书、推送基础 APK、配置代理、导入脚本;在控制台执行镜像快照,保存到内部镜像仓库;新建实例时直接选择该镜像,批量拉起一批环境完全一致的安卓节点。维护多套镜像基线:纯净测试镜像、带自动化框架镜像、业务预安装镜像;镜像版本管理,记录变更日志,可以回滚到上一个稳定版本;

a598652的博客 336

Cadence PSpice 仿真6:反向放大器傅里叶仿真(FFT,谐波分析)实战图文教程

总谐波失真(THD)指音频信号源通过功率放大器时,由于非线性元件所引起的输出信号比输入信号多出的额外谐波成分。比如理想运放输出为5V 1Khz的正玄波时,实际输出的信号按照傅里叶展开后不但含有5V 1KHZ的分量,还有1V 2KHZ的分量,那么多出来的1V的分量就是二次谐波,二次谐波失真系数就是20%,由于任意1个波形按照傅里叶展开是可以展开到n次的,所以除了二次谐波外,输出的信号还有3,4,5……n次谐波,随着n的变大谐波的分量会变小,总谐波失真系数就是所有谐波分量和1次谐波(基波)的比值。Cadence

fydar的博客 4956

股票价格预测的秘密武器:用C#实现蒙特卡洛路径模拟,轻松掌握市场波动规律!

摘要: 蒙特卡洛模拟是股票预测的有效工具,通过随机抽样模拟价格路径,克服传统技术分析的局限性。其核心模型是几何布朗运动(GBM),描述股价随机变化过程。C#实现的关键步骤包括:1)获取输入参数;2)生成随机数路径;3)分析结果。该方法不预测具体价格,而是提供可能的价格范围,帮助投资者评估风险。代码结构清晰,分为输入、模拟、分析和可视化四个模块,通过参数封装提高可读性,适用于不确定市场的概率预测。

墨夶的博客 601

【计算机毕业设计】基于Hadoop的公共交通运营数据分析与可视化系统 大数据毕业设计选题 Hadoop Spark Numpy Pandas Echarts

基于Hadoop生态的公共交通运营数据分析与可视化系统,利用Spark处理海量公交数据,结合K-Means聚类、Pandas/Numpy分析,实现线路、站点、区段等多维度统计。通过Django提供接口,Vue+ElementUI搭建前端,Echarts实现城市规模、线路特征、站点网络等动态可视化看板,构建从数据采集到可视化的完整闭环,助力智慧交通决策。支持机器学习模型定制,文末可获取源码。

weixin_19164791635 763

TensorFlow2深度学习实战(十四):目标检测算法 YOLOv4 解析

最易上手的【计算机视觉】小白教程!

不积跬步,无以至千里! 7635

用 Excel 完成数据分析,一套可上手实操流程

很多初学数据分析的人会陷入一个误区:把 Excel 数据分析等同于背诵、嵌套各种函数,觉得不会几十条函数,就做不了数据分析。但在商贸、门店、工厂这类传统行业的日常工作里,大量的数据工作其实不靠复杂公式,依靠 Excel 的自带功能:规范表格结构、Power Query 批量清洗、数据透视表汇总、切片器联动、条件格式预警、图表可视化,就能独立完成从杂乱原始台账,到一份可以交给领导复盘的分析报表。对于想要应聘进销存、运营数据岗的人来说,这一套能力甚至比会写复杂嵌套函数更加常用。

qq_22201881的博客 242

OV9734 DATASHEET,完整规格书

OV9734完整规格书,包括电气参数,尺寸规格,寄存器配置表等

IMSL CNL 7.0.0 (x86-64)Crack

IMSL CNL 7.0.0 (x86-64)Crack intel的算法库破解文件,这是C++版本的破解文件

大专商务数据分析与应用考哪些证书难度相对低?

对大专商务数据分析与应用专业的学生来说,选证书不能只看“好不好考”,还要看考试内容能否转化为实习中的具体能力:能不能整理销售明细、核对经营数据、制作分析报表,以及解释业务变化的原因。结合专业课程和常见就业方向,可以重点考虑这四类证书。其中,办公软件类更适合作为入门选择;分析类更贴近专业发展;会计类适合准备进入财务、零售经营和电商结算相关岗位的学生。

2501_93367079的博客 244

汉书HE8,好用的汇编代码编写工具

汉书HE8,好用的汇编代码编写工具早期编写汇编代码所用功能强大

基于 Python 的汽车市场数据分析与可视化平台

本平台是一个基于 Python Flask 框架的汽车市场数据分析与可视化系统,整合了多个真实汽车市场数据集,提供数据概览、车辆检索、多维分析、价格预测、品牌对比、技术规格分析、销量统计等功能模块,适用于汽车市场趋势研究和二手车价格预测场景。所有数据源的价格在导入时已按汇率统一转换为人民币(CNY),确保跨数据集价格可比。

aiyuanma_vip的博客 308

基于springboot+vue+uniapp的羽毛球预约小程序(Websocket智能沟通、Echarts数据分析、会员闭环管理、灵活运营规则、全流程预约)

本系统基于B/S架构,采用前后端分离设计,集成微信小程序与管理后台,实现多角色权限管控。核心亮点包括:全流程可视化预约、灵活运营规则配置、会员闭环管理(含余额、充值、退款)、ECharts多维度数据分析及WebSocket智能客服。支持语音、图片沟通,提升服务效率。系统覆盖用户、工作人员、管理员全链路功能,实现场馆资源高效管理与用户体验优化。

paopaokaka_luck的博客 225

visium数据分析范例--解码调控胶质母细胞瘤可塑性的基因调控程序

visium数据分析范例--解码调控胶质母细胞瘤可塑性的基因调控程序

weixin_53637133的博客 177

零售交易与行为数据分析:指标口径、客群留存建模与增量验证实践

在零售消费领域的数据分析中,单纯依赖当期销量容易掩盖退货损耗与客群质量差异。本文围绕可复用的数据分析方法,系统阐述零售交易口径规范、订单退款处理机制、商品与客户多对象关联建模、分批留存观察窗口设计,以及 RFM 交易基线与行为信号的互补应用,并深入剖析算法预测概率与 A/B 实验增量(Uplift)的统计边界。

shujudang的博客 318

多工作区数据分析应用的 DuckDB 连接隔离:每工作区独立连接、同工作区单流串行

第一步是把"一个工作区的一套连接资产"收进一个结构体,而不是散落在全局状态里。daw 的做法叫/// DuckDB 内存会话;DuckLake 是该工作区视图/表的唯一持久层/// 该连接的查询超时中断句柄/// 该工作区的绝对路径(~/.daw/<工作区>),供内省与后续落盘钩子/// 单流标志:同一工作区同一时刻只允许一个数据分析任务用这个连接翻译成人话:连接本体、中断手柄、归属路径、忙闲标志,打包成一份"工作区连接档案"。conn外面套。

遇码开源社区 491

商务数据分析与应用专业哪些证书企业比较认可?

商务数据分析与应用专业的学生,选择证书时经常面临一个问题:是先证明办公软件操作能力,还是直接学习商业分析、数据库和数据建模?答案需要从目标岗位出发。经营分析、数据运营、商业智能等岗位虽然都与数据有关,对技能的侧重点却有所不同。面向2027年的实习、求职与学习规划,可以重点考察四类证书:全国计算机等级考试证书、Microsoft Office Specialist、CDA数据分析师,以及微软Power BI数据分析师助理认证。

kaiyou2026的博客 192

数据分析岗 Pandas 面试题 20 道(下):手写代码题

概念题能背,手写题才是分水岭。这篇给 10 道高频手写题:每组取 TopN、连续登录天数、找出重复记录、宽表⇄长表、缺失值按组填、按条件分组统计、两表对比差异、环比计算、分箱统计、一行代码做透视;每题都有题目、考察点、答案和可跑验证。 标签:Python、Pandas、面试题、数据分析、数据处理

2201_76128658的博客 318

京东商品采集+数据分析:Python爬虫遇到滑块怎么办!

京东的列表接口和页面结构随时可能改版,参数还可能带当次签名,我不能凭印象给你编一个域名或者 sign 算法,脚本里接口地址干脆留空,自己打开浏览器 Network 面板复制当次请求的地址和参数填进去,选择器同理从 Elements 面板复制。下面就可以接数据分析了。这是个右偏的长尾分布,只报一个均价很容易把人带偏,这是一个比较简单的实例应用。可以看到,正常页面返回 False,验证页和 403 都返回 True,退避序列按 2 秒、4 秒、8 秒往上走,四条样例数据也解析对了,这是一个比较简单的实例应用。

Z_suger7的博客 516

AI驱动技术性股市数据分析

2026年沪深A股市场中,“机构费率更低”已失效,个人新开户佣金低至万0.691–1.0,低于部分量化私募与公募分仓佣金。真正决定成本的是交易频率与综合冲击成本,单笔显性成本仅差几十元,但高频交易下滑点与门槛拖累显著放大。AI工具使用率虽达40%–50%,但深度采纳不足15%,直接下单者仅5.5%。所谓“准确率90%+”多为口径错位,真实可交易胜率仅50%–58%。测算显示,单轮成本超32bp时,即便58%准确率也无法盈亏平衡——成本先于能力决定结果。

一只懂代码不懂人情世故的源码爱好猿 417

企业智能数据分析平台落地实践:语义层、行为分析引擎与 AI 边界认知

自然语言问数工具降低了数据消费的交互门槛,但在面对用户时序行为分析、跨团队语义一致性和分析到运营的连贯执行时,这类工具有其客观的适用边界。本文从工程实践角度梳理企业级智能数据分析平台的关键技术维度,以及 AI 在分析链路中的合理定位。

shujudang的博客 293

Python 爬取前程无忧最新招聘数据 matplotlib数据分析与可视化

最近有个需求,想看看这段时间 Python 相关的岗位到底都在招什么、给到多少钱、集中在哪几个城市,简单来说就是把招聘列表上公开的岗位信息抓下来存成一张表,再用 matplotlib 画几张图看看分布,给到的方案是 Python 加 requests 加 pandas 加 matplotlib 这一套,但我之前没怎么接触过这块的采集,参数怎么带、字段怎么对、被限流了怎么办,完全没有头绪,就想着在本机跑一遍,把过程记下来,省得下次又从头翻一遍,接下来就先开始环境的安装。2、出口 IP 得换一下。

Z_suger7的博客 268

数据分析AI Agent怎么选?四层能力评估框架详解

数据分析 AI Agent 的选型难点,是链路闭环。把“数据接入、分析推理、行动闭环、治理部署”四层拆开评估,等于把一句模糊的“这个产品很强”翻译成四个可验证的问题。市场还在快速扩张,产品之间的真实差距会随着场景深入而拉开;用统一框架逐层打钩,比看演示、听口碑都更可靠。能接得住数据、讲得清结论、落得了动作、管得住风险,才是真正值得进入生产环境的数据分析 AI Agent。

效率工作研究中心 133
上一篇: AI 成为主流负载后,数据基础设施将如何演进?|Apache Doris 2026 Roadmap
下一篇: SelectDB Enterprise 4.0.5:强化安全与治理,构建企业级实时分析与 AI 数据底座
SelectDB技术团队
博客等级 码龄4年 2119粉丝 484原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包

打赏作者

SelectDB技术团队

你的鼓励将是我创作的最大动力

¥1 ¥2 ¥4 ¥6 ¥10 ¥20
扫码支付:¥1
获取中
扫码支付

您的余额不足,请更换扫码支付或充值

打赏作者

实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值