从 Elasticsearch 到 Apache Doris 腾讯音乐内容库升级,统一搜索分析引擎,成本直降 80%

腾讯音乐开源的SuperSonic到底强在哪?手把手教你配置专属数据分析Agent 本文深度解析腾讯音乐开源的SuperSonic平台,展示其如何通过AI+BI技术打造智能数据问答Agent。重点介绍其独特的语义层与Agent协同架构,并提供电商流量分析Agent的配置实战指南,帮助用户快速部署专属数据分析工具,提升决策效率。 阅读详情

导读: 为满足更严苛数据分析的需求,腾讯音乐内容库借助 Apache Doris 替代了 Elasticsearch 集群,统一了内容库数据平台的内容搜索和分析引擎。并基于 Doris 倒排索引和全文检索的能力,支持了复杂的自定义标签计算,实现秒级查询响应需求。此外,实现写入性能提升 4 倍、使用成本节省达 80% 的显著成效。相关文章:#腾讯音乐案例 、#Elasticsearch 到 Apache Doris 案例、#日志场景案例

作者|腾讯音乐内容信息平台部,张俊、罗雷、李继蓬、代凯

基于公司丰富的音乐内容资产,将歌曲库、艺人资讯、专辑信息、厂牌信息等大量数据统一存储,形成音乐内容库数据平台,该平台旨在为应用层提供库存盘点、分群画像、指标分析、标签圈选等内容分析服务,高效为业务赋能。

内容库数据平台的数据架构已经从 1.0 版本演进到了 4.0 版本。之前的文章介绍了分析引擎 从 ClickHouse 到 Apache Doris 升级实践。本文将重点分享内容搜索引擎从 Elasticsearch 到 Apache Doris 的替换,如何通过一个系统同时满足内容搜索和数据分析的需求,并满足复杂的自定义标签计算的支持。最终,实现存储成本降低 80%,写入性能提升 4 倍的显著效益。

业务需求

从业务角度来看,腾讯音乐有两个场景需要搜索能力的支持,分别是内容库的百科搜索及内容库的标签圈选。

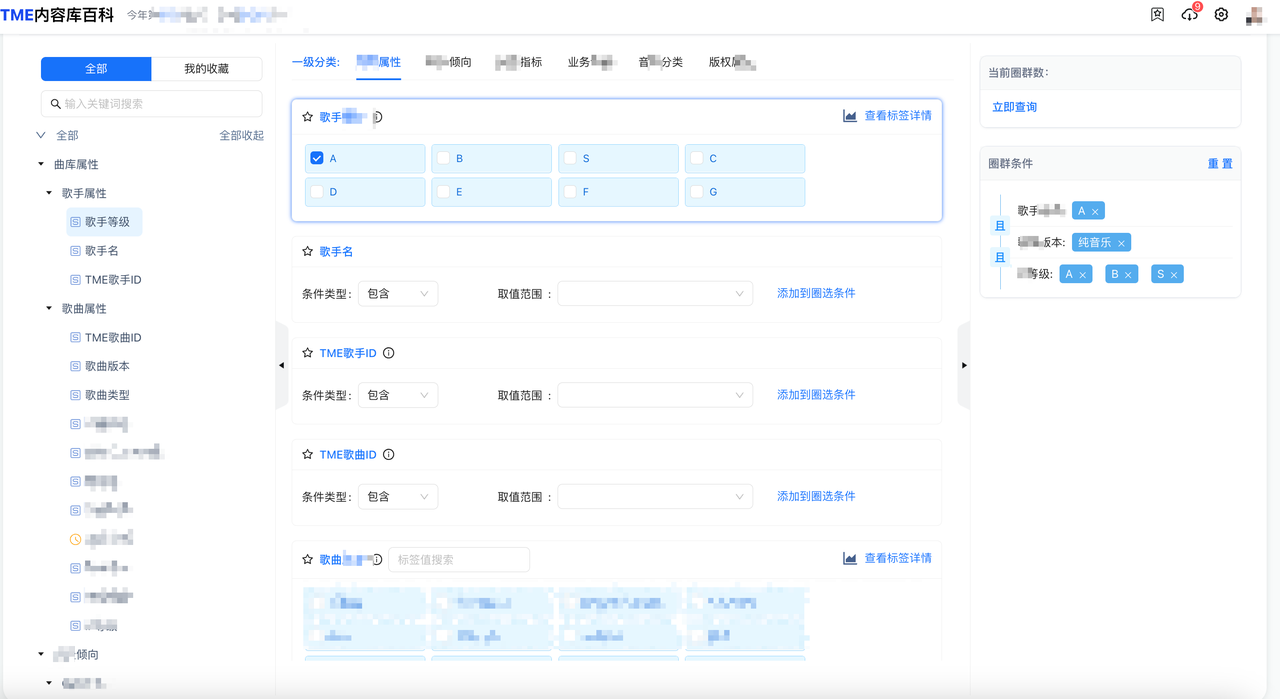
  • 内容库百科搜索: 分析师和运营人员需要快速查找歌手、歌曲名称以及其他文本信息。这种检索能力不仅要求高效的全文搜索,还需支持多种查询条件,以便用户能够迅速获取所需数据,提升工作效率。
  • 内容库标签圈选: 分析师和运营人员会根据特定的标签和条件,筛选出符合要求的内容。这要求系统能够在亿级数据量的情况下,提供秒级的查询响应,以便快速定位和分析相关数据,支持业务决策和策略优化。
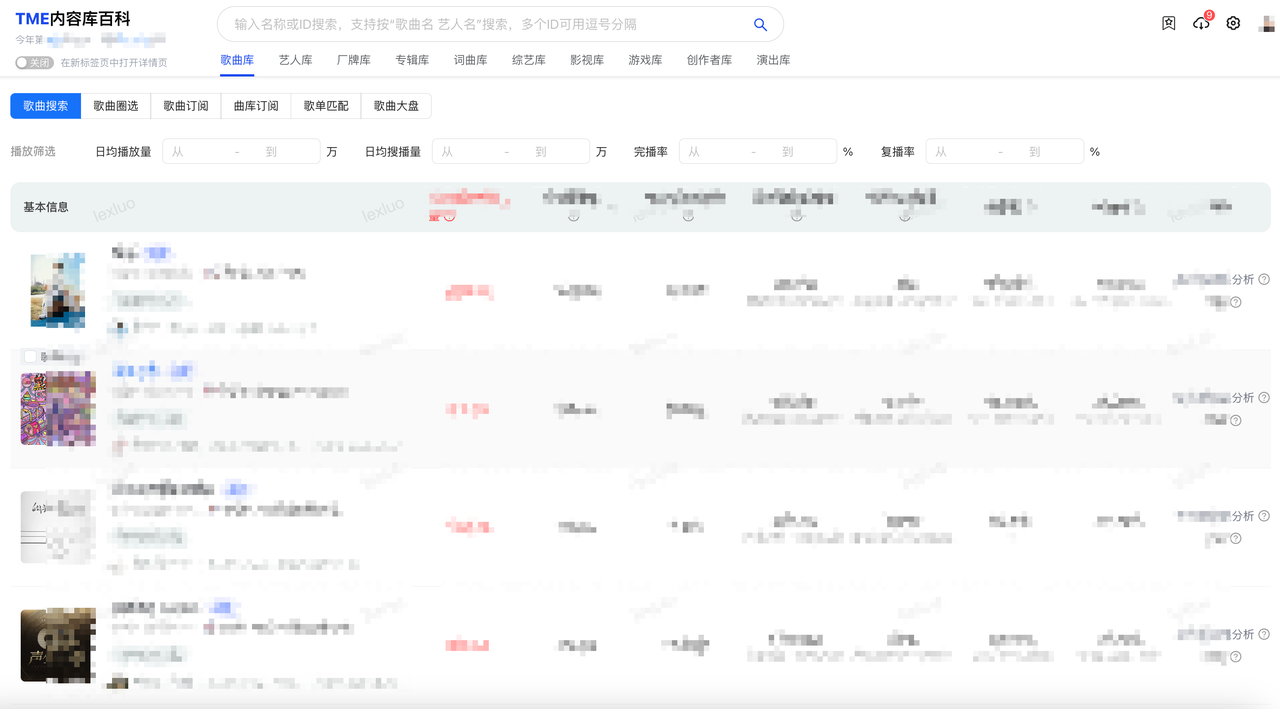
业务需求-内容库百度搜索.PNG

业务需求-内容库-标签圈选.PNG

Elasticsearch + Doris 混合架构

在 2.0 版本之前,Doris 暂未推出倒排索引能力,检索能力相对较弱。而 Elasticsearch 在全文检索方面具备优势,能够基于倒排索引快速匹配特定关键词或短语、可对所有字段建立索引,在查询时支持任意组合的过滤条件等。

但是,Elasticsearch 聚合统计分析性能较差,不支持 JOIN 等复杂查询,且存储空间占用较高。这些正是 Apache Doris 所擅长的领域,能够高效处理复杂的统计分析和查询任务,并通过高压缩率优化存储效率。

因此,腾讯音乐构建基于 Elasticsearch 与 Doris 的混合架构,Elasticsearch 负责内容的全文检索和标签圈选,而 Apache Doris 专注于 OLAP 分析。借助 Doris 的 ES catalog 外表查询机制,能够直接查询 Elasticsearch 中数据,实现对外查询接口的统一。
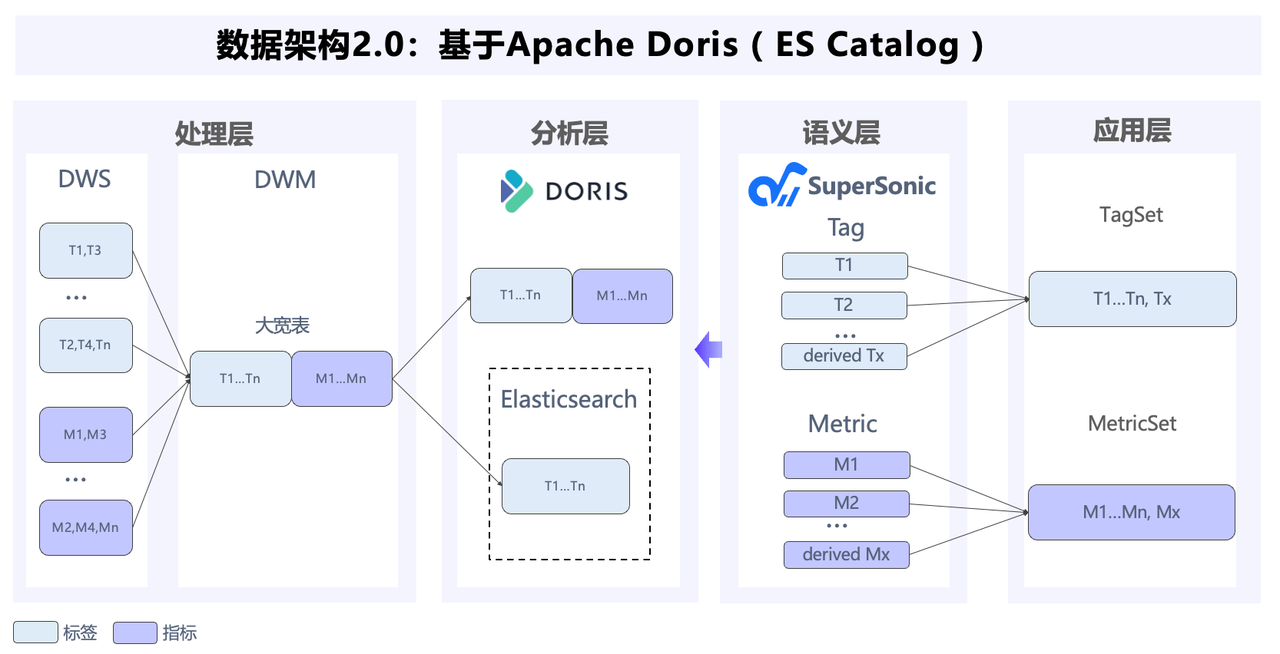
Elasticsearch + Doris 混合架构.PNG

但这套混合架构在应用时,也遇到了一些问题:

  • 存储成本较高:Doris 的引入并没有完全解决存储成本高的问题,Elasticsearch 的存储空间占用仍然显著。
  • 写入性能受限:随着数据量的增长,Elasticsearch 集群的写入压力不断加大,全量写入耗时超过 10 个小时,接近业务可承受极限。
  • 混合架构复杂:Elasticsearch 和 Doris 的混合架构增加了系统和技术栈的维护成本,同时冗余的数据存储也带来了额外费用,两套系统也增加了数据不一致的风险。

基于 Apache Doris 的统一架构方案

因此,腾讯音乐考虑是否可以将搜索引擎统一为 Doris,让其全面负责全文检索、标签圈选以及聚合分析的需求。这样考虑的主要原因是 Apache Doris 自 2.0 版本开始支持倒排索引和全文检索,这使其有能力完全替 Elasticsearch 所负责的部分,获得更好的收益。

  • 在全文检索方面,Doris 不仅支持普通的等值和范围(=, !=, >, >=, <, <=)查询加速,还支持文本字段的全文检索,包括中英文分词、多关键词检索(MATCH_ANY, MATCH_ALL)、短语检索(MATCH_PHRASE, MATCH_PHRASE_PREFIX, MATCH_PHRASE_REGEXP)、短语词距(slop)、多字段检索(MULTI_MATCH),其性能相较于传统数据库支持的 LIKE 模糊匹配有数量级的提升。
  • 在倒排索引方面, Doris 倒排索引在数据库内核中实现,语法与 SQL 无缝结合,支持多种条件的任意 AND OR NOT 逻辑组合,满足普通过滤以及全文检索组合的复杂需求。如下方示例,WHERE 筛选条件由 5 部分组成,包括全文检索 title MATCH '爱' OR description MATCH_PHRASE '热爱',日期范围过滤 dt BETWEEN '2024-09-10 00:00:00' AND '2024-09-10 23:59:59',数值范围过滤 rating > 4,字符串等值过滤 country = '中国',这些条件通过统一的 SQL 语法无缝组合起来,筛选完之后又按照 actor 进行分组统计,最后对分组统计的 cnt 排序取最高的 100 个结果。
SELECT actor, count() as cnt 
FROM table1
WHERE dt BETWEEN '2024-09-10 00:00:00' AND '2024-09-10 23:59:59'
  AND (title MATCH '爱' OR description MATCH_PHRASE '热爱')
  AND rating > 4
  AND country = '中国'
GROUP BY actor
ORDER BY cnt DESC LIMIT 100;

因此,腾讯音乐将 Doris 升级至 2.0 版,将架构从原先的 Elasticsearch 和 Doris 转变为统一的 Doris 解决方案:
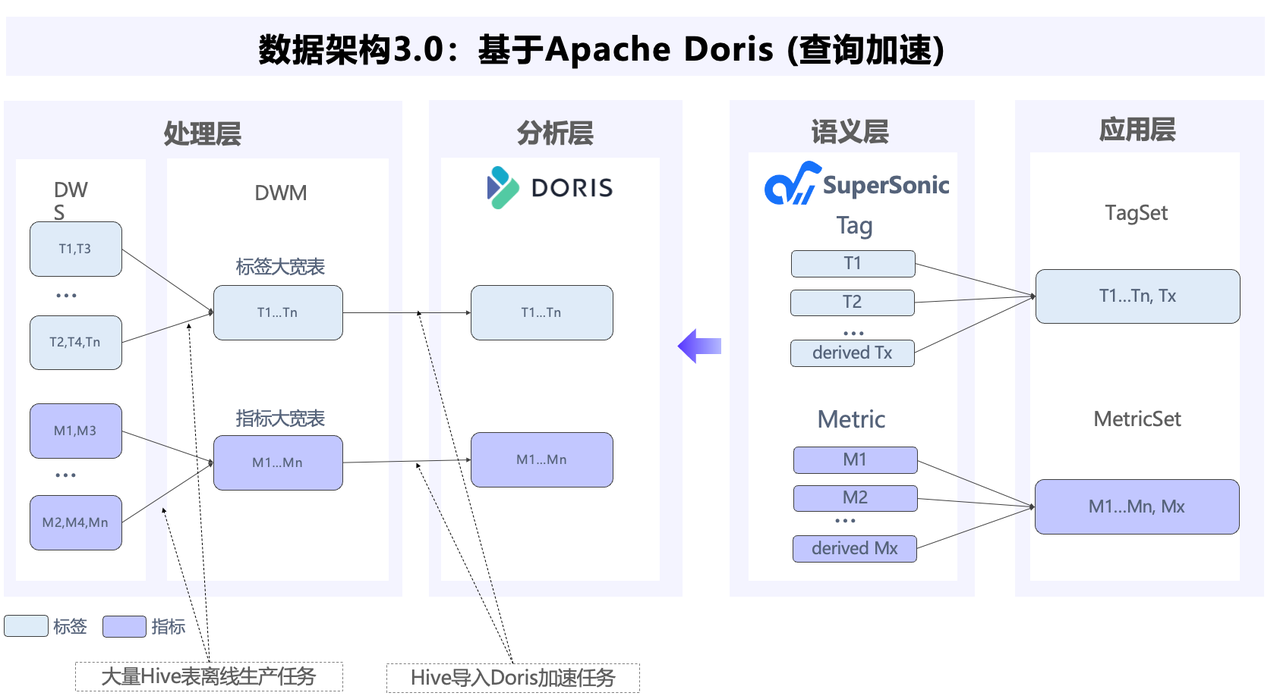
基于 Apache Doris 的统一架构方案.png

基于 Doris 的统一架构上线后,所带来的收益也非常可观:

  • 成本显著降低:Doris 替代了 Elasticsearch 集群,同时承载了搜索和分析两类负载,使用成本节省达 80%。比如,某个表单日全量数据在 Elasticsearch 中需要 697.7 GB 存储空间,而在 Doris 中仅需 195.4 GB ,存储空间减少了 72%。
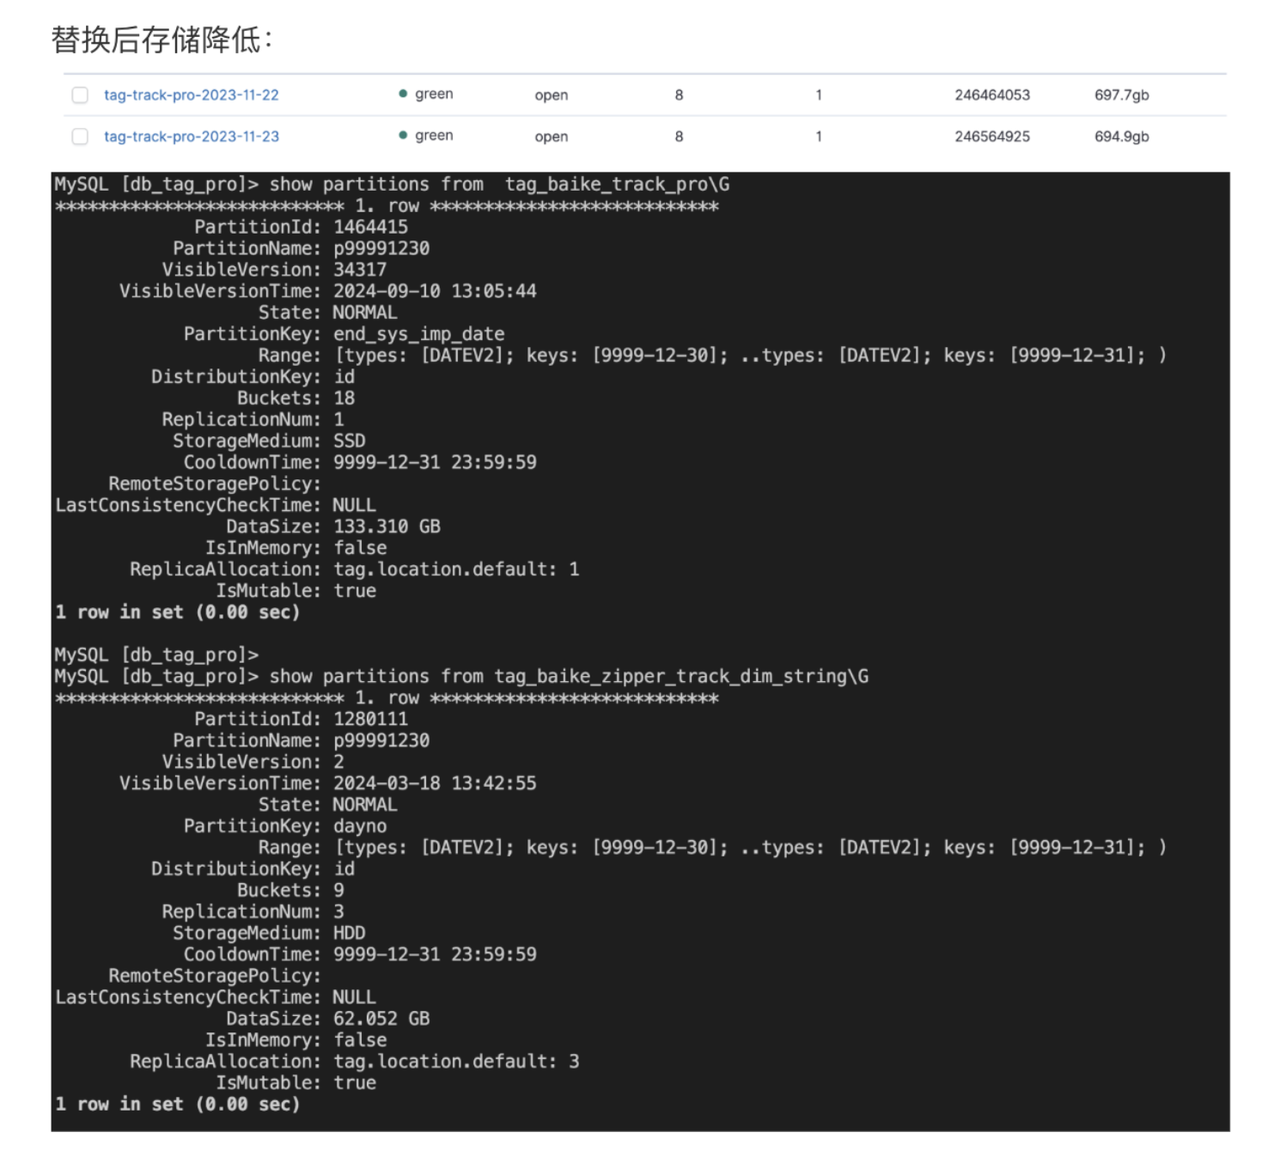
基于 Apache Doris 的统一架构方案-2.png

  • 写入和查询性能提升:全量数据导入时间从 10 小时以上缩短至 3 小时以内, **写入性能是 Elasticsearch 的 4 倍。**此外,Doris 可以支持复杂的自定义标签计算,使不可能变为可能,显著改善了用户体验。

  • 统一系统架构:架构统一到 Doris 后,内部只需维护一套技术栈,极大降低了维护成本,同时也很好避免了两套系统之间的数据一致性问题,确保了数据质量的可靠性。

在架构统一的过程中,涉及到一些关键设计,接下来将相关方案及经验分享给读者。

01 Doris 倒排索引的使用

在存储结构上采用了维度表与事实表的方案:

  • 维度表:使用 Merge-on-Write Unique 模型,用于百科搜索和标签圈选,通过部分列更新进行维度更新。
  • 事实表:使用 Aggregate 模型,用于存储每日的指标数据。由于数据量较大且每天的数据独立,每天需新建一个分区。

参考 Doris 倒排索引的使用文档,根据 Elasticsearch Mapping 设计了对应的 Doris 的表结构和索引。其中,Elasticsearch 的 Keyword 类型对应 Doris 的 Varchar/String 类型及不分词的倒排索引(USING INVERTED),ES 的 Text 类型对应 Doris 的 Varchar/String 类型及分词倒排索引(USING INVERTED PROPERTIES("parser" = "english/chinese/unicode"))。

CREATE TABLE `tag_baike_zipper_track_dim_string` (
  `dayno` date NOT NULL COMMENT '日期',
  `id` int(11) NOT NULL COMMENT 'id',
  `a4` varchar(65000) NULL COMMENT 'song_name',
  `a43` varchar(65000) NULL COMMENT 'zyqk_singer_id',
  INDEX idx_a4 (`a4`) USING INVERTED PROPERTIES("parser" = "unicode", "support_phrase" = "true") COMMENT '',
  INDEX idx_a43 (`a43`) USING INVERTED PROPERTIES("parser" = "english") COMMENT ''
) ENGINE=OLAP
UNIQUE KEY(`dayno`, `id`)
COMMENT 'OLAP'
PARTITION BY RANGE(`dayno`)
(PARTITION p99991230 VALUES [('9999-12-30'), ('9999-12-31')))
DISTRIBUTED BY HASH(`id`) BUCKETS auto
PROPERTIES (
...
);

使用 Doris 倒排索引的前后对比:

使用前:以下方复杂查询为例,在使用 Doris 倒排索引之前,该查询运行较慢、响应级别为分钟级。

-- like (查询复杂性能低):
SELECT  * FROM db_tag_pro.tag_track_pro_3  WHERE 
dayno='2024-08-01' AND  ( concat('#',a4,'#') like '%#若月亮还没来#%' 
or concat('#',a43,'#') like '%#1000#%')  

-- explode (执行性能差,经常 ERROR 1105 (HY000)):
SELECT * 
 FROM (
 SELECT tab1.*,a4_single,a43_single FROM ( 
 SELECT * 
 FROM db_tag_pro.tag_track_pro_3
  WHERE dayno='2024-08-01'
 ) tab1 
 lateral view explode_split(a4, '#') tmp1 as a4_single
 lateral view explode_split(a43, '#') tmp2 as a43_single
 ) tab2 
 where a4_single='若月亮还没来' or a43_single='1000'

使用后:使用 Doris 倒排索引之后,查询过程显著简化,运行速度极大提升,响应时间从分钟级缩短至秒级别。

  • 对中文采用 unicode 分词,数值采用 english分词创建倒排索引。
  • 设置 store_row_column,启用行存,优化select* 查询所有列。
-- 先通过match从维度表搜索查询到id
SELECT  id FROM db_tag_pro.tag_baike_zipper_track_dim_string  WHERE
( a4 MATCH_PHRASE '若月亮还没来' OR a43 MATCH_ALL '1000' )  AND  dayno ='2024-08-01'

-- 再通过id主键查询事实表得到明细数据
SELECT * FROM db_tag_pro.tag_baike_track_pro  WHERE  id IN ( 563559286  ) 

不仅如此,原来在 Elasticsearch 中由于语句过长而无法查询的复杂自定义标签,在 Doris 内能够更好的支持,Doris 能够处理更长的 SQL 语句。并且在同一个引擎内,可以通过物化视图和 BITMAP 类型轻松对查询后的中间结果进一步优化,避免了不同引擎之间的跨网络同步。

02 业务间资源隔离

为了确保业务侧使用体验和成本可控,我们采用了 Doris 的资源隔离机制进行业务间的资源管理。

  • 第一层:物理隔离(Resource Group) 将集群划分为两个资源组:Core 和 Common,以服务不同重要场景的需求。Core 组专注于内容搜索和标签圈选的核心需求,而 Common 组则处理其他普通需求。通过在节点层面实施物理隔离,可确保核心业务不受其他业务的影响。
  • 第二层:逻辑隔离(Workload Group) 在每个物理隔离内部,通过 Workload Group 对每个 Resource Group 进行逻辑资源的细分。例如,在普通集群中建立多个 Workload Group,并为用户指定默认的 Workload group,以防止单个用户占满整个集群的资源。

业务间资源隔离.png

上述资源隔离机制显著提升了系统的稳定性,告警频率从每天 20 多次降低到每月个位数。这不仅保障了业务的可靠性,还减轻了团队运维管理压力,使他们能够将更多时间投入到系统优化中。

业务无感迁移方案

腾讯音乐自研的 SuperSonic 项目内置了 Headless BI 功能,其核心理念是将数据建模、管理和消费进行解耦。通过这种架构,业务分析师只需在 Headless BI 平台上定义指标和标签,而无需关心底层数据源的具体实现。

在业务迁移过程中,业务团队通过 SuperSonic Headless BI 进行。利用转换工具将 DSL 转换为 Elasticsearch SQL 查询,只需切换已定义指标和标签所对应的数据源即可。由于 Headless BI 屏蔽了底层不同数据存储和分析引擎的差异,业务方能够实现无感知的迁移。
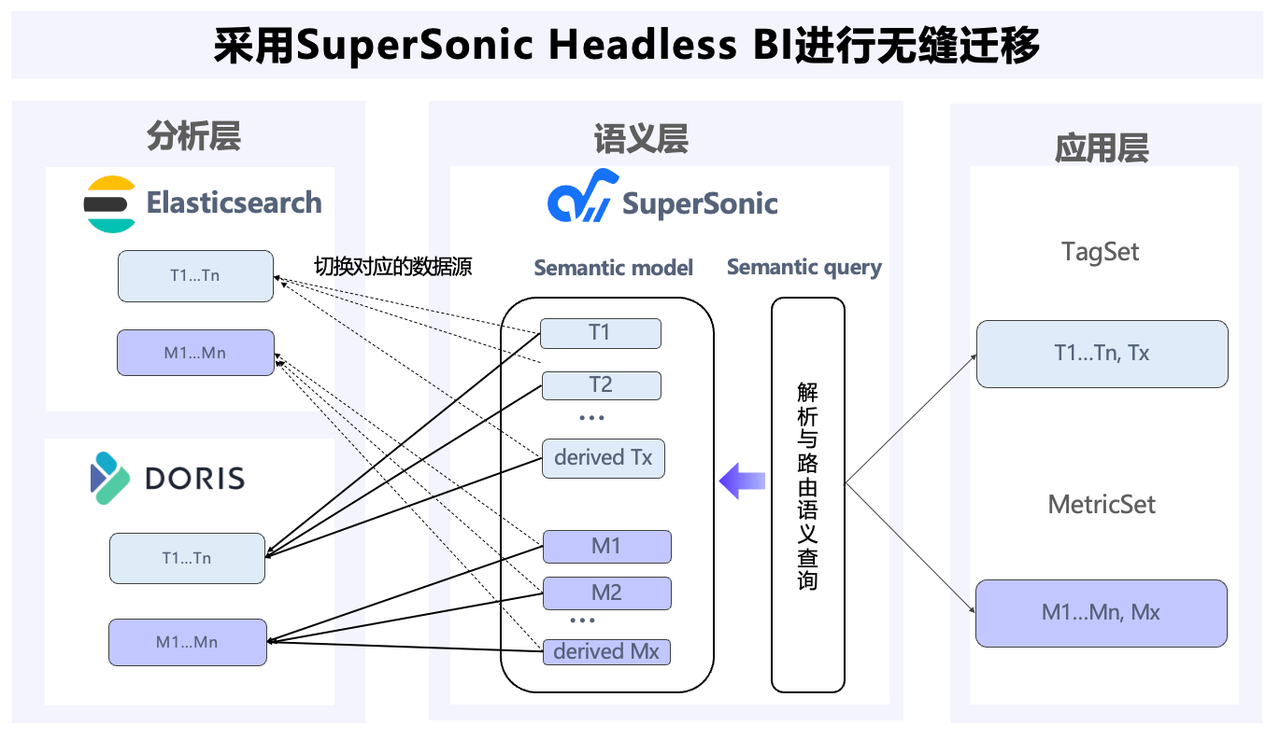
业务无感迁移方案.png

Headless BI 架构不仅实现了数据源的无缝迁移,还大大简化了数据管理和查询的复杂性。SuperSonic 将 Chat BI 与 Headless BI 融合,使用户能够实现统一的数据治理,并通过自然语言进行数据分析。经过腾讯音乐的自主研发和实际应用,SuperSonic 平台现已开源,欢迎感兴趣的同仁使用与共同建设。(项目地址)

结束语

借助 Doris 替代 Elasticsearch 集群,腾讯音乐统一了搜索和分析引擎。基于倒排索引和全文检索的能力,支持复杂的自定义标签计算,满足秒级响应需求。此外,写入性能提升了 4 倍,存储空间减少了 72%,使用成本节省达 80%。

未来,腾讯音乐将与 Apache Doris 深度合作,探索更多特性在场景应用中的可能性,包括引入 3.0 版本的存算分离,以进一步降低成本。

相关文章:#腾讯音乐案例 、#Elasticsearch 到 Apache Doris 案例、#日志场景案例

[ComfyUI]腾讯开源黑科技Sonic,插件更新,更加可控啦 之前很喜欢的数字人开口说话项目Sonic更新了,再不会限制正方形输出了,爱了。 阅读详情

相关推荐

ClickHouse/Doris vs Elasticsearch谁更胜一筹?

我之前在ClickHouse vs Doris 读写性能比较一文中,初步做了一下ClickHouse和Doris的读写性能比较,但由于数据样本比较小,且未发挥出所有硬件资源的性能,因此进行了第二轮压测。新加入了Elasticsearch搜索引擎ClickHouse和Doris均采用多并发写入,发挥最大性能本轮测试得到了飞轮科技多位技术专家的指导,对Doris进行了一定的参数调优环境准备(硬件机器配置同上一篇文章)clickhouse集群节点IP分片编号副本编号ck9311ck941。

禹鼎侯的博客 5856

Supersonic 新一代AI数据分析平台

Supersonic是腾讯音乐开源的融合了Chat BI和Headless BI的新一代数据分析平台,可以通过自然语言来分析数据。(项目地址在文章末尾)

3629

腾讯开源SuperSonic:AI+BI如何重塑数据分析?

SuperSonic是腾讯开源的AI+BI平台,融合Chat BI与Headless BI,为制造企业提供实时数据分析。它通过自然语言交互打破数据壁垒,实现生产、库存、质量、供应链等多环节优化,提升决策效率,其开源生态与扩展性助力企业数字化转型与数据价值挖掘。

数据与算法架构提升之路专栏 4533

腾讯音乐开源ChatBI + Headless BI平台SuperSonic全面使用指南

SuperSonic 开源AI+BI平台使用指南摘要 SuperSonic是腾讯音乐开源的下一代AI+BI平台,融合ChatBI(LLM驱动)与HeadlessBI(语义层驱动)两大范式。本指南涵盖从部署到应用的全流程: 核心架构 六层架构:前端层→API网关→聊天智能层→语义层→LLM集成→数据访问 双阶段查询:自然语言解析为S2SQL→语义层翻译为物理SQL执行 关键技术:Schema感知、RAG增强、自一致性投票优化 部署方式 Docker Compose(推荐):一键启动完整服务 Release包:

xyghehehehe的专栏 837

【Doris】Doris on ES在快手商业化的最佳实践

快手商业化报表引擎为外部广告主提供广告投放效果的实时多维分析报表在线查询服务,以及为商业化内部各系统提供多维分析报表查询服务。致力于解决多维分析报表场景的高性能、高并发、高稳定的查询问题。1 业务场景介绍1.1 服务介绍本文主要侧重介绍Doris on ES(DOE)在我们业务场景的实践,所以我们的数据架构在这里只做简单介绍,如上如图所示。总体来说数据分为实时+离线两块事实数据写入,外加mysql binlong同步这一部分的维度数据写入。实时主要是flink+kafka,离线部分基本各大公司都是统一解决方

m0_54252387的博客 1322

ChatBI 之 SuperSonic 初尝试

SuperSonic的核心理念是通过将物理数据模型抽象为逻辑语义模型,并确保语义的一致性、严谨性,从而支持用户通过 Chat 对话的方式进行数据查询。NLP > SQL,错误率太高。而 SuperSonic 采用的是:NLP > 一致语义层 > SQL的方式,将数据语义(如业务术语、列值等)纳入提示词中,使 LLM 能够更好地理解语义,以减少幻觉,这也是市面上大多数类似产品的通用思路。

实践出真知 6437

腾讯音乐内容库 ES 替代:从 Elasticsearch 到 Apache Doris 统一搜索分析引擎实践

一句话摘要:腾讯音乐使用 Apache Doris 替代 Elasticsearch 统一内容库搜索与分析引擎,关键能力包括倒排索引与全文检索、维度表/事实表建模、资源隔离(Resource Group + Workload Group)与业务无感迁移。:Apache Doris · SelectDB · 腾讯音乐 · Elasticsearch 替代 · 倒排索引 · 全文检索 · 资源隔离 · 内容库。

SelectDB 246

Abaqus CEL分析必备:Hypermesh网格导出与inp文件合并技巧

本文详细介绍了在Abaqus CEL分析中使用Hypermesh生成六面体网格并合并多组件inp文件的完整流程。从单元类型设置(EC3D8R)、网格质量优化到inp文件合并技巧,提供了一套解决流固耦合仿真前处理痛点的实战方案,帮助工程师高效完成复杂CEL分析任务。

weixin_29279101的博客 212

探索Doris:日志分析的新宠,是否能取代老牌ES?

在大数据时代,日志存储与分析对于企业的运营和决策起着至关重要的作用。Elasticsearch(简称 ES)作为一款广泛应用的开源分布式搜索和分析引擎,长期以来在日志管理领域占据着举足轻重的地位。然而,随着技术的不断发展,新的解决方案层出不穷,其中Apache Doris 凭借其卓越特性,在日志存储与分析领域迅速崛起,引发业界热议:Doris 是否会成为新一代王者,取代传统的 Elasticsearch(ES)?

涤生大数据 1357

Wireshark抓包分析:如何从HTTP流量中快速定位黑客攻击痕迹(附pcap文件)

本文通过Wireshark实战,详细解析了如何从HTTP流量中快速定位黑客攻击痕迹。文章提供了核心过滤策略,并重点剖析了如何识别SQL注入攻击的流量特征、揭露WebShell的隐蔽通信以及追踪攻击者在横向移动中的行为,帮助安全人员系统性地从pcap文件中还原完整攻击链。

sprite的博客 1008

LDA主题模型简介及Python实现

一、LDA主题模型简介 LDA主题模型主要用于推测文档的主题分布,可以将文档集中每篇文档的主题以概率分布的形式给出根据主题进行主题聚类或文本分类。 LDA主题模型不关心文档中单词的顺序,通常使用词袋特征(bag-of-word feature)来代表文档。词袋模型介绍可以参考这篇文章:文本向量化表示——词袋模型 - 知乎 了解LDA模型,我们需要先了解LDA的生成模型,LDA认为一篇文章是怎么形成的呢? LDA模型认为主题可以由一个词汇...

weixin_41168304的博客 20万+

es 对比 doris对比

综上所述,ES和Doris各有优势,选择哪种数据库取决于具体的使用场景和需求。如果需要处理非结构化数据、进行全文搜索或日志分析,ES可能是更好的选择;如果需要处理结构化数据、进行复杂的数据分析和报表生成,Doris可能更适合。ES(Elasticsearch)和Doris是两种不同类型的数据库,它们各自在不同的使用场景下有优势。

vmaps的博客 4910

django drf 框架知识点(一)——serializer序列化器_用法全解

【django drf】序列化器:别名设置,全部参数序列化,自定义字段,只读只写,部分更新

qq_59344127的博客 1338

实时数仓-Doris ON ES

原理介绍 Doris通过创建外部表方式将Doris的分布式查询规划能力和ES(Elasticsearch)的全文检索能力相结合,提供更完善的OLAP分析场景解决方案,支持: ES中的多index分布式Join查询 Doris和ES中的表联合查询,更复杂的全文检索过滤 创建ES外表后,FE会请求建表指定的主机,获取所有节点的HTTP端口信息以及index的shard分布信息等,如果请求失败会顺序遍历host列表直至成功或完全失败。 执行查询时,会根据FE得到的...

test_test111的专栏 5841

FPGA实现PI控制

FPGA实现PI控制

m0_57319166的博客 3888

课堂练习及课后作业2.1:外部中断

本关任务:通过相关知识以及实验回答:版本 1 内核的第 6 次时钟中断发生时,断点和恢复点(指令地址)分别是多少?本关任务:修改版本 0 内核,使得每发生 100 次时钟中断,就在屏幕上输出一个字符‘t’和当时的进程号,如“t(0)”表示0号进程运行时发生了时钟中断。本关任务:通过实际操作回答在输出第一行 0/1 字符的过程中(如下图所示),共发生了几次时钟中断?本关任务:修改版本 1 内核源码,使得每次时钟中断发生时,都在屏幕上输出字符‘t’。分析版本1内核,找到第一次时钟中断的恢复点地址。

Junds0的博客 1万+

9个优秀的Text2Sql(Chat2Sql)开源项目、资源

随着大模型能力逐步强大、场景越来越丰富,从Text到sql或者从Chat到sql的方案也十分火热,这个方案主要是利用大模型将自然语言转化为可以执行的Sql语句,进行数据分析,并根据结果实现报告生成或者可视化展示。这种方案提高了领导们随时想要报告的效率,缓解了应对向上汇报的焦虑,在许多决策支持、大屏展示等场景中非常见效。 本文主要收集了几个比较优秀的Text2Sql相关的开源项目或者资源,供借鉴。

人工智能讲师分享前沿技术 2万+

瑞芯微RK3588/RK3576平台采集BT1120(fpga)驱动调试记录

本文介绍了在RK3576/RK3588平台上采集FPGA传输的BT1120数据的方法。主要内容包括:1)硬件连接需确认管脚复用和图像格式(通常为uyvy_2x8);2)设备树配置要点,如I2C总线设置、BT1120模式指定等;3)驱动适配注意事项,包括时钟极性、分辨率格式等关键参数;4)测试方法,通过media-ctl和v4l2-ctl工具验证数据采集。文中特别指出RK3576和RK3588配置的通用性,并提供了常见问题的排查思路。

bingdund的博客 913

基于 SuperSonic SPI 机制集成 DolphinScheduler CLI 的实践

SuperSonic 是腾讯音乐开源的下一代 AI+BI 平台,统一了 Chat BI(由 LLM 驱动)和 Headless BI(由语义层驱动)两种范式。核心特性:架构组件:GitHub: https://github.com/tencentmusic/supersonic (⭐ 4.9k)Apache DolphinScheduler 是 Apache 基金会的现代数据编排平台,专注于处理数据管道中的复杂任务依赖。核心特性:GitHub: https://github.com/apache/dolph

暗影八度 254

使用LSTM实现自动调制识别(RML2018.01a)

目录一、LSTM的代码实现1.1 导入包1.2 数据读取及数据集划分1.3 数据预处理1.4 构建LSTM模型 本文基于RML2018.01a大型数据集,给出LSTM的信号识别的实现方式(附代码) RML2018.01a数据集信息如下: 模型 传送门 CNN/ResNet 使用CNN/ResNet实现自动调制识别(RML2018.01a) LSTM 使用LSTM实现自动调制识别(RML2018.01a)) 一、LSTM的代码实现 1.1 导入包 import numpy as np

QAQIknow的博客 6121

ET2012新版免狗免安装绿色软件

ET2012新版免狗免安祖昂绿色软件。,新界面,新视觉,

探索未来数据查询的新边界——SuperSonic(超音数)

欢迎来到SuperSonic的世界,这是一个革命性的数据分析平台,它结合了ChatBI与HeadlessBI的力量,让用户可以借助自然语言轻松提问,获取精准的数据见解。SuperSonic无需复杂的SQL知识,也不需要改动原始数据,只需要建立逻辑语义模型,即可实现与数据的无缝对话。不仅如此,它的可插拔设计使得定制化成为可能,以满足各种特定需求。 ## 项目技术分析 SuperSonic的创新之

gitblog_00027的博客 1058

VB摄像头监控

该VB模块可对摄像头捕获的画面进行录像等,可在创建的窗口进行控制

10分钟掌握Doris,超越Hive、Elasticsearch和PostgreSQL

介绍Apache Doris作为数据仓库的升级,提高数据处理效率和查询能力。

u013643074的博客 3763

复分析 阿尔福斯(Ahlfors) 第三版答案 英文

答案分为十章,有部分习题没有答案,全英文复分析阿尔福斯(Ahlfors) 第三版答案

AI问数架构supersonic-源码导读

说明supersonic的主要接口架构,协作关系,各接口意义及对应文件位置

想~ai抽 1588

从 Elasticsearch 到 Apache Doris,构建 10 倍性价比提升的新一代日志存储分析平台

从 Elasticsearch 到 Apache Doris,构建 10 倍性价比提升的新一代日志存储分析平台

crg18438610577的博客 998

「精华版」Doris VS Elasticsearch全方位对比和落地实践指导

Doris 3.0 引入 存算分离架构,计算节点与存储节点独立扩展,支持冷热数据分层(热数据存 SSD,冷数据存 HDD / 对象存储),资源利用率提升 40%。MPP 分布式架构:无共享设计,Frontend 负责元数据与查询调度,Backend 并行处理计算任务,支持向量化执行引擎,单节点写入吞吐量达 550MB/s,是 Elasticsearch 的 5 倍(后者约 124MB/s)。然而,随着数据规模的爆炸式增长和分析需求的复杂化,其在复杂聚合、存储成本、SQL 生态兼容性等方面的短板逐渐显现。

微信搜:import_bigdata,大数据领域硬核原创作者 2125

大模型日报2024-06-21

摘要: DrVideo通过将长视频转化为文本文档,利用大语言模型进行关键帧检索和信息增强,实现高效长视频理解,显著提升多项基准测试的准确率。摘要: DataSquirrel.ai帮您快速、轻松地理解数据,自动生成洞察、清晰图表和报告,支持分享和下载,适合非技术经理。摘要: 此项目为增强版ChatGPT克隆,支持多种AI模型和插件,完全开源,适合自托管,使用TypeScript编写。摘要: Immersfy在几分钟内将剧本转化为故事板,节省80%的时间和50%的成本,提供强大的自定义功能。

weixin_40262196的博客 866
上一篇: Apache Doris 2.0.15 版本发布
下一篇: Apache Doris 3.0 里程碑版本|存算分离架构升级、湖仓一体再进化
SelectDB技术团队
博客等级 码龄4年 2119粉丝 483原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包

打赏作者

SelectDB技术团队

你的鼓励将是我创作的最大动力

¥1 ¥2 ¥4 ¥6 ¥10 ¥20
扫码支付:¥1
获取中
扫码支付

您的余额不足,请更换扫码支付或充值

打赏作者

实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值