数据分析:用pandas处理金融时间序列数据的基础知识

python数据分析--金融数据处理 主要知识点:缺失值处理,折线图,密度图,数据移动,窗口滑动,重采样 阅读详情

本文使用的是以CSV文件形式在本地存储的金融数据集形式为本地存储的CSV文件。从技术上讲,CSV文件是包含数据行结构的文本文件,其特征是以逗号分隔单个值。在导入数据之前,导入一些软件包并进行定制:

In [1]: import numpy as np
        import pandas as pd
        from pylab import mpl, plt
        plt.style.use('seaborn')
        mpl.rcParams['font.family'] = 'serif'
        %matplotlib inline
数据导入

pandas提供不同的函数和DataFrame方法,以导入不同存储格式(CSV、SQL、Excel等)的数据,并将数据导出为不同格式(详见第9章)。下面的代码通过pd.read_csv()函数导入CSV[1]文件中的时间序列数据:

In [2]: filename = '../../source/tr_eikon_eod_data.csv' ❶

In [3]: f = open(filename, 'r') ❷
        f.readlines()[:5] ❷
Out[3]: ['Date,AAPL.O,MSFT.O,INTC.O,AMZN.O,GS.N,SPY,.SPX,.VIX,EUR=,XAU=,GDX,
        ,GLD\n',
         '2010-01-01,,,,,,,,,1.4323,1096.35,,\n',
         '2010-01-04,30.57282657,30.95,20.88,133.9,173.08,113.33,1132.99,20.04,
        ,1.4411,1120.0,47.71,109.8\n',
         '2010-01-05,30.625683660000004,30.96,20.87,134.69,176.14,113.63,1136.52,
        ,19.35,1.4368,1118.65,48.17,109.7\n',
         '2010-01-06,30.138541290000003,30.77,20.8,132.25,174.26,113.71,1137.14,
        ,19.16,1.4412,1138.5,49.34,111.51\n']
In [4]: data = pd.read_csv(filename, ❸
                           index_col=0, ❹
                           parse_dates=True) ❺

In [5]: data.info() ❻
        <class 'pandas.core.frame.DataFrame'>
        DatetimeIndex: 2216 entries, 2010-01-01 to 2018-06-29
        Data columns (total 12 columns):
        AAPL.O    2138 non-null float64
        MSFT.O    2138 non-null float64
        INTC.O    2138 non-null float64
        AMZN.O    2138 non-null float64
        GS.N      2138 non-null float64
        SPY       2138 non-null float64
        .SPX      2138 non-null float64
        .VIX      2138 non-null float64
        EUR=      2216 non-null float64
        XAU=      2211 non-null float64
        GDX       2138 non-null float64
        GLD       2138 non-null float64
        dtypes: float64(12)
        memory usage: 225.1 KB

❶ 指定路径和文件名。

❷ 显示原始数据(Linux/Mac)的前5行。

❸ 传递给pd.read_scv()函数的文件名。

❹ 指定第一列作为索引处理。

❺ 指定索引值为datetime类型。

❻ 结果为DataFrame对象。

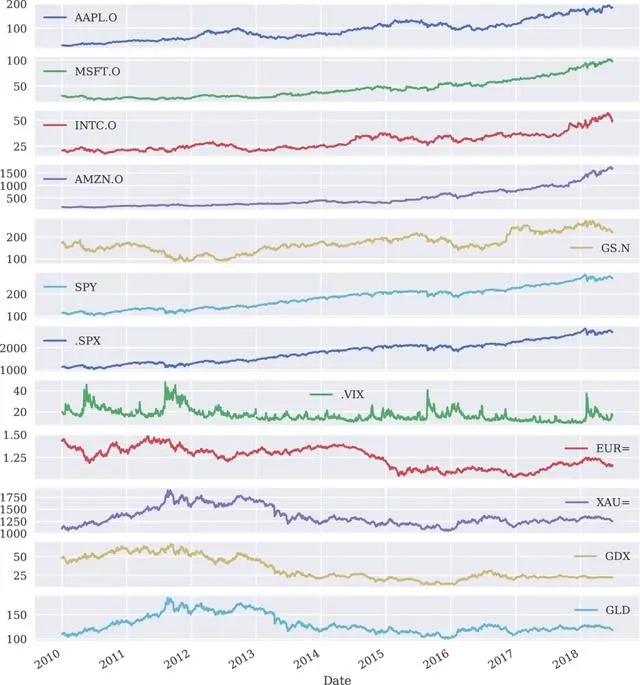
在这一阶段,金融分析师可能首先观察数据,对其进行检查或者可视化:

Uploading file...

In [6]: data.head() ❶
Out[6]:
                   AAPL.O MSFT.O INTC.O AMZN.O  GS.N   SPY   .SPX .VIX \
    Date
    2010-01-01        NaN    NaN    NaN    NaN   NaN   NaN    NaN  NaN
    2010-01-04  30.572827 30.950  20.88 133.90 173.08 113.33 1132.99 20.04
    2010-01-05  30.625684 30.960  20.87 134.69 176.14 113.63 1136.52 19.35
    2010-01-06  30.138541 30.770  20.80 132.25 174.26 113.71 1137.14 19.16
    2010-01-07  30.082827 30.452  20.60 130.00 177.67 114.19 1141.69 19.06

                  EUR=    XAU=   GDX    GLD
    Date
    2010-01-01  1.4323 1096.35   NaN    NaN
    2010-01-04  1.4411 1120.00 47.71 109.80
    2010-01-05  1.4368 1118.65 48.17 109.70
    2010-01-06  1.4412 1138.50 49.34 111.51
    2010-01-07  1.4318 1131.90 49.10 110.82

In [7]: data.tail() ❷
Out[7]:
                AAPL.O MSFT.O INTC.O  AMZN.O   GS.N    SPY   .SPX.VIX \
    Date
    2018-06-25  182.17  98.39  50.71 1663.15 221.54 271.00 2717.07 17.33
    2018-06-26  184.43  99.08  49.67 1691.09 221.58 271.60 2723.06 15.92
    2018-06-27  184.16  97.54  48.76 1660.51 220.18 269.35 2699.63 17.91
    2018-06-
python金融:从金融数据的获取到运用pandas数据清洗、处理、加工与金融波动率、年化收益率、最大回撤、夏普比率等指标计算与数据可视化 python在处理金融数据时,具有很多优点:一是语法简单,可以轻松上手;二是免费与开源,使用python不像使用matlab需要购买软件授权,节约成本开支;三是具有强大的第三方模块支持,从numpy到pandas、再到人工智能,都有成熟开源模块提供支撑;最后一个是与金融进行了深度的结合,从行情获取到投资策略开发再到风控,都有广泛的应用场景。这篇文章演示了从数据获取到处理的一个简单的、完整的业务流程,主要面向python金融初学者。 阅读详情

相关推荐

Python金融大数据分析——第6章 金融时间序列 笔记

第6章 金融时间序列 6.1 pandas基础 6.1.1 使用DataFrame类的第一步 6.1.2 使用DataFrame类的第二步 6.1.3 基本分析 6.1.4 Series类 6.1.5 GroupBy操作 6.2 金融数据 6.3 回归分析 第6章 金融时间序列 6.1 pandas基础 6.1.1 使用DataFrame类的第一步 import...

RealEmperor 博客 8940

【人工智能】用Python和Pandas进行时间序列数据分析:从处理到预测

时间序列数据是广泛存在于金融、天气、销售等领域的重要数据类型,其分析和预测对业务决策具有关键意义。Python 的 Pandas 库提供了强大的时间序列数据处理功能,从基本的数据加载、清洗到高级的重采样、移动平均和可视化分析,能够高效支持时间序列任务。本文将从基础概念出发,结合丰富的代码实例,详细讲解如何使用 Pandas 处理和分析时间序列数据。我们将以金融数据和天气数据为例,探索数据的预处理、趋势分析、季节性分解、移动平均计算等技术,并使用简单模型对时间序列进行预测。通过这篇文章,读者将掌握 Panda

一个被知识诅咒的人 1769

Python金融大数据分析-数据获取与简单处理

无意中发现了一个巨牛的人工智能教程,忍不住分享一下给大家。教程不仅是零基础,通俗易懂,而且非常风趣幽默,像看小说一样!觉得太牛了,所以分享给大家。教程链接:https://www.cbedai.net/qtlyx Python的功能不可以说不大,在金融数据分析里面有着很方便的应用。 1.数据获取 pandas包中有自带的数据获取接口,详细的大家可以去其官网上找,是io.data下的...

lyx的专栏 3万+

Pandas教程 | 教你用Pandas玩转时间序列数据

微信公众号:「Python读财」 如有问题或建议,请公众号留言 进行金融数据分析或量化研究时,总避免不了时间序列数据的处理,时间序列是指在一定时间内按时间顺序测量的某个变量的取值序列。常见的时间序列数据有一天内随着时间变化的温度序列,又或者交易时间内不断波动的股票价格序列。Pandas也因其强大的时序处理能力而被广泛应用于金融数据分析,这篇文章为大家介绍一下Pandas中的时间序列处理,所使用...

Python读财 1155

Python Pandas 时间序列分析

移动窗口是时间序列分析中的一个强大工具,特别适用于趋势分析、数据平滑处理等应用场景。处理时间序列时常用的功能之一是时间频率的转换,包括重采样(Resampling)和频率转换(Frequency Conversion)。重采样是改变时间序列频率的过程,包括将高频率数据转换为低频率(降采样),或将低频率数据转换为高频率(升采样)。Pandas 库中,处理时间数据是一个核心功能,特别是对于时间序列分析。pd.Timedelta 对象表示一个时间间隔,可以用来进行日期和时间的计算。

weixin_42098295的博客 1659

Python在金融大数据分析中的AI应用实战

Python作为一种灵活且强大的编程语言,在金融大数据分析领域有着广泛的应用。通过以上示例代码,我们展示了Python在股票市场分析、投资组合优化和风险管理方面的应用。未来,随着人工智能技术的不断发展,Python将在金融领域发挥越来越重要的作用。通过本文,我们希望能够引导读者更深入地了解Python在金融大数据分析中的实际应用,以及未来在这个领域的发展趋势。

xiaolinyui的博客 1919

Pandas时间序列处理:从基础到金融数据分析实战

时间序列数据处理是数据分析的核心技能之一,尤其在金融、物联网等领域应用广泛。Pandas库作为Python生态中的数据处理利器,其Timestamp对象和to_datetime方法能智能处理50多种时间格式,解决实际项目中常见的时间格式混乱问题。通过设置时间索引、重采样(resample)和滑动窗口(rolling)等操作,可以显著提升查询效率并实现复杂的统计分析。在金融数据分析场景中,这些技术可用于计算移动平均线、布林带等技术指标。针对性能优化,建议使用datetime64数据类型和分块处理策略,同时注意

weixin_42522953的博客 253

Python和数据分析:Pandas新手指南

Pandas是一个基于Python的开源数据分析库,提供了高性能、易用的数据结构和数据分析工具。其主要构建块是两个核心数据结构:Series和DataFrame。Series: 类似于一维数组,但带有标签(索引),可以存储任意类型的数据。可以将Series看作是带标签的列。DataFrame: 类似于电子表格或SQL表,是一个二维表格,可以包含多个列,每个列可以是不同的数据类型。DataFrame是Pandas中最常用的数据结构。我们将使用一个虚构的销售数据集,其中包含产品、销售额、日期等信息。

weixin_68789096的博客 692

利用Python进行数据分析(十九)之金融和经济数据应用

金融经济数据方面应用Python非常广泛,也可以算是用Python进行数据分析的一个实际应用。数据规整化方面的应用时间序列与截面对齐在处理金融数据时,最费神的一个问题就是所谓的“数据对齐” (data alignment)问题。两个相关的时间序列的索引可能没有很好的对齐,或两个DataFrame对象可能含有不匹配的列或行。Pandas可以在算术运算中自动对齐数据。在实际工作中,这不仅能为你带来极大...

Python达人 7686

【Dify】智能文档信息检索与问答全流程自动化

本文介绍了基于大语言模型的智能文档问答系统,通过Dify平台实现一键式自动化流程。系统采用文档上传、文本解析、向量化检索和问答推理四个核心节点,集成openai-text-embedding-ada-002和qwen-turbo模型,支持多格式文档的语义理解和精准问答。工作流包含文档预处理、向量索引构建和智能交互三个阶段,可应用于企业知识库、智能客服、法律检索等多个场景,显著提升信息获取效率。文章还提供了系统配置指南和典型应用案例,展示其在降低人工成本、提高检索准确率方面的优势。

Mr数据杨 751

价值投资数据科学:Pandas处理金融时间序列数据

本文旨在为价值投资者和数据科学家提供一个全面的指南,介绍如何使用Pandas高效处理金融时间序列数据。我们将覆盖从基础数据操作到高级分析技术的完整流程,特别关注价值投资特有的数据分析需求,如基本面指标分析、估值比率计算和长期趋势识别等。本文首先介绍金融时间序列数据的特性和Pandas的基本概念,然后深入探讨数据处理和分析技术,接着通过实际案例展示完整的工作流程,最后讨论相关工具资源和未来发展趋势。价值投资:一种投资策略,通过分析公司的基本面数据,寻找市场价格低于其内在价值的股票时间序列数据。

2501_92132293的博客 627

【python数据挖掘课程】二十三.时间序列金融数据预测及Pandas库详解

这是《Python数据挖掘课程》系列文章,也是我上课内容及书籍中的一个案例。本文主要讲述时间序列算法原理,Pandas扩展包基本用法以及Python调用statsmodels库的时间序列算法。由于作者数学比较薄弱,自己也还在学习,所以原理推导部分本文只简单叙述,同时参考了《Python金融大数据分析 ·Yves Hilpisch》书籍。本篇文章为基础性文章,希望对你有所帮助,提供些思路,也是自己教

杨秀璋的专栏 1万+

Python数据处理035:结构化数据分析工具Pandas之Pandas概览

Python结构化数据分析工具Pandas之Pandas概览

若北辰 5646

Pandas进阶之路:解锁数据处理新姿势

本文聚焦 Pandas 进阶应用,全面探索数据处理的高效技巧。从数据清洗进阶出发,深入讲解复杂缺失值处理、异常值识别与处理及数据去重的高级方法;接着阐述数据合并重塑、时间序列处理、分组聚合等核心操作的进阶策略;还涉及函数应用映射与性能优化技巧,包括向量化操作、数据类型优化、大文件分块处理等。最后结合金融、销售数据分析案例,将理论融入实战,帮助读者突破 Pandas 基础应用局限,提升数据处理能力,为数据分析工作提供有力支持。

邓邓子的博客 960

TMS320C6678开发笔记1-6---C6678单核烧写程序

第6节 单核烧写加载程序 6.1节 TI参考文档 参考文档:《KeystoneI Bootloader Resources and FAQ》讲的非常好,建议一定要看 https://processors.wiki.ti.com/index.php/KeystoneI_Bootloader_Resources_and_FAQ#Direct_Boot_Examples_.28without_IBL.29 里面有三个工程: C6678 EVM SPI boot example C6657 EVM ..

kunkliu的博客 5699

金蝶个版本下载地址,记得保存收藏。

专业版 V10.0 http://downloads.cmcloud.cn/kis/kis_pro/10.0/kiszybV10sp1.rar V11.0 http://downloads.cmcloud.cn/kis/kis_pro/11.0/KISV11Setup.rar V12.0 http://dow...

饺子的博客 2512

实现高精度卷积混响--MATLAB仿真篇

一、前言 之前在STM32F407上现实了直播声卡,实现的经典Schroeder混响模型和Moorer混响模型,得到不错效果。后来得知卷积混响最为真实地表现空间的特性,所以也就尝试在MCU上实现一个高精度的卷积混响(卷积点数为32768),目前MCU出来的混响效果算得上一流水准,本人也在计划在ADI的21489或者SC584上更高精度的卷积混响。 二、卷积方式 1、conv1是使用MATLAB自带卷积函数conv 2、conv2和conv3是改进后卷积过程,具有减少运算量特点,方便嵌入式移植 clear;

Six44的博客 5082

Openclaw错误排查及解决方案之:Something went wrong while processing your request. Please try again.

Openclaw错误排查及解决方案之:Something went wrong while processing your request. Please try again.

多媒体编程、网络编程、系统编程、网络安全编程、驱动编程 3793

AI 视觉宠物喂食器:智能识别 + 精准投喂,打造宠物喂养新体验

AI 视觉宠物喂食器将边缘 AI 计算与传统硬件结合,既解决了传统喂食器的核心痛点,又兼顾了 DIY 的易用性和扩展性。无论是宠物主人 DIY 使用,还是小型创客团队产品化,该方案都具备较高的实用价值和落地性,为宠物智能化喂养提供了轻量化的实现路径。

weixin_42300449的博客 419

自定义模型训练——打造专属OpenClaw模型(2026AI版)

本文介绍了OpenClaw自定义模型训练的核心流程,包括框架选择(PyTorch、TensorFlow、HuggingFace和原生OpenClaw框架)、训练环境搭建脚本、以及数据收集系统的设计。数据收集器支持从数据库、API、文件和网络等多种来源获取训练数据,并提供灵活的过滤机制确保数据质量。通过这套系统,开发者可以高效准备训练数据,为后续模型训练打下坚实基础。

博客 878

10、数据挖掘与轨迹生成技术:FSSEMiner与CondTraj - GAN的探索

本文介绍了两种先进的数据处理技术:FSSEMiner算法用于从动态属性图中挖掘频繁顺序子图演化模式,揭示如交通流和疾病传播等复杂系统的演化规律;CondTraj-GAN是一种端到端的条件生成对抗网络,能够生成高质量的合成车辆轨迹,解决真实轨迹数据因隐私问题难以获取的挑战。通过实验评估与真实数据集验证,两种技术在可扩展性、实用性及生成质量方面均表现出色,并在交通管理、城市规划、自动驾驶研发等领域具有广泛应用前景。

grafana8visual的博客 88

基于Simulink的电气弹簧ES稳压控制模型仿真

在本文中,我们将使用Simulink建立一个ES稳压控制系统的模型,并通过仿真验证其性能。接下来,我们配置了各个组件的参数,包括电源电压、负载电流以及ES和控制器的传递函数。通过调整模型中的参数和控制算法,我们可以进一步优化系统的性能并实现更好的电压稳定调节。该系统通过对电力系统中的ES进行控制,调整其阻尼特性,以实现对电压的稳定调节。例如,我们可以设置电源的电压值、负载的电流值,以及控制器的参数(如PID控制器的比例、积分和微分增益)。反馈控制可以根据测量值来调整控制器的输出,从而实现对电压的稳定调节。

DevProZ的博客 423

WINCC7.3破解文件

WINCC7.3硬件够破解文件,有需要的下载!WINCC7.3硬件够破解文件,有需要的下载!

OV9734 DATASHEET,完整规格书

OV9734完整规格书,包括电气参数,尺寸规格,寄存器配置表等

ET2012新版免狗免安装绿色软件

ET2012新版免狗免安祖昂绿色软件。,新界面,新视觉,

深度学习工具包 DeepLearningToolbox

深度学习工具包Deprecation notice.-----This toolbox is outdated and no longer maintained.There are much better tools available for deep learning than this toolbox, e.g. [Theano](http://deeplearning.net/software/theano/), [torch](http://torch.ch/) or [tensorflow](http://www.tensorflow.org/)I would suggest you use one of the tools mentioned above rather than use this toolbox.Best, Rasmus.DeepLearnToolbox================A Matlab toolbox for Deep Learning.Deep Learning is a new subfield of machine learning that focuses on learning deep hierarchical models of data.It is inspired by the human brain's apparent deep (layered, hierarchical) architecture.A good overview of the theory of Deep Learning theory is[Learning Deep Architectures for AI](http://www.iro.umontreal.ca/~bengioy/papers/ftml_book.pdf)For a more informal introduction, see the following videos by Geoffrey Hinton and Andrew Ng.* [The Next Generation of Neural Networks](http://www.youtube.com/watch?v=AyzOUbkUf3M) (Hinton, 2007)* [Recent Developments in Deep Learning](http://www.youtube.com/watch?v=VdIURAu1-aU) (Hinton, 2010)* [Unsupervised Feature Learning and Deep Learning](http://www.youtube.com/watch?v=ZmNOAtZIgIk) (Ng, 2011)If you use this toolbox in your research please cite [Prediction as a candidate for learning deep hierarchical models of data](http://www2.imm.dtu.dk/pubdb/views/publication_details.php?id=6284)```@MASTERSTHESIS\{IMM2012-06284, author = "R. B. Palm", title = "Prediction as a candidate for learning deep hierarchical models of data", year = "2012",}```Contact: rasmusbergpalm at gmail dot comDirectories included in the toolbox-----------------------------------`NN/` - A library for Feedforward Backpropagation Neural Networks`CNN/` - A library for Convolutional Neural Networks`DBN/` - A library for Deep Belief Networks`SAE/` - A library for Stacked Auto-Encoders`CAE/` - A library for Convolutional Auto-Encoders`util/` - Utility functions used by the libraries`data/` - Data used by the examples`tests/` - unit tests to verify toolbox is workingFor references on each library check REFS.mdSetup-----1. Download.2. addpath(genpath('DeepLearnToolbox'));Example: Deep Belief Network---------------------```matlabfunction test_example_DBNload mnist_uint8;train_x = double(train_x) / 255;test_x = double(test_x) / 255;train_y = double(train_y);test_y = double(test_y);%% ex1 train a 100 hidden unit RBM and visualize its weightsrand('state',0)dbn.sizes = [100];opts.numepochs = 1;opts.batchsize = 100;opts.momentum = 0;opts.alpha = 1;dbn = dbnsetup(dbn, train_x, opts);dbn = dbntrain(dbn, train_x, opts);figure; visualize(dbn.rbm{1}.W'); % Visualize the RBM weights%% ex2 train a 100-100 hidden unit DBN and use its weights to initialize a NNrand('state',0)%train dbndbn.sizes = [100 100];opts.numepochs = 1;opts.batchsize = 100;opts.momentum = 0;opts.alpha = 1;dbn = dbnsetup(dbn, train_x, opts);dbn = dbntrain(dbn, train_x, opts);%unfold dbn to nnnn = dbnunfoldtonn(dbn, 10);nn.activation_function = 'sigm';%train nnopts.numepochs = 1;opts.batchsize = 100;nn = nntrain(nn, train_x, train_y, opts);[er, bad] = nntest(nn, test_x, test_y);assert(er < 0.10, 'Too big error');```Example: Stacked Auto-Encoders---------------------```matlabfunction test_example_SAEload mnist_uint8;train_x = double(train_x)/255;test_x = double(test_x)/255;train_y = double(train_y);test_y = double(test_y);%% ex1 train a 100 hidden unit SDAE and use it to initialize a FFNN% Setup and train a stacked denoising autoencoder (SDAE)rand('state',0)sae = saesetup([784 100]);sae.ae{1}.activation_function = 'sigm';sae.ae{1}.learningRate = 1;sae.ae{1}.inputZeroMaskedFraction = 0.5;opts.numepochs = 1;opts.batchsize = 100;sae = saetrain(sae, train_x, opts);visualize(sae.ae{1}.W{1}(:,2:end)')% Use the SDAE to initialize a FFNNnn = nnsetup([784 100 10]);nn.activation_function = 'sigm';nn.learningRate = 1;nn.W{1} = sae.ae{1}.W{1};% Train the FFNNopts.numepochs = 1;opts.batchsize = 100;nn = nntrain(nn, train_x, train_y, opts);[er, bad] = nntest(nn, test_x, test_y);assert(er < 0.16, 'Too big error');```Example: Convolutional Neural Nets---------------------```matlabfunction test_example_CNNload mnist_uint8;train_x = double(reshape(train_x',28,28,60000))/255;test_x = double(reshape(test_x',28,28,10000))/255;train_y = double(train_y');test_y = double(test_y');%% ex1 Train a 6c-2s-12c-2s Convolutional neural network %will run 1 epoch in about 200 second and get around 11% error. %With 100 epochs you'll get around 1.2% errorrand('state',0)cnn.layers = { struct('type', 'i') %input layer struct('type', 'c', 'outputmaps', 6, 'kernelsize', 5) %convolution layer struct('type', 's', 'scale', 2) %sub sampling layer struct('type', 'c', 'outputmaps', 12, 'kernelsize', 5) %convolution layer struct('type', 's', 'scale', 2) %subsampling layer};cnn = cnnsetup(cnn, train_x, train_y);opts.alpha = 1;opts.batchsize = 50;opts.numepochs = 1;cnn = cnntrain(cnn, train_x, train_y, opts);[er, bad] = cnntest(cnn, test_x, test_y);%plot mean squared errorfigure; plot(cnn.rL);assert(er<0.12, 'Too big error');```Example: Neural Networks---------------------```matlabfunction test_example_NNload mnist_uint8;train_x = double(train_x) / 255;test_x = double(test_x) / 255;train_y = double(train_y);test_y = double(test_y);% normalize[train_x, mu, sigma] = zscore(train_x);test_x = normalize(test_x, mu, sigma);%% ex1 vanilla neural netrand('state',0)nn = nnsetup([784 100 10]);opts.numepochs = 1; % Number of full sweeps through dataopts.batchsize = 100; % Take a mean gradient step over this many samples[nn, L] = nntrain(nn, train_x, train_y, opts);[er, bad] = nntest(nn, test_x, test_y);assert(er < 0.08, 'Too big error');%% ex2 neural net with L2 weight decayrand('state',0)nn = nnsetup([784 100 10]);nn.weightPenaltyL2 = 1e-4; % L2 weight decayopts.numepochs = 1; % Number of full sweeps through dataopts.batchsize = 100; % Take a mean gradient step over this many samplesnn = nntrain(nn, train_x, train_y, opts);[er, bad] = nntest(nn, test_x, test_y);assert(er < 0.1, 'Too big error');%% ex3 neural net with dropoutrand('state',0)nn = nnsetup([784 100 10]);nn.dropoutFraction = 0.5; % Dropout fraction opts.numepochs = 1; % Number of full sweeps through dataopts.batchsize = 100; % Take a mean gradient step over this many samplesnn = nntrain(nn, train_x, train_y, opts);[er, bad] = nntest(nn, test_x, test_y);assert(er < 0.1, 'Too big error');%% ex4 neural net with sigmoid activation functionrand('state',0)nn = nnsetup([784 100 10]);nn.activation_function = 'sigm'; % Sigmoid activation functionnn.learningRate = 1; % Sigm require a lower learning rateopts.numepochs = 1; % Number of full sweeps through dataopts.batchsize = 100; % Take a mean gradient step over this many samplesnn = nntrain(nn, train_x, train_y, opts);[er, bad] = nntest(nn, test_x, test_y);assert(er < 0.1, 'Too big error');%% ex5 plotting functionalityrand('state',0)nn = nnsetup([784 20 10]);opts.numepochs = 5; % Number of full sweeps through datann.output = 'softmax'; % use softmax outputopts.batchsize = 1000; % Take a mean gradient step over this many samplesopts.plot = 1; % enable plottingnn = nntrain(nn, train_x, train_y, opts);[er, bad] = nntest(nn, test_x, test_y);assert(er < 0.1, 'Too big error');%% ex6 neural net with sigmoid activation and plotting of validation and training error% split training data into training and validation datavx = train_x(1:10000,:);tx = train_x(10001:end,:);vy = train_y(1:10000,:);ty = train_y(10001:end,:);rand('state',0)nn = nnsetup([784 20 10]); nn.output = 'softmax'; % use softmax outputopts.numepochs = 5; % Number of full sweeps through dataopts.batchsize = 1000; % Take a mean gradient step over this many samplesopts.plot = 1; % enable plottingnn = nntrain(nn, tx, ty, opts, vx, vy); % nntrain takes validation set as last two arguments (optionally)[er, bad] = nntest(nn, test_x, test_y);assert(er < 0.1, 'Too big error');```[![Bitdeli Badge](https://d2weczhvl823v0.cloudfront.net/rasmusbergpalm/deeplearntoolbox/trend.png)](https://bitdeli.com/free "Bitdeli Badge")

上一篇: 练习两年半......写给python初中级的进阶指南,该怎么学?
下一篇: 机器学习分类模型10大指标详解
Python_P叔
博客等级 码龄3年 5454粉丝 827原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值