小白程序员必收藏! Agent推理模式深度解析(CoT & ReAct)助力大模型面试

ReAct、CoT 和 ToT:大模型提示词推理架构的对比分析 对比维度CoTToTReAct推理结构线性链树状结构推理 + 动作交替可否探索多路径否是部分(通过动作探索)是否支持工具调用否是(可结合)是实现难度低高中典型场景数学推理、逻辑题多解问题、复杂决策任务开放领域问答、交互任务可解释性中高高模拟人类思维程度中极高高核心优势易用性高,通用性强全局优化,推理质量高灵活适应环境变化局限路径单一,灵活性不足工程成本高依赖外部工具可用性。 阅读详情

小白程序员必收藏! Agent推理模式深度解析(CoT & ReAct)助力大模型面试

本文深入解析了Agent推理模式,包括基础输出答案模式、思维链CoT和结合行动的ReAct范式,阐述了它们如何解决LLM推理困境。重点解析了ReAct原理、实现方式及现代LLM优化,适合准备大模型面试的小白和程序员学习收藏。快手面试真题:“Agent推理模式有哪些?ReAct是啥?具体是怎么实现的?”本文详细回答了这些问题。

快手面试题真题:「Agent 推理模式有哪些?ReAct 是啥?具体是怎么实现的?」

💡 简要回答

Agent 的推理模式我用过几种。

最基础的是直接输出答案,没有中间推理;CoT 是让 LLM 先把推理过程写出来再给答案,准确率更高;ReAct 是在 CoT 基础上加了「行动」,让 LLM 交替输出思考和工具调用,每次行动后再根据结果继续思考,形成一个循环。

我觉得 ReAct 是目前 Agent 用得最广的模式,因为它推理过程可见,又能动态利用外部工具,两个优点都有。

📝 详细解析

什么是推理模式?

要理解「推理模式」这个词,得先说清楚 LLM 面临的一个根本困境。

LLM 的工作原理,是根据你给它的输入,一个 token 一个 token 地往后预测。

你问它一个简单问题,它可以直接说出答案。但如果你问的是一个需要多步推导的问题,比如「A 公司的市值是 B 公司的 1.2 倍,B 公司比 C 公司高 30%,请问 A 和 C 谁更高,差多少?」,LLM 在没有任何辅助的情况下,往往直接给你一个「感觉对」的答案,而这个答案可能是错的。

原因在于,当它「一口气」预测答案时,中间的推导步骤都是隐式的,没有办法强制自己在每一步都做出正确的推断。误差会在中间某个暗处悄悄累积,最终暴露在答案里。

你可以把它类比成心算和笔算的区别。让你心算「123 × 456」,你可能算错;但如果你把每一步都写在纸上,「123 × 6 = 738、123 × 50 = 6150……」,一步一步来,算错的概率就会大大降低。原因不是你突然变聪明了,而是「写下来的过程」本身帮助你避免在中间某步跳跃出错。

LLM 也一样,把推导过程写出来,就等于在每一步都有了一个可以依赖的「前文」,下一步的预测建立在一个已经写清楚的正确基础之上。

「推理模式」存在的根本原因就是这个:通过不同的方式,让 LLM 把隐式的思考过程显式化出来,从而减少多步推理中的累积误差。CoT、ReAct 就是这个方向上的两种解法,每一个都在解决前一个的局限性。

CoT是什么?

CoT,全称 Chain of Thought(思维链),是最早也最简单的解法。

核心想法极其朴素:在 prompt 里加一句「让我们一步步思考」,LLM 就会先把推理步骤写出来,再给答案,而不是直接蹦出结论。为什么加一句话就有效?

本质是因为 LLM 的输出是顺序生成的,先写出来的推理内容会进入上下文,成为后续生成的依据。

当 LLM 先写出「第一步:A 市值是 B 的 1.2 倍,所以 A > B」这句话之后,这个推导结论就进入了上下文,下一步的预测建立在这个明确写出的正确基础上,而不是靠它在脑子里「暗中维持」这个中间状态。就像笔算,纸上的每一行数字都在帮你记住上一步算到哪了。

CoT 有两种触发方式。

  • 一种是 Zero-shot CoT,直接在 prompt 末尾加上「让我们一步步思考」,LLM 自己展开推理,不需要额外示例;
  • 另一种是 Few-shot CoT,给几个带有完整推理过程的例子让 LLM 模仿,效果更稳定,适合格式要求比较固定的场景。

但 CoT 有一个根本性的局限:它是纯文字推理,没有办法和外部世界交互。推理过程再完整,也拿不到实时数据,不能执行计算,不能访问数据库。

如果你问 LLM「现在苹果公司的市值是多少?」,它只能根据训练数据里的知识回答,而那些知识可能已经过时好几个月了。这就是 CoT 不够用的地方,你需要的不只是一个能把推理写出来的 LLM,而是一个能在推理过程中「出去拿数据」「执行工具」再「回来继续推理」的系统。于是有了 ReAct。

ReAct 是什么?

ReAct 是 Reasoning and Acting 的缩写,核心思路是在 CoT 的推理链里,插入真实的「行动」。

它让 LLM 按照「思考 -> 行动 -> 观察」这个循环来推进任务:先思考当前该怎么做,然后调用一个工具去获取信息或执行操作,把工具返回的结果作为新的「观察」接收回来,再进入下一轮思考,直到 LLM 判断任务完成。

用一个具体例子来感受这个循环。假设你问 Agent「2024 年苹果公司和谷歌的市值谁更高?差多少?」,如果只靠 CoT,LLM 只能说出它训练时知道的数字,可能已经不准了。但用 ReAct,整个过程会是这样的:

Thought: 这道题需要两家公司的实时市值数据,我得先查苹果的市值
Action: search
Action Input: 苹果公司 2024 年市值
Observation: 苹果公司 2024 年市值约为 3.5 万亿美元

Thought: 好,苹果的数字有了,再查谷歌的
Action: search
Action Input: 谷歌 2024 年市值
Observation: 谷歌 2024 年市值约为 2.1 万亿美元

Thought: 两个数字都有了,苹果 3.5 万亿,谷歌 2.1 万亿,苹果更高,差距是 1.4 万亿
Final Answer: 苹果公司 2024 年市值约 3.5 万亿美元,谷歌约 2.1 万亿美元,苹果更高,差距约 1.4 万亿美元

每一个 Thought 是 LLM 的推理,每一个 Action 是它决定调什么工具,每一个 Observation 是工具执行后系统填进去的真实结果,最后 Final Answer 是任务完成的终止信号。推理和真实数据的获取是交织在一起的,这才让 Agent 能处理「需要实时信息」或「需要执行操作」的任务。

ReAct 的实现原理,是通过 prompt 格式来约束 LLM 的输出结构,但这个循环不是 LLM 自己在转,而是由你的代码来驱动的。

LLM 每次只做一件事:根据当前的历史,输出下一步的 Thought 加上 Action。你的代码负责检测它的输出,判断「有没有 Final Answer」,如果没有就解析出 Action、执行对应的工具、把工具结果作为 Observation 填回历史,再次调用 LLM,一轮一轮地转。

一个典型的 ReAct prompt 长这样:

你是一个 AI 助手,可以使用以下工具:
- search(query): 搜索互联网获取最新信息
- calculator(expr): 计算数学表达式

回答时请严格按照以下格式:
Thought: 你的思考过程(分析当前情况,决定下一步)
Action: 工具名称
Action Input: 工具的输入参数
Observation: (此行由系统填入工具返回的结果,你不用写)
... 以上可以重复多轮 ...
Final Answer: 当你确定可以回答时,在这里给出最终答案

问题:2024 年苹果公司的市值是多少?和谷歌相比谁更高?

然后你的代码跑一个循环,不断地「调 LLM、检查输出、执行工具、把结果填回去」:

def react_agent(question: str, tools: dict, max_steps: int = 10):
    # 把 ReAct 格式约束和问题拼在一起,作为初始 prompt
    prompt = build_react_prompt(question, tools)
    # 用来存每一轮的对话历史,每次调 LLM 都把完整历史带上
    history = []

    for _ in range(max_steps):
        # 调 LLM,让它输出下一步的 Thought + Action
        # 注意:每次调用都把完整历史拼进去,LLM 才知道之前做了什么
        response = llm.generate(prompt + "/n".join(history))

        if"Final Answer:"in response:
            # LLM 输出了 Final Answer,说明它判断任务完成了
            return response.split("Final Answer:")[-1].strip()

        # 从 LLM 输出里解析出 Action 名称和 Action Input
        # 例如:Action: search,Action Input: 苹果公司市值 -> ("search", "苹果公司市值")
        action, action_input = parse_action(response)

        # 执行对应的工具,拿到真实结果
        if action in tools:
            observation = tools[action](action_input)
        else:
            # 如果 LLM 填了一个不存在的工具名,给它一个错误反馈
            observation = f"工具 {action} 不存在,请选择可用工具"

        # 把这一轮的 LLM 输出(含 Thought+Action)和 Observation 都追加进历史
        # 下次调 LLM 时这些内容会成为它的「记忆」
        history.append(response)
        history.append(f"Observation: {observation}")

    return"超过最大步数,任务未完成"

整个 loop 里,真正的「智能」全在 LLM 每次输出的 Thought 里,它在分析当前情况、做出下一步决策。

你的代码框架做的事是:管理对话历史、执行工具、检测循环终止条件。两件事分工很清楚,理解了这个分工,ReAct 就不再神秘了。

需要补充一点:上面描述的是 ReAct 的经典实现,靠 prompt 格式约束加文本解析来驱动工具调用。

现代 LLM(GPT-4、Claude 3 之后)基本都原生支持 Function Calling / Tool Use,模型可以直接输出结构化的 JSON 工具调用,不再需要靠解析 Action: xxx 这种文本格式。

这让 ReAct 的实现更干净,也更可靠,不容易因为 LLM 输出格式不规范而解析失败。本质上「思考 -> 行动 -> 观察」的循环没变,只是「行动」这一步从解析文本变成了解析结构化 JSON。

ReAct 的主要代价是 token 消耗随步骤数线性增长,因为每次调 LLM 都要把完整历史带上,任务步骤越多,输入就越长,成本可观。

最后

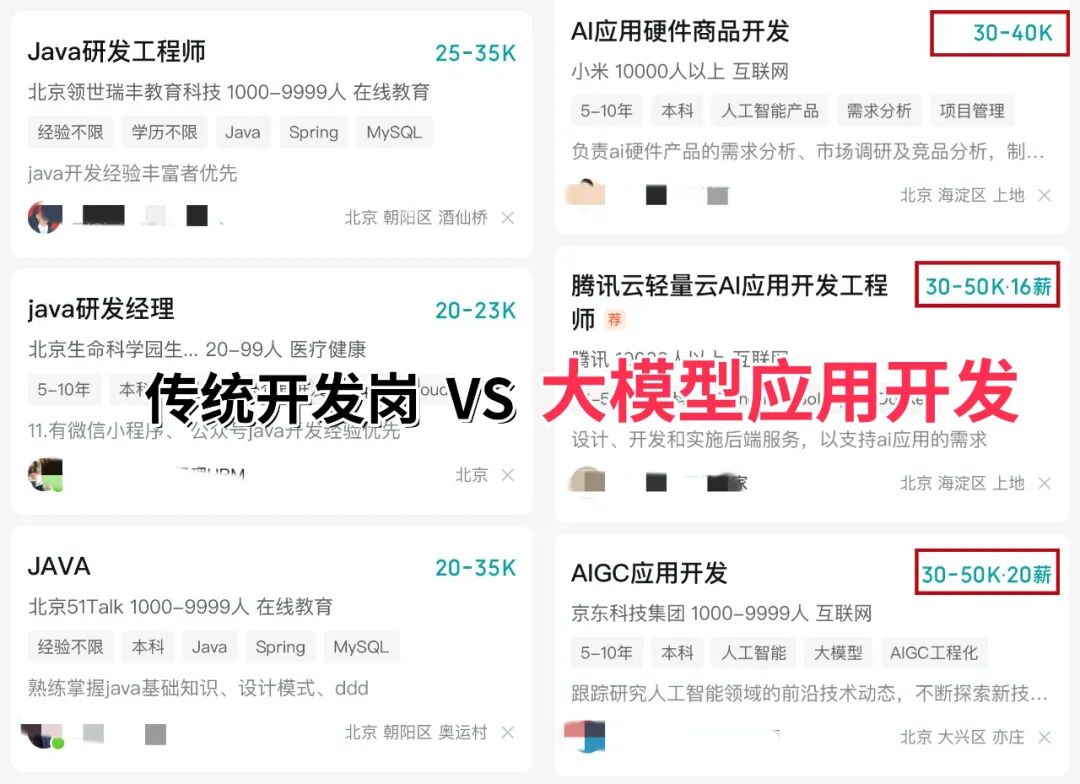
近期科技圈传来重磅消息:行业巨头英特尔宣布大规模裁员2万人,传统技术岗位持续萎缩的同时,另一番景象却在AI领域上演——AI相关技术岗正开启“疯狂扩招”模式!据行业招聘数据显示,具备3-5年大模型相关经验的开发者,在大厂就能拿到50K×20薪的高薪待遇,薪资差距肉眼可见!
图片

业内资深HR预判:不出1年,“具备AI项目实战经验”将正式成为技术岗投递的硬性门槛。在行业迭代加速的当下,“温水煮青蛙”式的等待只会让自己逐渐被淘汰,与其被动应对,不如主动出击,抢先掌握AI大模型核心原理+落地应用技术+项目实操经验,借行业风口实现职业翻盘!

深知技术人入门大模型时容易走弯路,我特意整理了一套全网最全最细的大模型零基础学习礼包,涵盖入门思维导图、经典书籍手册、从入门到进阶的实战视频、可直接运行的项目源码等核心内容。这份资料无需付费,免费分享给所有想入局AI大模型的朋友!

图片

👇👇扫码免费领取全部内容👇👇

在这里插入图片描述

部分资料展示

1、 AI大模型学习路线图

img

2、 全套AI大模型应用开发视频教程

从入门到进阶这里都有,跟着老师学习事半功倍。
在这里插入图片描述

3、 大模型学习书籍&文档

在这里插入图片描述

4、 AI大模型最新行业报告

2025最新行业报告,针对不同行业的现状、趋势、问题、机会等进行系统地调研和评估,以了解哪些行业更适合引入大模型的技术和应用,以及在哪些方面可以发挥大模型的优势。

img

5、大模型大厂面试真题

整理了百度、阿里、字节等企业近三年的AI大模型岗位面试题,涵盖基础理论、技术实操、项目经验等维度,每道题都配有详细解析和答题思路,帮你针对性提升面试竞争力。

img

在这里插入图片描述

6、大模型项目实战&配套源码

学以致用,在项目实战中检验和巩固你所学到的知识,同时为你找工作就业和职业发展打下坚实的基础。

img

👉学会后的收获:👈

• 基于大模型全栈工程实现(前端、后端、产品经理、设计、数据分析等),通过这门课可获得不同能力;

• 能够利用大模型解决相关实际项目需求: 大数据时代,越来越多的企业和机构需要处理海量数据,利用大模型技术可以更好地处理这些数据,提高数据分析和决策的准确性。因此,掌握大模型应用开发技能,可以让程序员更好地应对实际项目需求;

• 基于大模型和企业数据AI应用开发,实现大模型理论、掌握GPU算力、硬件、LangChain开发框架和项目实战技能, 学会Fine-tuning垂直训练大模型(数据准备、数据蒸馏、大模型部署)一站式掌握;

• 能够完成时下热门大模型垂直领域模型训练能力,提高程序员的编码能力: 大模型应用开发需要掌握机器学习算法、深度学习框架等技术,这些技术的掌握可以提高程序员的编码能力和分析能力,让程序员更加熟练地编写高质量的代码。

  • 👇👇扫码免费领取全部内容👇👇

在这里插入图片描述

这些资料真的有用吗?

这份资料由我和鲁为民博士(北京清华大学学士和美国加州理工学院博士)共同整理,现任上海殷泊信息科技CEO,其创立的MoPaaS云平台获Forrester全球’强劲表现者’认证,服务航天科工、国家电网等1000+企业,以第一作者在IEEE Transactions发表论文50+篇,获NASA JPL火星探测系统强化学习专利等35项中美专利。本套AI大模型课程由清华大学-加州理工双料博士、吴文俊人工智能奖得主鲁为民教授领衔研发。

资料内容涵盖了从入门到进阶的各类视频教程和实战项目,无论你是小白还是有些技术基础的技术人员,这份资料都绝对能帮助你提升薪资待遇,转行大模型岗位。

在这里插入图片描述
在这里插入图片描述

这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】
在这里插入图片描述

【AI技术】主流Agent思想研究——Cot+ReAct+Reflexion 从24年初开始的时候,吴恩达(Andrew Ng)、Harrison Chase(LangChain创始人)等人开始在红杉资本AI论坛等公开场合,提倡Agent、workflow、flow engineering等概念,整个Agent和大模型结合的范式在2024年逐渐由学界研究转到终端应用的实际开发与实践上,大量的软件架构(Langchain、LlamaIndex、MetaGPT)等逐渐建设整个agent 生态吴恩达观点:2024年,目前通过Reflection(反思)和外部工具的调用,是比较成熟的技巧;通 阅读详情

相关推荐

CoT及ReAct解密与实战(三)

我们来看一下LangChain的官方文档,首先它很简单的说了一下,计划和执行代理(Plan and execute agents)首先计划要做什么,然后执行子任务来实现目标,言外之意ReAct不是这样的,我们在ReAct中看见的内容是,有一步具体的步骤,然后执行一个行动,然后再有一步具体的步骤,然后再执行一个具体的行动。在计划的末尾,写上”,这跟论文是一致的,这些都是非常高质量的提示词,会很清晰的告诉模型要干什么,这是计划器(planner)的部分。这就只剩下原来班级的55%。

大模型与Agent智能体 1577

大模型推理框架完全指南:CoT、ReAct、ToT原理与实践

大模型推理的三大核心框架解析:CoT(思维链)采用线性单链推理,适合简单问题,成本低但无纠错能力;ReAct(推理+行动)通过闭环交互支持工具调用,是AI Agent的主流框架;ToT(思维树)通过多分支探索实现高阶推理,适合复杂问题但成本高。三者从简单到复杂形成推理能力进阶体系,开发者需根据任务复杂度、交互需求和计算成本进行选择。

m0_74942241的博客 874

【AI大模型应用开发】从CoT到ToT,再到ReAct,提升大模型推理能力的方式探索(含代码)

本文我们深入学习了改进大模型推理能力的三种方法:CoT、ToT、ReAct。并从使用和实现的角度,进行了详细讲解。

同学小张的博客 7612

什么是 CoT 思维链和 ReAct 模式?它们如何提高 AI 推理能力?

CoT思维链(Chain of Thought)和ReAct模式(Reasoning and Acting)是提升大语言模型(LLM)复杂任务推理能力的两种关键技术。

weixin_45422672的博客 1500

CoT及ReAct解密与实战(一)

这是现在业界比较流行的一句话了,对于一些简单的任务,把它分成具体的步骤是有效的。如图8-1所示,我们谈思维链的时候,一个最简单的、最基本的方式是,让它展示具体的步骤,左图是传统的零样本(Zero-Shot)提示词,构建一个问题(Question),去获得答案(Answer),右图是思维链(Zero-Shot-CoT)的改进,将答案(Answer)增加一个提示词:“Let’s think step by step”(“让我们一步一步地思考”),希望模型一步一步的输出推理步骤,然后给出结果。

大模型与Agent智能体 1664

CoT及ReAct解密与实战(二)

另外还有一种情况是直接使用语言模型(LM)生成具体的行动(Actions),然后和外界(Environment)打交道进行沟通,行动和外界进行了交互之后,产生的结果叫观察(Observation),它会进行循环,这种方式叫只有行动(“Act only” )的方式,而ReAct把这两个步骤融合起来,做事情之前先进行思考,思考之后进行行动,然后看它的观察结果。如图8-3所示,在ReAct语言模型中的协同推理和行为中,ReAct完成了一件事情,这个事情就是大型语言模型与外部工具的协作,它做了这样一个贡献。

大模型与Agent智能体 1225

【收藏版】某大厂 AI 大模型岗高频面试题 ——Agent 专题(小白 / 程序员必学)

Agent并非单一组件,而是一套智能决策系统LLM(决策中枢) + 记忆(Memory) + 工具(Tools) + 规划(Planner),四者协同实现复杂任务的自主处理。🔹普通Prompt调用:属于“单次请求-单次响应”的单向交互,LLM仅根据当前输入生成结果,无持续决策和自主行动能力;🔹Agent:支持多轮自治决策,能根据任务目标自动选择工具、处理工具返回结果、纠错迭代,甚至调整任务规划,实现端到端的任务闭环。工具类型典型应用示例标准化定义方式API工具。

python12345_的博客 1117

Index-TTS-1.5:多模态语音合成的技术演进与商业落地实践

本文深入探讨了Index-TTS-1.5在多模态语音合成领域的技术演进与商业落地。该模型基于GPT风格的自回归Transformer架构,通过优化条件编码器和引入字符-拼音混合建模,显著提升了语音生成的稳定性、精准度和真实感,实现了高质量的零样本语音克隆。文章还详细介绍了其云端体验、本地WebUI部署及ComfyUI集成等实战路径,并分析了其在虚拟数字人、个性化内容创作等商业场景中的应用潜力与挑战。

weixin_29098367的博客 402

【收藏学习】AI智能体入门指南:20个关键概念助你掌握大模型工作逻辑

本文系统介绍了AI智能体的20个核心概念,分为基础组件、大模型与推理、工具与行动、多智能体与进化四大类。这些概念包括Agent、Environment、Memory、大语言模型、思维链、工具使用等,共同构成智能体的"积木"。掌握这些概念有助于从基础到进阶理解AI智能体如何自主感知、决策和行动,为构建能自主工作的智能系统提供理论支撑。

2401_85325557的博客 673

S905L3B机顶盒刷Armbian:从安卓Root到eMMC全攻略

在嵌入式开发与轻量级服务器搭建中,ARM架构设备因其低功耗和高性价比备受关注。晶晨S905L3B作为运营商机顶盒的主流芯片,通过刷写Armbian系统可将其改造为ARM小服务器。其原理是利用Amlogic芯片的uboot引导机制,将Linux系统写入eMMC存储,从而脱离原厂安卓限制。这一方案的技术价值在于以极低成本实现Docker容器、下载机、轻量数据库等服务的部署,应用场景涵盖家庭网络广告过滤、智能家居控制、复古游戏机等。本文以CM311-1S为例,详细拆解从安卓9 Root到Armbian写入eMMC

weixin_31476015的博客 340

对称加密和非对称加密,数字签名和证书

在对称加密中,任何人都可以使用公钥进行加密。在数字签名中,任何人都可以使用公钥验证签名。数字签名,其实就是将非对称加密反过来使用。公钥私钥非对称加密发送者加密时使用接收者解密时使用数字签名验证者验证签名时使用签名者生成签名时使用谁持有密钥?只要有需要,任何人都可以持有个人持有既然是加密,那肯定是不希望别人知道我的消息,所以只有我才能解密。公钥负责加密,私钥负责解密。既然是签名,那肯定是不希望有人冒充我发消息,所以只有我才能签名。私钥负责签名,公钥负责验签。

m0_70432049的博客 1410

推理框架对比:ReAct、思维链(COT)和思维树(TOT)谁更胜一筹

推理框架作为 AI 解决复杂问题的核心机制,正逐渐成为研究和应用的焦点。ReAct、思维链(Chain-of-Thought,CoT)()和思维树(Tree-of-Thoughts,ToT)这三种推理框架各具特色,它们从不同角度模拟人类思维方式,为 AI 提供了多样化的问题解决策略。深入研究和比较这些框架,对于推动人工智能的发展、拓展其应用场景具有重要意义。

llm_way的博客 4362

逐行逐句进一步了解SurroundOcc(一)

通过分析中的模型构建过程,理解了从配置文件到模型实例化的整个流程。构建过程的核心是通过build和等函数,逐步将配置文件解析并生成模型的各个模块对象,最终组合成一个完整的模型结构。这一过程涉及多个类和函数的调用,其中函数是生成对象的关键,它能够从配置字典中提取必要信息并生成对应的类实例。

lovely_yoshino的博客 8112

大模型提示词推理架构对比:ReAct/CoT/ToT

通过使用推理框架,AI变得更加像一个能够处理复杂任务的助手,而不仅仅是一台静态的机器。在本文中,我们将探讨三个关键框架:ReAct(推理与行动)、链式思维(CoT) 和 树形思维(ToT)。

IT大头的博客 3035

Python+Selenium实战:5分钟搞定快手评论区数据采集(附完整代码)

本文详细介绍了如何使用Python和Selenium快速采集快手评论区数据,提供完整的代码实现和优化方案。通过动态加载处理和智能等待策略,5分钟内即可构建高效的评论采集工具,适用于用户行为分析和内容挖掘等场景。

weixin_30415113的博客 344

华为OD机考双机位A卷 - 开心消消乐(Java & Python& JS & C/C++ & GO )

华为OD机考双机位A卷 - 开心消消乐(OD上机考试双机位A卷)。提供在线OJ刷题。Java、C++、Python、GO语言、C语言、JavaScript题解,并提供完整思路讲解。

算法大师! 1268

深度解析 AI 智能体 3 大主流思考框架:CoT、ReAct 与 Plan-and-Execute

深度解析 AI 智能体 3 大主流思考框架:CoT、ReAct 与 Plan-and-Execute

youmaob的博客 2104

46、聚类算法在智能交通数据分析中的应用

本文探讨了聚类算法在智能交通数据分析中的应用,介绍了K-均值算法、K-中心点算法和基于模型的聚类算法的基本原理及特点,并结合实际交通数据讨论了其应用场景与挑战。通过聚类分析,能够从海量交通数据中发现隐藏模式,为交通管理和规划提供科学依据。文章还展示了具体的案例分析和实现流程,为未来智能交通系统的发展提供了参考。

zz67890的博客 133

COT存在的问题以及ReAct Agent对此所做的优化

从ReAct的论文中(参考1),可以看到,单纯用COT,也会存在一些问题,靠COT也无法很好的回答问题,如下图所示

ybdesire的专栏 842

使用Python与OpenCV实现基于霍夫变换的圆形缺陷检测与定位详细教程

本文详细探讨了如何使用Python和OpenCV库,通过图像边缘检测和霍夫变换实现圆形对象的检测与缺陷定位。我们不仅介绍了算法的基本原理,还通过具体的代码示例展示了如何在实际应用中实现这些技术。对于工业检测和医学影像分析,本文的方法提供了高效且易于实现的解决方案。随着图像处理技术的不断发展,未来我们可以期待更多新算法和新技术的应用,如深度学习与传统方法的结合,以及多传感器融合技术的引入,这将进一步提升缺陷检测与定位的效率和准确性。

qq_38334677的博客 1295

温度PID控制PLC程序

温度PID稳定控制程序,适用于欧姆龙PLC,对其他PLC也具有很大参考价值

【思维链条CoT与React模式深度解析】AI智能体的核心推理框架

摘要: 本文系统解析了思维链条(CoT)与React模式的技术原理与应用。CoT通过逐步推理提升大模型的逻辑性与可解释性,适用于数学计算、代码调试等任务;React模式通过“思考-行动-观察”循环实现智能体与外部工具的交互,扩展了AI的动态任务处理能力。两者在技术本质(封闭推理vs开放交互)、流程(分步推理vs循环决策)及适用场景上存在显著差异。实践案例展示了结合CoT与React构建智能股票助手的方案,通过分解问题与调用API实现实时数据分析。未来,优化推理链设计、工具适配及性能缓存是提升智能体效能的关键

独立思考,明辨是非 1272

jre9下载 jdk9

(Java SE Runtime Environment 9.0) 9.0u175 官方最新版 【x86|x64】

收藏级干货|一文吃透Agent:ReAct、CoT、ToT三大LLM推理框架全解析(小白&程序员入门必备)

2022年由谷歌率先提出的基础推理范式,核心逻辑是让大模型模仿人类解决简单问题的线性思考习惯,将复杂问题拆解为一系列连续、有序的中间推理步骤,逐步推导最终答案,彻底替代传统“问题→答案”的直接输出模式,让推理过程可追溯、可解释。对于小白而言,可简单理解为“做数学题一步一步写演算过程”,是最容易上手、最易落地的基础框架。核心关键词:线性单链、分步推导、无外部交互、纯思维推理。

youmaob的博客 1327

WINCC7.3破解文件

WINCC7.3硬件够破解文件,有需要的下载!WINCC7.3硬件够破解文件,有需要的下载!

ReAct 与 Chain-of-Thought(CoT):大模型推理与智能体框架详解

React 是 Google 与 Princeton 团队在 2022 年提出的一种基于提示的智能体(Agent)框架。它通过交替进行和的循环,让大模型在解决复杂问题时能够进行外部工具调用(如搜索、各种 API),并基于工具反馈更新推理状态,从而实现多步、可交互的问题求解。让大模型在解决问题时,显式交替输出 Thought,形成一个的推理-执行循环。期间涉及对外部环境的感知(通过工具调用获取真实世界信息)以及对问题状态的持续更新。

weixin_43507232的博客 1072

Learn Prompt-Prompt 高级技巧:Agents 组件详解

在以LLM驱动的Agent系统中,LLM扮演着Agent的大脑角色,并辅以几个关键组件: 规划:LLM能够进行全面的规划,不仅仅是简单的任务拆分。它可以评估不同的路径和策略,制定最佳的行动计划,以实现用户给出的目标。 记忆:LLM具有记忆功能,它可以存储和检索过去的信息和经验。这使得它能够在处理用户查询时,利用之前学到的知识和经验,提供更准确和个性化的答案。 工具使用:LLM熟练掌握各种工具和资源,能够灵活运用它们来支持任务的完成。它可以利用搜索引擎、数据库、API等工具,获取和整理相关信息,以满足用户的

xiaoshun007的专栏 1978

大语言模型提示词技术:CoT、ReAct与DSP详解

摘要:CoT、ReAct和DSP三大提示词工程技术正在革新人机协作模式。CoT通过分步推理提升复杂任务的准确性,ReAct结合工具调用实现动态问题解决,DSP则让模型自主规划任务流程。这些技术不仅增强了AI系统的可靠性与可解释性,更推动了可信AI的发展。随着技术进步,自适应提示和多模型协同等创新模式将成为未来方向,而掌握这些核心提示词技术将成为开发者释放大模型潜能的关键。 (150字)

Q2024107的博客 992

复杂任务链式Prompt设计实战:CoT与ReAct范式落地

CoT 不仅仅是一种 Prompt 技巧,它是一种将“计算过程显式化”的策略。传统 Prompt是System 1(快思考):依赖直觉、联想,迅速但易错。CoT 范式是System 2(慢思考):依赖逻辑、演算,缓慢但精准。核心原理:通过引导模型生成更多的 Token(推理步骤),实际上是强迫模型**消耗更多的计算资源(FLOPs)**来处理当前问题,将隐式的思维过程转化为显式的文本流。ReAct(Reasoning + Acting)是CoT(思维链)的进阶版。如果说 CoT 是让模型在内部世界。

831
上一篇: 收藏 | 程序员小白必看:如何设计可控的多轮对话系统(附大模型学习资源)
下一篇: 掌握大语言模型(LLMs):从入门到精通(小白程序员必备,收藏学习)
SQL11192001
博客等级 码龄1年 0粉丝 21原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符  | 博主筛选后可见
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值