轻松玩转DeepSeek-V3:分布式推理部署实践指南

快速体验

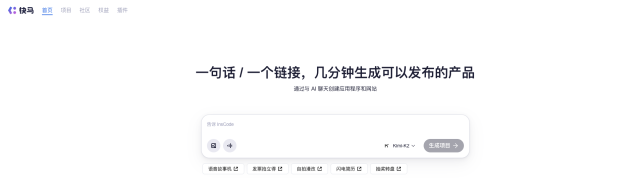
  1. 打开 InsCode(快马)平台 https://www.inscode.net
  2. 输入框输入如下内容
    帮我开发一个DeepSeek-V3部署演示系统,帮助开发者快速体验6710亿参数大模型的分布式推理能力。系统交互细节:1.展示模型基本信息 2.提供API调用示例 3.演示问答交互流程,注意事项:需要确保GPU资源充足。
  3. 点击'项目生成'按钮,等待项目生成完整后预览效果

示例图片

分布式推理部署全流程解析

  1. 环境准备阶段是成功部署的关键。需要特别注意GPU资源规划,建议使用H100级别的显卡16块以上,搭配512GB内存和1TB存储空间。这些硬件配置是为了满足DeepSeek-V3模型的6720亿参数和642GB模型文件的运行需求。

  2. Kubernetes集群搭建需要重点关注kubectl工具的配置。建议在开始前先熟悉基本的Kubernetes命令操作,特别是namespace创建和资源监控相关指令。这能为后续的集群管理打下良好基础。

  3. KubeRay作为分布式计算框架,其operator安装需要特别注意版本匹配问题。1.2.2版本经过验证是最稳定的选择。安装完成后,可以通过helm命令随时查看和调整集群状态。

  4. 模型下载环节是最耗时的步骤。使用huggingface-cli工具下载时,建议在网络条件良好的环境下进行,并做好长时间等待的准备。可以考虑使用--resume-download参数来应对可能的网络中断情况。

  5. 服务暴露配置中,ServiceExporter是最关键组件。它能够将内部服务映射到外部可访问的地址,但要注意每个ServiceExporter只能暴露一个端口。创建完成后,需要仔细检查返回的访问URL是否正确。

  6. 模型加载阶段预计需要40-50分钟,这个过程中可以通过监控GPU使用情况来判断加载进度。使用vLLM服务时,各种参数如--tensor-parallel-size需要根据实际硬件配置进行调整。

  7. API调用测试是最后的验证环节。提供的Python示例代码可以直接用于测试服务是否正常,但要注意base_url需要替换为实际的ServiceExporter地址。建议先用简单的问答测试基本功能。

实际体验建议

在InsCode(快马)平台上体验这类大模型项目时,我发现几个实用技巧:首先可以先用小规模模型测试整个流程,确认无误后再切换到完整模型;其次要善用平台的实时预览功能,快速验证各个阶段的输出结果。
示例图片

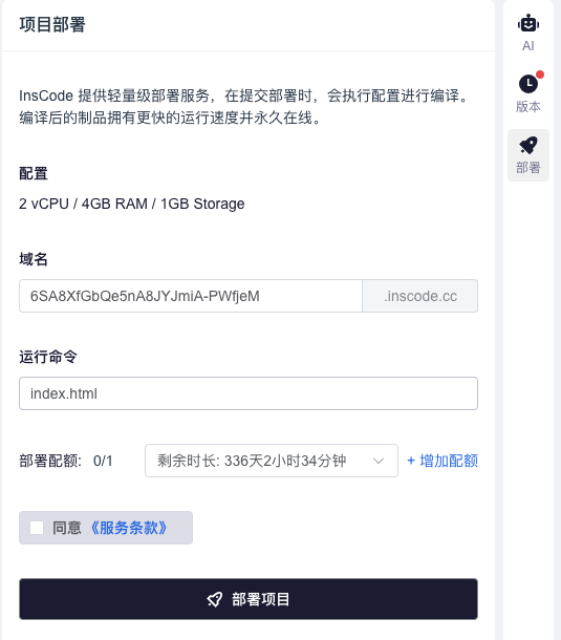
对于资源需求如此大的项目,平台的一键部署功能特别实用,省去了繁琐的环境配置过程。整个部署流程从开始到完成可能耗时较长,建议分阶段进行,每个步骤确认无误后再继续下一步。

相关推荐

2025年第十六届蓝桥杯省赛C/C++大学B组 个人题解

也是写了写部分题解,朱波也是狠狠水了个省二┭┮﹏┭┮,毕竟许多算法知识没怎么学。

2301_80173664的博客 2436

DeepSeek-V3分布式推理与高效并行机制全解读

本文系统梳理DeepSeek-V3在分布式推理与高效并行方面的架构设计与工程实现,结合源码与实际案例,帮助开发者深入理解其分布式推理原理、并行机制与工程落地方法。文中配有架构图、流程图、思维导图、甘特图、饼图等多种可视化图表,并提供详细的Python代码示例与最佳实践建议。DeepSeek-V3通过高效的分布式与并行机制,极大提升了大模型推理的可扩展性与性能。掌握其分布式推理原理与工程实现,有助于开发者在实际业务中高效落地AI大模型应用。

加入“Super Entity”,与全能开发团队共探AI智能体与数字人项目,开启前沿技术之旅。 1238

海思Hi3559A/CV100 DDR4参数配置经验分享

海思Hi3559A/CV100 DDR4参数配置方法 Hi3559AV100 DDR4 驱动配置说明 1.1 Hi3559AV100 DDR4 CLK/AC 驱动配置方法 寄存器地址 DDR PHY0:0x1206d0bc DDR PHY1:0x1206f0bc 寄存器描述 − Bit[5:3]:CLK 驱动 − Bit[14:12]:2T 驱动 − Bit[20:18]:1T 驱动 驱动大小定义 − 000:Disable − 001:240ohm − 010: 120ohm − 011:80ohm −

WeChat_zhanggong345的博客 2883

一文教你如何本地部署玩转DeepSeek-V3,免费体验100度算力包跑通!

只需三步,免费体验100度算⼒包就能完成DeepSeek-V3的私有化部署!

weixin_46880696的博客 9万+

PSF(点扩散函数)与去卷积算法消除图像模糊

本文旨在总结图像处理中使用去卷积的传统方法来进行图像去模糊的相关知识。

m0_53607446的博客 6017

如何在R语言中使用Logistic回归模型

在日常学习或工作中经常会使用线性回归模型对某一事物进行预测,例如预测房价、身高、GDP、学生成绩等,发现这些被预测的变量都属于连续型变量。然而有些情况下,被预测变量可能是二元变量,即成功或失败、流失或不流失、涨或跌等,对于这类问题,线性回归将束手无策。这个时候就需要另一种回归方法进行预测,即Logistic回归。 在实际应用中,Logistic模型主要有三大用途: 1)寻找危险因素,找到某些影响...

weixin_34056162的博客 9552

一文教你如何本地部署玩转 DeepSeek-V3,免费体验 100 度算力包跑通!

DeepSeek-V3就像是AI界的超级英雄,带着6710亿个参数的“智慧”降临人间。自从它开源以来,整个AI圈都为之沸腾了!它在众多测试中表现得异常出色,而且训练成本之低,简直让人拍手称快。

ytt0523_com的博客 6768

rockchip rk3566 android11 网口log报错: DMA engine initialization failed

问题描述:上电初始化前将网口插入,然后上电初始化网口能够正常使用,且能够找到PHY,ifconfig 查看能够有eth0 产生,网口正常使用且能够热插拔,但上电初始化时,不插入网口,就会报DMA engine initialization failed 错误,DMA 初始化的时候出错了。 分析:一般产生这个问题可以认为是GMAC 的工作时钟出问题了。先测量时钟引脚是否有时钟,时钟频率以及幅度等指标是否正常,主要确认以下几个方面: 1.IOMUX 出错,检查时钟脚寄存器值是否正确。 2.时钟方向以及配置

qq_48709036的博客 2万+

K8S部署分布式DeepSeek-r1:671b推理集群

硬件配置服务器数量(台)CPU(核)内存(TB)系统版本RDMA2192/台2.0Ti/台软件工具软件版本备注Kubernetesv1.30.6容器编排引擎v24.9.1自动化管理配置GPU驱动程序Volcanov1.9.0调度引擎560.35.03GPU驱动560.35.03NVSwitch互联CUDA12.6MLNX_OFEDIB驱动NCCL2.21.5GPU多卡通信SGLangLLM推理引擎v0.5.1Open-WebUI。

weixin_59191169的博客 2106

机械臂电机力矩计算

设计 6 轴机械臂时,电机力矩计算是确保机械臂负载能力、运动精度和安全性的核心环节,需围绕和两大核心展开,结合机械臂结构参数(如关节长度、质量分布)、负载需求(如末端负载重量、惯性)和运动参数(如加速度、角速度)逐步推导。

ZPC8210的博客 1858

uniapp [安卓苹果App端] - 实现APP开发后台保活+息屏后台持续运行效果,强制后台保活手机黑屏后进程存活后台保持网络连接或持续定位等功能提供支持(app后台运行休眠仍然可以确保一直运行)

uniapp APP开发后台保活,Uniapp-APP后台保活插件(安卓苹果ios后台保活)保证应用在后台继续运行,uniapp实现app保活 保后台运行 避免系统主动杀进程,如何让安卓APP一直在后台运行?uniapp 安卓 APP 后台持续运行(保活)iOS App后台保活,Android 后台运行白名单实现保活,保活息屏后台运行,uniapp后台保活,uniapp熄屏 后台运行,Android/ios进程保活/息屏后后台保持定位、网络运行,uniapp在android ios保活,挂后台可运行,安卓A

🏆 前端领域优质创作者 1万+

5步轻松实现DeepSeek-Coder-V2分布式推理:多节点集群部署终极指南

DeepSeek-Coder-V2是DeepSeek AI推出的开源代码大模型,支持338种编程语言和128K上下文长度。本文将详细介绍如何通过5个步骤实现DeepSeek-Coder-V2的分布式推理和多节点集群部署,提升代码智能任务的处理效率。无论您是初学者还是经验丰富的开发者,本指南都将帮助您快速搭建高性能的推理环境。 ## 为什么选择DeepSeek-Coder-V2? DeepSee

gitblog_00735的博客 1186

C# WinForm 基于DirectShow.dll编写的程序,可边预览边保存视频,音频和图片

基于微软的DirectShow.dll的二次开发1.自动识别连接的摄像头跟麦克风且可以对其进行选择(默认选中第一个)2.可录制wmv和avi两种格式的视频并且都带有音频,avi可以录制的分辨率和帧数进行选择,wmv默认进行了淸晰度优化如不喜欢可去除代码中有相关提示3.可在预览点开之后进行拍照,也可边录制视频边拍照4.添加了视频和音频的压缩功能(酌情使用)这次二次开发发现C#对DirectShow的相关信息太少,这次做完也不敢藏私共享出来,还望大家指正

解锁DeepSeek-V3推理性能:从参数调优到实战部署的终极指南

DeepSeek-V3作为新一代大语言模型,凭借卓越的推理能力和高效的部署方案,成为开发者构建AI应用的理想选择。本文将带你全面掌握DeepSeek-V3的推理优化技巧,从环境配置到参数调优,再到实战部署,让你轻松释放模型潜能。 ## 🚀 为什么选择DeepSeek-V3?性能优势一目了然 DeepSeek-V3在多项权威 benchmark 中表现卓越,尤其在数学推理、代码生成等复杂任务上

gitblog_00260的博客 956

SAP B1中文培訓教材_SDK

公司内部培训资料,对开发工具 ,DIAPI, UIAPI,Add-ON有详细解说

WINCC7.3破解文件

WINCC7.3硬件够破解文件,有需要的下载!WINCC7.3硬件够破解文件,有需要的下载!

华为云 Flexus+DeepSeek 征文|DeepSeek-V3/R1 商用服务开通全流程与本地部署搭建

华为云 Flexus+DeepSeek 征文|DeepSeek-V3/R1 商用服务开通全流程与本地部署搭建

wei_shuo的博客 1万+

TMS_WebGMaps_1.9.8.0_Full_Source

TMS_WebGMaps_1.9.8.0_Full_Source 全源码 delphi cbuilder

模型并行推理实践:DeepSeek-Coder-V2在多GPU环境中的部署方案

你是否还在为236B参数的DeepSeek-Coder-V2模型部署发愁?单卡显存不足、推理速度缓慢、多GPU协同效率低下——这些问题正在阻碍你充分发挥这款性能超越GPT-4-Turbo的开源代码模型的潜力。本文将系统讲解模型并行推理技术,提供从环境配置到性能优化的全流程解决方案,让你在普通GPU集群上也能流畅运行千亿级代码模型。 读完本文你将获得: - 掌握3种主流模型并行策略的实现原理与适用...

gitblog_00698的博客 1118

DeepSeek-V4-Pro-DSpark多节点部署教程:轻松玩转分布式推理

DeepSeek-V4-Pro-DSpark是一款强大的分布式推理框架,能够帮助用户轻松实现多节点部署,显著提升AI模型的推理效率。本教程将为您详细介绍如何快速搭建DeepSeek-V4-Pro-DSpark的多节点分布式推理环境,让您的AI应用处理能力得到质的飞跃。 ## 准备工作:环境与依赖检查 在开始多节点部署前,请确保所有节点满足以下条件: - 操作系统:Linux(推荐Ubuntu

gitblog_00423的博客 422

DeepSeek-V2.5实战:高效部署与推理指南

本文详解如何基于PyTorch-CUDA镜像快速部署DeepSeek-V2.5,涵盖环境搭建、模型加载、分布式训练及性能优化,助力开发者高效运行大模型并实现生产级推理。

weixin_33480380的博客 975

DeepSeek-V3容器化:Docker部署最佳实践

在当今AI应用快速发展的时代,大型语言模型(LLM)的部署复杂度日益增加。DeepSeek-V3作为拥有671B总参数、37B激活参数的混合专家模型(MoE),其部署面临着多重挑战: - **环境依赖复杂**:需要特定版本的PyTorch、CUDA、Triton等 - **硬件要求高**:需要多GPU并行计算和大量显存 - **配置繁琐**:模型转换、分布式设置等技术门槛较高 - **可移植性差...

gitblog_01116的博客 1106

突破算力瓶颈:DeepSeek-V3的Kubernetes容器化多节点部署方案

你是否正面临大模型推理时的算力不足问题?单节点部署无法发挥DeepSeek-V3的全部性能?本文将带你通过Kubernetes集群实现DeepSeek-V3的多节点推理部署,解决高并发场景下的性能瓶颈,让你轻松应对大规模推理需求。读完本文,你将掌握容器化部署的核心步骤、配置优化技巧以及分布式推理的实现原理。 ## 方案架构概览 DeepSeek-V3的多节点推理部署采用分布式计算架构,通过Ku...

gitblog_00085的博客 819

3种量化方案轻松部署DeepSeek-V3:从671B到消费级显卡的完整指南

想象一下,你刚下载了DeepSeek-V3这个强大的671B参数大模型,却发现需要8张H100显卡才能运行,显存占用超过150GB!😱 这种存储和算力困境是不是让你望而却步?别担心,今天我将为你揭秘如何通过**模型量化技术**,将DeepSeek-V3部署到普通消费级显卡上,同时保持95%以上的推理精度!🚀 DeepSeek-V3作为目前最强的开源MoE模型之一,原生支持FP8混合精度训练,

gitblog_00440的博客 500

如何快速体验DeepSeek-V3:2025年最强大的开源AI模型本地部署指南

DeepSeek-V3是目前最先进的开源混合专家(Mixture-of-Experts)语言模型,拥有6710亿总参数和370亿激活参数,在20项权威AI任务中实现了碾压式领先。本文将详细介绍如何在本地环境部署这款革命性的AI模型,让普通用户也能轻松体验其强大能力。 ## 为什么选择DeepSeek-V3?令人惊叹的性能突破 DeepSeek-V3在多项权威基准测试中展现出令人瞩目的性能,不仅

gitblog_00731的博客 1224

DeepSeek-V3企业级部署实战:如何用消费级显卡实现75%成本优化

在AI大模型应用成本居高不下的今天,DeepSeek-V3以其突破性的架构设计,让普通企业也能在消费级硬件上实现高性能部署。本文将详解如何通过DeepSeek-V3的优化配置,在保证90%+推理精度的同时,将硬件成本压缩75%,让中小企业也能轻松拥抱大模型技术。 ## 为什么选择DeepSeek-V3?性能与成本的完美平衡 DeepSeek-V3在多项权威 benchmark 中展现出惊人的性

gitblog_00976的博客 1170

DeepSeek-V3服务化部署:构建企业级AI推理API的完整方案

想要将强大的DeepSeek-V3大语言模型转化为可用的企业级AI推理服务吗?🤔 本文为您提供完整的DeepSeek-V3服务化部署指南,帮助您快速构建稳定、高效的AI推理API,让您的企业应用轻松接入6710亿参数的先进AI能力!🚀 DeepSeek-V3是深度求索于2024年12月发布的开源大语言模型,采用创新的混合专家(MoE)架构,在数学推理、代码生成和知识理解等任务中表现出色。通过

gitblog_01058的博客 511

AI大模型部署成本降低75%:DeepSeek-V3轻量化技术实战指南

DeepSeek-V3作为新一代开源大模型,采用创新的混合专家(MoE)架构,在保持671B总参数规模的同时仅激活37B参数进行推理,实现了性能与效率的完美平衡。本文将详细介绍如何通过其轻量化技术将部署成本降低75%,让普通开发者也能轻松驾驭千亿级AI模型。 ## 一、为什么选择DeepSeek-V3轻量化部署? 传统大模型部署面临两大痛点:高昂的硬件成本和复杂的技术门槛。DeepSeek-V

gitblog_00490的博客 1004

DeepSeek-V4-Flash-DSpark多节点部署教程:轻松实现分布式百万Token处理

DeepSeek-V4-Flash-DSpark是一款高性能AI模型,支持分布式部署以处理百万级Token任务。本教程将详细介绍如何通过多节点配置实现高效的分布式推理,让普通用户也能轻松搭建企业级AI服务。 ## 🌟 为什么选择多节点部署? 随着AI模型规模的增长,单节点往往难以满足大吞吐量和低延迟的需求。DeepSeek-V4-Flash-DSpark通过**分布式推理**技术,将计算任务

gitblog_00603的博客 400

昇腾多机推理极速上手:10倍简化的 DeepSeek R1 超大规模模型部署

昇腾多机推理太复杂?易出错?试试 GPUStack

GPUStack的博客 1310
上一篇: 数据结构核心知识点速查手册
下一篇: 从零开始掌握计算机原理——《编码》第二版学习心得
RubyWolf84
博客等级 码龄2年 622粉丝 1171原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符  | 博主筛选后可见
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包

打赏作者

RubyWolf84

你的鼓励将是我创作的最大动力

¥1 ¥2 ¥4 ¥6 ¥10 ¥20
扫码支付:¥1
获取中
扫码支付

您的余额不足,请更换扫码支付或充值

打赏作者

实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值