


1. 顺序表
1.1 偶数放前
线性表,顺序结构存储,且每个元素为不相等的整数。
设计把所 有奇数移动到所有偶数前边的算法
(要求时间最少,辅助空间最少)。
思路: 双指针
1.2 元素逆置
设计一个高效算法,
将顺序表 L 中所有元素逆置,
要求算法的空间复杂度为 O(1)。
1.3 元素合并
将两个有序表合并为一个新的有序顺序表,并由函数返回结果顺序表。
1.4 删除最小
从顺序表中删除具有最小值的元素(假设唯一)并由函数返回被删除元素的 值。空出的位置由最后一个元素填补。
1.5 删除x元素 M
已知长度为 n 的线性表 L 采用顺序存储结构,编写一个时间复杂度为 O(n)、空间 复杂度为 O(1)的算法,该算法删除线性表中所有值为 x 的数据元素。
思路1,用 k 记录顺序表 L 中等于 x 的元素个数,边扫描 L 边统计 k,并将不为 x 的元
素前移 k 位,最后修改 L 的长度。对应的算法如下:
解法 2:用 i 从头开始遍历顺序表 L,k 置初始 0。若 L.data[i]不等于 x,则将其存放 在 L.data[k]中,k 增 1;若 L.data[i]等于 x,则跳过继续判断下一个元素。最后顺序表 长度置为 k。对应算法如下。
1.6 删除x-y间元素
设计一个算法,从一给定的顺序表 L 中删除元素值在 x 到 y(x≤y)之间的所有元素, 要求以较高的效率来实现,空间复杂度为 O(1)。
思路 : 为1.5 派生,唯一不同在于是否删除的判断
1.7 数组移位 M
设将 n(n>1)个整数存放在一维数组 R 中。试着设计一个在时 间复杂度和空间复杂度都尽可能高效的算法,将 R 中保存的序列循环左移 p (0<p<n)个位置,即将 R 中的数据由(x0,x1,…,xn-1 )变换为(xp, xp+1,…,xn-1,x0,x1,…,xp-1)。
eg: R = { 0 1 2 3 4 5 6 } , p =2
out : { 2 3 4 5 6 0 1 }
思路:为了不增加额外空间。
可以 步骤1:反转 reverse(R, 0 ,L-1) =>{ 6 5 4 3 2 1 0 }
步骤2:分别反转 reverse(R, 0 ,L-p-1) ,reverse(R, L-p ,L-1)
=> {2 3 4 5 6 } + {0 1}
2. 链表
2.1 有序链表合并I
将两个递增的有序链表合并为一个递增的有序链表。要求结果链表仍使用原 来两个链表的存储空间,不另外占用其他的存储空间。表中不允许有重复的数据。
2.2 有序链表合并II
将两个非递减的有序表合并为一个非递增的有序表。要求结果链表仍然使用 原来两个链表的存储空间,不占用另外的存储空间。表中允许有重复的数据。
2.3 有序链表交集
已知两个链表 A 和 B 分别为两个集合,其元素递增排列。请设计一个算法,
用于求出 A 与 B 的交集,并存放在 A 链表中。
2.4 有序链表差集 M
已知两个链表 A 和 B 分别表示两个集合,其元素递增排列。请设计两个算法 求出两个集合 A 和 B 的差集(即仅由在 A 中出现而不在 B 中出现的元素所构成 的集合),并且以同样的形式存储,同时返回该集合的元素个数。
2.5 单链表 L 中删除一个最小值结点
编写在带头结点的单链表 L 中删除一个最小值结点的高效率算法(假设最 小值结点是唯一的)。
2.6 单链表删除X元素
在带头结点的单链表 L 中,删除所有值为 x 的结点,并释放其空间,假设值 为 x 的结点不唯一,试编写算法实现上述操作。
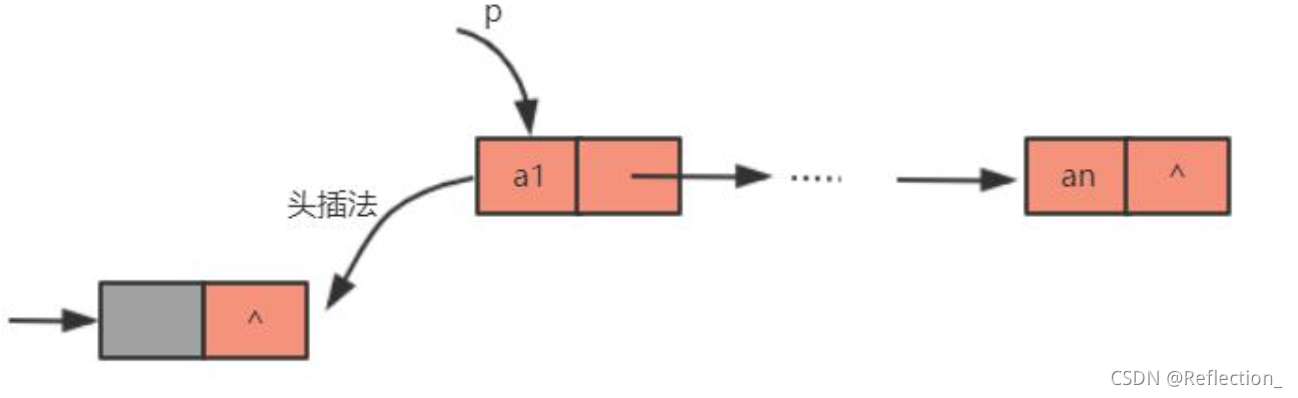
2.7 单链就地逆置 M
试编写算法将带头结点的单链表就地逆置,所谓“就地”是辅助空间复杂度为 O(1)。
思路:将头结点摘下,然后从第一结点开始,一次插入到头结点的后面(头 插法建立单链表),直到最后一个结点为止,这样就实现了链表的逆置,如下图 所示。
2.8 奇偶分链
将一个带头结点的单链表 A 分解为两个带头结点的单链表 A 和 B,使得 A 表 中中含有原标中序号为奇数的元素,而 B 表中含有原表中序号为偶数的元素, 且保持其相对顺序不变。
2.9 交替分链
设 C = {a1,b1,a2,b2,…,an,bn}为线性表,采用头结点的 hc 单链表存放, 设计一个就地算法,将其拆分为两个单链表,使得 A = {a1,a2,…,an},B = {bn,…, b2,b1}。
2.10 正负分链
设计算法将一个带头结点的单链表 A 分解为两个具有相同结构的链表 B 和 C,其中 B 表的结点为 A 表中小于零的结点,而 C 表中的结点为 A 表中值大于 零的结点(链表 A 中的元素为非零整数,要求 B、C 表利用 A 表的结点)。
【变式例题】
设有一个带头结点的单链表,设计一个算法:
void split(LinkList *hc, LinkList *&ha, LinkList *&hb, ElmeType x, ElemType x)
将 hc 拆分为两个带头结点的单链表 ha 和 hb,其中 ha 的所有结点值均大于等于 x 且小于等于 y,hb 为其他结点。
2.11 单链最大元素
设计一个算法,通过一趟遍历确定长度为 n 的单链表中值最大的结点,返回 该结点的数据域。
【思路】: 指针 pmax 记录值最大的结点的 位置
2.12 删除mink-maxk间元素
设计一个算法,删除递增有序表中值大于 mink 且小于 maxk(mink 和 maxk 是给定的两个参数,其值可以和表中的元素相同,也可以不同)的所有元素。
2.13 去掉重复元素
在一个递增有序的线性表中,有数值相同的元素存在。若存储方式为单链表,
设计算法去掉数值相同的元素,使表中不再具有重复的元素。
2.14 元素分类
已知由单链表表示的线性表中,含有 3 类字符的数据元素(如:字母字符、数字 字符和其他字符),试编写算法构造 3 个以循环链表表示的线性表,使每个表中只含 同一类的字符,且利用原表中的节点空间作为这三个表的节点空间,头节点可另辟 空间。
【思路】 带头循环链表 可用头插入法
2.15 判断
已知带头节点的循环单链表 L 中至少有两个节点,每个节点的两个字段为 data 和 next,其中 data 的类型为整型。试设计一个算法判断该链表中每个元素的 值是否小于其后续两个节点的值之和。若满足,则返回 true;否则返回 false。
【注意】 带头循环链表 的遍历
//带头循环链表 的遍历
while(p->next->next != L) {

}
2.16 LocateNode 和 动态有序频度
有一个双链表 L,每个节点中除有 prior、data 和 next 三个域外,还有一个 访问频度域 freq,在链表被起用之前,其值均初始化为零。每当进行 LocateNode(L,x)运算时,令元素值为 x 的节点中 freq 域的值加 1,并调整表中节 点的次序,使其按访问频度的递减序排列,以便使频繁访问的节点总是靠近表头。 试写一符合上述要求的 LocateNode 运算的算法。
有复杂度
int {
*L, *pre;
//找到 data //
x)
LocateNode(DLinkList
*p =
p = if(p ==
&&
x
p;
while(p!=NULL
return 0; else
{ //
pre =
if(pre != L)
//频度 freq +1
//pre 为 p 的前驱结点
p->freq++;
更多计算机考研资料,请关注微信公众号:抓码计算机考研
  对应算法如下。
 if(p->next
ElmeType
  DLinkList
L->next,
  p->data!=x)
  p->next;
   NULL)
域值为
 如果没有找到,返回
的结点
  找到这样的结点
 p->prior;

{
pre =
//找到 pre 结点
while(pre != L &&
< p->freq) //删除结点 p
pre->freq

p->prior->next
pre->prior;
 =
p->next;

!=
NULL)
  p->next
p->next->prior
= p->prior;
//将结点 p 插入到 pre 结点之后

=
pre->next;

if(pre->next
= p; = p;
= pre; }
return 1; }
}
2.17 查找链表中 倒数第 k 个位置上的结点 M
已知一个带有表头结点的单链表,假设该链表只给出了头指针 list。在不改变链表的前提下,请设计一个尽可能高 效的算法,查找链表中 倒数第 k 个位置上的结点( k 为正整数)。若查找成功, 算法输出该结点的 data 域的值,并返回 1;否则,只 返回 0
【算法思想】 双指针
定义指针 p 和 q,初始化指针时均指向单链表的首元结点。首先将 p 沿链表移动 到第 k 个结点,而 q 指针保持不变,这样当 p 移动到第 k+1 个结点时,p 和 q 所 指结点的间隔距离为 k。然后 p 和 q 同时向下移动,当 p 为 NULL 时,q 所指向 的结点就是该链表倒数第 k 个结点。(典中典)
时间上 只用了 n次时间 !!!!
2.18 链表环路判断 M
给定一个链表,判断链表中是否有环。如果有环,返回 1,否则返回 0。

【算法思想】 (双指针) 对于链表找环路问题,有一个通用的解法——快慢指针(Floyd 判圈法)。
快慢指针(Floyd 判圈法):
快慢指针遍历链表,快指针步距为 2,慢指针步距为 1,如果链表带环,两指针 一定会在环中相遇。
1、判断极端条件,如果链表为空,或者链表只有一个结点,一定不会带环,直 接返回 NULL。
2、创建快慢指针,都初始化指向头结点。因为快指针每次都要步进 2 个单位, 所以在判断其自身有效性的同时还要判断其 next 指针的有效性,在循环条件中将两语句逻辑与并列起来。
初始化慢指针 slow = head,每次向后走一步;
初始化快指针 fast =head->next,每次走两步,每走一步判断一次。 如果存在环, fast 和 slow 必定会相遇。
3. 栈 队列
3.1 回文判断 M
回文是指正读反读均相同的字符序列,如“abba”和“abdba”均是回文, 但“good”不是回文。试写一个算法判断给定字符序列是否是回文。(提示: 将一半字符入栈。)
【算法思想】 将字符串前一半入栈,然后,栈中元素和字符串后一半比较。
即将第一个出 栈元素和后一半串中第一个字符比较,若相等,则再出栈一个元素与后一个 字符比较,依次类推,直至栈空,在这种情况下可判断该字符序列是回文。 如果出栈元素与串中的字符进行比较时出现不等的情况,则可判断该字符序 列不是回文。
3.2 循环队列实现
假设以数组 Q[m]存放循环队列的元素,同时设置一个标志域名 tag,以 tag == 0 和 tag == 1 来区别队头指针(front)和队尾指针(rear)相等时,队列状态为 “空”还是“满”。试编写与此结构相应的插入(EnQueue)和删除(DeQueue) 算法。
【算法思想】
在循环队列中,增设一个 tag 类型的整型变量,进队时置 tag 为 1,出队时置 tag
为 0(因为入队操作可能导致队满,只有出队操作可能会导致队空)。队列 Q 初
试时,置 tag == 0,front == rear == 0。这样队列的 4 要素如下:
3.3 括号匹配
设计一个算法判断输入的表达式中括号是否配对(假设只含有左、右圆括号)
3.4 三种括号的匹配
【课后变式习题】假设表达式中允许包含 3 种括号:圆括号、方括号和大括 号。编写一个算法判断表达式中的括号是否正确匹配。
4. 树 与 二叉树
4.1 二叉树遍历
1 先序 递归遍历 与 非递归遍历
2 中序 递归遍历 与 非递归遍历
3 后序 递归遍历 与 非递归遍历
4 层次遍历算法
PS:
1反向层次遍历、
2求二叉树高度、
3求二叉树宽度、
4判断完全二叉树。
4.2 二叉树的自下而上、从右到左的层次遍历算法。 M
二叉树的自下而上、从右到左的层次遍历算法。
【思路】 需要 队列
1把根结点入队;
2把一个元素出队列,遍历这个元素;
3依次把这个元素的左孩子、右孩子入队列;
4若队列不空,则调到2,否则结束。
4.3 二叉树高度
设二叉树采用二叉链表的存储结构,试着编写非递归算法二叉树的最大 高度。
4.4 二叉树宽度
计算二叉树的最大宽度(二叉树的最大宽度是指二叉树所有层中结点个 数的最大值)
4.5 判断完全二叉树
二叉树按二叉链表形式存储,写一个判别二叉树是否是完全 二叉树的算法。
【算法思想】根据完全二叉树的定义,具有 n 个结点的完全二叉树与满二叉树中 编号 1~n 的结点一一对应。(注:空树也是完全二叉树)
层次遍历 将所有结点加入队列(包含空结点)。
遇到空结点时,查看其后是否有非空结点。若有,则二叉树不是完全二叉树。
(用 二叉树的递归算法设计策略 )
4.6 计算节点数
试设计一个算法,计算一棵给定二叉 树的所有节点数。
4.7 计算叶子数
假设二叉树采用二叉链存储结构存储,设计一个算法计算一棵给定二叉 树的所有叶子节点个数。
4.8 双分支节点数
假设二叉树采用二叉链存储结构存储,设计一个算法计算一棵给定二叉树的 所有双分支节点。
4.9 寻找最小节点
假设二叉树采用二叉链存储结构存储,设计一个算法求其中最小值的节点值。
4.10 所有节点和
假设二叉树采用二叉链存储结构存储,所有节点的值为正整数,设计一 个算法求所有节点值之和。
4.11 x节点个数
假设二叉树采用二叉链存储结构存储,设计一个算法求其中节点值为 x 的节点个数
4.12 递归 高度
假设二叉树采用二叉链表存储结构,设计一个递归算法求二叉树的高度
4.13 求双亲节点
二叉链存储结构,设计一个算法
void findparent(BTNode*b,ElemType x,BTNode *&p)
求指定值为 x 的节点的双亲 节点 p。
【变式训练】
设二叉树 T 采用二叉链表存储结构,根结点用 t 指示,设计一 个算法,求指针 p 所指结点的双亲结点。
【变式训练】
假设二叉树采用二叉链存储结构,设计一个算法输出值为 x
的结点的所有祖先。
4.14 二叉树左右交换 M
假设二叉树采用二叉链存储结构,设计一个算法把树 b 的左、右子树进行交换。要求算法的空间复杂度为 O(1)。
【算法思想】本题直接交换二叉树 b 的左、右子树,其递归模型如下(基于
后序遍历算法)。
【相似二叉树】
假设二叉树采用二叉链存储结构,设计一个算法判断两棵二 叉树是否相似。所谓二叉树 bl 和 b2 相似指的是 bl 和 b2 都是空的二叉树; 或者 bl 和 b2 的根结点是相似的,以及 b1 的左子树和 b2 的左子树是相似的, 并且 bl 的右子树与 b2 的右子树是相似的。
4.15 X结点 层号
假设二叉树采用链式存储结构进行存储,设计一个算法,求二叉树 b 中值为 x 的结点层号
4.16 先序的 第 i 个元素
假设二叉树采用二叉链存储结构存储,设计一个算法,求先序遍历序列中第k(1≤k≤二叉树中节点个数)个节点的值。
ps : 也可以非递归,用辅助栈
4.17 中序的 第 i 个元素
假设二叉树采用二叉链存储结构存储,设计一个算法,求中序遍历序列中第 k(1≤k≤二叉树中节点个数)个节点的值。
4.18 后序的 第 i 个元素
假设二叉树采用二叉链存储结构存储,设计一个算法,求后序遍历序列中第 k(1≤k≤二叉树中节点个数)个节点的值。
4. 19 带权路径长度
二叉树的带权路径长度(WPL)是二叉树中所有结点 的带权路径长度之和。给定一棵二叉树 T,采用二叉链表存储,结点结构为
left | Weight | right
其中叶结点的 weight 域保存该结点的非负权值。设 root 为指向 T 的根结点的指 针,请设计求 T 的 WPL 的算法,要求“
(1)给出算法的基本设计思想。
(2)适用 C 或 C++语言,给出二叉树结点的数据类型定义 (3)根据设计思想,采用 C 或 C++语言描述算法,关键之初给出注释。
4.20 表达式树转换中缀表达式
设计一个算法,将给定的表达式树(二叉树)转换为 等价的中缀表达式(通过括号反映操作符的计算次序)并输出。例如,当下列的 两棵表达式树作为算法的输入时:
思路: 中顺便利基础上 加上括号
5. 图
- 设计一个算法,判断一个无向图 G 是否为一棵数。若是一棵树,则算法返回 true,否则返回 false.
- 写出图的深度优先搜索 DFS 的非递归算法(图采用邻接表存储形式)。
- 分别采用基于深度优先遍历和广度优先遍历算法判别以邻接表方式存储的有 向图中是否存在有顶点 Vi 到顶点 Vj 的路径(i≠j)。
- 假设图 G 采用邻接表存储,设计一个算法,求不带权无向连通图 G 中从顶 到 u 到顶点 v 的一条最短路径。
- 设计一个算法,求不带权无向连通图 G 中距离顶点 v 最远的一个顶点(所谓
最远就是到大 v 的路径长度最大) - 假设图采用邻接表存储,分别写出基于 DFS 和 BPS 遍历的算法来判别顶点 i 和顶点 j (i≠j)之间是否有路径。
- 假设图 G 采用邻接表存储,设计一个算法,判断无向图 G 是否连通。若连通
则返回 1;否则返回 0。 - 假设图 G 采用邻接表存储,设计一个算法,判断无向图 G 中任意两点之
6. 查找
6.1 折半查找非递归算法(二分查找)
6.2 折半查找递归算法
6.3 判断二叉排序树的
思路1 定义; 左子树关键字比根结点关键字 小,右子树的关键字比根结点的关键字大,一旦有不满足条件则可判断不是二叉 排序树。
思路2 中序遍历 前小于后
6.4 排序树数据值≥x
请写出递归算法,从小到大输出二叉排序树中所有 数据值≥x 的结点的数据。要求先找到第一个满足条件的结点后,再依次输出其他 满足条件的结点。
6.5
已知二叉树 T 的结点形式为(llink, data, count, rlink),在树中查找值为 X 的结 点,若找到,则记数(count )加 1;否则,作为一个新结点插人树中,插入后仍为二叉 排序树,写出其非递归算法。
6.6 平衡判断
利用二叉树遍历的思想设计一个判断二叉树是否为平衡二叉树的算法。
6.7 平衡因子
设计一个算法,计算一棵 AVL 树中所有节点的 bf(平衡因子)值
6.8 知平衡因子 求高度
假设一棵平衡二叉树的每个结点都表明了平衡因子 b,试设计一个算法,求平衡二叉树的高度。
8.9 折半查找(page78)
线性表(a1,a2,a3,…,an)中元素递增有序且按照顺序存储于计算机内。要求设 计一个算法完成:
(1)用最少的时间在表中查找数值为 x 的元素。
(2)若查找到将其与后继元素位置交换。
(3)若找不到将其插入表中并使表中元素仍然递增有序。
7. 排序
7.1 快排 M
7.2 快排应用 M
编写算法,对 n 个关键字取整数值的记录序列进行整理, 以使得所有关键字为负值的关键字排列在关键字为非负值的记录之前,
要求:
(1)采用顺序存储结构,至多使用一个记录的辅助存储空间
(2)算法的时间复杂度为 O(n)
【思路】
此题目借助快速排序中子表划分的算法思想对表中的数据进行划分。附设两个指 针 low 和 high,初始时分别指向表的上界和下界。
7.3【变式例题】
设有一组初始记录关键字序列(K1,K2,…,Kn),
要求设计一个算法能够在 O(n)的时间复杂度内将线性表划分成两部分,其中左半部分的每个关键字均小于 Ki,右半部分的每个关键字均大于等于 Ki。

 1031


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


