《数据挖掘》- 房价数据分析

kaggel数据分析竞赛--房价预测 ~~~~~~~~特征降维,特征太多,需要特征筛选,为避免多重共线问题。#----------------------------提交最终预测---------------------------------#---------------------------------四、数据建模---------------------------#-------------------------三、特征工程----------------------------- 阅读详情

采用的技术

链家网有反爬机制,频繁请求可能会被封IP

1. Python编程语言

作用:Python是一种高级、解释型、通用的编程语言,以其简洁的语法和强大的生态系统著称。
特点:
易读性:Python代码接近自然语言,适合快速开发和维护。
丰富的库支持:拥有大量第三方库(如aiohttp、requests、parsel),适合各种应用场景。
跨平台:可在Windows、Linux、macOS等系统上运行。
适用场景:数据抓取、数据分析、Web开发、自动化脚本等。

2. 网络爬虫库

网络爬虫库是专门用于从网页上提取数据的工具。本项目使用了以下库:

  • a) aiohttp
    作用:基于asyncio的异步HTTP客户端/服务器框架,用于高效发送HTTP请求和处理响应。
    特点:
    异步非阻塞:支持高并发请求,适合大规模爬取。
    轻量级:比requests更高效,但学习曲线稍陡。
    支持WebSocket:可用于实时数据抓取。
    适用场景:需要高并发、高性能的爬虫项目。
  • b) requests
    作用:简单易用的HTTP库,用于发送同步HTTP请求。
    特点:
    同步阻塞:每次请求需等待响应,不适合高并发。
    API友好:代码简洁直观,适合初学者。
    功能全面:支持会话(Session)、Cookie、代理等。
    适用场景:小规模爬取或简单API调用。
  • c) parsel
    作用:基于lxml和cssselect的HTML/XML解析库,用于从网页中提取结构化数据。
    特点:
  • CSS选择器/XPath:支持两种方式定位元素,灵活性强。
    高性能:底层依赖lxml,解析速度快。
    Scrapy兼容:与Scrapy框架的Selector API一致。
    适用场景:需要精确提取网页数据的场景。

技术点对比与区别
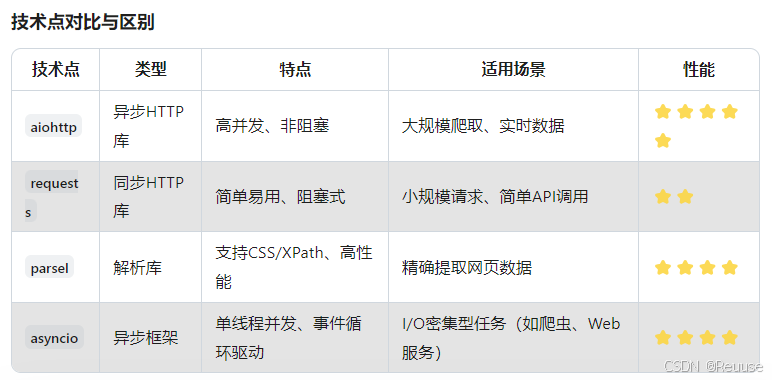
在这里插入图片描述

项目技术栈的协同工作流程

发起请求:
使用aiohttp(异步)或requests(同步)获取网页HTML。
解析数据:
通过parsel的CSS选择器/XPath提取目标数据。
并发控制:
利用asyncio管理多个爬取任务,避免阻塞。
数据处理:
将提取的数据存储到列表或数据库(如Pandas、SQLite)。

请添加图片描述

代码解析

在这里插入图片描述

1. 导入头文件

%matplotlib inline
import pandas as pd
import matplotlib.pyplot as plt
import seaborn as sns
# 设置matplotlib的字体为支持中文的字体
plt.rcParams['font.sans-serif'] = ['SimHei']  # 黑体
plt.rcParams['axes.unicode_minus'] = False  # 用来正常显示负号
  • %matplotlib inline:魔术命令,用于在 Notebook 中内嵌显示 matplotlib 图形。
  • pandas:数据处理库(通常用于数据清洗和分析)。
  • matplotlib.pyplot:Python 最基础的绘图库,plt 是约定俗成的别名。
  • seaborn:基于 matplotlib 的高级统计可视化库,默认风格更美观。
  • rcParams 是 matplotlib 的全局参数配置字典。

2. 读取原始数据

data = pd.read_csv("./data/二手房数据.csv")
data.head()

这一部分就比较简单,所以就不多赘述 请添加图片描述

3. 清洗数据

我们获取到的野生数据也会出现重复或者缺失值,所以在开始统计之前我们需要清洗数据

清洗前:

# 缺失值统计
data.isnull().sum()

# 重复值统计
data.duplicated().sum()

# 获取数值型数据的统计摘要(计数、均值、标准差、最小值、四分位数、最大值)
data.describe()
在这里插入图片描述

# 删除关键数值缺失的行
data = data.dropna(subset=['单价(元/平米)', '总价(万)'])  

# 删除区和位置都缺失的行(地理位置信息很重要)
data = data.dropna(subset=['区', '位置'])
data = data.dropna(subset=['房屋信息'])

4. 数据分割

原始数据中某一列可能包含多个信息,将复杂或复合型数据拆解为结构化字段,以便后续分析和建模

4.1 统计房屋信息的分段数量

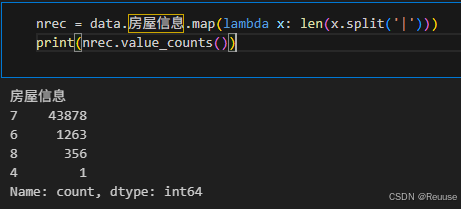
统计 房屋信息 列中每条记录通过 | 分割后的字段数量

# 统计房屋信息的分段数量
nrec = data.房屋信息.map(lambda x: len(x.split('|')))
print(nrec.value_counts())
  • map(lambda x: …):对 房屋信息 列的每个元素应用函数。
  • x.split(‘|’):按 | 分割字符串,返回列表。
  • len():计算列表长度(即分段数量)。
  • value_counts():统计不同分段数量的出现次数。
    在这里插入图片描述
    这里返回的意思是:分成7段的数据有43878条;分成6段的数据有1263条(可能缺失数据);以此类推。那么为了后续的统计,我们就只保留分成7段的所有数据即可
# 只保留字段书数量为7的数据行
data = data[nrec == 7]
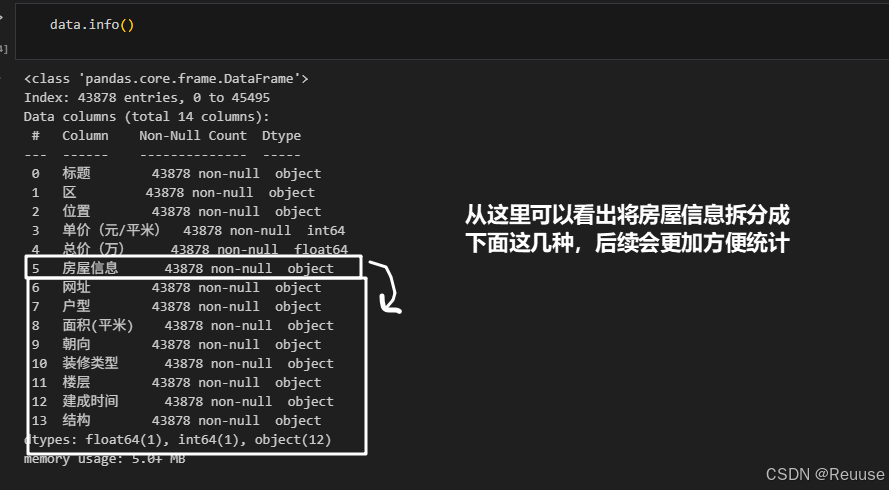
data.info()

4.2 将房屋信息拆分为独立列

将 房屋信息 列按 | 分割为7个独立字段,并赋值到新列

data['户型'] = data.房屋信息.map(lambda x: x.split(' | ')[0])
data['面积(平米)'] = data.房屋信息.map(lambda x: x.split(' | ')[1])
data['朝向'] = data.房屋信息.map(lambda x: x.split(' | ')[2])
data['装修类型'] = data.房屋信息.map(lambda x: x.split(' | ')[3])
data['楼层'] = data.房屋信息.map(lambda x: x.split(' | ')[4])
data['建成时间'] = data.房屋信息.map(lambda x: x.split(' | ')[5])
data['结构'] = data.房屋信息.map(lambda x: x.split(' | ')[6])
data.head()
在这里插入图片描述

4.3 处理面积字段

在后面制图表需要用到房屋面积的数值,但是有些数据里面会出现 xxx.xx平米 在后缀有中文的情况下是不能识别出来的,所以下一步需要将后缀的中文删除

data['面积(平米)'] = data['面积(平米)'].apply(lambda x: float(x.split('平米')[0]))
  • x.split(‘平米’)[0]:按 “平米” 分割字符串,取第一部分(数字)。
  • float():将字符串转为数值类型。

4.4 删除原始房屋信息列

删除已拆分完毕的原始列 房屋信息,避免数据冗余。

data.drop(labels='房屋信息', axis=1, inplace=True)
  • labels=‘房屋信息’:指定要删除的列名。
  • axis=1:表示按列删除(axis=0 为行)。
  • inplace=True:直接修改原DataFrame,不返回新对象。

5. 可视化分析

  • plt.figure() 用于创建一个新的图形/画布
  • figsize=(10, 6) 设置图形的宽度为10英寸,高度为6英寸
  • dpi=150 设置图形分辨率为150 dots per inch (每英寸点数)

5.1 房屋户型数量统计

👉条形图绘制

sns.barplot(x=house_layout_counts.index, y=house_layout_counts.values)
  • sns.barplot() 是 seaborn 库中绘制条形图的函数
  • x 参数指定条形图的x轴数据(户型类别)
  • y 参数指定条形图的高度(各户型数量)
  • seaborn 是基于 matplotlib 的高级可视化库,提供更美观的默认样式和更简洁的API

👉坐标轴调整
✈当x轴标签较长或较多时,旋转可以避免标签重叠

plt.xticks(rotation=90, horizontalalignment='right')
  • plt.xticks() 用于自定义x轴刻度标签
  • rotation=90 将x轴标签旋转90度(垂直显示)
  • horizontalalignment=‘right’ 设置标签右对齐,使显示更整齐

👉 图表保存

plt.savefig('./image/house_layout_distribution.png', dpi=300, bbox_inches='tight')
  • plt.savefig() 用于将图表保存为图像文件
  • dpi=300 设置保存图像的分辨率为300dpi(高于显示分辨率)
  • bbox_inches=‘tight’ 自动调整边界框,避免标签被截断

给出的图片显示如下:
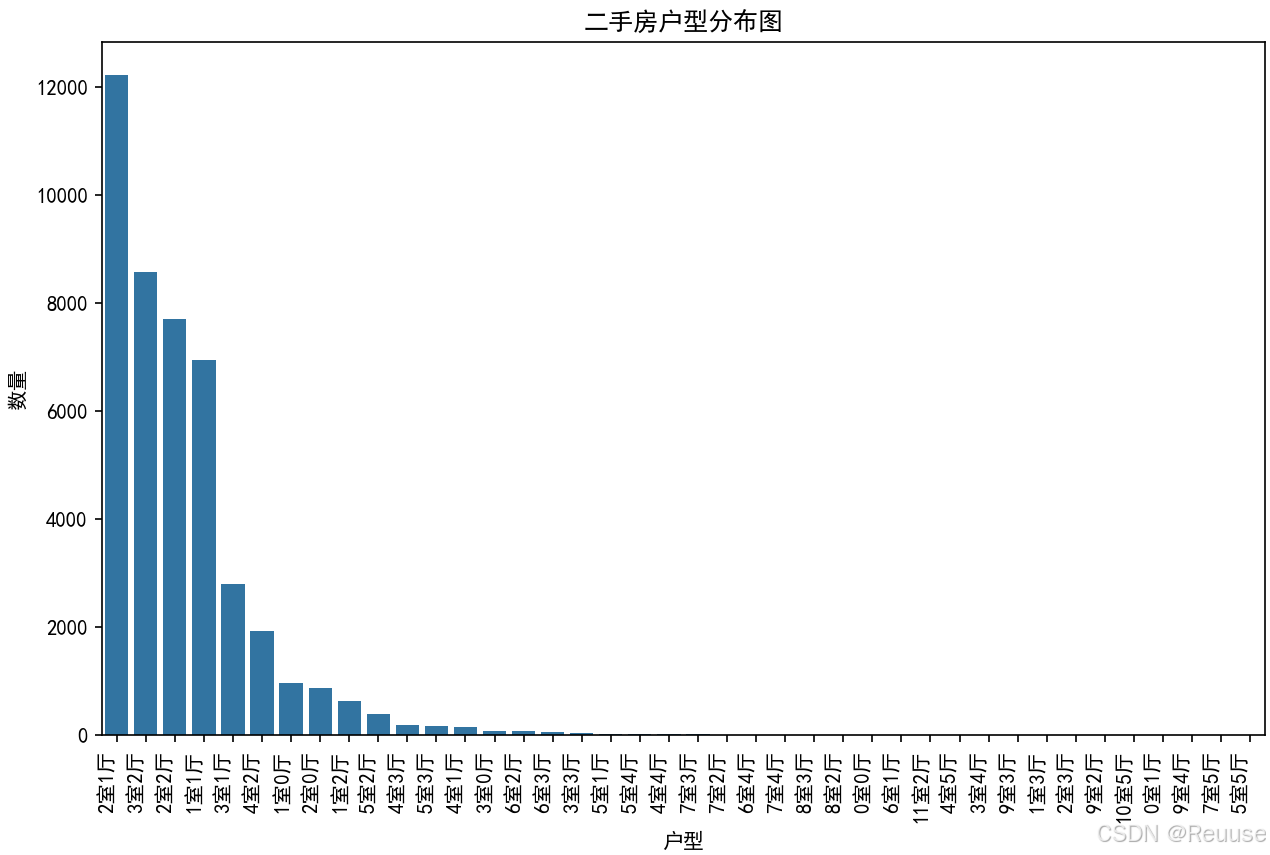
在这里插入图片描述

5.2 房源面积与总价

这段代码主要用于处理和分析二手房数据中的面积与总价关系,并通过散点图进行可视化展示

👉数据类型转换

data['面积(平米)'] = pd.to_numeric(data['面积(平米)'], errors='coerce')
data['总价(万)'] = pd.to_numeric(data['总价(万)'], errors='coerce')
  • pd.to_numeric() 是 pandas 中将数据转换为数值类型的函数
  • errors=‘coerce’ 参数表示当转换失败时(如遇到非数字字符串),将值设为 NaN(Not a Number)

👉 散点图绘制

sns.scatterplot(x='面积(平米)', y='总价(万)', data=data)
  • sns.scatterplot() 是 seaborn 中绘制散点图的函数

5.3 各区二手房平均单价的热力图

👉数据聚合计算

average_price_by_district = data.groupby('区')['单价(元/平米)'].mean().reset_index()
print(average_price_by_district)
districts = average_price_by_district['区'].tolist()
average_prices = average_price_by_district['单价(元/平米)'].tolist()
  • groupby() 是 pandas 的分组聚合函数,按’区’列分组
  • mean() 计算每个分组的平均值
  • reset_index() 将分组结果转换回DataFrame格式
  • tolist() 将Series转换为Python列表,便于后续使用

DataFrame是Python中Pandas库的核心数据结构,是一种二维的、表格型的数据结构,类似于Excel表格或SQL数据库中的表

👉数据重构

pd.DataFrame(average_prices, index=districts, columns=['Average Price (Yuan/M^2)'])
  • 将列表数据重新构建为DataFrame
  • 使用行政区名作为索引(index)
  • 单列数据,列名为Average Price (Yuan/M^2)
  • 这种结构适合热力图输入要求

👉热力图绘制
✈ 热力图适合展示单变量在不同类别上的数值分布

sns.heatmap(
    data=...,  # 数据源
    annot=True,  # 显示数值
    fmt=".0f",  # 数值格式化为整数
    cmap="Reds",  # 红色系颜色映射
    cbar_kws={'label': 'Average Price (元/平米)'}  # 颜色条标签
)
  • annot=True 在每个单元格中显示数值
  • fmt=“.0f” 控制数值显示格式(0位小数)
  • cmap=“Reds” 使用红色渐变表示数值大小
  • cbar_kws 自定义颜色条属性

5.4 不同户型的占比分布

👉数据统计

house_type_counts = data['户型'].value_counts(normalize=True)
  • value_counts() 是 pandas 中统计唯一值出现次数的方法
  • normalize=True 参数返回的是比例而非绝对计数
  • 结果是一个 Series,索引是户型类别,值是对应的占比(0-1之间)
  • 这种统计方式适合展示类别数据的分布比例

👉饼图绘制

plt.pie(
    house_type_counts,  # 数据
    labels=house_type_counts.index,  # 标签
    autopct='%1.1f%%',  # 百分比格式
    startangle=140,  # 起始角度
    colors=plt.cm.tab20.colors  # 颜色方案
)
  • house_type_counts:占比数据
  • labels:每个扇区对应的标签(户型名称)
  • autopct=‘%1.1f%%’:在扇区上显示百分比,保留1位小数
  • startangle=140:从140度开始绘制第一个扇区(顺时针方向)
  • colors=plt.cm.tab20.colors:使用tab20色板的颜色

5.5 不同行政区的修类型分布情况

👉数据统计与透视

total_by_district = data.groupby('区')['装修类型'].value_counts(normalize=True) * 100
pivot_table = total_by_district.unstack(fill_value=0).fillna(0)
  • groupby(‘区’)[‘装修类型’] 按行政区对装修类型分组
  • value_counts(normalize=True) 计算每种装修类型的占比(0-1)
  • *100 将比例转换为百分比(0-100)
  • unstack() 将多级索引的Series转换为DataFrame(装修类型变为列)
  • fill_value=0和fillna(0)确保没有数据的组合显示为0%

👉折线图绘制

for column in pivot_table:
    plt.plot(pivot_table.index, pivot_table[column], marker='o', label=column)
  • 遍历DataFrame的每一列(每种装修类型)
  • plt.plot()绘制折线图,参数包括:
    • x轴数据:区域名称(pivot_table.index)
    • y轴数据:装修占比(pivot_table[column])
    • marker='o’在数据点显示圆形标记
    • label=column设置图例标签

请添加图片描述

聚类分析

为了自动分类相似属性的房源,揭示市场细分结构,帮助理解不同群体的住房需求,评估房价合理性,为买家、卖家及投资者提供定制化信息和策略指导,同时也能洞察市场趋势,优化资源配置,提升决策效率与服务质量。我们对上海市的二手房数据进行聚类分析。
我们使用sklearn库中的KMeans聚类方法来对数据进行聚类工作。Scikit-learn(通常简称为sklearn)是一个开源的机器学习库,它构建于Python编程语言之上,是Python中最广泛使用的机器学习框架之一。
我们选取单价、总价、面积这三个数值型字段进行作为特征。在这之前,我们还需要对这三个字段的数据进行标准化操作。K-means等基于距离的聚类算法依赖于数据点间的距离计算。如果没有标准化,不同特征的量纲和大小可能导致计算出的距离失去实际意义。

数据准备与标准化

from sklearn.cluster import KMeans
from sklearn.preprocessing import StandardScaler

features = ['单价(元/平米)', '总价(万)', '面积(平米)']
X = data[features]
scaler = StandardScaler()
X_scaled = scaler.fit_transform(X)
  1. 数据标准化:使用StandardScaler对数据进行标准化处理(均值为0,方差为1)
  2. 消除不同特征量纲的影响
  3. 使各特征对聚类结果的贡献度相同
  4. fit_transform():计算均值和标准差并立即应用转换

确定最佳聚类数量(肘部法则)

inertias = []
for i in range(1, 11):
    kmeans = KMeans(n_clusters=i, init='k-means++', random_state=42)
    kmeans.fit(X_scaled)
    inertias.append(kmeans.inertia_)

K-means参数:

  1. n_clusters:尝试1到10个聚类
  2. init=‘k-means++’:智能初始化聚类中心,加速收敛
  3. random_state=42:统一随机值,确保结果可复现

请添加图片描述

结论

本数据分析报告通过深入挖掘上海市二手房市场中的户型、单价、面积、总价以及区域分布,并结合聚类分析,揭示了市场的主要特征和潜在趋势。分析结果显示,上海市二手房市场呈现出明显的层次化和差异化特征,主要可分为三类群体:低价小户型、中价中型房、以及高价大户型,且这些群体在地理位置上也表现出特有的分布规律。

后记

本博客主要的代码参考原csdn付费文章——上海二手房数据分析
加上临近期末,于是把这个项目拆开总结成知识点共初学者学习
可以更好的加深对这门课的理解
所需源代码还请支持原作者!


原创不易,还请大家多多支持!
请添加图片描述

二手房数据分析预测系统 今天我们为大家展示一个全方位,多维度的数据分析场景——二手房数据分析预测系统。该系统全面展示了数据分析过程中的数据获取,数据预处理,数据分析,可视化呈现以及分析结果的生成。 阅读详情

相关推荐

GBMLlib(GBase支撑数据挖掘和机器学习)简介

GBMLlib(GBase支撑数据挖掘和机器学习)简介

huixinhuiyismile的博客 507

数据分析与数据挖掘实战案例本地房价预测(716):

原2022 年首届钉钉杯大学生大数据挑战赛练习题目 练习题 A:二手房房价分析与预测解题代码,分享学习 住房一直以来都是人们关心的热门话题,房价也是人们时时刻刻关心的热点。 虽然新房子更加上档次,但是二手房有着现房交易,地段较好,配套设施完善, 选择面更加广泛等优势,因此二手房越来越受到广大消费者的青睐。根据现有二 手房的地段、装修等属性预估该二手房的价格也是买卖双方所关心的问题。因此 通过现有数据,分析并且预测二手房的价格是一项有意义的研究课题。...

shine_Lee_的博客 6909

AdaBoost(下):数据分析 | 数据挖掘 | 十大算法之一

今天我带你用 AdaBoost 回归分析对波士顿房价进行了预测。因为这是个回归分析的问题,我们直接使用 sklearn 中的 AdaBoostRegressor 即可。如果是分类,我们使用 AdaBoostClassifier。另外我们将 AdaBoost 分类器、弱分类器和决策树分类器做了对比,可以看出经过多个弱分类器组合形成的 AdaBoost 强分类器,准确率要明显高于决策树算法。所以 AdaBoost 的优势在于框架本身,它通过一种迭代机制让原本性能不强的分类器组合起来,形成一个强分类器。

weixin_42108731的博客 524

python房价数据挖掘_Python数据分析及可视化实例之帝都房价预测

数据集下载易一网络科技 - 付费文章​www.intumu.com加载数据import pandas as pddf=pd.read_csv("MYUNOI.csv") # "石景山","丰台","朝阳","海淀","东城","西城"df.head()dist roomnum halls AREA floor subway school price 0 chaoyang 1 0 46.0...

weixin_39678089的博客 335

SZTU数科导论实验-第9章-回归算法+流数据分析(选做)

SZTU数科导论实验答案-第9章-回归算法 只有回归算法的答案,无流数据分析的答案

Annabel666的博客 40

PSF(点扩散函数)与去卷积算法消除图像模糊

本文旨在总结图像处理中使用去卷积的传统方法来进行图像去模糊的相关知识。

m0_53607446的博客 6014

kaggle房价预测特征意思_数据分析&&数据挖掘入门:Kaggle房价预测

在人工智能、大数据横行的时代背景下,数据分析以及数据挖掘也变的越来越重要。站得更高,才能走得更远。站在数据的肩上,才能窥探人类未来的方向。下面借助kaggle里房价预测比赛数据,尝试数据分析以及数据挖掘。本文仅小白参考,路过大神勿喷。比赛结果:import numpy as np import pandas as pd import seaborn as sns import matplotlib...

weixin_39929721的博客 447

IC617多线程仿真卡死?手把手教你用TigerVNC替换解决ADE XL Explorer问题(附Manjaro/Centos8实测)

本文针对IC617在Manjaro、CentOS 8等高版本Linux系统中运行ADE XL Explorer进行多线程仿真时出现的卡死问题,提供了详细的诊断与解决方案。文章指出问题根源在于软件内置的旧版VNC组件不兼容,并手把手指导用户通过使用TigerVNC替换原组件来彻底解决,附有在Manjaro和CentOS 8系统上的实测步骤与验证方法。

hill8的博客 774

基于Python的房价数据分析与可视化毕业设计源码

首先收集和整理了某城市的房价数据,然后对数据进行清洗和预处理,接着利用Python中的数据挖掘和机器学习库,对房价数据进行特征提取、数据挖掘和机器学习模型训练。实验法:实验法是一种常用的数据分析方法,通过构建实验环境,收集数据,对房价数据进行处理和分析,以期为房地产市场提供风险预警和决策支持。首先收集和整理了某城市的房价数据,然后对数据进行清洗和预处理,接着利用Python中的数据挖掘和机器学习库,如Pandas、NumPy、Scikit-learn等,对房价数据进行特征提取、数据挖掘和机器学习模型训练。

937

2025年度工业级3D全景相机技术解析选型参考:国产品牌的技术突围与市场格局

本文分析了工业级3D相机在智慧城市和建筑数字化中的应用。通过对比国内外主流设备的技术参数和应用场景,发现国产品牌如众趣科技在性价比和本地化服务方面具有优势,尤其适合大型空间扫描项目;而国际品牌如Faro、Leica则在精度和可靠性上保持领先。建议根据项目需求(如测距范围、精度要求、预算)进行设备选型,综合考虑扫描效率、数据处理能力和系统兼容性。国产品牌已在国内大型基建项目中展现出竞争力,国际品牌则更适合高精度逆向工程和国际化项目。

gxdtgsy的博客 1072

解决vscode无法运行npm命令的问题(cmd可行)

Powershell以及vscode中npm命令使用不了

无痕坚守本心的博客 2749

数据挖掘实战项目——北京二手房房价分析

本次实战项目的主要目的是分析北京二手房房价,项目源自博文:入门Python数据分析最好的实战项目(一)和入门Python数据分析最好的实战项目(二)。本篇文章仅记录博主在学习过程中的思路。 数据分析 首先我们要对数据进行分析,可分为以下几个主要步骤: 导入数据 检查缺失值情况并对表格进行简单处理 数据可视化分析 这里我们重点要讲的是...

weixin_34124939的博客 4139

AFC自动售检票系统与人工智能AI结合的关键应用方案

针对售检票、大客流管理、设备运维及服务优化提供了可落地的技术支持和实现细节,可作为地铁智慧交通项目的实践参考

leijinquan01的博客 1513

基于Python的房价预测系统 爬虫+大屏可视化

房价是一个国家经济水平的重要体现,也是反映居民生活质量和水平的最直接的指标。目前我国住房制度以租售并举形式出现,房屋所有权人通过出售、出租房屋获得租金收入。但是由于房价波动较大,不能及时反映房价变化趋势,需要预测房价来指导市场。研究房产价格走势,可以为房地产价格的调控提供参考依据。本系统通过对网络爬虫的分析,研究58同城网房屋数据,尝试使用Python技术进行开发,将58同城网房产信息和房屋数据尽可能的爬取出来,并对结果进行检测判断,最后可视化分析出来,为用户提供精确的查询结果。

QQ860234001的专栏 2365

YOLOv11 改进策略之 Conv 篇:基于 C2fC 与 RepC_SPELAN4 的性能跃迁教程

某工业质检场景中,采用本文改进模块的 YOLOv11 模型,对微小零件缺陷的检测准确率提升 22%;YOLOv10 提出的 C2fC 模块与 RepC_SPELAN4 结构,是针对特征融合与卷积效率的突破性设计,掌握它们,你就能让自己的 YOLOv11 模型在精度与速度的平衡上实现“质的飞跃”。别再让“模型精度不足”成为你的瓶颈——现在就动手修改代码,让你的 YOLOv11 模型在特征提取与检测效率上实现质的飞跃,用技术实力证明你的 AI 研发能力!中的卷积层为 RepC_SPELAN4。

m0_71589036的博客 97

SAP项目中 Waterfall vs Agile 的深度对比分析背景:方法论的演进SAP项目实施方法论经历了显著的代际更替。早期以 ASAP(Accelerated SAP) 为代表,采用经典瀑

本文对比分析了SAP项目实施中瀑布模型(ASAP)与敏捷方法(SAP Activate)的核心差异。瀑布模型采用线性流程,需求固定但变更成本高;敏捷方法则通过迭代开发实现动态调整,强调最佳实践和用户持续参与。文章指出,SAP系统的复杂性使纯粹敏捷难以实施,需在标准化与定制化间取得平衡。最终建议根据项目特性选择方法论:稳定需求适用瀑布模型,变化频繁则推荐敏捷,而SAP Activate本质上是两者的结构化融合,代表未来趋势。关键在于匹配项目实际需求,而非盲目追随方法论潮流。

金牌架构师 345

基于Python+大数据+SSM南昌房价数据分析系统(源码+LW+调试文档+讲解等)/南昌房价分析/南昌房价数据/南昌房价系统/南昌房产数据分析/南昌房价研究系统/南昌楼市数据分析系统

前端:Spring+SpringMVC+Mybatis后端:大数据数据库:MySQL、SQLServer开发工具:IDEA、Eclipse、Navicat等✌关于毕设项目技术实现问题讲解也可以给我留言咨询!!!SSM 框架的整合使用,为程序设计带来了诸多优势。在开发过程中,Spring 负责整体的架构管理和资源整合,SpringMVC 处理用户请求和业务逻辑,MyBatis 进行数据的持久化操作。三者相互协作,形成了一个高效、稳定的开发体系。

2401_85513329的博客 511

【异常】Hermes Agent调用z.ai接口失败(余额不足)API call failed (attempt 1/3): RateLimitError [HTTP 429]

补充说明:同步尝试解析接口对应网页时,出现“网页解析失败,可能是不支持的网页类型,请检查网页或稍后重试”提示,该提示不影响核心报错排查,仅作为辅助信息。

奶爸的编程之路,也就一周冷个三天 1194

计算机毕业设计之基于Python的二手房房价的数据挖掘与可视化分析

本文基于Python技术框架对二手房房价进行数据挖掘与可视化分析,通过爬虫、Vue和Django构建分析系统。研究采用Pandas进行数据预处理(缺失值/异常值处理),结合NumPy/SciPy进行统计计算,深入分析各特征对房价的影响。系统采用前后端分离架构,包含用户和管理员两大模块,管理员可进行轮播图管理、资讯维护等操作。创新点在于:1)运用Python技术栈实现高效可扩展的分析流程;2)涵盖数据预处理、统计分析、可视化及预测的全方位研究;3)揭示特征变量与房价关系。研究成果为房地产市场分析提供数据支持和

2401_85546897的博客 216

LinePhone3.2.7(android端最新版本) sip客户端

SIP客户端For android:LinePhone3.2.7(最新版本),官网地址:http://www.linphone.org/

汉书HE8,好用的汇编代码编写工具

汉书HE8,好用的汇编代码编写工具早期编写汇编代码所用功能强大

基于python的房价可视化预测系统

这是一个基于Python开发的房价可视化预测系统,主要服务于买房者、卖房者和数据开发者。系统通过爬取房价网站信息和百度API获取周边设施数据,构建数据仓库进行房价分析预测和数据可视化展示。主要功能包括:房屋信息筛选查询、周边设施分析(交通/教育等)、数据导出和未来的房价预测功能开发。采用Echarts可视化库展示数据,支持Docker运行部署。

毕业作品网站 4989

温度PID控制PLC程序

温度PID稳定控制程序,适用于欧姆龙PLC,对其他PLC也具有很大参考价值

我的博客文章汇总

进博客园四年多,从第一篇讨论地图显示的文章到现在,已经有80多篇文章了。此处总结一下写过的文章并作分类,方便大家查看。 革命尚未成功,同志仍需努力! 个人邮箱 buptzym@qq.com 数据分析,编译和模式 用数据说话:北京房价数据背后的数据 《编程语言实现模式》笔记(一)词法和句法分析 数据挖掘工具分析北京房价 (一) 数据爬取采集 数据挖掘工...

weixin_34217773的博客 239

STM32F407中文手册

STM32f407中文手册 本参考手册面向应用开发人员,提供有关使用 STM32F405xx/07xx、STM32F415xx/17xx、 STM32F42xxx 和 STM32F43xxx 微控制器存储器与外设的完整信息。STM32F405xx/07xx、STM32F415xx/17xx、STM32F42xxx 和 STM32F43xxx 构成一个微 控制器系列,各产品具有不同的存储器大小、封装和外设。有关订购信息以及器件的机械与电气特性,请参见数据手册。有关 ARM Cortex™-M4F 内核的信息,请参见《Cortex™-M4F 技术参考手册》。

深度探讨AI人工智能在数据分析中的应用场景

在当今数字化时代,数据如潮水般涌来。我们的目的就是研究如何借助AI人工智能这一强大工具,对海量的数据进行有效分析,挖掘出其中有价值的信息。本文的范围涵盖了AI在数据分析中的各种应用场景,从基础的概念到实际的操作,再到未来的发展。本文首先会介绍AI和数据分析的核心概念,以及它们之间的联系。接着会讲解核心算法原理和数学模型,通过项目实战展示具体的代码实现和应用。然后探讨AI在不同行业的实际应用场景,推荐相关的工具和资源。最后分析未来的发展趋势与挑战,并进行总结和提出思考题。AI人工智能。

AI 原生应用开发的博客 1054

毕设项目分享 基于大数据挖掘分析的北京二手房数据分析

摘要 本项目基于北京二手房房价数据,通过数据分析和可视化方法探索影响房价的关键因素。首先对数据进行预处理,包括缺失值检查、异常值检测和特征工程(如新增单价特征PerPrice)。利用分组统计和可视化工具(如柱状图、箱线图)分析不同区域(Region)的房价分布,发现西城区均价最高(约11万/平),海淀区和朝阳区二手房数量最多。此外,通过回归分析和核密度估计发现Size与Price呈线性关系,但存在异常值(如极小户型高价或超大户型低价)。进一步分析建造年份(Year)与装修条件(Renovation)的关系,

loop_yang123的博客 724

python数据分析和hadoop_Python 数据分析与挖掘的学习路径

很多人反映在学习了Python基础之后无所适从,不知道下一步往哪走。作为较早期的跨界者(土木狗)深有体会。本文将结合上图,为后来者指明方向,可作为参考。在此强调:如果打算依靠Python逃离现有的工作(如土木施工),那就要认真想想自己打算做哪一方面的工作,互联网营销、前端、运维、爬虫、数据分析、数据挖掘、Web开发?强烈建议:直接上拉钩或者Boss直聘,针对性学习更为稳妥。如果打算业余玩玩,那跟着...

weixin_39526651的博客 387

计算机毕业设计之基于Python的武汉房源数据可视化分析系统设计与实现

本文设计并实现了一个基于Python的武汉房源数据可视化分析系统。该系统整合分散的武汉房源数据,通过数据清洗预处理后,利用Python进行房价走势、市场趋势等深度分析,并构建预测模型提供前瞻性参考。系统采用可视化技术直观展示分析结果,帮助购房者、投资者等用户快速理解市场状况。研究成果提升了武汉房源信息透明度,为房地产决策提供数据支持,对行业发展具有实践意义,也可为其他城市数据分析提供参考。系统包含数据可视化大屏等功能模块,有效呈现房源数据详情。

2401_87153198的博客 10
上一篇: 【鱼皮-用户中心】笔记
下一篇: 【前端三件套】最容易掌握的技能
Reuuse
博客等级 码龄3年 611粉丝 72原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包

打赏作者

Reuuse

你的鼓励将是我创作的最大动力

¥1 ¥2 ¥4 ¥6 ¥10 ¥20
扫码支付:¥1
获取中
扫码支付

您的余额不足,请更换扫码支付或充值

打赏作者

实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值