【NLP学习】IMDB 情感分类实战:Word2Vec + 逻辑回归完整解析

人工智能学习路径:从机器学习基础到深度学习与NLP实战 机器学习作为人工智能的核心基础,通过算法让计算机从数据中自动学习规律。其原理涉及监督学习、无监督学习和深度学习等不同范式,通过训练模型实现预测和分类任务。在工程实践中,机器学习技术能够处理复杂数据模式,广泛应用于自然语言处理、计算机视觉和推荐系统等场景。深度学习作为机器学习的进阶分支,特别擅长处理图像、语音等高维数据,而自然语言处理(NLP)则是深度学习的典型应用领域。本文基于机器学习与深度学习的热门技术,系统解析从环境搭建、算法理解到项目实战的完整学习路径,帮助开发者建立扎实的AI工程能力。 阅读详情

​ 在自然语言处理(NLP)入门阶段,如何把文本变成“模型能理解的数字”,往往是第一个真正的门槛。

​ 本文将通过一个完整的实战案例,带你从原始文本出发,使用 Word2Vec 构建词向量表示,并结合逻辑回归(Logistic Regression),完成 IMDB 电影评论的情感分类任务。

​ 整个流程覆盖了从数据预处理到模型评估的完整闭环,适合作为 NLP 特征工程与传统机器学习结合的经典示例。

一、项目背景与任务定义

1.1 任务目标

​ 基于 IMDB 电影评论数据集,判断一条评论的情感倾向:

  • 1:正面(positive)

  • 0:负面(negative)

    这是一个标准的 二分类文本情感分析问题。

1.2 技术方案选择

​ 本文采用的整体技术路线如下:

  1. 使用 NLTK 进行文本分词与停用词过滤
  2. 使用 Gensim 训练 Word2Vec 模型,将词映射为稠密向量
  3. 通过词向量平均的方式,将句子转换为固定长度向量
  4. 使用 逻辑回归 完成情感二分类
  • 为什么选择这个组合?下面做一个简单对比:
方法优点缺点
TF-IDF + 逻辑回归实现简单、可解释性强无法建模词语语义相似性
Word2Vec + 逻辑回归能捕捉语义关系,泛化能力好平均操作会丢失词序信息
BERT + 微调效果最好计算资源消耗大,工程复杂

​ Word2Vec + 逻辑回归 在效果与成本之间取得了不错的平衡,是非常经典、也非常适合入门理解的 NLP 实战方案。

二、环境准备

2.1 依赖安装

pip install numpy pandas tqdm nltk gensim scikit-learn

2.2 NLTK 数据下载

首次运行需要下载分词器与停用词表:

import nltk
nltk.download("punkt")
nltk.download("stopwords")

三、数据集说明

​ 本项目使用 Stanford 提供的 IMDB Movie Review Dataset( IMDB 电影评论数据集),共包含 50,000 条影评,正负样本各占一半。

  • 数据格式(CSV):
字段说明
text评论文本
label情感标签(1=正面,0=负面)
  • 数据划分:
data/
└── imdb/
    ├── imdb_train.csv   # 25,000 条训练样本
    └── imdb_test.csv    # 25,000 条测试样本

四、项目结构

Word2Vec/
├── data/
│   └── imdb/
│       ├── imdb_train.csv
│       └── imdb_test.csv
├── models/                    # 训练好的模型
├── src/
│   └── imdb_word2vec.py       # 主程序
└── docs/
    └── IMDB 情感分类实战.md

​ 这种结构便于 数据、代码和文档解耦,也更符合真实工程实践。

五、核心代码解析

5.1 数据加载

def load_data(train_path: str, test_path: str):
    """加载训练集与测试集"""
    train_df = pd.read_csv(train_path)
    test_df = pd.read_csv(test_path)
    return train_df, test_df

​ 逻辑非常直接:分别读取训练集和测试集,返回 DataFrame 供后续处理。

5.2 文本预处理(分词 + 去停用词)

​ 文本预处理是 NLP 的第一步,其目标是降低噪声、统一输入形式。

from nltk.tokenize import word_tokenize
from nltk.corpus import stopwords

stop_words = set(stopwords.words("english"))

def tokenize_text(text_series):
    return text_series.progress_apply(
        lambda x: [
            word for word in word_tokenize(x.lower())
            if word not in stop_words
        ]
    )

  • 示例:
输入: "This movie is great! I really enjoyed it."
输出: ['movie', 'great', '!', 'really', 'enjoyed', '.']
  • 说明:
    • 全部转为小写,减少词表规模
    • 去除停用词(the / is / a 等)以降低无信息噪声

5.3 训练 Word2Vec 模型

def train_word2vec_model(
    tokens,
    vector_size=100,
    window=5,
    min_count=5,
    sg=1,
    workers=4,
    epochs=5
):
    model = Word2Vec(
        sentences=tokens,
        vector_size=vector_size,
        window=window,
        min_count=min_count,
        sg=sg,
        workers=workers,
        epochs=epochs
    )
    return model
  • 本实验中使用的关键参数如下:
参数值说明
vector_size300较高维度,捕捉更多语义信息
window5标准窗口大小
min_count40过滤低频词,IMDB 语料较大,阈值可设高一些
sg1使用 Skip-gram 算法
epochs5训练轮数

5.4 句子向量化方法

​ Word2Vec 只能生成词向量,但分类器需要的是句子级特征。

​ 最简单、也最常用的方法是 词向量平均:
s ⃗ = 1 n ∑ i = 1 n w i ⃗ \vec{s} = \frac{1}{n} \sum_{i=1}^{n} \vec{w_i} s =n1​i=1∑n​wi​ ​

def sentence_to_vec(tokens, model, vector_size=100):
    """将句子转换为词向量的平均值"""
    vecs = [model.wv[word] for word in tokens if word in model.wv]
    if len(vecs) == 0:
        return np.zeros(vector_size)  # 处理全部 OOV 的情况
    return np.mean(vecs, axis=0)
  • 其中,w2v_model.wv 返回的是一个 KeyedVectors 对象,它只负责“词 → 向量”的查询与相似度计算,不包含训练相关内容。

  • 注意:

    • 该方法会丢失词序信息,因此表达能力有限,但胜在简单、稳定、易解释。
    • "我喜欢你"和"你喜欢我"的向量相同。
    • 更好的方法包括 TF-IDF 加权平均、Doc2Vec、或使用 RNN/Transformer。

5.5 embedding映射:构建特征矩阵

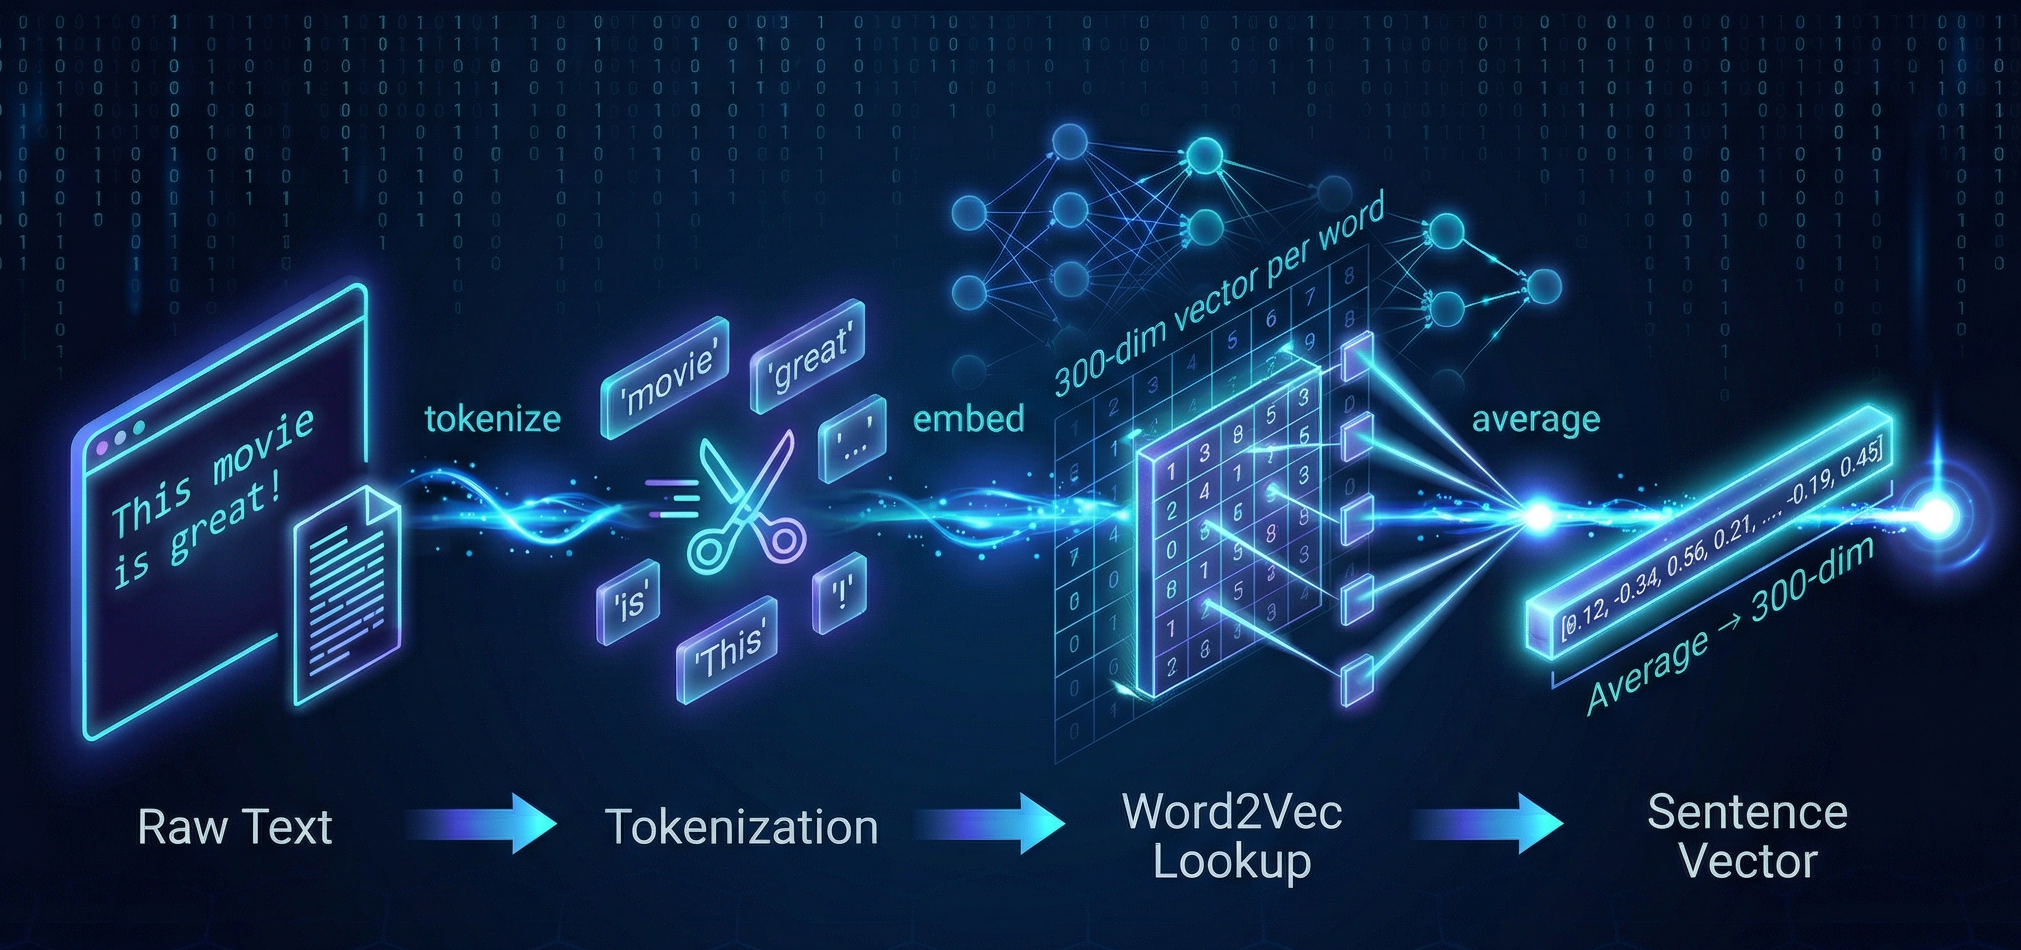
​ 这一步是连接 Word2Vec 和分类器的关键桥梁—将所有文本转换为统一格式的特征矩阵,供机器学习模型使用。

(1) 整体流程
在这里插入图片描述

(2) 数据维度变化
阶段数据形式维度
原始数据文本字符串25,000 条评论
分词后词语列表每条评论 N N N个词
Word2Vec 映射词向量矩阵每个词 → 300 维向量
句子向量化句子向量每条评论 → 300 维向量
最终输入特征矩阵 X \mathbf{X} X(25000, 300)
(3) 代码实现
# 将所有句子转换为向量,堆叠成特征矩阵
X_train = np.vstack([sentence_to_vec(t, w2v_model, vector_size) for t in train_df["tokens"]])
X_test = np.vstack([sentence_to_vec(t, w2v_model, vector_size) for t in test_df["tokens"]])

print(X_train.shape)  # (25000, 300)
print(X_test.shape)   # (25000, 300)

# 标签
y_train = train_df["label"]  # (25000,)
y_test = test_df["label"]    # (25000,)
(4) 映射示例
# 单条评论的映射过程
text = "This movie is great!"
tokens = ['movie', 'great', '!']  # 分词后(已去停用词)

# 查询每个词的向量
movie_vec = w2v_model.wv['movie']   # shape: (300,)
great_vec = w2v_model.wv['great']   # shape: (300,)
# '!' 不在词汇表中,跳过

# 取平均得到句子向量
sentence_vec = np.mean([movie_vec, great_vec], axis=0)  # shape: (300,)
  • 经过这一步,我们得到了:

    • X_train: (25000, 300) 的特征矩阵,每行是一条评论的向量表示
    • y_train: (25000,) 的标签数组,0 或 1
  • 这正是 scikit-learn 等机器学习库所需要的标准输入格式。

5.6 逻辑回归分类器

​ 有了特征矩阵 X \mathbf{X} X和标签 y \mathbf{y} y,就可以使用任意分类器进行训练。这里选择逻辑回归作为分类器:

(1) 为什么选择逻辑回归?
优点说明
简单高效训练速度快,适合作为 baseline
可解释性可以分析特征权重
适合稠密特征300 维的句子向量正好适用
(2) 代码实现
from sklearn.linear_model import LogisticRegression

def train_model(X_train, y_train):
    """训练逻辑回归分类器"""
    clf = LogisticRegression(max_iter=1000)
    clf.fit(X_train, y_train)
    return clf
  • 核心思想:

    • Word2Vec 负责「特征提取」——将文本转换为捕捉语义信息的向量;
    • 逻辑回归负责「分类决策」——根据这些向量判断情感极性。

    两者各司其职,组成完整的文本分类 pipeline。

5.7 模型评估

from sklearn.metrics import accuracy_score, classification_report

def evaluate_model(clf, X_test, y_test):
    """评估模型性能"""
    y_pred = clf.predict(X_test)
    acc = accuracy_score(y_test, y_pred)
    report = classification_report(y_test, y_pred)
    return acc, report

六、运行流程

​ 完整的执行流程如下:

1. 加载数据
   ├── 读取 imdb_train.csv(25,000 条)
   └── 读取 imdb_test.csv(25,000 条)

2. 文本预处理
   ├── 分词(word_tokenize)
   └── 去除停用词

3. 训练 Word2Vec
   ├── 输入:分词后的训练集
   ├── 输出:词向量模型
   └── 保存模型到 models/ 目录

4. 句子向量化
   ├── 训练集 → X_train (25000, 300)
   └── 测试集 → X_test (25000, 300)

5. 训练逻辑回归
   └── 输入 X_train, y_train

6. 评估模型
   └── 在测试集上计算准确率和分类报告

​ 运行命令:

python src/imdb_word2vec.py

七、总结

​ 本文以 IMDB 电影评论情感分类为例,完整演示了 Word2Vec + 逻辑回归 在文本分类任务中的实际应用流程。从原始文本出发,经过分词、去停用词、词向量训练、句子向量构建,最终完成情感预测,形成了一条清晰、可复现的 NLP 处理链路。

​ 在该方案中,Word2Vec 负责将文本映射到语义向量空间,逻辑回归负责基于这些向量进行分类决策。两者分工明确,使得整个模型结构简单、训练高效,也非常适合作为文本分类任务的 baseline。

​ 需要注意的是,词向量平均的方法会丢失词序和词重要性信息,因此模型性能存在一定上限。实际应用中,可以通过 TF-IDF 加权平均、Doc2Vec 或引入更复杂的深度模型来进一步提升效果。

​ 总体而言,这一实战的核心价值在于帮助理解:文本是如何一步步转化为模型可学习的数值特征的。掌握这一过程,对后续学习更复杂的 NLP 模型具有重要意义。

单层感知机在NLP情感分类中的可解释性实践 感知机是理解机器学习分类本质的基础模型,其线性决策边界、显式权重映射和几何可解释性,为文本分类提供了直观的原理入口。它不依赖复杂架构或预训练,而是聚焦于‘词向量化→线性组合→阈值判定’这一核心链路,天然适配TF-IDF等传统特征工程,并能暴露数据线性可分性、特征质量与类别不平衡等底层问题。在情感分析任务中,感知机既是教学锚点,也是诊断探针——通过权重分析可识别关键情感词,通过边界可视化可定位特征空间缺陷,进而指导Word2Vec替换、n-gram增强或领域词典引入等升级路径。本文基于NumPy手写实现,完整 阅读详情

相关推荐

文本分类模型选型指南:从Word2Vec到BERT的性能与成本权衡

文本分类作为自然语言处理的基础任务,其模型选择需兼顾语义建模能力、计算效率与工程落地成本。静态词向量(如Word2Vec)依赖手工特征与加权池化,在领域明确、数据适中时仍具高性价比;CNN凭借多尺度卷积擅长局部模式识别,推理快、显存低;LSTM结合注意力机制可有效建模序列依赖,稳定性优于纯RNN;而BERT等预训练大模型虽在准确率和F1分数上领先,但带来显著的推理延迟、显存开销与硬件门槛。本文基于AG News统一实验框架,实证揭示‘模型复杂度应匹配任务复杂度’这一核心原则,为情感分析、新闻分类、垃圾邮件识

angou6476的博客 452

Python情感分析实战:从IMDb评论到机器学习模型

情感分析作为自然语言处理(NLP)的核心技术,通过机器学习算法自动识别文本情感倾向。其技术原理基于文本特征提取(如词袋模型和TF-IDF)与分类算法(如逻辑回归)的结合,在用户评论分析、社交媒体监控等场景具有重要价值。本文以IMDb电影评论数据集为例,详细演示了从数据预处理、特征工程到模型训练的全流程,特别介绍了Python机器学习技术栈在实际项目中的应用技巧,包括处理大规模数据的核外学习方法和模型部署方案,为开发者提供了可复用的工程实践参考。

weixin_33924312的博客 458

NLP特征工程实战:从TF-IDF到语义嵌入的系统化文本解码

文本特征工程是自然语言处理(NLP)中连接原始语言与机器学习模型的关键桥梁,其核心在于将非结构化文本转化为可计算、可解释、可泛化的数字表征。它基于语言统计规律(如词频、逆文档频率)和语义建模原理(如词向量、句向量),通过规则驱动、嵌入驱动与任务自适应三层策略,实现对任务目标的高度适配。技术价值体现在轻量高效、强可解释性与低资源依赖,广泛应用于文本分类、情感分析、客服工单处理及推荐系统等工业场景。本文聚焦Feature Engineering with NLP这一核心实践路径,深入解析中文分词选型、TF-ID

weixin_29035405的博客 324

IMDb情感分析实战:从词袋到BERT的完整流程与避坑指南

情感分析是NLP的基础任务,其核心在于将文本转化为向量表示并训练分类模型。IMDb影评数据集作为二分类情感分析的黄金标准,包含5万条标注数据,适合从词袋模型、TF-IDF到LSTM、BERT的完整技术路线实践。通过数据清洗、文本向量化、模型训练与验证集调参,可系统掌握情感分析全流程。该流程可迁移至垃圾邮件识别、产品评论分析等场景。本文以IMDb为例,详解从传统机器学习到预训练模型的实现细节与常见问题排查,帮助读者构建扎实的工程能力。

weixin_33997389的博客 726

稠密嫁接词嵌入策略:优化NLP基础表示层的工程实践指南

词嵌入作为自然语言处理的基石技术,通过将词汇映射为稠密向量,为下游任务提供语义表示。其核心原理在于捕捉词汇间的语义与语法关系,在向量空间中构建分布式表示。这一技术的价值在于显著提升了文本分类、情感分析和机器翻译等任务的性能。在实际应用场景中,开发者常面临如何融合多源语义信息、增强领域适应性以及提升嵌入判别力等挑战。本文聚焦于“稠密嫁接”这一创新策略,它旨在通过模型结构或训练方法的优化,解决传统词嵌入模型在特定任务上的瓶颈。该策略尤其适用于需要处理领域自适应嵌入和多源数据融合的工程实践,为NLP算法工程师提供

weixin_30399155的博客 419

(三十四)人工智能应用--自然语言处理--自然语言处理概述

自然语言处理(NLP)是让机器理解人类语言的交叉学科,涵盖语音识别、语义理解与生成。其发展历经规则驱动、统计学习到深度学习三阶段,核心突破在于词向量(如Word2Vec)实现语义表示。课程以“三层金字塔”框架梳理基础技术、核心技术与应用实践,并强调数据维度:文本为2D,序列3D,图像4D,视频5D,第一维恒为样本数。掌握文本→ID→Embedding的转化链路,是构建模型的基础。

直到世界的尽头 44

文本分类模型选型指南:Word2Vec、CNN、LSTM与BERT的投入产出比分析

文本分类是自然语言处理最基础且高频的落地任务,其核心在于选择适配业务场景的表征与建模方法。从静态词向量(Word2Vec)到局部特征提取(CNN),再到序列建模(LSTM)和上下文感知编码(BERT),不同技术路线在效果、效率、硬件成本与泛化能力上存在本质权衡。理解各模型的原理边界——如Word2Vec的确定性优势、CNN对短文本n-gram的敏感性、LSTM的时序建模代价、BERT的显存与延迟瓶颈——是避免‘大模型迷信’的关键。本文聚焦真实工业约束下的模型性价比评估,覆盖小数据冷启动、中等规模平衡部署与大

weixin_34323858的博客 377

Python深度学习电影评论情感分析:从LSTM模型到系统实现

情感分析是自然语言处理中的经典任务,旨在识别文本所表达的情绪倾向。以电影评论为对象,通过深度学习模型自动学习文本语义特征,可有效解决传统机器学习依赖人工特征工程、难以捕捉上下文语序的问题。LSTM及其变体BiLSTM凭借对序列数据的建模优势,成为短文本情感分类的主流选择。该技术可广泛应用于舆情监控、产品口碑分析、影视平台用户反馈挖掘等场景。本文围绕Python环境下基于深度学习的电影评论情感分析毕业设计,详细介绍从数据预处理、模型构建、实验对比到Web系统与数据库落地的完整链路,并给出常见问题的排查思路,为

weixin_28221501的博客 202

顶会论文阅读心法:从文本分类模型演进到工业实践

自然语言处理(NLP)中的文本分类是基础且核心的任务,其技术演进深刻反映了人工智能领域的发展脉络。从早期的静态词向量到基于Transformer的预训练模型,其核心原理在于如何更有效地将文本语义转化为机器可理解的数值表示,并通过深度神经网络学习特征与标签之间的复杂映射关系。这一技术价值在于,它使得计算机能够自动化地理解和归类海量文本信息,极大地提升了信息处理的效率和智能化水平。在应用场景上,文本分类技术已广泛应用于情感分析、新闻分类、意图识别、内容审核等多个领域。随着预训练微调范式的普及,如何高效地将前沿学

chuange6363的博客 437

SpringBoot 中 @RequestMapping 及衍生注解的全面解析与实践

本文全面解析Spring Boot中@RequestMapping及其衍生注解的使用,涵盖核心功能、HTTP方法特定注解(@GetMapping/@PostMapping等)、属性详解(路径/参数/头信息等)以及路径变量处理。文章详细介绍了注解的组合使用、继承特性、版本控制策略等高级应用,并针对405/404等常见错误提供解决方案。通过学习这些注解的规范用法,开发者能够构建符合RESTful风格的API接口,提升代码可读性和可维护性。建议优先使用HTTP方法特定注解,合理规划URL结构,并注意避免路径冲突。

Java&AI小吕布的博客 2037

华为路由器 VRRP主备配置

3、R3 出口路由器。

一直被模仿,从未被超越 5586

科罗拉多应用深度学习笔记(十)

本节课我们一起学习了用于句子分类的卷积神经网络。我们将句子视为一维图像,通过一维卷积操作提取局部特征,再通过全局最大池化得到句子的固定长度表示,最后进行分类。我们还介绍了Dropout这一重要的正则化技术,它通过在训练中随机丢弃神经元来防止过拟合,提升模型泛化能力。这种方法结构简单、易于并行,是文本分类任务中一个强大且高效的基线模型。本节课中我们一起学习了两种文档向量化方法。现在我们来对比一下它们的性能。

龙哥盟 55

Ollama安装教程

Ollama 是一个开源的大语言模型(LLM)部署工具,专为在本地机器部署和运行大模型而设计,通过简单的命令就可以在本地快速运行大模型(如DeepSeek、Llama、Gemma、QWQ等)。非常适合开发者、研究人员以及对数据安全和隐私有较高要求的企业和用户

学习AI应用开发,分享AI干货、获取最新AI咨询 3857

自然语言处理的技术演进与核心任务

自然语言处理的技术演进与核心任务一、技术演进的主线二、语言理解类任务三、语言生成类任务四、跨语言与多模态五、应用边界与负责任使用#自然语言 #自然语言处理 #人工智能 #大模型。

2501_92553370的博客 189

深入解析AMBA5 AXI与ACE协议:从基础到高级应用

本文深入解析了AMBA5 AXI与ACE协议的核心机制与应用。AXI协议通过分离通道、突发传输和乱序完成实现高性能数据传输,而ACE协议在此基础上构建了硬件级缓存一致性解决方案,通过监听机制和状态模型确保多核系统数据统一。文章还探讨了在异构计算等复杂场景下的实战应用与AMBA5的新特性。

cc789的博客 962

DeepLens是一个用于计算镜头设计的可微光线追踪器

若安装过程中遇到网络问题导致安装失败,可尝试更换pip源,例如使用国内的镜像源,修改pip配置文件(Windows系统在。

max500600的博客 1142

总结1:大语言模型概述

AI是什么 → AI发展从1.0到2.0的演变 → 什么是大语言模型LLM → 市面上常见大模型介绍 → 大模型各行各业落地应用 → 大模型未来趋势与现存挑战、解决办法

xiaobaivera的博客 404

一文带你了解什么是RDMA

RDMA(Remote Direct Memory Access,远程直接内存访问)是一种起源于高性能计算领域的通信技术,如今已广泛应用于数据中心。该技术使得用户程序能够绕过操作系统内核及CPU,直接与网络接口卡(NIC)交互,实现网络通信。这种方式不仅大幅提升了通信带宽,还显著降低了网络延迟,优化了整体性能。

嵌入式技术开发 6016

11.04 大语言模型研究简报:OpenAI 工程 Agent 在 BenchCAD 2.0 上达到 0.875 分

大型语言模型的应用场景正在从代码编写延伸至真实的工程设计。2026 年 11 月 3 日,OpenAI 发表《Accelerating engineering for the physical world》,介绍 GPT-6 Astra 与 Codex 在机械设计、计算机辅助设计(CAD)、印刷电路板(PCB)设计、有限元分析(FEA)及制造工作流中的应用。

qq_48717745的博客 438

AutoSAR系列讲解(入门篇)1.2-AutoSAR概述

这里主要说明了AutoSAR是个什么,还有其工具链

雪云飞星的博客 5万+

【STM32 Blue Pill编程】-STM32CubeIDE开发环境搭建与点亮LED

本文为使用 STM32Cube IDE 的 STM32 Blue Pill 入门教程。 在本文中,我们将介绍如何控制 STM32 Blue Pill 的 GPIO 引脚。以及开发环境搭建。 本系列文章将重点介绍采用 ARM Cortex-M 的 BluepellSTM32F103C8 微控制器以及如何使用 STM32CubeIDE 对其进行编程。 STM32CubeIDE是STM32官网提供的IDE

视觉与物联智能 1070

论文 | WebCopass:面向代码语言模型的多模态Web编码评估 | 多模态网页编码评估基准

WebCompass:面向代码语言模型的多模态Web编码评估多模态基准测试平台完整的 lifecycle:生成-编辑-修复用任务感知评估方法,需要强大的功能推理能力,还深入的视觉设计理解和更高的输出一致性。代码生成评估流程图:流程:模型上下文协议(MCP)对真实浏览器的控制。

weixin_42479421的博客 113

华为的C语言编程规范.pdf

华为技术有限公司内部技术规范。本规范制定了编写C语言程序的基本原则、规则和建议。从代码的清晰、简洁、可测试、安全、程序效率、可移植各个方面对C语言编程作出了具体指导。

【字节拥抱开源】Cola2:用连续隐变量重构语言模型,346B Token 跑出 60.10 八任务均分

Cola2 是一款基于连续隐变量的自适应语言模型,通过动态语义压缩与块因果扩散 Transformer(DiT)实现高效生成。它在346.03B token上训练,八项评测平均得分60.10,性能超越部分更大规模模型。其核心创新在于联合优化隐变量压缩与离散解码,支持受控扩展与稳定推理。项目提供完整权重、工具链及评测数据,适用于研究与应用。

weixin_41446370的博客 294

lwip-2.0.3

lwip是瑞典计算机科学院(SICS)的Adam Dunkels 开发的一个小型开源的TCP/IP协议栈。实现的重点是在保持TCP协议主要功能的基础上减少对RAM 的占用。

文档:亲测可用解决vnc灰屏,黑屏,鼠标大黑叉情况

主要解决vnc-viewer灰屏,黑屏,鼠标大黑叉等现象,详细见文档。

新书预告 从《Transformer与大语言模型》到《LLM量化实战》

《Transformer 与大语言模型》完结,新系列《LLM 量化实战》启动。上一本解析“为什么”设计大模型,本册聚焦“怎么”让模型变小变快——从FP16到4-bit量化,详解GPTQ、AWQ、QLoRA、GGUF等技术,结合RTX 4090实测,手把手教你压缩模型、降低显存、部署推理。适合想在8GB~24GB显存设备上运行7B/70B模型的开发者与工程师。原理+实战双线并进,只写真实跑通的结果。

AI服务生活 340

VB摄像头监控

该VB模块可对摄像头捕获的画面进行录像等,可在创建的窗口进行控制

总结2:大语言模型入门

我用开一家AI小餐馆做整套比喻: 把大模型想象成一家餐馆,大语言模型就是餐馆本身;训练原理就是装修、培训后厨;使用技巧是顾客怎么点菜才能吃到合心意的菜;解决幻觉就是避免后厨瞎编菜品;Agent智能体是雇来的全能店长;模型生态就是选后厨是自研(开源)还是外包(闭源),以及调整后厨规模大小。下面按顺序梳理,每个专业术语配一句话解释+生活化例子。

xiaobaivera的博客 739

来自Transformers的双向编码器表示(BERT)

BERT是一种基于Transformer编码器的双向预训练语言模型,通过自监督学习在大规模语料上进行掩蔽语言模型(MLM)和下一句预测(NSP)任务预训练。其输入包含词元、片段和可学习位置嵌入,利用双向上下文表示词元。预训练后,可微调用于下游自然语言处理任务。实验表明,BERT能生成上下文敏感的词向量,有效捕捉语义信息。

2301_76293625的博客 226
上一篇: PyTorch DataLoader `num_workers` 配置指南:从新手到进阶
下一篇: 【Fine-tuning】 详解:Feature Extraction、Linear Probing 与 End-to-End 的区别
未收敛
博客等级 码龄11年 3313粉丝 163原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包

打赏作者

未收敛

你的鼓励将是我创作的最大动力

¥1 ¥2 ¥4 ¥6 ¥10 ¥20
扫码支付:¥1
获取中
扫码支付

您的余额不足,请更换扫码支付或充值

打赏作者

实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值