Python爬虫,用xpath爬取豆瓣电影!

Python 爬虫之爬豆瓣TOP250电影 爬虫超详细讲解 零基础入门 先看后赞,养成习惯!!! 点赞收藏,人生辉煌!!! 讲解我们的爬虫之前,先概述关于爬虫的简单概念(毕竟是零基础教程) 爬虫 网络爬虫(又被称为网页蜘蛛,网络机器人)就是模拟浏览器发送网络请求,接收请求响应,一种按照一定的规则,自动地抓取互联网信息的程序。 原则上,只要是浏览器(客户端)能做的事情,爬虫都能够做。 为什么我们要使用爬虫 互联网大数据时代,给予我们的是生活的便利以及海量数据爆炸式的出现在网络中。 过去,我们通过书籍、报纸、电视、广播或许信息,这些信息数量有限,且... 阅读详情

步骤

  1. 将目标网站下的页面抓取下来
  2. 将抓取下来的数据根据一定规则进行提取

具体流程

  1. 将目标网站下的页面抓取下来

1. 倒库

import requests

2.头信息(有时候可不写)
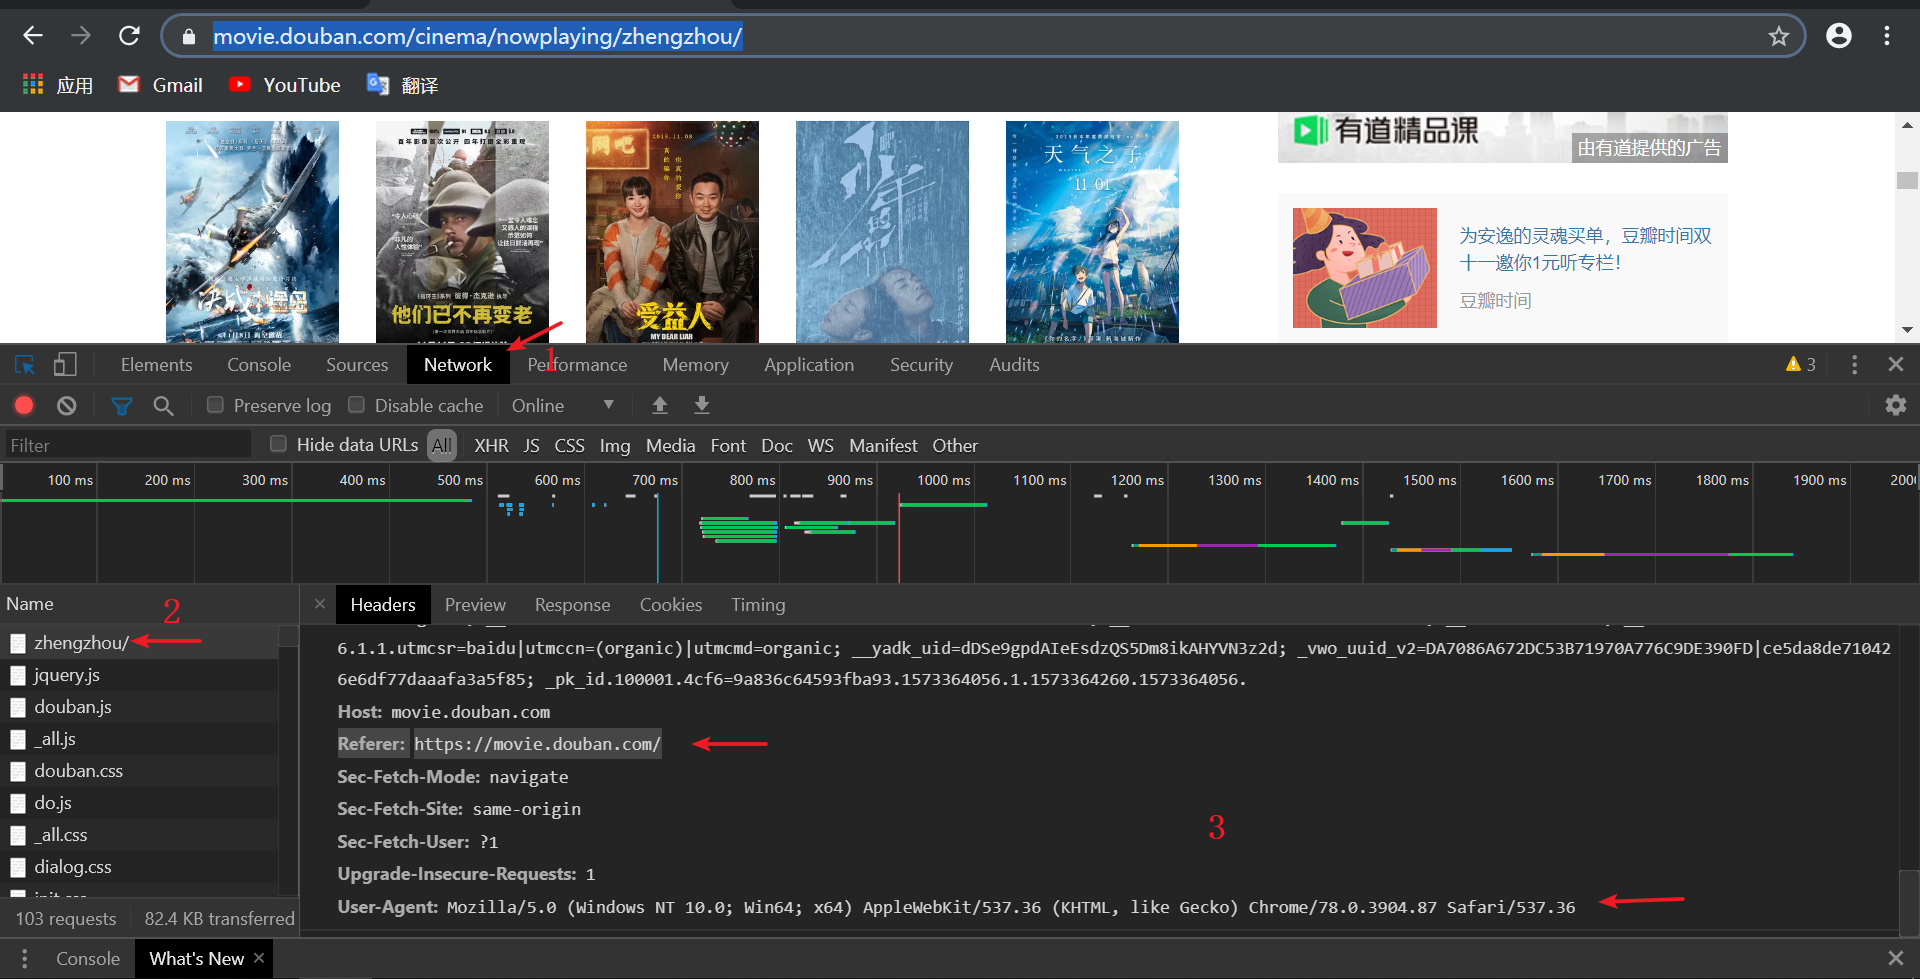
headers = {
    #请求身份/默认为User-Agent:python
	'User-Agent':'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/78.0.3904.87 Safari/537.36',
    'Referer': 'https://movie.douban.com/'
}  

3.url

url = 'https://movie.douban.com/cinema/nowplaying/zhengzhou/'
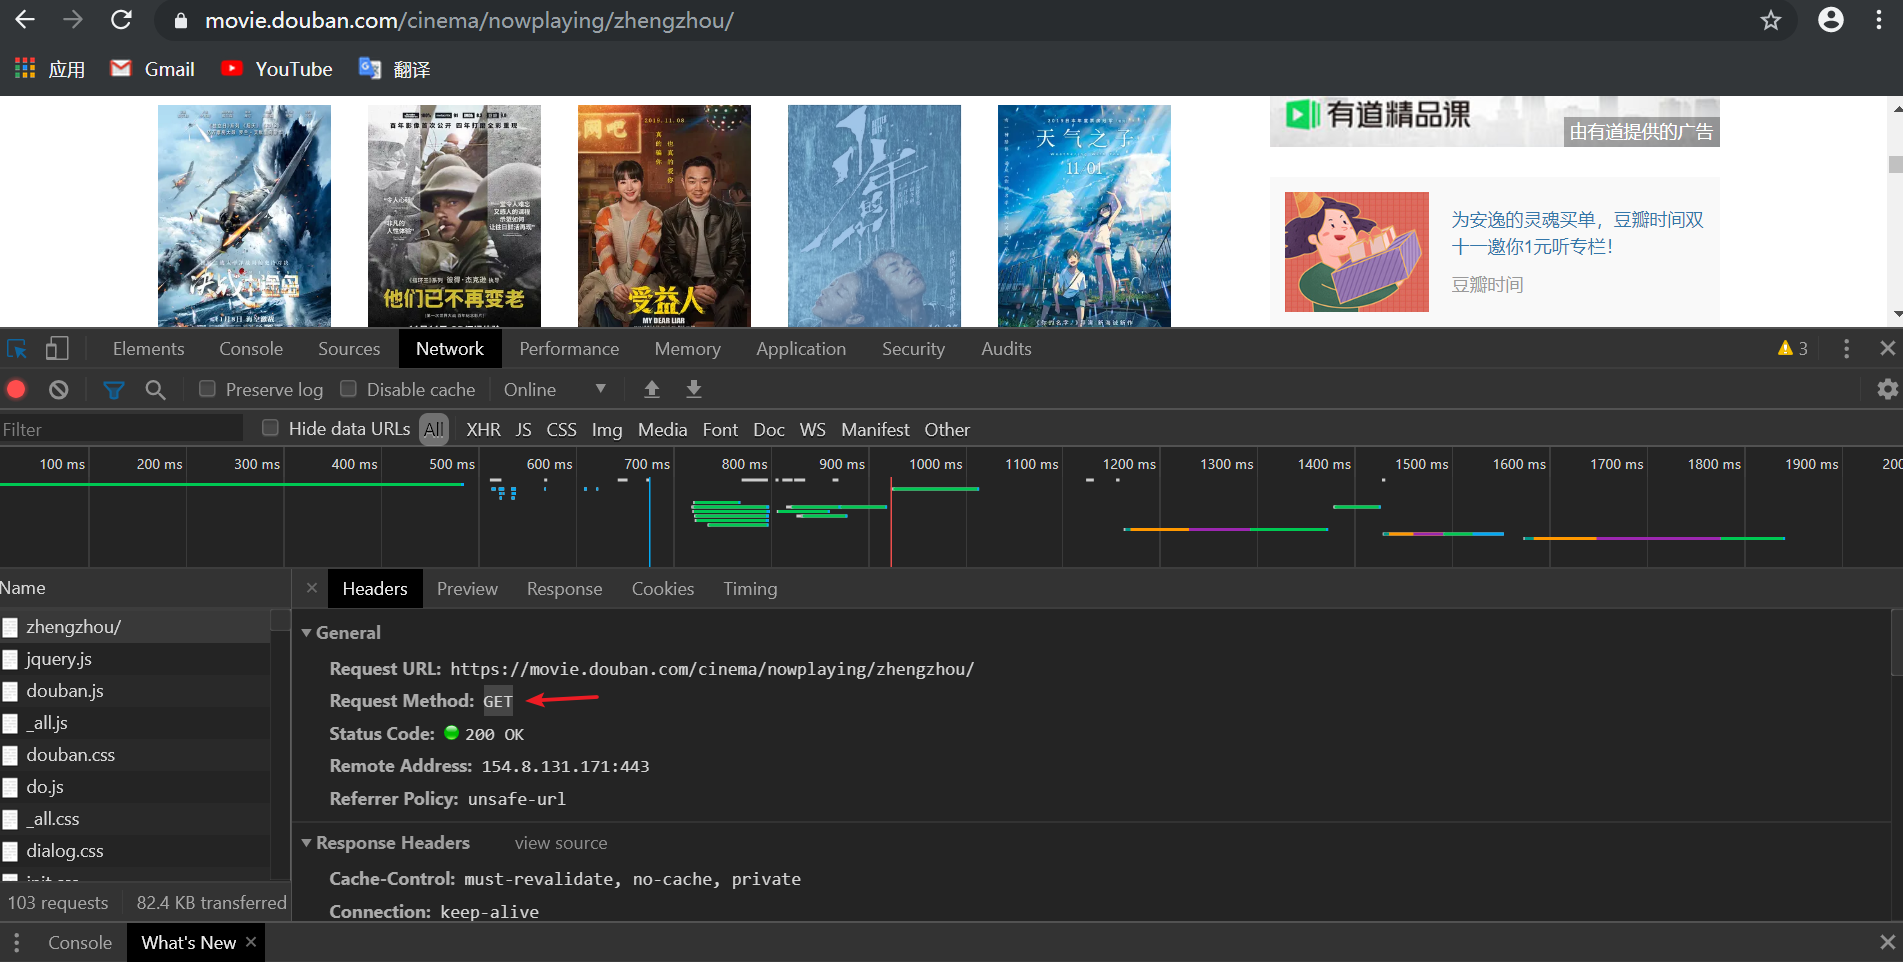
4.返回响应

response = requests.get(url,headers=headers)  #响应
#print(response.text)
text = response.text 

response.text:返回的是一个经过解码后的字符串,是str(unicode)类型

response.concent:返回的是一个原生的字符串,就是从网页上抓取下来的,没有经过解码的字符串,是bytes类型

2.将抓取下来的数据根据一定规则进行提取

1.将爬取下来是数据用lxml进行解析

from lxml import etree
html = etree.HTML(text)

2.获取ul、li下的 ‘title’、‘score’、‘poster’
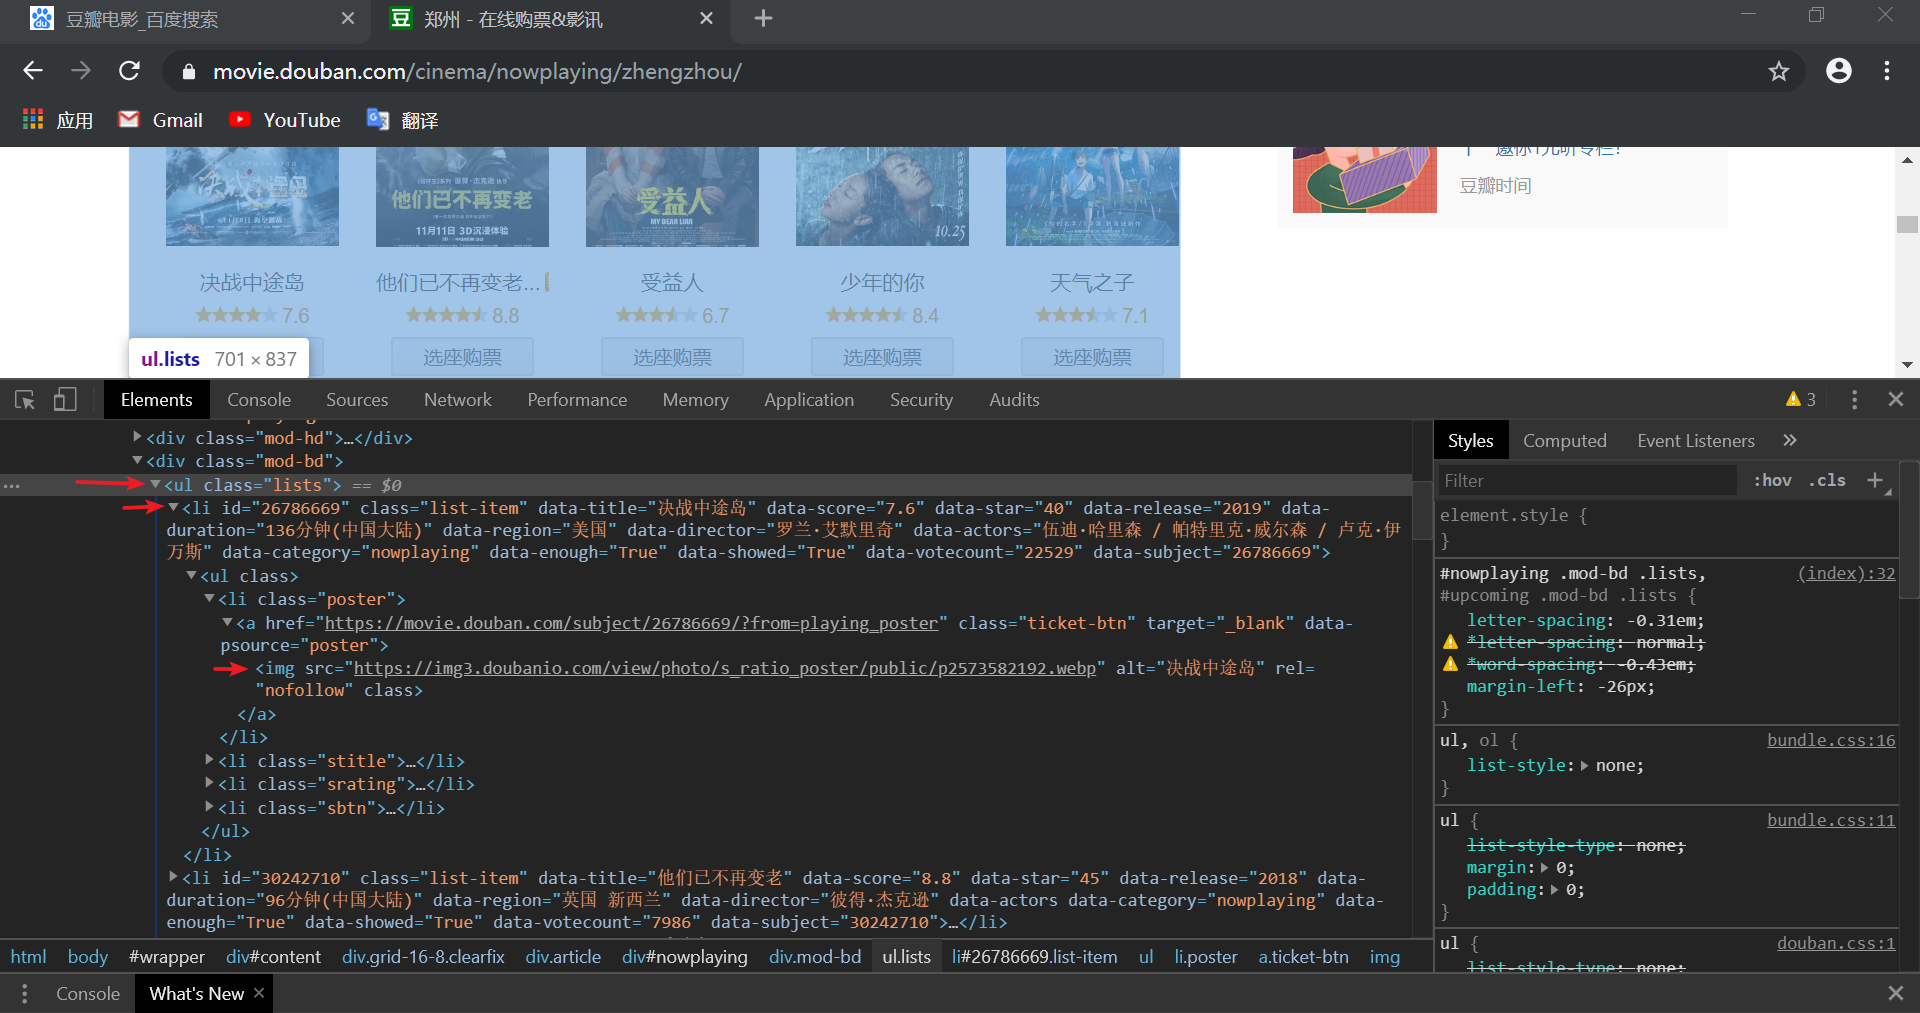
先看看框架

ul (class=‘list’)

li ······

ul

li

a ······

ul = html.xpath("//ul\[@class='lists'\]")\[0\]
#print(etree.tostring(ul,encoding='utf-8').decode('utf-8'))
lis = ul.xpath('./li')
for li in lis:
    #print(etree.tostring(li,encoding='utf-8').decode('utf-8'))
    title = li.xpath('@data-title')\[0\]
    #print(title)
    score = li.xpath('@data-score')\[0\]
    # print(score)
    poster = li.xpath('.//img/@src')\[0\]
   # print(poster)

[0] 只获取第一个内容

// 获取网页当中所有的元素

./ 在当前标签下获取

.// 在当前标签下下获取

xpath返回的是列表的形式 [‘’],[0]就可以只拿内容

3.储存信息

1.下载

request.urlretrieve(poster, 'D:/A/' + score + title + '.jpg')

下载到D盘下A目录中,文件名为 评分+影名.jpg

2.显示进度条

fns\_num = 1
num = len(lis)
for li in lis:
    ···
    print("\\r完成进度: {:.2f}%".format(fns\_num \* 100 / num), end="")
    fns\_num += 1

完整版Python项目源码,点击领取 100%免费!

👉 这份完整版的Python全套学习资料已经上传,朋友们如果需要可以扫描下方优快云官方认证二维码或者点击链接免费领取【保证100%免费】
在这里插入图片描述

用python爬取豆瓣电影信息 阅读详情

相关推荐

爬虫入门经典(四) | 如何爬取豆瓣电影Top250

大家好,我是不温卜火,昵称来源于成语—不温不火,本意是希望自己性情温和。

不温卜火 5万+

谷歌浏览器获取cookies方法

以爬取豆瓣短评为例,豆瓣短评在未登录的情况下只能爬取220条评论,然后就会403。我试过更换代理ip和headers都没用,但使用cookies登录可以解决这个问题。以下是获取cookies的步骤,获取后直接加在headers里面就好。 1.打开要爬取的网页 如果是爬取豆瓣短评,就打开对应的评论网页,在评论网页中获取cookie。注意这里如果打开的是豆瓣主页,后期爬虫时会遇见403。 2. 打开:右上角省略号→更多工具→开发人员工具 3. 找到“network”,然后ctrl+r...

weixin_46607513的博客 1万+

Python之爬取《你好,李焕英》电影豆瓣短评

2021年春节档热播电影《你好,李焕英》,拿下累计票房54.12亿,一路杀进中国票房榜前五,堪称票房黑马。今天就以《你好,李焕英》这部电影为例,利用Python中的Xpath爬取其豆瓣短评,爬取的字段主要有:评论者、评分、评论日期、点赞数以及评论内容。该案例难度系数不大,刚好作为入门案例,废话不多说,让我们一起去看看吧! 注:虽然在短评首页显示《你好,李焕英》共有41万多条短评,但是当浏览时,却发现只能查看前25页的短评,也就是说用户只能看到500条短评评论。发现这个问题后,查阅了一些相关资料,原来是

qq_38230663的博客 1万+

爬虫实战-手把手教你爬豆瓣电影 | 附详细源码和讲解

目前为止,你应该已经了解爬虫的三个基本小节:xiaqo.com正文明确需求我们今天要爬的数据是豆瓣电影Top250,是的,只有250条数据,你没猜错。输入网址我们可以看到网页长这样:​编辑​编辑`250条数据`清清楚楚,没有问题。可以看到,这个页面其实已经包含了影片的主要内容:影片名、排序、编剧、主演、年份、类型、评论人数、评分,基本上都在这个页面中。但我点开详细影片之后,发现了这个:​编辑似乎这个页面数据更全一些,我们爬数据要的是什么,肯定是数据越多越好啊。

JBIB ENGINE 7357

使用requests爬取豆瓣电影

使用requests爬取豆瓣电影 一、分析 豆瓣电影信息https://movie.douban.com/explore#!type=movie&tag=%E7%83%AD%E9%97%A8&sort=recommend&page_limit=20&page_start=0 我们根据首页信信息获取链接 然后,点击进入二级链接 到了这个页面,我们就可以看到我们需要的信息了 接着,我们回到上个网页,查看一下我们需要爬取多少电影信息,可是当我们点击加载更多的时候,页面没有跳转,

钟健的博客 7万+

【爬虫】使用 Scrapy 框架爬取豆瓣电影 Top 250 数据的完整教程

本文适合刚接触python爬虫的小白,讲解如何使用 Scrapy 框架爬取 豆瓣电影 TOP250 数据。通过环境配置、项目创建和编写爬虫的步骤,帮助你快速上手并掌握 Scrapy 的基本使用方法。

小白一枚~ 3977

Python网页爬虫爬取豆瓣Top250电影数据——Xpath数据解析

本次程序只爬取了豆瓣top250电影的展示页面的数据,没有爬取电影详情页的数据。在前面我们已经获取了每一部电影详情页的链接links,如果想要爬取电影的详情页,可以通过for循环遍历列表links,对每一个详情页发起请求,从而获取电影详情页的数据并进行解析。

qq_44777595的博客 6万+

Python爬虫之豆瓣TOP250爬取

@ 1.

fuyao2209的博客 3912

【Python网络爬虫案例】python爬虫之爬取豆瓣电影信息

豆瓣是一个电影资讯网站,用户可以在网站上查找电影信息、评论电影等。我们希望通过爬虫程序获取豆瓣电影的名称、评分和简介等信息,以便进行数据分析或制作推荐系统。

左手の明天的博客 4193

零基础爬虫----python爬取豆瓣电影top250的信息

今天利用xpath写了一个小爬虫,比较适合一些爬虫新手来学习。话不多说,开始今天的正题,我会利用一个案例来介绍下xpath如何对网页进行解析的,以及如何对信息进行提取的。 python环境:python3.5 先看看网页的样子先看看网页的样子先看看网页的样子 豆瓣电影网站链接 我们下面将要对电影的名字、链接、评分、评价人数和一句话描述这些信息进行提取 1、检查并复制电影名字的xPa...

云南省高校数据化运营管理工程研究中心的博客 9236

保存及读取cookie文件登陆豆瓣网站

通过模拟登陆获取cookie, 保存到本地, 使用本地cookie登陆网站。。。。。。。。。。。。。。。。。。。。。。。。。。。。。。。。。。

Python爬取豆瓣电影top250

我的目录1.准备工作1.1、安装Python2.1建立jupyter环境3.1进入编辑环境2.分析网页2.1 打开豆瓣电影top250网页2.2 分析网页结构2.3 用for循环分析结果2.4 用page函数表示这十页的URL链接3.爬取网页3.1 请求HTML源代码3.2 到TOP250上对代码进行审查3.3 请求网页及请求方法3.4 伪装浏览器4.信息筛选4.1 安装lxml库4.2 过滤4....

weixin_45624304的博客 1万+

C#通过Aforge调用电脑摄像头(附代码)

C#标准库本身不带有能调用电脑摄像头的库,如果利用windows自身的API来实现的话,着实有些麻烦。Aforge这个第三方库能很好的实现调用、处理的功能。 PS:文末给大家分享了完整的项目源码,各位最好先下载下来,对照着来看 1、先看一下效果 2、Aforge介绍 AForge.NET是一个专门为开发者和研究者基于C#框架设计的,这个框架提供了不同的类库和关于类库的资源,还有很多应用程序例子,包括计算机视觉与人工智能,图像处理,神经网络,遗传算法,机器学习,机器人等领域。 3、我使用的开发环境 操作系统

weixin_44996090的博客 1万+

豆瓣电影top250信息爬取——xpath解析(适合初学者)

推测第一页时start=0,实验过后确实如此,所以翻页功能可以利用for循环实现,利用range以25为间隔使start后的值依次等于0,25,50……all_data.to_csv('D:/豆瓣电影top250信息.csv',mode='a',encoding='utf-8-sig')all_data=pd.DataFrame({'电影名称':name_list,'详情页网址':url_list})快速解决表头重复问题:数据——删除重复值——全选(不要勾选数据包含标题)(2)获取电影详情页链接。

2302_80061155的博客 2568

在MacBook M1/M2上,手把手教你打包包含嵌入模型的RagFlow Docker镜像(避坑指南)

本文详细指导如何在MacBook M1/M2上构建ARM64架构的RagFlow Docker镜像,涵盖环境准备、依赖处理、镜像构建及性能优化全流程。特别针对Apple Silicon芯片的兼容性问题提供解决方案,帮助开发者高效完成本地开发环境搭建。

weixin_26908317的博客 242

别再让PyCharm吃光你的C盘!保姆级教程:安全迁移config、plugins和remote sources到D盘

本文提供了一份详细的PyCharm配置与缓存文件迁移指南,帮助开发者将config、plugins和remote sources等占用大量C盘空间的文件安全转移到D盘。通过修改data.properties文件和正确迁移顺序,确保PyCharm功能不受影响,同时释放宝贵的系统盘空间。

weixin_28836989的博客 423

python爬虫实践——零基础快速入门(二)爬取豆瓣电影

爬虫又称为网页蜘蛛,是一种程序或脚本。 但重点在于,它能够按照一定的规则,自动获取网页信息。 爬虫的基本原理——通用框架 1.挑选种子URL; 2.讲这些URL放入带抓取的URL列队; 3.取出带抓取的URL,下载并存储进已下载网页库中。此外,讲这些URL放入带抓取URL列队,进入下一循环。 4.分析已抓取列队中的URL,并且将URL放入带抓取URL列队,从而进去下一循环。 ...

MTbaby的博客 1万+

告别系统迁移蓝屏!用Intel RST驱动搞定11代酷睿装Win11的硬盘识别难题

本文详细介绍了如何通过Intel RST驱动解决11代酷睿处理器在安装Win11时遇到的硬盘识别问题。针对VMD技术导致的系统迁移蓝屏错误,提供了从驱动下载、PE环境创建到驱动注入的完整解决方案,帮助用户顺利完成系统升级或迁移。

weixin_31309419的博客 577

【python爬虫案例】利用python爬取豆瓣电影TOP250评分排行数据!

【python爬虫案例】利用python爬取豆瓣电影TOP250评分排行数据,并导出为excel文档

王哪跑的博客 1万+

vscode远程开发-调试模式下attach远程进程提示管理员权限失败的问题

vscode 远程开发 附加进程

comhaqs的专栏 2878

【生成C01/C10材料常数excel表】

计算橡胶件的邵尔硬度和C01/C10材料常数

weixin_46153372的博客 1934

使用Python爬取豆瓣电影 Top 250

目录 前言 一、大致思路 1.导入第三方库 2.简单需求分析 二、代码解析 三、代码实现 四、总结一下 实现Python爬虫的基本思路: 1. 确定需求 2. 网站分析 3. 单一数据提取 4. 提取大量数据 5. 函数封装,简化代码 前言 本博客主要叙述了Python爬虫中xpath解析的实际应用以及如何将解析好的数据保存为.csv格式,这里以豆瓣电影 Top 250 一、大致思路 1.导入第三方库 我这里用了几个比较简单的第三方库,大家环境里没有的话需要下载一下:..

qq_51652382的博客 8356

基于51单片机的智能台灯设计:嵌入式程序设计实现

随着智能家居和物联网的快速发展,智能台灯作为一种典型的智能家居产品,已成为现代家庭中不可或缺的设备。传统的台灯只能提供简单的照明功能,而智能台灯不仅具备基础的照明功能,还能根据用户的需求进行自动调节,比如自动调节亮度、色温,甚至具备定时开关、远程控制等智能功能。本文将介绍如何基于51单片机设计一款智能台灯。我们将涉及硬件设计、嵌入式系统架构、传感器选择、调光控制、语音识别、远程控制等方面,详细阐述如何实现这些功能,并给出相关的代码和实现步骤。

2201_76125393的博客 836

简单上手Python爬虫实战:豆瓣top250电影数据爬取

这里所用到的知识点有request库和xpath用法,同时也需要一点点的python基础,如果有没有学的小伙伴建议学完后再来跟着欧来一起实战项目哦!

2301_77408198的博客 7115

【小白CV教程】YOLOv5+Deepsort实现车辆行人的检测、追踪和计数

【小白CV教程】YOLOv5+Deepsort实现车辆行人的检测、追踪和计数本文禁止转载!项目简介:YOLOv5检测器:DeepSort追踪器:运行demo:训练自己的模型:调用接口:创建检测器:调用检测接口: 本文禁止转载! 项目简介: 使用YOLOv5+Deepsort实现车辆行人追踪和计数,代码封装成一个Detector类,更容易嵌入到自己的项目中。 代码地址(欢迎star): https://github.com/Sharpiless/Yolov5-deepsort-inference 最终效果:

梁瑛平的博客 5万+

RU DOS版、EFI版32bit/64bit BIOS常用工具

DOS版、EFI版的RU工具,可用来查看IO、MEM、PCI、SMBIOS等资源。亲测在EFI SHELL下可用。

上一篇: Pycharm下载安装汉化教程!
下一篇: Python验证码识别
Python_trys
博客等级 码龄2年 4370粉丝 377原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值