用Python爬虫爬取音乐!(附源码)

python爬取音乐源码_Python爬虫教程,爬取网易云的音乐 https://m10.music.126.net/20200715163315/a075d787d191f6729a517527d6064f59/ymusic/0552/0f0e/530f/28d03e94478dcc3e0479de4b61d224e9.mp3Part2编写爬虫程序接下来就超级简单了下面的代码是最常规的操作,应该有爬虫基础的都能看懂;如果有不懂的,注释都在上面#导入reque... 阅读详情
AI摘要

本文围绕QQ音乐爬虫展开,指出其页面联系强,下载音乐需分析多页面。介绍了获取歌曲播放链接的方法,包括通过控制台找数据包、分析链接参数如vkey和guid,还提及搜索歌曲信息数据包找mid,以及对请求头链接进行删减和归纳参数含义。

QQ音乐相比于网易云音乐加密部分基本上没有,但是就是QQ音乐的页面与页面之间的联系太强了,,导致下载一个音乐需要分析前面多个页面,找数据。。太繁琐了

包含编程资料、学习路线图、源代码、软件安装包等!【点击领取】!
在这里插入图片描述

首先随便找一个页面先点进去

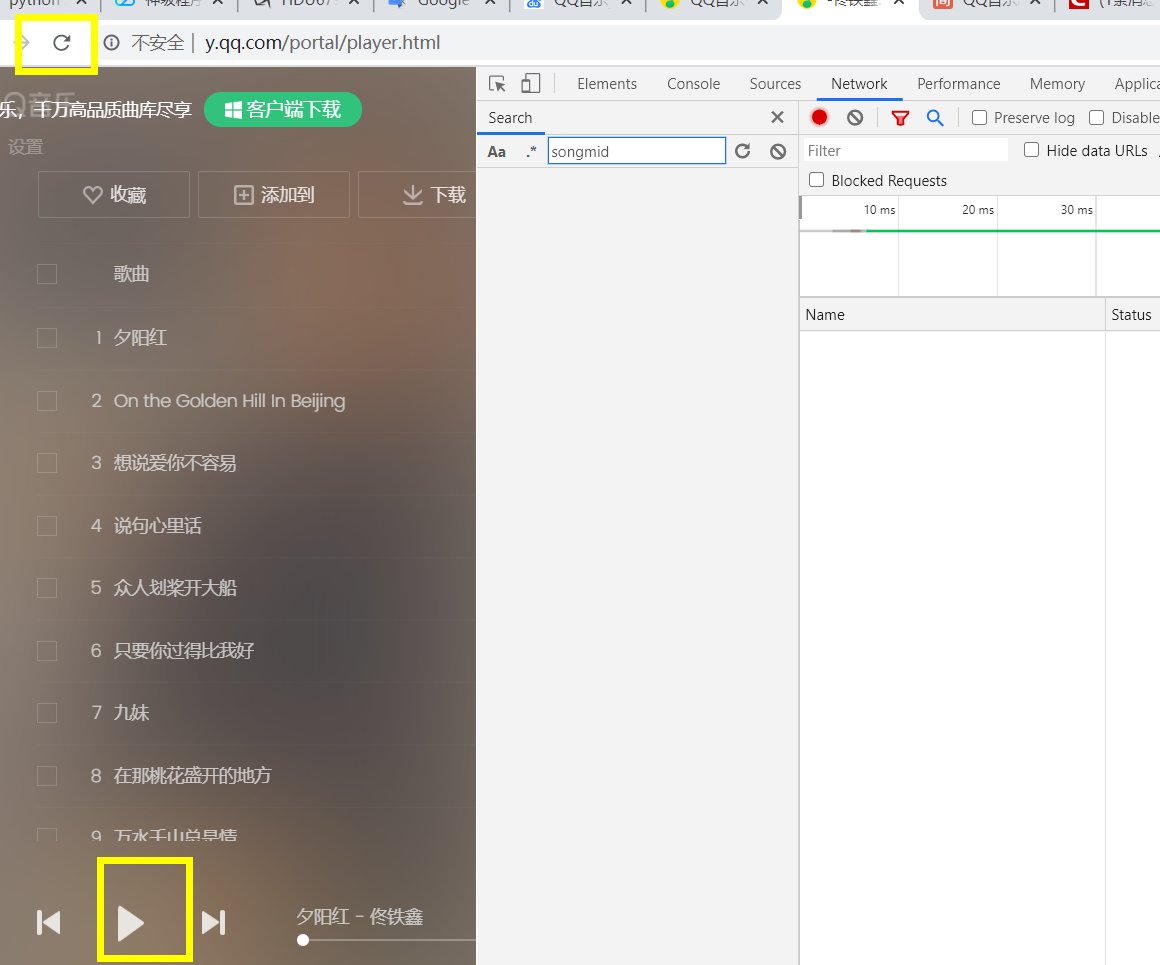
2、点击播放歌曲会打开一个页面,按F12打开控制台,然后刷新页面并点击播放歌曲,network里面就会有数据包
3、在控制台选中media,找到下图这样类型的文件,它的request url就是歌曲播放url,如下下图
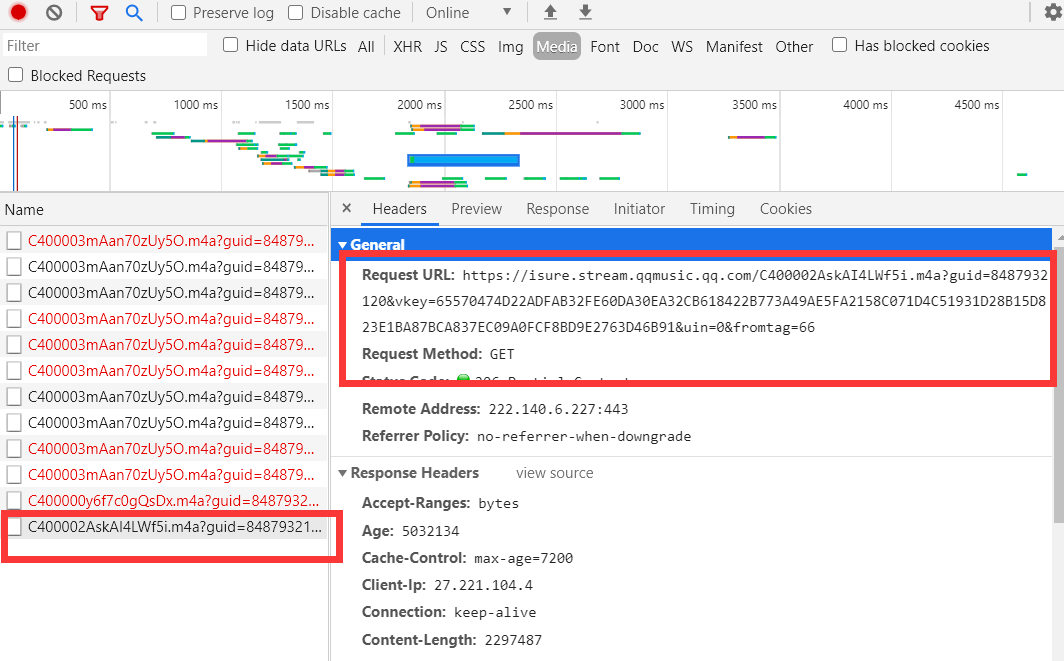
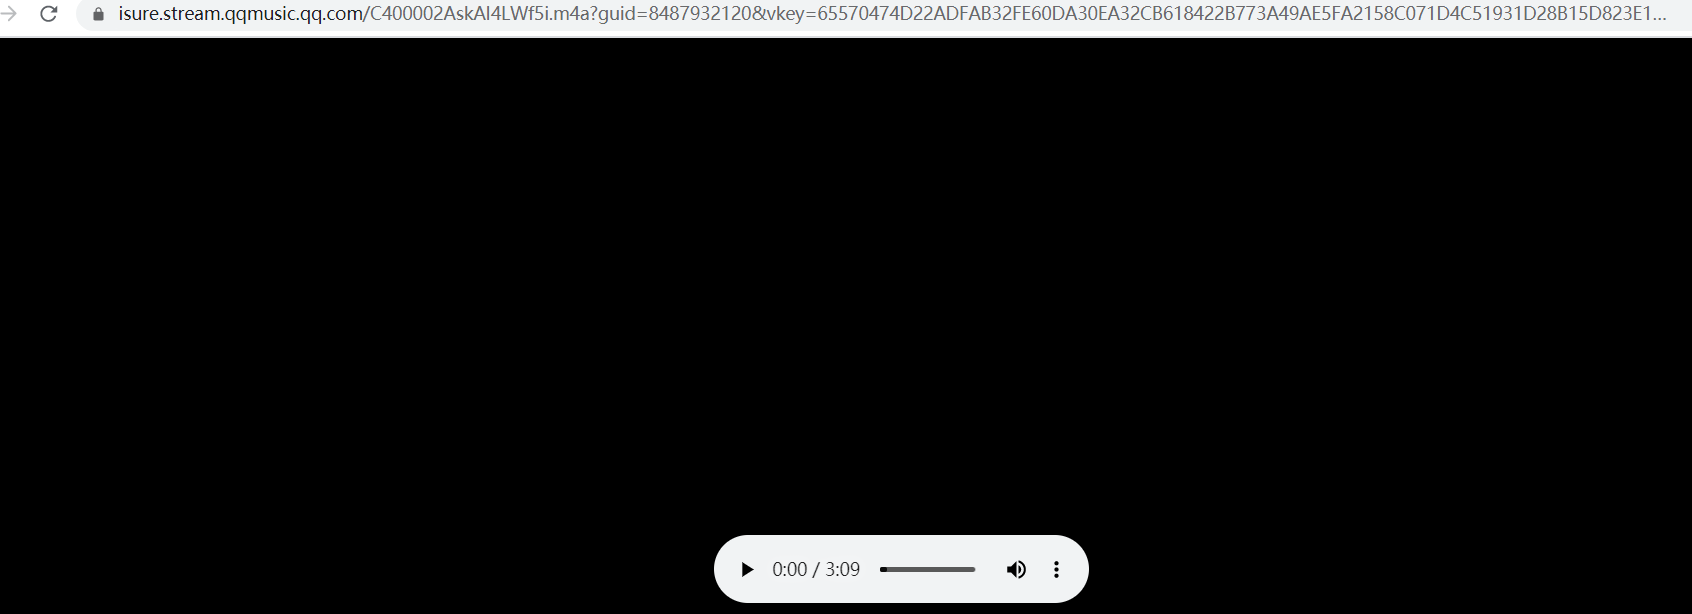
当然,我们肯定不能每下载一首歌都这样,一是这样很麻烦,二是遇到vip等音乐,你在线都不能播放,你还怎么找到歌曲链接

所以,分析页面是必然的!!!我们首先分析一下这个歌曲播放链接的url

https://isure.stream.qqmusic.qq.com/C400002AskAI4LWf5i.m4a?guid=8487932120&vkey=65570474D22ADFAB32FE60DA30EA32CB618422B773A49AE5FA2158C071D4C51931D28B15D823E1BA87BCA837EC09A0FCF8BD9E2763D46B91&uin=0&fromtag=66

我们对这个url进行删减(因为url有些部分都不需要,我们为了看起来更直观要对其进行处理)

#精简后url
https://isure.stream.qqmusic.qq.com/C400002AskAI4LWf5i.m4a?guid=8487932120&vkey=65570474D22ADFAB32FE60DA30EA32CB618422B773A49AE5FA2158C071D4C51931D28B15D823E1BA87BCA837EC09A0FCF8BD9E2763D46B91

我们大致一看它的url,就知道页面提交用get将参数guid和vkey追加到url地址后面,那么我们就要去找vkey和guid参数是怎么来的

guid参数:

你多打开几个歌曲就会发现它的guid都是一样的,所以这个我们就不用管

vkey参数:

这个参数难为死我了,我刚开始以为它和网易云音乐一样也是加密一下,然后我就去js文件里面找,找了半天没找到赋值语句,我就纳闷了,以为这是更高级的加密,,,,然后看了半天js,最后终于确定,js和这个没啥关系。。。。。。。

之后感觉分析页面分析不动了,上网找了篇博客给了我灵感,虽然那篇博客代码已经过时了,但是它启发了我 “播放歌曲的链接可能不止一个”

于是我又开始找vkey在哪个数据包出现过,如下图
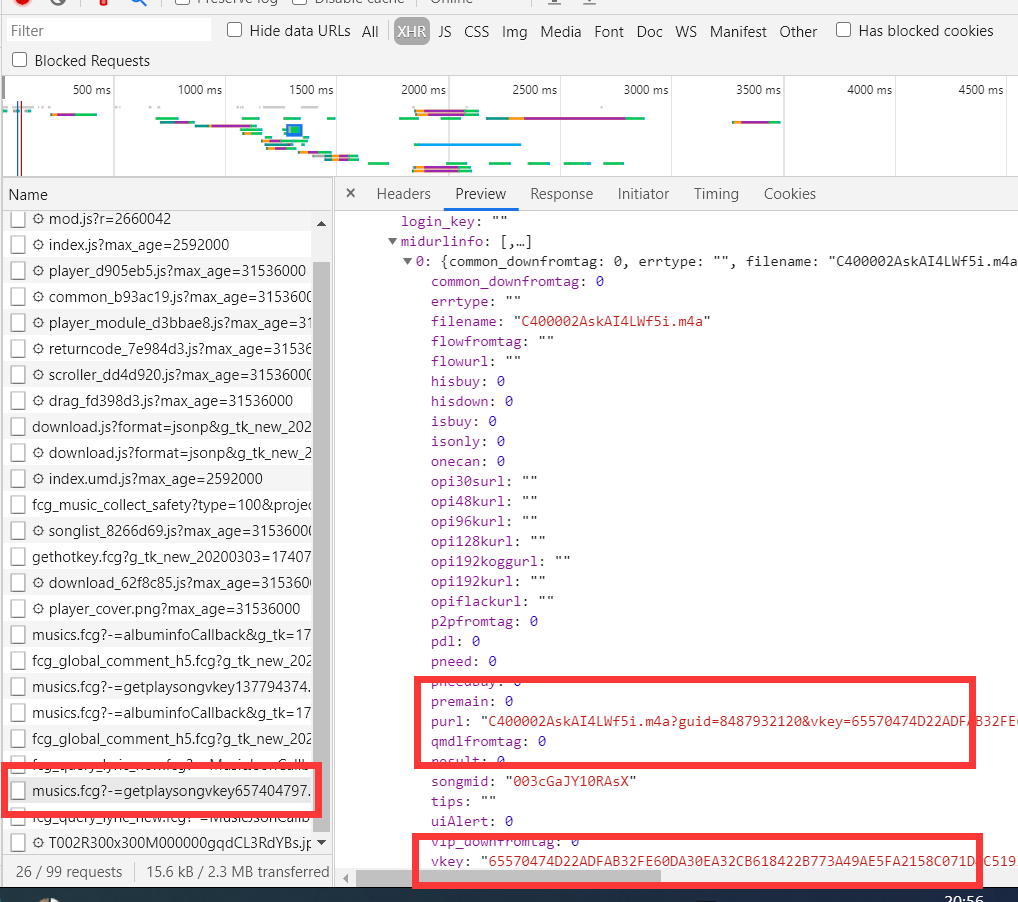
我找到了vkey且对比了一下和之前链接上vkey的值一样,你再仔细看就会发现那个歌曲下载链接就是

https://isure.stream.qqmusic.qq.com/加上purl的值。(我giao!!)

然后就要去分析这个数据包的请求头了(呜呜呜),请求头如下(好长~~)

https://u.y.qq.com/cgi-bin/musics.fcg?-=getplaysongvkey6574047973093009&g\_tk=1740745507&sign=zzaztgck8xaqpsxorw45ed952a339dbe91c7990f803cb9a6f1&loginUin=0&hostUin=0&format=json&inCharset=utf8&outCharset=utf-8&notice=0&platform=yqq.json&needNewCode=0&data=%7B%22req\_0%22%3A%7B%22module%22%3A%22vkey.GetVkeyServer%22%2C%22method%22%3A%22CgiGetVkey%22%2C%22param%22%3A%7B%22guid%22%3A%228487932120%22%2C%22songmid%22%3A%5B%22003cGaJY10RAsX%22%5D%2C%22songtype%22%3A%5B0%5D%2C%22uin%22%3A%220%22%2C%22loginflag%22%3A1%2C%22platform%22%3A%2220%22%7D%7D%2C%22comm%22%3A%7B%22uin%22%3A0%2C%22format%22%3A%22json%22%2C%22ct%22%3A24%2C%22cv%22%3A0%7D%7D

这个时候我就遇到一个坑点(QQ音乐有毒),这么长的链接我们肯定要对其进行删减,好看看哪些参数有用,哪些参数用来混乱我们的视线

但是如果你前面的一段链接改为

https://u.y.qq.com/cgi-bin/musicu

你就能对很多参数进行删除,就最后一个字母不一样,但是对参数进行删除的时候前面那个链接就基本上参数都不能删除

这让我就很难受,我的访问链接就是

https://u.y.qq.com/cgi-bin/musics

这一部分,但是有些人访问链接是

https://u.y.qq.com/cgi-bin/musicu

化简之后链接就变成了

https://u.y.qq.com/cgi-bin/musicu.fcg?format=json&data=%7B%22req\_0%22%3A%7B%22module%22%3A%22vkey.GetVkeyServer%22%2C%22method%22%3A%22CgiGetVkey%22%2C%22param%22%3A%7B%22guid%22%3A%22358840384%22%2C%22songmid%22%3A%5B%22{}%22%5D%2C%22songtype%22%3A%5B0%5D%2C%22uin%22%3A%221443481947%22%2C%22loginflag%22%3A1%2C%22platform%22%3A%2220%22%7D%7D%2C%22comm%22%3A%7B%22uin%22%3A%2218585073516%22%2C%22format%22%3A%22json%22%2C%22ct%22%3A24%2C%22cv%22%3A0%7D%7D".format(mid值)
            

与其他歌曲的这个链接对比一下就会发现只有songmid的值再改变

我们再去找songmid是什么,疯狂在文件中寻找,结果没有songmid字样,有也是在js中,songmid在js中还多以注释出现。。。

之后我在搜索歌曲之后,在歌曲信息的数据包里面发现了mid,然后我把url地址中编码过的mid解码后发现它们一样。。。(牛掰!!!)

下面给一个在多个文件中快速搜索关键子字的方法,如下图:

在线url解码:http://tool.chinaz.com/tools/urlencode.aspx
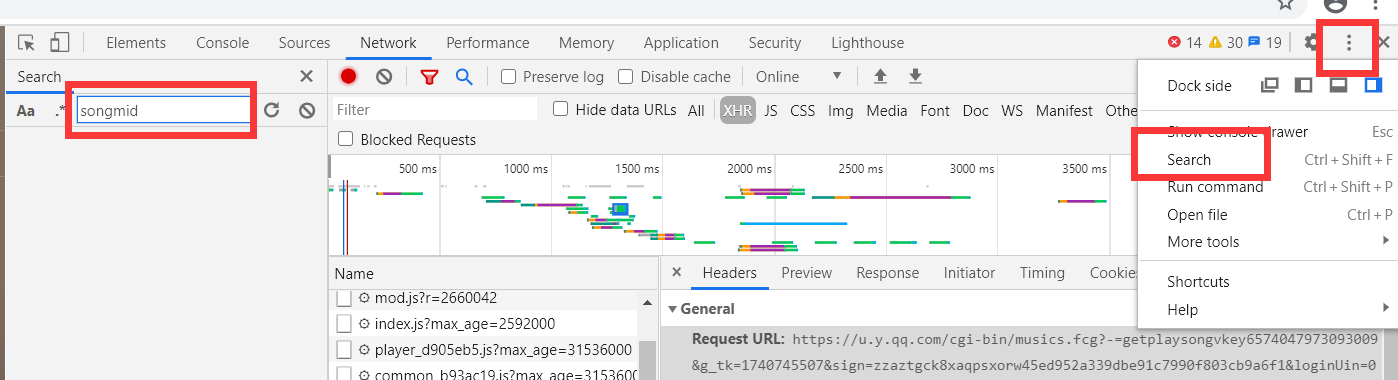
以搜索“夕阳红为例”
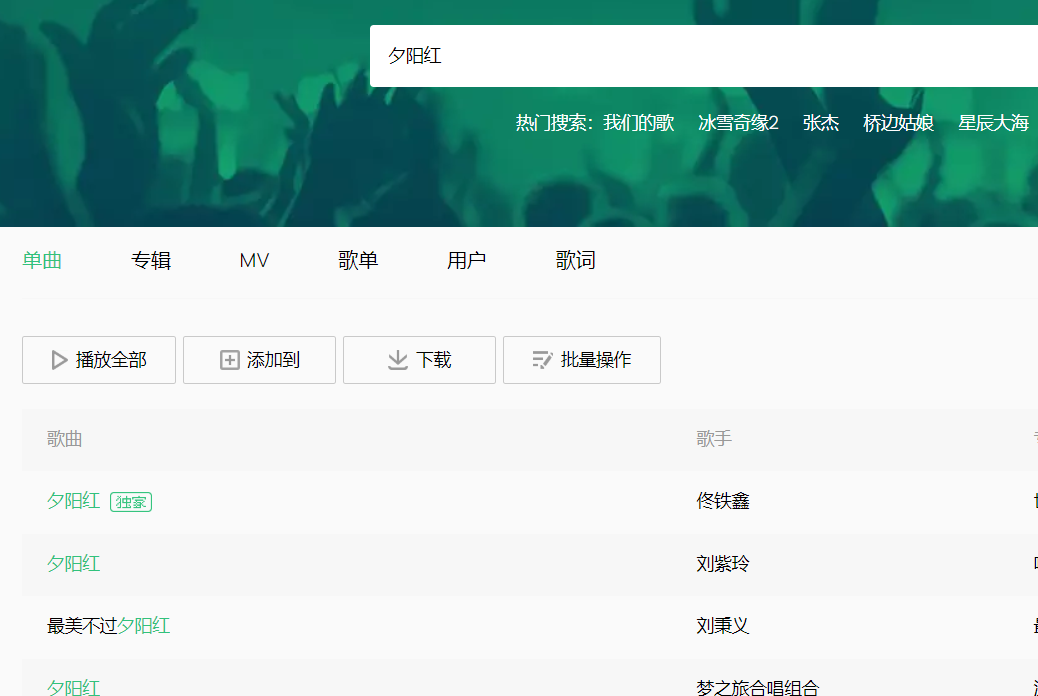
数据包list字段下面就是歌曲信息
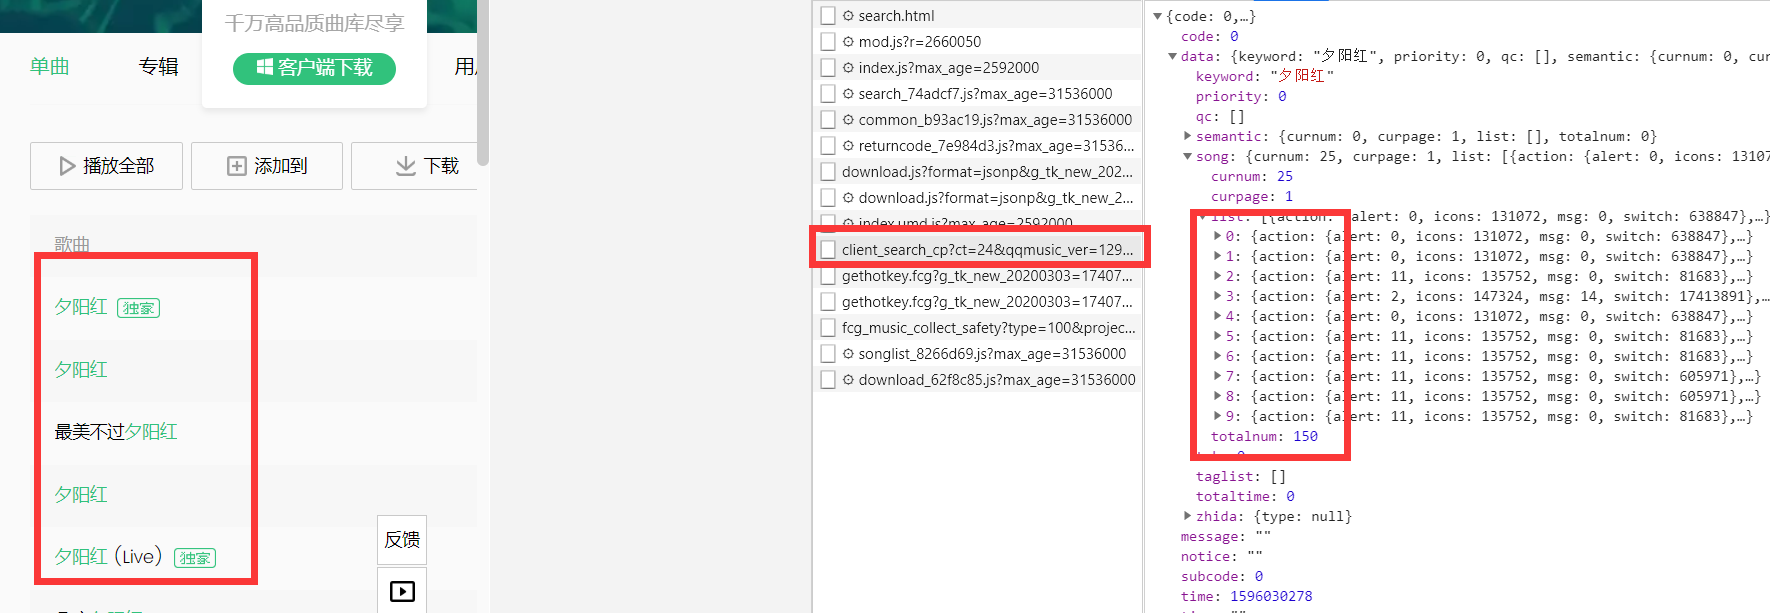
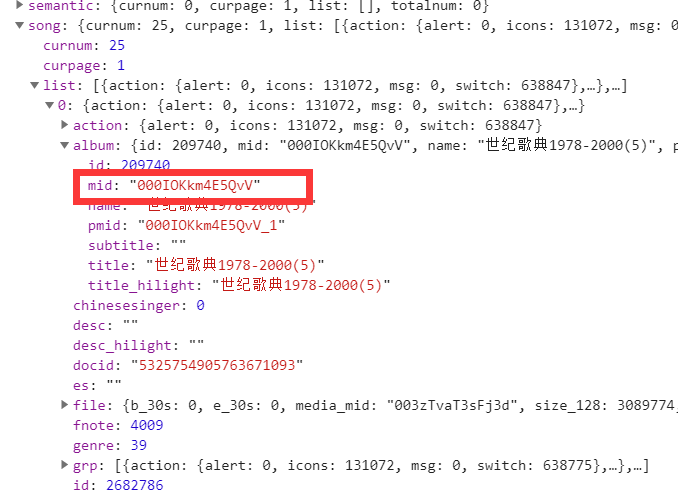
然后再看一下这个数据包的请求头(希望不要麻烦)

https://c.y.qq.com/soso/fcgi-bin/client\_search\_cp?ct=24&qqmusic\_ver=1298&new\_json=1&remoteplace=txt.yqq.song&searchid=70921863029222715&t=0&aggr=1&cr=1&catZhida=1&lossless=0&flag\_qc=0&p=1&n=10&w=%E5%A4%95%E9%98%B3%E7%BA%A2&g\_tk\_new\_20200303=1740745507&g\_tk=1740745507&loginUin=0&hostUin=0&format=json&inCharset=utf8&outCharset=utf-8&notice=0&platform=yqq.json&needNewCode=0

删减之后

https://c.y.qq.com/soso/fcgi-bin/client_search_cp?ct=24&qqmusic_ver=1298&new_json=1&remoteplace=txt.yqq.song&searchid=70631360004412645&t=0&aggr=1&cr=1&catZhida=1&lossless=0&flag_qc=0&p=1&n=10&w=%E9%9D%9E%E9%B1%BC&g_tk_new_20200303=5381&g_tk=5381&loginUin=2272463882&hostUin=0&format=json&inCharset=utf8&outCharset=utf-8&notice=0&platform=yqq.json&needNewCode=0

通过归纳可以知道n代表搜索到的歌曲显示数目,w是搜索的关键字

所以我们n设定一个值就行,w就运行程序是输入就行

所有问题都解决了(呼~~~~~~~)
**

import requests
import re
import os
import json
import time as t

class QQmusic():
    """代码仅供学习"""

    def \_\_init\_\_(self):
        """初始化"""
        self.headers \= {
            'Accept-Encoding': 'gzip, deflate, sdch',
            'Accept-Language': 'en-US,en;q=0.8',
            'User-Agent': 'Mozilla/5.0 (Macintosh; Intel Mac OS X 10\_10\_1) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/39.0.2171.95 Safari/537.36',
            'Accept': 'text/html,application/xhtml+xml,application/xml;q=0.9,image/webp,\*/\*;q=0.8',
            'Referer': 'http://www.baidu.com/',
            'Connection': 'keep-alive',
        }
        self.names \= \[\]
        self.order \= ' '

    def search(self):
        """搜索"""
        w \= input("请输入歌曲名: ")
        url\_0 \= "https://c.y.qq.com/soso/fcgi-bin/client\_search\_cp?ct=24&qqmusic\_ver=1298&new\_json=1&remoteplace=txt.yqq.song&searchid=61460539676714578&t=0&aggr=1&cr=1&catZhida=1&lossless=0&flag\_qc=0&p=1&n=10&w={0}&g\_tk\_new\_20200303=5381&g\_tk=5381&loginUin=0&hostUin=0&format=json&inCharset=utf8&outCharset=utf-8&notice=0&platform=yqq.json&needNewCode=0".format(
            w)
        res\_0 \= requests.get(url\_0, headers=self.headers)  # 第一层,搜索页
        res\_0.encoding = res\_0.apparent\_encoding
        res\_0 \= res\_0.json()  # dict
        music\_list = res\_0\["data"\]\["song"\]\["list"\]
        print("共计" + str(len(music\_list)) + "结果: ")

        all\_singers \= \[\]
        a \= 0
        for music in music\_list:
            singer \= music\["singer"\]\[0\]\["title"\]  # 歌手名
            name = str(a) + "  " + music\["title"\]  # 歌曲名
            all\_singers.append(singer)
            self.names.append(name)
            a \= a + 1
        infs \= dict(zip(self.names, all\_singers))
        infs \= json.dumps(infs, ensure\_ascii=False, indent=4, separators=(',', ':'))
        infs \= infs.replace('"', ' ')
        infs \= infs.replace(':', '——————')
        print(infs)

        self.order \= input("请输入歌曲前的序号:")
        songmid \= res\_0\['data'\]\['song'\]\['list'\]\[int(self.order)\]\['mid'\]
        url\_1 \= "https://u.y.qq.com/cgi-bin/musicu.fcg?format=json&data=%7B%22req\_0%22%3A%7B%22module%22%3A%22vkey.GetVkeyServer%22%2C%22method%22%3A%22CgiGetVkey%22%2C%22param%22%3A%7B%22guid%22%3A%22358840384%22%2C%22songmid%22%3A%5B%22{}%22%5D%2C%22songtype%22%3A%5B0%5D%2C%22uin%22%3A%221443481947%22%2C%22loginflag%22%3A1%2C%22platform%22%3A%2220%22%7D%7D%2C%22comm%22%3A%7B%22uin%22%3A%2218585073516%22%2C%22format%22%3A%22json%22%2C%22ct%22%3A24%2C%22cv%22%3A0%7D%7D".format(songmid)

        res\_1 \= requests.get(url\_1, headers=self.headers)
        res\_1.encoding \= res\_1.apparent\_encoding
        res\_1 \= res\_1.json()  # dict
        purl = res\_1\['req\_0'\]\['data'\]\['midurlinfo'\]\[0\]\['purl'\]
        url\_2 \= "https://isure.stream.qqmusic.qq.com/" + purl
        return url\_2

    def download(self):
        """下载"""
        res\_2 \= requests.get(self.search(), headers=self.headers).content
        fir \= self.names\[int(self.order)\]
        tit \= re.sub(r'\\d+', '', fir)
        now \= os.getcwd()
        now \= os.path.join(now, "qq音乐 ")
        if not os.path.exists(now):
            os.mkdir(now)
        os.chdir(now)
        file\_name \= tit + '.m4a'
        with open(file\_name, 'wb') as f:
            f.write(res\_2)


one\_file \= QQmusic()
one\_file.download()
真给力,字节跳动年度首发《音视频开发进阶指南》限时领取,理论与实战齐飞 音视频播放:音视频同步音视频解封和封装:生成一个MP4。 阅读详情

相关推荐

手把手教你使用Python抓取QQ音乐数据!

【一、项目目标】 通过Python爬取QQ音乐数据(一)我们实现了获取 QQ 音乐指定歌手单曲排行指定页数的歌曲的歌名、专辑名、播放链接。 此次我们在之前的基础上获取QQ音乐指定歌曲的歌词及前15个精彩评论。 【二、需要的库】 主要涉及的库有:requests、json、html 【三、项目实现】 1.以歌曲“泡沫”为例,查看该界面的XHR 2.通过对XHR的Size进行排序,逐个查看(参考英文含义),我们看到第一个红框内是歌曲评论,第二个框内是歌词! 3.分别查看这两条..

爬遍所有网站 7663

Python爬虫视频教程:教你爬取QQ音乐数据(实战处理+数据可视化)

本视频课程主要培训Python爬虫入门,数据分析及数据可视化实战内容,通过本课的学习,您可以在2小时左右掌握Python基础编程的核心内容,实现Python在爬虫、数据分析,及数据可视化等操作,各位同学在掌握了Python后,可以选择Python的其中一个方向进行深入研究,不管对于自身升职找工作,还是对于自身IT专业能力的提升,都是非常有帮助的。刘宇宙,《Python3.5从零开始学》、《Python3.7从零开始学》一书作者。 目前主要担任大数据人工智能后台技术负责,负责人工智能项目落地,目前已落地计算机视觉中的以图搜图、侵权图片检测、智能广告、实时推荐、销量预测等项目。 先后从事过卡系统研发,云计算中IAAS的研发,大数据研发,物联网研发,网络爬虫研发。

教你使用Python抓取QQ音乐数据(三)

【一、项目目标】 通过教你使用Python抓取QQ音乐数据(一)我们实现了获取 QQ 音乐指定歌手单曲排行指定页数的歌曲的歌名、专辑名、播放链接。 通过教你使用Python抓取QQ音乐数据(二)我们实现了获取 QQ 音乐指定歌曲的歌词和指定歌曲首页热评。 此次我们在项目(二)的基础上获取更多评论并生成词云图,形成手把手教你使用Python抓取QQ音乐数据(第三弹)。 【二、需要的库】 主要涉及的库有:requests、json、wordcloud、jieba 如需更换词云图背景图片还需要numpy库和PIL

python入门学习进阶教程 1020

【python爬虫 系列 最终篇】16.利用多线程多进程爬取qq音乐全站所有信息和音乐

实战 爬取qq音乐 1.项目详情 歌手分区:(a-#) 整个爬虫项目按功能分为爬虫规则和数据入库,分别对应文件 music.py 和 music_db.py。 爬虫规则大致如下: 在歌手列表(https://y.qq.com/portal/singer_list.html)中按照字母类别对歌手进行分类,遍历每个分类下的每位歌手页面,然后获取每位歌手页面下的全部歌曲信息。根据该设计方案列出遍历...

AI_LINNGLONG的博客 1万+

python爬虫代码-python网络爬虫源代码(可直接抓取图片)

在开始制作爬虫前,我们应该做好前期准备工作,找到要爬的网站,然后查看它的源代码我们这次爬豆瓣美女网站,网址为:用到的工具:pycharm,这是它的图标...博文来自:zhang740000的博客Python新手写出漂亮的爬虫代码1初到大数据学习圈子的同学可能对爬虫都有所耳闻,会觉得是一个高大上的东西,仿佛九阳神功和乾坤大挪移一样,和别人说"老子会爬虫”,就感觉特别有逼格,但是又不知从何...

q6q6q的专栏 3662

python爬取酷狗音乐_python 爬虫 爬取酷狗音乐

终于到了周末!怎么能少得了我的每周一更的文章呢?介绍你是不是常常想要在各大音乐网站上下载音乐?但是网站却逼迫你下载他们的应用?不要怪他们,这只是他们的赚钱的方式(你不下载他们应用,他们怎么赚钱呢)然而,你下载了应用,它们却逼迫你购买vip……没关系,今天我们就来用爬虫手段“制裁”这些网站!首先,就由最简单的酷狗音乐开始爬!功能概述让用户输入要搜索的音乐名,然后把所有的音乐以及每一个音乐对应的信息展...

weixin_39616547的博客 2617

基于Python的QQ音乐数据爬取分析与可视化(附源码)

通过对QQ音乐平台上的数据进行爬取、分析和可视化,可以更好地了解音乐市场的需求和趋势,为音乐推荐、版权管理等方面提供支持。通过对数据的分析和可视化,可以深入了解QQ音乐平台上歌曲、歌手、用户等方面的信息,为用户提供更好的音乐推荐服务,为音乐产业提供更为准确的数据支持。在音乐领域,通过对用户偏好、音乐市场趋势等数据进行分析和预测,可以为音乐服务提供更为精准的推荐和管理。通过本文的研究,我们成功利用Python编程语言对QQ音乐平台的相关数据进行爬取、分析和可视化,为音乐领域的数据研究提供了新的思路和方法。

Dalu_1226的博客 5138

Python爬虫实战,Request+urllib模块,批量下载爬取飙歌榜所有音乐文件

今天给大家介绍的是Python爬取飙歌榜所有音频数据并保存本地,在这里给需要的小伙伴们代码,并且给出一点小心得。

Modeler_xiaoyu的博客 2242

Python大作业-网络爬虫程序

本文章介绍了一个Python大作业(课程设计)-网络爬虫程序,爬取“Bangumi-我看过的动画”,文章详细展示了程序功能及程序代码。

XiuMu的博客 1万+

Python爬虫实战:爬取歌曲宝音乐资源

输出结果逻辑分析:设置自定义请求头;:展示服务器接收到的请求头内容。User-Agent 是识别客户端的重要字段。模拟浏览器 User-Agent 可以避免被反爬。逻辑分析:指定本地证书文件路径;- 适用于连接使用私有证书的服务器。在实际开发中,网站的登录机制往往更加复杂,可能包括:JavaScript 渲染页面:此时建议使用Selenium或Playwright。OAuth 认证。

weixin_42298778的博客 1044

浅谈MOS管的发热原因和解决办法

解读一下开关管发热原因,解决方案和开关损耗测试。

qq_45508321的博客 1万+

【python】爬取酷狗音乐Top500排行榜【附源码】

爬虫案例、爬取酷狗音乐排行榜、爬虫top500

m0_73367097的博客 2万+

滤波器初步入门(非常全面)

主要关注的是-3dB这个点,-3dB就是截止频率所对应的点,我们把功率降至50%以下的信号定义为被衰减掉了(但要跟实际情况相结合,有些信号衰减-3db不够,需要衰减更多)-3dB这个点对应我们的电压来说是0.707。设计电路可以留一定的余量,如果你把4k设计为截止频率,那么4k时候衰减倍数为-3dB通常是不够的,你可以将截止频率设为2k,那么4k的衰减就可以达到15dB(假设),根据自己的需要去设计对应的截止频率。理想的滤波器是当输入的信号频率大于截止频率时,大于部分的频率对应的电压信号直接归0。

yybyybds的博客 5720

Python爬取网易云音乐热评(附源码)

Python爬取网易云音乐热评 Markdown将文本转换为 HTML。 下面展示一些 内联代码片。 // A code block var foo = 'bar'; import a b = 'dsdfhshfksahdf' b.

weixin_51152456的博客 9631

STM32驱动MG996R舵机的PWM控制与闭环原理

舵机是一种典型的模拟闭环伺服系统,其核心是通过电位器反馈实现角度位置的自动校正。工作原理基于负反馈控制:目标PWM脉宽决定期望角度,电位器输出实时反馈实际角度,控制电路计算偏差并驱动电机消除误差。该机制赋予舵机强带载能力与抗干扰性,是机器人、云台、智能执行器等场景的关键执行单元。在嵌入式开发中,STM32通过定时器生成标准20ms周期、0.5–2.5ms脉宽的PWM信号,需严格遵循电气规范,并解决PA15引脚SWJ复用冲突、定时器重映射及CCR精度计算等关键问题。本文深入解析MG996R舵机控制全流程,涵盖

weixin_42600407的博客 562

自定义LayoutManager实现android-pile-layout滑动卡片堆叠效果

这是我的第一篇博客,总算有个契机开始写博客了,就从自定义LayoutManager开始吧。 前段时间看到一个项目(android-pile-layout),效果特别不错,这是效果图: 效果确实不错,我看了下实现,是用的自定义的ViewGroup实现的,计算什么还搞的挺复杂的,具体的没细看。作者说也尝试过用LayoutManager实现,但是没找到合适的数学模型,好吧,看到数学模型我

u014296305的博客 1万+

python爬虫酷狗音乐_Python爬虫教程:爬取酷狗音乐

介绍你是不是常常想要在各大音乐网站上下载音乐?但是网站却逼迫你下载他们的应用?然而,你下载了应用,它们却逼迫你购买vip......没关系,今天我们就来用爬虫手段“制裁”这些网站!首先,就由最简单的酷狗音乐开始爬!功能概述让用户输入要搜索的音乐名,然后把所有的音乐以及每一个音乐对应的信息展示给用户。再询问用户要不要下载任何音乐,如果要,则让用户输入音乐对应的id号来下载(支持批量下载)。...

weixin_29168393的博客 8906

YOLOv8实战:5分钟搞定Windows环境下的目标检测模型部署(附常见报错解决方案)

本文详细介绍了在Windows环境下快速部署YOLOv8目标检测模型的实战指南,包括环境配置、模型加载、快速验证及常见报错解决方案。通过5分钟快速入门教程,帮助开发者高效实现计算机视觉应用,特别适合需要快速上手的AI开发者。

weixin_30566063的博客 556

Python爬虫实战-批量爬取下载网易云音乐

我们要通过Python得到这个请求地址,需要进行js逆向,破解,得到js方法源代码,然后进行模拟拼接动态请求,得到音乐二进制文件,锋哥上有老,下有小,容易受到律师函,进去踩缝纫车,就不搞这种方式。近日锋哥又卷了一波Python实战课程-批量爬取下载网易云音乐,主要是巩固下Python爬虫基础。谷歌 F12 进入开发者工具,点 Media 我们是可以得到音乐的源文件的。第三步,我们点 音乐列表 前面的播放按钮,当前页面底部会出现播放器,播放音乐。现在我们要爬取这里面的音乐文件,我们正常人的分析思路是这样的。

java1234的博客 4370

面向边缘计算的YOLOv12模型剪枝-蒸馏联合优化实战教程**

这套剪枝-蒸馏联合方案的优势在于其系统性和可靠性。它不是单一的技巧,而是一套完整的工程流程,确保了从研发到部署的无缝衔接。

FJN110的博客 159

【Python】秋招机考 —— 2025/8/27 华为 AI 方向

2025 华为 AI 秋招机考题目包含15道单选题、5道多选题和2道机器学习编程题,涵盖核心算法与数学知识。单选题考察了Softmax激活、Transformer位置编码、Jacobi迭代、大模型幻觉现象、特征向量、K-means聚类、矩阵秩、实对称矩阵性质、SVD分解、概率论等知识点。多选题涉及高斯-赛德尔迭代和朴素贝叶斯分类器。

一杯水果茶!足矣~ 840

python网易云爬虫——实现网易云歌词的爬取(输入歌手的id,即可实现歌词的爬取)

python网易云爬虫——实现网易云歌词的爬取(输入歌手的id,即可实现歌词的爬取) 1、网页的分析 打开网易云音乐,找到任意一位歌手的歌曲界面(我们以邓紫棋的《来自天堂的魔鬼》为例)。 第一步:尝试常规思路,把网页的源码爬下来,直接对源码的分析,提取出来对应的歌词。上代码: import requests #引入request库 url = 'http://music.163.com/#/...

一个偶尔更新,有点神经质的开发人员,专注于网络安全和人工智能应用领域。 4942

Unity零基础到入门 ☀️| 小万字教程 对 Unity 中的 协程 ❤️全面解析+实战演练❤️

Unity,为了让Unity基础知识专栏更加完善,又肝了一篇协程来学习。 协程在Unity中还是很常用的,一起来看一下协程的基本概念和使用方法吧!

努力前行,总会成为自己心中的那道光 8万+

用Python网络爬虫来抓取网易云音乐歌词

前几天小编给大家分享了数据可视化分析,在文尾提及了网易云音乐歌词爬取,今天小编给大家分享网易云音乐歌词爬取方法。 本文的总体思路如下: 找到正确的URL,获取源码; 利用bs4解析源码,获取歌曲名和歌曲ID; 调用网易云歌曲API,获取歌词; 将歌词写入文件,并存入本地。 本文的目的是获取网易云音乐的歌词,并将歌词存入到本地文件。整体的效果图如下所示: ...

pdcfighting的博客 3570

jdk-8u144-linux-x64.tar.gz.

该资源为搭建Linux系统Java环境用,资源的后缀为tar.gz格式的压缩包

Devexpress16.2.6破解工具

Devexpress16.2.6破解工具Devexpress16.2.6破解工具Devexpress16.2.6破解工具Devexpress16.2.6破解工具

python源码_Python爬虫教程爬取酷狗音乐源码

在常见的几个音乐网站里,酷狗可以说是最好爬取的啦,什么弯都没有,也没加密啥的,所以最适合小白入门爬虫项目源码import requestsfrom selenium import webdriverfrom pyquery import PyQuery as pq#获取歌名def Access_to_the_song(C): doc=pq(C) The_song=doc('....

weixin_39916758的博客 1307

Statistics and Machine Learning Toolbox

Statistics and Machine Learning Toolbox(带书签),MATLAB统计学习工具

手把手教你用Python网络爬虫获取网易云音乐歌曲

前天给大家分享了用Python网络爬虫爬取了网易云歌词,在文尾说要爬取网易云歌曲,今天小编带大家一起来利用Python爬取网易云音乐,分分钟将网站上的音乐down到本地。 跟着小编运行过代码的筒子们将网易云歌词抓取下来已经不再话下了,在抓取歌词的时候在函数中传入了歌手ID和歌曲名两个参数,其实爬取歌曲也是同样的道理,也需要传入这两个参数,只不过网易云歌曲的URL一般人找不到。不过也不要慌,有小编在,分分钟扫除您的烦恼。 网易云歌曲一般会有一个外链,专门用于下载音乐音频的,以赵雷的歌曲《成都》为例,《成都》的

pdcfighting的博客 2485

精雕软件(JDpaint) 5.5 绿色版

精雕软件(JDpaint) 5.5 绿色版精雕软件(JDpaint) 5.5 绿色版精雕软件(JDpaint) 5.5 绿色版

上一篇: Python-requests模块详解!
下一篇: Pycharm下载安装汉化教程!
Python_trys
博客等级 码龄2年 4369粉丝 377原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值