


前言
正则表达式是对字符串的一种逻辑公式,用事先定义好的一些特定字符、及这些特定字符的组合,组成一个“规则的字符串”,此字符串用来表示对字符串的一种“过滤”逻辑。正在在很多开发语言中都存在,而非python独有。对其知识点进行总结后,会写一个demo。
1.正则表达式
python是自1.5开始引进re模块进行处理正则的。我先把正则的匹配规则总结一下,再总结re模块相应的方法。
1.1匹配规则
| 语法 | 解释 | 表达式 | 成功匹配对象 |
|---|---|---|---|
| 一般字符 | 匹配自身相对应的字符 | abc | abc |
| . | 匹配除换行符(\n)以外的任意字符 | a.c | abc |
| \ | 转义字符,可以改变原字符的意思 | a.c | a.c |
| \d | 匹配数字:0~9 | \dabc | 1abc |
| \w | 匹配单词字符,az;AZ;0~9 | \w\w\w | oX2 |
| \s | 匹配空格字符(\t,\n,\r,\f,\v) | a\sc | a c |
| \D | 匹配非数字字符 | \Dabc | aabc |
| \W | 匹配非单词字符 | a\Wc | a c |
| \S | 匹配非空格字符 | \S\Sc | 1bc |
| [] | 字符集,对应位置上可以是字符集里的任意字符 | a[def]c | aec |
| [^] | 对字符集当中的内容进行取反 | a[^def]c | a2c |
| [a-z] | 指定一个范围字符集 | a[A-Z]c | aBc |
| * | 允许前一个字符可以出现0次或者无限次 | a*b | aaab或b |
| + | 前一个字符至少出现1次 | a+b | aaab或ab |
| ? | 前一个字符只能出现一次或者不出现 | a?b | ab或b |
| {m} | 允许前一个字符只能出现m次 | a{3}b | aaab |
| {m,n} | 允许前一个字符至少出现m次,最多出现n次(如果不写n,则代表至少出现m次) | a{3,5}b和a{3,} | aaaab和aaaaaab |
| ^ | 匹配字符串的开始,多行内容时匹配每一行的开始 | ^abc | abc |
| $ | 匹配字符串的结尾,多行内容时匹配每一行的结尾 | abc& | abc |
| \A | 匹配字符串开始位置,忽略多行模式 | \Aabc | abc |
| \Z | 匹配字符串结束位置,忽略多行模式 | abc\Z | abc |
| \b | 匹配位于单词开始或结束位置的空字符串 | hello \bworld | hello world |
| \B | 匹配不位于单词开始或结束位置的空字符串 | he\Bllo | hello |
| 表示左右表达式任意满足一种即可 | abc | ||
| (…) | 将被括起来的表达式作为一个分组,可以使用索引单独取出 | (abc)d | abcd |
| (?P…) | 为该分组起一个名字,可以用索引或名字去除该分组 | (?Pabc)d | abcd |
| \number | 引用索引为number中的内容 | (abc)d\1 | abcdabc |
| (?P=name) | 引用该name分组中的内容 | (?Pabc)d(?P=id) | abcdabc |
| (?:…) | 分组的不捕获模式,计算索引时会跳过这个分组 | (?:a)b©d\1 | abcdc |
| (?iLmsux) | 分组中可以设置模式,iLmsux之中的每个字符代表一个模式 | (?i)abc | Abc |
| (?#…) | 注释,#后面的内容会被忽略 | ab(?#注释)123 | ab123 |
| (?=…) | 顺序肯定环视,表示所在位置右侧能够匹配括号内正则 | a(?=\d) | a1最后的结果得到a |
| (?!…) | 顺序否定环视,表示所在位置右侧不能匹配括号内正则 | a(?!\w) | a c最后的结果得到a |
| (?<=…) | 逆序肯定环视,表示所在位置左侧能够匹配括号内正则 | 1(?<=\w)a | 1a |
| (?<!…) | 逆序否定环视,表示所在位置左侧不能匹配括号内正则 | 1 (?<!\w)a | 1 a |
| (?(id/name)yes | no) | 如果前面的索引为id或者名字为name的分组匹配成功则匹配yes区域的表达式,否则匹配no区域的表达式,no可以省略 | (\d)(?(1)\d |
上面表格中(?iLmsux)这里的”i”, “L”, “m”, “s”, “u”, “x”,它们不匹配任何字串,而对应re模块中(re.S|re.S):
I:re.I# 忽略大小写
L:re.L# 字符集本地化,为了支持多语言版本的字符集使用环境
U :re.U# 使用\\w,\\W,\\b,\\B这些元字符时将按照UNICODE定义的属性
M:re.M # 多行模式,改变 ^ 和 $ 的行为
S:re.S  # '.' 的匹配不受限制,包括换行符
X:re.X # 冗余模式,可以忽略正则表达式中的空白和#号的注释
对于一个特殊字符在正则表达式中是不能正常识别的,如果接触过其他语言我们就这到有一个叫做转移字符的东西的存在,在特殊字符前加用反斜杠接口。比如\n换行\\为反斜杠,在这不再累述。下面来介绍一下re这个模块。
1.2.re模块
此模块主要方法如下
re.match()#尝试从字符串的起始位置匹配一个模式(pattern),如果不是起始位置匹配成功的话,match()就返回None
re.search()#函数会在字符串内查找模式匹配,只要找到第一个匹配然后返回,如果字符串没有匹配,则返回None。
re.findall()#遍历匹配,可以获取字符串中所有匹配的字符串,返回一个列表。
re.compile()#编译正则表达式模式,返回一个对象的模式。(可以把那些常用的正则表达式编译成正则表达式对象,这样可以提高一点效率。)
re.sub()#使用re替换string中每一个匹配的子串后返回替换后的字符串。
re.subn()#返回替换次数
re.split()#按照能够匹配的子串将string分割后返回列表。
1.2.1.re.match()
方法: re.match(pattern, string, flags=0)#pattern:正则表达式(或者正则表达式对象)string:要匹配的字符串flags:修饰符
先看一个最简单的用法
import re
content \='Hello 123 4567 wangyanling REDome'
print(len(content))
result \= re.match('^Hello\\s\\d\\d\\d\\s\\d{4}\\s\\w{10}.\*Dome$', content)
print(result)
print(result.group())
print(result.span())
结果:
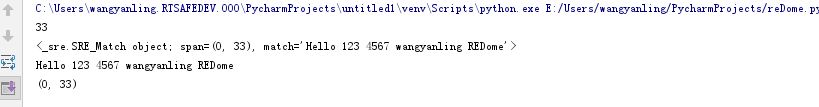
匹配规则就不在累述,以上需要注意的是
(1)**.group()**表示的是返回正则匹配的结果
(2)**.span()**表示返回正则匹配的范围
使用:
以上我们已经知道re.matcha()的具体方法,那么接下我来看一下具体使用,对此我们要理解以下几种匹配的感念。
1.泛匹配(.*):匹配所有字符
import re
content \='Hello 123 4567 wangyanling REDome'
result \= re.match('^Hello.\*Dome$', content)
print(result)
print(result.group())
print(result.span())
它的结果是和上面的输出结果完全一样的。
2.目标匹配(()):将需要的字符匹配出来
import re
content \='Hello 123 4567 wangyanling REDome'
result \= re.match('^Hello\\s\\d\\d(\\d)\\s\\d{4}\\s\\w{10}.\*Dome$', content)
print(result)
print(result.group(1))
import re
content \='Hello 123 4567 wangyanling REDome'
result \= re.match('^Hello\\s(\\d+)\\s\\d{4}\\s\\w{10}.\*Dome$', content)
print(result)
print(result.group(1))
结果
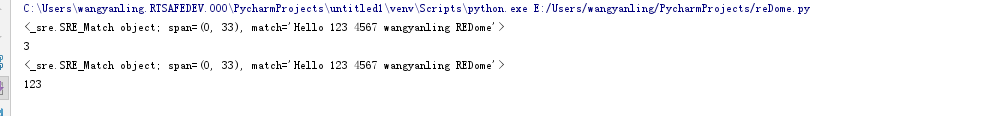
以上可以看出:
(1)_()_匹配括号内的表达式,也表示一个组
(2)+ 匹配1个或多个的表达式
* 匹配0个或多个的表达式
(3).group(1)—输出第一个带有()的目标
3.贪婪匹配(.*()):匹配尽可能少的的结果
import re
content \='Hello 123 4567 wangyanling REDome'
result \= re.match('^H.\*(\\d+).\*Dome$', content)
print(result)
print(result.group(1))
结果

**4.贪婪匹配(.\*?()):匹配尽可能多的结果**
import re
content \='Hello 123 4567 wangyanling REDome'
result \= re.match('^H.\*?(\\d+).\*?Dome$', content)
print(result)
print(result.group(1))
结果

以上3,4两个匹配方式请尽量采用非贪婪匹配
**5.其他**
换行:
import re
content \='''Hello 123 4567
         wangyanling REDome'''

result \= re.match('^H.\*?(\\d+).\*?Dome$', content,re.S)#re.S
print(result.group(1))
result \= re.match('^H.\*?(\\d+).\*?Dome$', content)
print(result.group(1))
结果:

转义字符:
import re
content \= 'price is $5.00'
result \= re.match('price is $5.00', content)
print(result)
result \= re.match('price is \\$5\\.00', content)
print(result)
结果:

其中re.I使匹配对大小不敏感,re.S匹配包括换行符在内的所有字符,\进行处理转义字符。匹配规则中有详细介绍。
1.2.2.re.search()
方法:
re.search(pattern, string, flags=0)#pattern:正则表达式(或者正则表达式对象)string:要匹配的字符串flags:修饰符
    #re.match()和re.search()用法类似唯一的区别在于re.match()从字符串头开始匹配,若头匹配不成功,则返回None
对比一下与match()
import re
content \='Hello 123 4567 wangyanling REDome'
result \= re.match('(\\d+)\\s\\d{4}\\s\\w{10}.\*Dome$', content)
print(result)#从开头开始查找,不能匹配返回None
result = re.search('(\\d+)\\s\\d{4}\\s\\w{10}.\*Dome$', content)
print(result)
print(result.group())
结果:
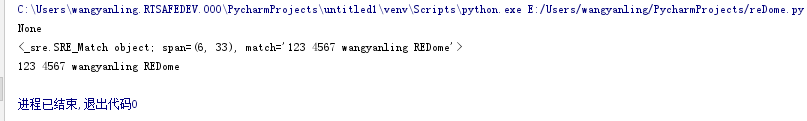
可以看出两个使用基本一致,search从头开始匹配,如果匹配不到就返回none.
1.2.3.re.findall()
方法: re.finditer(pattern, string, flags=0)#pattern:正则表达式(或者正则表达式对象)string:要匹配的字符串flags:修饰符
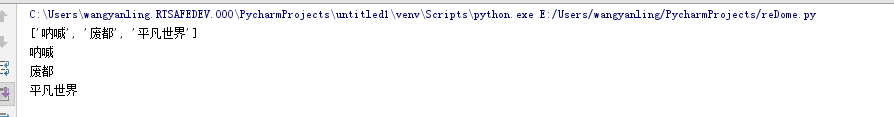
与re.search()类似区别在于re.findall()搜索string,返回一个顺序访问每一个匹配结果(Match对象)的迭代器。找到 RE 匹配的所有子串,并把它们作为一个迭代器返回。
import re

html \= '''
  <div>
  <li><a href="" singer="鲁迅"\>呐喊</a></li>
  <li><a href="#" singer="贾平凹"\>废都</a></li>
  <li class\="active"\><a href="#" singer="路遥"\>平凡世界</a></li>
  <span class\="rightSpan"\>谢谢支持</span>
  </div>
'''
regex\_4='<a.\*?>(.\*?)</a>'
results\=re.findall(regex\_4,html,re.S)
print(results)
for result in results:
    print(result)
结果:
1.2.4.re.compile()
编译正则表达式模式,返回一个对象的模式。
方法: re.compile(pattern,flags=0)#pattern:正则表达式(或者正则表达式对象);flags:修饰符
看一个demo
import re
content \='Hello 123 4567 wangyanling REDome wangyanling 那小子很帅'
rr \= re.compile(r'\\w\*wang\\w\*')
result \=rr.findall(content)
print(result)
结果:

我们可以看出compile 我们可以把它理解为封装了一个公用的正则,类似于方法,然后功用。
1.2.5.其他
re.sub 替换字符
方法: re.sub(pattern, repl, string, count=0, flags=0)#pattern:正则表达式(或者正则表达式对象)repl:替换的字符串string:要匹配的字符串count:要替换的个数flags:修饰符
re.subn 替换次数
方法: re.subn(pattern, repl, string, count=0, flags=0)#pattern:正则表达式(或者正则表达式对象)repl:替换的字符串string:要匹配的字符串count:要替换的个数flags:修饰符
re.split()分隔字符
方法
re.split(pattern, string,\[maxsplit\])#正则表达式(或者正则表达式对象)string:要匹配的字符串;maxsplit:用于指定最大分割次数,不指定将全部分割
2.案例:爬取猫眼信息,写入txt,csv,下载图片
2.1.获取单页面信息
def get\_one\_page(html):
    pattern\= re.compile('<dd>.\*?board-index.\*?>(\\d+)</i>.\*?data-src="(.\*?)".\*?name"><a.\*?>(.\*?)</a>.\*?star">(.\*?)</p>.\*?releasetime'
                         + '.\*?>(.\*?)</p>.\*?score.\*?integer">(.\*?)</i>.\*?>(.\*?)</i>.\*?</dd>',re.S)#这里就用到了我们上述提到的一些知识点,非贪婪匹配,对象匹配,修饰符
    items = re.findall(pattern,html)
    for item in  items:
        yield {
            'rank' :item\[0\],
            'img':  item\[1\],
            'title':item\[2\],
            'actor':item\[3\].strip()\[3:\] if len(item\[3\])>3 else '',
            'time' :item\[4\].strip()\[5:\] if len(item\[4\])>5 else '',
            'score':item\[5\] + item\[6\]
        }
对于上面的信息我们可以看出是存到一个对象中那么接下来我们应该把它们存到文件当中去。
2.2.保存文件
我写了两种方式保存到txt和csv这些在python都有涉及,不懂得可以去翻看一下。
2.2.1.保存到txt
def write\_txtfile(content):
    with open("Maoyan.txt",'a',encoding='utf-8') as f:
        #要引入json,利用json.dumps()方法将字典序列化,存入中文要把ensure\_ascii编码方式关掉
        f.write(json.dumps(content,ensure\_ascii=False) + "\\n")
        f.close()
结果: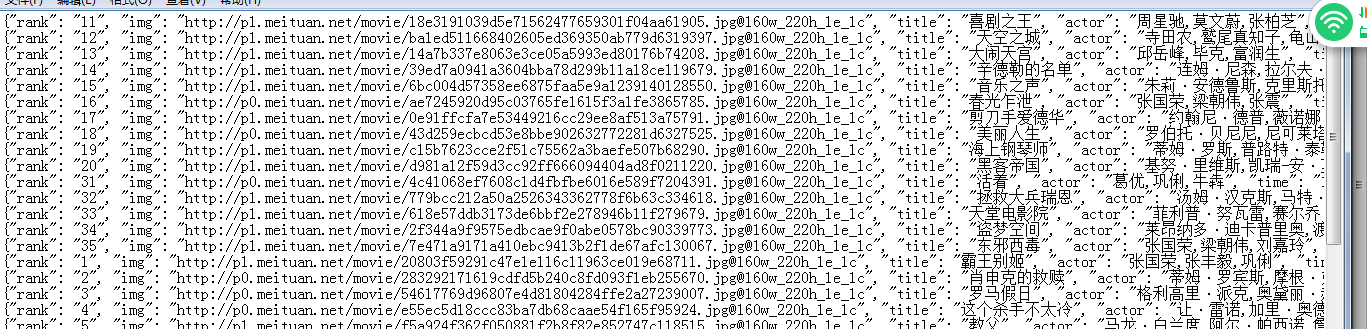
以上看到并非按顺序排列因为我用的是多线程。
2.2.2.保存到csv
def write\_csvRows(content,fieldnames):
    '''写入csv文件内容'''
    with open("Maoyao.csv",'a',encoding='gb18030',newline='') as f:
        #将字段名传给Dictwriter来初始化一个字典写入对象
        writer = csv.DictWriter(f,fieldnames=fieldnames)
        #调用writeheader方法写入字段名
        writer.writerows(content)
        f.close()
结果:
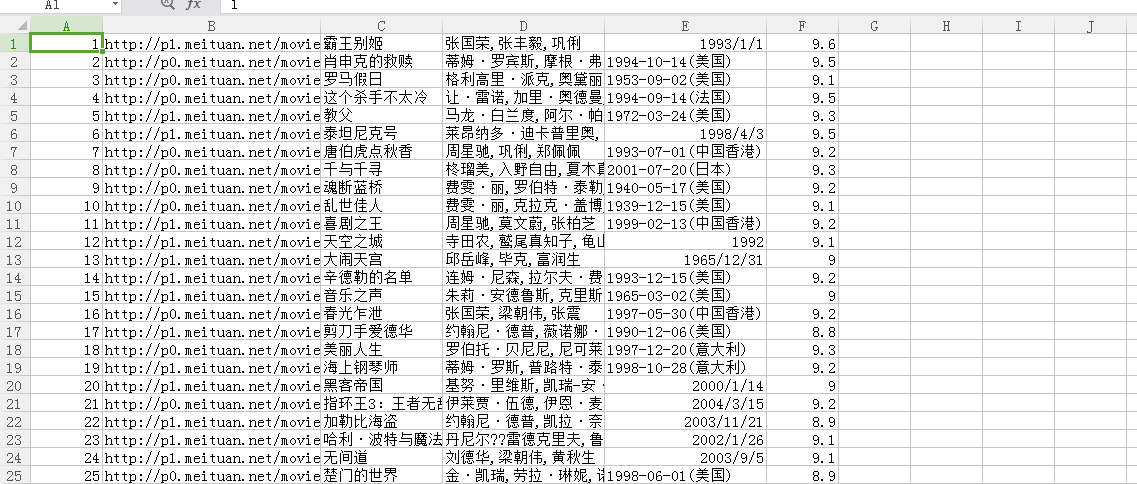
那么还有一部就是我们要把图片下载下来。
2.2.3.下载图片
def download\_img(title,url):
   r\=requests.get(url)
   with open(title+".jpg",'wb') as f:
        f.write(r.content)
2.3.整体代码
这里面又到了多线程在这不在叙述后面会有相关介绍。这个demo仅做一案例,主要是对正则能有个认知。上面写的知识点有不足的地方望大家多多指教。
#抓取猫眼电影TOP100榜
from multiprocessing import Pool
from requests.exceptions import RequestException
import requests
import json
import time
import csv
import re
def get\_one\_page(url):
    '''获取单页源码'''
    try:
        headers \= {
            "User-Agent":"Mozilla/5.0(WindowsNT6.3;Win64;x64)AppleWebKit/537.36(KHTML,likeGecko)Chrome/68.0.3440.106Safari/537.36"
        }
        res \= requests.get(url, headers=headers)
        # 判断响应是否成功,若成功打印响应内容,否则返回None
        if res.status\_code == 200:
            return res.text
        return None
    except RequestException:
        return None
def parse\_one\_page(html):
    '''解析单页源码'''
    pattern \= re.compile('<dd>.\*?board-index.\*?>(\\d+)</i>.\*?data-src="(.\*?)".\*?name"><a.\*?>(.\*?)</a>.\*?star">(.\*?)</p>.\*?releasetime'
                         + '.\*?>(.\*?)</p>.\*?score.\*?integer">(.\*?)</i>.\*?>(.\*?)</i>.\*?</dd>',re.S)
    items \= re.findall(pattern,html)
    #采用遍历的方式提取信息
    for item in  items:
        yield {
            'rank' :item\[0\],
            'img':  item\[1\],
            'title':item\[2\],
            'actor':item\[3\].strip()\[3:\] if len(item\[3\])>3 else '',  #判断是否大于3个字符
            'time' :item\[4\].strip()\[5:\] if len(item\[4\])>5 else '',
            'score':item\[5\] + item\[6\]
        }

def write\_txtfile(content):
    with open("Maoyan.txt",'a',encoding='utf-8') as f:
        #要引入json,利用json.dumps()方法将字典序列化,存入中文要把ensure\_ascii编码方式关掉
        f.write(json.dumps(content,ensure\_ascii=False) + "\\n")
        f.close()
def write\_csvRows(content,fieldnames):
    '''写入csv文件内容'''
    with open("Maoyao.csv",'a',encoding='gb18030',newline='') as f:
        #将字段名传给Dictwriter来初始化一个字典写入对象
        writer = csv.DictWriter(f,fieldnames=fieldnames)
        #调用writeheader方法写入字段名
        #writer.writeheader()            ###这里写入字段的话会造成在抓取多个时重复.
        writer.writerows(content)
        f.close()
def download\_img(title,url):
   r\=requests.get(url)
   with open(title+".jpg",'wb') as f:
        f.write(r.content)
def main(offset):
    fieldnames \= \["rank","img", "title", "actor", "time", "score"\]
    url \= "http://maoyan.com/board/4?offset={0}".format(offset)
    html \= get\_one\_page(url)
    rows \= \[\]
    for item in parse\_one\_page(html):
        #download\_img(item\['rank'\]+item\['title'\],item\['img'\])
        write\_txtfile(item)
        rows.append(item)
    write\_csvRows(rows,fieldnames)

if \_\_name\_\_ == '\_\_main\_\_':
    pool \= Pool()
    #map方法会把每个元素当做函数的参数,创建一个个进程,在进程池中运行.
    pool.map(main,\[i\*10 for i in range(10)\])
如果你是准备学习Python或者正在学习(想通过Python兼职),下面这些你应该能用得上: 包括:Python安装包、Python web开发,Python爬虫,Python数据分析,人工智能、自动化办公等学习教程。带你从零基础系统性的学好Python!
 5860


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


