Python爬虫入门篇!

什么是网络爬虫 又称为网页蜘蛛,网络机器人,在FOAF社区中间,更经常的称为网页追逐者,是一种按照一定的规则,自动地抓取万维网信息的程序或者脚本。网络爬虫可以根据指定的规则,从互联网上下载网页、图片、视频等内容,并抽取其中的有用信息进行处理。网络爬虫的工作流程包括获取网页源代码、解析网页内容、存储数据等步骤。根据其目的和工作方式的不同,网络爬虫可以分为多种类型。常见的网络爬虫包括通用爬虫、聚焦爬虫、增量式爬虫等。 阅读详情

之前听说Python这方面比较强,就想用Python试试,之前也没用过Python。所以,边爬边学,边学边爬。废话不多说,进入正题。

  1.首先是获取目标页面,这个对用python来说,很简单

#encoding=utf8
import urllib

res = urllib.urlopen("http://www.baidu.com")
print res.read()

  运行结果和打开百度页面,查看源代码一样。这里针对python的语法有几点说明。

    a).import 就是引入的意思,java也用import,C/C++用的是include,作用一样

    b).urllib 这个是python自带的模块,在以后开发的时候,如果遇到自己需要的功能,python自带的模块中没有的时候,可以试着去网上找一找,比如需要操作MySql数据  库,这个时候python是没有自带的,就可以在网上找到MySQLdb,然后安装引入就行了。

    c).res是一个变量,不用像java,C语言那样声明。用的时候直接写就行了

    d).标点符号。像java,C这些语言,每行代码后面都要用分号或者别的符号,作为结束标志,python不用,用了反了会出错。不过有的时候,会用标点符号,比如冒号,  这个后面再说

    e).关于print,在python2.7中,有print()函数,也有print 语句,作用基本差不多。

    f).#注释

    g).encoding=utf8代表使用utf8编码,这个在代码中有中文的时候特别有用

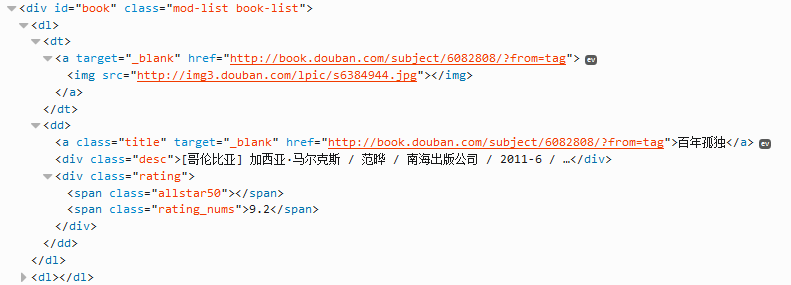
  2.解析获取的网页中的元素,取得自己想要的,以豆瓣为例,我们想获取这个页面中的所有书籍名称(仅供学习交流)

  http://www.douban.com/tag/%E5%B0%8F%E8%AF%B4/?focus=book
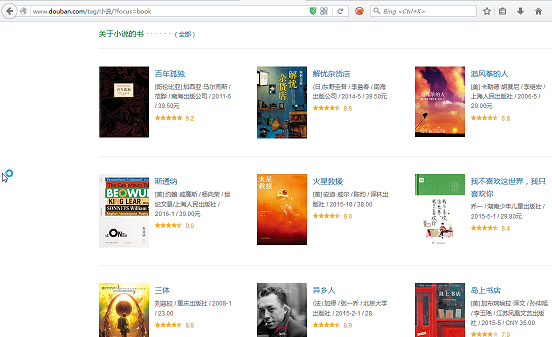
  

  首先获取页面代码:

#encoding=utf8
import urllib
res = urllib.urlopen("http://www.douban.com/tag/%E5%B0%8F%E8%AF%B4/?focus=book")
print res.read()

  获取结果,通过分析页面源代码(建议用firefox浏览器,按F12,可看到源代码),可以定位到有效代码如下:
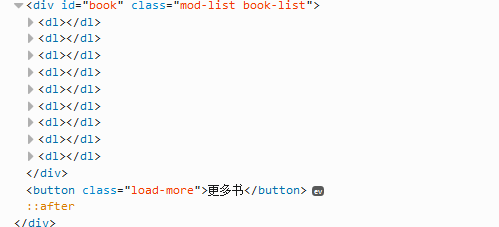


  下面我们开始解析(这里用BeautifulSoup,自行下载安装),基本流程:

    a).缩小范围,这里我们通过id="book"获取所有的书

    b).然后通过class="title",遍历所有的书名。

  代码如下: 

#encoding=utf8
import urllib
import BeautifulSoup

res = urllib.urlopen("http://www.douban.com/tag/%E5%B0%8F%E8%AF%B4/?focus=book")
soup = BeautifulSoup.BeautifulSoup(res)
book_div = soup.find(attrs={"id":"book"})
book_a = book_div.findAll(attrs={"class":"title"})
for book in book_a:
    print book.string

  代码说明:

    a).book_div    通过id=book获取div标签

    b).book_a    通过class="title"获取所有的book  a标签

    c).for循环     是遍历book_a所有的a标签

    d).book.string  是输出a标签中的内容

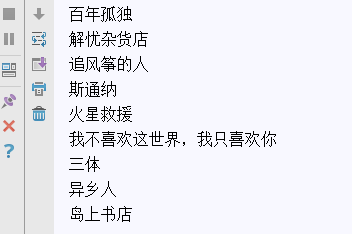
  结果如下:
  

  3.存储获取的数据,比如写入数据库,我的数据库用的Mysql,这里就以Mysql为例(下载安装MySQLdb模块这里不做叙述),只写怎么执行一条sql语句

  代码如下:

connection = MySQLdb.connect(host="***",user="***",passwd="***",db="***",port=3306,charset="utf8")
cursor = connection.cursor()
sql = "*******"
sql_res = cursor.execute(sql)
connection.commit()
cursor.close()
connection.close()

  说明:

    a).这段代码是执行sql语句的流程,针对不同的sql语句,会有不同的处理。比如,执行select的语句,我怎么获取执行的结果,执行update语句,怎么之后成没成功。这  些就要自己动手了

    b).创建数据库的时候一定要注意编码,建议使用utf8

  4.至此,一个简单的爬虫就完成了。之后是针对反爬虫的一些策略,比如,用代理突破ip访问量限制

最后,如果你对Python感兴趣,想要学习python,希望可以帮到你,一起加油!以上是给大家分享的Python全套学习资料,都是我自己学习时整理的:

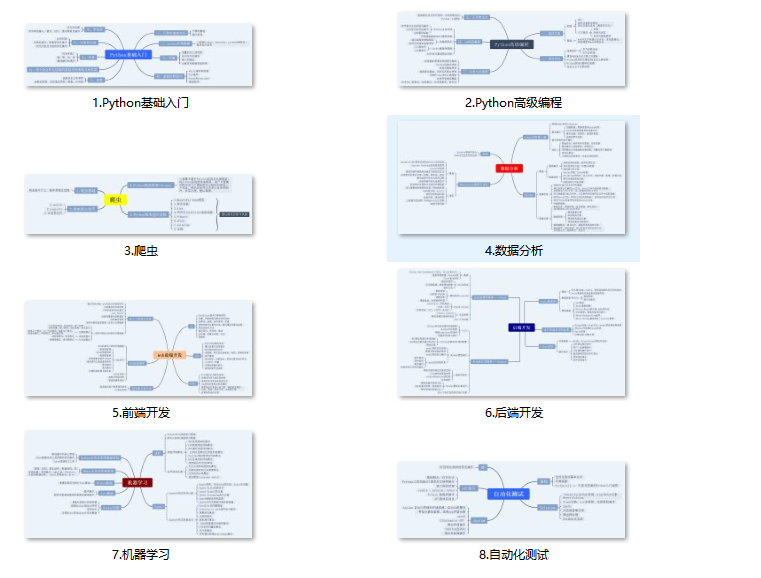
一、Python所有方向的学习路线

Python所有方向路线就是把Python常用的技术点做整理,形成各个领域的知识点汇总,它的用处就在于,你可以按照上面的知识点去找对应的学习资源,保证自己学得较为全面。
图片

图片

二、学习软件

工欲善其事必先利其器。学习Python常用的开发软件都在这里了,还有环境配置的教程,给大家节省了很多时间。
图片

三、全套PDF电子书

书籍的好处就在于权威和体系健全,刚开始学习的时候你可以只看视频或者听某个人讲课,但等你学完之后,你觉得你掌握了,这时候建议还是得去看一下书籍,看权威技术书籍也是每个程序员必经之路。
图片

四、入门学习视频全套

我们在看视频学习的时候,不能光动眼动脑不动手,比较科学的学习方法是在理解之后运用它们,这时候练手项目就很适合了。
图片

图片

五、实战案例

光学理论是没用的,要学会跟着一起敲,要动手实操,才能将自己的所学运用到实际当中去,这时候可以搞点实战案例来学习。
图片

图片

 **学习资源已打包,需要的小伙伴可以戳这里:【学习资料】 

Python-网络爬虫 网络爬虫(Web Spider)又称网络蜘蛛或网络机器人,是一段用来实现自动采集网站数据的程序。网络爬虫不仅能够为搜索引擎采集网络信息,而且还可以作为定向信息采集器,定向采集某些网站中的特定信息。对于定向信息的爬取,网络爬虫主要采取数据抓取、数据解析、数据入库的操作流程。(1)数据抓取:发送构造的HTTP请求,获得包含所需数据的HTTP响应;(2)数据解析:对HTTP响应的原始数据进行分析、清洗,以提取出所需要的数据;(3)数据入库:将数据进一步保存到数据库(或文本文件)中,用于构建知识库。 阅读详情

相关推荐

五分钟学会Python网络爬虫

但不管怎样,爬虫技术是无罪的,还是值得我们开发人员去学习了解一下的。在学习之前,我们还是要先了解一下相关概念。 什么是爬虫 网络爬虫:又被称为网页蜘蛛,网络机器人,是一种按照一定的规则,自动的抓取万维网信息的程序或者脚本。 大数据时代,要进行数据分析,首先要有数据源,可数据源从哪里来,花钱买,没预算,只能从其它网站就行抓取。 细分下来,业内分为两类:爬虫和反爬虫。 反爬虫:顾名思义,就是防止你来我网站或APP上做爬虫的。 爬虫工程师和反爬虫工程师是一对相爱相杀的小伙伴,经常因为对方要加班写代码,

python588的博客 2355

Python BeautifulSoup中文乱码问题的2种解决方法

解决方法一: 使用python的BeautifulSoup来抓取网页然后输出网页标题,但是输出的总是乱码,找了好久找到解决办法,下面分享给大家 首先是代码 from bs4 import BeautifulSoup import urllib2 url = 'http://www.jb51.net/' page = urllib2.urlopen(url) soup = Beau

GYZ的csdn 2万+

手把手教你用CCS v7.3调试TI DSP28377:从连接仿真器到看懂Flash里的秘密

本文详细介绍了使用CCS v7.3调试TI DSP28377的全过程,从连接仿真器到解析Flash启动机制。通过实战演示和关键配置要点,帮助工程师快速掌握DSP调试技巧,并深入探讨bootloader设计与在线升级的实现方法,提升开发效率。

weixin_29158413的博客 408

python爬虫入门

毕设是做爬虫相关的,本来想的是用java写,也写了几个爬虫,其中一个是爬网易云音乐的用户信息,爬了大概100多万,效果不是太满意。之前听说Python这方面比较强,就想用Python试试,之前也没用过Python。所以,边爬边学,边学边爬。废话不多说,进入正题。   1.首先是获取目标页面,这个对用python来说,很简单 #encoding=utf8import urllib re...

weixin_33720078的博客 107

基于51单片机的电压表【0-20V,ADC0832,4051,自动量程】(仿真)

自动换挡式数字电压表就是一个基于单片机的能自动切换量程的数字电压表,其作用是在使用低位的AD转换实现高精度电压测量,可以测量0~20V的电压,并且具有0~0.2V(待测电玉低于0.2V时),0~2V(待测电压低于2V时)和0~20V三个量程自动匹配测量,当待测电压值发生变化时,电压表可以根据输入电压情况自动选择合适的量程进行测量,并且把测量结果显示出来。(2)实现电压表精度测试,最高精度要求0.01V;(1)实现0~20V分3档式电压表;

qq_63964231的博客 1497

数据库行转列的sql语句

 问题描述假设有张学生成绩表(CJ)如下Name Subject Result张三 语文 80张三 数学 90张三 物理 85李四 语文 85李四 数学 92李四 物理 82现在 想写  sql 语句     查询后结果 为    姓名 语文 数学 物理张三 80 90 85李四 85 92 82       该怎么实现 ?研究意义        这是个并不复杂的问题,但却是数

jb303的专栏 2248

python爬取网页有乱码怎么解决_python用beautifulsoup爬取网页时出现乱码的解决方法...

一、原因:在用beutifulsoup爬取网页的信息时,我们会遇到信息变成乱码的情况,之所以出现这种情况,是因为requests和beautifulsoup模块都会自行评测原网页的编码格式。二、解决办法:(1)查看网页编码格式:既然要将soup中编码格式改为正确的,那我们首先就要知道你要爬取的网页编码格式是什么。首先是F12—>到控制台Console—>输入document.charset。此处的...

weixin_39990660的博客 853

32位MIPS流水线CPU设计

32位MIPS流水线CPU设计(vivado)

m0_51320209的博客 3201

Python网络爬虫入门篇!

Beautiful Soup提供一些简单的、python式的函数用来处理导航、搜索、修改分析“标签树”等功能。它是一个工具箱,通过解析文档为用户提供需要抓取的数据,因为简单,所以不需要多少代码就可以写出一个完整的应用程序。Beautiful Soup自动将输入文档转换为Unicode编码,输出文档转换为utf-8编码。你不需要考虑编码方式,除非文档没有指定一个编码方式,这时,Beautiful Soup就不能自动识别编码方式了。然后,你仅仅需要说明一下原始编码方式就可以了。

Python_trys的博客 2015

Kali下RTL8812AU网卡5G抓包精准适配指南

WiFi监听模式是无线安全测试的基础能力,其核心在于网卡驱动对802.11a/n/ac协议栈的完整支持。RTL8812AU系列USB无线网卡因成本低、兼容性广被广泛用于渗透测试,但其芯片版本碎片化(如VA/VC/ACM)与Linux内核演进(6.1~6.5)存在严重适配断层,导致5GHz频段Beacon帧捕获失败、信道切换异常、注入功能残缺等典型问题。技术价值在于突破‘即插即用’幻觉,建立从USB设备ID识别、固件版本校验到射频寄存器级补丁的全链路可控流程。典型应用场景包括CTF无线赛题实战、红蓝对抗中的W

weixin_33783283的博客 762

基于SAHI算法优化YOLOv8的小目标检测性能研究

SAHI(SliceAwareHyperInference)是一种推理优化算法,通过将大图切片为小块并分别推理的方式,实现更精细的小目标检测。提升小目标检测精度:切片后的小目标在每个小块中占比更大,模型能够更好地聚焦。兼容性强:可直接集成到现有目标检测框架中(如YOLO系列、Detectron2等)。支持大分辨率图片和视频推理:减少硬件对大图推理的限制。本文详细探讨了如何通过SAHI(切片辅助超推理算法)结合YOLOv8模型,有效提升小目标检测性能,尤其是在高分辨率图片和视频场景中表现优异。

博客 2371

Python网络爬虫入门篇!(超详细)

Beautiful Soup提供一些简单的、python式的函数用来处理导航、搜索、修改分析“标签树”等功能。它是一个工具箱,通过解析文档为用户提供需要抓取的数据,因为简单,所以不需要多少代码就可以写出一个完整的应用程序。Beautiful Soup自动将输入文档转换为Unicode编码,输出文档转换为utf-8编码。你不需要考虑编码方式,除非文档没有指定一个编码方式,这时,Beautiful Soup就不能自动识别编码方式了。然后,你仅仅需要说明一下原始编码方式就可以了。

zw666284的博客 1万+

AI大模型探索之路-认知篇1-全景透视:揭秘AIGC技术的进化之路

随着人工智能技术的突飞猛进,内容创作方式的发生了革命性的转变;从早期专业人员主导的内容生产,到现如今生成式人工智(AIGC)能创作时代;本篇文章主要讲解AIGC技术的演变历程。

寻道AI,探索AI无限可能! 1649

python网络爬虫知识点(入门篇)超级有帮助!

爬虫能够自动访问互联网并提取数据,广泛应用于数据采集、搜索引擎、数据分析等领域。

2301_80945113的博客 1528

Vek385评估板(二):板子联网 & memtester安装(LPDDR5X测试)

继上一篇文章:Vek385评估板(一):EDF成功烧录启动及一些问题。 本章完成最主要的两个功能:开发板联网+内存 memtester。因为我是做测试行业的,所以这两个是最想试的。内存测试,除了FPGA测,也可以系统级测,本次在versal上实现这个功能,主要是可以应急。在没有安卓、X86的情况下,可以使用本方案测试。 下一篇会继续做一些其他功能。

千歌叹尽执夏的博客 222

SAP B1中文培訓教材_SDK

公司内部培训资料,对开发工具 ,DIAPI, UIAPI,Add-ON有详细解说

网络爬虫是什么?怎么学python爬虫

网络爬虫又称网络蜘蛛、网络机器人,它是一种按照一定的规则自动浏览、检索网页信息的程序或者脚本。网络爬虫能够自动请求网页,并将所需要的数据抓取下来。通过对抓取的数据进行处理,从而提取出有价值的信息。

Itmastergo的博客 3万+

Camera2Demo

在Camera2 的基础上进行封装,使得Camera2一堆初始化逻辑与Activity分离,降低耦合度,完成预览拍照并保存的操作

终于有人把网络爬虫讲明白了

摘要:Python网络爬虫的详尽解释。导读:网络爬虫也叫做网络机器人,可以代替人们自动地在互联网中进行数据信息的采集与整理。在大数据时代,信息的采集是一项重要的工作,如果...

苏克的博客 4342

计算机控制技术及应用

《计算机控制技术及应用》通过总结作者的科研成果和吸收国内外的先进理论、方法和技术,以计算机控制系统的网络化、开放化、智能化和集成化发展趋势为主线索,主要介绍计算机控制系统的基本概念和计算机控制系统的典型形式,计算机控制系统的数学描述与基本分析方法,以及数字PID控制器、最少拍控制系统、达林算法、状态变量设计法等设计方法及其各种改进算法。重点突出计算机控制系统输入输出通道接口的设计方法和典型控制系统的设计案例与实现方法等。

Python网络爬虫

网络爬虫(英语:web crawler),也叫网络蜘蛛(spider),是一种用来自动浏览万维网的网络机器人。通俗来讲,网络爬虫就是模拟浏览器发送网络请求,接收请求响应,一种按照一定的规则,自动地抓取互联网信息的程序。原则上,只要是浏览器(客户端)能做的事情,爬虫都能够做。

zgl040803的博客 2635

浅谈 Python 网络爬虫的那些事

在大数据、人工智能应用越来越普遍的今天,Python 可以说是当下世界上热门、应用广泛的编程语言之一,在人工智能、爬虫、数据分析、游戏、自动化运维等各个方面,无处不见其身影。随着大数据时代的来临,数据的收集与统计占据了重要地位,而数据的收集工作在很大程度上需要通过网络爬虫来爬取,所以网络爬虫技术变得十分重要。

黛琳ghz的博客,期待你的关注。 6826

Python 网络爬虫教程

网络爬虫是一种自动化程序,它模拟人类用户访问网页,自动获取网页上的内容。这些数据可以是文本、图片、视频等。爬虫的核心任务是发送 HTTP 请求,获取网页响应并解析内容。

JH_joker的博客 2362

【愚公系列】《Python网络爬虫从入门到精通》001-初识网络爬虫

随着互联网的快速发展,数据的获取与处理变得愈发重要。在这个信息爆炸的时代,如何有效地收集和利用网络上的海量数据,成为了各行业面临的一大挑战。网络爬虫,作为一种自动化获取网页信息的技术,正逐渐成为数据分析、市场研究、竞争对手监控等领域不可或缺的工具。本文将带领读者初步了解网络爬虫的基本概念、工作原理以及常见应用场景。我们将探讨爬虫的构建过程,包括如何发送请求、解析网页、存储数据等关键步骤。同时,还会涉及一些爬虫开发中的注意事项,如如何遵循网站的robots.txt协议、避免被封禁等。

愚公智库 12万+

网络爬虫解析

网络爬虫(也称为网页蜘蛛、网络机器人)是一种按照一定的规则,自动地抓取万维网信息的程序或者脚本。网络爬虫可以用于从网站提取数据,例如监测社交媒体平台上的活动,或者从网上收集新闻和文章。它们也可以用于搜索引擎,如Google和Bing,来抓取和索引网页,以便在用户进行搜索时提供结果。URL通常由多个部分组成,包括协议类型(如HTTP、HTTPS)、主机名(域名或IP地址)、路径(资源在主机上的位置)以及可选的查询参数(用于传递额外的信息)。通过URL,用户可以方便地访问和定位到特定的网络资源。

2301_82032652的博客 2634

网络爬虫-Python网络爬虫和C#网络爬虫

C# 也可以用于网络爬虫开发,通过 HTTP 请求获取网页数据并进行解析。与 Python 类似,C# 也有相应的库和框架,虽然 C# 网络爬虫在简便性和灵活性上不如 Python,但在某些企业级应用中,C# 也表现出色。

weixin_42462436的博客 3403

什么是网络爬虫?有什么用?怎么爬?终于有人讲明白了

「2019 Python开发者日」全日程揭晓,请扫码咨询 ↑↑↑作者|韦玮,资深网络爬虫技术专家、大数据专家和软件开发工程师,从事大型软件开发与技术服务多年,精通Py...

Python大本营的博客 1万+
上一篇: 10比较实用的Python自测题!
下一篇: Python最常见的语句、函数,想学好Python必须要懂得!
Python_trys
博客等级 码龄2年 4369粉丝 377原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值