10行Python代码,采集笔趣阁小说!

采集笔趣阁小说详情页内容 目标站地址:http://www.biquges.cc/b2922/ 代码如下: #coding=utf-8 import requests,re class GetDes: def gettitle(self,str): “”" 获取小说标题 :param str: :return: “”" get_title=re.compile(r’.*最新章节’)<br/> title=get... 阅读详情

需要的导入的包:

import requests
import re

爬取笔趣阁小说:

很多人学习python,不知道从何学起。
很多人学习python,掌握了基本语法过后,不知道在哪里寻找案例上手。
很多已经做案例的人,却不知道如何去学习更加高深的知识。
那么针对这三类人,我给大家提供一个好的学习平台,免费领取视频教程,电子书籍,以及课程的源代码!??¤
QQ群:961562169

https://www.biquge.com.cn/

最近在看《超神机械师》就以这个为例分析爬取代码

先到小说的详情页面:

https://www.biquge.com.cn/book/29105/

检索之后可以发现每章小说的网址:


用re.findall 获取这些网址保存起来待用:


因为这些网址只是后半部分,我们可以加上后半部分,访问章节网址,获取小说:
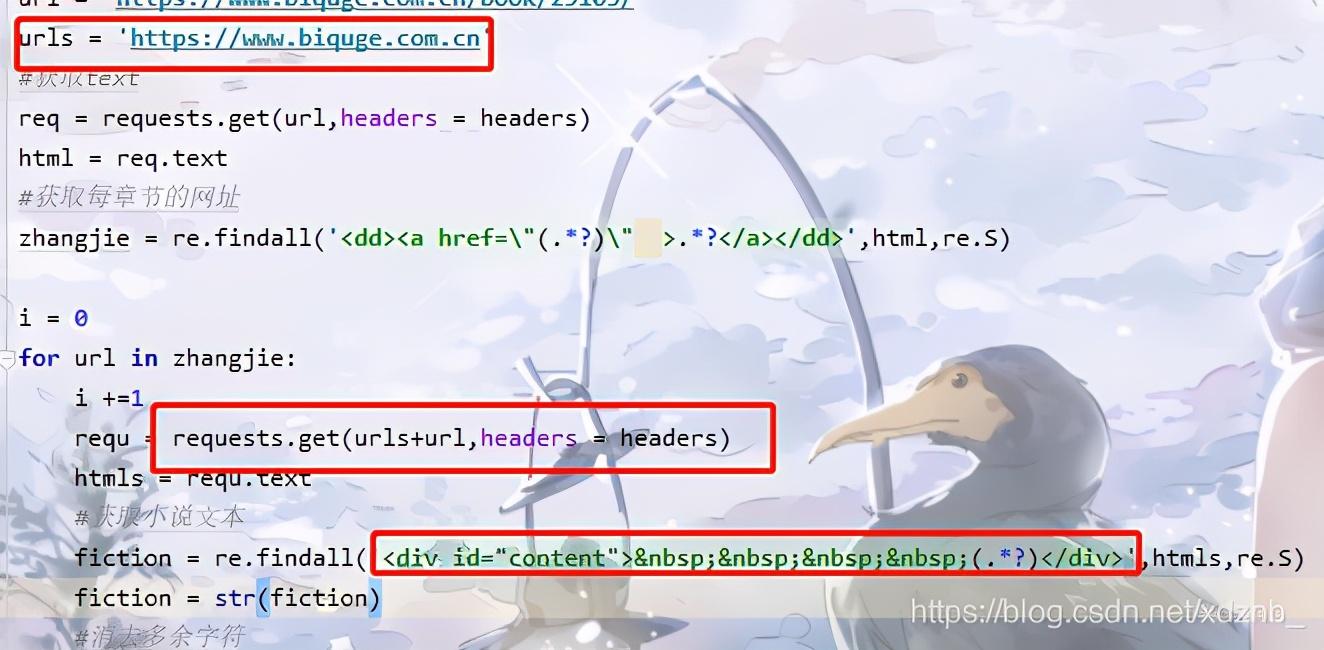

最后保存到文档中就行了:
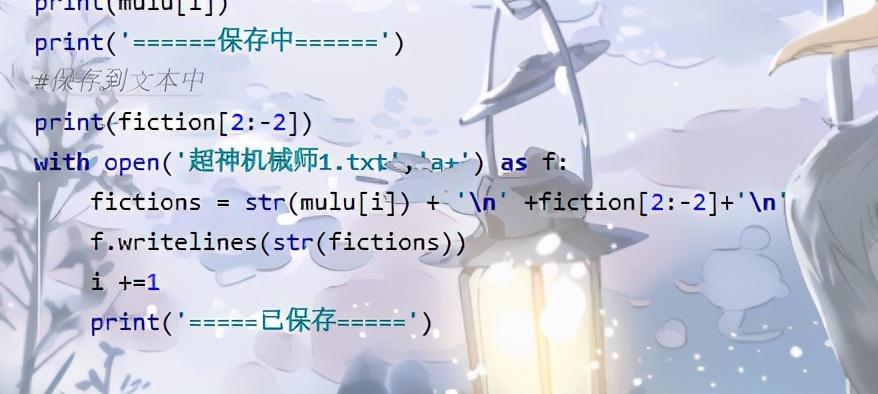
import requests
import re
#请求头
headers = {
    'User-Agent': 'Mozilla/5.0 (Macintosh; Intel Mac OS X 10_11_6) AppleWebKit/601.7.7 (KHTML, like Gecko) Version/9.1.2 Safari/601.7.7',
    'Referer': 'https://www.biquge.com.cn/'
}
#网址
url = 'https://www.biquge.com.cn/book/29105/'
urls = 'https://www.biquge.com.cn'
#获取text
req = requests.get(url,headers = headers)
html = req.text
#获取每章节的网址
zhangjie = re.findall('<dd><a href="(.*?)"  >.*?</a></dd>',html,re.S)
mulu = re.findall('<dd><a href=".*?"  >(.*?)</a></dd>',html,re.S)

i = 0
for url in zhangjie:
    requ = requests.get(urls+url,headers = headers)
    htmls = requ.text
    #获取小说文本
    fiction = re.findall('<div id="content">&nbsp;&nbsp;&nbsp;&nbsp;(.*?)</div>',htmls,re.S)
    fiction = str(fiction)
    #消去多余字符
    fiction = re.sub("[|]|<br><br>&nbsp;&nbsp;&nbsp;&nbsp;|<br>",'',fiction)
    print(mulu[i])
    print('======保存中======')
    #保存到文本中
    print(fiction[2:-2])
    with open('超神机械师1.txt','a+') as f:
        fictions = str(mulu[i]) + '\n' +fiction[2:-2]+'\n'
        f.writelines(str(fictions))
        i +=1
        print('=====已保存=====')


python爬虫实战篇(知识讲解+爬取小说) 大家谨记爬虫只是用来方便大家从互联网上检索信息,获取免费资源,不得以危害或者窃取对方资源使用为目的进行违法犯罪。牢记网络安全法。 1.爬虫的准备工作 安装第三方库-requests lxml 使用pip命令直接安装requests pip install requests pip install lxml 如果出现失败,请检查网络,或者换源使用阿里云下载(直接换源比较推荐)。 2.爬虫介绍以及基本使用到的方法介绍 概念:(爬虫又被称为网页蜘蛛,网络机器人)就是模拟浏览器发送网络请求,接收请求响应,一种按照 阅读详情

相关推荐

笔趣阁爬虫优化

笔趣阁爬虫优化 import requests import time from bs4 import BeautifulSoup import os from multiprocessing.dummy import Pool as ThreadPool from multiprocessing import Pool from threading import Thread import pandas as pd from pandas import DataFrame,Series import nu

qestion_yz_10086的博客 353

最新YGbook小说网自适应源码 自动采集笔趣阁 附详细图文安装教程

介绍: 新安装的直接安装压缩包里边的安装教程进行这个小说采集程序的优点就是,软解析–并不把小说文字和图片采集过来,而是利用转码的形势在你搭建的站点实现,不占用你网站的空间! 自带4条采集规则速度更快(比较原版,个人对源码做了少许优化,运行速度更顺畅)网站源码深度SEO优化(网页快速收录)自适应(完美自适应手机端/电脑端,已经自动填写设定,不修改就自适应)网站后台采集小说(无需使用采、集器,后台带自动采集+手动采集小说功能) 教程 小说自动采集+【深度seo优化】+自适应=小说网站源码 (原创模板 ) 默认图

百度SEO工具 2462

从零开始打造Python爬虫:实战爬取笔趣阁小说免费章节

作为一名爬虫爱好者或Python开发者,你一定对网络爬虫技术充满好奇。笔趣阁作为国内知名的小说阅读网站,拥有海量的免费小说资源,非常适合作为爬虫入门的实战项目。本文将带你从零开始,使用Python打造一个完整的笔趣阁小说爬虫,涵盖请求发送、HTML解析、字符串处理、数据存储等核心知识点。本项目的目标是开发一个能够自动爬取笔趣阁网站免费章节的Python爬虫程序。用户输入小说名称或URL后,程序能够自动下载所有免费章节,并将内容保存为文本文件。

2201_76125261的博客 1363

python爬取笔趣阁小说(附源码)

python爬取笔趣阁小说 文章目录python爬取笔趣阁小说前言一、获取小说目录结构获取目录连接请求代码解析目录XPathtqdm解析二、获取小说章节结构请求代码解析章节代码重构代码总结 前言 通过学习爬取电子书,了解python爬虫的魅力! 一、获取小说目录结构 获取目录连接 可知目录连接: url = “http://www.paoshuzw.com/13/13959/” 请求代码 import requests url = "http://www.paoshuzw.com/13/1395

luxuncang的博客 1万+

YGBOOK6.14YG采集规则

YGBOOK6.14YG采集规则

笔趣阁模板_笔趣阁模板_

Biquge template 1.7 Universal blue tone template

python爬虫篇(项目案列讲解-爬取小说)

学习一下思路:1.我们进入需要爬取到的小说界面,右键开发者工具 ,选中元素显示,然后找到需要爬取的小说章节模块在代码中的位置。将a标签中的文本内容复制,然后ctrl+u打开源代码 ctrl+f将刚刚的文本内容复制查找是否有这个模块。(比较爽的是,刚好这里有,可以不需要去查看网络请求和script代码了)那么我们现在可以可以来获取源代码了编码格式的查看方式。获取源代码之后,我们现在需要去解析一下这串源代码。

m0_65482549的博客 4842

STM32与SD卡SPI接口硬件设计:从原理图到调试的完整指南

SPI(串行外设接口)作为一种广泛应用的同步串行通信协议,以其接线简单、驱动成熟的特点,成为连接微控制器与各类外设的经典方案。其工作原理基于主从架构,通过时钟、数据线和片选信号实现全双工通信,在嵌入式系统中具有极高的技术价值,常用于连接传感器、存储设备和显示模块等。在数据存储场景中,SD卡凭借其大容量和便携性成为首选,而通过SPI模式驱动SD卡,则平衡了性能与设计复杂度。本文聚焦于使用Altium Designer进行硬件设计的工程实践,详细解析了STM32微控制器与SD卡通过SPI通信时,电源管理、上拉电

weixin_34101784的博客 555

Python爬虫抓取笔趣阁小说(含源码)

每一章节对应的链接所在的结构都是一样的,全部存在于dl->dt->dd->a->href 所以我只需要获取全部的dd标签,然后一个for循环遍历所有的dd标签,然后内部再写一个for循环,即可获取正本书籍。我们需要的小说,所以现在我们需要解析note,通过下面的信息,我们可以发现需要的文字在一个div中的文字形式,所以直接解析获取文本即可。Python所有方向的技术点做的整理,形成各个领域的知识点的汇总,它的用处就在于,你可以按照上面的知识点去找对应的学习资源,保证自己学得较为全面。编码格式的查看方式。

蟒蛇小码农的博客 6327

手把手教你用STM32的SPI驱动MCP2517FD实现CAN FD通信(附完整代码)

本文详细介绍了如何使用STM32通过SPI驱动MCP2517FD实现CAN FD通信,涵盖硬件连接、SPI驱动编写、寄存器配置及数据收发实战。提供完整代码示例和常见问题排查指南,帮助开发者快速构建高可靠性的CAN FD通信系统,适用于汽车电子和工业控制等领域。

weixin_30607029的博客 675

ERPS协议原理

目录 1、ERPS概述: 2、ERPS名词概念解释: 3、ERPS协议报文: 4、ERPS单环基本原理: 5、单环多实例原理: 6、多环原理: 1、ERPS概述: ERPS(Ethernet Ring Protection Switching),即以太网多环保护技术,是ITU-T定义的一种二层破环协议标准,标准号为ITU-T G.8032/Y1344,因此又称为G.8032。它定义了RAPS(Ring Auto Protection Switching)协议报文和保护倒换机制。 ERPS目前支持v1和v2两

weixin_44880796的博客 1万+

爬取“笔趣阁”小说

欢迎加入我们卧虎藏龙的python讨论qq群:729683466●导 语●在网站上看小说的时候是不是经常为弹窗广告所烦恼呢今天分享如何爬取小说从此摆脱广告烦恼~代码及相关资源获取1:关...

qq_42680814的博客 2220

MPLAB修改工程名称方法

修改工程名称方法 如下图所示,工程名称为:Loar_V1.0_20210205 现将该工程名称修改为:Loar_V1.1_20210205 修改方法: ①找到工程文件路径,将工程名称修改为Loar_V1.1_20210205 注意:此时打开变成进行编译,会报错:Loar_V1.1_20210205.production.hex does not exist or is not an executable, ②找到工程下的 nbproject 文件夹 ③将nbproject文件夹下的文件全部打开,并且将

qq_26195179的博客 1759

小说采集,采集笔趣阁小说网站(www.biquges.cc)

小说采集一直是站主比较头大的一件事,接下来我将给大家分享用python采集笔趣阁小说站,可能会多写几篇,不足之处大家多多指教 目标站:www.biquges.cc 先采集小说资源链接 代码中是将所有采集到的链接存放到列表中,有需要的同学可以自己写sql语句存放到数据库中或者保存到txt文件中 #coding=utf-8 import requests class GetList: “”" 获取小说...

shanying1991的博客 1万+

AUTOSAR OS Counter讲解

Counter(计数器)以tick为单位记录操作系统中发生了多少“事情”。tick(滴答)是一个抽象的单位。时间,例如毫秒,微妙,分钟等,然后计数器计算过去了多少时间旋转,例如以度或分钟为单位,计数器计算物体旋转了多少按钮按下,计数器计算按钮按下多少次错误,计数器计算错误发生的频次中断(有时是任务)用于驱动一个计数器。该驱动程序负责进行正确的OS API调用来滴答计数器,或者告诉OS计数器已经滴答到一个所需的值。

酒无忧的博客 1073

【AI大模型应用开发】【RAG评估】0. 综述:一文了解RAG评估方法、工具与指标

本文主要总结了当前比较流行的RAG评估方法和指标。当前AI技术的快速发展,RAG和RAG评估是当前比较有前景的发展方向,不断有新的评估工具和理论被提出,让我们持续跟进,了解这些工具和理论,从而在使用时知道如何选择。

同学小张的博客 6827

【亲测免费】 Python爬虫-笔趣阁小说爬虫-自动爬取小说

本仓库提供了一个利用 Python 爬虫技术自动爬取笔趣阁小说的资源文件。通过结合 BeautifulSoup 和 requests 库,你可以轻松实现小说的自动爬取,让你随时随地享受阅读的乐趣。 ## 功能特点 - **自动爬取**:程序能够自动识别并爬取笔趣阁上的小说内容。 - **简单易用**:代码结构清晰,易于理解和修改,适合初学者学习。 - **高效稳定**:使用 Beautiful

gitblog_09706的博客 1633

AI游戏制作07——波次计时器,敌人按波次生成

AI游戏制作07——波次计时器,敌人按波次生成

qq_40572023的博客 47

Python爬虫爬取笔趣阁小说

使用python爬取笔趣阁的实战案例,适合爬虫初学者

weixin_73614199的博客 3021

Cesium 实战 19 - 使用 gltf-vscode 查看、预览以及编辑 glTF 和 GLB 模型

Cesium 实战 - 使用 gltf-vscode 查看、预览以及编辑 glTF 和 GLB 模型。

非科班Java出身GISer的博客 6435

华为的C语言编程规范.pdf

华为技术有限公司内部技术规范。本规范制定了编写C语言程序的基本原则、规则和建议。从代码的清晰、简洁、可测试、安全、程序效率、可移植各个方面对C语言编程作出了具体指导。

scrapy 简单爬取笔趣阁并保存为txt

scrapy 简单爬取笔趣阁并保存为txt 作为一个老书虫,每个寂寞的夜总要本书陪着才能入眠 话不多说直接开始 解决两个主要的问题 1.输出pipelines时章节乱序 2.字符编码 直接上代码 爬取部分. import scrapy from one.items import QuBiGe class HomeSpider(scrapy.Spider): name = 'qubige' allowed_domains = ['www.biquge.info'] start_ur

weixin_42776548的博客 2755

SIMATIC S7-1200, S7-1500 PID 控制[手册]

SIMATIC S7-1200, S7-1500 PID 控制[手册]

Python爬虫实战:从零构建笔趣阁小说抓取工具

网络爬虫作为数据采集的核心技术,通过模拟浏览器行为自动抓取网页信息,其原理基于HTTP协议与HTML解析。在Python生态中,Requests库负责发送网络请求,BeautifulSoup4则用于解析HTML文档结构,二者结合构成了静态网页抓取的基础技术栈。这项技术的工程价值在于将非结构化网页数据转化为结构化信息,广泛应用于舆情监控、价格追踪等领域。针对小说网站这类结构规整的静态站点,爬虫技术能高效实现内容聚合与离线存储。本文以笔趣阁为例,详细拆解了搜索匹配、目录解析、正文抓取等核心模块的实现逻辑,重点探

weixin_33600816的博客 1310

STM32F407中文手册

STM32f407中文手册 本参考手册面向应用开发人员,提供有关使用 STM32F405xx/07xx、STM32F415xx/17xx、 STM32F42xxx 和 STM32F43xxx 微控制器存储器与外设的完整信息。STM32F405xx/07xx、STM32F415xx/17xx、STM32F42xxx 和 STM32F43xxx 构成一个微 控制器系列,各产品具有不同的存储器大小、封装和外设。有关订购信息以及器件的机械与电气特性,请参见数据手册。有关 ARM Cortex™-M4F 内核的信息,请参见《Cortex™-M4F 技术参考手册》。

Camera2Demo

在Camera2 的基础上进行封装,使得Camera2一堆初始化逻辑与Activity分离,降低耦合度,完成预览拍照并保存的操作

小说爬虫-01 Scrapy 爬虫完整教程:用 Python 高效爬取笔趣阁小说排行榜(附源码)

Scrapy 是一款由 Python 编写的高性能网络爬虫框架,具备异步处理、模块化架构和强大的扩展能力,非常适合构建大规模数据采集系统。其核心组件包括引擎、调度器、下载器、爬虫和数据管道,通过协同工作实现从请求调度到数据存储的全自动流程。Scrapy 支持 XPath、CSS 选择器及正则表达式,可灵活解析网页内容,并通过中间件系统实现请求重试、限速、代理、UA 伪装等功能。内置管道可轻松将数据输出为 JSON、CSV 或存入数据库。本文以“笔趣阁小说排行榜”为例,展示了如何利用 Scrapy 与 SQL

谢谢你的喜欢 我们一起无限进步 3199

toolkit-frame之toolkit-sprider(数据采集)---笔趣阁小说

采集笔趣阁小说,使用以下几个核心包: requests:2.10.0 beautifulsoup4:4.7.1 其中: 1、BaseFrame.__log__("开始采集中国船舶网的数据...") BaseFrame.__log__() 就是我个人封装的日之类替换成print就可以。 2、response = requests.get(self.base_url, timeout=30,...

zy0412326的专栏 448

爬虫新手入门实战项目(爬取笔趣阁小说并下载)

网络爬虫是什么?简单来说就是一个脚本,他能帮助我们自动采集我们需要的资源。 爬虫步骤 获取数据 # 导入模块 import requests import re url = 'https://www.biqudu.com/43_43821/' 模拟头部信息 headers = {"User-Agent":"Mozilla/5.0 (Windows NT 10.0; Win64; x...

weixin_44266342的博客 2395

[我叫以赏]Python下载笔趣阁文章

前言 本文章没有恰饭,只是提供制作思路 一个同学要我下载笔趣阁的文章,我便同意了,一言既出,驷马难追。我用我网站搭建了一个“设备见外”平台(类似与盗版笔趣阁),就可以做到在线搜索笔趣阁文章、在线浏览目录与阅读,而且十分简洁没有广告, 那我我就使用Python从0开始搭建吧,(注意:UP一边写文章一边写程序,工作量很大,一步一个操作) 界面 先写一个简单的交互式页面, # -...

qq_35937739的博客 439
上一篇: 利用Python编写图片下载器,单线程与多线程版合集
下一篇: Python生成桌面文件,并添加数据(应用于数据的下载等等)
Python_sn
博客等级 码龄6年 324粉丝 290原创
评论 1
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值