基于深度学习的桃子成熟度检测系统(yolo26、yolo12、yolo11、yolov8、yolov5+UI界面+Python项目源码+模型+标注好的数据集)2027毕业版

opencv实现图片中文字识别并切割 为了提升用户欣赏书法图片的体验,需要从高清TIF图片中把每个字都切割出来,手动切割太麻烦,所以利用opencv自动识别图片中的文字,并将每个文字切割保存。 阅读详情


项目介绍

本项目基于 PyQt5 构建了简洁易用的图形用户界面,支持用户选择本地图片或视频进行目标检测。系统界面美观,交互流畅,具备良好的用户体验。

项目附带完整的 Python 源码和详细的使用说明,适合学生进行学习或有一定 Python 基础的开发者,参考与二次开发。您可以在文末获取完整的代码资源文件。


✨ 项目亮点

  • 🔧 完整系统级项目: 包括pyqt5界面、后台检测逻辑、模型加载等模块

  • 🧠 支持深度学习模型扩展: 源代码,支持个人添加改进、模型修改等

  • 🚀 可用于毕(she)/课(she)/个人项目展示: 结构清晰,逻辑完整,便于演示


在这里插入图片描述

🎯 功能展示

本系统具备多个核心功能,支持图像、视频、摄像头等多种输入源的目标检测需求:

  • 🎴功能1:支持单张图片识别
    加载本地图片进行目标识别,支持多种图片格式(如 .jpg、.png 等)。

  • 📁功能2:支持遍历文件夹识别
    可批量读取指定文件夹中的所有图像,并依次完成目标检测任务。

  • 🎫功能3:支持识别视频文件
    支持导入本地视频文件,逐帧分析,实时显示检测效果。

  • 📷功能4:支持摄像头识别
    直接调用笔记本/外接USB摄像头进行实时目标检测。(此功能识别不准,仅仅是为了有这个功能。)

  • 📤功能5:支持结果文件导出(.xls 格式)
    自动保存检测结果为表格文件,包含类别、位置、置信度等信息,方便后续统计与分析。

  • 🔄功能6:支持切换检测目标进行查看
    可自定义选择或切换需要检测的目标种类,仅显示感兴趣的目标。

🎥 更多功能细节、代码演示效果获取请参考下方视频演示。此视频是必看的,里面的信息比文章要丰富,很多内容无法通过博客文字表达出来。

22-基于YOLO12的桃子成熟度检测识别系统项目实战!-全网最全资料(附赠任务书、开题报告模板课程)人工智能/深度学习/计算机视觉/神经网络

22-基于深度学习的桃子成熟度检测识别系统-yolo11-彩色版界面(附赠任务书、开题报告模板课程)

22-基于深度学习的桃子成熟度检测识别系统-yolov8/yolov5-经典版界面(附赠任务书、开题报告模板课程)

22-基于深度学习的鸟类分类检测识别系统-yolo11-彩色版界面

22-基于深度学习的鸟类分类检测系统(yolov8)


🌟 一、环境安装

🎆 环境配置说明

本项目已准备好 完整的环境安装资源包,包含:

  • Python、PyCharm
  • CUDA、PyTorch
  • 其他依赖库(版本已适配)

所有依赖版本均已过验证,确保彼此兼容,可直接参考配套文档或视频教程一步步安装,无需手动调试。


📘 安装指南说明

本项目附带的环境配置文档及配套视频,文档是我在辅导上千名同学安装环境过程中,持续整理总结而成的经验合集,内容覆盖:

  • GPU 与 CPU 两种版本的详细安装流程
  • 安装过程中常见问题汇总
  • 每个问题对应的解决方案
  • 实测可行的安装顺序建议与注意事项

🧩 无论你是新手还是有经验的开发者,相信这份文档都能为你省下大量踩坑时间!

🎥 环境安装教学视频

环境安装-03GPU版


🌟 二、数据集介绍

使用数据集一部分个人标注,一部分来源网络,已统一标注格式并完成预处理,可直接用于训练与测试。
数据集样式如下:

训练样例1训练样例2
train_batch0.jpgtrain_batch1.jpg

数据集制作流程
标注数据: 使用标注工具(LabelImg)对图像中的目标进行标注。每个目标需要标出边界框,并且标注类别。

转换格式: 将标注的数据转换为YOLO格式。YOLO标注格式为每行: <x_center> <y_center> ,这些坐标是相对于图像尺寸的比例。

分割数据集: 将数据集分为训练集、验证集和测试集,通常的比例是80%训练集、10%验证集和10%测试集。

准备标签文件: 为每张图片生成一个对应的标签文件,确保标签文件与图片的命名一致。

调整图像尺寸: 根据YOLO网络要求,统一调整所有图像的尺寸(如416x416或608x608)。

这里只是简单大概介绍,我实际的文档里,内容更要比这里丰富很多,保姆级的教程。这里放太多链接,大家容易看不到😂😂😂。


🌟 三、系统环境(框架/依赖库)说明

以下内容是简单的介绍,方便大家写文章,可直接套用。

🧱 系统环境与依赖配置说明

本项目采用 Python 3.8.10 作为开发语言,整个后台逻辑均由 Python 编写,主要依赖环境如下:

🎡 图形界面框架:

  • PyQt5 5.15.9:用于搭建系统图形用户界面,实现窗口交互与组件布局。

🧠 深度学习框架:

  • torch 1.9.0+cu111:PyTorch 深度学习框架,支持 CUDA 11.1 加速,用于模型构建与推理。
  • torchvision 0.10.0+cu111:用于图像处理、数据增强及模型组件辅助。

⚡ CUDA 与 cuDNN(GPU 加速支持):

  • CUDA 11.1.1(版本号:cuda_11.1.1_456.81):用于 GPU 加速深度学习运算。
  • cuDNN 8.0.5.39(适用于 CUDA 11.1):NVIDIA 深度神经网络库,用于加速模型训练与推理过程。

🧪 图像处理与科学计算:

  • opencv-python 4.7.0.72:实现图像读取、显示、处理等功能。
  • numpy 1.24.4:用于高效数组计算及矩阵操作。
  • PIL (pillow) 9.5.0:图像文件读写与基本图像处理库。
  • matplotlib 3.7.1(可选):用于结果图形化展示与可视化调试。

📈 模型训练参数说明

本项目中提供了两个训练好的模型,均基于如下参数完成训练。具体训练时的设置需根据您自己的硬件配置灵活调整:

🎯 基本训练参数

  • batch size:16
  • epoch:200
  • imgsz(输入尺寸):640
  • 优化器:SGD
  • 学习率:初始学习率 0.01,最终学习率 0.0001
  • 学习率衰减策略:余弦退火(Cosine Annealing)
  • 激活函数:SiLU
  • 损失函数:CIOU(Complete IOU)

🔁 实时数据增强策略

训练过程中使用了多种 在线增强 方法,包括:

  • HSV 色域变换
  • 上下翻转、左右翻转
  • 图像旋转
  • Mosaic 图像拼接增强

⚠️ 特别说明:
以上所有增强操作均为 实时数据增强,只在训练过程中动态生成,用作模型输入,不会将增强后的图像保存到本地。

这种策略具有以下优势:

  • 节省磁盘空间
  • 提高训练样本的多样性
  • 增强模型的泛化能力

若需要可视化增强效果,可自行编写脚本或借助工具(如 Photoshop、美图秀秀等)生成示例图像进行展示。


🌟 四、YOLO相关介绍

🎀 yolov5相关介绍

YOLOV5有YOLOv5n,YOLOv5s,YOLOv5m,YOLOV5l、YOLO5x五个版本。这个模型的结构基本一样,不同的是deth_multiole模型深度和width_multiole模型宽度这两个参数。就和我们买衣服的尺码大小排序一样,YOLOV5n网络是YOLOV5系列中深度最小,特征图的宽度最小的网络。其他的三种都是在此基础上不断加深,不断加宽。不过最常用的一般都是yolov5s模型。
在这里插入图片描述

  本系统采用了基于深度学习的目标检测算法YOLOv5,该算法是YOLO系列算法的较新版本,相比于YOLOv3和YOLOv4,YOLOv5在检测精度和速度上都有很大的提升。YOLOv5算法的核心思想是将目标检测问题转化为一个回归问题。此外,YOLOv5还引入了一种称为SPP(Spatial Pyramid Pooling)的特征提取方法,这种方法可以在不增加计算量的情况下,有效地提取多尺度特征,提高检测性能。

  在YOLOv5中,首先将输入图像通过骨干网络进行特征提取,得到一系列特征图。然后,通过对这些特征图进行处理,将其转化为一组检测框和相应的类别概率分数,即每个检测框所属的物体类别以及该物体的置信度。YOLOv5中的特征提取网络使用CSPNet(Cross Stage Partial Network)结构,它将输入特征图分为两部分,一部分通过一系列卷积层进行处理,另一部分直接进行下采样,最后将这两部分特征图进行融合。这种设计使得网络具有更强的非线性表达能力,可以更好地处理目标检测任务中的复杂背景和多样化物体。

在这里插入图片描述

  在YOLOv5中,每个检测框由其左上角坐标(x,y)、宽度(w)、高度(h)和置信度(confidence)组成。同时,每个检测框还会预测C个类别的概率得分,即分类得分(ci),每个类别的得分之和等于1。因此,每个检测框最终被表示为一个(C+5)维的向量。在训练阶段,YOLOv5使用交叉熵损失函数来优化模型。损失函数由定位损失、置信度损失和分类损失三部分组成,其中定位损失和置信度损失采用了Focal Loss和IoU Loss等优化方法,能够有效地缓解正负样本不平衡和目标尺寸变化等问题。

  YOLOv5网络结构是由Input、Backbone、Neck、Prediction组成。Yolov5的Input部分是网络的输入端,采用Mosaic数据增强方式,对输入数据随机裁剪,然后进行拼接。Backbone是Yolov5提取特征的网络部分,特征提取能力直接影响整个网络性能。YOLOv5的Backbone相比于之前Yolov4提出了新的Focus结构。Focus结构是将图片进行切片操作,将W(宽)、H(高)信息转移到了通道空间中,使得在没有丢失任何信息的情况下,进行了2倍下采样操作。

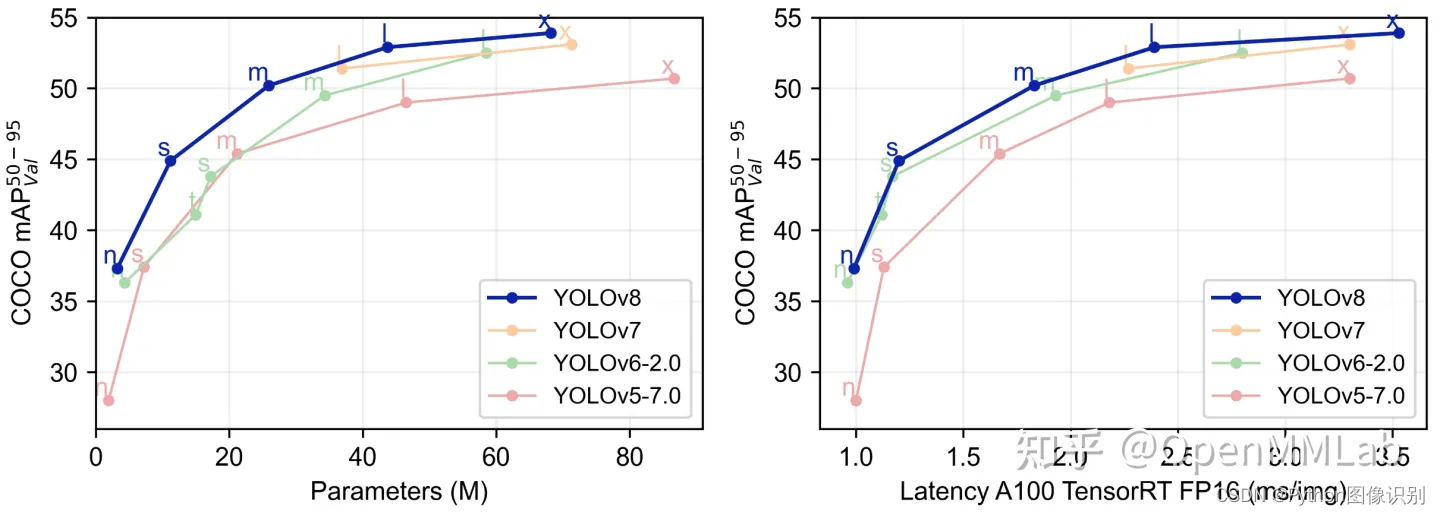
🎑 yolov8相关介绍

YOLOv8 是一个 SOTA 模型,它建立在以前 YOLO 版本的成功基础上,并引入了新的功能和改进,以进一步提升性能和灵活性。具体创新包括一个新的骨干网络、一个新的 Ancher-Free 检测头和一个新的损失函数,可以在从 CPU 到 GPU 的各种硬件平台上运行。

不过 ultralytics 并没有直接将开源库命名为 YOLOv8,而是直接使用 ultralytics 这个词,原因是 ultralytics 将这个库定位为算法框架,而非某一个特定算法,一个主要特点是可扩展性。其希望这个库不仅仅能够用于 YOLO 系列模型,而是能够支持非 YOLO 模型以及分类分割姿态估计等各类任务。
总而言之,ultralytics 开源库的两个主要优点是:

  • 融合众多当前 SOTA 技术于一体

  • 未来将支持其他 YOLO 系列以及 YOLO 之外的更多算法

在这里插入图片描述

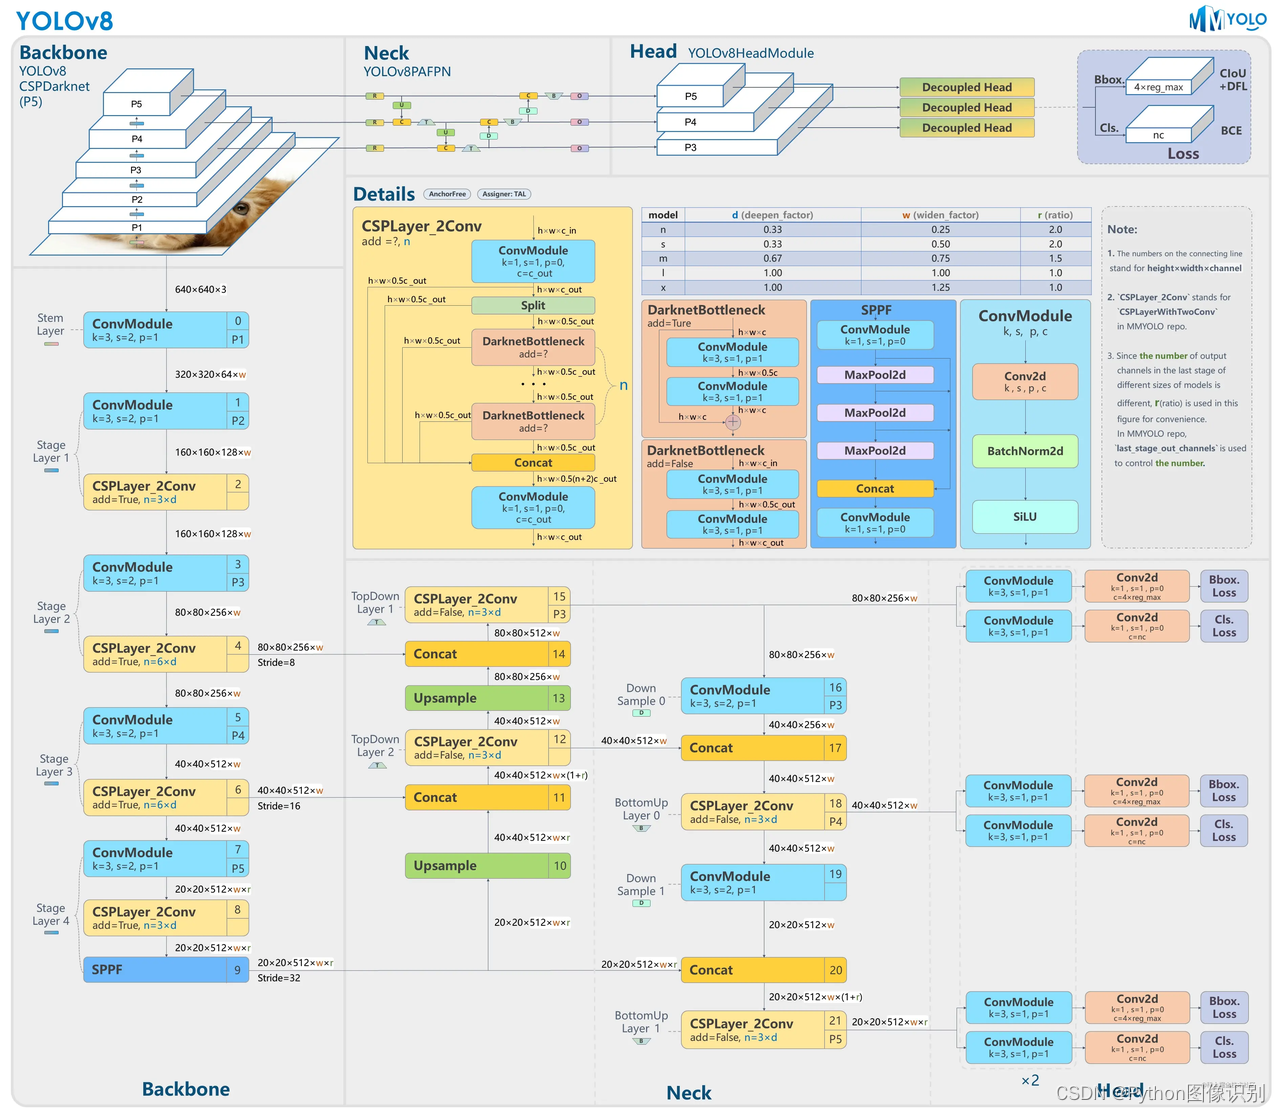
网络结构如下:
在这里插入图片描述

🎐 yolo11相关介绍

YOLO11 是Ultralytics YOLO 系列实时物体检测器的最新版本,以尖端的精度、速度和效率重新定义了可能性。基于先前 YOLO 版本的令人印象深刻的进步,YOLO11 在架构和训练方法方面引入了重大改进,使其成为各种计算机视觉任务的多功能选择。
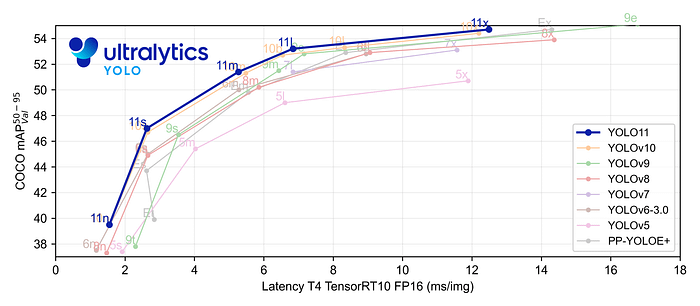
在这里插入图片描述

Key Features 主要特点:

  • 增强的特征提取:YOLO11采用改进的主干和颈部架构,增强了特征提取能力,以实现更精确的目标检测和复杂任务性能。
  • 针对效率和速度进行优化:YOLO11 引入了精致的架构设计和优化的训练管道,提供更快的处理速度并保持准确性和性能之间的最佳平衡。
  • 使用更少的参数获得更高的精度:随着模型设计的进步,YOLO11m 在 COCO 数据集上实现了更高的平均精度(mAP),同时使用的参数比 YOLOv8m 少 22%,从而在不影响精度的情况下提高计算效率。
  • 跨环境适应性:YOLO11可以无缝部署在各种环境中,包括边缘设备、云平台以及支持NVIDIA GPU的系统,确保最大的灵活性。
  • 支持的任务范围广泛:无论是对象检测、实例分割、图像分类、姿态估计还是定向对象检测 (OBB),YOLO11 旨在应对各种计算机视觉挑战。
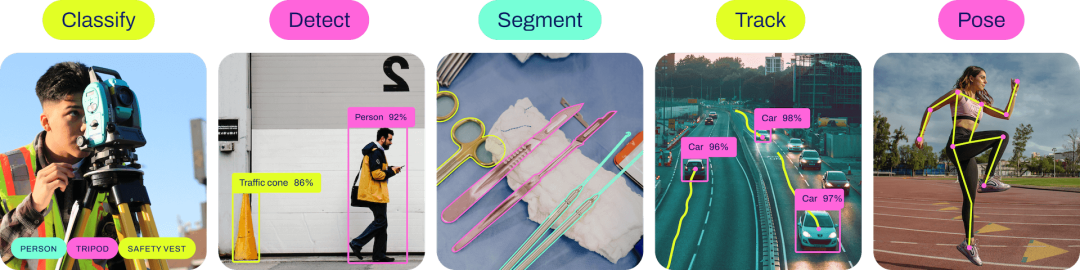
    在这里插入图片描述

🌟 五、模型训练步骤

以下操作步骤,每年我都会更新,所以下方操作步骤可跳过,可以去我文档里查看最新的操作步骤。

  1. 使用pycharm打开代码,找到train.py打开,示例截图如下:
    在这里插入图片描述

  2. 修改 model_yaml 的值,根据自己的实际情况修改,想要训练 yolov5s模型 就 修改为 model_yaml = yaml_yolov5s, 训练 添加SE注意力机制的模型就修改为 model_yaml = yaml_yolov5_SE

  3. 修改data_path 数据集路径,我这里默认指定的是traindata.yaml 文件,如果训练我提供的数据,可以不用改

  4. 修改 model.train()中的参数,按照自己的需求和电脑硬件的情况更改

    # 文档中对参数有详细的说明
    model.train(data=data_path,             # 数据集
                imgsz=640,                  # 训练图片大小
                epochs=200,                 # 训练的轮次
                batch=2,                    # 训练batch
                workers=0,                  # 加载数据线程数
                device='0',                 # 使用显卡
                optimizer='SGD',            # 优化器
                project='runs/train',       # 模型保存路径
                name=name,                  # 模型保存命名
                )
    
  5. 修改traindata.yaml文件, 打开 traindata.yaml 文件,如下所示:
    在这里插入图片描述
    在这里,只需修改 path 的值,其他的都不用改动(仔细看上面的黄色字体),我提供的数据集默认都是到 yolo 文件夹,设置到 yolo 这一级即可,修改完后,返回 train.py 中,执行train.py。

  6. 打开 train.py ,右键执行。
    在这里插入图片描述

  7. 出现如下类似的界面代表开始训练了
    在这里插入图片描述

  8. 训练完后的模型保存在runs/train文件夹下
    在这里插入图片描述


🌟 六、模型评估步骤

以下操作步骤,每年我都会更新,,所以下方操作步骤可跳过,可以去我文档里查看最新的操作步骤。

  1. 打开val.py文件,如下图所示:
    在这里插入图片描述

  2. 修改 model_pt 的值,是自己想要评估的模型路径

  3. 修改 data_path ,根据自己的实际情况修改,具体如何修改,查看上方模型训练中的修改步骤

  4. 修改 model.val()中的参数,按照自己的需求和电脑硬件的情况更改

    model.val(data=data_path,           # 数据集路径
              imgsz=300,                # 图片大小,要和训练时一样
              batch=4,                  # batch
              workers=0,                # 加载数据线程数
              conf=0.001,               # 设置检测的最小置信度阈值。置信度低于此阈值的检测将被丢弃。
              iou=0.6,                  # 设置非最大抑制 (NMS) 的交叉重叠 (IoU) 阈值。有助于减少重复检测。
              device='0',               # 使用显卡
              project='runs/val',       # 保存路径
              name='exp',               # 保存命名
              )
    
  5. 修改完后,即可执行程序,出现如下截图,代表成功(下图是示例,具体输出结果以自己的实际项目为准。)
    在这里插入图片描述

  6. 评估后的文件全部保存在在 runs/val/exp... 文件夹下
    在这里插入图片描述


🌟 七、训练结果

模型训练完成后,所有相关文件(包括权重文件、训练日志、评估结果等)均统一保存在代码工程的weights文件夹下,便于后续模型部署与复用。文件夹内包含训练过程中生成的所有最优权重(best.pt)及最终权重(last.pt),整体结构清晰,可直接用于推理或二次训练。

训练结果截图.jpg

训练的曲线图:
训练过程中,模型的关键指标(如损失值、精度、召回率等)变化曲线已自动记录并可视化。从曲线中可以清晰观察到:

  • 训练集与验证集的损失值(Loss)随迭代次数增加逐步下降并趋于稳定,表明模型有效学习到数据特征;
  • 核心评估指标(如 mAP@0.5、准确率)在训练后期逐步收敛,验证集性能与训练集保持一致,无明显过拟合现象;
  • 通过对比不同阶段的指标变化,可直观判断模型收敛速度与稳定性,为参数调优提供参考。

results.png

评估的结果示例图:
为更直观展示模型性能,选取val中具有代表性的样本进行可视化评估,涵盖不同场景、不同目标密度及复杂背景下的检测 / 分类效果:

评估示例图1评估示例图2
val_batch0_labels.jpgval_batch0_labels.jpg

🌟 获取方式说明

这是一套完整的资源,经过往届学长学姐检验过,是OK的项目,我这里就不做过多的介绍了,说的太多了,大家容易看不到。如果想要获取源码进行学习,可观看一下前面 功能展示 章节的视频演示。如有疑问,也可通过下方的名片或者留言进行交流,一起学习、进步。

💡 温馨提示:资源仅用于学习交流,请勿用于商业用途,感谢理解与支持!

深度学习之Encoder-Only原理与实战 【代码】深度学习之Encoder-Only原理与实战。 阅读详情

相关推荐

深度学习之Seq2Seq原理与实战

【代码】深度学习之Seq2Seq原理与实战。

yumiwangzi30的博客 132

【OpenCV】一种基于阈值的图片中的文字分割

在今年泰迪杯A题电商中图片的文字识别这道题中,我们先用了一种很笨的办法来分割字符。 首先对图片进行灰度化,然后二值化,这里的二值化要选择一个合适的阈值。然后我们进行轮廓的提取,计算轮廓最小矩形的面积,若面积过大,则认为这个是背景图片,若面积过小,则认为是噪点。这种方法有一个弊端,就是文字有大有小,大的文字也有可能会被当成背景,小的标点也可能会被当成噪点。 代码如下: 实现了...

al_qaeda8888的博客 552

深度学习之TF-IDF原理与实战

【代码】深度学习之TF_IDF原理与实战。

yumiwangzi30的博客 186

深度学习0:数学知识:正态分布1

步骤内容结果1引入e−x2e^{-x^2}e−x2钟形曲线2算它的面积I∫−∞∞e−x2dxI∫−∞∞​e−x2dx3平方变成二重积分I2I^2I24换极坐标简化计算5算出I2πI^2 = \piI2πIπIπ​6代入σ\sigmaσ和μ\muμ做变量替换得到σ2πσ2π​7除以它归一化得到正态分布公式2π2π​不是随便写的,它来自高斯积分∫−∞∞e−x2。

tellmewhoisi的博客 195

深度学习之LoRA(低秩适配)原理与实战

【代码】深度学习之LoRA(低秩适配)原理与实战。

yumiwangzi30的博客 256

深度学习之词袋(Bag-of-Words, BoW)原理与实战

【代码】深度学习之词袋(Bag-of-Words, BoW)原理与实战。

yumiwangzi30的博客 224

图解循环神经网络(RNN)

RNN(循环神经网络)就是“带记忆的网络”:让网络拥有一块“记忆”,在处理当前数据时,能同时参考之前看过的内容;它不一次性看完全部输入,而是像人读书一样,一个字一个字地读,每读一个字就更新一次脑子里的记忆,然后用这份记忆去理解当前这个字。但便签一直在被改写,新信息不断挤占旧信息,传到第 40 步时,“巴黎”的痕迹已经淡得几乎没了。读到“贵”的时候,网络并没有重新去查“好看”这个词——但“好看”的影响已经融在了便签里(那个 1.5)。这三个困难的共同点:答案不在当前这一个字里,而在“前面那串东西”里。

技术管理两手抓,两手都要硬. 357

深度学习之LSTM原理与实战

【代码】深度学习之LSTM原理与实战。

yumiwangzi30的博客 130

【原创深度学习项目】基于深度学习的建筑工地防护装备检测系统|安全帽与反光衣检测系统(RT-DETR-L 模型)

本文设计并实现了一套基于RT-DETR-L的建筑工地防护装备检测系统,采用Django+Vue前后端架构,实现对安全帽、反光背心等7类装备及“无PPE”“未戴安全帽”等缺失状态的精准识别。系统支持图片、视频、摄像头实时检测,具备参数可调、数据可视化与统计分析功能,有效解决小目标漏检、误检及管理难问题,助力智慧工地安全管理落地。文末可获取源码。

qq_1445749146的博客 214

AI对战五子棋——深度学习策略网络

在本篇博文中,我们完成了:✔ 构建一个 CNN 五子棋策略网络✔ 让神经网络输出落子概率✔ 使用 Policy Gradient 强化学习训练 AI✔ 让 AI 实现人与 AI、AI 自对弈博弈。

X2829352498的博客 25

【白话系列】倍增算法

【序言】         我认为吧,所有能够优化复杂度的算法都是神奇的,所有能够化繁琐为形象的文字都是伟大的。一直觉得倍增算法是个很神奇的东西,所以决定写点东西纪念一下它。但是作为一个非常不称职的OIER,我非常讨厌在看别人的算法解析时整版的i,j,k等我看到鼠标就惯性移到右上角的符号语言,所以我想用最形象的方式来纪念它。 【一】         从前,有一只可爱得不得了的小白兔,它想从

JarjingX 3万+

神经网络入门指南:从 CNN、RNN 到 Attention

神经网络的学习,本质是“预测—比较—纠错”的循环;CNN 通过局部连接与权重共享理解图像;RNN 通过隐藏状态传递上下文;LSTM 和 GRU 用门控机制管理记忆;Encoder–Decoder 把理解与生成拆成两个阶段;Attention 则让模型在每一步都能主动寻找最相关的信息。到这里,我们已经走完了从普通神经网络到 Attention 的完整路线。下一篇将正式进入 Transformer,看看它如何摆脱 RNN 的顺序计算,又如何让每个 Token 直接找到与自己相关的信息。

爱敲代码的小黄 350

医药行业新零售项目数据分析报告——基于Excel的分析与可视化

不同平台客户支付金额用数字+百分比展示更直观。各大区支付金额分析较为粗浅,后续可加入不同大区人数、配送费等进行细分分析。图表略微单一,可采用组合图,运用两个及以上维度对数据进行分析。数据来源本项目数据来源于某机构的项目案例,以上分析内容均为本人原创,不涉嫌抄袭。原做项目,新平台首发。

2401_84213513的博客 1495

基于深度学习的垃圾分类系统的设计与实现

本系统是一个基于 Flask Web 框架与 PyTorch 深度学习模型的垃圾分类智能识别平台。系统面向垃圾图像分类场景,能够对上传图片中的玻璃、纸张、纸板、塑料、金属、其他垃圾等六类垃圾进行自动识别与置信度评估,并提供识别历史、数据统计、模型在线训练与记录导出等完整功能。系统使用 TrashNet 公开垃圾分类数据集进行模型训练,管理员可手动发起模型训练,训练完成后自动加载新权重。启动服务不会自动训练。

aiyuanma_vip的博客 384

STM32 烧录报错Invalid ROM Table

STM32 烧录报错Invalid ROM Table

热爱科技,物联,程序开发等 1732

Jenkins离线安装保姆级教程:从下载.war包到SVN+Maven项目一键部署(附避坑脚本)

本文详细介绍了Jenkins离线安装的全流程,包括.war包下载、SVN+Maven项目配置及自动化部署。特别针对内网环境提供解决方案,涵盖插件管理、开发工具链配置、构建触发器和SSH部署等关键步骤,帮助企业在网络隔离环境下实现高效持续集成。

weixin_30096975的博客 374

CNN 卷积神经网络深度解析:卷积、池化与特征提取的底层原理

卷积核(Kernel),也叫滤波器(Filter),本质上是一个可以训练的权重矩阵。1 0 -11 0 -11 0 -1这个卷积核可以对图像中的局部像素进行加权计算。不同的卷积核能够提取不同类型的特征:水平边缘特征垂直边缘特征纹理特征角点特征局部形状特征在传统图像处理中,滤波器通常由人工设计。而在 CNN 中,卷积核的权重通过训练数据和反向传播自动学习得到。这也是 CNN 能够自动提取图像特征的关键。# 第一层卷积padding=1# 第二层卷积padding=1。

2503_90237586的博客 237

阿里云搭建vps服务器的过程

最近突发奇想想要搭建一个阿里云的的vps服务器,下面是搭建的过程: 首先,登录阿里云网站: 搜索,esc控制台: 点击创建实例: 选择地区: 选择实例规格: 选择镜像: 将存储规格改成100G(40G可能不够用) 点击下一步: 这里面不需要更改,点击下一步 设置连接密码即可 创建成功后点击启动 点击远程连接,然后立即登录,在弹出的框里面输入之前设置的密码即可 登录成功:

zhanchulan的博客 3373

图解常用深度学习优化器

来隐式构造 Hessian 逆的近似,从而直接估计出“谷底在哪”,而非仅仅判断“哪边最陡”。即SGD/Adam 主要看“当前坡度”,LBFGS 还会看“最近几步坡度怎么变”,像用局部地形图来规划路线。训练 Transformer 时,有些层梯度大,有些层梯度小。如果用 Adam + L2,梯度大的参数反而可能被“少衰减”,正则效果不稳定;:你要下山,但每次迈步前都要派侦察兵把整座山的每一个坡面都测量一遍,算出“绝对最陡”的方向才走一步。:还是下山,但这次你只问身边一个路人“哪边最陡”,然后就走。

技术管理两手抓,两手都要硬. 199

高质量文献综述原来这么写!借助Gemini 3 Pro+四步法,手把手教你写出有逻辑深度的综述

总结与展望先总结现状,说明前人已经做到什么地步了,再指出缺口,前人没解决什么问题、方法有什么局限等等,最后再在这个缺口的基础上,提出你的未来研究方向。当你有个复杂的研究题目,但没办法拆解出关键词,就可以让Gemini 3 Pro来辅助帮你拆解,并帮你写专业的检索式,若是找英文文献,还能帮你将中文关键词翻译成地道的专业术语。做文献笔记,可以建立文献笔记矩阵,可以用Excel建个表格,横向是文献,纵向是关键要素,包括作者/年份、研究问题/假设、理论框架/模型、研究方法/数据来源、核心结论、局限性/Gap。

智能AI让学术科研更容易 992

1. SAP Fiori Elements 开发环境的搭建和开发准备工作

本文介绍了本地使用 Visual Studio Code 进行 Fiori Elements 开发所需要安装的这个扩展包里6个能够提高 Fiori Elements 应用开发效率的扩展。在本教程后续步骤里我们会通过实际的例子介绍这些 Visual Studio Code 扩展的详细用法。

2007 年 ~ 2025 年,深耕 SAP 技术 18 年 3451

证件阅读机如何用多光谱光学成像、端到端深度学习 OCR 与 MRZ 解析、13.56MHz 射频芯片认证三层能力,把单证核验压缩到 1–2 秒

"说走就走"的外国游客多了,酒店前台的压力也就跟着一起"入境"了。复印件在红外图里会丢掉层次,屏幕翻拍件在紫外图里会暴露像素网格和屏幕的摩尔纹,PS 改过的资料页在红外和可见光的交叉比对下常常"对不上"。客人只觉得"这家酒店办入住挺快",前台只觉得"今天没被催",店长只觉得"这个月没收到整改通知"。三只眼睛和一个 AI 大脑在 1–2 秒里跑完的一整套核验,被压缩成了体验里那句轻飘飘的"好的,您的房卡"。有意思的是,真正在缓解这个压力的,不是多招几个前台,而是柜台上多了一台巴掌大的小设备——证件阅读机。

智能图像识别 345

霍尼韦尔SoftMaster使用说明

霍尼韦尔SoftMaster使用说明

基于深度学习的猫图像目标检测方法研究:YOLOv8s模型海选、多种子对比训练与Django+ONNX部署实现详解

本课题基于深度学习研究猫图像目标检测问题。数据集含1000张猫图像、1188个标注框,按固定比例划分并冻结清单;训练前在多个候选族中短训海选,确定YOLOv8s为主模型,经学习率搜索与显存标定后完成150轮训练,验证集mAP50达到0.92,并以7个随机种子的对比实验验证稳定性。最优权重导出为ONNX接入Django系统,提供图片、视频、摄像头三种识别方式,配套识别记录管理与统计大屏,形成从训练到应用的完整闭环。

WEIXIN_JSJBSZDS的博客 164

WINCC7.3破解文件

WINCC7.3硬件够破解文件,有需要的下载!WINCC7.3硬件够破解文件,有需要的下载!

怀旧版电脑GBC模拟器

再现原版GBC掌机的界面,电脑运行连游戏界面都一样大小,很怀旧,很真实,(英文版)强烈推荐,很小的文件,很难才找到的。

深度学习0:数学知识:正态分布2(积分,幂函数积分公式)

积分符号∫(\int∫= 把无数个极窄的小矩形面积(高度×dx(\times dx×dx))“拼接”起来。dx(dxdx= 无穷小的宽度。定积分的结果= 曲线下方的总面积(一个具体的数字)。不定积分= 寻找求导前的那个原函数。这就是“积分求面积”最朴素的意思!

tellmewhoisi的博客 209

Data-Structures-and-Algorithm-Analysis-in-Java.pdf

作者: Weiss, Mark A. 出版社: Addison Wesley Data Structures and Algorithm Analysis in Java is an “advanced algorithms” book that fits between traditional CS2 and Algorithms Analysis courses. In the old ACM Curriculum Guidelines, this course was known as CS7. This text is for readers who want to learn good programming and algorithm analysis skills simultaneously so that they can develop such programs with the maximum amo...

上一篇: 基于深度学习的番茄病害检测识别系统(yolo26、yolo12、yolo11、yolov8、yolov5+UI界面+Python项目源码+模型+标注好的数据集)2027毕业版
下一篇: 基于深度学习的植物类别检测识别系统(yolo26、yolo12、yolo11、yolov8、yolov5+UI界面+Python项目源码+模型+标注好的数据集)2027毕业版
Python图像识别-1
博客等级 码龄2年 1010粉丝 199原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值