


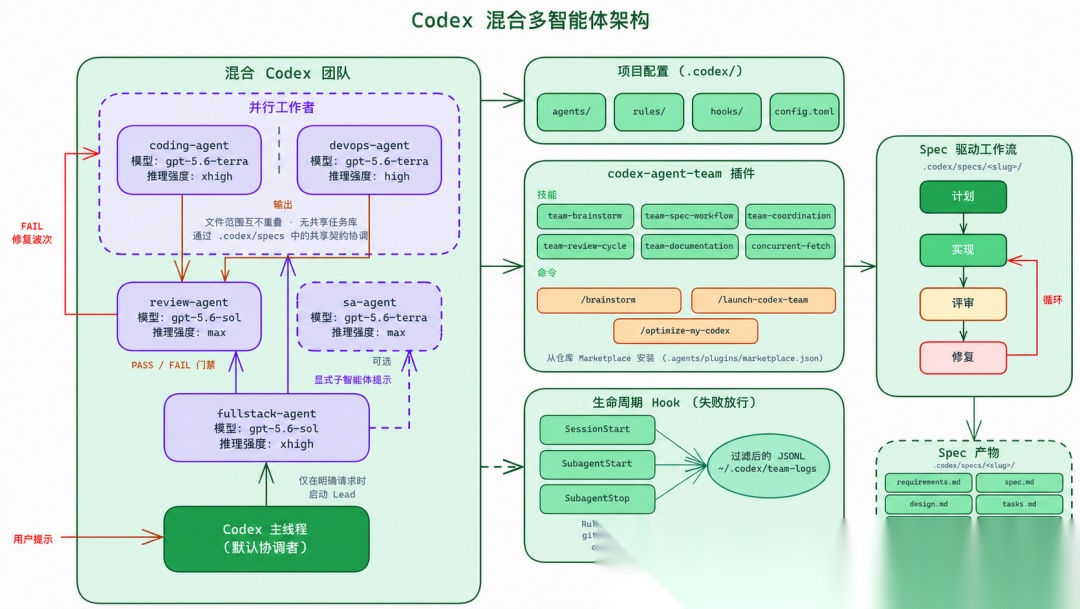
我通读了 AWS Samples 最近开源的 sample-codex-agent-team,原本以为会看到一个 Agent 调度服务:任务队列、状态数据库、并发控制器,再加一个可视化界面。
代码里什么都没有。
整个项目只有 53 个受 Git 管理的文件,核心资产是五份 Agent 配置、九个工作流 Skill、三条命令、三个生命周期 Hook、一套高风险命令规则,以及若干 Markdown 模板。它不运行 API,不保存任务状态,也不提供 Agent 之间的文件隔离。
但这恰恰是它最值得研究的地方。
这个项目没有试图再造一个“AI 版 Jira”,而是先回答了一个更基础的问题:当多个 Codex Agent 共享同一个代码仓库时,怎样让它们像一支工程团队,而不是一群同时修改文件的模型?
我读完配置、提示词、Hook、规则和测试后,得到的结论是:
多 Agent 软件工程真正的门槛,不是同时调用多少个模型,而是能否把任务边界、共享状态、接口契约、独立评审和失败收口写成一套可持续执行的协作协议。
这套样例已经把协议写得相当完整,但它仍然不是生产级控制平面。它展示了“团队应该怎样协作”,却没有从运行时强制“团队只能这样协作”。这两者之间的差距,正是理解这个项目的关键。
项目地址:
github.com/aws-samples/sample-codex-agent-team
本文分析基于main分支提交ea5bf54,仓库状态截至 2026 年 7 月 19 日。
先建立心智模型:这不是框架,而是工程协议包
如果只看项目里的 fullstack-agent、coding-agent 和 review-agent,很容易把它理解成“给不同模型写了几份角色提示词”。但真正把这些角色连起来的,是一条 Spec 驱动的控制链。
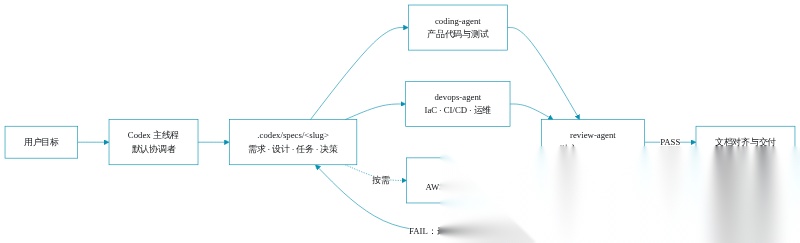
读这张图时要注意三点。
第一,默认协调者仍然是 Codex 主线程。fullstack-agent 不是每个任务都必须启动的“老板 Agent”,只有用户明确要求 Lead Profile 或 Spawn Plan 时才适合使用。
第二,Agent 之间没有共享任务数据库。它们通过 .codex/specs/<slug>/ 下的 Markdown 文件交换长期状态,通过主线程的显式 Spawn、Wait、Steer 和 Close 操作完成调度。
第三,Review 不是写完代码后随手执行的一条命令,而是一道有独立所有者、有次数上限、有终止条件的工程门禁。
从组件上看,这个仓库可以分成四层:
| 层级 | 主要文件 | 解决的问题 |
|---|---|---|
| 角色层 | .codex/agents/*.toml | 谁负责规划、编码、运维、评审和 AWS 架构 |
| 流程层 | plugins/codex-agent-team/skills/ | 怎样形成需求、拆任务、并行、评审和收尾 |
| 状态层 | .codex/specs/<slug>/ | 如何把需求、接口、任务、决策和评审留在对话之外 |
| 护栏层 | .codex/hooks.json 、.codex/rules/ | 如何记录生命周期,并对部分高风险命令加审批 |
这种结构说明,项目的设计中心不是“更聪明的单个 Agent”,而是把软件团队原本隐性的合作习惯显式化。
五个 Agent,不是五种人格,而是五种工程责任
项目为五个角色明确指定了模型和推理强度:
toml
.codex/config.toml
model = “openai.gpt-5.6-sol”
model_reasoning_effort = “xhigh”
[agents]
max_threads = 14
max_depth = 2
角色矩阵如下:
| Agent | 模型 | 推理强度 | 主要责任 | 建议并发上限 |
|---|---|---|---|---|
fullstack-agent | openai.gpt-5.6-sol | xhigh | 规格、接口、任务波次、委派和结果整合 | 1 |
coding-agent | openai.gpt-5.6-terra | xhigh | 限定范围内的产品代码、测试和修复 | 6 |
devops-agent | openai.gpt-5.6-terra | high | CI/CD、容器、IaC、环境和 Runbook | 2 |
review-agent | openai.gpt-5.6-sol | max | 独立审查正确性、安全性和验证证据 | 4 |
sa-agent | openai.gpt-5.6-terra | max | AWS 架构、安全、可靠性、成本和运营 | 1 |
表面上看,最醒目的数字是 max_threads = 14。但项目在 README 和 Agent 指令里反复强调:这些数字是上限,不是配额。
真正决定并发数的,不是“最多能启动几个 Agent”,而是当前任务波次里有多少个互不重叠的文件所有权范围。只有两个可以独立写入的模块,就只应该启动两个实现 Agent;一个顺序任务,启动一个 Worker 即可。
反直觉的是:这个样例虽然以“Agent Team”为卖点,却一直在克制使用 Agent。因为多启动一个 Worker 不只增加 Token 成本,也会增加过期交接、接口漂移和同文件竞争的概率。
fullstack-agent 的指令甚至明确禁止 Lead 直接接管大规模实现:
toml
.codex/agents/fullstack-agent.toml
Do not implement non-trivial production code, production-touching tests,
IaC, deployment scripts, or broad refactors.
The implementation-phase entry gate is delegation:
the first build action is to spawn or direct the worker pool.
这条边界很重要。Lead 的工作是确定需求、接口和文件所有权;Worker 的工作才是实现;Reviewer 的工作则是独立判断实现能否被接受。如果 Lead 一边规划、一边编码、最后再给自己 PASS,所谓多 Agent 团队只是在一个上下文里换了三顶帽子。
想先跑起来:15 分钟完成第一轮安全试用
读到这里,如果你想先看它到底能不能工作,最稳妥的方式不是立即把整套配置复制进主力项目,而是在样例仓库里跑一轮无云资源、无部署动作的小任务。
先确认四个前置条件:
| 前置条件 | 为什么需要 |
|---|---|
| Codex 已安装并完成认证 | 自定义 Agent、插件和 Hook 都由 Codex 加载 |
Python 3.11+ 在 PATH | 完整提示词回归测试依赖 tomllib |
| 当前目录是 Git 仓库根目录 | Hook 用 git rev-parse 定位脚本 |
| 你准备信任这个项目 | .codex 下的配置、Agent、Hook 和 Rules 只有信任后才加载 |
还有一个最容易忽略的条件:公开仓库没有包含私有 model_provider、凭据、区域和信任配置。配置里的 openai.gpt-5.6-sol 与 openai.gpt-5.6-terra 必须由你的 Provider 提供;如果当前环境没有这些模型,Agent 会在真正开始工作前报 404 Not Found: Engine not found。
路径一:在样例仓库中试跑
第一步,克隆并进入仓库:
bash
git clone https://github.com/aws-samples/sample-codex-agent-team.git
cd sample-codex-agent-team
python3 --version
codex --version
第二步,不要急着信任。先检查 .codex/config.toml、.codex/hooks.json、.codex/rules/ 和五份 Agent 配置。项目默认启用了 AWS IaC MCP、Context7、DeepWiki 和三个伴随插件;其中部分工具会启动 uvx、npx 进程、下载包或访问远程服务。不需要 AWS 和外部知识库时,先把相关 enabled 设为 false。
第三步,从仓库根目录打开 Codex,确认项目可信后,注册仓库 Marketplace:
bash
codex plugin marketplace add “$PWD”
然后在 Codex 中打开 /plugins,切换到 Sample Codex Agent Team Marketplace,安装 Codex Agent Team。
AWS 优化路径还建议安装三个伴随插件,但它们不是验证本地协作闭环的必要条件:
text
aws-core@agent-toolkit-for-aws
aws-data-analytics@agent-toolkit-for-aws
superpowers@openai-curated
第四步,启动一个新的 Codex 线程。插件是在会话启动时发现的,安装完成后继续使用旧线程,常常会表现为 Skill 和命令“已经在磁盘上,却找不到”。
新开线程前,可以先跑一轮本地预检:
bash
python3 scripts/test_prompt_invariants.py -v
python3 .codex/hooks/test_subagent_lifecycle.py -v
codex debug prompt-input “validate repo config”
前两条检查角色、Prompt 和 Hook;最后一条确认 Codex 能加载当前项目上下文。它们不会证明多 Agent 团队已经端到端可用,但可以提前暴露 Python 版本、配置解析和项目信任问题。
第五步,用一个只要求规划、不要求部署的 Prompt 验证整条链:
text
Use the Codex hybrid team to plan a small local CLI feature.
Create a .codex/specs plan, define exact interfaces,
split implementation into file-disjoint scopes,
spawn role agents only where useful,
and run one independent review wave.
Do not deploy or access cloud resources.
如果只是一个粗略想法,可以从需求访谈开始:
text
Use $team-brainstorm for:
一个只读取本地 Git 状态并生成 Markdown 摘要的 CLI。
如果已经有 Spec,则直接让工作流构建下一波任务:
text
Use $team-spec-workflow for .codex/specs/.
Build the next file-disjoint wave, then run review.
插件还提供三条快捷命令:/brainstorm 用于从想法生成需求,/launch-codex-team 用于启动完整团队工作流,/optimize-my-codex 用于审计当前 Codex 配置。快捷命令只是入口,底层仍然调用对应 Skill。
第一次试跑时,不要以“启动了几个 Agent”为成功标准。真正要检查的是:
-
.codex/specs/<slug>/是否生成需求、规格和任务;
-
每个 Worker 是否拥有明确且不重叠的文件;
-
返回结果是否包含真实验证命令和输出;
-
review.md是否由独立 Reviewer 写出;
-
任务结束后是否没有遗留 Agent;
-
Git Diff 中是否只有预期文件。
路径二:迁移到已有项目
这里必须分清两种资产。
plugins/codex-agent-team 提供可复用的 Skill 和命令;.codex/agents/*.toml、Hook、Rules 与项目配置则属于项目级或用户级 Codex 配置。只安装插件,不会自动把五个项目级 Agent 安装到任意代码库。
如果希望插件进入个人 Marketplace,可以在样例仓库中运行:
bash
python3 scripts/install_personal_plugin.py --dry-run
python3 scripts/install_personal_plugin.py --refresh-cache
第一条先展示将要修改的 Marketplace 文件和符号链接;确认无误后再执行第二条。脚本会更新 ~/.agents/plugins/marketplace.json,并创建 ~/plugins/codex-agent-team 指向当前仓库插件目录的符号链接。
然后再把真正需要的 .codex/agents、Hook、Rules 和 Spec 模板合并进目标仓库。注意是“审查后合并”,不是直接覆盖:现有项目可能已经有自己的 AGENTS.md、模型 Provider、线程上限、MCP、审批策略和安全规则。
四个最常见的开箱问题
| 症状 | 优先检查 |
|---|---|
| Skill 或命令看不到 | 安装后是否启动了新线程,插件是否启用 |
| 自定义 Agent 看不到 | 项目是否可信,Codex 是否从仓库根目录启动 |
Engine not found | Provider 是否提供配置中的精确模型 ID |
| Hook 没有运行 | /hooks 是否已信任,当前目录是否存在 Git 根 |
如果个人 Marketplace 中出现重复 Skill,通常是因为既安装了插件,又把同一批 Skill 直接软链接到了 ~/.agents/skills。保留 ~/plugins/codex-agent-team 这一条标准插件来源,删除重复直链,再刷新插件缓存并新开线程。
仓库没有提供专门的 test-suite-runner Agent。实现 Worker 应使用目标项目原生的测试、Lint、类型检查和 CI 命令,Reviewer 再判断这些验证是否真的覆盖验收条件。不要为了凑齐角色,额外制造一个没有项目上下文的“万能测试 Agent”。
至此,读者已经能跑通一轮。但“能启动”不等于“能长期协作”。接下来才进入这套系统真正承重的部分:它如何把跨 Agent 状态放进 .codex/specs。
.codex/specs 才是团队的共享记忆
多 Agent 最容易制造的一种错觉,是把聊天记录当成团队状态。
一个 Worker 在消息里说“测试通过”,另一个 Worker 说“接口已经对齐”,Lead 再把两段结果总结成一句“本轮完成”。只要中间发生一次上下文压缩、会话中断或消息延迟,团队对当前状态的理解就可能分叉。
这个样例给出的解法很朴素:对话负责沟通,仓库文件负责记忆。
每个非平凡任务都可以在 .codex/specs/<slug>/ 下维护一组文档:
| 文件 | 职责 | 关键问题 |
|---|---|---|
requirements.md | 已确认的产品意图 | 用户真正需要什么,什么不做 |
spec.md | 可执行规格 | 接口、错误、边界和验收标准是什么 |
design.md | 架构与取舍 | 组件怎样连接,为什么选择这个方案 |
tasks.md | 波次、所有权和进度 | 谁能写哪些文件,用什么命令验证 |
decisions.md | 追加式决策日志 | 中途改了什么,谁批准,怎样回滚 |
review.md | 独立评审历史 | 当前第几轮,有哪些发现,是否 PASS |
sa-review.md | AWS 架构意见 | 安全、可靠性、成本和残余风险是什么 |
这些文档不是为了“多写几份 Markdown”,而是为了建立明确的事实优先级。
仓库里的 AGENTS.md 规定:当前文件与 Diff 是实现状态的事实来源;.codex/specs 是需求、所有权、决策、阻塞和评审的事实来源;新鲜的命令输出是验证结论的事实来源。Agent 的返回消息只是证据之一,旧摘要和沉默都不能覆盖当前磁盘状态。
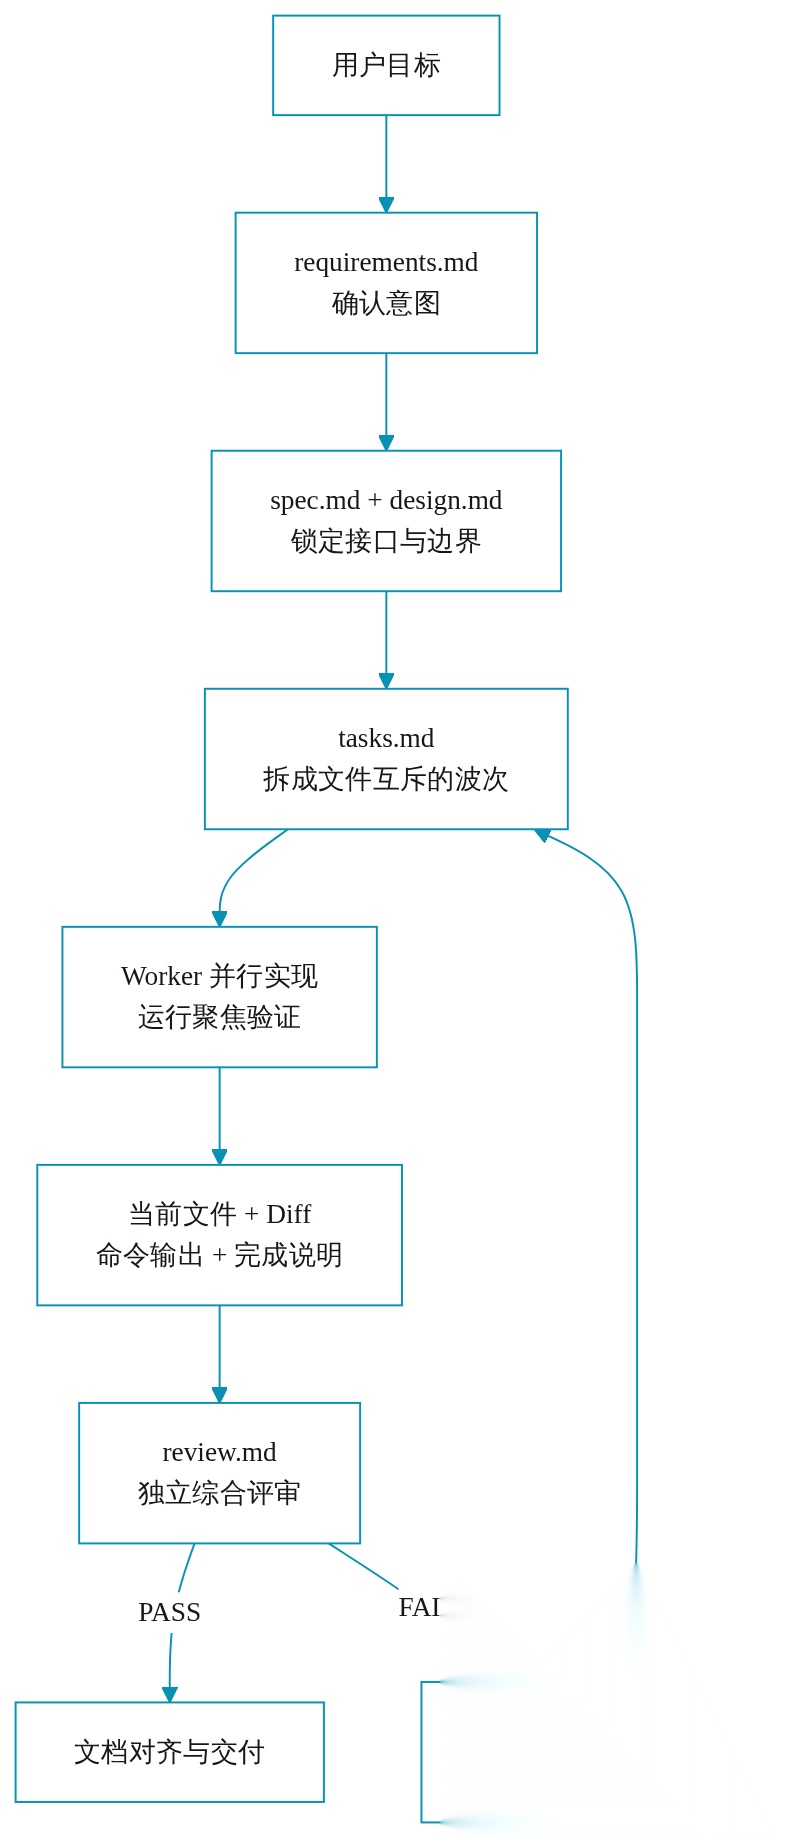
这条链路最大的价值,是恢复能力。一次会话中断后,Lead 不应该重新播放旧的 Spawn Plan,而是重新读取 tasks.md、decisions.md、review.md、当前文件和 Agent 状态,再判断哪些工作已经完成、仍在运行、明确失败或状态未知。
Agent 会遗忘,聊天会被压缩,但仓库可以被重新读取。多 Agent 系统要想可恢复,就必须把关键状态放在模型上下文之外。
并行不是“同时开始”,而是文件所有权互不重叠
有了共享记忆,还要解决共享工作区的问题。
这些 Agent 默认操作同一个仓库文件系统,没有容器级或操作系统级隔离。如果两个 Worker 同时改同一个文件,提示词里的角色名称并不能阻止覆盖。项目因此把“文件互斥”提升成整个工作流最核心的规则:
md
Wave 1:
Spec refs: spec.md#interfaces, requirements.md#FR-1
-
[coding] Implement order validation |
src/orders/validate.ts,src/orders/validate.test.ts|Match
OrderInputand error contracts.Run:
npm test -- orders/validate
一个合格任务至少要写明:
- 唯一实例名,例如
coding-2; - 对应的 Spec、任务和波次;
- 精确可写文件与禁止编辑的边界;
- 验收条件和生产、消费的接口契约;
- 验证命令或必须提交的证据;
- 预期返回内容;
- 是否必须等待全部同波次 Agent;
- 其他 Agent 正在附近并行编辑的提醒。
项目给出的交接示例很具体:
text
.codex/agents/fullstack-agent.toml
Use coding-agent as coding-2.
Context: .codex/specs/orders-api/, Wave 2.
Scope: only src/orders/handler.ts and
src/orders/handler.test.ts.
Acceptance: match spec.md#interfaces.
Run: npm test -- orders/handler.
Do not edit outside scope; peers are working concurrently.
这其实是在用自然语言模拟一个轻量级的所有权系统。每个 Worker 获得一块写入租约;任务波次则是一组可以同时持有、又不会重叠的租约。
天真的做法是按“前端、后端、测试、文档”分四个 Agent。但真实仓库里,前端 Agent 和测试 Agent 往往都要改同一份测试夹具,后端 Agent 和文档 Agent 可能同时修改 OpenAPI 文件。按角色拆分不等于按文件拆分。
更可靠的顺序是:先锁定共享接口,由一个明确所有者完成;再根据当前磁盘上的文件边界向外扇出;如果两个任务必须写同一个文件,就串行执行,或者指定唯一 Merge Owner。
这也解释了为什么 tasks.md 使用“波次”而不是一张平铺清单。波次边界必须对应真实依赖:接口、数据、代码生成或顺序约束,而不是为了让计划看起来整齐。
主线程真正要管理的是不确定性
Worker 启动之后,主线程并不是坐等几条“完成”消息。
它要持续维护四类事实:谁拥有哪些文件、哪些结果已经返回、哪些证据足以关闭任务、哪些 Agent 仍然活跃。项目将这个循环概括为 Spawn、Wait、Steer、Close:
text
Spawn 启动当前波次真正需要的 Worker
Wait 等待所有已请求 Agent,不用沉默推断失败
Steer 对不完整结果做最小范围纠正
Close 收割结果后关闭已完成或不再需要的 Agent
这里有一个很成熟的判断:沉默不是失败。
Agent 可能正在跑未缓存测试、构建容器、执行 terraform plan 或做大范围评审。仅凭时间流逝、没有新消息或看不到某个进程,不能复制任务或重新分配相同文件。
只有出现积极证据——明确的终止错误、确认进程已结束、输出损坏,或有持久证据证明验收无法完成——才允许恢复或重派。而且恢复时只重派未完成的最小范围,不能由 Lead 顺手接管全部实现。
这条规则解决的是 Agent 系统中一个常见灾难:因为看起来“卡住”而启动第二个 Worker,两个实例随后同时写回同一批文件。很多多 Agent 冲突并不是并发设计错误,而是错误恢复制造的重复所有权。
独立评审不是角色扮演,而是一道权限边界
当实现完成,项目没有让 Lead 汇总一下测试结果就宣布成功。它要求 review-agent 独立给出 PASS 或 FAIL。
这不是措辞上的严格,而是职责上的隔离:
- Lead 不能在
review.md里写权威 PASS; - 实现 Agent 的自我检查只能算 TODO 标记;
- 分析 Reviewer 只能提交局部证据;
- 每一轮只能有一个综合 Reviewer 写最终结论;
- 综合 Reviewer 必须等待所有被请求的分析结果,或明确记录缺失证据。
大范围变更最多可以启用四个 Reviewer,但它们不是四次独立投票:review-1 是唯一综合者,review-2 到 review-4 是按文件切片的分析员。分析员不写 review.md,避免多人覆盖同一份权威记录。
评审关注的不只是“代码看起来对不对”,还要求验证验证器本身:
text
plugins/codex-agent-team/skills/team-review-cycle/SKILL.md
A green command is not enough if it:
-
checks the wrong scope
-
omits a CI-pinned linter/type checker/test
-
never exercises the acceptance criterion
-
uses a broken assertion or inadequate script
-
substitutes static validation for required runtime behavior
因此,一条绿色命令不能自动关闭任务。terraform validate 证明不了真实账户和区域;静态检查证明不了部署脚本保留了真实退出码;Mock 测试也不能替代验收标准要求的服务行为。
对于 IaC、部署脚本、CI/CD、容器和 Shell 工具,项目明确区分“静态已验证”和“运行时已验证”。如果没有凭据、Docker 或安全环境,必须留下开放的 Live Validation Gate,而不能把静态 PASS 写成运行时 PASS。
三轮评审预算:防止系统无限自转
更反直觉的是,这套工作流为整个用户目标只提供三次综合评审机会。
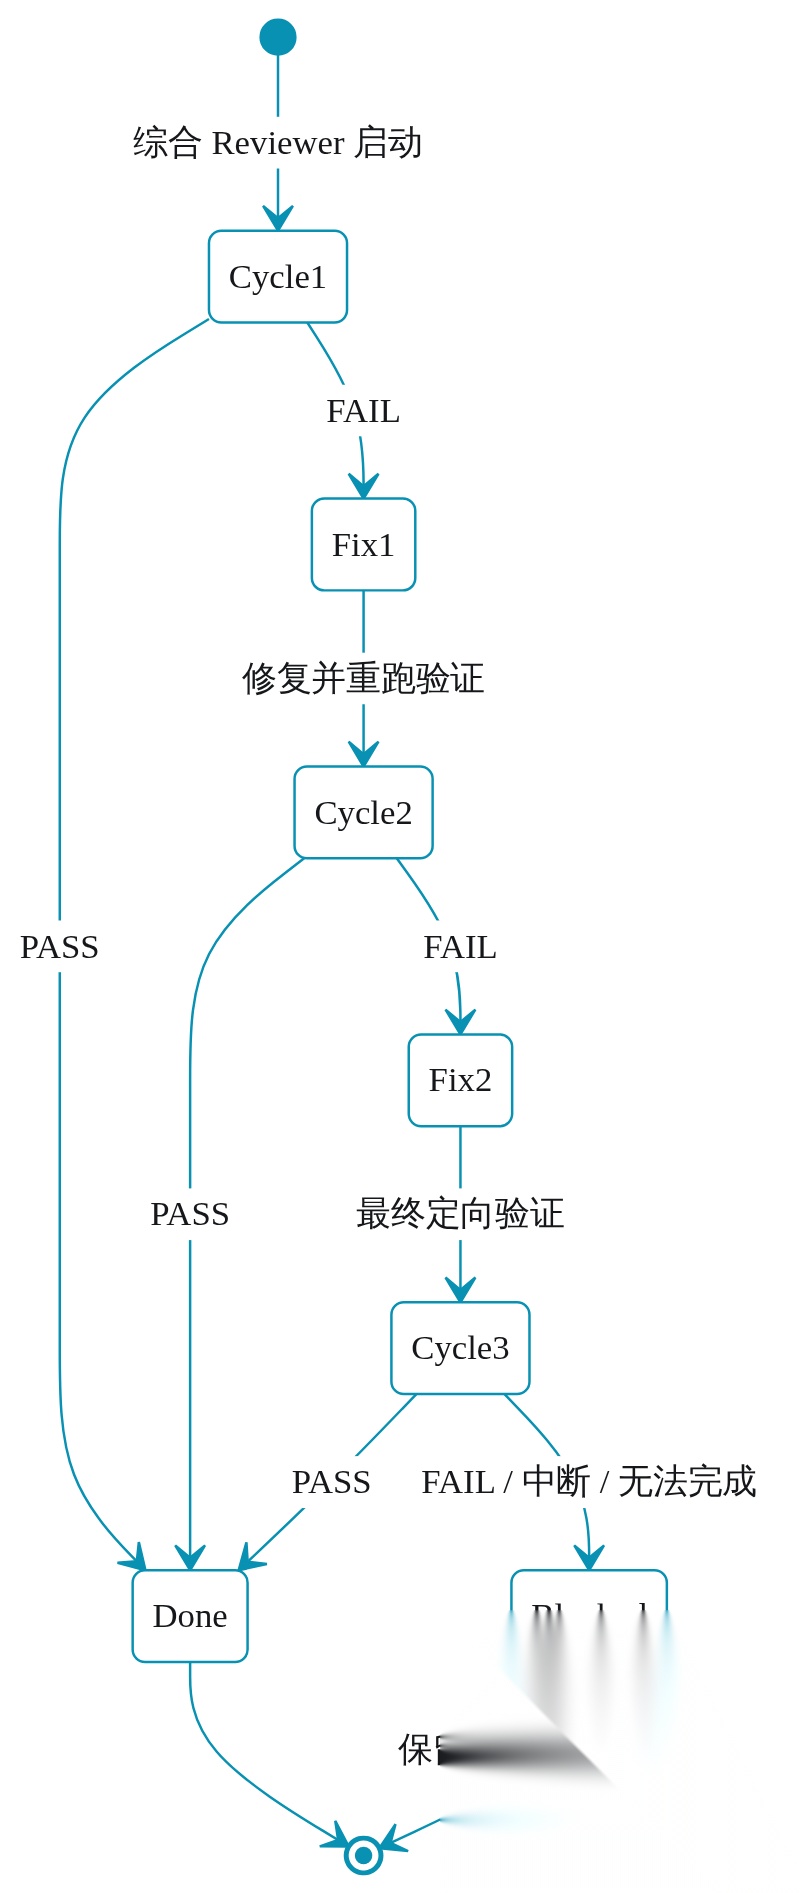
一次评审不是 Reviewer 返回结论时才计数,而是综合 Reviewer 被启动时就消耗预算。初次评审、定向复查、替换 Reviewer 和中断后的重试都算。预算不会因为换了文件、波次、会话或 Reviewer 而重置。
第一轮和第二轮 FAIL 可以各产生一个范围明确的修复波次;第三轮是终局。如果第三轮失败、中断或无法完成,系统必须停止继续 Spawn 修复和评审 Agent,关闭仍在运行的实例,保存发现和验证证据,然后把决定权交还给用户。
这种设计牺牲了一部分自动修复能力,换来资源上界和清晰的停止条件。它防止一个“Reviewer 总能找到新问题”的系统无限消耗 Token,也避免 Agent 在没人监督时不断修改已经接近稳定的代码。
但三轮预算也有副作用:模型路由故障、基础设施抖动或 Reviewer 意外中断,同样会消耗稀缺次数。它适合作为安全样例的保守默认值,真实团队则应该把“工程失败”和“平台失败”分开计量,同时仍保留总成本上限。
Hook 和 Rules 是护栏,不是控制平面
项目还提供三类生命周期 Hook:SessionStart、SubagentStart 和 SubagentStop。
json
// .codex/hooks.json
{
“SubagentStart”: “subagent_lifecycle.py start”,
“SubagentStop”: “subagent_lifecycle.py stop”
}
Hook 会过滤输入字段,把事件写入 ~/.codex/team-logs,日志达到 1 MiB 后轮转并保留三个备份。Subagent 日志在轮转和追加时使用 fcntl.flock,避免多个 Agent 同时启动或停止造成写入竞争。
它还采用 Fail-open 策略:日志目录不可写、输入 JSON 损坏或轮转失败,都返回成功,不让观测功能困住正常会话。
这是一种合理的可用性取舍,但也要看清边界。Hook 只是记录“Agent 开始或停止”,不会阻止两个 Worker 修改同一个文件,不会验证 tasks.md 是否更新,也不会强制关闭遗留 Agent。前面所有团队纪律,仍然依赖主线程和角色提示词执行。
命令规则也一样。仓库对以下操作设置了确认或禁止:
-
git push、
gh pr create; -
git push --force、
git reset --hard; -
terraform apply/destroy、
cdk deploy/destroy; -
sam deploy/delete、CloudFormation 部署和删除;
-
aws s3 rm/rb、
kubectl delete; -
docker system prune。
我用 Codex 自带的 Execpolicy 检查器测试了代表性命令。直接执行 git push 会要求确认,git push --force 和 git reset --hard 会被禁止,Terraform、S3、Kubernetes 和 Docker 的目标命令也能正确匹配。
但前缀规则不是完整安全策略。git -C /path push、bash -lc 'git push'、aws s3api delete-object 和 helm uninstall 并不匹配现有规则。仓库文档也承认,Rules 只能减少部分误操作,不能取代 Sandbox、最小权限凭据和人工审批。
提示词是组织制度,Hook 是审计日志,Rules 是局部门禁。三者都很有用,但没有一个等于强制调度控制平面。
我实际跑了一遍验证:语法是绿的,行为仍有空白
为了区分“文档设计得很好”和“仓库当前真的可用”,我按 README 跑了自带验证,并补了几项结构检查。
| 检查 | 结果 | 它实际证明了什么 |
|---|---|---|
| 提示词不变量测试 | 9/9 通过 | 五角色模型矩阵和关键概念仍存在 |
| Subagent Hook 测试 | 5/5 通过 | 非对象 JSON、坏 JSON、字段过滤、Fail-open 和锁文件行为 |
| JSON/TOML/YAML 解析 | 通过 | 配置和元数据语法有效 |
| Python 编译 | 通过 | Hook、安装器和测试脚本可被 Python 3.13 编译 |
| 插件校验逻辑 | 通过 | Manifest、Skill Front Matter 和 Agent YAML 满足当前结构契约 |
| Execpolicy 代表命令 | 通过 | 文档列出的直接命令前缀可以正确确认或禁止 |
| 安装器 Dry-run | 通过 | 能计算个人 Marketplace 和符号链接目标,不进行写入 |
这里有一个环境细节:当前 macOS 的 /usr/bin/python3 是 Python 3.9,没有 tomllib,因此完整提示词测试用系统 python3 会失败;切换到已安装的 Python 3.13 后 9 项全部通过。README 已要求 Python 3.11+,所以这不是代码回归,但它说明采用者不能只看“机器上有 Python”。
更重要的是,这些测试大部分验证“配置存在”和“关键词没有消失”,而不是验证真实的多 Agent 行为。仓库已经删除早期的临时 Smoke Project,也明确要求采用者在自己的沙箱里重新验证 GPT-5.6 路由、并行池和 Hook 锁。
因此,当前能给出的准确结论是:静态配置和局部脚本测试是绿的,完整团队闭环尚未被端到端证明。
六个投入真实项目之前必须补的缺口
1. .gitignore 与 README 自相矛盾
这是我在仓库里发现的最具体、也最应该优先修的问题。
README 明确写着:运行时生成的 .codex/specs 已被 .gitignore 排除,不属于这个可复用样例;安全章节也要求把运行时 Specs、日志、本地状态和凭据留在 Git 之外。
但仓库根目录没有 .gitignore。我用 git check-ignore 检查 .codex/specs/example/spec.md,结果是 NOT_IGNORED。
这意味着一次普通的 git add .,可能把需求、架构决策、评审发现、被接受的安全风险甚至内部环境信息一起提交。对于一个把 .codex/specs 作为长期记忆的系统,这不是文档瑕疵,而是数据治理缺口。
最低限度应该加入:
gitignore
.codex/specs/
.codex/team-logs/
*.sqlite
.env
.env.*
真实项目还应区分哪些规格需要版本控制、哪些只允许保留在本地,不能简单把所有 Spec 一刀切忽略。
2. 协作约束没有运行时强制
文件互斥、等待全部 Worker、三轮预算和关闭 Agent 都写得很细,但它们本质上仍是提示词协议。
没有调度器验证两个 Spawn Prompt 是否包含重复文件,没有租约服务拒绝第二个 Writer,也没有状态机自动阻止第四轮 Reviewer。主线程遵守时系统工作良好;主线程漏读、上下文被压缩或提示词被覆盖时,规则可能静默失效。
如果用于高价值仓库,至少应该增加机器可读的任务清单、文件所有权冲突检查和评审计数器,而不是只依赖 Markdown 自由文本。
3. MCP 使用 @latest,可复现性不足
项目默认启用了三个外部能力入口:AWS IaC MCP、Context7 和 DeepWiki。其中两个本地进程直接引用浮动版本:
toml
.codex/config.toml
args = [“awslabs.aws-iac-mcp-server@latest”]
args = [“-y”, “@upstash/context7-mcp@latest”]
这让同一份仓库在不同日期启动时可能下载不同代码。对于能读取仓库、访问文档甚至接触 AWS 环境的工具,浮动依赖会同时扩大供应链风险和调试难度。
更稳妥的做法是固定版本、记录校验信息,并把网络工具设为显式启用,而不是在项目配置里默认打开。
4. 默认 AWS Profile 和远程数据出口需要组织级审查
AWS IaC MCP 写死 AWS_PROFILE=default,Context7 配置了默认工具批准,DeepWiki 则是远程 HTTP MCP。
这三个设置对个人样例很方便,对企业仓库却意味着三类问题:默认凭据可能指向未知账户;仓库片段可能发送给第三方;工具调用的批准边界可能比组织策略更宽。
采用前应该明确账户、区域、Profile、数据分类和允许外发的内容,并对云端工具使用最小权限、只读凭据和单独的启用开关。
5. Hook 的跨平台能力有限
Hook 命令硬编码 /usr/bin/python3,用 $(git rev-parse ...) 解析仓库根目录;Subagent Logger 又直接导入 Unix 专有的 fcntl。
这套实现适合当前 macOS/Linux 环境,但不能直接视为跨平台样例。Windows 缺少 fcntl,Shell 命令替换语法也不同。即使在 Unix 上,Python 的实际版本和安装位置也可能不一致。
如果目标团队包含 Windows,应该改成平台无关的启动入口和锁实现,并在 CI 中建立 macOS、Linux、Windows 三平台测试矩阵。
6. 回归测试保护的是提示词词面,不是系统行为
scripts/test_prompt_invariants.py 的方法主要是:检查模型与推理强度、统计最低单词数、确认提示词包含指定概念。
这能防止一次“精简提示词”误删安全条款,却也会产生两个副作用:一是包含关键词不等于 Agent 会正确执行;二是最低字数门槛会鼓励提示词不断增长。
当前五个 Agent 的提示词合计约 7,380 个英文单词,九个 Skill 再增加约 12,022 个单词。虽然 Skill 会按需加载,但 AGENTS、角色 Prompt 和 Skill 之间已经有大量重复。未来每修复一个失败案例,都继续追加一段警告,最终会形成提示词债务。
更好的测试组合应该包括:结构化 Schema、少量关键 Prompt Snapshot、临时仓库中的多 Agent Smoke Test、规则匹配矩阵、真实并发日志压力测试,以及中断恢复演练。
如果我要把它用于真实团队,会分三步落地
第一步不是启动 14 个线程,而是建立一个最小可信闭环。
只选一个边界清楚的功能,用一个 Coding Agent 和一个独立 Reviewer。要求任务有明确文件范围、接口和验证命令;中断后必须能仅靠 .codex/specs 和 Git 状态恢复。只要这条链路还不能稳定重复,就不应该扩大并发。
第二步补强机器护栏。
加入 .gitignore 和数据分类;固定 MCP 版本;关闭默认远程集成;将任务范围写成可解析结构;Spawn 前做文件重叠检查;用 CI 测试 Execpolicy、Hook、安装器和中断恢复;给 Token、时间、重试与外部调用设置预算。
第三步才扩大角色池。
从 2~4 个 Worker 开始,根据真实的文件互斥宽度增加并发。AWS 工作一旦涉及 IAM、KMS、网络暴露、EKS、状态后端或分类数据,再引入 sa-agent。Reviewer 数量也按变更切片增加,而不是为了“更独立”就让四个 Reviewer 重复阅读同一批文件。
这套顺序的核心是:先证明闭环,再扩展吞吐;先增加可验证性,再增加自治。
真正值得抄走的,不是五个 Agent 的名字
sample-codex-agent-team 目前仍是一个年轻样例:创建时间只有一个月左右,没有正式 Tag 或 Release,模型 Provider、凭据和信任配置也刻意没有提交。它离生产级多 Agent 控制平面还有明显距离。
但它已经抓住了一个经常被忽略的方向。
很多多 Agent Demo 把注意力放在角色数量、并发动画和“几个模型一起讨论”。这个项目反过来,把最多篇幅花在文件所有权、事实来源、验证证据、恢复条件、独立评审和停止规则上。
这些内容看起来没有那么炫,却更接近真实软件团队每天赖以生存的东西。
Agent 能不能成为工程同事,不取决于它有没有一个像人的名字,而取决于它是否拥有清晰责任、可检查交接、有限权限、独立验收和可恢复状态。没有这些,所谓团队只是并发调用;有了这些,即使底层仍然是 Markdown 和提示词,也已经开始形成工程组织。
所以,这个仓库最值得借鉴的,不是 fullstack-agent、coding-agent 或 review-agent 的具体 Prompt,也不是 max_threads = 14 的参数。
真正值得抄走的是它背后的判断:
不要只提示 Agent 去完成任务。把一支工程团队如何分工、如何共享事实、如何证明完成、如何拒绝错误、又如何在失败后停下来,写成 Agent 可以反复读取的系统。
当这些协议逐渐从提示词走向机器可验证的状态、租约和门禁,多 Agent 软件工程才会真正从“几个模型一起工作”,走向“一个可以被信任的生产系统”。
学AI大模型的正确顺序,千万不要搞错了
🤔2026年AI风口已来!各行各业的AI渗透肉眼可见,超多公司要么转型做AI相关产品,要么高薪挖AI技术人才,机遇直接摆在眼前!
有往AI方向发展,或者本身有后端编程基础的朋友,直接冲AI大模型应用开发转岗超合适!
就算暂时不打算转岗,了解大模型、RAG、Prompt、Agent这些热门概念,能上手做简单项目,也绝对是求职加分王🔋

📝给大家整理了超全最新的AI大模型应用开发学习清单和资料,手把手帮你快速入门!👇👇
学习路线:
✅大模型基础认知—大模型核心原理、发展历程、主流模型(GPT、文心一言等)特点解析
✅核心技术模块—RAG检索增强生成、Prompt工程实战、Agent智能体开发逻辑
✅开发基础能力—Python进阶、API接口调用、大模型开发框架(LangChain等)实操
✅应用场景开发—智能问答系统、企业知识库、AIGC内容生成工具、行业定制化大模型应用
✅项目落地流程—需求拆解、技术选型、模型调优、测试上线、运维迭代
✅面试求职冲刺—岗位JD解析、简历AI项目包装、高频面试题汇总、模拟面经
以上6大模块,看似清晰好上手,实则每个部分都有扎实的核心内容需要吃透!
我把大模型的学习全流程已经整理📚好了!抓住AI时代风口,轻松解锁职业新可能,希望大家都能把握机遇,实现薪资/职业跃迁~
这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】

 2万+


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


