LangGraph Reducer 深度应用:为什么你的 State 合并总是出问题?

State 深度解析:Reducer、Schema 与多状态设计——从零开始学 LangGraph(二) 第一期我们搭了一个最简单的 StateGraph,见识了三个概念:State、Node、Edge。其中State是最容易被低估的——很多人把它简单理解成"一个存数据的 dict",然后就跳过去了。但等你真正开始写复杂的 Agent,你会发现程序里 80% 的 bug 都出在 State 上:“为什么消息被覆盖了?” “为什么 Node 收到了我没有传的参数?” “为什么 invoke 返回的数据比我想象的多?这一期,我们彻底搞懂 State。更新方式语法行为适用场景覆盖不加 Annotated。 阅读详情

这篇文章帮你搞定 LangGraph Reducer 的高级用法,从源码解析到生产级模式,从并发安全到测试策略

阅读提示

  • 适合谁看:已读过 State 设计模式基础,想深入 Reducer 机制的工程师
  • 看完能做什么:能实现生产级 Reducer,处理复杂的 State 合并场景
  • 不适合谁:还没了解 Reducer 基础概念的纯新手

先给结论

  • Reducer 不是"合并函数",而是"定义 State 语义的核心机制"
  • add_messages 基于 message_id 去重,不是简单的列表拼接
  • 生产级 Reducer 必须考虑:幂等性、线程安全、版本兼容

01 add_messages 源码解析:不只是列表拼接
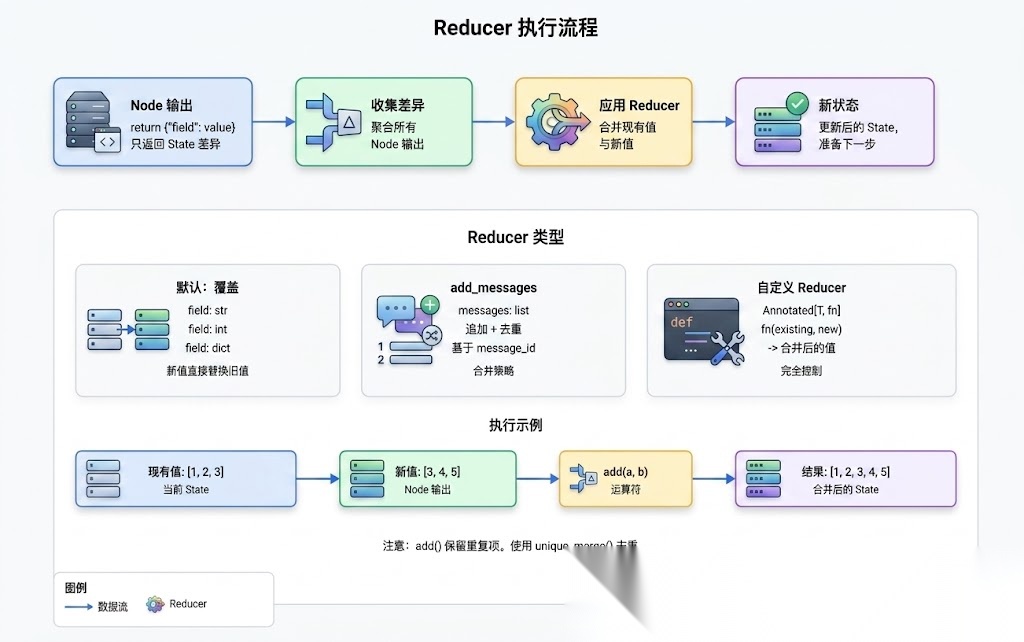
很多人以为 add_messages 就是 list.extend(),其实它做了更多事情。

完整实现
from langgraph.graph.message import add_messagesfrom langchain_core.messages import BaseMessagefrom typing import List, Sequence, Union# add_messages 的生产级实现(简化版)def add_messages(    left: Sequence[BaseMessage],    right: Union[Sequence[BaseMessage], BaseMessage]) -> List[BaseMessage]:    """合并消息列表,基于 message_id 去重      行为:    1. 右侧消息追加到左侧    2. 相同 id 的消息会被更新(不是重复)    3. 保持消息的时间顺序    """    # 规范化输入    if isinstance(right, BaseMessage):        right = [right]    # 转换为字典,基于 id 去重    left_map = {msg.id: msg for msg in left}    # 合并右侧消息    for msg in right:        left_map[msg.id] = msg  # 相同 id 会覆盖    # 保持原始顺序    return list(left_map.values())
关键洞察:基于 id 去重
from langchain_core.messages import HumanMessage, AIMessage# 示例:相同 id 的消息会被更新msg1 = HumanMessage(content="hello", id="msg-1")msg2 = AIMessage(content="hi", id="msg-2")msg3 = HumanMessage(content="hello updated", id="msg-1")  # 同一个 idexisting = [msg1, msg2]new = [msg3]result = add_messages(existing, new)# 结果: [msg1_updated, msg2]# msg3 替换了 msg1(因为 id 相同)

为什么这样设计? 因为在多轮对话中,消息可能会被重新生成(比如 LLM 重试),需要用 id 来标识同一条消息。

02 Reducer 与 Annotated 的交互机制
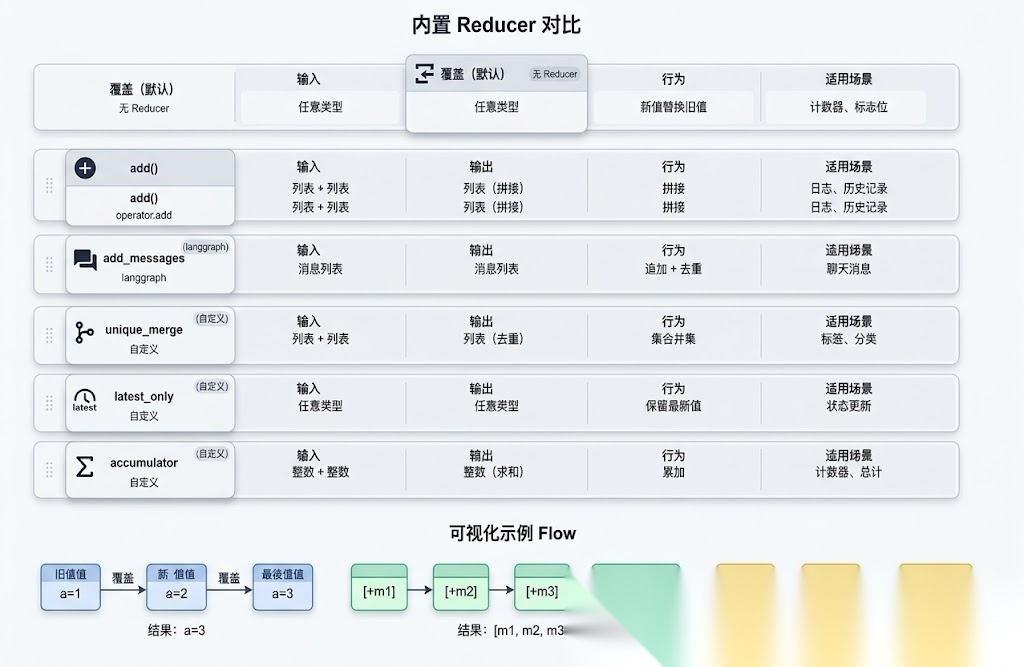
Annotated 的第二个参数就是 Reducer。但很多人不理解这个机制是怎么工作的。

底层原理
from typing import Annotated, get_type_hints, get_args# LangGraph 内部如何提取 Reducer(简化版)def extract_reducer(state_class):    """从 State 类中提取 Reducer"""    reducers = {}    for field_name, field_type in state_class.__annotations__.items():        if hasattr(field_type, '__metadata__'):            # Annotated 类型,提取 Reducer            metadata = field_type.__metadata__            if len(metadata) >= 2:                reducers[field_name] = metadata[1]  # 第二个参数是 Reducer    return reducers# 使用示例class AgentState(TypedDict):    messages: Annotated[list, add_messages]  # Reducer 是 add_messages    count: Annotated[int, lambda old, new: old + new]  # Reducer 是 lambdareducers = extract_reducer(AgentState)# reducers = {#     "messages": add_messages,#     "count": <lambda># }
Reducer 的调用时机
# LangGraph 内部执行流程(简化版)class StateManager:    def __init__(self, state_class):        self.reducers = extract_reducer(state_class)        self.state = {}    def apply_update(self, node_output: dict):        """应用 Node 输出,使用 Reducer 合并"""        for key, value in node_output.items():            if key in self.reducers:                # 有 Reducer,调用 Reducer 合并                reducer = self.reducers[key]                self.state[key] = reducer(                    self.state.get(key),  # 现有值                    value                  # 新值                )            else:                # 没有 Reducer,直接覆盖                self.state[key] = value

03 生产级 Reducer 模式
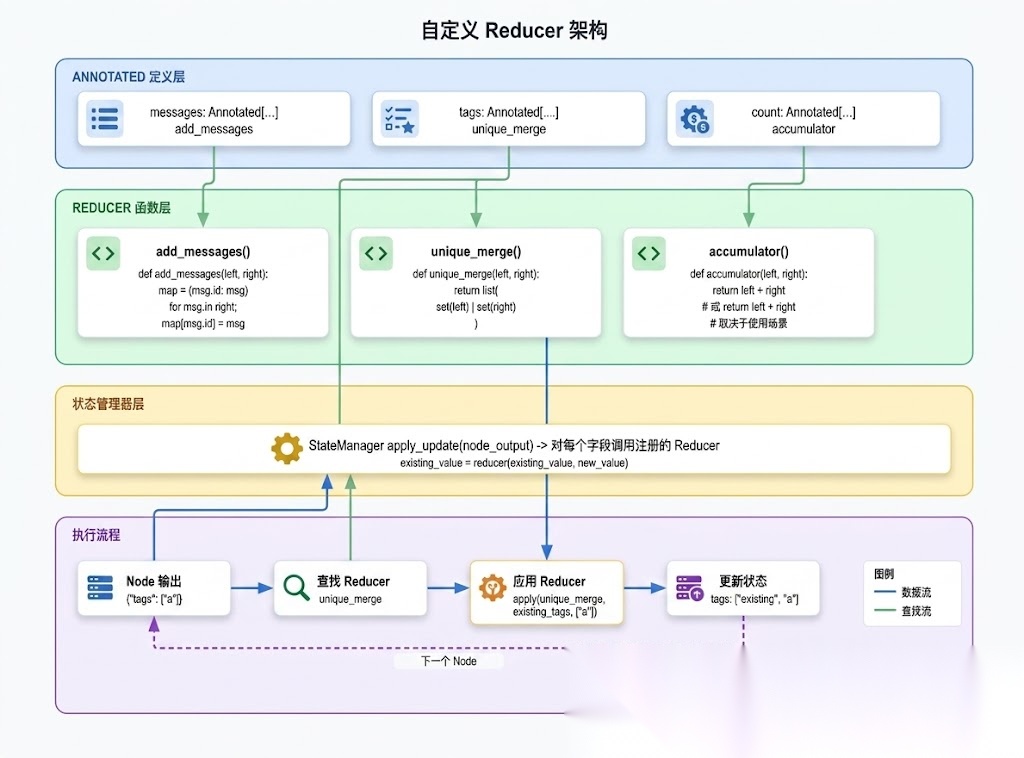
图 3|Custom Reducer Architecture

模式 1:条件更新
def conditional_update(existing: dict, new: dict, only_if_exists: bool = True) -> dict:    """条件更新:只更新已存在的字段"""    if only_if_exists:        return {k: v for k, v in new.items() if k in existing}    return {**existing, **new}# 在 State 中使用class AgentState(TypedDict):    config: Annotated[dict, lambda old, new: conditional_update(old, new, only_if_exists=True)]
模式 2:带版本控制
def versioned_merge(existing: dict, new: dict) -> dict:    """带版本号的合并:只接受更高版本"""    if new.get("version", 0) > existing.get("version", 0):        return new    return existing# 在 State 中使用class AgentState(TypedDict):    config: Annotated[dict, versioned_merge]
模式 3:深度合并
def deep_merge(existing: dict, new: dict) -> dict:    """深度合并:递归合并嵌套字典"""    result = existing.copy()    for key, value in new.items():        if key in result and isinstance(result[key], dict) and isinstance(value, dict):            result[key] = deep_merge(result[key], value)        else:            result[key] = value    return result# 在 State 中使用class AgentState(TypedDict):    config: Annotated[dict, deep_merge]

04 并发安全:生产环境必须考虑

import threadingfrom typing import Any# ❌ 危险:非线程安全的 Reducerclass UnsafeReducer:    def __init__(self):        self.cache = {}  # 共享状态    def __call__(self, existing: Any, new: Any) -> Any:        # 多线程同时访问 cache 会导致数据竞争        key = str(existing) + str(new)        if key notin self.cache:            self.cache[key] = existing + new        return self.cache[key]# ✅ 安全:无状态 Reducer(推荐)def safe_reducer(existing: Any, new: Any) -> Any:    """无状态 Reducer:不依赖外部变量"""    return existing + new# ✅ 安全:带锁的 Reducer(需要缓存时)class ThreadSafeReducer:    def __init__(self):        self.lock = threading.Lock()        self.cache = {}    def __call__(self, existing: Any, new: Any) -> Any:        with self.lock:            key = str(existing) + str(new)            if key notin self.cache:                self.cache[key] = existing + new            return self.cache[key]

并发安全检查清单:

检查项说明
无全局变量Reducer 不应该依赖 global 变量
无共享状态Reducer 不应该有实例变量(除非加锁)
无 I/O 操作Reducer 不应该读写文件、网络等
纯函数相同输入相同输出,无副作用

05 Reducer 测试策略

import pytestclass TestReducer:    """Reducer 测试套件"""    def test_basic_merge(self):        """测试基本合并"""        reducer = unique_merge        result = reducer([1, 2], [2, 3])        assert result == [1, 2, 3]    def test_idempotent(self):        """测试幂等性:多次调用结果相同"""        reducer = unique_merge        result1 = reducer([1, 2], [3])        result2 = reducer(result1, [3])  # 重复添加        assert result1 == result2    def test_type_preservation(self):        """测试类型保持:输入输出类型相同"""        reducer = unique_merge        existing = [1, 2]        new = [3]        result = reducer(existing, new)        assert type(result) == type(existing)    def test_empty_input(self):        """测试空输入"""        reducer = unique_merge        result = reducer([], [1, 2])        assert result == [1, 2]              result = reducer([1, 2], [])        assert result == [1, 2]    def test_concurrent_safety(self):        """测试并发安全"""        import threading              reducer = ThreadSafeReducer()        results = []              def run_reducer():            for _ in range(100):                result = reducer([1], [2])                results.append(result)              threads = [threading.Thread(target=run_reducer) for _ in range(10)]        for t in threads:            t.start()        for t in threads:            t.join()              # 所有结果应该相同        assert all(r == [1, 2] for r in results)

06 最小实验:跑通一个生产级 Reducer

实验条件

  • 环境:Python 3.11 + langgraph 1.1.10
  • 输入:一个使用深度合并 Reducer 的 Agent
  • 预期观察:嵌套字典正确合并

代码 1

from langgraph.graph import StateGraph, MessagesState, START, ENDfrom langgraph.checkpoint.memory import MemorySaverfrom typing import Annotated, TypedDict# 深度合并 Reducerdef deep_merge(existing: dict, new: dict) -> dict:    result = existing.copy()    for key, value in new.items():        if key in result and isinstance(result[key], dict) and isinstance(value, dict):            result[key] = deep_merge(result[key], value)        else:            result[key] = value    return result# 定义 Stateclass AgentState(TypedDict):    messages: Annotated[list, add_messages]    config: Annotated[dict, deep_merge]# 定义 Nodedef update_config(state: AgentState):    return {"config": {"llm": {"model": "gpt-4", "temperature": 0.7}}}def update_more_config(state: AgentState):    # 应该深度合并,而不是覆盖    return {"config": {"llm": {"max_tokens": 1000}, "timeout": 30}}# 构建图graph = StateGraph(AgentState)graph.add_node("update_config", update_config)graph.add_node("update_more_config", update_more_config)graph.add_edge(START, "update_config")graph.add_edge("update_config", "update_more_config")graph.add_edge("update_more_config", END)# 运行checkpointer = MemorySaver()app = graph.compile(checkpointer=checkpointer)config = {"configurable": {"thread_id": "user-123"}}result = app.invoke({"messages": [], "config": {}}, config)# 验证:config 应该深度合并print(result["config"])# 预期: {"llm": {"model": "gpt-4", "temperature": 0.7, "max_tokens": 1000}, "timeout": 30}assert"model"in result["config"]["llm"]  # 保留了 modelassert"max_tokens"in result["config"]["llm"]  # 添加了 max_tokensassert result["config"]["timeout"] == 30# 添加了 timeout

如果结果不符合预期,先看哪里

  • 检查 Reducer 是否递归处理嵌套字典
  • 检查是否使用了 existing.copy() 避免修改原对象
  • 检查 Annotated 的参数顺序是否正确

07 调试 Reducer:快速定位问题

def debug_reducer(reducer, existing, new):    """调试 Reducer"""    print(f"Input: existing={existing}, new={new}")      try:        result = reducer(existing, new)        print(f"Output: {result}")        print(f"Type preserved: {type(existing) == type(result)}")        return result    except Exception as e:        print(f"ERROR: {e}")        return None

常见问题排查:

问题现象排查步骤
类型丢失恢复后类型变了检查 Reducer 是否返回正确类型
数据丢失字段被覆盖检查是否用了覆盖而不是合并
并发错误数据不一致检查 Reducer 是否线程安全
内存泄漏内存持续增长检查是否有缓存未清理

08 什么时候该用,什么时候别急着上

更适合自定义 Reducer:

  • 嵌套字典需要深度合并
  • 需要去重(tags, categories)
  • 需要版本控制(配置更新)
  • 需要条件更新(只更新存在的字段)

不需要自定义 Reducer:

  • 简单覆盖(counters, flags)
  • 使用 add_messages(聊天消息)
  • 开发环境(用默认覆盖)

3 问判断法

  1. 你的字段是否需要合并(而不是覆盖)?
  2. 合并时是否需要去重或深度合并?
  3. 是否有并发写入的场景?

如果 3 个问题大多是否定,先用默认覆盖。

09 给读者一个真正能用来做决策的结论

决策帮助

  • 如果你是个人项目:用 add_messages 或 unique_merge,够用就行
  • 如果你是小团队 PoC:用 deep_merge 或 versioned_merge,处理复杂场景
  • 如果你是生产系统:必须做并发安全测试 + 幂等性测试

Reducer 设计的核心原则:

  1. 纯函数:无副作用,相同输入相同输出
  2. 线程安全:支持并发调用
  3. 类型一致:输入输出类型相同
  4. 幂等性:多次调用结果相同

学AI大模型的正确顺序,千万不要搞错了

🤔2026年AI风口已来!各行各业的AI渗透肉眼可见,超多公司要么转型做AI相关产品,要么高薪挖AI技术人才,机遇直接摆在眼前!

有往AI方向发展,或者本身有后端编程基础的朋友,直接冲AI大模型应用开发转岗超合适!

就算暂时不打算转岗,了解大模型、RAG、Prompt、Agent这些热门概念,能上手做简单项目,也绝对是求职加分王🔋

在这里插入图片描述

📝给大家整理了超全最新的AI大模型应用开发学习清单和资料,手把手帮你快速入门!👇👇

学习路线:

✅大模型基础认知—大模型核心原理、发展历程、主流模型(GPT、文心一言等)特点解析
✅核心技术模块—RAG检索增强生成、Prompt工程实战、Agent智能体开发逻辑
✅开发基础能力—Python进阶、API接口调用、大模型开发框架(LangChain等)实操
✅应用场景开发—智能问答系统、企业知识库、AIGC内容生成工具、行业定制化大模型应用
✅项目落地流程—需求拆解、技术选型、模型调优、测试上线、运维迭代
✅面试求职冲刺—岗位JD解析、简历AI项目包装、高频面试题汇总、模拟面经

以上6大模块,看似清晰好上手,实则每个部分都有扎实的核心内容需要吃透!

我把大模型的学习全流程已经整理📚好了!抓住AI时代风口,轻松解锁职业新可能,希望大家都能把握机遇,实现薪资/职业跃迁~

这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】

在这里插入图片描述

深度解析 Reducer——自定义归约器与 State 进阶玩法——从零开始学 LangGraph(五) 前两期我们一直在用 Reducer,但都是现成的——和。它们好用,但不是万能的。想往列表里加元素,但不是简单的 append,而是去重后追加想更新字典里的某个 key,而不是覆盖整个字典某个节点想直接覆盖一个带 Reducer 的字段,而不是经过 Reducer 处理多个 Redis 查询结果需要合并成一个大字典这些场景都需要自定义 Reducer。手写 Reducer。全部不需要 API Key。来看一个实际需求:你有一个标签系统,每个节点可能给文章打标签。标签不能重复。用。 阅读详情

相关推荐

LangGraph状态管理:从核心原理到实战避坑指南

在构建复杂AI应用时,状态管理是确保智能体具备记忆和上下文感知能力的关键技术。其核心原理在于通过中心化的状态容器,统一管理工作流中的数据流与执行上下文,从而解决传统链式调用在并发、多轮交互中的状态丢失问题。这一设计为开发稳定、可扩展的智能体系统提供了工程基础,广泛应用于对话系统、自动化工作流等需要维护长期记忆的场景。本文以LangGraph框架为例,深入剖析其状态管理的设计哲学,特别是通过State Schema定义数据结构,并利用Reducer机制处理并发更新,例如专为消息列表设计的add_message

weixin_30301449的博客 738

LangGraph并行节点数据丢失?详解Reducer机制与选型指南

在构建复杂的AI工作流或数据处理管道时,并行执行是提升效率的关键技术。其核心原理在于将任务拆分为多个可同时执行的子任务,但随之而来的挑战是如何协调各子任务对共享状态的修改,避免数据竞争和不一致。Reducer(归约器)正是解决这一问题的核心技术组件,它定义了多个并行节点输出结果的合并规则,直接决定了数据是协同构建还是相互覆盖。从技术价值看,正确的Reducer选型能保障数据一致性、提升系统可靠性,是构建健壮并行系统的基石。其应用场景广泛,包括智能客服路由中的意图分类、多源数据聚合、日志收集以及分布式计算中的

weixin_30271335的博客 438

LangGraph实战指南:State、Node与Edge的生产级应用

LangGraph是一种面向真实业务场景的AI Agent流程编排框架,其核心在于以状态(State)为驱动、节点(Node)为执行单元、边(Edge)为条件路由,构建可追溯、可调试、可扩展的图结构工作流。区别于线性Chain,LangGraph天然支持循环、分支、中断与状态累积,特别适用于客服分派、合规审计、跨系统协作等复杂决策场景。本文聚焦State类型化设计(如Annotated+Reducer)、Node增量更新范式、Conditional Edge动态路由机制,以及SQLite/PostgreSQ

weixin_33847182的博客 408

LangGraph State 深度解析

LangGraph 支持多种 State 定义方式。dataclassTypedDict类型提示清晰运行开销低与 Python typing 生态兼容LangGraph 的 State 设计是整个系统的核心。1 State 是共享数据结构2 Node 返回 partial updates3 Reducer 定义 merge 规则4 Runtime 负责 state 合并State↓↓↓↓Next node而不是简单的 LLM pipeline。# 定义状态类型。

无风听海 675

LangGraph实战:从状态管理到条件路由,构建复杂Agent流程

大语言模型应用开发中,Agent常需处理多步推理、工具调用与动态分支,传统线性Chain难以优雅编排复杂流程。LangGraph 引入基于状态的有向图执行引擎,将State视作节点间共享的“黑板”,通过Node封装单步操作、Edge控制流转、Conditional Edge实现分支与循环,并利用子图和并行分支应对高复杂度业务场景。本文以可运行的实战示例,讲解如何定义状态、组装节点、应用条件边完成灵活路由,并重点解析在节点函数中正确更新State的姿势,帮助开发者降低多工具、多步骤Agent的工程复杂度,高效

weixin_34194087的博客 384

SMIC Memory配置与Library Compiler实战:从lib到db的高效转换

本文详细介绍了SMIC Memory Compiler的配置要点与使用Library Compiler将.lib文件高效转换为.db文件的完整流程。文章深入解析了关键配置参数对性能和面积的影响,并提供了从交互式操作到自动化脚本的实战指南,帮助数字芯片设计工程师顺利完成存储器模型的生成与集成,确保Design Compiler能正确调用。

weixin_28314575的博客 336

LangGraph State 深度解析:TypedDict / Annotated / Reducer 全梳理

本文深入解析LangGraph Agent中的核心概念State,包括其作用、语法实现和常见问题。State作为多节点间的共享上下文容器,存储用户输入、工具调用结果等数据,通过reducer机制实现增量更新。文章详细拆解了TypedDict定义数据结构、Annotated绑定reducer、operator.add进行列表合并等关键技术点,并提供了可运行示例代码。最后总结了State的核心知识点和常见踩坑点,强调理解State的合并机制是掌握LangGraph的关键。全文聚焦实战,帮助开发者避免常见错误,正

weixin_54574094的博客 298

总结-NuerIPS2023-Direct Preference Optimization:Your Language Model is Secretly a Reward Model

对比PPO,DPO的泛化能力更强。

m0_60361484的博客 1609

深入浅出 LangGraph —— 第4章:状态管理深入:如何设计State

深入探讨LangGraph状态设计的核心原则与进阶技巧,包括Reducer的高级用法、私有状态与输入输出状态分离、状态持久化策略、复杂嵌套状态设计,以及如何根据业务场景选择合适的状态结构,构建可维护的Agent应用。本章包含完整的实战案例和最佳实践指南。

FrontAI的博客 825

Wio-LR1121多频段LoRa模块技术解析与应用实践

LoRa技术作为低功耗广域物联网(LPWAN)的核心通信方案,通过独特的扩频调制技术实现远距离传输与强抗干扰能力。其工作原理基于CSS(Chirp Spread Spectrum)调制,支持动态调整扩频因子(SF)和带宽(BW)来平衡传输距离与数据速率。Wio-LR1121模块作为Semtech LR1121芯片的载体,创新性地整合了sub-GHz、S-Band和2.4GHz多频段支持,配合仅1.35μA的睡眠电流,为跨境物联网部署提供了硬件基础。在智慧农业、工业监测等场景中,开发者可通过SPI接口快速集成

weixin_33742618的博客 417

计算机网络基础:揭开网络世界的神秘面纱

计算机网络基础:揭开网络世界的神秘面纱,计算机网络已深度融入现代生活,这篇文章对其基础内容展开全面阐述。开篇介绍计算机网络的定义,说明其由计算机设备、网络设备和传输介质构成。接着从地域范围和拓扑结构两个维度对计算机网络进行分类,并详细讲解 OSI 和 TCP/IP 参考模型,明晰各层功能与联系。随后阐述网络通信协议的定义及常见协议,如 TCP/IP、HTTP 等。最后聚焦网络安全,涵盖定义、重要性以及防火墙、加密技术等常用安全技术。文章旨在帮助读者构建计算机网络基础知识体系,理解其在生活和工作中的应用与价值

不踩坑,不知道坑有多深;不总结,踩过的坑白踩。 6万+

LangGraph并行节点数据丢失:Reducer机制详解与实战避坑

在构建复杂工作流时,状态管理是核心挑战之一,尤其在并发场景下,多个节点同时更新共享状态可能导致数据竞争与丢失。其原理在于系统需要一套明确的规则来协调并行更新,这就是Reducer机制。理解并正确配置Reducer对于确保数据一致性、提升系统可靠性具有重要技术价值,广泛应用于多轮对话、文档分析、并行工具调用等场景。本文聚焦LangGraph中的三种核心Reducer——last_writer_wins、append和merge,深入解析其语义差异与适用场景,帮助开发者精准控制数据流向,有效解决因并发更新导致的

weixin_30315723的博客 376

广东省低应变题库

11.按《建筑地基基础检测规范》DBJ/T15-60-2019的规定,采用低应变法对混凝土预制桩进行检测时,地基基础设计等级为甲级的桩基工程抽检桩数不应少于总桩数的30%,其余桩基工程抽检桩数不应少于总桩数的20%,且不得少于10根;16.按《建筑地基基础检测规范》DBJ/T15-60-2019的规定,当对某桩的桩身完整性判定为III类时,可认为该桩不满足验收条件,不用进一步确定该桩桩身缺陷对桩身结构承载力的影响程度。2.地基基础检测所用计量器具均应在检定(校准、验证)的有效期内,性能符合相关技术要求。

ZShy001238的博客 322

LangGraph-State架构深度解构

在构建复杂 Agent 时,90% 的工程师倒在了状态管理的混乱上。本文摒弃基础教程,直击 LangGraph 核心命门——State 机制。深入剖析 Schema 选型博弈(TypedDict vs Pydantic)、Reducer 在并行计算中的合并逻辑、Input/Output Schema 的内外解耦,以及 Private State 与 Checkpoint 的持久化差异。用结构化思维重构 Agent 大脑,从"调包侠"进阶为能驾驭复杂工作流的架构师。

FrankVans的博客 578

多跳问答技术解析:从原理到金融领域实践

多跳问答(Multi-hop QA)是自然语言处理中的高级任务,要求系统通过多步推理整合分散信息来回答问题。其核心技术在于理解文档间的复杂关联,相比单跳问答需要更精细的数据集设计和模型架构。在金融、医疗等专业领域,多跳问答能有效处理如'腾讯大股东投资的港股上市公司'这类需要串联多个信息点的问题。典型实现方案包括MR-Search框架的三级检索器设计,分别处理实体召回、关系匹配和数值比较。当前最佳实践表明,结合稠密检索与稀疏检索的混合策略,配合动态路由机制,能在保持较高精度的同时控制计算成本。这类技术在金融风

weixin_42566072的博客 607

手把手教你学基带SOC芯片(4.4.9)--基带芯片的电源管理实例:高通 Snapdragon 系列实例(十)

Snapdragon 888 通过支持多种深度睡眠模式,如 AOAC 模式、低功耗模式和深度睡眠模式,以及智能电源管理技术,实现了对功耗的精细管理。这些模式不仅延长了设备的电池寿命,还确保了用户在各种使用场景下的良好体验。无论是保持网络连接、限制后台活动,还是完全关闭不必要的功能,Snapdragon 888 都能够灵活应对,提供高效的功耗管理方案。

MHD0815的博客 741

【收藏】LangGraph State完全指南:从原理到实践,打造高效大模型应用

LangGraph是一个状态图框架,State作为其核心组件贯穿整个生命周期。State是共享数据结构,由模式和reducer函数组成,用于存储和传递任务执行过程中的关键信息。State采用增量更新机制,自动保存支持工作流的暂停、恢复和回滚。在图的执行流程中,每个节点接收前一个节点的状态作为输入,处理后传递给下一个节点,确保多节点协作时信息的一致性和连续性。理解State机制对于构建稳定高效的大模型应用至关重要。

2401_85325557的博客 1022

保边滤波之Mean shift filter

保边滤波之Mean shift filter 目录 保边滤波之Mean shift filter 一、算法原理 二、练手实现的算法代码如下: 三、实现结果 一、算法原理 在OpenCV中,meanshift filter函数为 p...

大熊 1562

# LangGraph Send机制深度解析:Map-Reduce动态并行与reducer并发合并实战

你的 LangGraph 图需要同时处理 10 篇文档摘要——普通条件边只能走一个分支,你不得不串行调用 10 次模型。Send 机制解决这个问题:它根据运行时数据动态创建并行任务,每个任务接收不同的 State,最后通过 reducer 合并结果。本文从 Send 的基本结构出发,完整拆解 Map-Reduce 数据流、OverallState vs WorkerState 分离设计、reducer 并发冲突解决,以及动态并行中的排序陷阱。

l125865的博客 239

精雕软件(JDpaint) 5.5 绿色版

精雕软件(JDpaint) 5.5 绿色版精雕软件(JDpaint) 5.5 绿色版精雕软件(JDpaint) 5.5 绿色版

VB摄像头监控

该VB模块可对摄像头捕获的画面进行录像等,可在创建的窗口进行控制

LangGraph State 深度解析:从概念到实战的完整指南

在 LangGraph 中,State是一个贯穿整个图(Graph)执行生命周期的、可变的共享数据容器。它定义了工作流中每个节点(Node)可以读取和写入的数据结构。你可以将其想象成一个在多个函数(节点)间传递的“共享笔记本”,每个函数都可以在上面查阅信息、记录结果或修改内容。与普通函数调用传参不同,State 是有状态的、持续化的。一次图执行(Run)的完整上下文都保存在 State 中,这使得构建循环、条件分支、记忆回溯等复杂逻辑成为可能。

li263302065的博客 325

efm32 入门.pdf

本PDF共计22页,介绍的是操作驱动API,下载与否自己斟酌。

第2篇-State-Node-Edge-LangGraph三大核心组件深度拆解

LangGraph 系列第 2 篇 · 这三个概念搞懂了,LangGraph 你就掌握了 80%。上一篇文章我们用三个短程序感受了 LangGraph 的线性、分支、循环流程。但你可能已经发现了——所有程序的结构都一样:定义 State,写几个节点函数,用 add_node / add_edge 串起来,compile。这个结构不是巧合。,只要你把这三个概念彻底搞懂,剩下的 Checkpointer、Subgraph、RetryPolicy 都只是锦上添花。

2401_86515434的博客 201

霍尼韦尔SoftMaster使用说明

霍尼韦尔SoftMaster使用说明

LangGraph从入门到实战:构建分支、循环与并行的LLM应用

在基于大模型的应用开发中,流程控制是决定系统复杂度的关键。当业务需要分支、循环与并行时,传统的线性链式调用已难以维护。状态图(State Graph)通过节点、边与全局状态共享,将执行流程抽象为可编排的图结构,从而优雅地解决这类问题。LangGraph正是这一思想的工程实现,它与LangChain生态无缝衔接,既能管理多个模型调用,也能统筹工具执行与Agent的思考-行动循环。本文从LangGraph的核心模型出发,通过可运行代码演示状态定义、条件路由、并行分支、子图嵌套等关键特性,并基于客服工单场景给出一

weixin_30735745的博客 373

LangGraph 状态管理深度解析:Reducer、Annotation、Channel 是什么关系

上一篇我们拆解了 LangGraph 的底层原理,搞清楚它是怎么把 LLM 变成状态机的。今天要啃一块更硬的骨头——状态管理的三个核心概念:Reducer、Annotation、Channel,很多人用了半年还分不清楚它们的关系。

xx_nm98的博客 441

LangGraph状态管理实战:如何用Reducer函数优化AI Agent工作流

本文深入探讨了如何利用LangGraph的Reducer函数优化AI Agent工作流的状态管理。通过对比基础的字典状态与引入TypedDict的类型安全方法,文章详细解析了Reducer的工作原理,并提供了消息列表合并、多Agent投票系统等实战案例,展示了如何通过自定义Reducer实现状态的精细化控制,从而构建更健壮、高效的复杂协作应用。

solidity8miner的博客 668

LangGraph 核心 API 解析:State 与 Node 构建有状态 AI 工作流

在构建复杂 AI 应用时,工作流编排与状态管理是核心挑战。其原理在于通过定义清晰的数据结构和执行单元,来控制信息的流转与任务的协同。这项技术的价值在于能将混乱的“意大利面代码”转化为模块化、可调试、可持久化的自动化流程,极大地提升了智能体(Agent)应用的可靠性与可维护性。其典型应用场景包括多步骤决策、工具调用循环、以及需要记忆上下文的对话任务。本文聚焦于 LangGraph 框架中最基础的 State(状态)与 Node(节点)API,通过剖析状态设计哲学、节点函数契约与条件边控制,并结合“上下文长度超

weixin_30781775的博客 471

从Reducer设计模式看LangGraph的架构哲学

本文深入探讨了LangGraph如何通过Reducer设计模式革新状态管理架构,结合Python的Annotated类型注解实现声明式编程与类型安全。文章详细解析了Reducer模式在并发控制、状态更新及与传统方案对比中的优势,为构建复杂工作流系统提供了实践指导。

p4q5r6s7t的博客 156
上一篇: 一文讲清:什么是大模型、Agent、MCP?25 个 AI 高频概念全解读
下一篇: RAG 和 NotebookLM 都试过后,我才发现数据库知识库真正缺的不是搜索
Python_金钱豹
博客等级 码龄5年 1万+粉丝 2841原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值