AI开发福音来了!大模型智能体生产级部署全攻略,Kubernetes容器化部署教程,让小白也能玩转AI架构

OpenViking上下文数据库Golang集成实践 技术创新文件系统范式:将AI Agent的上下文管理从扁平向量存储提升为结构化文件系统分层检索策略:L0/L1/L2三层加载机制,减少62.1%的Token消耗记忆自迭代:会话提交触发Agent经验沉淀,实现越用越智能工程实践完整Golang实现:提供生产级可用的OpenViking客户端库企业级集成方案:涵盖文档摄入、检索、会话管理等全流程性能优化成果:检索准确率提升24.1%,响应时间减少53.3%可观测性提升可视化检索轨迹:实现检索过程的白盒化,调试效率提升77.1%全面监控指标。 阅读详情

背景

近年来,人工智能技术的发展正从模型为中心转向以应用为中心,智能体(Agent)作为 AI 应用的核心载体,其落地部署需求日益迫切。而随着 AI 应用向生产环境迁移,以 Kubernetes 为核心的云原生基础设施成为很多企业的默认选择,为 Agent 应用提供标准化、可扩展且具备成本效益的运行时环境势在必行。

根据 CNCF 最新发布的年度云原生调查:

Kubernetes 已从容器编排工具,发展为现代基础设施的核心,包括 AI 领域。在容器用户中,82% 已在生产环境使用 Kubernetes,66% 的 AI 采用者用它来扩展推理任务。Kubernetes 不再是小众工具,而是支撑规模、可靠性和 AI 系统的基础层。 —— CNCF Annual Cloud Native Survey The infrastructure of AI’s future

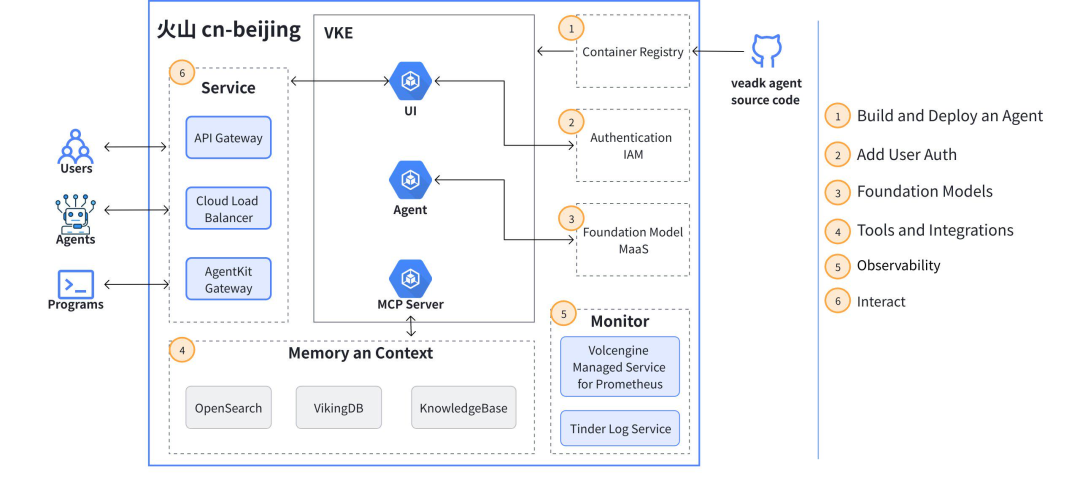
火山引擎的 Agent 开发套件(VeADK/AgentKit)目前已具备将 Agent 应用一键部署至函数服务(veFaaS)的能力。该路径为开发者提供了快速验证和轻量级部署的便利。然而,当 Agent 应用从实验阶段走向生产成熟阶段,其对环境的要求也随之提升。生产级应用通常需要更强的环境控制力、更复杂的依赖管理、更可靠的运行保障以及更精细的成本控制。因此,将 Agent 应用的部署目标从 veFaaS 延伸至火山引擎容器服务(VKE),是满足其生产化需求的一个可选的方向。

VKE 作为一个生产级的 Kubernetes 托管服务,能够提供:

  • 安全可靠的环境:通过 IAM for Service Accounts (IRSA) 等机制实现细粒度的权限管控,避免敏感密钥硬编码。
  • 极致的弹性伸缩:借助水平 Pod 自动扩缩容(HPA),根据负载自动调整资源,实现成本与性能的最佳平衡。
  • 全面的可观测性:无缝集成日志服务、监控告警等系统,提供端到端的应用健康度洞察。
  • 开放的云原生生态:与 API 网关、持续集成与持续部署(CI/CD)等工具链深度整合,加速应用交付与迭代。

本文旨在介绍一套将 VeADK Agent 部署至 VKE 的标准化路径,为 AI 应用提供一个真正意义上的生产级云原生托管方案,实现从开发、部署到运维的全生命周期高效管理。

一、操作流程

  1. 创建 VKE 托管版集群及节点池。
  2. 使用 IRSA 机制,安全地将应用与火山引擎的其他云服务 API 连接。
  3. 使用 Dockerfile 将应用容器化,并将其推送到火山引擎容器镜像服务(CR)。
  4. 编写并应用 Deployment 和 Service 的 Kubernetes 声明式配置。
  5. 使用水平 Pod 自动扩缩容(HPA)配置应用的弹性伸缩。
  6. 使用火山引擎 API 网关将应用发布至公网。
  7. 日志查看与监控观测。

VeADK Agent 容器化部署实践

环境准备

在开始操作前,请完成以下准备工作。

火山引擎账号与访问密钥

你需要一个已完成实名认证的火山引擎账号,并创建访问密钥(Access Key),用于本地与云端资源的身份验证。

  • 注册账号:若无账号,请前往火山引擎官网注册并完成实名认证。
  • 创建访问密钥(AK/SK):

a. 登录火山引擎控制台。

b. 进入访问控制服务。

c. 在左侧导航栏选择用户,找到你的 IAM 用户(或新建用户)。

d. 点击用户名进入详情页,选择密钥管理标签页。

e. 点击新建密钥,生成 Access Key ID(AK)和 Secret Access Key(SK)。

重要提示:AK/SK 代表你的账户权限,请妥善保管,避免泄露导致安全风险。

配置本地开发环境

安装以下命令行工具,用于操作火山引擎 VKE 及 Kubernetes 集群。

  • 安装 kubectl: kubectl 是与 Kubernetes 集群交互的标准命令行工具。请参考 Kubernetes 官方文档进行安装:https://kubernetes.io/docs/tasks/tools/install-kubectl-linux/。
  • 安装并配置火山引擎 CLI: 火山引擎 CLI 工具可以帮助你通过命令行管理云资源。
  1. 安装 CLI: 请参考火山引擎 CLI 官方文档进行安装:https://www.volcengine.com/docs/83927/1184023?lang=zh。
  2. 配置 CLI: 安装完成后,运行配置命令,并输入你之前创建的 AK/SK 和默认地域(例如 cn-beijing)。

volc configure

根据提示依次输入 AK、SK、Region 和 Output 格式。

Access Key ID [****************YQ==]: YOUR_ACCESS_KEY
Secret Access Key [****************NQ==]: YOUR_SECRET_KEY
Region [cn-beijing]: cn-beijing
Output [json]: json

开通所需云服务

请确保在火山引擎控制台已激活以下服务:

  • 容器服务(VKE):用于部署与管理 AI 代理应用。
  • 容器镜像服务(CR):用于存储应用容器镜像。
  • API 网关(APIG):用于将服务公开至公网。
  • 日志服务(TLS):用于收集与分析应用日志。

安装项目依赖

安装 uv 包管理器:

macOS / Linux(官方安装脚本)

curl -LsSf https://astral.sh/uv/install.sh | sh

或使用 Homebrew(macOS)

brew install uv

初始化项目依赖:

如果没有 uv 虚拟环境,可以使用命令先创建一个虚拟环境

uv venv --python 3.12

使用 pyproject.toml 管理依赖

uv sync

激活虚拟环境

source .venv/bin/activate

基础设施准备:创建 VKE 集群与节点

部署的第一步是搭建承载 Agent 应用的 Kubernetes 环境。

创建 VKE 托管版集群

首先,你需要创建一个 VKE 托管版集群作为 AI Agent 部署的基石。选择“托管版”可将 Kubernetes 控制面的管理工作(如扩缩容、升级和运维)交由火山引擎负责,使团队能更专注于业务应用。

  1. 创建集群

在终端中,创建一个名为 vke-veadk 的集群

ve vke CreateCluster --body '{
“KubernetesVersion”: “1.30”,
“Name”: “vke-veadk”,
“DeleteProtectionEnabled”: true,
“ProjectName”: “default”,
“ServicesConfig”: {
“ServiceCidrsv4”: [
“192.168.120.0/22”
]
},
“ClusterConfig”: {
“SubnetIds”: [

    ],  
    "ApiServerPublicAccessEnabled": true,  
    "ApiServerPublicAccessConfig": {  
        "PublicAccessNetworkConfig": {  
            "Bandwidth": 10,  
            "BillingType": 3  
        }  
    },  
    "ResourcePublicAccessDefaultEnabled": false  
},  
"PodsConfig": {  
    "PodNetworkMode": "VpcCniShared",  
    "VpcCniConfig": {  
        "SubnetIds": [  

        ]  
    }  
},  
"KubernetesConfig": {  
    "ControlPlaneConfig": {  
        "KubeApiServerConfig": {  
            "AdmissionPlugins": {  
                "AlwaysPullImages": true  
            }  
        }  
    }  
},  
"MaintenanceWindowConfig": {  
    "Enabled": true,  
    "Duration": 4,  
    "WeeklyCycle": [  
        "Tuesday",  
        "Wednesday"  
    ],  
    "StartTime": "17:00:00Z"  
},  
"MonitoringConfig": {  

    "ComponentConfigs": [  
        {  
            "Name": "KubeApiServer",  
            "Enabled": true  
        },  
        {  
            "Name": "KubeScheduler",  
            "Enabled": true  
        },  
        {  
            "Name": "Etcd",  
            "Enabled": true  
        },  
        {  
            "Name": "ClusterAutoscaler",  
            "Enabled": true  
        }  
    ]  
},  
"LoggingConfig": {  
    "LogProjectId": "de71fc2e-\*\*\*",  
    "LogSetups": [  
        {  
            "LogType": "KubeApiServer",  
            "Enabled": true  
        },  
        {  
            "LogType": "KubeScheduler",  
            "Enabled": true  
        },  
        {  
            "LogType": "KubeControllerManager",  
            "Enabled": false  
        },  
        {  
            "LogType": "Etcd",  
            "Enabled": true  
        },  
        {  
            "LogType": "ClusterAutoscaler",  
            "Enabled": false  
        }  
    ]  
}  

}’

说明:集群创建过程大约需要 5-10 分钟。请耐心等待。

  1. 创建节点池

在集群内创建一个或多个节点池,用于运行 Agent 应用的工作负载。建议根据应用对计算、内存或 GPU 的需求,选择合适的 ECS 实例规格。

Plain Text
ve vke CreateNodePool --body '{

"Name": "agent-nodes",  
"KubernetesConfig": {  
    "Labels": [],  
    "Cordon": false,  
    "AutoSyncDisabled": false  
},  
"NodeConfig": {  
    "InstanceTypeIds": [  
        "ecs.g3il.xlarge",  
        "ecs.g3il.2xlarge",  
        "ecs.g3il.4xlarge"  
    ],  
    "ImageType": "",  
    "ImageId": "image-ybqi99s7yq8rx7mnk44b",  
    "SubnetIds": [  

    ],  
    "SystemVolume": {  
        "Size": 40,  
        "Type": "ESSD\_PL0"  
    },  
    "DataVolumes": [  
        {  
            "Size": 100,  
            "Type": "ESSD\_PL0"  
        }  
    ],  
    "Security": {  
        "SecurityStrategies": [  
            "Hids"  
        ],  
        "Login": {  

        }  
    },  
    "InstanceChargeType": "PostPaid",  
    "Period": 1,  
    "AutoRenew": true,  
    "AutoRenewPeriod": 1,  
    "AdditionalContainerStorageEnabled": true,  
    "HpcClusterIds": [],  
    "ProjectName": "default"  
},  
"AutoScaling": {  
    "DesiredReplicas": 3,  
    "SubnetPolicy": "ZoneBalance"  
},  
"Management": {  
    "Enabled": false  
}  

}’

  1. 生成 kubeconfig 并连接 VKE 集群

Plain Text
ve vke CreateKubeconfig --body '{

"Type": "Public"  

}’

  1. 连接 VKE 集群

集群创建成功后,需要配置 kubectl 以便能够连接并管理它。

步骤1 获取 kubeconfig:

ve vke ListKubeconfigs

–body '{

“Filter”: {

    "Types": ["Public"]  
}  

}’ | jq -r ‘.Result.Items[0].Kubeconfig’

步骤2 在你的本地终端中,粘贴并执行该命令:

示例命令,请以你控制台实际生成的为准

export

KUBECONFIG=~/.kube/config_vke_adk-vke-cluster_****
kubectl config use-context adk-vke-cluster

步骤3 执行完成后,运行以下命令验证是否已成功连接到集群:

kubectl get nodes

如果能看到你创建的节点信息列表,说明连接已成功建立。从现在起,你的 kubectl 命令都将指向这个新的 VKE 集群。

开启安全围栏配置(IRSA)

为了保障云服务访问的安全性,本方案采用 IAM for Service Accounts (IRSA) 机制,避免在应用代码或容器镜像中硬编码或存储静态的访问密钥(AK/SK)。

IRSA 的核心机制是将 Kubernetes 的服务账号(ServiceAccount, KSA)与火山引擎的 IAM 角色进行绑定。当一个 Pod 被配置为使用此 KSA 启动时,VKE 会自动为其注入临时的、具有特定权限的安全凭证。这样,Pod 内的应用程序(即 Agent)便可通过标准 SDK 直接调用其被授权的云服务 API,无需任何手动密钥配置。

开启 IRSA 请参考 VKE 产品文档:https://www.volcengine.com/docs/6460/1324613?lang=zh。

  1. 创建 IAM 角色

在 IAM 控制台,新建 OIDC 身份提供商类型的 IAM 角色,比如:agent_onvke。

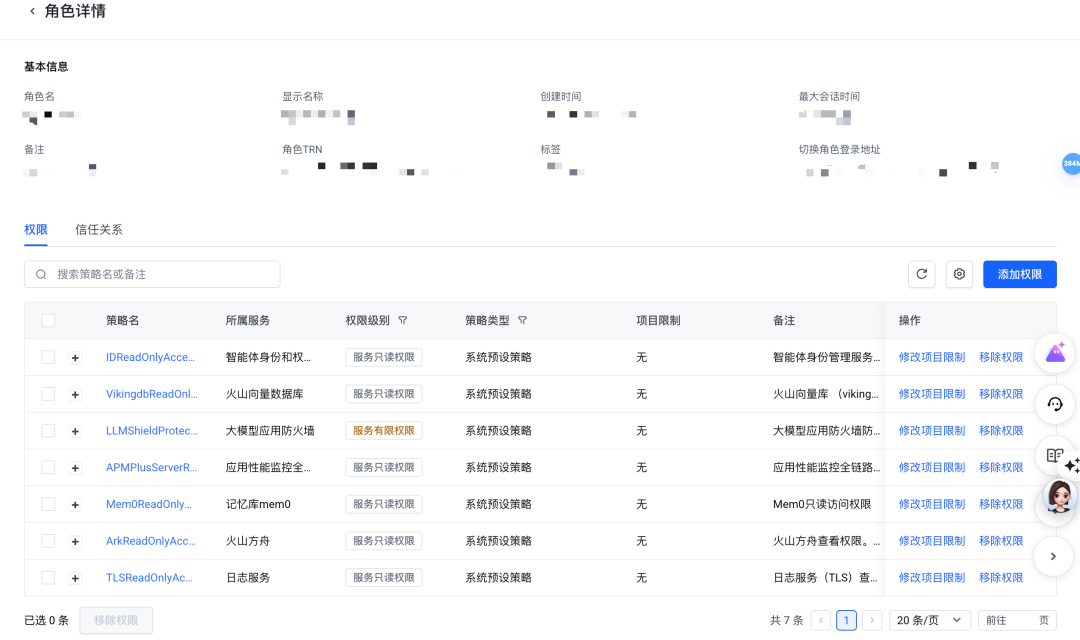
  1. 给角色授予所需要的权限

这里以方舟大模型权限为例:

  1. 授权 VKE 集群内指定命名空间(NameSpace)下的服务账号(Service Account)

如 veadk-agent-sa,允许扮演上述创建的 IAM 角色。代码示例如下:

学AI大模型的正确顺序,千万不要搞错了

🤔2026年AI风口已来!各行各业的AI渗透肉眼可见,超多公司要么转型做AI相关产品,要么高薪挖AI技术人才,机遇直接摆在眼前!

有往AI方向发展,或者本身有后端编程基础的朋友,直接冲AI大模型应用开发转岗超合适!

就算暂时不打算转岗,了解大模型、RAG、Prompt、Agent这些热门概念,能上手做简单项目,也绝对是求职加分王🔋

在这里插入图片描述

📝给大家整理了超全最新的AI大模型应用开发学习清单和资料,手把手帮你快速入门!👇👇

学习路线:

✅大模型基础认知—大模型核心原理、发展历程、主流模型(GPT、文心一言等)特点解析
✅核心技术模块—RAG检索增强生成、Prompt工程实战、Agent智能体开发逻辑
✅开发基础能力—Python进阶、API接口调用、大模型开发框架(LangChain等)实操
✅应用场景开发—智能问答系统、企业知识库、AIGC内容生成工具、行业定制化大模型应用
✅项目落地流程—需求拆解、技术选型、模型调优、测试上线、运维迭代
✅面试求职冲刺—岗位JD解析、简历AI项目包装、高频面试题汇总、模拟面经

以上6大模块,看似清晰好上手,实则每个部分都有扎实的核心内容需要吃透!

我把大模型的学习全流程已经整理📚好了!抓住AI时代风口,轻松解锁职业新可能,希望大家都能把握机遇,实现薪资/职业跃迁~

这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】

在这里插入图片描述

用AI学习graphify Graphify是一个AI驱动的知识图谱构建工具,能够将代码、文档、论文、图像和视频等多模态数据转换为结构化知识图谱。其核心技术特点包括: 多模态处理能力: 支持25+编程语言的AST解析 处理PDF、Markdown等文档 集成Whisper进行音视频转录 高效知识提取: 采用确定性AST解析与LLM语义提取结合 相比直接读取源文件,查询token消耗最多减少71.5倍 增量更新机制仅处理变更文件 智能分析功能: 自动识别高中心性的"上帝节点" 发现跨领域的"意外连接&quo 阅读详情

相关推荐

到底什么是Harness工程?一篇文章从入门到企业落地全解析

随着OpenClaw爆火,Harness Engineering(驾驭工程)成为AI编程时代的热门概念,很多小白对其感到陌生。本文用通俗类比和真实案例,避开复杂术语,从基础定义入手,讲清Harness Engineering的核心逻辑——人类工程师设计“约束系统”(马具),让AI模型(烈马)安全高效地完成代码工作,同时拆解其核心组件、企业落地场景和实战成果,帮小白快速入门,读懂这项能解放人力、提升效率的新技术,轻松掌握它的核心价值和落地思路。

program哲学 3270

基于RAG的企业智能客服项目,已拿70万offer!

基于 RAG 构建一套企业智能客服系统📖。

m0_59164520的博客 1445

手把手教你用Cadence仿真12bit SAR ADC:从电路图到FFT频谱分析(含Simc 18mmrf工艺文件)

本文详细介绍了使用Cadence仿真12bit SAR ADC的全流程,包括电路搭建、仿真环境配置、瞬态仿真优化及FFT频谱分析。基于Simc 18mmrf工艺文件,提供从电路图到性能验证的实战指南,特别分享工程实践中的排错技巧和优化策略,帮助工程师高效完成ADC设计验证。

weixin_30832405的博客 405

从Vibe Coding到可控生产力:Harness Engineering的实践启示

摘要:OpenAI提出的Harness Engineering(工程化治理)理念为AI Agent时代的软件工程提供了关键方法论,旨在解决代码高产出下的质量闭环、上下文管理等核心矛盾。其三大目标包括重构工程师角色、将AI纳入可控体系、实现低成本纠错,通过六大举措(如角色重构、机械化约束、反熵机制等)重构工程流程。该理念与vibe coding高度互补,既保留灵感驱动的敏捷性,又通过工程化体系保障稳定性,最终推动工程师从"代码生产者"升级为"工程体系设计者"。

小程故事多的博客 4400

OpenClaw + Ollama 本地大模型部署教程:彻底告别Token焦虑

OpenClaw + Ollama 本地大模型部署教程:彻底告别Token焦虑

leaning_java的博客 1228

块坐标下降法实战:如何用Python一步步优化无人机通信网络?

本文通过Python实战案例,详细介绍了块坐标下降法在优化无人机通信网络中的应用。文章以最大化网络吞吐量为目标,将复杂的非凸问题拆解为功率分配和轨迹规划两个子问题,并提供了完整的算法实现、代码示例及调参指南,为机器学习工程师解决类似优化问题提供了实用参考。

sat99的博客 975

大模型工程化:从Prompt到Harness,驾驭AI生产力新时代

大模型工程化三大范式:提示词工程、上下文工程与驾驭工程 摘要:随着大模型技术的成熟,行业焦点转向如何实现能力稳定落地。文章系统阐述大模型工程化的三大范式:提示词工程(Prompt Engineering)作为基础,通过标准化指令引导模型输出;上下文工程(Context Engineering)通过信息注入解决知识边界与幻觉问题;驾驭工程(Harness Engineering)构建全链路管控体系。三者呈递进互补关系,共同支撑生产级应用。当前趋势呈现三大特点:自动化Prompt优化、多模态场景融合、体系化管控

m0_63171455的博客 1852

一起玩儿物联网人工智能小车(ESP32)——48. 利用循迹模块实现循迹小车(三)

摘要:本文介绍循迹小车的接线方法及类的基础知识

一起玩儿科技 1135

graphify构建代码知识库,一行代码搭建属于自己的知识图谱

graphify 是一个将任意文件夹(代码、文档、图片、视频等)转化为可查询知识图谱的工具。它的核心理念是:与其让 AI 逐文件读取,不如先把所有内容构建成一张图,让 AI 按图索骥。 你可以把它理解为一个"代码库地图生成器"。输入一个项目目录,它会分析所有文件,提取概念、关系、调用链,然后用可视化的方式呈现给你。更重要的是,这张图是可以查询的——你可以问"认证模块和数据库之间有什么关系",而不需要自己去 grep 几十个文件。

努力前行,总会成为自己心中的那道光 8539

STM32 HAL 硬件IIC驱动BNO085:从移植到姿态解算全流程解析(附源码)

本文详细解析了STM32 HAL库下硬件IIC驱动BNO085 IMU传感器的全流程,包括CubeMX配置、驱动移植、传感器初始化、Q格式数据处理及四元数转欧拉角解算。提供了完整的源码实现和常见问题解决方案,帮助开发者快速掌握高精度姿态测量技术。

palm99的专栏 1047

LED单元板驱动(HUB75接口)

开始之前先吐槽一下,搜这个的资料。要么都是Arduino,要么单片机的收费。小小的一个LED单元板,凭什么? 用Arduino是你速度快还是我ST,树莓派不好用?收费更离谱,这点东西还藏私?给你个中指凸。把原理都写出来看你怎么收费。 一、接口定义及原理 如图,有两个RGB通道,共占用6个IO。剩下的ABCDE为地址通道,LAT为行数据锁存通道,CLK为数据时钟,OE为低电平使能LED显示。图片这里没有E,证明它是16扫的,有E就会把B上面的地改为E。这样就是5位,2的5次方32扫。1.

a3748622的博客 3万+

GitNexus 核心引擎深度解析

GitNexus 核心引擎深度解析:GitNexus 是一个将代码库转换为可查询知识图谱的系统,由索引流水线、社区检测和混合搜索三大子系统组成。索引流水线通过9个阶段将代码转换为知识图谱,支持多语言解析和并行处理。社区检测采用Leiden算法进行功能聚类,流程追踪则通过BFS算法从入口点生成执行流程。混合搜索结合关键词和语义搜索,使用RRF算法融合结果。系统优化包括Worker池并行解析、语言感知导入解析、调用关系置信度计算等,实现了高效的代码分析与搜索能力。

2841

计算机等级考试(二级WPS)---真题14套

目录 真题14一、选择题二、WPS文字三、WPS表格四、WPS演示21.打开考生文件夹下的素材文档 “WPS.docx”(.docx 为文件扩展名),后续操作均基于此文件,否则不得分。小周正在整理一份关于极光的文档,请按要求帮助她完成文档的排版工作。1.将全文中的手动换行符全部替换为中文句号并回车,删除文中的空行和空格。2.将正文第 2 段(“在我國的古書…… 極光”)中的繁体字转换成简体字,并为其设置 “正文” 样式。3.对文档样式进行如下设置:4.为 “1.3 极光的形态” 一节中列出的五种极光形态特征

2401_82750246的博客 1176

Harness Engineering:2026年最被低估的工程革命

2026年2月,OpenAI的工程师Ryan Lopopolo在官方博客发布了一篇看似平淡的技术文章。文章描述了一个内部实验:一个3人小组,用5个月时间,构建并上线了一个拥有百万行代码的生产级产品。

xx_nm98的博客 1089

3、Tone Mapping色调映射(Advanced High Dynamic Range Imaging )

3、Tone Mapping色调映射(Advanced High Dynamic Range Imaging) 如今,大多数可用的显示设备无法本地显示HDR内容。 入门级显示器的对比度仅为200:1。 尽管高端液晶电视具有更高的对比度,但平均对比度约为10,000:1,但通常每个色彩通道的离散度为8位,很少为10位。 这意味着色调限制为255。在过去的二十年中,研究人员花费了大量时间和精力来压缩HDR图像和视频的范围,以便可以在LDR显示器上更“自然”地看到数据。 图3.1 色调映射和真实场景之间.

ISP行业的忠实粉丝 1866

SAP B1中文培訓教材_SDK

公司内部培训资料,对开发工具 ,DIAPI, UIAPI,Add-ON有详细解说

Harness Engineering(驾驭工程)核心解析

Harness Engineering(国内常译“驾驭工程/管控工程”)是2026年Agent开发领域爆火的新一代工程化范式,是AI工程化从“提示工程→上下文工程”之后的第三次范式跃迁,核心解决Agent在生产环境中长期可靠运行的核心痛点。

weixin_58753619的博客 1401

android 蓝牙通讯demo

android 下蓝牙通讯demo,实现了发现蓝牙,使能蓝牙,通过蓝牙发送消息。

Graphify从入门到精通(非常详细),彻底搞懂下一代AI知识库,看这一篇就够了!

Graphify是一款开源命令行工具,由开发者captainkink07在Andrej Karpathy发文后连夜构建。它能将任意文件夹一键转化为持久化知识图谱,支持19种编程语言,与Claude Code深度集成,实现每次查询减少71.5倍token消耗。上线48小时内获得逾6000个GitHub星标,零遥测、无厂商锁定,数据永不离机。

m0_59164520的博客 7445

IDEA的使用指南

IDEA基于java的使用手册,可以最快速的上手,在使用中不断的丰富自己的使用技巧.

计算机控制技术及应用

《计算机控制技术及应用》通过总结作者的科研成果和吸收国内外的先进理论、方法和技术,以计算机控制系统的网络化、开放化、智能化和集成化发展趋势为主线索,主要介绍计算机控制系统的基本概念和计算机控制系统的典型形式,计算机控制系统的数学描述与基本分析方法,以及数字PID控制器、最少拍控制系统、达林算法、状态变量设计法等设计方法及其各种改进算法。重点突出计算机控制系统输入输出通道接口的设计方法和典型控制系统的设计案例与实现方法等。

驾驭未来:零基础读懂“驾驭工程”(Harness Engineering)

在混乱中建立秩序,在复杂中寻找路径。

举世誉之而不加劝,举世非之而不加沮,定乎内外之分,辩乎荣辱之境,斯已矣。 2520

OpenViking 深度解析:字节跳动为 AI Agent 设计的上下文数据库

OpenViking 是字节跳动火山引擎 Viking 团队于 2026 年 1 月开源的上下文数据库(Context Database),专为 AI Agent 设计。。把 Agent 所需的一切——记忆、资源文档、技能说明——统一抽象为"文件",组织在一个虚拟文件系统中,通过专属协议viking://进行寻址和访问。OpenViking 解决的是真实存在的问题,技术思路也有其创新之处——用文件系统范式统一管理 Agent 上下文,L0/L1/L2 分层加载在 token 效率上确实能做到显著优化。

潇汀 2381

一文分清用法Dify-Plugin与SkillS

很多人会把插件(Plugin)和Skill(技能)混为一谈,二者看似都是为应用拓展能力、实现更多功能,核心定位、适用范围、使用方式却有着明确差异。

legend24and8的博客 1850

dify查询接口响应到默认的图表渲染

之后走两条线,一条线流式响应返回数据分析的回复,另一条线走图表生成线,负责生成合适的图表。由于ECharts图表生成插件,支持生成的图表有柱状图,线形图,饼图,那么我们可以设置一个问题分类,然后对于数据分类的结果再做模型数据的抽取。在工作流中新建接收http请求的节点,用以接收http请求体数据。实现的效果:可以根据请求体自定义生成合适的图表数据。数据输入:来自于http请求体的数据。插件:ECharts图表生成插件。

qq_43781332的博客 812

AI(四): 工具 (GitNexus、CLI-Anything、 OMO: Oh-My-Openagent, OMO: oh-my-codex、 OpenSpec、 Superpowers)

GitNexus 是一款能够将代码库转化为可查询知识图谱的智能工具。它的核心能力可以概括为三点:解析 —— 基于 Tree-sitter 深度解析代码,提取函数、类、变量之间的调用与依赖关系建图 —— 将代码结构存入 KuzuDB 图数据库,构建完整的代码知识图谱适配 —— 通过 MCP 协议与 Claude 等 AI 智能体无缝对接,提供结构化代码上下文。

Men-DD 2853

Harness Engineering深度指南(非常详细),软件工程转型控制系统设计,从入门到精通,收藏这一篇就够了!

George 提到 **Harness engineering** 这种模式已经出现了三次: * 第一次是在 18 世纪 80 年代,詹姆斯·瓦特(James Watt)发明了离心调速器(Centrifugal governor)。 * 第二次是在 Kubernetes 出现。 * 第三次是 OpenAI 提出的 Harness engineering。

m0_59235945的博客 1034

MCP和Skill的区别

MCP与Skill是智能系统的两个关键维度:MCP(多通道平台/处理器)作为底层架构,负责整合多模态交互渠道(如语音、文本)和计算能力;Skill则是基于MCP的具体功能模块(如"查天气""设闹钟")。核心区别在于:MCP关注系统级资源调度与跨渠道协同,为Skill提供运行环境;Skill聚焦单一任务的精准执行,依赖MCP的底层能力。二者的关系如同"舞台与演员",MCP提供基础设施,Skill实现具体功能,共同构建完整的智能交互体系。

m0_53830442的博客 2219

Graphify:开启你的文档分类新时代

Graphify:开启你的文档分类新时代 项目介绍 Graphify 是一个基于Neo4j的无管理扩展项目,专为文档和文本分类而设计。通过利用强大的自然语言处理技术,Graphify能够高效地训练模型,并对未标记的文本进行智能分类。其简洁的RESTful API使得集成到任何系统中变得轻而易举。 项目技术分析 Graphify的核心在于它的自然语言解析模型,该模型采用先进的算法抽取文本的关键信息并...

gitblog_00060的博客 708

让AI真正理解你的代码库:GitNexus搭建代码知识库详解

你是否遇到过这种情况:AI助手帮你写了一段代码,你以为完美贴合项目风格,上线后却发现它根本不知道你们改了某个底层接口?团队协作中最怕的不是代码写错,而是AI在"看不见的盲区"里默默埋雷。

努力前行,总会成为自己心中的那道光 8402
上一篇: 爆肝程序员救星!UltraRAG 3.0:搭积木式构建RAG系统,代码量减少90%,小白也能秒上手!
下一篇: 震惊!大模型竟会被“历史投毒“?CyberArk分层防御技术详解,AI开发者必看!
Python_金钱豹
博客等级 码龄5年 1万+粉丝 2835原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值