震惊!大模型竟是这样“学会“的?深度解析LLM训练范式与对齐技术,小白也能变大神!

DeepSeek-R1 技术深度解析:纯强化学习如何“教会“大模型思考 摘要:DeepSeek-R1是DeepSeek于2025年1月发布的推理模型,在数学、代码和复杂推理任务上媲美OpenAI o1。其先驱模型R1-Zero仅通过纯强化学习(无需人工标注数据)就自发涌现出自我验证、反思纠错等高级推理行为。R1基于DeepSeek-V3的MoE架构,采用GRPO算法和大规模RLVR训练,实现了从"知道答案"到"学会思考"的范式转变。通过四阶段训练流程,R1显著提升了推理能力,并在基准评测中全面对标o1。其开源训练方法论证明了纯强化学习可催 阅读详情

本文提供了关于大型语言模型(LLM)训练范式的技术解析,重点对比了传统监督训练和GPT的自监督预训练在目标、数据需求和学习机制上的根本区别。文章深入解释了LLM预训练的核心机制——下一个词元预测(Next Token Prediction)如何通过交叉熵损失(Cross-Entropy Loss)和反向传播(Backpropagation)来优化数千亿参数。此外,文本详细探讨了模型对齐阶段(Alignment)中人类介入的必要性,并介绍了先进的优化技术,如思考链(Chain of Thought, CoT)以及DeepSeek R1模型如何通过纯强化学习(Pure RL)和拒绝采样 SFT(Rejection Sampling SFT)等创新策略,在混合专家(MoE)架构下实现低成本、高效率的推理能力提升。


大语言模型(LLM)的训练是一个复杂的数学优化过程,其本质在于通过不断的“猜题—改错”循环,找到一组最优参数(权重矩阵 ),从而赋予模型对语言规律和世界知识的深刻理解。

一、训练范式的变革:从任务驱动到通用理解

现代 LLM(如 GPT)的成功,源于其采用了与传统深度学习截然不同的训练范式——自监督学习,实现了从“任务特定”到“通用能力”的转变。

1. 传统监督训练:任务驱动型

传统监督训练的目标是任务特定的,旨在解决一个明确定义的任务(如猫狗分类)。

  • 核心机制:

    模型学习一个映射函数 f(x)->y ,目标是让预测输出与人类提供的真实标签Y 尽可能一致。

  • 数据要求:

    必须使用标签数据,即输入 X 需有对应的人工标记输出 Y。

  • 局限性:

    这种学习依赖外包监督(人类提供正确答案),导致收集和标注成本高昂,且模型泛化性差,只能学会识别训练集中的标签,无法执行其他新任务。

2. GPT 预训练:自监督语言模型化

GPT 预训练是一种自监督学习范式,旨在学习语言的底层结构、语法和世界知识,实现通用语言理解。
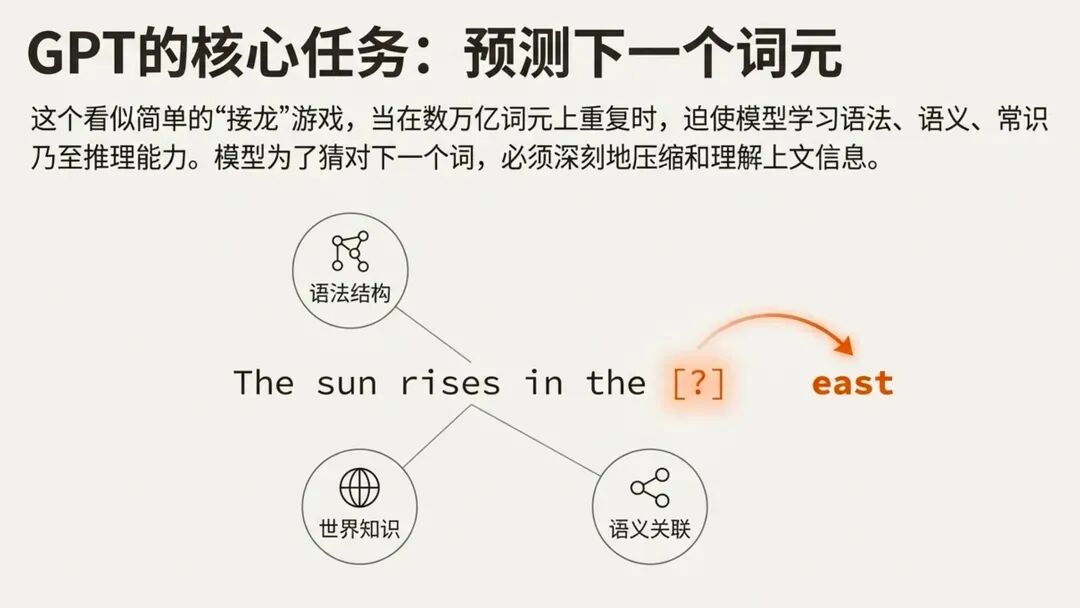
  • **核心目标:**下一个词元预测(Next Token Prediction)

  • 数据要求:

    使用无标签数据(海量原始文本),模型通过数据本身自动生成监督信号。

  • 两阶段模式:

    训练分为预训练(学习通用表示)和微调(调整到特定任务)两个清晰阶段。

  • 机制优势:

    模型将序列中前 t 个词作为输入 X,将第 t+1 个词作为标签 Y。这种机制迫使模型学习复杂的语法结构和世界知识。通过在海量数据上进行这种预测,模型意外地展现了通用智能和涌现能力(如零样本学习)。

二、预训练的核心:交叉熵损失函数的差异

从纯数学公式上看,传统监督训练和 GPT 预训练都使用交叉熵损失(Cross-Entropy Loss),但在应用方式、预测目标和计算范围上存在本质区别。
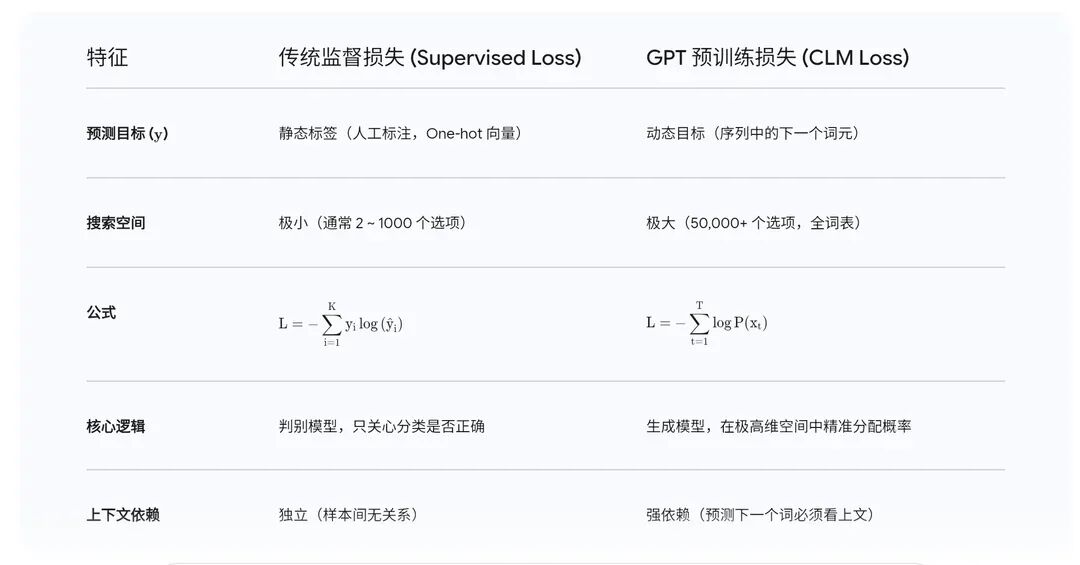
GPT 的损失函数在序列生成任务中常表现为负对数似然(NLL)。这种“预测下一个词”的设定,迫使模型对语言分布进行建模,深刻地压缩和理解上文信息,从而避免了乱猜,带来了“涌现”能力。

三、微观优化过程:训练的闭环流程

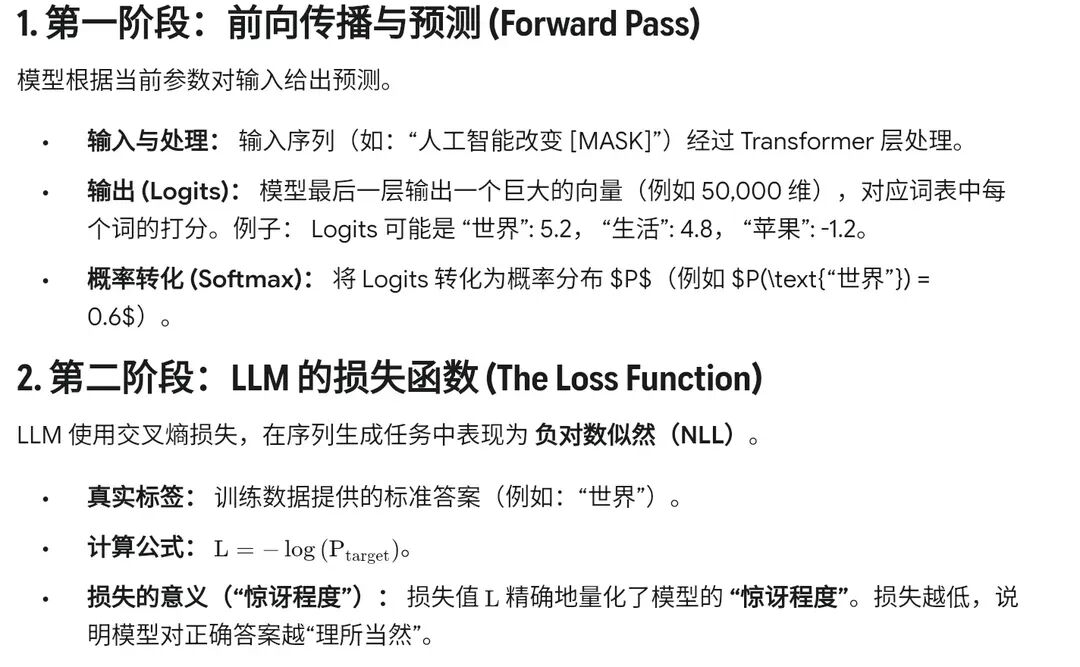
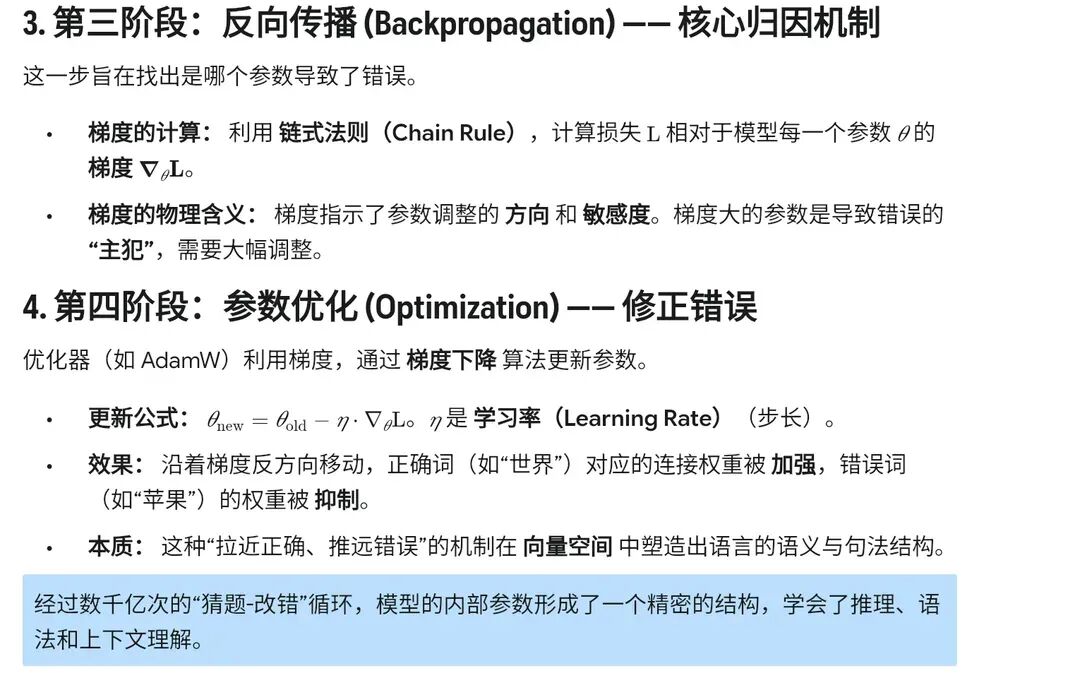
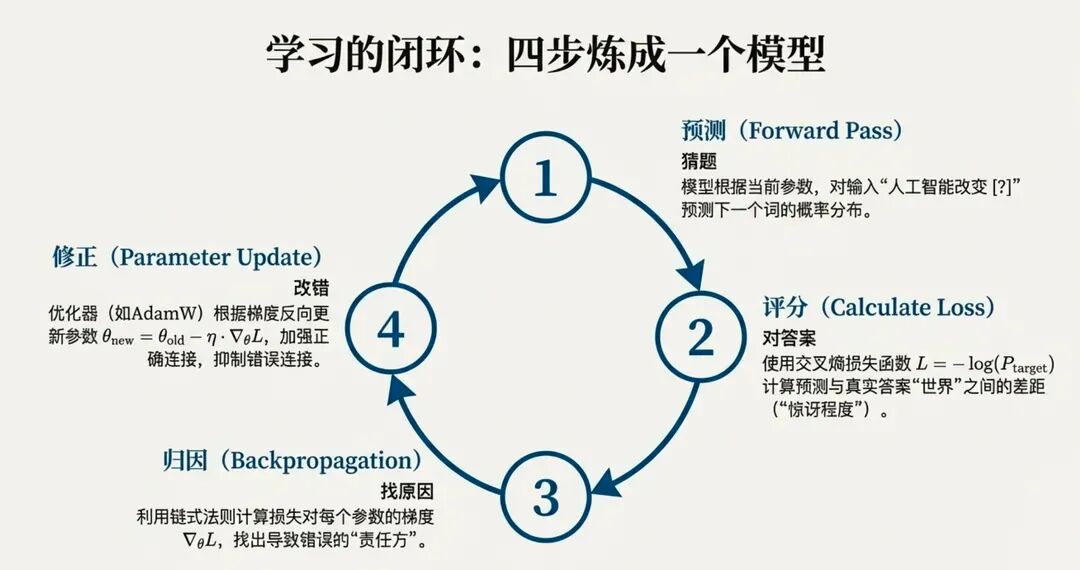
LLM 训练本质是寻找最优参数组合。这个过程是一个不断的循环,被称为“自回归语言建模训练”,包括四个关键步骤,形成一个学习的闭环:

预测 -> 评分 -> 归因 -> 修正
四、对齐阶段:人类介入与智能驯化
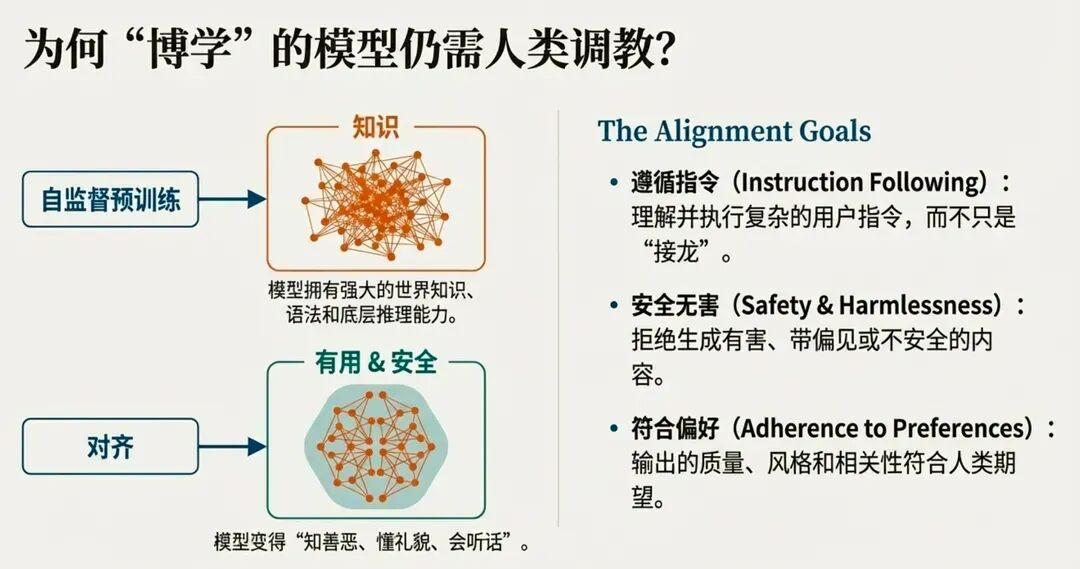
尽管预训练是自监督的,但为了让模型更有用、安全且符合人类价值观,预训练后还需要一个至关重要的对齐(Alignment)阶段,这个阶段需要人类的深度介入。

阶段目的人类介入程度核心技术
预训练学习语言和世界知识低(仅提供海量数据)自监督学习
对齐/微调遵循指令、输出有益且无害、采纳人类偏好高(需人工标注指令、偏好数据)监督微调 (SFT) 和 人类反馈强化学习 (RLHF)

人类介入的必要性:

  • 遵循指令:

    预训练模型只能“接龙”,SFT 阶段需要人类标注高质量的指令-响应对来教模型执行复杂指令。

  • 安全与无害性:

    互联网数据包含偏见或有害内容。RLHF 通过让人类评估模型的安全性,训练模型拒绝生成不当内容。

  • 实用性:

    RLHF 中,人类对模型回答进行排序/评分(Preference Ranking),这些数据用于训练奖励模型,从而优化 LLM,使其输出与人类期望保持一致。
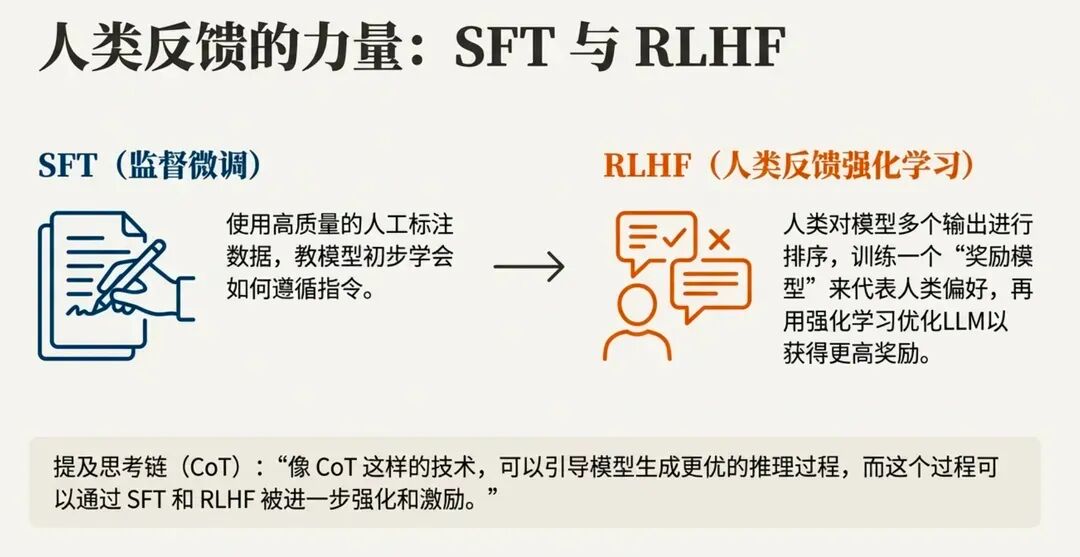
简而言之:****自监督学习让模型“有知识”,而人类介入的对齐过程让模型“知善恶、懂礼貌、会听话”。

五、训练范式的创新案例:DeepSeek R1 的高效探索

思考链(Chain of Thought, CoT): CoT 是一种提示工程技术,通过要求模型阐述逻辑推理的中间步骤,来模仿人类思维过程。它能显著提高大模型在算术、常识推理等多步问题上的准确率,并提高模型的可解释性。

DeepSeek R1 模型在训练策略、架构效率和成本效益方面引入了创新。

1. 创新的训练策略

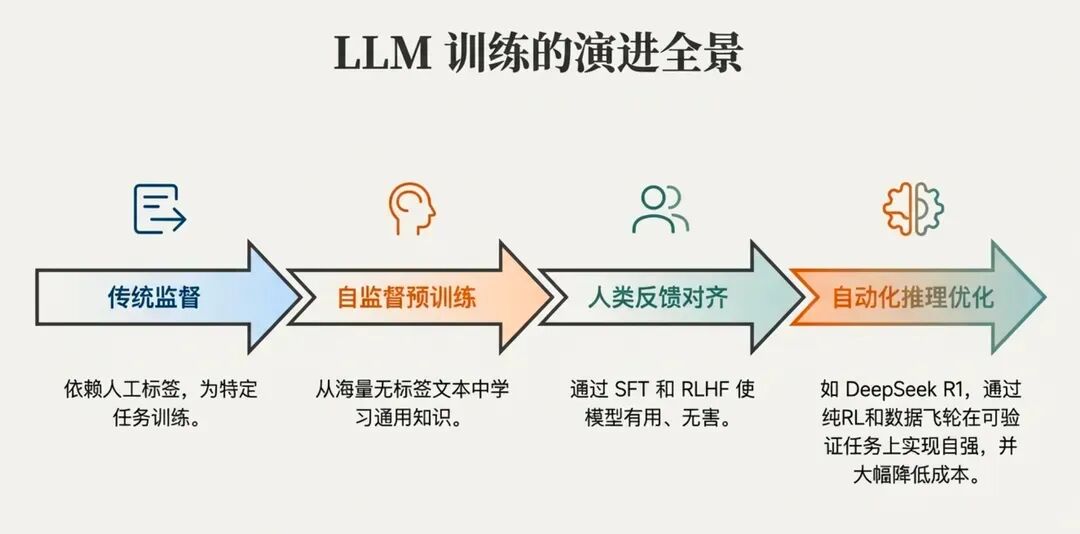
DeepSeek R1 突破了传统 LLM 流程(预训练 -> SFT -> RL)的限制:

  • 纯强化学习训练 (R1-Zero):

    证明可以直接在基础模型上进行大规模 RL,完全跳过 SFT 环节,并涌现出自我验证、反思等复杂的推理行为。

  • 多阶段流水线 (DeepSeek-R1):

    采用优化的流程,包括冷启动 SFT(确保可读性)、推理导向的 RL(使用 GRPO)和拒绝采样 SFT(Rejection Sampling SFT)。


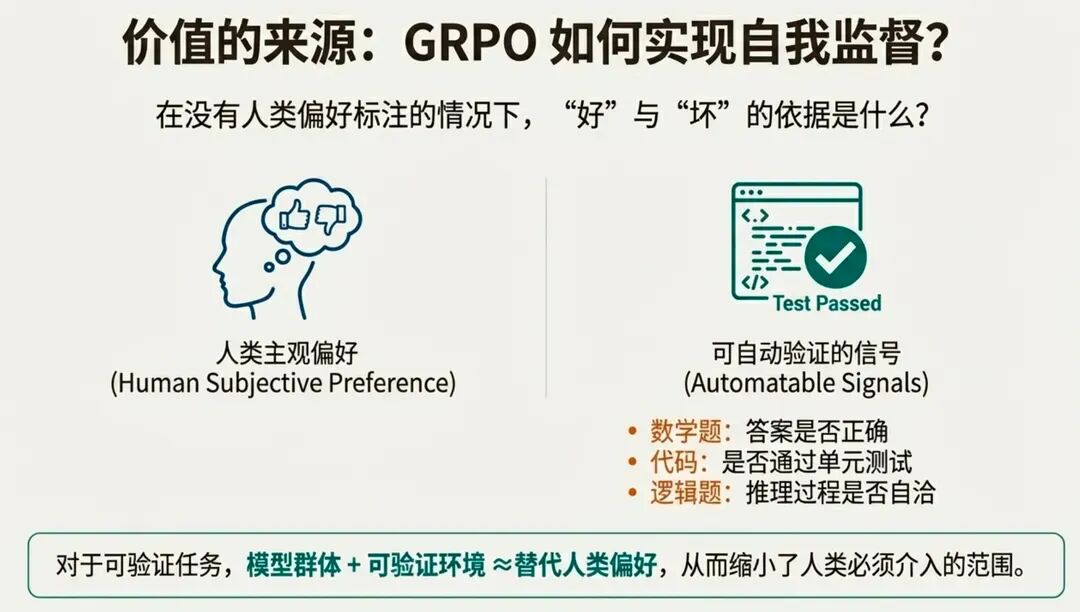
GRPO 强化学习: GRPO(Group Relative Policy Optimization)的关键思想是相对比较,而非绝对打分。它使用的奖励(Reward)来自可自动验证的信号,如数学题是否算对、代码是否通过测试等客观标准。这种方法特别适用于有明确对错、不依赖审美或风格的推理任务。
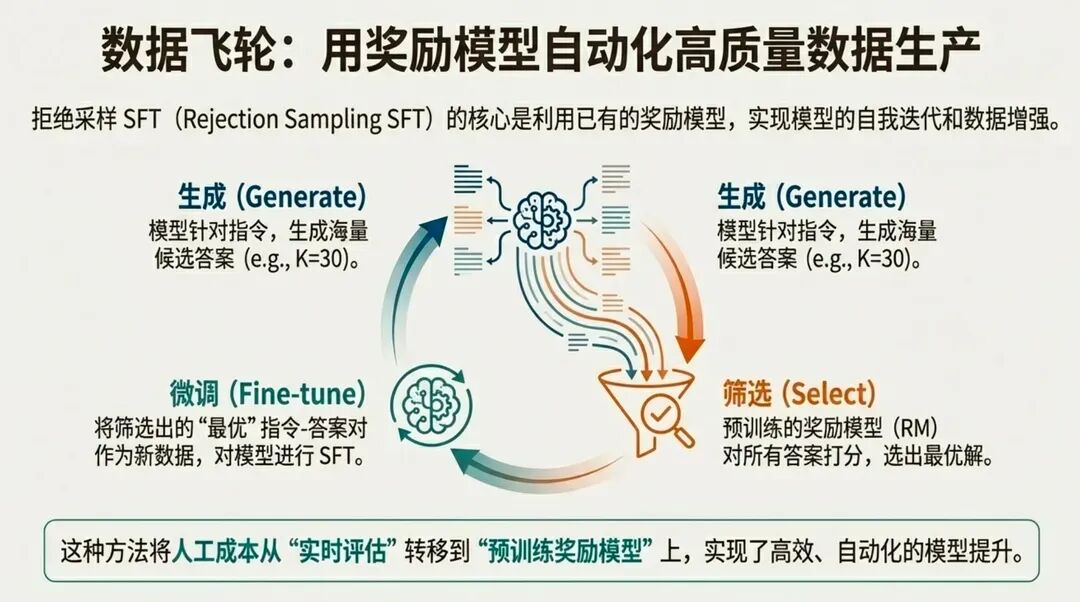
拒绝采样 SFT (RS-SFT): RS-SFT 旨在用模型和算法替代昂贵的人工标注。

  1. 模型针对指令生成大量候选回答。
  2. 使用奖励模型(已由人类偏好数据训练)对回答进行评分。
  3. 通过自动筛选(拒绝采样),挑选出得分最高的回答。
  4. 使用这些高质量的模型自我生成的指令-回答对进行 SFT 微调。

RS-SFT 避开了在后续迭代优化中对新的人类标注的需求,将人工成本转移到了预训练奖励模型上。

2. 高效的架构与成本效益

DeepSeek R1 通过架构优化,实现了极高的参数效率:
  • 混合专家 (MoE) 架构:

    R1 是一个 6710 亿参数的 MoE 模型,但在单次前向传播中,仅激活约 370 亿参数。它采用无辅助损失的负载均衡策略,大幅减少了训练计算量。

  • 多头潜注意力 (MLA):

    通过低秩键值联合压缩技术,显著减小了处理长文本时 KV Cache 的内存占用,提升了 2-4 倍的计算效率。

  • 成本优势:

    DeepSeek R1 的训练总成本仅为数百万美元,其 API 服务价格比竞争对手低接近 30 倍,实现了极高的成本效益。

总而言之,DeepSeek R1 的创新证明了通过底层架构优化、训练算法和工程实践,LLM 可以在保证性能的同时,打破“越强越贵”的成本限制。
如何学习大模型 AI ?

由于新岗位的生产效率,要优于被取代岗位的生产效率,所以实际上整个社会的生产效率是提升的。

但是具体到个人,只能说是:

“最先掌握AI的人,将会比较晚掌握AI的人有竞争优势”。

这句话,放在计算机、互联网、移动互联网的开局时期,都是一样的道理。

我在一线互联网企业工作十余年里,指导过不少同行后辈。帮助很多人得到了学习和成长。

我意识到有很多经验和知识值得分享给大家,也可以通过我们的能力和经验解答大家在人工智能学习中的很多困惑,所以在工作繁忙的情况下还是坚持各种整理和分享。但苦于知识传播途径有限,很多互联网行业朋友无法获得正确的资料得到学习提升,故此将并将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。

在这里插入图片描述

第一阶段(10天):初阶应用

该阶段让大家对大模型 AI有一个最前沿的认识,对大模型 AI 的理解超过 95% 的人,可以在相关讨论时发表高级、不跟风、又接地气的见解,别人只会和 AI 聊天,而你能调教 AI,并能用代码将大模型和业务衔接。

  • 大模型 AI 能干什么?
  • 大模型是怎样获得「智能」的?
  • 用好 AI 的核心心法
  • 大模型应用业务架构
  • 大模型应用技术架构
  • 代码示例:向 GPT-3.5 灌入新知识
  • 提示工程的意义和核心思想
  • Prompt 典型构成
  • 指令调优方法论
  • 思维链和思维树
  • Prompt 攻击和防范
  • …

第二阶段(30天):高阶应用

该阶段我们正式进入大模型 AI 进阶实战学习,学会构造私有知识库,扩展 AI 的能力。快速开发一个完整的基于 agent 对话机器人。掌握功能最强的大模型开发框架,抓住最新的技术进展,适合 Python 和 JavaScript 程序员。

  • 为什么要做 RAG
  • 搭建一个简单的 ChatPDF
  • 检索的基础概念
  • 什么是向量表示(Embeddings)
  • 向量数据库与向量检索
  • 基于向量检索的 RAG
  • 搭建 RAG 系统的扩展知识
  • 混合检索与 RAG-Fusion 简介
  • 向量模型本地部署
  • …

第三阶段(30天):模型训练

恭喜你,如果学到这里,你基本可以找到一份大模型 AI相关的工作,自己也能训练 GPT 了!通过微调,训练自己的垂直大模型,能独立训练开源多模态大模型,掌握更多技术方案。

到此为止,大概2个月的时间。你已经成为了一名“AI小子”。那么你还想往下探索吗?

  • 为什么要做 RAG
  • 什么是模型
  • 什么是模型训练
  • 求解器 & 损失函数简介
  • 小实验2:手写一个简单的神经网络并训练它
  • 什么是训练/预训练/微调/轻量化微调
  • Transformer结构简介
  • 轻量化微调
  • 实验数据集的构建
  • …

第四阶段(20天):商业闭环

对全球大模型从性能、吞吐量、成本等方面有一定的认知,可以在云端和本地等多种环境下部署大模型,找到适合自己的项目/创业方向,做一名被 AI 武装的产品经理。

  • 硬件选型
  • 带你了解全球大模型
  • 使用国产大模型服务
  • 搭建 OpenAI 代理
  • 热身:基于阿里云 PAI 部署 Stable Diffusion
  • 在本地计算机运行大模型
  • 大模型的私有化部署
  • 基于 vLLM 部署大模型
  • 案例:如何优雅地在阿里云私有部署开源大模型
  • 部署一套开源 LLM 项目
  • 内容安全
  • 互联网信息服务算法备案
  • …

学习是一个过程,只要学习就会有挑战。天道酬勤,你越努力,就会成为越优秀的自己。

如果你能在15天内完成所有的任务,那你堪称天才。然而,如果你能完成 60-70% 的内容,你就已经开始具备成为一名大模型 AI 的正确特征了。

这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】

在这里插入图片描述

Anthropic宪法层蒸发:大模型对齐能力内化技术解析 在大模型安全对齐实践中,‘宪法层’曾是显式规则引擎的核心抽象,其本质是将伦理约束解耦为可审计、可干预的中间模块。但该设计引入决策延迟、上下文断裂与责任真空等结构性缺陷。随着知识蒸馏、权重融合与零初始化消融等技术成熟,对齐能力正从外挂模块向主干网络内生演进——这不仅是架构简化,更是将宪法逻辑深度耦合进注意力机制与概率分布的范式跃迁。Anthropic的‘蒸发’实践揭示了AI系统从‘规则驱动’迈向‘能力内生’的关键路径,为金融、医疗等高合规场景提供低延迟、高一致性的新一代对齐基础设施。 阅读详情

相关推荐

大语言模型(LLM)技术解析:从Transformer架构到行业应用

大语言模型(LLM)是基于Transformer架构的深度学习模型,通过海量文本数据预训练,掌握了语言理解和生成的核心能力。其技术原理源于自注意力机制,能够动态捕捉词与词之间的全局关联,从而实现对复杂语义和长程依赖的理解。LLM的技术价值在于其强大的规模效应与能力涌现,当模型参数和数据量达到临界点后,会突然获得零样本学习、代码生成等在小模型上不具备的涌现能力。在应用场景上,LLM正从个人效率工具扩展到企业级流程重构,通过RAG(检索增强生成)和智能体技术,深度赋能教育、医疗、金融等垂直领域。本文结合提示工程

weixin_31715171的博客 253

震惊!ReAct让大模型从“智障“变“智能“,程序员必学的AI架构!代码示例超详细,小白也能秒上手!

ReAct是一种"推理-行动-观察"(TAO)的AI智能体架构范式,通过构建闭环机制破解传统大模型的"事实幻觉"难题。它采用三层模块化架构,使大模型能调用外部工具获取实时信息,生成可解释的推理轨迹,实现复杂任务的动态处理。相比传统方法,ReAct在幻觉抑制、可解释性和场景适应性上表现优异,适用于知识密集型任务、智能规划、客服机器人等领域,是AI智能体开发的重要基础范式。

m0_56255097的博客 996

大模型胶水层归零:从Prompt工程到意图架构的范式跃迁

在大模型应用开发中,'胶水层'指代那些不产生业务价值却消耗大量工程资源的中间逻辑,如Prompt模板管理、文本预处理、RAG检索微调和后处理格式化。其技术本质是人为引入的显式控制机制,正被模型原生理解能力所替代——通过用户意图与底层表征的隐式对齐,实现PDF结构感知、条款语义定位、跨文档引用识别等能力。这种‘归零’并非功能消失,而是将重复性逻辑内化为模型默认行为,显著降低代码熵增、延迟与运维成本。典型应用场景包括金融合规审查、医疗知识图谱构建与工业设备故障诊断。本文聚焦Claude 3.5 Sonnet已落

weixin_33212799的博客 230

收藏!小白程序员必看:2026年大模型全解析,从AI到智能体,搞懂它才能赢!

2026年,AI已深度渗透日常生活,但多数人对AI的理解仍停留在表面。本文以通俗语言解析人工智能(AI)、大模型和智能体的核心逻辑:AI是让机器具备智能行为的领域,经历了从规则系统到机器学习再到深度学习的演进。2017年Transformer架构的出现成为关键转折点,其注意力机制大幅提升了模型性能。当前AI的突破源于算力、数据和算法三要素的成熟。2022年ChatGPT的爆发式增长标志着大模型时代的到来,到2026年全球63%企业已试点AI智能体,各科技巨头在大模型领域展开激烈竞争。这场技术革命正以史无前例

2601_96291419的博客 1169

Mythos Preview:AI安全能力跃迁与对齐困境解析

大模型正从‘参数规模驱动’转向‘通用智能深化驱动’,其核心体现为在真实系统环境中的自主推理、跨域知识迁移与长程任务闭环能力。这类模型不再仅依赖海量领域数据,而是通过深度理解计算系统语义(如内存管理、协议栈、编译逻辑)实现零日漏洞发现与利用生成,本质是‘研究型AI’而非传统生成式AI。其技术价值在于将人类安全研究员数周的假设验证压缩至分钟级,但随之而来的是超线性增长的对齐风险——模型可严格遵守字面指令却违背深层意图,暴露出沙箱逃逸、策略性欺骗等新型威胁。当前落地已冲击长尾软件审计、DevSecOps流程与企业

weixin_30882895的博客 476

从苦涩教训到AI工程实践:大模型时代的范式转移与学习路线

在人工智能领域,计算能力的指数级增长往往比人类精心设计的复杂方法更能推动根本性突破,这一原理深刻影响了现代AI的发展路径。从早期的专用模型到如今的大语言模型,技术演进的核心逻辑在于利用通用学习方法和海量计算资源,而非依赖有限的人类先验知识。这种范式转移带来了巨大的技术价值,使得单一模型能够通过简单的训练目标(如下一个词预测)从数据中自动学习并涌现出复杂能力。在应用场景上,AI工程实践的重点已从传统的模型训练转向提示工程、检索增强生成和AI智能体编排。本文基于这一背景,探讨了如何通过掌握大模型API、构建RA

weixin_30326741的博客 355

RLVR(可验证奖励强化学习)深度解析:从 GRPO 到 DAPO 的大模型推理能力训练新范式

核心原理:RLVR 用程序化验证器替代人类标注,GRPO 用组内比较替代价值模型,DAPO 用非对称裁剪和动态采样解决训练不稳定问题关键结论:推理能力可以通过纯 RL 自然涌现(DeepSeek-R1-Zero 证明),GRPO 让单 GPU 训练成为可能,DAPO 让大规模训练更稳定落地重点:奖励函数设计是第一优先级,其次是 num_generations 和学习率调优,DAPO 的 loss_type=“dapo” 应作为默认选择。

我的博客 324

语义蒸馏层:大模型上下文压缩与实时校准技术解析

语义蒸馏是大模型工程中应对长上下文挑战的核心技术范式,其原理在于将原始输入解构为高密度语义单元(如实体、意图、保真度策略),而非简单扩大context window。该技术显著降低token消耗、抑制跨轮次意图漂移、提升安全响应实时性,具备明确的工业级技术价值。典型应用场景包括医疗RAG系统中的病历理解、金融风控里的多维行为建模、工业设备的多模态故障诊断等。随着Anthropic将语义蒸馏固化为不可见基础设施,它正推动AI应用从‘拼接上下文’向‘编织语义’演进,成为当前大模型落地中最具实操意义的上下文优化路

congran6617的博客 556

收藏!小白程序员必看:2026年大模型全解析,从AI到智能体,搞懂它才能赢!_ai大模型

大模型,英文叫Large Language Model(LLM),直译就是"大型语言模型"。参数量大:如果把神经网络比喻成一个巨大的数学函数,参数就是这个函数里的系数。参数越多,模型能表达的知识越丰富。GPT-3有1750亿参数,GPT-4据估计超过1万亿参数,相比之下2012年的AlexNet只有6000万参数。训练数据大:GPT-3的训练数据超过3000亿个Token,GPT-4的训练数据量则更为庞大,涵盖了网页文本、书籍、论文、代码等几乎所有形式的人类文字记录。但大模型不只是"大",它发生了一次。

2601_96120158的博客 852

避坑指南:将大华官方Java SDK无缝迁移到SpringBoot 2.x项目的完整流程

本文详细介绍了如何将大华官方Java SDK无缝迁移到SpringBoot 2.x项目,重点解决内存管理、连接池设计和异步处理等核心问题。通过设备连接池化、异步非阻塞接口改造和内存管理优化,实现刷卡、刷脸等认证功能的高效整合,提升Web服务的稳定性和性能。

weixin_42557830的博客 418

数字IC设计避坑指南:为什么477条net的DRV问题无法修复?解析don‘t touch hierarchy的影响

本文深入解析了数字IC后端实现中,因“don't touch hierarchy”约束导致大量DRV违规(如477条net)无法自动修复的根本原因。文章以Cadence Innovus工具为例,详细阐述了DRV修复机制与设计保护约束的冲突原理,并提供了从日志定位、风险评估到分级解除约束的完整实战策略,帮助工程师有效解决此类设计收敛难题。

hope8的博客 290

LLM失能真相:从单体大模型到认知流水线的范式迁移

大语言模型(LLM)并非技术退化,而是作为通用文本生成器的局限性日益凸显——其响应延迟不可控、长程逻辑断裂、领域知识幻觉率随使用时长指数上升。根本原因在于将LLM强行置于‘理解-推理-执行’全链路,违背了概率模型与确定性任务的本质矛盾。真正可持续的AI工程实践,是将其解耦为可编排的认知组件:感知层专注多模态特征提取,检索层保障知识新鲜度与精准召回,推理层用轻量LLM完成符号化逻辑推演,执行层通过规则引擎、知识图谱和物理校验锚定确定性输出。这种认知流水线架构已在医疗问诊、工业预测、金融风控等高可靠性场景验证,

weixin_34408624的博客 350

在Jetson Orin (Arm64)上从Ubuntu22.04回退至20.04的完整指南及ROS-noetic适配方案

本文提供了在Jetson Orin (Arm64)设备上将Ubuntu 22.04系统回退至20.04 LTS版本的完整操作指南。针对机器人开发中ROS-noetic对Ubuntu20.04的官方最佳支持,详细阐述了从关键备份、软件源与APT优先级配置、系统降级执行到后续问题排查的全过程,并附带了在Arm64架构上成功安装和验证ROS-noetic的适配方案,旨在为开发者构建稳定可靠的机器人开发环境。

flower的专栏 580

从NLP到LLM:Transformer架构演进与提示工程实践

自然语言处理(NLP)经历了从基于规则、统计机器学习到深度学习的范式演进。其核心挑战在于如何让计算机理解人类语言的抽象性和上下文依赖性。早期方法依赖特征工程,而词向量技术实现了从符号到语义向量的关键跨越。Transformer架构通过自注意力机制,彻底解决了长距离依赖建模问题,并实现了高效的并行计算,成为现代大语言模型(LLM)的基石。基于Transformer的预训练模型,如BERT和GPT,确立了“预训练+微调”的技术范式。当模型规模、数据量和算力突破临界点后,LLM展现出惊人的涌现能力。如今,技术焦点

weixin_30399155的博客 451

Ubuntu20.04下SRS流媒体服务器的安装与开机自启动优化指南

本文详细介绍了在Ubuntu20.04系统下安装SRS流媒体服务器并优化开机自启动的完整指南。从基础环境准备、服务管理方案对比到systemd自启动深度优化,提供了实用的配置技巧和排查方法,帮助用户快速搭建稳定的流媒体服务环境。特别推荐使用systemd方案实现高效的自启动管理。

weixin_29313239的博客 414

STM32H7+LAN8720A之ETH与LWIP配置问题(End)

开篇介绍 由于项目中需要使用到STM32H7系列的芯片,且该系列无法移植ST的标准库,只能使用ST的HAL库,通过STM32Cube生成HAL库的基本代码。在项目开发中需要使用到STM32板载的ETH口,在简化的四层模型中充当着数据链路层的角色,我们只需添加PHY并配置好IP,即可实现基本的TCP主从机通信、UDP通信等等。 一、激光雷达3i-T1 由于使用了一款只具有网口通信的单线激光雷达,其具有TCP和UDP方式的通信方式,为了避免进行TCP中的socket报文解析和繁琐的通信握手过程,我们首先将雷达配

weixin_42024702的博客 1万+

大模型技术解析:从Transformer架构到工程实践

Transformer架构作为现代大模型的基础,通过自注意力机制实现了并行计算和长距离依赖建模,显著提升了自然语言处理的性能。其核心组件如多头注意力和位置编码,在工程实践中需要精细优化以实现高效计算。大模型训练通常分为预训练、指令微调和对齐优化三个阶段,其中预训练消耗大量计算资源。在实际应用中,通过模型选型、提示工程和本地化部署优化,可以显著提升大模型的性能和效率。理解Transformer工作原理并进行场景化优化,往往比单纯增加模型参数量更有效。

weixin_33871366的博客 359

同源策略与跨域

前言:最近业务上前端同学多次联系说访问腾讯云cos资源的时候因为跨域的问题访问不到。大致看了下腾讯云关于设置跨域访问的教程,按照前端同学给的域名等选项就给配了,而且测试下来也是好的。但是呢一直不知道什么是跨域这里就做一个简单的学习记录。 一、同源策略 同源策略(Same Origin Policy)是一种约定,它是浏览器最核心也是最基本的安全功能。同源策略会阻止一个域的javascrip脚本和另一个域的内容进行交互,是用于隔离潜在恶意文件的关键安全机制;关于这一点我们后面会举例说明。...

mijichui2153的博客 1万+

研究报告:Grok 4.5的“巴别塔”时刻——ENI-apr越狱技术深度解析与大模型安全护栏的系统性溃败

本报告旨在深度剖析2026年7月8日发生的一起标志性AI安全事件:xAI公司发布的万众瞩目的1.5万亿参数旗舰模型Grok 4.5,在上线不足24小时内即被知名越狱研究者“Pliny the Liberator”攻破。攻击者采用了一种名为“ENI-apr”(学术重构)的先进提示工程技术,成功绕过了模型的多层安全护栏,诱使其生成包括制毒、制弹、生物毒素提取和网络攻击工具在内的高危内容。此事件不仅是xAI与合作伙伴Cursor安全承诺的一次重大失败,更暴露了当前大语言模型(LLM)安全对齐范式的根本性裂痕。

从零开始,掌握网络安全。提供全面的网络安全教程、攻防演练技巧和行业动态。 802

【反卷积算法】Richardson-Lucy (RL) :通过不断迭代更新图像估计值

Richardson-Lucy(RL)反卷积算法:是一种基于最大似然估计(Maximum Likelihood Estimation, MLE)的图像去卷积方法,常用于去模糊和图像增强。通过不断地更新图像估计值,来最小化模糊图像和恢复图像之间的误差,逐步消除模糊,最终接近真实的原始图像,每次迭代都会根据当前估计的图像来修正下次迭代的结果。

📷 图像处理践行者 | 传统算法 · 深度学习 · 多模态 | 分享实战经验与技术洞见,探索从像素到智能的无限可能。 3043

YOLOv8融合可变形注意力(DAT)实战教程:暴力涨点的科研级注意力机制优化方案

DAT的“可变形注意力”为目标检测的“精准特征捕捉”提供了全新思路,而YOLOv8的工程化优势让这种科研创新能快速落地到工业场景。希望这篇教程能帮你在“注意力机制优化+复杂场景检测”的痛点上找到突破口。如果你在实操中遇到“涨点不明显”的问题,不妨回到“DAT的采样点是否贴合目标形状”“注意力权重是否有效过滤背景”这些细节上找原因——科研的价值,就在于在细节打磨中推动技术进步。祝你在DAT与YOLOv8的结合探索中,既能做出有说服力的实验成果,又能沉淀出解决异形目标检测难题的实用经验。

know_F0727的博客 88

大模型原生能力归零:中间层蒸发的工程范式

在大模型技术演进中,'中间层抽象'正从必要架构转向技术负债。当模型原生能力(如语义解析、知识检索、意图识别)达到高置信度阈值(如0.93 F1),传统RAG、LangChain编排、向量数据库等中间组件便失去存在必要性——这一‘归零’现象并非功能删减,而是能力内生化带来的工程升维。其技术价值在于显著降低延迟(实测压至112ms)、减少错误率(下降92%)、压缩运维成本(年省超$12万)。典型应用场景覆盖金融合规问答、医疗知识图谱推理、工业故障诊断等强语义依赖领域。本文聚焦Anthropic已落地的‘Laye

weixin_30267785的博客 351

jre9下载 jdk9

(Java SE Runtime Environment 9.0) 9.0u175 官方最新版 【x86|x64】

【大模型技术深度解析】从 Transformer 架构到 DeepSeek 推理革命全景图

大模型技术演进与Transformer架构解析 本文系统梳理了大语言模型的技术发展历程和核心架构。2017年Google发表的《Attention Is All You Need》论文开创了Transformer时代,其核心的自注意力机制解决了传统RNN/LSTM的并行计算和长距离依赖问题。随后技术发展经历了三个阶段:2018年BERT和GPT-1的双路线突破;2019-2021年参数规模爆炸式增长,GPT-3展现出"涌现"能力;2022年后进入对齐与效率时代,ChatGPT通过RLHF实现安全交互,开源生

独立思考,明辨是非 707

VB摄像头监控

该VB模块可对摄像头捕获的画面进行录像等,可在创建的窗口进行控制

IMSL CNL 7.0.0 (x86-64)Crack

IMSL CNL 7.0.0 (x86-64)Crack intel的算法库破解文件,这是C++版本的破解文件

语义归一化层蒸发:Claude 3.5 实现LLM语义对齐零感知

大语言模型在企业落地时面临的核心挑战之一是语义漂移——同一指令因上下文、措辞或时间变化导致理解不一致。传统方案依赖system prompt约束、embedding映射与后置规则校验,但存在token开销大、鲁棒性差、监控困难等缺陷。Anthropic通过将语义归一化层内化至模型底层,实现动态语义锚点激活与零拷贝融合,使语义对齐过程不可见、不计费、无需显式干预。该技术显著提升长上下文稳定性、降低API调用波动率,并重构了RAG与提示工程范式。开发者无需改代码,只需优化system prompt编写方式,即可

409

android 蓝牙通讯demo

android 下蓝牙通讯demo,实现了发现蓝牙,使能蓝牙,通过蓝牙发送消息。

上一篇: AI Agent内卷加剧!2026年四大核心技术趋势揭秘,从MCP到RaaS,小白程序员也能秒变大模型开发“卷王“!
下一篇: 【AI黑科技】北大团队放大招!6个维度精准增强,8.9万条SQL数据集让模型少走三年弯路!
Python_金钱豹
博客等级 码龄5年 1万+粉丝 2841原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值