大模型落地太难?那是你不懂上下文工程!这篇续命指南,帮你避开 90% 的坑!

AI 是否会通过制造大量垃圾信息来污染互联网 AI确实可能通过生成大量垃圾信息污染互联网,但通过技术、政策、教育等多方面的努力,可以有效减少这种影响。关键在于提高生成内容的质量,同时发展强大的检测和过滤技术,并确保公众了解和能应对这些新出现的挑战。 阅读详情

Context Engineering**(上下文工程)****,让算法工程师精准找到大模型准确性与创造力的平衡点。

从OpenAI的最新发布会不难看出,基础模型的进步已经日渐放缓。

那么,怎么给大模型落地续命?

Anthropic、langchain、Manus在内,一众明星玩家都给出共同答案:提示词已死,Context Engineering(上下文工程)当立。

相比呆板的提示词,Context Engineering的输入更精简、更有逻辑、更动态,大模型的输出也因此变得更加可控且高质量。

那么,我们为什么需要Context Engineering,它的影响如何,我们如何设计Context Engineering,又该如何为它搭建合适的infra基础设施?本文将一一解答。

01

幻觉与创造力,是AI的一体两面

在正式聊Context Engineering之前,我想先分享一个观点,那就是幻觉与大模型创造力,本质上是同一事物的一体两面。

它们与人类的创作过程类似:都是基于扎实的事实、数据基础,产生规律总结,然后对规律进行延伸、组合,完成有根据的认知跳跃。

对人类来说,诗人写诗要懂语言韵律,科学家提假设需基于现有理论。对AI来说,它要在庞大的知识网络中寻找规律与连接点,才能实现类比推理、创意联想,产出好故事、好策划或新编程逻辑。

这种能力利用得当,就是优质内容产出;一旦失控,就是我们闻之色变的幻觉。

两者之间产生差别的根源,对人类来说,来自于阅读量与天分;对AI来说,则来自于模型能力以及模型的上下文输入质量。

而这,也是我们关注Context Engineering,也就是模型上下文工程的根本原因——找到模型的准确性与创造性的平衡点。

02

低质量输入带来的影响

低质量的上下文会带来一连串的输出问题,这种低质量包括但不限于:

(1)上下文污染(Context Poisoning)

当错误信息或幻觉内容进入上下文并被反复引用时,就会发生上下文污染。DeepMind在Gemini 2.5的技术报告中详细描述了这种现象:在Pokemon游戏实验中,AI智能体偶尔会产生关于游戏状态的错误判断,并将这些错误信息写入上下文。一旦目标部分被这些错误信息污染,智能体就会发展出完全荒谬的行动策略,执着地追求根本无法实现的目标。

(2)上下文分散(Context Distraction)

当前,许多头部模型已能支持100万token的上下文窗口——大约相当于75,000行代码或750,000字的文档内容。这给到了很多人一个错觉:我们给到大模型的输入越多越全面,大模型给我们的反馈就越好。

但现实是我们的输入上下文越长,大模型对核心内容的权重分配越混乱。而且,基于“Lost in the middle”现象,大模型会给上下文的开头和结尾更高的权重,忽略中间部分内容。

此外,当上下文变得过于冗长时,模型可能会过度依赖上下文内容而忽视其训练过程中获得的核心知识。研究发现,即使Gemini 2.5 Pro支持超过100万token的上下文,但在智能体任务中,一旦上下文超过10万token,智能体就更倾向于机械地重复历史动作,而不是基于训练知识综合出新的解决方案。Databricks的研究进一步显示,较小的模型如Llama 3.1 405b在32k token附近就开始出现明显的性能下降。

(3)上下文混乱(Context Confusion)

当上下文中包含过多无关信息时,会导致模型输出质量的显著下降。Berkeley的Function-Calling排行榜研究表明,所有模型在面对多个工具选项时性能都会下降,甚至在完全不需要工具的场景中也会错误地尝试调用工具。GeoEngine基准测试提供了一个典型案例:当给量化后的Llama 3.1 8b提供46个工具时,它完全失败;但减少到19个工具时,它就能成功完成任务。

(4)上下文冲突(Context Clash)

当上下文内部包含相互矛盾的信息时,会严重影响模型的推理能力。微软和Salesforce的联合研究发现,当将基准测试的prompt分散到多轮对话中时,模型表现平均下降39%。OpenAI o3的分数更是从98.1直接跌落到64.1。研究团队总结:"当大语言模型在对话早期阶段做出错误假设时,它们往往会迷失方向,很难重新回到正确的轨道上。
针对以上困境,Context Engineering作为一门显学逐渐发展起来:它的主张是,不过分限制模型的"幻觉",而是通过精心设计的上下文环境,引导模型在准确性与创造性之间找到最佳平衡点。

那么,一个优质的Context Engineering应该如何设计?

03

Context Engineering的三层架构如何运作

从工程实践角度分析,成功的Context Engineering应该有三层核心架构:
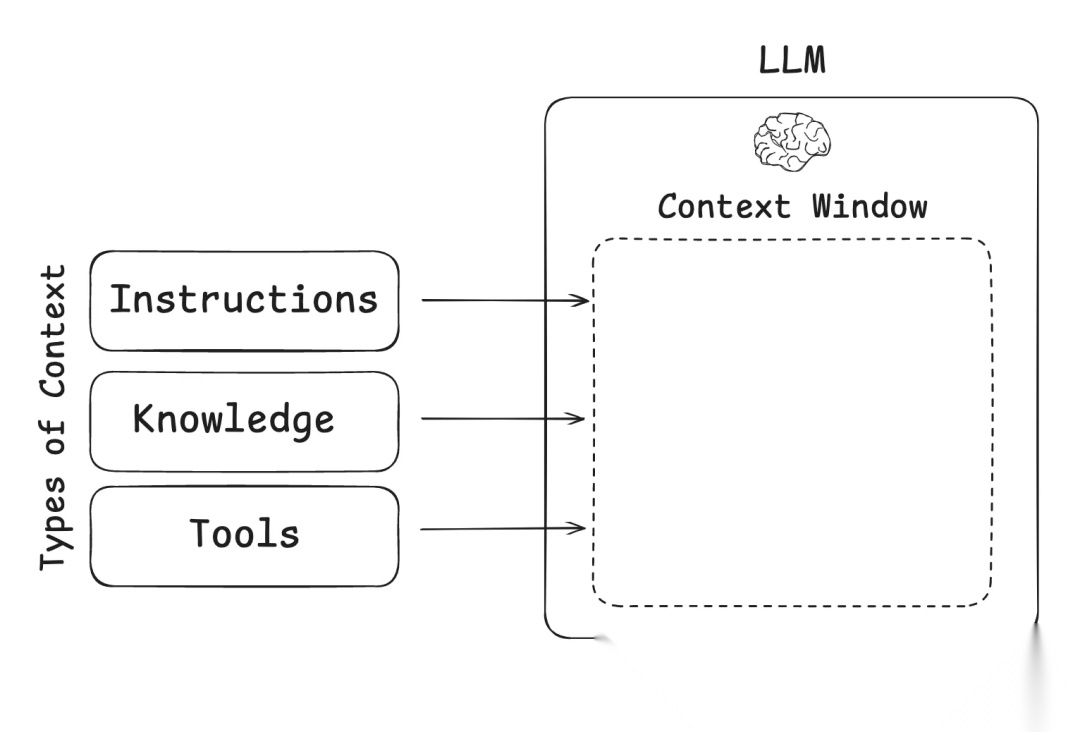
Instructions层(指令层)

这是系统的"导航系统",包括精确的Prompts、典型的few-shot示例等。其主要功能是明确指导模型执行任务,清晰表达用户意图并提供具体操作示范。

Knowledge层(知识层)

这是系统的"数据库",涵盖事实信息、长期记忆存储、代码库内容、当前系统状态和工作草稿等。它为模型推理过程提供必要的基础材料和背景信息。

Tools层(工具层)

这是系统的"执行引擎",包含工具功能描述、调用结果反馈等。其主要作用是扩展模型的行动能力边界,使其能够与外部系统进行有效交互。

这三个层次构成了一个完整而动态的上下文生态系统:Instructions层确定行动方向,Knowledge层提供决策素材,Tools层扩展执行能力并提供实时反馈。

04

Context Engineering的业内实践

基于三层架构,目前行业内关于Context Engineering的探索,主要有以下解决方案:

上下文隔离(Context Isolation)

将复杂任务拆解为多个独立Agent,每个子任务使用独立上下文避免相互干扰。这种方法特别适用于多步骤的复杂任务,通过多智能体并行协作不仅提升效率,还能显著降低错误传播的风险。

上下文修剪(ContextPruning)

定期清理无关内容,保留核心指令与目标,删除冗余历史与文档。这需要建立明确的信息重要性评估机制,确保上下文始终聚焦于当前最相关的信息。

上下文摘要(Context Summarization)

将累积的长篇信息压缩为简短而精准的总结,既保留了关键信息,又减少了重复与噪音。优秀的摘要策略能够显著降低"上下文分散"的风险。

上下文卸载(Context Offloading)

将部分信息存储在LLM外部,比如使用专门的笔记系统或草稿工具。这种方法能够有效减轻主上下文的负担,同时保持信息的可访问性。

RAG增强(检索增强生成)

有选择地引入外部相关信息,避免"垃圾进,垃圾出"的问题。关键在于建立有效的信息过滤和质量评估机制,确保引入的信息真正有助于任务完成。

精准工具配置(Optimized Tool Loadout)

仅加载当前任务真正需要的工具。研究表明,工具数量超过30个时性能会显著下降,因此精准的工具选择和配置至关重要。

05

Data Infra

Context Engineering的基础设施

Context Engineering的理论再精妙,也需要强大的基础设施支撑。当前企业的Context Engineering在数据基础设施层面临着三重挑战:

数据量级的指数增长

从TB级跃升至PB级,过去的简单操作变成了系统工程。给表添加一个字段不再是一行SQL的小事,而需要涉及存储重构、计算调度、系统协调的复杂工程。

数据消费模式的根本性转变

AI Agent直接生成和消费数据,基础设施必须对机器和模型友好。

多模态数据的复杂性管理

从1KB的文本消息到100MB的视频片段,从简单的数值记录到复杂的嵌入向量。更复杂的是,这些非结构化数据往往还携带着丰富的元数据:标签、特征、语义向量等结构化信息。如何统一管理和高效检索这些异构数据,成为Context Engineering实施的关键瓶颈。

06

Milvus + 向量数据湖

专为AI时代打造的数据架构

面对这些挑战,Zilliz提供了针对Context Engineering的工程化解决方案:

毫秒级向量检索

Milvus专门为向量数据而生,无论你的embedding来自文本、图片、音频还是视频,都能统一存储和管理。关键指标:毫秒级检索延迟,轻松支持过亿条向量数据。当你的AI应用需要从海量上下文中快速找到最相关的信息时,这种性能表现直接决定了用户体验的好坏。

面向海量多模态数据的数据湖方案

向量数据湖作为多模态数据湖方案,专门解决大规模非结构化数据的离线处理难题。配合Ray、Daft等经过生产环境验证的分布式计算框架,能够高效完成上下文压缩、去重、聚类等复杂操作。处理完成的优化数据无缝对接Milvus,整个数据流pipeline一气呵成,避免了传统方案中繁琐的数据格式转换和中间存储开销。

真正的云原生弹性扩展

采用存算分离架构,存储和计算资源可以独立扩缩容。当你的业务从每天处理几GB数据增长到几TB甚至PB级时,系统能够自动适应负载变化。更重要的是,你可以根据实际场景需求在实时serving和离线training之间灵活调配资源,既保证了服务质量,又避免了资源浪费。

为下一代AI应用而设计

这套架构的设计哲学立足当下的同时,还可以为未来3-5年的AI应用发展趋势做准备。随着Context Engineering变得更加复杂——需要处理更丰富的模态组合、更复杂的数据关系建模、更智能的模型推理能力——这个架构都能从容应对技术演进。从简单的语义检索到复杂的多步推理,从单模态数据到多模态融合,技术升级路径清晰且平滑。

如何学习大模型 AI ?

由于新岗位的生产效率,要优于被取代岗位的生产效率,所以实际上整个社会的生产效率是提升的。

但是具体到个人,只能说是:

“最先掌握AI的人,将会比较晚掌握AI的人有竞争优势”。

这句话,放在计算机、互联网、移动互联网的开局时期,都是一样的道理。

我在一线互联网企业工作十余年里,指导过不少同行后辈。帮助很多人得到了学习和成长。

我意识到有很多经验和知识值得分享给大家,也可以通过我们的能力和经验解答大家在人工智能学习中的很多困惑,所以在工作繁忙的情况下还是坚持各种整理和分享。但苦于知识传播途径有限,很多互联网行业朋友无法获得正确的资料得到学习提升,故此将并将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。

在这里插入图片描述

第一阶段(10天):初阶应用

该阶段让大家对大模型 AI有一个最前沿的认识,对大模型 AI 的理解超过 95% 的人,可以在相关讨论时发表高级、不跟风、又接地气的见解,别人只会和 AI 聊天,而你能调教 AI,并能用代码将大模型和业务衔接。

  • 大模型 AI 能干什么?
  • 大模型是怎样获得「智能」的?
  • 用好 AI 的核心心法
  • 大模型应用业务架构
  • 大模型应用技术架构
  • 代码示例:向 GPT-3.5 灌入新知识
  • 提示工程的意义和核心思想
  • Prompt 典型构成
  • 指令调优方法论
  • 思维链和思维树
  • Prompt 攻击和防范
  • …

第二阶段(30天):高阶应用

该阶段我们正式进入大模型 AI 进阶实战学习,学会构造私有知识库,扩展 AI 的能力。快速开发一个完整的基于 agent 对话机器人。掌握功能最强的大模型开发框架,抓住最新的技术进展,适合 Python 和 JavaScript 程序员。

  • 为什么要做 RAG
  • 搭建一个简单的 ChatPDF
  • 检索的基础概念
  • 什么是向量表示(Embeddings)
  • 向量数据库与向量检索
  • 基于向量检索的 RAG
  • 搭建 RAG 系统的扩展知识
  • 混合检索与 RAG-Fusion 简介
  • 向量模型本地部署
  • …

第三阶段(30天):模型训练

恭喜你,如果学到这里,你基本可以找到一份大模型 AI相关的工作,自己也能训练 GPT 了!通过微调,训练自己的垂直大模型,能独立训练开源多模态大模型,掌握更多技术方案。

到此为止,大概2个月的时间。你已经成为了一名“AI小子”。那么你还想往下探索吗?

  • 为什么要做 RAG
  • 什么是模型
  • 什么是模型训练
  • 求解器 & 损失函数简介
  • 小实验2:手写一个简单的神经网络并训练它
  • 什么是训练/预训练/微调/轻量化微调
  • Transformer结构简介
  • 轻量化微调
  • 实验数据集的构建
  • …

第四阶段(20天):商业闭环

对全球大模型从性能、吞吐量、成本等方面有一定的认知,可以在云端和本地等多种环境下部署大模型,找到适合自己的项目/创业方向,做一名被 AI 武装的产品经理。

  • 硬件选型
  • 带你了解全球大模型
  • 使用国产大模型服务
  • 搭建 OpenAI 代理
  • 热身:基于阿里云 PAI 部署 Stable Diffusion
  • 在本地计算机运行大模型
  • 大模型的私有化部署
  • 基于 vLLM 部署大模型
  • 案例:如何优雅地在阿里云私有部署开源大模型
  • 部署一套开源 LLM 项目
  • 内容安全
  • 互联网信息服务算法备案
  • …

学习是一个过程,只要学习就会有挑战。天道酬勤,你越努力,就会成为越优秀的自己。

如果你能在15天内完成所有的任务,那你堪称天才。然而,如果你能完成 60-70% 的内容,你就已经开始具备成为一名大模型 AI 的正确特征了。

这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】

在这里插入图片描述

Java电商秒杀系统性能优化(一)——电商秒杀系统框架回顾 电商秒杀系统框架回顾项目简介外部依赖框架回顾项目要点项目中存在的问题小结 课程是免费的,课程地址如下:SpringBoot搭建电商秒杀项目,课程真的很棒,作者的思路很清晰,建议各位读者可以跟着视频练习一下这个项目; 项目简介 通过SpringBoot快速搭建的前后端分离的电商基础秒杀项目。项目通过应用领域驱动型的分层模型设计方式去完成:用户otp注册、登陆、查看、商品列表、进入商品详情以及倒计时秒... 阅读详情

相关推荐

EtherCAT丢包问题深度解析:从原理到实战排查指南

在工业自动化与运动控制领域,实时通讯网络的稳定性是系统可靠运行的基石。EtherCAT(以太网控制自动化技术)作为一种高性能工业以太网协议,其核心在于独特的“飞读飞写”机制和纳秒级的分布时钟同步,以实现多设备间的精准协同。然而,物理链路干扰、配置不当或硬件性能瓶颈都可能导致数据帧丢失,破坏时钟同步,进而引发伺服抖动、定位精度下降乃至生产线停机。本文聚焦于EtherCAT丢包这一典型故障,结合SSC(Slave Stack Code Tool)从站协议栈开发与实时系统调优等工程实践,系统阐述其成因、影响及一套

weixin_32050773的博客 341

突破上下文牢笼:AI编程助手的记忆污染与遗忘难题全解

《AI编程助手的记忆优化解决方案》 随着AI编程助手在复杂项目中的应用,其面临三大"认知障碍":上下文限制导致信息截断、无关代码污染造成逻辑混乱,以及对话遗忘引发的架构决策丢失。这些问题严重影响了代码生成质量和开发效率。 本文提出基于向量数据库的智能记忆系统解决方案,通过层级化存储架构和精准上下文管理,重建AI的"外部大脑"。核心创新包括: 分层向量存储项目知识(架构设计、API定义等) 动态上下文分配机制 对话历史智能过滤 实际测试显示,该方案使跨文件代码生成准确率

huluang的专栏 1255

保姆级教程:用NILMTK和REDD数据集,5分钟跑通你的第一个负荷分解模型

本文提供了一份详细的NILMTK和REDD数据集负荷分解模型教程,适合零基础用户快速上手。从环境准备、数据获取到模型构建和评估,全程仅需5分钟即可完成。特别适合希望快速入门非侵入式负荷分解(NILM)的开发者,涵盖数据预处理、模型训练及结果可视化等关键步骤。

weixin_30493401的博客 442

大模型落地,已经走到了用上下文工程续命时刻

当你的AI应用需要从海量上下文中快速找到最相关的信息时,这种性能表现直接决定了用户体验的好坏。DeepMind在Gemini 2.5的技术报告中详细描述了这种现象:在Pokemon游戏实验中,AI智能体偶尔会产生关于游戏状态的错误判断,并将这些错误信息写入上下文。,甚至在完全不需要工具的场景中也会错误地尝试调用工具。从1KB的文本消息到100MB的视频片段,从简单的数值记录到复杂的嵌入向量。而且,基于“Lost in the middle”现象,大模型会给上下文的开头和结尾更高的权重,忽略中间部分内容。

ZILLIZ 1231

深入解析FPGA中的GTX高速收发器架构与设计原理

本文深入解析了FPGA中GTX高速收发器的核心架构与设计原理。文章将GTX比作数据“高速公路”,详细拆解了其PMA(物理媒介适配层)与PCS(物理编码子层)的双层结构,阐述了串并转换、时钟恢复等关键技术,并提供了时钟源选型(QPLL/CPLL)、上电复位流程及信号完整性调试等实战指南,是掌握高速接口设计的必备知识。

f6g7h8i9j的博客 220

AI量化交易工作台Vibe-Trading:用自然语言驱动策略回测与多智能体研究

量化交易通过数学模型和计算机程序执行投资决策,其核心在于将市场规律转化为可验证的策略。传统量化开发涉及数据获取、策略编写、回测验证等复杂工程,对非编程背景的从业者构成较高门槛。随着大语言模型技术的发展,自然语言交互正成为降低技术使用难度的关键。Vibe-Trading项目正是这一趋势的实践,它将金融工程任务封装为可调用的工具与技能,允许用户通过自然语言指令直接驱动策略回测、因子研究和投资组合分析。其技术价值在于构建了一个模块化的AI Agent框架,通过ReAct推理框架协调多个专项技能,并创新性地引入多智

weixin_28695161的博客 1567

上下文工程:解锁AI智能体潜力的关键策略,建议反复学习!

上下文工程是筛选和管理AI可用信息的策略,区别于关注"怎么说"的提示工程。AI存在"上下文衰减"问题,注意力有限,处理长信息能力不足。做好上下文工程需:1)素材精准精简;2)按需即时检索信息;3)处理长任务采用上下文压缩、结构化笔记和子智能体架构。这本质是重塑人与AI的协作关系,将AI视为有注意力极限的队友,以最低信息成本实现最优结果。

2401_85390073的博客 941

帝企鹅优化器(EPO)详解:从基础原理到代码实战

帝企鹅优化器(EPO)是受帝企鹅群体在极寒环境中抱团取暖行为启发,于2018年提出的一种群体智能优化算法。其核心机制是模拟帝企鹅种群通过动态调整位置来维持体温的过程,主要包括确定集群边界、计算温度分布、衡量个体间距离以及更新位置四个步骤,从而在求解复杂优化问题时有效平衡全局探索与局部开发。该算法具有参数少、结构清晰、易于实现等优点,在工程优化、图像处理、机器学习特征选择以及冷链物流车辆路径规划等领域展现出良好的应用潜力。

qq_42212808的博客 141

大模型 | Anthropic提出Contextual Retrieval让RAG再进化,大幅降低检索失败率

研究团队通过大量的实验,为大家指出了一个新的提升 RAG 性能的方法,为开发者指出了实践新方向。嵌入+BM25 比单独使用嵌入效果更好(向量检索与文本检索相结合);Voyage 和 Gemini 是测试中效果最好的嵌入模型;将前 20 个分块传递给模型比仅传递前 10 个或前 5 个分块更有效;为分块添加上下文显著提高了检索准确性;重排序比不重排序效果更好;

m0_56255097的博客 1431

大疆司空 2 私有化部署:FH2、Terra、4G 三大服务区别详解

摘要: 司空2私有版包含三大模块:FH2(核心平台,必选)、Terra(建模算力,需NVIDIA显卡)、4G(内网图传)。FH2是基础,支持设备管理与任务调度;Terra适用于测绘建模场景,依赖GPU算力;4G模块保障复杂环境下的图传稳定性,适合纯内网部署。选择逻辑:先部署FH2,再按需添加Terra(需显卡)或4G(需内网支持),避免资源浪费。

2501_93651177的博客 580

从零开始学习CANoe(十六)—— Graphics

Graphics是一种以时间轴为横坐标,符号值为纵坐标的显示分析方法,相对于Trace来说,更直观的观察出信号的跳变

蚂蚁小兵 9194

收藏!2026大模型转行/入门指南:普通人落地AI的实战路线(避开90%新手坑)

对于正在迷茫择业、想转行提升,或是刚入门的程序员、编程小白来说,有一个问题几乎人人都在问:未来10年,什么领域的职业发展潜力最大?答案只有一个:人工智能(尤其是大模型方向)当下,人工智能行业正处于爆发式增长期,其中大模型相关岗位更是供不应求,薪资待遇直接拉满——字节跳动作为AI领域的头部玩家,给硕士毕业的优质AI人才(含大模型相关方向)开出的月基础工资高达5万—6万元;即便是非“人才计划”的普通应聘者,月基础工资也能稳定在4万元左右。

python12345_的博客 792

jdk-8u144-linux-x64.tar.gz.

该资源为搭建Linux系统Java环境用,资源的后缀为tar.gz格式的压缩包

收藏!后端/新手转大模型实战指南:避开90%人踩的坑,6个月可求职

今天这篇内容,我拒绝堆砌教科书式的理论——那些论文库里一搜就有的公式定理,对想快速入局的人来说,远不如“选对方向”“避开深坑”来得实在。内容全是实战干货,每一条都是我对接企业需求、带学员实战时踩过的坑、总结的经验。

优快云_430422的博客 393

最新的sdio 4.0 spec 协议标准 带书签 高清完整PDF版

Part-E1-SDIO-Specification-Ver4.00-Final-120220.pdf:最新的sdio 4.0 spec 协议标准 带书签 高清完整PDF版,包括SDIO 接口的外设,SDIO 接口官方协议等。

VC中sqlite的使用

在VC中对sqlite的使用,实现数据库大批数据的快速插入,读取数据库中的数据在ListCtrl中显示

收藏!大模型转型避坑指南:从0到1落地,后端/小白都能对号入座

如今技术圈降薪裁员频频爆发,传统岗位大批缩水,相反AI相关技术岗疯狂扩招,薪资逆势上涨150%,大厂老板们甚至开出70-100W年薪,挖掘AI大模型人才!技术的稀缺性,才是你「值钱」的关键!具备AI能力的程序员,比传统开发高出不止一截!有的人早就转行AI方向,拿到百万年薪!👇🏻👇🏻是不是也想抓住这次风口,但卡在 “入门无门”?小白:想学大模型,却分不清 LLM、微调、部署,不知道从哪下手?传统程序员:想转型,担心基础不够,找不到适配的学习路径?

AI大模型的博客 1047

STM32F407中文手册

STM32f407中文手册 本参考手册面向应用开发人员,提供有关使用 STM32F405xx/07xx、STM32F415xx/17xx、 STM32F42xxx 和 STM32F43xxx 微控制器存储器与外设的完整信息。STM32F405xx/07xx、STM32F415xx/17xx、STM32F42xxx 和 STM32F43xxx 构成一个微 控制器系列,各产品具有不同的存储器大小、封装和外设。有关订购信息以及器件的机械与电气特性,请参见数据手册。有关 ARM Cortex™-M4F 内核的信息,请参见《Cortex™-M4F 技术参考手册》。

别不信!90%的人转行AI不是学不会,而是死在这3个坑里

【摘要】AI转行热潮中90%的人最终放弃,并非因为学习难度,而是踩了三大坑:1️⃣误入算法研发误区,忽略应用层机会(如智能座舱测试、Prompt工程等);2️⃣沉迷理论收藏却缺乏真实项目实践;3️⃣信息闭塞导致就业匹配失败。成功转行需把握三点:选择软硬结合的落地领域、专注实战项目、借助行业资源。AI行业红利窗口期有限,行动力才是关键。

qazwsx0717的博客 2273

收藏备用!技术人学大模型的避坑指南,从入门到变现

最近和几个程序员朋友聚餐,聊起职场现状全是共鸣:有人做了6年后端,被刚毕业的年轻人用AI工具抢了效率优势;有人跟风学大模型,花3000块报的课全是基础理论,学完连项目都搭不起来;还有人自学时踩坑无数,光模型部署就卡了半个月,最后直接放弃。这届技术人太难了:不学大模型,怕被行业淘汰;盲目学大模型,又容易交“智商税”。作为从传统测试转型大模型应用开发,现在靠接外包项目月入过万的“过来人”,我太清楚这个过程的痛点——。

AI大模型的博客 899

收藏!程序员&小白必看|2026大模型入门指南,从0到1少走90%弯路

打开BOSS直聘、智联等招聘软件,相信很多程序员和IT新手都能发现一个明显趋势:传统开发岗位内卷愈演愈烈,简历石沉大海成为常态,但大模型相关岗位却一路开挂、供不应求——算法工程师、大模型应用开发、Prompt工程师等职位薪资持续飙升,甚至不少企业放宽门槛,推出“零基础培训+带薪入职”的福利政策。对程序员而言,现在学大模型,早已不是“可选项”,而是关乎职场生存、避免被淘汰的“必修课”;对小白来说,这更是低成本切入IT行业、实现弯道超车的绝佳风口。后台经常收到留言:“我是后端开发,转型大模型会不会太难?

kaka0722ww的博客 651

零基础程序员入门大模型,避开90%的转型误区

上周参加技术沙龙,旁边坐了个写了五年Java后端的哥们儿,一杯接一杯地灌咖啡,愁眉苦脸地跟我吐槽:“现在找工作太难了!去年投10份简历能有8个面试,今年投20份才有3个,薪资还砍了20%。”我问他:“那你试过投大模型相关岗位吗?”他摇摇头:“那玩意儿太高端了,我这种写CRUD的,哪敢碰啊?无独有偶,散场的时候碰到另一个做前端的朋友,他刚跳槽到一家AI公司做大模型应用开发,薪资直接翻倍,从原来的25K涨到了55K。

HHX_01的博客 243

收藏!大模型转型避坑指南:从后端/0基础到入职,120+学员验证的实战路径

今天这篇内容,我不想罗列教科书式的理论——那些在论文库里一搜就有的公式定理,对想快速入局的人来说,远不如“选对方向”“避开深坑”来得实在。内容偏实战干货,每一条都是我对接企业需求、带学员实战时踩过的坑、总结的经验。

优快云_430422的博客 866

后端转大模型?0基础入门?这份实战指南帮你少走3年弯路

今天这篇内容,我不想罗列教科书式的理论——那些在论文库里一搜就有的公式定理,对想快速入局的人来说,远不如“选对方向”“避开深坑”来得实在。内容有点干,但每一条都是我对接企业需求、带学员实战时踩过的坑、总结的经验。

EnjoyEDU的博客 895

程序员转大模型必避的10个坑,90%的人都踩过

上周参加技术沙龙,旁边坐了个写了五年Java后端的哥们儿,一杯接一杯地灌咖啡,愁眉苦脸地跟我吐槽:“现在找工作太难了!去年投10份简历能有8个面试,今年投20份才有3个,薪资还砍了20%。” 我问他:“那你试过投大模型相关岗位吗?” 他摇摇头:“那玩意儿太高端了,我这种写CRUD的,哪敢碰啊?无独有偶,散场的时候碰到另一个做前端的朋友,他刚跳槽到一家AI公司做大模型应用开发,薪资直接翻倍,从原来的25K涨到了55K。这几乎就是2026年程序员职场最真实的缩影:一边是传统开发岗卷到飞起,薪资腰斩;

HHX_01的博客 255

AI大模型入行必看!90%的人都找不到工作的真相,普通人如何逆袭?

摘要: AI大模型领域分为算法开发与应用开发两大方向,前者门槛极高(需985/211学历),后者门槛较低(专科即可)。当前行业机会集中在应用层,如RAG、Agent智能体、模型微调等技术,企业需求旺盛但人才稀缺,薪资高达百万年薪。建议普通人选择大模型应用开发方向(如Java+AI),通过实战掌握核心技术,规避算法岗的高竞争。文末提供免费学习资料及内推资源,助力职业转型。 (字数:149)

2401_84204207的博客 175

【收藏级】程序员 & 小白必看!大模型落地实战指南,告别内卷弯道超车

打开BOSS直聘、智联等招聘软件,相信很多程序员和IT新手都能发现一个明显趋势:传统开发岗位内卷愈演愈烈,简历石沉大海成为常态,但大模型相关岗位却一路开挂、供不应求——算法工程师、大模型应用开发、Prompt工程师等职位薪资持续飙升,甚至不少企业放宽门槛,推出“零基础培训+带薪入职”的福利政策。对程序员而言,现在学大模型,早已不是“可选项”,而是关乎职场生存、避免被淘汰的“必修课”;对小白来说,这更是低成本切入IT行业、实现弯道超车的绝佳风口。后台经常收到留言:“我是后端开发,转型大模型会不会太难?

kaka0722ww的博客 425

收藏备用!程序员入门大模型:从0到1的学习全攻略

打开招聘软件不难发现一个趋势:传统开发岗位竞争愈发激烈,但大模型相关岗位却一路“绿灯”——算法工程师、大模型应用开发、Prompt工程师等职位薪资水涨船高,甚至不少公司开出“零基础培训入职”的条件。对程序员来说,现在学大模型,不是“选择题”,而是“生存题”。“我是后端开发,转大模型会不会太难?”“刚入行的小白,能跟上节奏吗?”其实这些顾虑都多余。大模型的学习门槛远低于你想象,尤其是有编程基础的程序员,更是自带优势——你熟悉的代码逻辑、数据结构,都是理解大模型的“垫脚石”。

qq_46094651的博客 993

传统PM转型大模型产品:避开90%人踩过的认知误区

大模型技术正在重塑产品形态,产品经理面临能力升级的挑战。理解大模型的基本原理,掌握提示词工程、检索增强生成(RAG)等关键技术,是构建AI产品的基石。与传统软件不同,大模型产品的输出具有概率性,因此建立科学的评估体系比堆砌功能更重要。在智能客服、知识问答、内容生成等场景中,合理运用RAG和微调能显著提升效果,但需警惕过度依赖Agent与忽视安全合规的误区。从本地部署开源模型到参与真实项目实践,是传统PM转型为AI产品经理的有效路径。本文系统梳理转型过程中的常见认知误区,帮助从业者少走弯路,快速构建大模型产品

weixin_29040367的博客 195

大模型转型指南:小白程序员避坑手册,实战经验助你快速入行(收藏版)

近期科技圈传来重磅消息:行业巨头英特尔宣布大规模裁员2万人,传统技术岗位持续萎缩的同时,另一番景象却在AI领域上演——AI相关技术岗正开启“疯狂扩招”模式!据行业招聘数据显示,具备3-5年大模型相关经验的开发者,在大厂就能拿到50K×20薪的高薪待遇,薪资差距肉眼可见!业内资深HR预判:不出1年,“具备AI项目实战经验”将正式成为技术岗投递的硬性门槛。在行业迭代加速的当下,“温水煮青蛙”式的等待只会让自己逐渐被淘汰,与其被动应对,不如主动出击,抢先掌握AI大模型核心原理+落地应用技术+项目实操经验。

ai_ZZIC的博客 333
上一篇: 震惊!30B参数碾压GPT-5?MiroThinker 1.5开源大模型杀疯了!小白程序员必学的“交互式智能“新范式,降本增效还能跑赢235B!内卷时代的新出路!
下一篇: 显存爆炸?成本过高?RaBitQ 1bit 压缩神技,高召回不降级,这才是 AI Infra 的省钱王炸!
Python_金钱豹
博客等级 码龄5年 1万+粉丝 2839原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值