大模型时代的 YOLO:从实时检测到开放词汇与多模态理解(附:YOLO家族进化史全景图)

从 YOLO 到视觉大模型:工程实践中如何选择? 本文对比了传统视觉模型YOLO与视觉大模型的差异。YOLO是单任务专用模型,适合规则明确、实时性要求高的检测任务;视觉大模型则具备通用视觉理解能力,但存在推理延迟大、算力成本高和"过度智能"等问题。在实际工程中,参数规模并非越大越好,7B-8B模型往往更均衡。控制大模型幻觉需通过严格Prompt设计、定向样本微调和任务拆解等方法。工业落地时应根据任务特性选择模型:YOLO适用于确定性高的场景,视觉大模型更适合复杂多变的环境。模型效果的关键在于任务边界、数据质量和系统设计,而非单纯追求参数 阅读详情

1. 引言:当 YOLO 遇到“大模型”

自 2015 年 YOLO(You Only Look Once)首次提出以来,YOLO 系列一直是目标检测领域的标杆。YOLO 以其极快的推理速度、端到端的训练方式和部署友好的特性,成功打破了传统目标检测方法的瓶颈。而随着 大模型时代 的到来,视觉模型的能力正变得越来越强大,尤其是在 多模态学习、全局关联建模、开放类别检测等领域取得了显著进展。近年来,YOLO 系列也逐步向这些趋势靠拢,从实时检测向更加智能与全局的多任务能力迈进。

随着 YOLOv12 和 YOLOv13 的发布,YOLO 系列也显现出在“大模型时代”下的新面貌,尤其是通过引入注意力机制、高阶关联建模、以及开放词汇检测,让 YOLO 不再局限于传统的“检测”任务,而是逐步扩展到更广泛的应用场景中。本文将回顾 YOLO 系列的演变,并探讨它在大模型时代的未来发展方向。


2. 快速回顾:从 YOLO 到“YOLO 们”
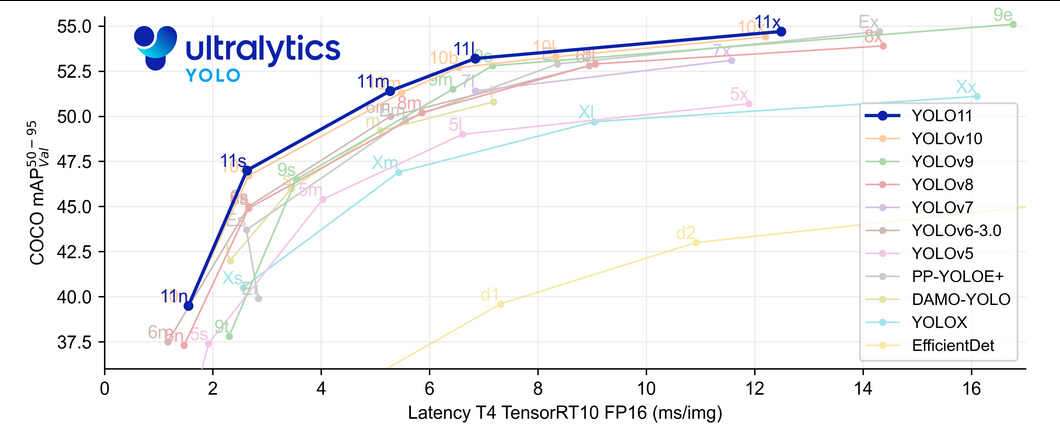
YOLO 的起源与演进

  • v1(2015年):首次提出将目标检测任务视为回归问题,即对每个网格预测边界框和类别概率,从而实现实时检测,但小目标和定位精度有限。

  • v2(2017年,YOLO9000):引入锚框、维度聚类等技术,提升了多尺度物体的检测能力,并在不同类别检测上取得了较好表现。

  • v3(2018年):使用Darknet-53作为骨干网络,加入三尺度输出,大幅提升了小目标的检测精度。

  • v4(2020年):引入CSPDarknet-53骨干网络、PANet、CIoU损失等技术,提升了模型的精度和鲁棒性,同时保持了较高的推理速度。

  • v5(2020年):由Ultralytics发布,提供了基于PyTorch的原生实现,方便用户进行训练和部署,并引入了多任务训练的框架。

  • v6–v8(2021–2023年):逐步支持多任务(检测、分割、姿态估计),并加强了模型的部署能力,特别是在工业级场景中。

  • v9–v11(2024年):继续在信息流与梯度传播上做优化,同时在训练策略和蒸馏技术上进行了多次增强,提升了模型的实时性和精度。
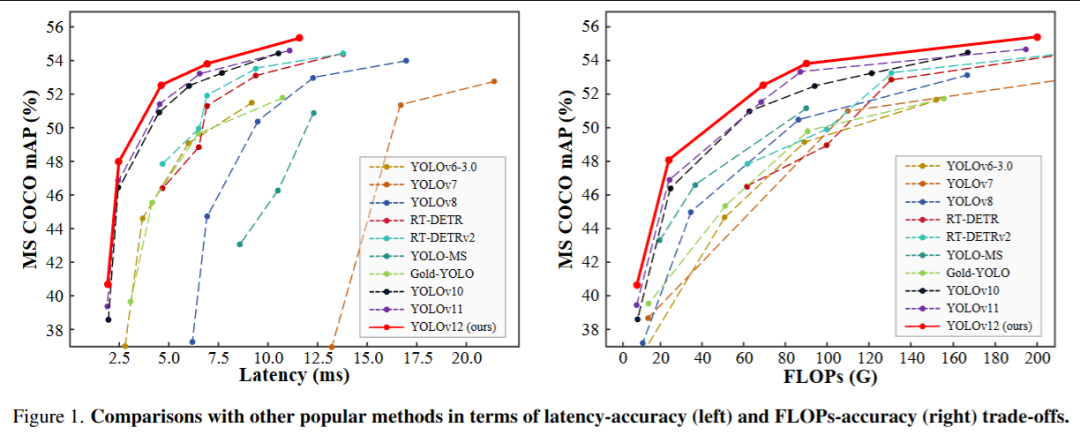
3. 两种风格的分界:以 v12 为转折

3.1 风格 A(v1–v11):CNN 强化的“实时 YOLO”

YOLO 系列的前十一代(v1–v11)主要围绕 CNN(卷积神经网络) 强化,旨在优化推理速度和精度之间的平衡。这些版本的核心特征包括:

  • 卷积结构为主,逐步优化Backbone、Neck、Head等网络模块。
  • 引入多尺度检测和数据增强等技术,提升小物体检测能力。
  • 强调在低延迟环境中的应用,尤其是在视频流和嵌入式设备上。

这些版本的 YOLO 主要关注 实时检测,即便是在推理速度和精度之间做了妥协,也始终保持了极高的 FPS(每秒帧数),是许多工业和视频分析场景中的首选。

3.2 风格 B(v12–v13):注意力/高阶关联驱动的“新 YOLO”

自 YOLOv12 以来,YOLO 系列进入了风格 B,标志着 从经典 CNN 架构向更强的全局建模、注意力机制等更为复杂的架构转型。具体的关键改进包括:
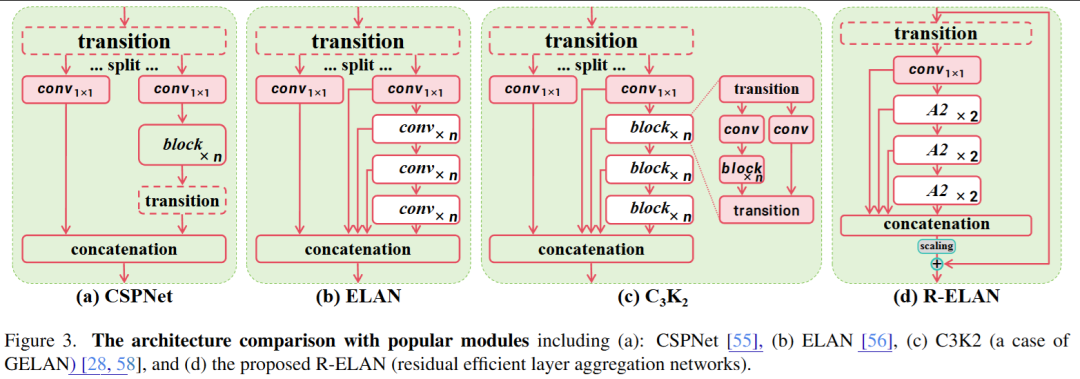
  • YOLOv12 引入了 Attention‑Centric 的架构,使 YOLO 能够在 实时 任务中有效地集成 注意力机制,通过全局信息捕捉提升模型性能,同时保证推理速度。
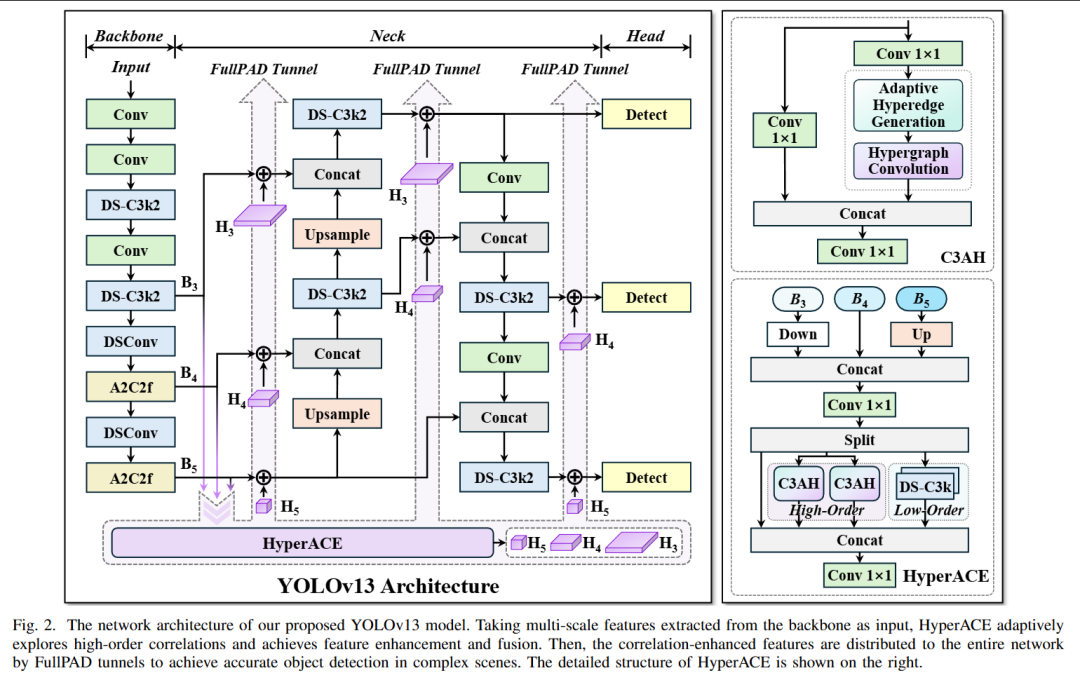
  • YOLOv13 进一步扩展了这一思路,提出了 Hypergraph‑Enhanced Adaptive Visual Perception(超图增强视觉感知)机制,极大地提升了对 复杂场景(如遮挡、多目标)下的检测能力,并引入了更高效的 全局关联建模。
  • 这些新版本的核心优势在于:加强对全局信息的建模,提高了检测精度,尤其在复杂场景(如多物体交互)中表现更为出色。

4. 版本纵览(v1 → v13)与关键要点

版本关键技术优点局限性
v1基本回归化检测实时检测,结构简单小目标检测差,定位精度低
v2锚框、多尺度多尺度检测,精度提升计算开销增加,仍受制于硬件限制
v3Darknet-53, 三尺度更强的骨干网络与小目标检测参数量大,实时性有所下降
v4CSPDarknet、PANet高精度与速度兼顾,良好的泛化能力结构复杂,部署成本较高
v5PyTorch 实现方便部署与扩展,支持多任务训练过于依赖硬件,部署面临挑战
v6–v8多任务、分割与姿态支持多功能一体化,适应多场景需求精度提升有限,无法全面覆盖开放类别
v9–v11GELAN、PGI提高信息流与梯度传播,精度提升在极限硬件上可能表现不佳
v12Attention‑Centric强化全局感知,提升精度与实时性推理加速仍是挑战,尤其在低延迟场景下
v13Hypergraph‑Enhanced高阶全局关联建模,提升复杂场景表现计算量增加,模型过大可能影响实时性

5. 最新系列作品与研究趋势

5.1 开放类别与提示化检测:YOLO‑World 与 YOLOE
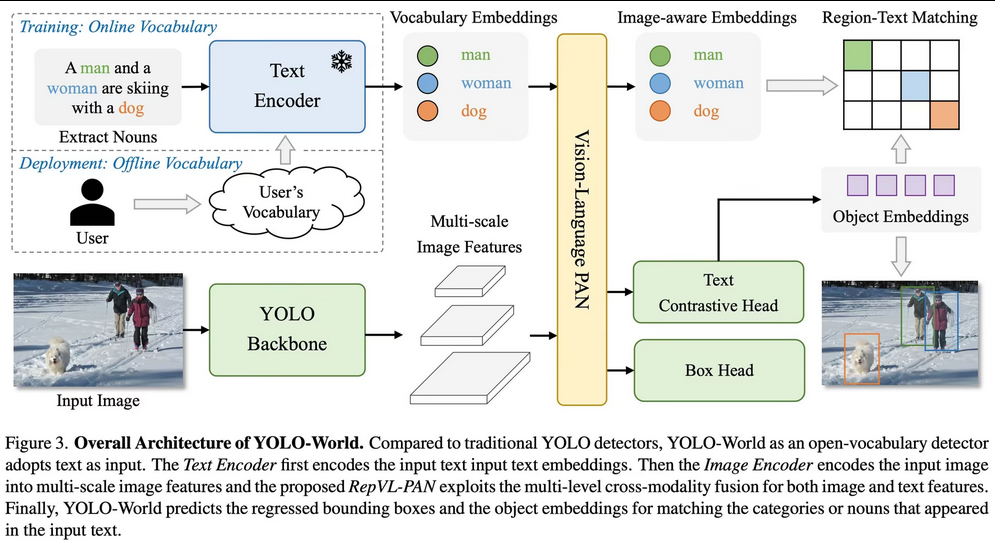
YOLO‑World: Real‑Time Open‑Vocabulary Object Detection

YOLO‑World 打破了传统 YOLO 模型在类别检测上的限制,提出了开放词汇检测能力。该模型通过视觉-语言特征融合,使得 YOLO 能够根据不同的文本描述来识别任意类别的物体,而不需要重新训练模型,极大地增强了模型的适应性。具体技术包括RepVL‑PAN网络结构和region‑text 对比损失,使得视觉区域与文本描述之间的对应关系更加紧密,从而能够更好地处理动态类别。它的推理速度与传统 YOLO 系列保持一致,适合实时检测任务。

YOLOE: Real‑Time Seeing Anything
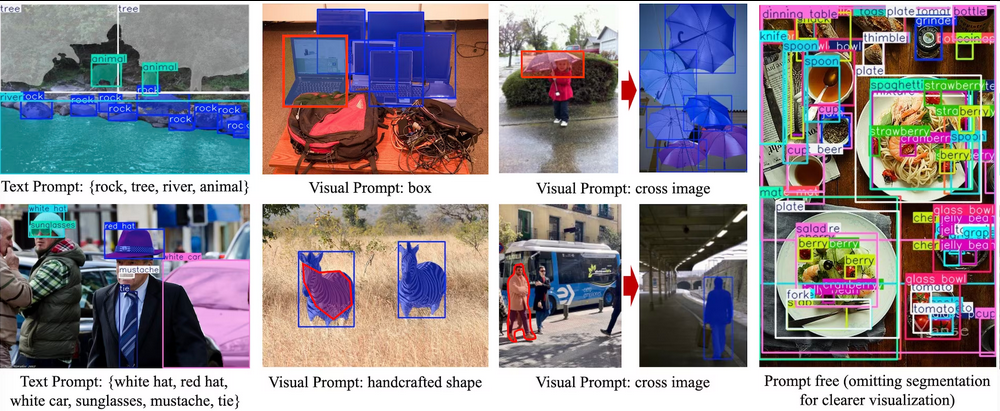
YOLOE 进一步推进了 YOLO‑World 的方向,不仅支持开放类别检测,还实现了多任务(检测+分割)一体化。YOLOE通过引入RepRTA和SAVPE模块,能够同时处理文本提示、视觉提示以及无提示的开放类别任务,进一步增强了 YOLO 在处理各种复杂场景下的能力。其性能在 LVIS 数据集上有显著提升,相比 YOLO‑World,YOLOE 在训练与推理的效率上也表现出色,适合工业级实时应用。

总结:这两篇文章展示了 YOLO 在 开放词汇 和 多任务 领域的应用,意味着 YOLO 正在从单一的检测器向 多模态理解 和 通用视觉模型 转变。这些变体可以视为 YOLO 系列风格 B 的进一步探索。


6. 大模型时代下的 YOLO:问题域与能力版图

6.1 从“局部卷积”到“全局注意力/高阶关联”

  • 局部–全局的鸿沟:卷积擅长局部模式捕捉,但在远距离依赖和多对象交互上有限;注意力则擅长全局依赖,极大地扩展了模型的感知范围。
  • YOLOv12/v13 的转折:YOLO系列逐步从局部卷积逐步引入注意力机制,加强了对复杂场景(如多目标、遮挡)的建模能力。
  • YOLOE 和 YOLO‑World:更进一步,YOLOE 和 YOLO‑World 引入了视觉‑语言特征融合和开放类别能力,推动了YOLO系列向更加通用的视觉理解迈进。

6.2 训练与数据:从“有监督小闭环”到“更开放的大循环”

  • 自监督/大规模预训练的融合:借鉴 MAE 和 ViT 的成功经验,YOLO 系列可能会更多地引入大规模的 自监督预训练,以进一步提升其性能和泛化能力。
  • 开放类别与提示化检测:YOLO‑World 和 YOLOE 展示了 YOLO 向 开放类别 和 多模态任务 扩展的潜力,标志着它从传统的“固定类别检测器”逐步迈向了“通用视觉模型”。

6.3 部署与生态:让“大模型特性”以“小预算”落地

  • 轻量化高阶结构:YOLOv13 用深度可分离卷积等方法减少了大模型的计算成本,在保证精度的同时,实现了推理速度的提升。
  • 工具链的完善:YOLO 系列从 PyTorch 实现 到 ONNX/TensorRT 导出,其工具链逐步完善,使得部署和迁移更加灵活。

7. 总结

YOLO系列自2015年提出以来,从实时检测走向了大模型时代的全局关联建模,其中 YOLOv12 和 YOLOv13 带来了 全局注意力、开放词汇检测、视觉-语言融合 等技术的创新。而YOLO‑World和YOLOE则进一步将YOLO推向了多任务/多模态理解的方向,提供了更为通用的视觉识别能力。在大模型时代,YOLO依然保持着其高效、实时的优势,同时不断拓宽其能力边界

随着未来技术的不断进步,YOLO 可能会在 大规模预训练、跨模态融合 等方面取得进一步突破。对于从事实际应用的研究人员和工程师,理解 YOLO 系列的技术演变以及最新的进展,能为构建更智能、更高效的视觉识别系统提供有力支持。

如何学习大模型 AI ?

由于新岗位的生产效率,要优于被取代岗位的生产效率,所以实际上整个社会的生产效率是提升的。

但是具体到个人,只能说是:

“最先掌握AI的人,将会比较晚掌握AI的人有竞争优势”。

这句话,放在计算机、互联网、移动互联网的开局时期,都是一样的道理。

我在一线互联网企业工作十余年里,指导过不少同行后辈。帮助很多人得到了学习和成长。

我意识到有很多经验和知识值得分享给大家,也可以通过我们的能力和经验解答大家在人工智能学习中的很多困惑,所以在工作繁忙的情况下还是坚持各种整理和分享。但苦于知识传播途径有限,很多互联网行业朋友无法获得正确的资料得到学习提升,故此将并将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。

在这里插入图片描述

第一阶段(10天):初阶应用

该阶段让大家对大模型 AI有一个最前沿的认识,对大模型 AI 的理解超过 95% 的人,可以在相关讨论时发表高级、不跟风、又接地气的见解,别人只会和 AI 聊天,而你能调教 AI,并能用代码将大模型和业务衔接。

  • 大模型 AI 能干什么?
  • 大模型是怎样获得「智能」的?
  • 用好 AI 的核心心法
  • 大模型应用业务架构
  • 大模型应用技术架构
  • 代码示例:向 GPT-3.5 灌入新知识
  • 提示工程的意义和核心思想
  • Prompt 典型构成
  • 指令调优方法论
  • 思维链和思维树
  • Prompt 攻击和防范
  • …

第二阶段(30天):高阶应用

该阶段我们正式进入大模型 AI 进阶实战学习,学会构造私有知识库,扩展 AI 的能力。快速开发一个完整的基于 agent 对话机器人。掌握功能最强的大模型开发框架,抓住最新的技术进展,适合 Python 和 JavaScript 程序员。

  • 为什么要做 RAG
  • 搭建一个简单的 ChatPDF
  • 检索的基础概念
  • 什么是向量表示(Embeddings)
  • 向量数据库与向量检索
  • 基于向量检索的 RAG
  • 搭建 RAG 系统的扩展知识
  • 混合检索与 RAG-Fusion 简介
  • 向量模型本地部署
  • …

第三阶段(30天):模型训练

恭喜你,如果学到这里,你基本可以找到一份大模型 AI相关的工作,自己也能训练 GPT 了!通过微调,训练自己的垂直大模型,能独立训练开源多模态大模型,掌握更多技术方案。

到此为止,大概2个月的时间。你已经成为了一名“AI小子”。那么你还想往下探索吗?

  • 为什么要做 RAG
  • 什么是模型
  • 什么是模型训练
  • 求解器 & 损失函数简介
  • 小实验2:手写一个简单的神经网络并训练它
  • 什么是训练/预训练/微调/轻量化微调
  • Transformer结构简介
  • 轻量化微调
  • 实验数据集的构建
  • …

第四阶段(20天):商业闭环

对全球大模型从性能、吞吐量、成本等方面有一定的认知,可以在云端和本地等多种环境下部署大模型,找到适合自己的项目/创业方向,做一名被 AI 武装的产品经理。

  • 硬件选型
  • 带你了解全球大模型
  • 使用国产大模型服务
  • 搭建 OpenAI 代理
  • 热身:基于阿里云 PAI 部署 Stable Diffusion
  • 在本地计算机运行大模型
  • 大模型的私有化部署
  • 基于 vLLM 部署大模型
  • 案例:如何优雅地在阿里云私有部署开源大模型
  • 部署一套开源 LLM 项目
  • 内容安全
  • 互联网信息服务算法备案
  • …

学习是一个过程,只要学习就会有挑战。天道酬勤,你越努力,就会成为越优秀的自己。

如果你能在15天内完成所有的任务,那你堪称天才。然而,如果你能完成 60-70% 的内容,你就已经开始具备成为一名大模型 AI 的正确特征了。

这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】

在这里插入图片描述

Yolo-World和YoloE模型说明及测试 文本到图像的生成:虽然CLIP本身不是一个生成模型,但它的编码器(Encoder)可以与生成模型(如GANs)结合,用于生成与文本描述相匹配的图像。跨模态对比学习:CLIP通过最小化正样本对(pair)之间的距离并最大化负样本对(pair)之间的距离来进行训练,从而学习图像和文本之间的相关性。它的作用主要包括:图像和文本的联合表示学习:CLIP通过在大量图像和文本对上进行预训练,学习将。CLIP模型因其强大的通用性和灵活性,在图像和文本的多模态任务中被广泛研究和应用。训练数据的情况下,识别或预测这些类别。 阅读详情

相关推荐

【全面认知YOLO系列】第一部分:YOLO系列模型发展史

YOLO V1(You Only Look Once version 1)是YOLO系列模型的第一个版本,由Joseph Redmon等人于2015年提出。相比于传统的目标检测方法,YOLO V1采用了全新的设计思路和网络结构,实现了端到端的目标检测,具有较高的检测速度和简单的设计。网络结构:YOLO V1模型采用卷积神经网络(CNN)作为基础网络结构,在输入图像上进行卷积操作,提取图像特征。单次预测。

今晚打老虎的专栏 1万+

通俗易懂的YOLO系列(从V1到V5)模型解读!

点击上方“小白学视觉”,选择加"星标"或“置顶”重磅干货,第一时间送达0 前言本文目的是用尽量浅显易懂的语言让零基础小白能够理解什么是YOLO系列模型,以及他们的设计思想和改进思路分别是什...

小白学视觉 4万+

YOLOv26【第六章:开放词汇实例分割篇·第2节】YOLOE-26 与 YOLO26 的关系:端到端架构 + 开放词汇能力!

🏆 本文收录于 《YOLOv26实战:从入门到深度优化》 专栏。该专栏系统复现并梳理全网各类 YOLOv26 改进与实战案例(当前已覆盖分类 / 检测 / 分割 / 追踪 / 关键点 / OBB 检测等方向),坚持持续更新 + 深度解析,质量分长期稳定在 97 分以上,可视为当前市面上 覆盖较全、更新较快、实战导向极强 的 YOLO 改进系列内容之一。

**My Coding Family** 387

目标检测:YOLO 模型详解

YOLO 模型凭借其高效的端到端检测能力,在实时目标检测领域取得了显著的成果。:在前几代 YOLO 的基础上,对损失函数进行了进一步的优化和完善,使其能够更好地平衡边界框定位误差和类别分类误差之间的关系,并且针对不同尺度特征图的预测结果采用了不同的损失权重,以提高模型在不同尺度上的检测效果。:进一步改进了损失函数,采用了不同尺度特征图的损失加权求和的方式,使得模型在不同尺度上的检测结果都能够得到有效的优化,并且对边界框的坐标、宽度高度以及类别置信度的误差计算都进行了精细化的设计,以提高整体检测性能。

分享学习期间的笔记心得 1万+

【YOLOv8/v9/v10 实战 06】YOLO发展简史:从v1到v10的演进与关键突破

YOLO从v1到v10历经十年迭代,始终引领实时目标检测技术。本文系统梳理了各版本的核心创新:v1开创单阶段回归范式;v2引入锚框与Darknet-19;v3实现多尺度预测;v4集成CSPDarknet与Mosaic等训练技巧;v5引爆PyTorch生态;v6采用重参数化;v7提出高效聚合。重点对比v8、v9、v10三大当代版本的架构差异:v8采用解耦头与TaskAlignedAssigner;v9通过可编程梯度信息解决信息瓶颈;v10实现一致双重分配彻底消除NMS。文章结合代码、性能基准与实战案例,帮助读

专注于人工智能、软件开发、工控自动化、工厂数字化及智能化等领域,希望和大家共同进步! 298

全志Longan和Tina系统T113-S3-(Tina Linux 系统介绍)

Tina Linux是全志科技基于Linux内核开发的针对智能硬件类产品的嵌入式软件系统。Tina Linux基于openwrt-14.07 版本的软件开发包,包含了 Linux 系统开发用到的内核源码、驱动、工具、系统中间件与应用程序包。Tina系统软件架构如图所示。从下至上分别为Kernel && Driver、Libraries、System Services、Applications 四层。

szembed的博客 6337

OpenCV、YOLO与大模型的区别与关系

OpenCV是基础工具库,解决传统图像处理问题。YOLO是高效的深度学习模型,解决特定任务(目标检测)。大模型是通用人工智能的探索,解决复杂、跨模态任务。在实际项目中,三者可结合使用:OpenCV 处理数据流,YOLO 负责实时检测,大模型完成高层语义理解或生成。

具身小站 4962

解决PubMed卡在“正在检查浏览器”页面的完整排查指南

DNS解析是将域名转换为IP地址的基础网络服务,其稳定性和准确性直接影响网站访问。当DNS服务器响应缓慢或返回异常结果时,可能导致客户端与服务器建立连接时出现偏差,从而触发网站的安全验证机制,例如Cloudflare等安全服务提供的浏览器环境检查。这一机制旨在防御恶意流量,但偶尔也会误拦截正常访问。在生物医学信息检索领域,PubMed作为核心文献数据库,其稳定访问对科研工作流至关重要。针对因DNS或本地缓存问题导致的‘正在检查浏览器’页面卡顿,通过刷新DNS缓存、更换为Google Public DNS或C

weixin_29597551的博客 3639

YOLOv1-7全系列模型大合集,学习记录和思考

YOLO系列V1~V7,模型框架各个部分的理解学习。

qq_53250079的博客 3242

多目标进化算法——NSGA-II(python实现)

NSGA-II(python实现)--最全注释,痴呆能懂--

no___good的博客 5279

Unity通用Buff系统,Buff编辑器(1,理论篇)(技能系统之Buff篇)

逻辑层根据游戏的规则和设计,控制Buff的生命周期、影响目标对象的属性或行为,以及处理Buff的交互和冲突。Buff堆叠和冲突:有些游戏中允许同类型的Buff叠加,以增加效果的强度,而有些游戏中可能不允许Buff叠加,只能由更强力的Buff来覆盖较弱的Buff。灵活个性化:每个游戏对象拥有自己的BuffManager,可以实现个体对象的独特Buff效果,增加游戏的多样性和个性化。自由控制:每个对象独立管理自己的Buff,可以自由地激活、更新和移除Buff效果,提供更精细的控制和逻辑实现。

u010082265的博客 4694

大模型时代,为什么工业界还在疯狂用 YOLO?算完这笔账,我沉默了

这两年大模型太火了,火到很多人忘了一个基本事实——99% 的 AI 应用场景,根本用不起大模型。一个工厂的质检摄像头,不需要理解莎士比亚;一台送餐机器人,不需要和你聊人生哲学。它们只需要又快又准地完成一件事:看懂眼前这一帧画面,然后做出反应。这就是 YOLO 系列存在的意义,不是所有 AI 都要追求"大而全",有时候"小而美"才是真正的生产力。

夕小瑶科技说 1582

Python爬虫实战:高效爬取中国版权登记数据

本文将详细介绍如何使用Python最新技术栈构建一个高效、稳定的中国版权登记数据爬虫系统。我们将使用Playwright+Asyncio实现无头浏览器自动化,结合Redis分布式任务队列和MongoDB数据存储,打造一个能够应对反爬机制的企业级数据采集方案。文章包含完整代码实现、性能优化技巧以及法律合规建议,帮助开发者快速掌握大规模数据采集的核心技术。本文详细介绍了2024年使用Python最新技术栈构建中国版权登记数据爬虫的完整方案。基于Playwright的无头浏览器自动化。

2201_76125261的博客 1899

AI大模型介绍yolo

速度快准确率高可解释性强适用性广rcnn使用区域建议方法,首先在一张图像中产生可能的边界框。分类后,利用后处理对边界框进行细化,消除重复检测,并根据场景中的其他对象边界框进行重新扫描,这些复杂的流水线很慢。并且因为每个独立的部分都需要被分开训练,所以很难优化。yolo模型原理:将目标检测重新定义为一个单一的检测问题,从图像像素直接到边界框坐标和类别概率。使用过一个卷积神经网络同时预测多个边界框和这些框类别概率。模型在完整的图像上训练,并直接优化检测性能。

weixin_43941538的博客 1513

语音识别:PyAudio、SoundDevice、Vosk、openai-whisper、Argos-Translate、FunASR(Python)

本文介绍了Python中常用的音频处理库PyAudio,详细解析了其核心功能、核心概念和典型工作流程。PyAudio是一个跨平台的音频I/O库,支持音频录制、播放、实时流处理和低延迟操作。核心概念包括PyAudio类(管理音频设备和流)和Stream类(代表音频流)。文章重点讲解了open()方法的关键参数、回调函数的使用方式以及典型的工作流程,包括设备查询、流配置和资源释放。PyAudio适用于需要实时音频处理的场景,如语音识别和音频效果处理。

算法工程师 706

ESP8266-Arduino网络编程实例-异步TCP客户端

本次实例将使用ESPAsyncTCP库实现一个简单的客户端。

视觉与物联智能 1741

大模型微调平台推荐:一键训练YOLO模型

本文介绍基于大模型微调平台的YOLO镜像化训练方案,涵盖其在工业质检中的应用、容器化部署优势、YOLO算法演进及性能表现,并提供数据增强、训练监控和模型优化等工程实践建议,助力企业快速实现AI视觉落地。

weixin_35636570的博客 742

IMSL CNL 7.0.0 (x86-64)Crack

IMSL CNL 7.0.0 (x86-64)Crack intel的算法库破解文件,这是C++版本的破解文件

【深度学习项目】目标检测之YOLO系列详解(一)

YOLO(You Only Look Once)是一种实时目标检测算法,由Joseph Redmon等人提出。与传统的基于滑动窗口和区域提案的目标检测方法不同,YOLO将目标检测问题框架化为一个单一的回归问题,直接从图像像素预测边界框和类别概率。YOLO有多个版本,如YOLOv2, YOLOv3, YOLOv4, YOLOv5到YOLO11,每个新版本都在尝试改进其前代产品的性能,提高检测精度和速度,同时减少错误类型,比如背景假阳性。YOLOv3引入了多尺度预测,增强了小物体的检测能力;

专注上位机开发、机器视觉、机器学习、嵌入式软硬件开发 7334

假人有限元模型

假人模型,车辆碰撞假人有限元模型,适合做乘员安全的研究者利用

Camera2Demo

在Camera2 的基础上进行封装,使得Camera2一堆初始化逻辑与Activity分离,降低耦合度,完成预览拍照并保存的操作

《零基础入门AI:YOLO目标检测模型详解(从基础概念到YOLOv1核心原理)》

是一种革命性的单阶段目标检测方法,由Joseph Redmon等人于2016年提出。它将目标检测任务视为一个统一的回归问题,直接从完整图像中一次性预测出所有目标的边界框坐标和类别概率。YOLOv1的设计灵感来源于GoogleNet,因其极快的检测速度(45 FPS)和独特的“一次看完整张图”思想而得名。它将目标检测建模为一个回归问题,仅需一次前向传播即可输出所有检测结果。处理流程:将输入图像调整为固定尺寸(448×448)。:通过24层卷积+2层全连接网络进行特征提取与预测。

m0_75034893的博客 2639

怀旧版电脑GBC模拟器

再现原版GBC掌机的界面,电脑运行连游戏界面都一样大小,很怀旧,很真实,(英文版)强烈推荐,很小的文件,很难才找到的。

人工智能大模型原理与应用实战:从YOLO到Faster RCNN 2

1.背景介绍 人工智能(Artificial Intelligence, AI)是一门研究如何让计算机自主地完成人类常见任务的学科。在过去的几年里,人工智能技术的发展取得了显著的进展,尤其是在深度学习(Deep Learning)领域。深度学习是一种通过神经网络模拟人类大脑工作原理的机器学习方法,它已经被广泛应用于图像识别、自然语言处理、语音识别等领域。 在图像识别领域,目标检测是一项重要的任...

AI天才研究院 629

【多模态大模型】的正确打开方式——图片

# 早期痛点 识别图片中的物体,早期可以使用Yolo 但是缺点也很明显: - 训练时间长 - 成本高 - 泛华性能差 - 通用识别领域覆盖有限 优点: - 特殊领域识别 # 大模型出现 大模型出现后,一些大模型对接了图片识别相关的模型,实现了图片识别,然后转换成文本再返回给大模型。 这样,基本实现了识别图片中存在的物体,但是仍然无法代替一般的Yolo应用,因为它无法提供物体在图片中的坐标信息。 因为图片模型“转换成文本再返回给大模型”,丢失了很多信息,无法完成这样的需求。 # 多模态大模型如何代替

Deng_Xian_Sheng的博客 1264

多模态大模型也能识别一些图元,那还有用yolo的必要么

目标推荐方式提升图元分类精度方案 1:裁剪 + MLLM 细分类理解系统拓扑/逻辑方案 2:全图 + YOLO 坐标提示快速构建标注数据用 MLLM 自动生成标签 → 训练 YOLO工业部署YOLO 为主,MLLM 仅用于疑难样本(降低 API 成本)记住YOLO 是主力(快、准、轻量)MLLM 是顾问(慢、贵、智能)不要为了用大模型而用大模型,以解决问题为导向。

caoyongsheng的博客 1326

别卷单模态了!YOLO+多模态 才是未来场景实战的“天选方案”

本文系统梳理了YOLO在多模态目标检测领域的最新进展,重点分析了如何通过融合红外、深度图、文本等多源信息突破RGB单模态的感知局限。文章围绕轻量化融合、动态模态选择、开放词汇检测等方向,深入探讨了MM-YOLO、YOLO-World等代表性工作采用的门控机制、模态对齐策略与跨模态语义引导方法。研究表明,YOLO正从单一图像检测器向多模态感知平台演进,在自动驾驶、安防监控等复杂场景展现出更强的环境适应能力。未来,动态融合策略、开放词汇支持和轻量化部署将成为多模态YOLO发展的关键方向。

Q2024107的博客 1051

yolo-world:”目标检测届大模型“

YOLO在标准基准测试中,World 的速度和效率超过了现有的开放词汇检测器,包括 MDETR 和 GLIP 系列,展示了YOLOv8 在单个 NVIDIA V100 GPU 上的卓越性能。YOLO属于经典的传统AI模型,即经过有监督的训练后,模型学习到特征与标签间的关联关系,可对图像、视频中出现的物体进行特征检测,负荷已知特征的物体图像会被打上标签和置信度。:利用 CNN 的计算速度,YOLO-World 可提供快速的开放词汇检测解决方案,满足各行业对即时结果的需求。

2231

人工智能任务7-计算机视觉必备模型YOLO系列模型的知识点,提供YOLOv1-v8模型结构与代码实例

计算机视觉作为人工智能领域的一个重要分支,近年来取得了飞速的发展,而目标检测作为其基础且关键的任务之一,更是吸引了众多研究者的关注。在这片技术热土上,YOLO(You Only Look Once)系列模型以其创新的设计理念和卓越的性能表现,成为了目标检测领域的明星算法,广泛应用于监控、自动驾驶、图像识别等多个场景。通过上述代码样例,我们不仅展示了如何加载YOLO系列的不同版本模型,还演示了如何进行基本的目标检测操作。

微学AI的博客 3148
上一篇: 【智能体开发新范式】一文掌握MCP,构建你的“AI工具链”知识体系!
下一篇: 【多模态】从HunyuanOCR看RL+VLM(附:腾讯技术专家解读与核心思想)
Python_金钱豹
博客等级 码龄5年 1万+粉丝 2835原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值