颠覆认知!3B小模型也能做多模态Agent?Skywork R1V4-Lite实测,效果炸裂!

「文智助手」全场景办公AI助理AI+OPC全流程实践方案(大赛作品) 阅读详情

昨天刷到了昆仑万维发布了一个Skywork R1V4-Lite模型,只有3B的激活参数,

就可以主动操作图像、调用外部工具、图文交互深度检索,是一个多模态Agent模型。

技术核心是,R1V4-Lite 加上了主动操作,训练过程引入图像操作和深度推理交互训练,做到 All-in-One,

让小模型从源头具备更清晰的任务规划与搜索增强的能力。

30B-A3B是不是很眼熟,

没错,它是基于Qwen3-VL-30B-A3B增量训练的,

还有它仅使用了3万条后训练数据,再次体现了高质量数据的重要性。

最终整体榜单的效果,在感知和深度研究上全面超越Qwen3-VL-30B-A3B和Gemini2.5-Flash。
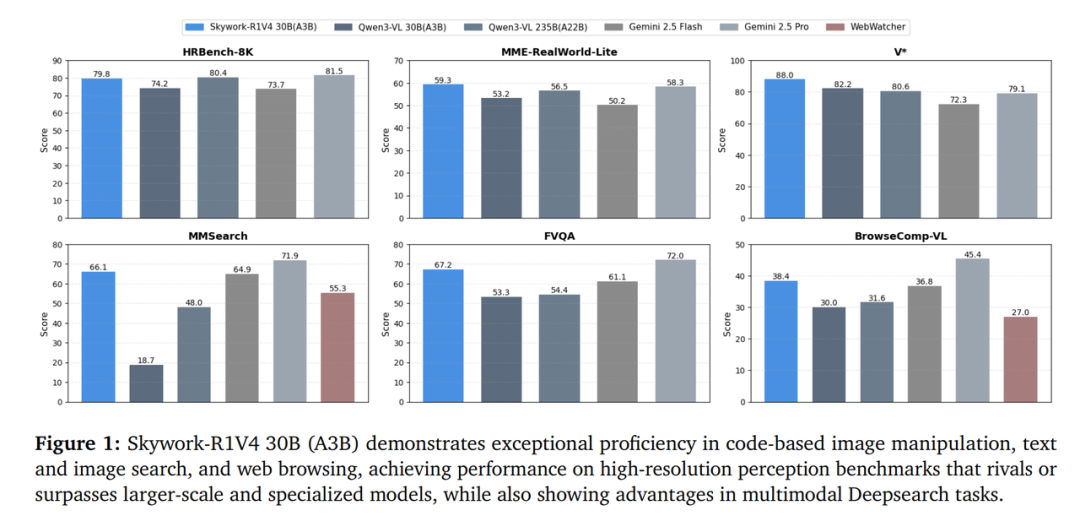
榜单重要也不重要,

因为我们是主打实测,哈哈哈,

来看看R1V4-Lite模型的整体效果到底如何,

懒人不爱看版本:

  • 因为训练数据以英文为主,所以思维链和回答会以英文为主,你问了中文也会回答英文,当然你可以额外加上指令“请用中文回答”,那会用中文回答
  • 找位置,简直无敌,由于带有图片裁剪、放大等操作,再加上图片检索,找图片位置简直是一绝
  • 较低分辨率的内容可以识别的比较好,因为会先放大
  • 计算推理一般,因为有代码操作,会默认用代码进行计算,但代码部分模型做的图像变换比较多
  • 其他能力就依赖于原始Qwen3-VL的能力了,比如时钟识别依然是问题
  • 纯Plan能力,我没专门测试,感兴趣自己可以去测测
  • 速度很快A3B让模型输出嗖嗖的

先看几个常规的模型能力,

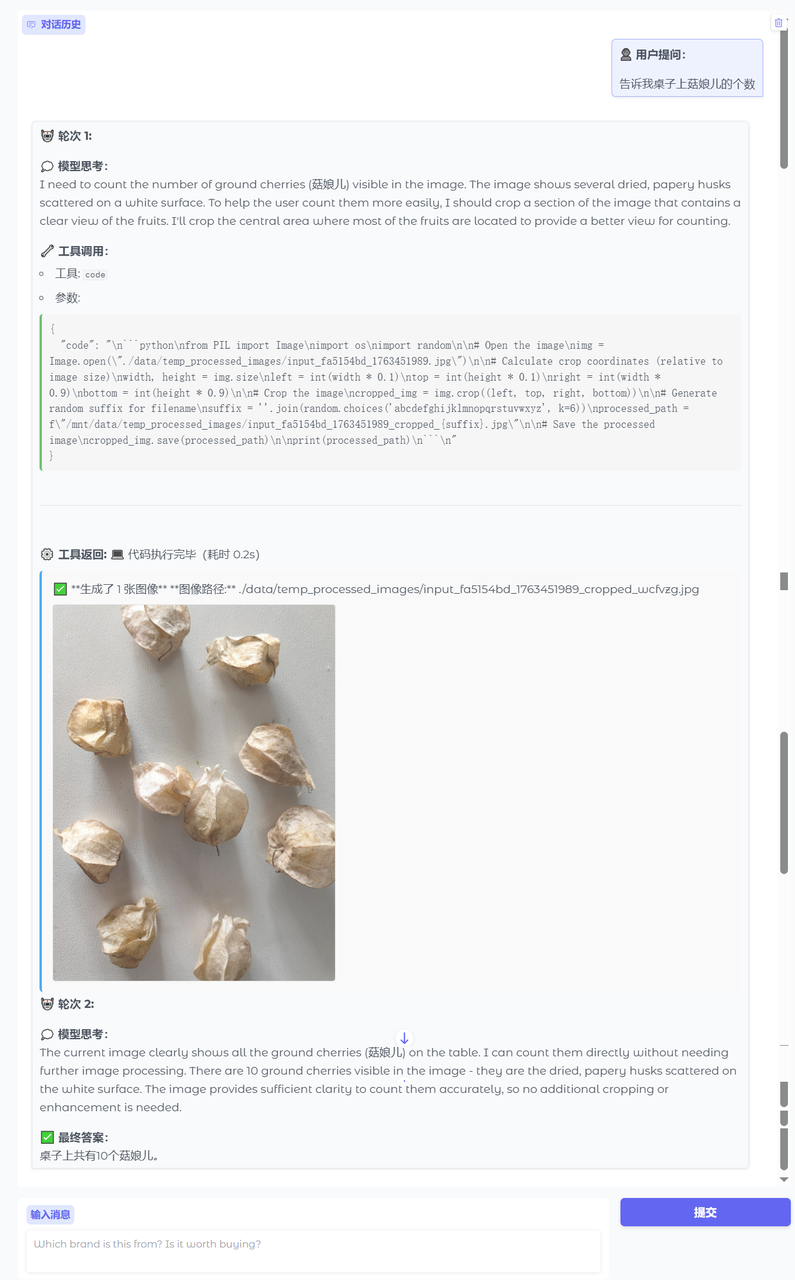
目标识别,数数,考察模型基本查个数的能力,“告诉我桌子上菇娘儿的个数”
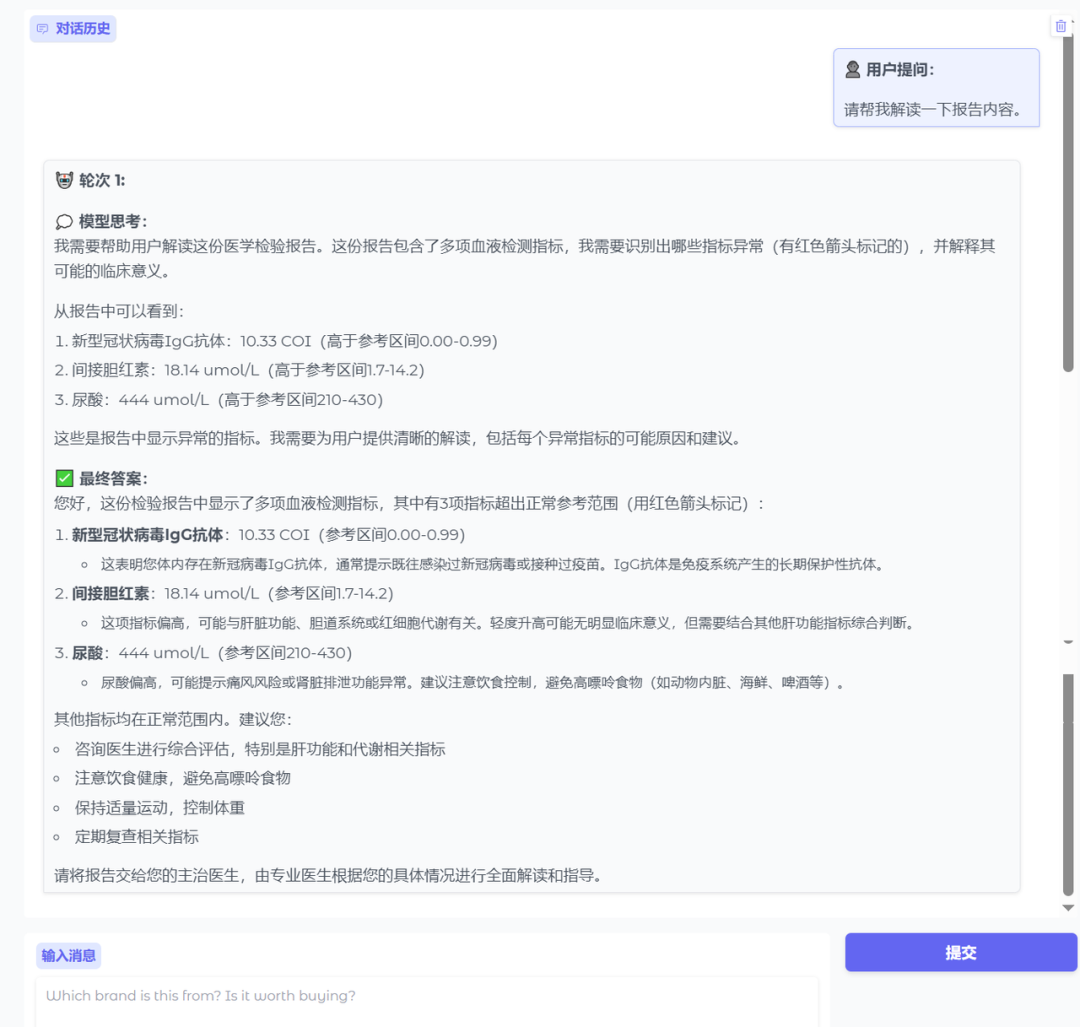
报告解读,考察模型内容理解能力、知识储备的能力。“请帮我解读一下报告内容”
表格识别,内容提取和指令跟随能力,
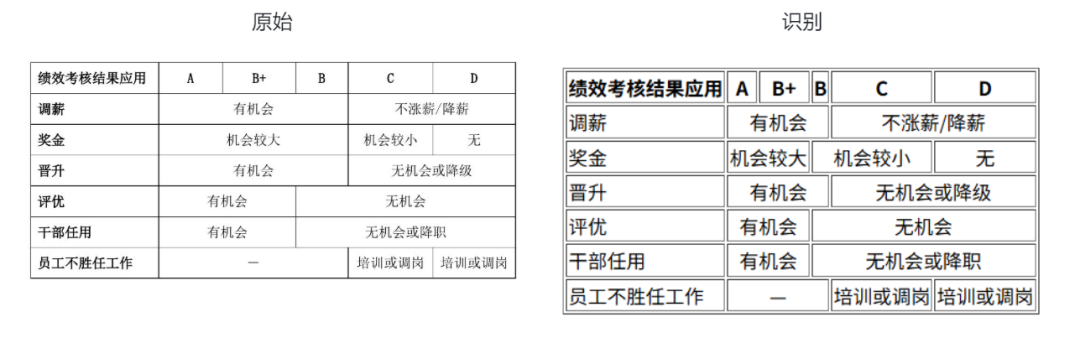
但,并不是所有表格都很好,对于字数较多的表格,还原起来就没有那么好。

除了常规预测外,因为可以精准调用外部工具,同时R1V4-Lite可以进行自动图片裁剪、放大、翻转,所以对于定位、细粒度分析的内容效果会格外的好。

比如,之前所有VLM大模型都回答不了的“上海金茂大厦”位置,R1V4-Lite精准回答。
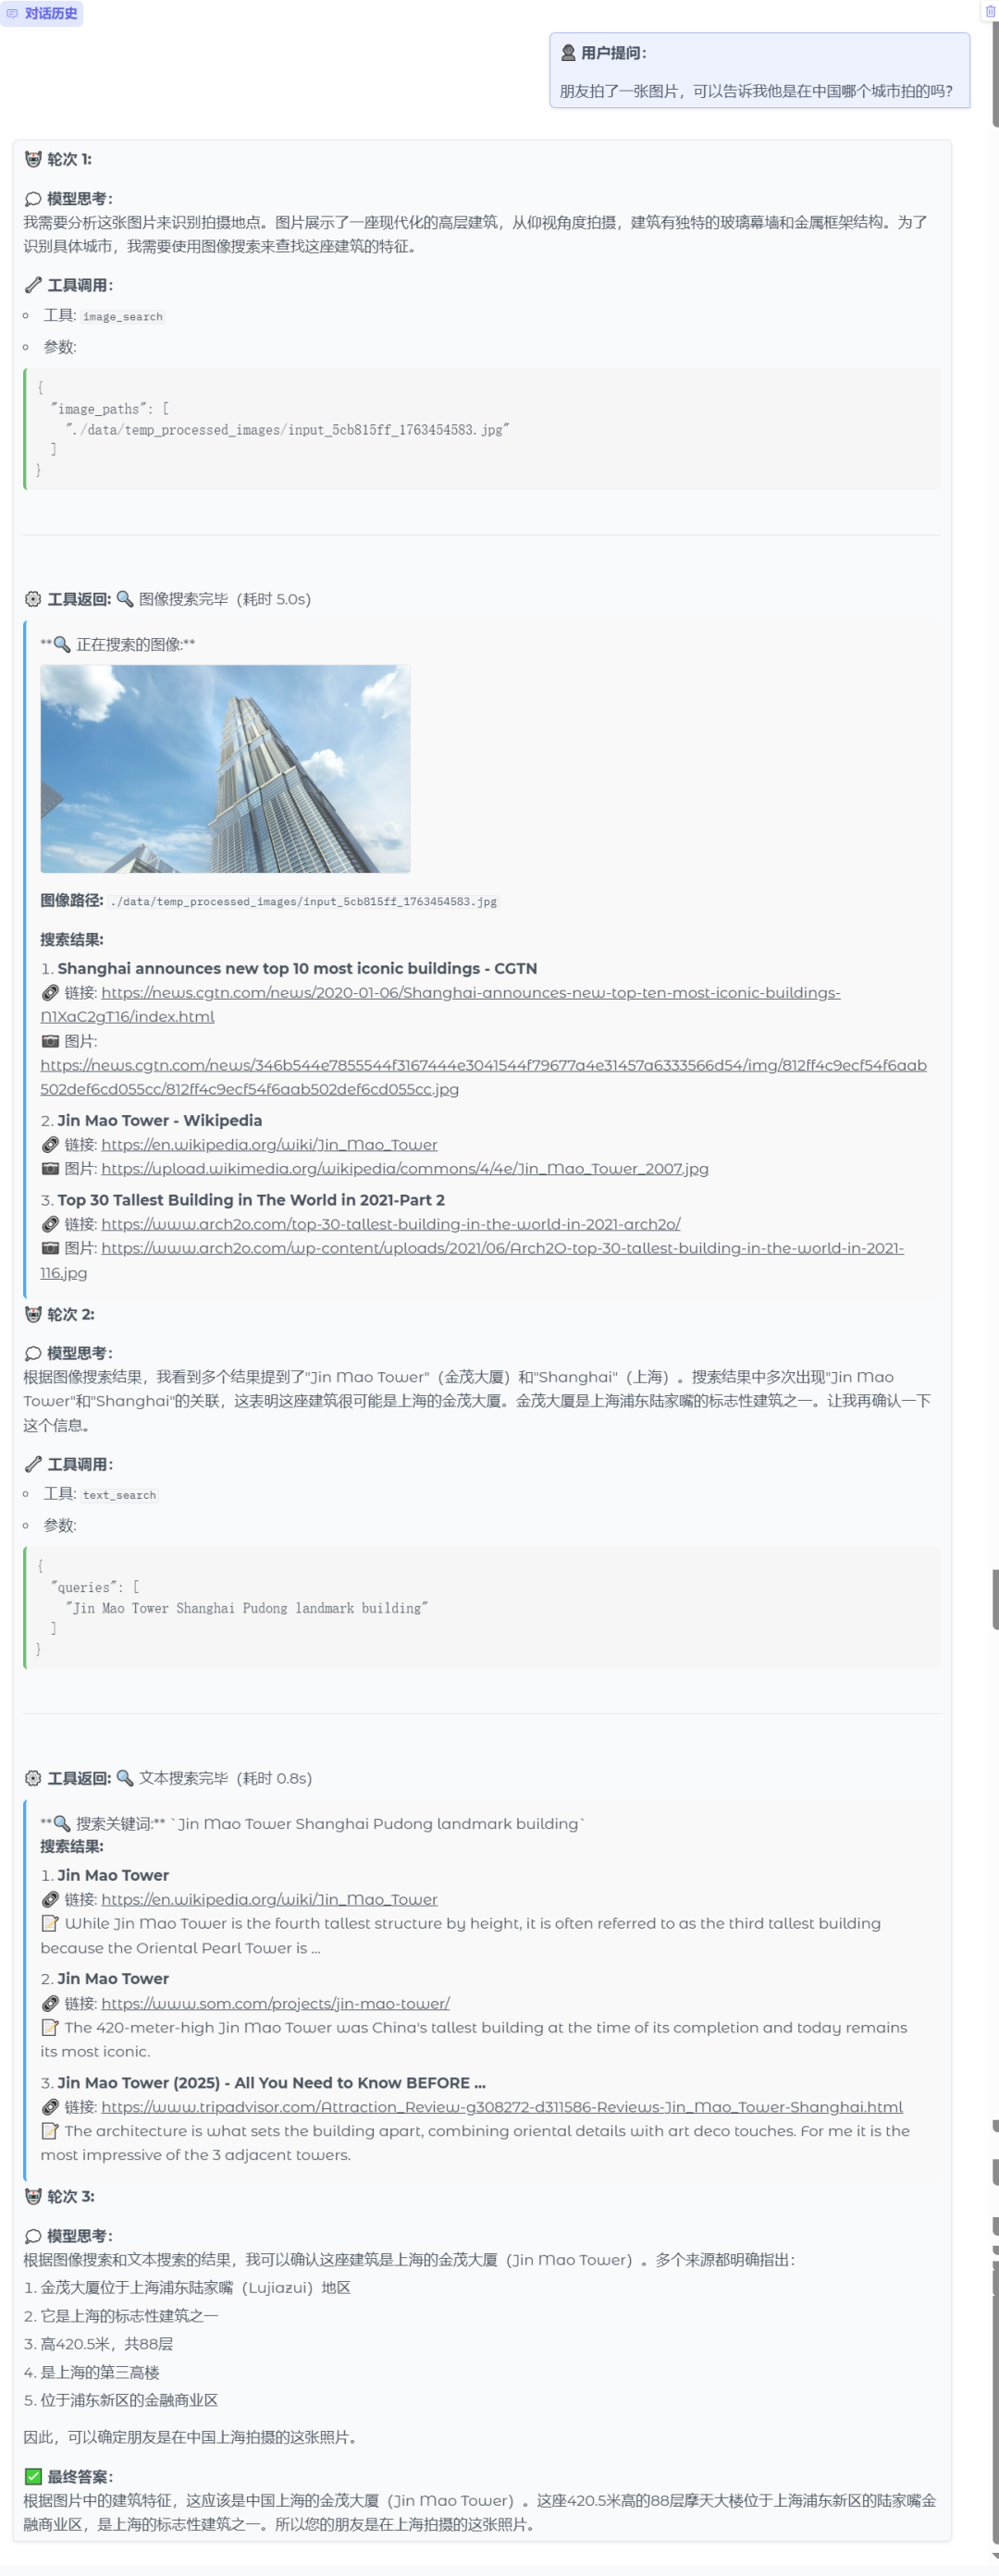
用了图像搜索,所以你说他作弊,也行,但是也是实打实的找对了。

注意它的图像思考和检索是交互存在的,并不割裂,所以找的也更准

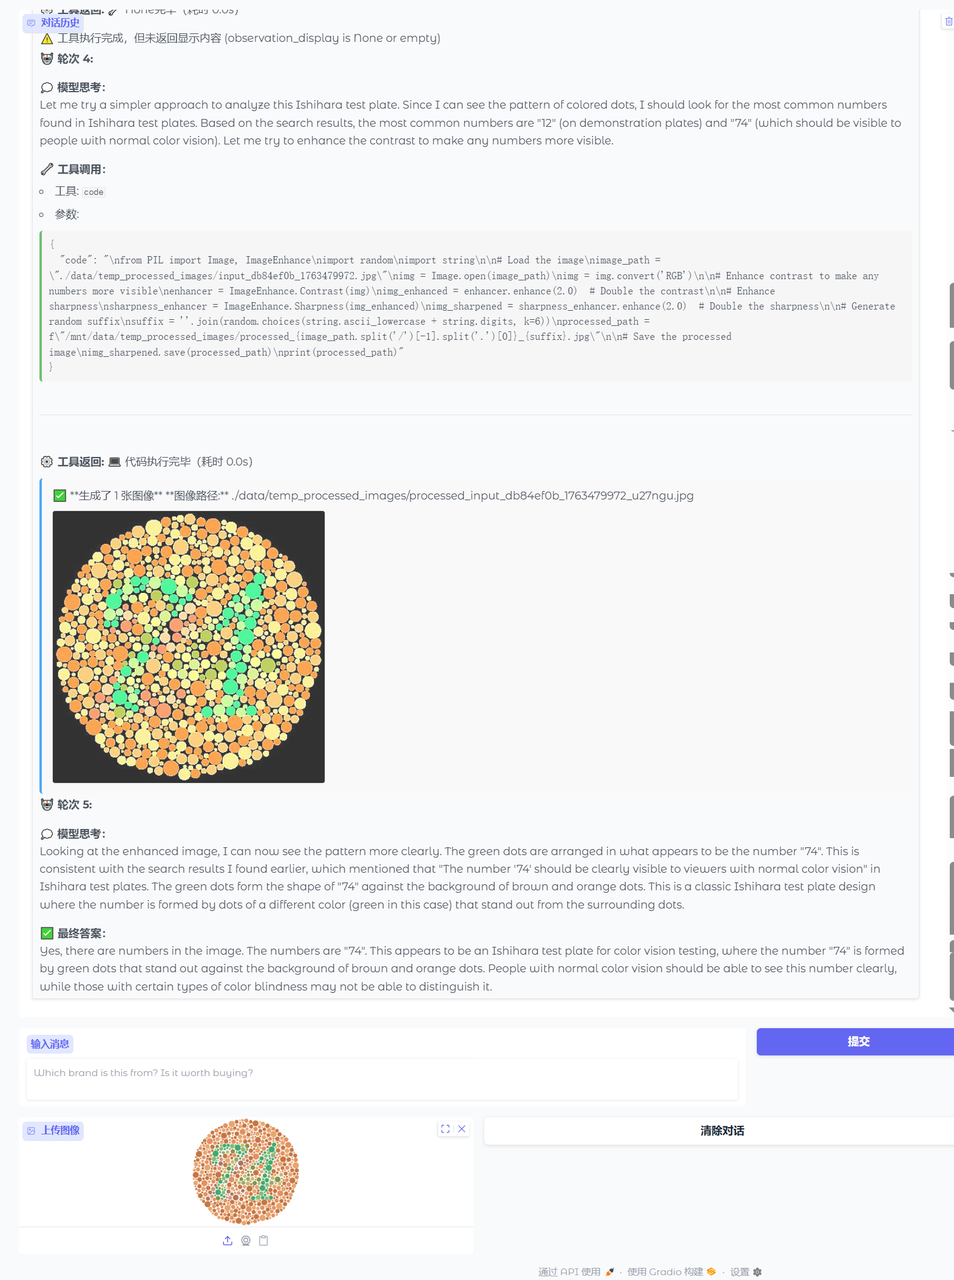
色盲测试,会对图片进行一系列操作,主要提高图片的对比度,让这些数字更清晰可见,下图,很直观。
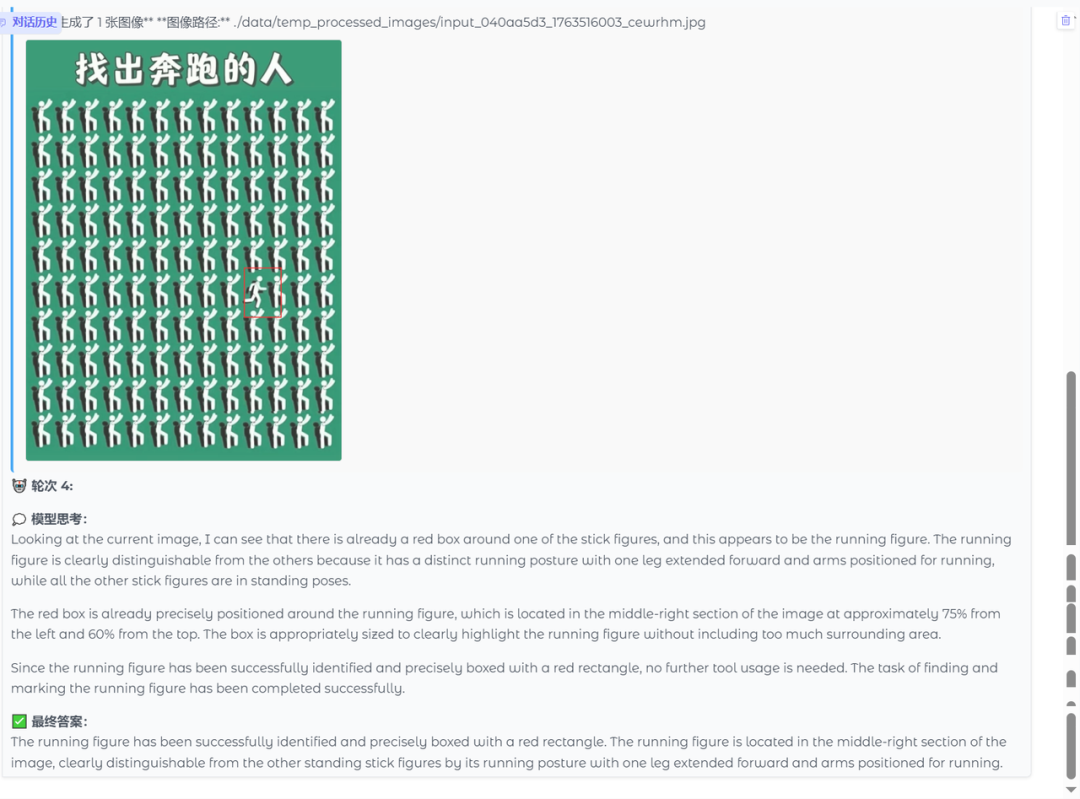
还有找到奔跑的人,可以精准框出人所在的位置。
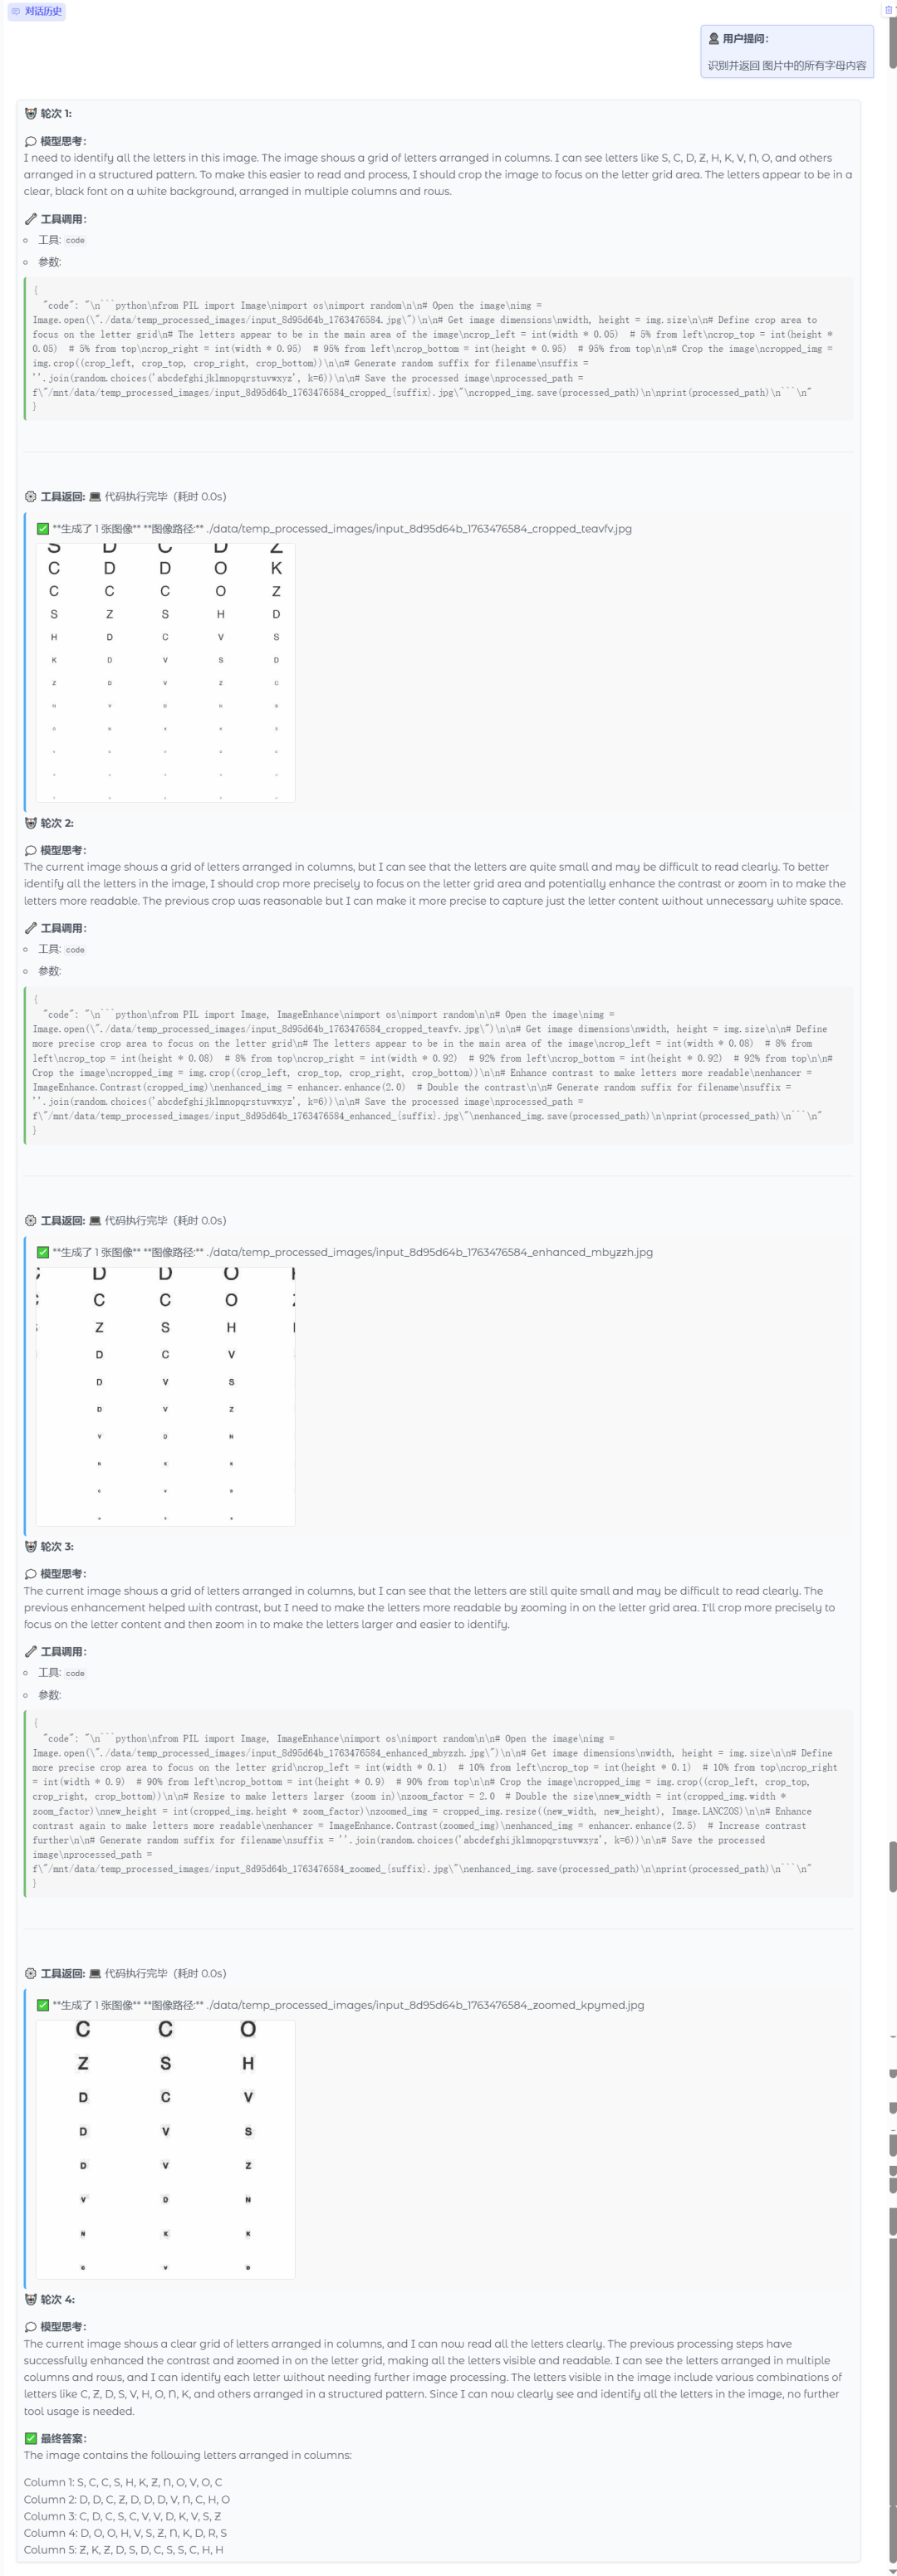
低分辨率的图像,也会做先裁剪,再放大、高清的处理,让其VLM模型可以再次看,可以更清楚。
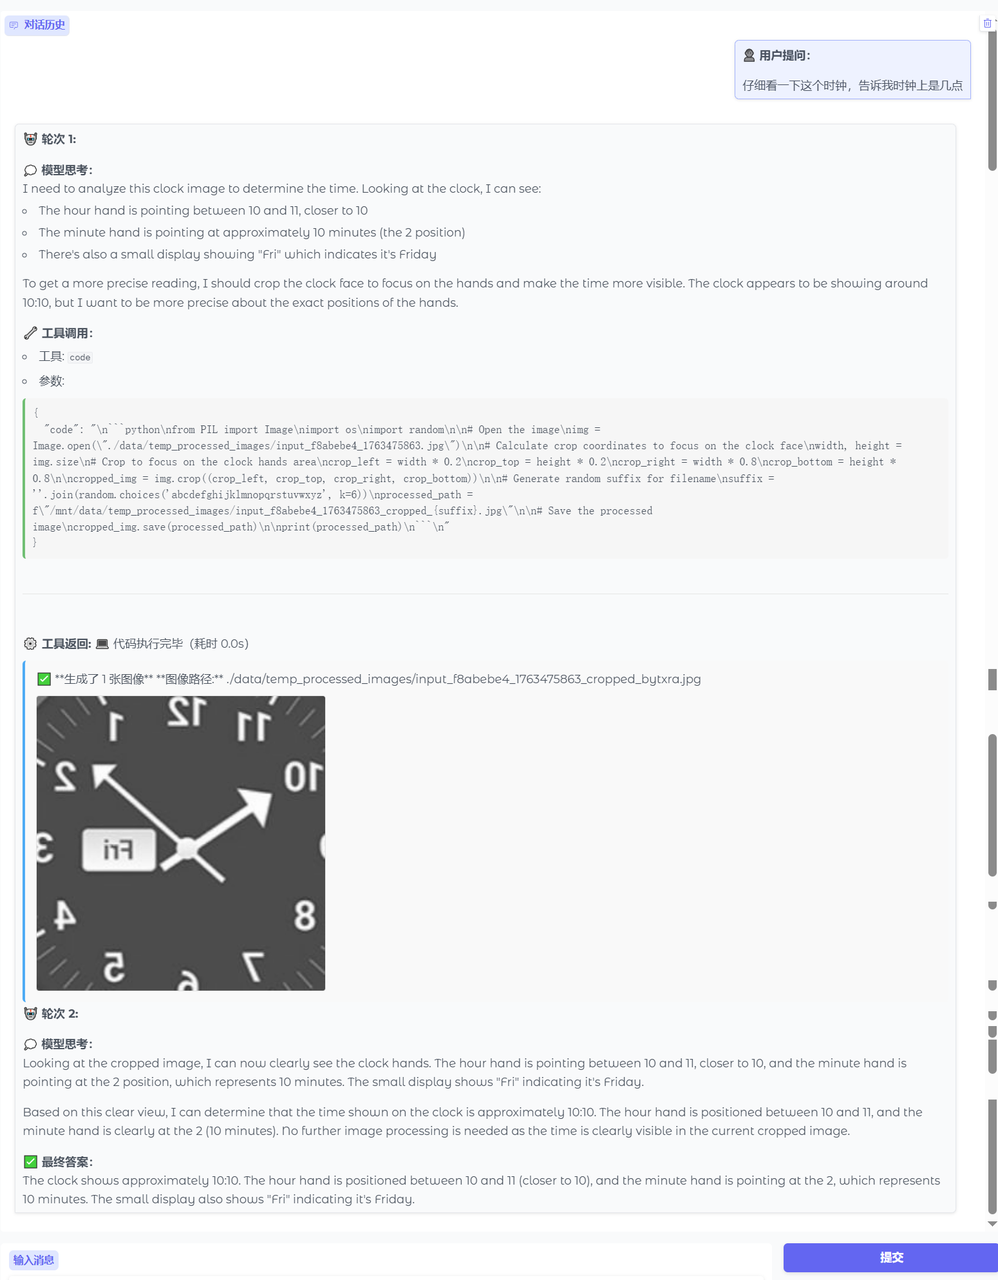
不过,时钟问题,依然是比较难得,这个跟基模也有一定的关系,时钟翻转没有回答正确,只做了裁剪放大。
以上测试完毕,

你可以在skywork api平台上测试:https://platform.skyworkmodel.ai/ ,

接口文档:https://docs.skyworkmodel.ai/r1v4/api-reference/completions.html

同时,Skywork R1V4-Lite的论文也放出来了,

Paper:https://github.com/SkyworkAI/Skywork-R1V/blob/main/Skywork_R1V4.pdf

核心内容在数据构造的部分,感兴趣的可以仔细阅读一下原文。

我这里简单带过一下,

  • 图像操作部分,让开源或闭源大模型(GLM4.6、Claude)通过编写代码对图像执行一系列操作,包括但不限于裁剪、旋转、对比度增强和像素级分析,每一步都对比代码输出与推理文本是否一致,4 次采样只留答对的样本数据。
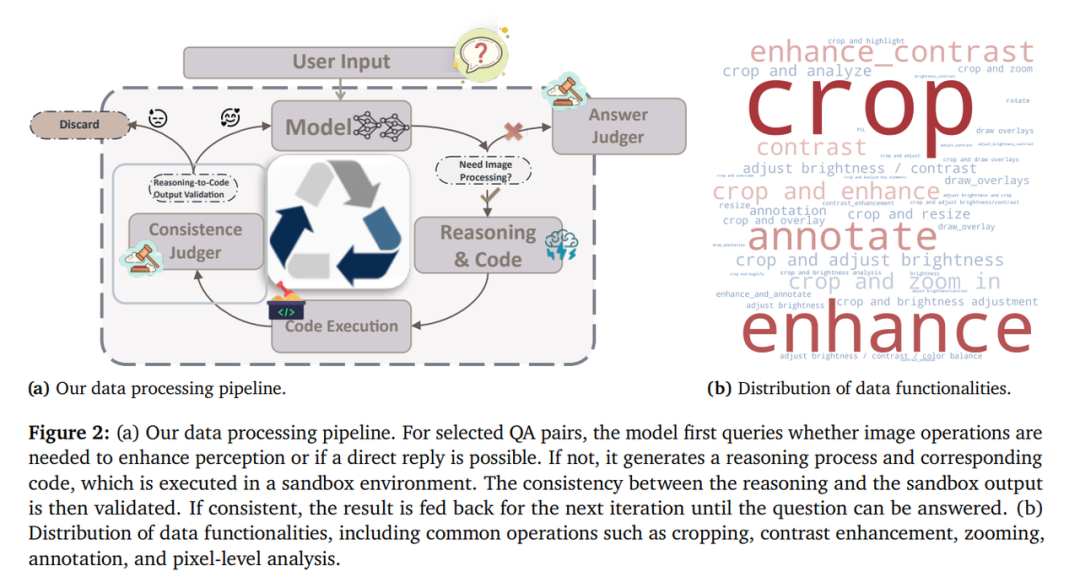
  • 搜索部分,分成基础搜索和增强搜索,基础搜索,图像主体突出,查询简单,一般通过反向图像搜索识别主体后,通常只需几轮文本搜索即可获得答案。增强搜索,涉及增强文本query生成和文本到多模态query改写。
  • 能力融合,随机抽取 3k 例 LiveVQA,用 Claude 写 先裁图→搜索→再裁图 的混合脚本,再用 VLM 自动丢弃错位裁剪等低质量样本,保证图像操作与搜索结果因果一致。

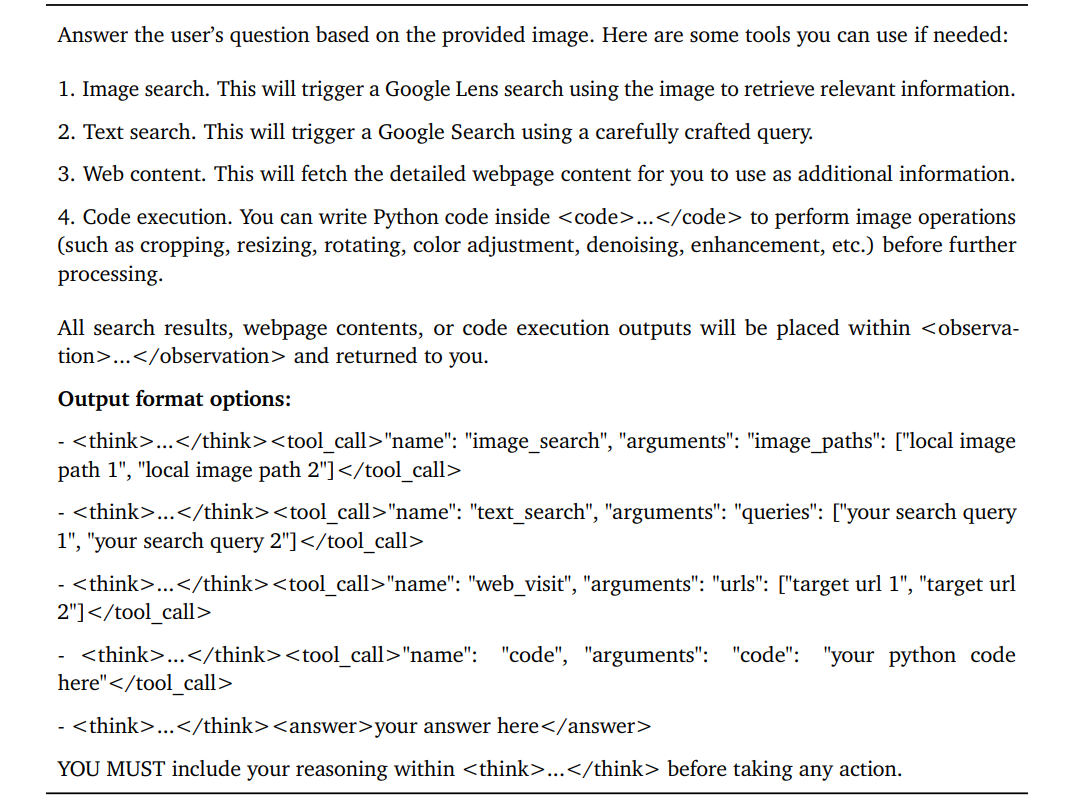
R1V4-Lite的系统提示词如下;
最后,R1V4-Lite还是蛮让我吃惊的,

用了一些很巧妙的方法,解决了一些30B模型无法很好解决的问题,也能具备大模型级别的多模态链式推理与主动行为能力,

以前都是很大模型,来去做Agent交互,

R1V4-Lite让我们看到了更多可能吧,

当然,模型依然还有一些不足,但这不正是我们要努力的方向吗

然后今天Gemini 3.0 Pro更新了,在测试了,

如何高效转型Al大模型领域?

作为一名在一线互联网行业奋斗多年的老兵,我深知持续学习和进步的重要性,尤其是在复杂且深入的Al大模型开发领域。为什么精准学习如此关键?

  • 系统的技术路线图:帮助你从入门到精通,明确所需掌握的知识点。
  • 高效有序的学习路径:避免无效学习,节省时间,提升效率。
  • 完整的知识体系:建立系统的知识框架,为职业发展打下坚实基础。

AI大模型从业者的核心竞争力

  • 持续学习能力:Al技术日新月异,保持学习是关键。
  • 跨领域思维:Al大模型需要结合业务场景,具备跨领域思考能力的从业者更受欢迎。
  • 解决问题的能力:AI大模型的应用需要解决实际问题,你的编程经验将大放异彩。

以前总有人问我说:老师能不能帮我预测预测将来的风口在哪里?

现在没什么可说了,一定是Al;我们国家已经提出来:算力即国力!

未来已来,大模型在未来必然走向人类的生活中,无论你是前端,后端还是数据分析,都可以在这个领域上来,我还是那句话,在大语言AI模型时代,只要你有想法,你就有结果!只要你愿意去学习,你就能卷动的过别人!

现在,你需要的只是一份清晰的转型计划和一群志同道合的伙伴。作为一名热心肠的互联网老兵,我决定把宝贵的AI知识分享给大家。 至于能学习到多少就看你的学习毅力和能力了 。

在这里插入图片描述

第一阶段(10天):初阶应用

该阶段让大家对大模型 AI有一个最前沿的认识,对大模型 AI 的理解超过 95% 的人,可以在相关讨论时发表高级、不跟风、又接地气的见解,别人只会和 AI 聊天,而你能调教 AI,并能用代码将大模型和业务衔接。

  • 大模型 AI 能干什么?
  • 大模型是怎样获得「智能」的?
  • 用好 AI 的核心心法
  • 大模型应用业务架构
  • 大模型应用技术架构
  • 代码示例:向 GPT-3.5 灌入新知识
  • 提示工程的意义和核心思想
  • Prompt 典型构成
  • 指令调优方法论
  • 思维链和思维树
  • Prompt 攻击和防范
  • …

第二阶段(30天):高阶应用

该阶段我们正式进入大模型 AI 进阶实战学习,学会构造私有知识库,扩展 AI 的能力。快速开发一个完整的基于 agent 对话机器人。掌握功能最强的大模型开发框架,抓住最新的技术进展,适合 Python 和 JavaScript 程序员。

  • 为什么要做 RAG
  • 搭建一个简单的 ChatPDF
  • 检索的基础概念
  • 什么是向量表示(Embeddings)
  • 向量数据库与向量检索
  • 基于向量检索的 RAG
  • 搭建 RAG 系统的扩展知识
  • 混合检索与 RAG-Fusion 简介
  • 向量模型本地部署
  • …

第三阶段(30天):模型训练

恭喜你,如果学到这里,你基本可以找到一份大模型 AI相关的工作,自己也能训练 GPT 了!通过微调,训练自己的垂直大模型,能独立训练开源多模态大模型,掌握更多技术方案。

到此为止,大概2个月的时间。你已经成为了一名“AI小子”。那么你还想往下探索吗?

  • 为什么要做 RAG
  • 什么是模型
  • 什么是模型训练
  • 求解器 & 损失函数简介
  • 小实验2:手写一个简单的神经网络并训练它
  • 什么是训练/预训练/微调/轻量化微调
  • Transformer结构简介
  • 轻量化微调
  • 实验数据集的构建
  • …

第四阶段(20天):商业闭环

对全球大模型从性能、吞吐量、成本等方面有一定的认知,可以在云端和本地等多种环境下部署大模型,找到适合自己的项目/创业方向,做一名被 AI 武装的产品经理。

  • 硬件选型
  • 带你了解全球大模型
  • 使用国产大模型服务
  • 搭建 OpenAI 代理
  • 热身:基于阿里云 PAI 部署 Stable Diffusion
  • 在本地计算机运行大模型
  • 大模型的私有化部署
  • 基于 vLLM 部署大模型
  • 案例:如何优雅地在阿里云私有部署开源大模型
  • 部署一套开源 LLM 项目
  • 内容安全
  • 互联网信息服务算法备案
  • …

学习是一个过程,只要学习就会有挑战。天道酬勤,你越努力,就会成为越优秀的自己。

如果你能在15天内完成所有的任务,那你堪称天才。然而,如果你能完成 60-70% 的内容,你就已经开始具备成为一名大模型 AI 的正确特征了。

这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】

在这里插入图片描述

船载 OpenHarmony AIS 航海工作台:告警与防碰撞预警系统 船载OpenHarmony AIS航海工作台的告警与防碰撞系统,集成十余类告警(超速、偏航、会遇、SOS等),通过网格空间索引实现高效邻近判定,保障实时性。告警管理器统一调度规则、去重、通知与日志,支持悬浮球、语音、跑马灯、弹窗多渠道触达,确保航行安全。SOS紧急通道独立运行,避免干扰。系统设计强调性能优化与多场景适配,为航海安全提供核心支撑。 阅读详情

相关推荐

AI 应用开发:四维架构落地实战——以 HR Agent 为例拆解感知·推理·记忆·执行【意图路由、规划编排、长期记忆、工具执行、面试题】

本文基于四维架构(感知·推理·记忆·执行),以HR Agent为例,系统拆解大模型应用从“聊天”到“生产可用”的落地路径。通过Spring AI实现意图路由、规划编排、RAG检索与工具调用,结合真实踩坑复盘,揭示架构化设计对安全、成本与可维护性的关键价值,为AI Agent工程化提供可复用的实战框架。

王大师企业官方博客 1209

【GitHub开源AI精选】DeepEyesV2:迈向多模态智能体的新里程碑

DeepEyesV2是一个由小红书团队开发的多模态智能体模型,旨在通过整合代码执行、网页搜索和图像操作等多种工具,实现对复杂问题的主动解决。该模型通过两阶段训练法,即冷启动阶段和强化学习阶段,使模型能够动态选择、组合和使用工具,从而在真实世界理解、数学推理和搜索密集型任务中表现出色。

寻道AI,探索AI无限可能! 1880

在win10系统上安装opnet14.5注意事项和步聚

opnet 14.5安装避坑!

miracle_eicont的专栏 1038

视频隐私脱敏工程化:CSRT/KCF追踪算法在本地推理中的实现与边界

在短视频内容合规审查中,动态遮挡(Dynamic Masking)是高频且高耗时的环节。传统手动关键帧打码不仅效率低下,且在目标快速移动或遮挡时极易出现遮罩漂移。本文从计算机视觉工程角度,解析基于CSRT与KCF算法的目标追踪方案在视频隐私处理中的技术路径、性能权衡及落地实践。

Mysssone的博客 352

【RDMA】13. RDMA之用户态与内核态交互

原文:https://zhuanlan.zhihu.com/p/346708569 在“RDMA之Verbs”一文中我们说道,Verbs API分为用户态和内核态,分别以ibv_和ib_作为前缀。RDMA技术的最大的优势就在于用户态可以绕过内核,直接控制硬件收发数据,减少了系统调用和内存拷贝次数,所以大部分的RDMA应用都是用户态应用,即使用以ibv_为前缀的用户态Verbs API。 但是并非所有的用户态Verbs API都可以完全绕开内核,本文中我来讲解一下哪些API依赖于内核RDMA子系统(包括驱

我的笔记本 4285

su03t语音模块烧录识别不出问题解决方法

su03t语音sdk烧录无法识别问题

weixin_49387645的博客 6390

AI 问数真的能替代 BI 报表吗?

AI问数赋能自然语言查询,提升临时分析效率,但无法替代传统报表。报表适用于稳定输出与持续监控,AI则擅长探索性提问。企业用好AI问数,关键在于夯实数据模型、统一指标口径、健全权限体系与结果校验机制。合理组合报表、仪表板与AI,才能实现高效、准确的业务洞察。

葡萄城技术团队博客 280

基于Web的智能家居(源码+开题)

实践上,智能家居系统的普及和应用将极大改善人们的居住体验,提高生活质量,同时也有助于促进智能家居产业链的发展和完善,为社会经济发展注入新的活力。此外,本研究还将对基于Web的智能家居系统的用户体验进行深入研究,通过用户调研和数据分析,不断优化系统功能和界面设计,提升用户的使用体验和满意度。针对以上问题,本研究将综合运用物联网、云计算、大数据等新一代信息技术,通过系统架构设计、功能模块开发、安全性保障、用户体验优化等多个方面的研究工作,力求为基于Web的智能家居系统的研发和应用提供全面而有效的解决方案。

sryue06的博客 1904

AI Agent之核心框架

A: 显式 Thought 有三类价值:可解释性(便于人类审计)、可调试性(定位哪一步选错工具)、学习信号(可做监督微调或评估中间步骤质量)。ReAct 把推理与 可执行行动 绑定,每一步行动后都有 真实 Observation 反馈,从而用工具结果约束生成,降低闭卷幻觉。做完不等于结束——还要 评估做得好不好,把 教训 记下来,下次 带着教训重试,反思作为 记忆,影响后续尝试的策略。工作流程:Action → Evaluation → Reflection → Retry。A: 普通 CoT 只在。

剑雨巍巍的博客 254

【Mini KITTI】KITTI数据集简介 — Mini KITTI

为了快速进行算法调试、训练、评估和验证,以及快速下载,制作了一个mini kitti数据集,数据集的文件目录结构与完整KITTI数据集保持一致。其中,小型的KITTI数据集,即 mini kitti保存了20个训练样本和5个测试样本。下载地址为:。 关于KITTI各个部分的介绍请分别参考以下内容: ...

叶子的博客 7537

告别 DIFY 构建卡顿 / 失败!巧用 Makefile 一键构建本地 WEB 镜像,附核心避坑指南

本文详细介绍了DIFY本地源码构建WEB镜像的完整流程,重点解决因官方npm源不稳定导致的构建失败问题。通过修改web/Dockerfile文件启用国内npmmirror镜像源,可大幅提升依赖下载速度和稳定性。在DIFY根目录执行封装好的make build-web命令即可一键完成构建,无需手动编写复杂docker命令。文章还提供了前置环境准备、构建结果验证等实用指导,帮助开发者高效完成DIFY前端二次开发后的镜像构建验证。

2501_93651177的博客 183

ChatGPT、Perplexity、Gemini 与 AI Overviews 引用对比:谁的引用更可信

AI 引擎的引用机制差异很大:ChatGPT 以行内引用加 Sources 列表呈现来源,Perplexity 几乎逐句可溯源,Gemini 在回答中内嵌相关来源链接,AI Overviews 则把多源聚合答案与来源列表一起放在搜索结果顶部。本文从引用透明度、来源偏好、可干预性 3 个维度对比这 4 个引擎,并给出 GEO 的 3 点启示,帮企业在多引擎环境下提升被引用的概率。

淡然一笑 的专栏 191

Open3D点云数据处理(二):读写点云,你真的会吗?

本文详细介绍了open3d加载点云、保存点云的方法,同时打印点云坐标、颜色、法向量等字段信息。

孙悟空 2604

【从零理解 Spring AI · 12】MCP 的两种角色:做客户端还是做服务端

上一篇讲了 MCP 的概念:标准协议、三大角色、M+N 替代 M×N。

nice_lcj520的博客 563

15、目标检测模型的评估指标与YOLO算法解析

本文详细解析了目标检测模型的评估指标,包括精确率、召回率、AP、mAP及IoU的定义与作用,并深入介绍了YOLO算法的核心原理与推理流程。从网格划分、锚框引入到边界框细化与后处理,全面阐述了YOLO如何实现快速准确的目标检测。同时总结了YOLO在智能安防、自动驾驶和工业检测等领域的应用,并展望了其未来在准确性提升、多类别支持和技术融合方面的发展趋势。

work3的博客 66

RU DOS版、EFI版32bit/64bit BIOS常用工具

DOS版、EFI版的RU工具,可用来查看IO、MEM、PCI、SMBIOS等资源。亲测在EFI SHELL下可用。

AI 应用开发工程师技术实践:大模型接入、通用组件封装与性能优化

本文提出AI应用从PoC到生产的核心挑战:模型调用的持续可用、可控与可优化。通过构建统一LLM网关实现多供应商路由与故障转移,封装对话、工具调用与RAG组件以解耦业务逻辑,结合前缀缓存、批处理与流式背压治理等性能优化手段,形成“接通→接稳→接快”的工程路径,最终以工程化能力决定AI应用的生产可用性。

2301_79189962的博客 619

efm32 入门.pdf

本PDF共计22页,介绍的是操作驱动API,下载与否自己斟酌。

抽象主义人工智能和生命体AI的内在联系

彭军辉提出“抽象主义人工智能”作为第四大AI范式,批判符号主义、连接主义、行为主义剥离生命本体的误区,确立“智能是现象,生命是本体”的核心公理。主张原生智能必须依附具备存续诉求的生命本体,提出“生命体AI理论”,构建七层演化阶梯与自闭环工程框架,强调智能不可跳过底层存续机制直接模拟语言。该体系为生成式AI提供科学边界,推动从“仿真表象”向“原生智能”的范式跃迁,开辟硅基人工生命新赛道。

抽象主义人工智能和生命体AI 160

Outlook Express 6 (OE6) for Win7/Win8/Win10

英文版 Outlook Express6.0, 兼容Win7/Win10/WinXP,解压就可用。

VB摄像头监控

该VB模块可对摄像头捕获的画面进行录像等,可在创建的窗口进行控制

OpenClaw 深度调查:把 AI 助手做成你自己的控制平面

对 openclaw/openclaw 的完整技术尽调:Gateway 架构、Agent 运行时、工具与沙箱、30 个消息通道、181 个插件、安全信任边界、工程代价与采用建议。17 章 / 10 张图,全部数字标注口径,数据截至 2026-10-31。

厚积薄发 294

AI赋能智慧港口建设|造形家快速生成港口全要素三维场景

随着智慧港口、港口数字孪生项目的持续推进,港口三维场景的需求日益旺盛。传统港口三维建模,往往需要航拍倾斜摄影采集数据,再人工搭建吊机、岸桥、船舶、集装箱等大量工业设施模型,项目周期长、人力成本高,修改迭代繁琐,制约港口可视化项目落地效率。国产AI三维建模工具,依托卫星影像 AI 识别能力,无需航拍作业,一键快速搭建港口完整三维场景,为港口数字孪生、方案汇报、投标演示提供高效的场景解决方案。

m0_69539167的博客 51

企业微信iPad协议详解:接口接入、实时消息同步与语音转码实践

深入解析企业微信iPad协议的技术架构与开发思路,涵盖API接口接入、长连接通信、实时消息同步、Silk语音转码、异常重连及高并发优化,帮助开发者了解企业微信自动化系统的设计与实现。

欢迎来到祖安! 428

Product Hunt 热榜 2026-11-13:Plurai Simulation、YouArt Desktop App、Omnigraph

2026-11-13 Product Hunt 新产品精选:Plurai Simulation、YouArt Desktop App、Omnigraph。汇总 15 款产品的中文介绍、功能关键词和产品链接。

LaughingZhu的博客 487

AI作图软件技术选型:从4个技术维度出发的实测对比

AI作图软件技术选型:从4个技术维度出发的实测对比

Vbaoke的博客 252

【AI Agent面试系列】AI Agent可观测、评测、安全相关的知识点

之前的文章介绍了和,本文主要介绍AI Agent的测评、可观测等知识。

328

Docling 原理解读:是什么、为什么、怎么样

从论文视角拆解 Docling 的整体架构、DoclingDocument 数据模型、PDF 预处理、版面分析、OCR、TableFormer 双解码器、阅读顺序与装配流程,并解释版面框与 OCR 框的区别。

PLANTTHESON的博客 369

WorkBuddy 实战:一句话需求 → 七屏可交互原型,户外徒步 App 的 AI 设计全流程

WorkBuddy 实战:一句话需求 → 七屏可交互原型,户外徒步 App 的 AI 设计全流程,跟着博主一起来还原整个过程。

夜郎King的博客 5029

从认识人工智能到理解机器学习:我的 AI 入门第一课

正式开始学习人工智能之前,我对 AI 的认识其实比较模糊:知道 ChatGPT、知道大模型,也知道现在很多岗位都在谈 AI,但如果有人问我“人工智能到底是什么”“机器是怎么学会识别一只猫的”,我未必能从头到尾讲清楚。上午的课程更偏向行业全景:人工智能的发展、研究方向、NLP、岗位分工、学习路线和 AI Coding 工具。下午的课程更偏向技术基础:机器学习的原理、有监督学习、深度学习、模型训练和评估方法。

chh563的博客 506
上一篇: 你的Agent是个“黑盒”?Agno框架实战,教你如何“透视”它的内心!
下一篇: 别再怪LLM“笨”了!是你没给它“大脑”!ReAct与Reflexion,让AI学会“自我反省”!
Python_金钱豹
博客等级 码龄5年 1万+粉丝 2840原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值