AI克隆声音泛滥?再也不用怕!大模型音频水印技术,为你的声音上把“锁”!

Mossland在线音频克隆工具:零门槛体验AI声音克隆技术 AI声音克隆技术通过深度学习模型学习并模仿特定音色,实现文本到个性化语音的合成。其核心原理通常基于生成对抗网络或自回归模型,从参考音频中提取声学特征并迁移到目标文本上。这项技术的价值在于极大降低了语音合成的定制化门槛,为内容创作、语音助手、有声读物等领域提供了高效工具。在实际应用中,用户常关注音色保真度、合成自然度以及使用便捷性。Mossland作为一款在线音频克隆工具,正是基于这些需求,提供了无需本地配置、通过浏览器即可快速体验声音克隆能力的解决方案,尤其适合初学者快速验证效果和轻量级内容创作场景。 阅读详情

一、背景和意义

随着生成式人工智能的迅猛发展,特别是大型语言模型和音频生成模型(Sora 2、AudioLM、Vall-E、FunAudioLLM等)的广泛应用,高质量、逼真的合成音频内容正以前所未有的速度被创造和传播。同时,在企业内部存在大量的客户服务录音、会议记录、语音产品、培训资料及智能语音交互等关键业务场景,这给音频内容的版权保护、内容认证和来源追溯带来了严峻挑战。一旦敏感音频被违规使用,不仅可能导致商业机密外泄、引发版权争议与法律纠纷,严重损害企业声誉和用户信任。

传统音频水印技术在处理音频内容时,实现上通常在音频生成后作为后处理步骤添加,这种方式容易在后续处理中丢失,且可能影响音质,往往在鲁棒性、不可感知性和容量之间难以取得平衡。大模型音频水印技术旨在将不可感知的标识信息(水印)直接嵌入到由大模型生成的音频和存量音频中,它将水印的嵌入过程集成到模型的生成过程内部,通过在模型训练或推理阶段引入水印机制,模型“学会”了如何在其输出的音频中自然地承载水印信息,从而在根本上提升了水印的不可感知性和鲁棒性,因此它为模型知识产权(IP)声明、AI 生成内容(AIGC)溯源、伪造语音主动检测提供了一种前沿的技术解决方案。

二、音频水印技术

2.1 音频水印技术的基本概念

音频水印技术是一种将特定信息(称为水印)嵌入到音频信号中的技术,嵌入的水印不会对原始音频的听觉效果产生明显影响,但可以通过专门的检测方法提取出来。通常音频水印技术上需要满足下面4个基本要求:

  1. 不可感知性:水印的存在不应引起音频质量的下降,即人耳无法察觉嵌入水印后的音频与原始音频的差异。
  2. 鲁棒性:水印应能够抵抗常见的信号处理操作(如压缩、滤波、重采样、添加噪声等)以及恶意攻击(如篡改、去除水印等)。
  3. 容量:水印应能够携带足够的信息量,以满足应用需求。
  4. 安全性:水印的嵌入和提取过程应保证安全性,未经授权者无法检测或移除水印。

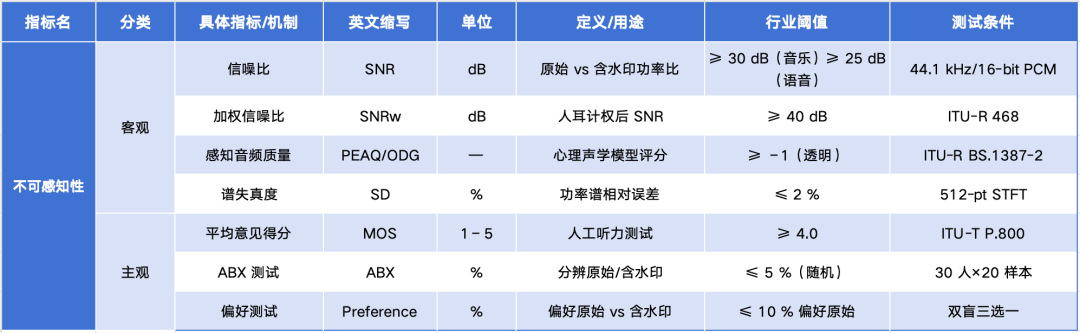
2.1.1 不可感知性(Imperceptibility)指标

水印的存在不应引起音频质量的下降,不可感知性从指标维度包含客观指标和主观指标。客观指标通过数学模型计算原始音频和含水印音频之间的差异,无需人工参与。主观指标通过人工听力测试来评估,更符合人类实际听感。
2.1.2 鲁棒性(Robustness)指标

衡量音频水印在遭受各类正常信号处理、恶意攻击或环境干扰后,仍能被可靠检测与解码的能力。以下从"攻击类型-评价指标"2个维度进行描述:

def robustness_metrics(self):
"""鲁棒性指标"""
attacks = {
"常规信号处理": ["MP3压缩", "AAC压缩", "重采样", "音量调整", "带宽限制"],
"时域操作": ["裁剪", "拼接", "时域缩放", "回声添加"],
"噪声干扰": ["加性白噪声", "脉冲噪声", "环境噪声"],
"恶意攻击": ["去水印攻击", "共谋攻击", "几何攻击"]
}
metrics = {
"比特错误率(BER)": "错误比特数/总比特数",
"检测率": "正确检测出水印的概率",
"虚警率": "错误检测出水印的概率",
"归一化相关系数(NC)": "提取水印与原始水印的相似度"
}
return {"攻击类型": attacks, "评估指标": metrics}

2.1.3 容量(Capacity)指标

音频水印系统在单位时间内能够嵌入的水印信息量,通常以比特率(bits per second, bps)表示。另外,也可以指在一段音频中嵌入的总比特数。

  • 比特率(bps):每秒嵌入的比特数。例如,如果一段10秒的音频中嵌入了100比特的水印,则比特率为10 bps。
  • 总容量:整段音频中嵌入的水印总比特数。
  • 频谱效率(Spectral Efficiency):单位带宽内嵌入的信息量。

2.1.4 安全性指标

安全性维度上需要考虑机密性(未授权方无法读取水印内容)、完整性(能够检测水印是否被篡改)、抗攻击性(抵抗恶意去除或破坏水印)、不可否认性(水印提供不可否认的证据)。目前从实现方法上采用加密和签名,抵御"去除攻击"、“协议攻击”、“共谋攻击”。

2.2 三个核心指标的“不可能三角”

音频水印技术中,不可感知性、鲁棒性和容量这三个核心特征构成了一个经典的"不可能三角"。这意味着在任何实际的水印系统中,无法同时实现这三个特征的绝对最优化。例如“不可感知性 ”vs “鲁棒性”,其中提高鲁棒性需要增加水印信号的强度,使其能够抵抗各种处理攻击;保证不可感知性要求限制水印信号的强度,避免被人类听觉系统察觉。

强鲁棒性需求 → 提高水印强度 → 更易被感知 → 降低不可感知性

高不可感知性要求 → 降低水印强度 → 更易被消除 → 降低鲁棒性

因此需要根据不同的应用场景进行策略的权衡,比如取证溯源场景上,通常优先级:不可感知性 > 鲁棒性 > 容量,在容量上需求极低,仅需存在性证明。

三、当前主流音频水印技术简介

传统的音频水印技术为今天的大模型水印奠定了基础,主要分为几类:

  • 时域方法:直接在音频样本点上做修改,如最低有效位(LSB)编码、回声隐藏等。优点是简单高效,但鲁棒性较差。
  • 频域方法:将音频变换到频域(如使用傅里叶变换、小波变换、DCT变换),在特定的频率分量中嵌入水印。这是最常用的方法,因为人类听觉系统(HAS)对频域变化更不敏感,因此能更好地平衡不可感知性和鲁棒性。
  • 扩频水印:借鉴通信中的扩频技术,将水印信号扩展到一个很宽的频带上,使其看起来像背景噪声,从而极难被检测和移除,鲁棒性非常强。

四、货拉拉安全团队在音频水印的探索和实现案例

传统音频水印技术长期受困于鲁棒性、不可感知性与安全性难以兼顾的固有缺陷,在面对现代复杂处理与恶意攻击时往往力不从心。然而,生成式人工智能的崛起不仅带来了新的挑战,也催生了更强大的解决方案。以SynthID和AudioSeal为代表的AI水印技术,通过深度学习与对抗训练机制,从根本上突破了传统方法的局限,为音频数据保护开启了智能溯源与精准防控的新阶段。

4.1、SynthID实现音频水印

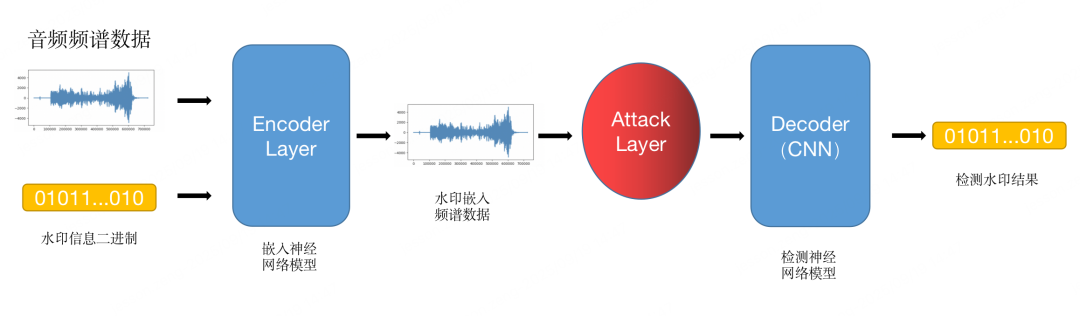
SynthID基于一种名为联合优化的深度学习技术。它主要包含两个神经网络模型:

  • 水印嵌入模型:这个模型与音频生成模型(如Lyria)协同工作。它的任务是在生成音频的频域表示中,巧妙地嵌入一个唯一的、不可感知的数字签名(水印)。
  • 水印检测模型:这个模型的任务是从一段音频中,即使是被修改过的音频,检测并解码出可能存在的SynthID水印。

这两个模型是一起训练的。训练目标是让嵌入模型学会嵌入一个既难以听见(对人类听觉系统不可感知)又难以移除(能够抵抗各种音频处理操作)的水印;同时,检测模型要学会在各种干扰下依然能可靠地检测到它。

实现过程:

  1. 水印嵌入:

  2. 加载音频并转换为频谱图数据;

  3. 在频谱中嵌入水印(一个二进制数据),然后初始化并训练神经网络,使用神经网络优化嵌入位置,最后使用扩频技术嵌入水印信息;

  4. 将修改后的频谱图还原为音频数据;

  5. 水印检测:

  6. 先将带有水印信息的音频数据,读取为频谱图数据;

  7. 使用水印嵌入训练的同一个深度神经网络模型和水印信息进行检测频谱图数据;

  8. 计算匹配率,得到水印信息的检测结果;

图1 使用SynthID添加音频水印

4.2、AudioSeal实现音频水印

AudioSeal的核心是一个基于生成对抗网络(GAN)框架的、端到端的神经水印系统。它主要包含两个核心神经网络:一个发生器(Generator) 和一个检测器(Detector)。

实现过程:

  1. 嵌入过程:

  2. 根据提供的原始音频数据和需要隐藏的水印信息,使用生成器的神经网络输出一个噪音信息,该噪音的信息的音频不在人耳的可感知范围;

  3. 将定制好的噪音信号叠加到原始音频上,得到一个添加了水印的音频;

  4. 检测水印过程:

  5. 获取到一个可能完整或破坏的音频,利用检测器沿着音频的时间线逐秒扫描,并计算水印的概率值;

  6. 最后汇总检测结果中出现是否是原始音频或者水印音频,其中出现峰值区域就是添加的水印噪声位置,即得到音频中是否存在水印信息。
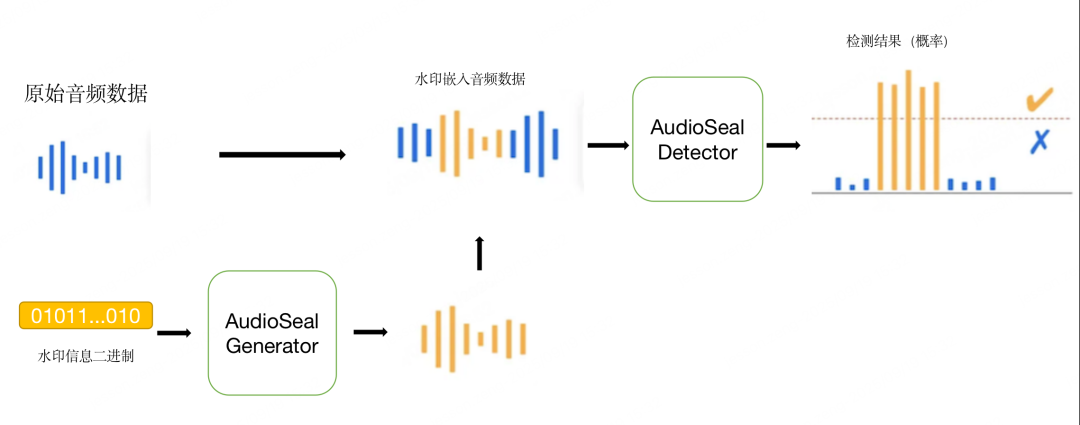
图2 使用AudioSeal添加音频水印

4.3、对比实现结果分析

使用AudioSeal对测试语音数据加水印:

# 加载音频文件
wav, sr = torchaudio.load(audio_path)
# 自定义水印
secret_mesage = torch.randint(0, 2, (1, 16), dtype=torch.int32)
print(f'自定义水印信息:{secret_mesage}')
watermarked_audio = model(wav, sample_rate=sr, message=secret_mesage, alpha=1)
torchaudio.save(output_path, watermarked_audio.squeeze(0), sr)
print(f"水印音频已保存到 {output_path}")

使用检测模型对音频进行水印检测:

# 加载音频文件
det_wav, sr = torchaudio.load(output_path)
# 确保 wav 是三维张量 (Batch, Channels, Time)
if det_wav.dim() == 2:
det_wav = det_wav.unsqueeze(0)  # 增加批次维度
result, message = detector.detect_watermark(det_wav, sr)
print(f'检测准确率:{result}')
print(f'检测水印信息结果:{message}')

检测结果:
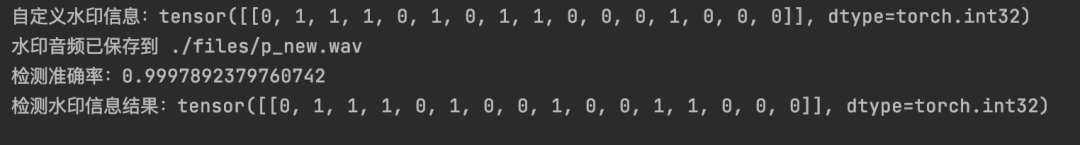
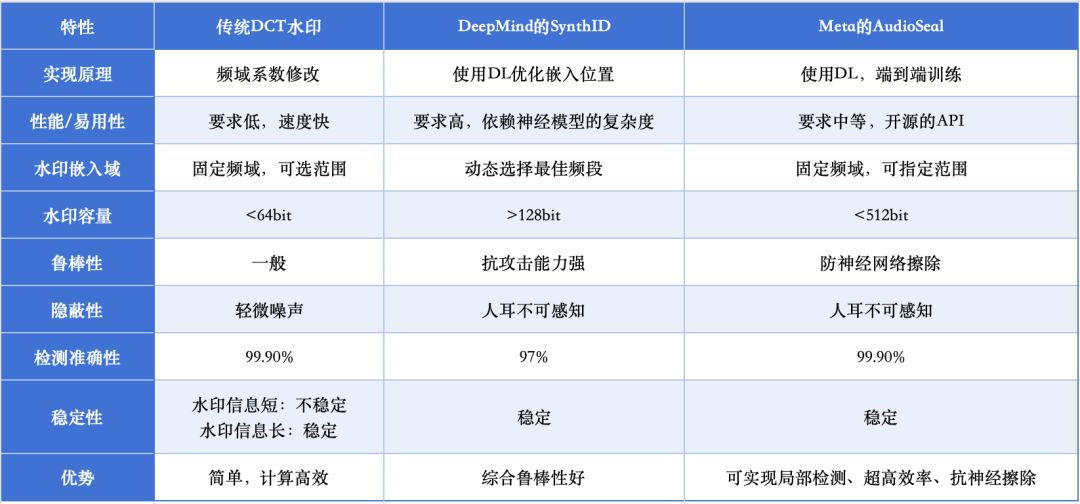
通过在测试语音数据上集成AudioSeal算法进行添加音频水印信息,成功实现了对音频内容毫秒级、高准确度的水印嵌入与溯源检测,并能保持音频质量人耳无感的同时,对各类压缩、裁剪攻击的检测准确率均超过99.9%。

对比不同音频水印技术的实现结果对比:
五、未来展望

音频水印技术仍在飞速演进,未来趋势包括:

  • 标准化:行业将推动建立统一的水印协议和标准,实现跨平台、跨模型的互操作识别。
  • 抗对抗性攻击:与试图移除水印的对抗性攻击之间的“军备竞赛”将持续升级,水印技术必须变得更加坚固。
  • 水印与区块链结合:将水印的哈希值存储在区块链上,创建不可篡改的、可公开验证的生成内容溯源记录。
  • 可解释水印:水印不仅包含来源信息,还可能包含模型的训练数据信息、生成参数等,使AI生成内容更加透明。
  • 法规驱动:随着全球对AI监管的加强(如欧盟AI法案)以及中国国家标准《数据安全技术 数字水印技术实现指南》的核心要求,水印可能从“最佳实践”变为“法律要求”,成为AI模型上市的必备功能。

六、结语

大模型音频水印技术远非一个简单的技术附加项,而是构建负责任、可信赖的AIGC生态系统的基石。像SynthID和AudioSeal这样的创新方案,为解决内容溯源和版权保护这一巨大挑战提供了强大而实用的工具。随着技术的不断成熟和行业的广泛采用,音频水印将像互联网时代的HTTPS一样,成为保障AI内容安全流通的基础协议,默默守护着数字世界的真实与秩序。

如何学习大模型 AI ?

我国在AI大模型领域面临人才短缺,数量与质量均落后于发达国家。2023年,人才缺口已超百万,凸显培养不足。随着Al技术飞速发展,预计到2025年,这一缺口将急剧扩大至400万,严重制约我国Al产业的创新步伐。加强人才培养,优化教育体系,国际合作并进,是破解困局、推动AI发展的关键。

但是具体到个人,只能说是:

“最先掌握AI的人,将会比较晚掌握AI的人有竞争优势”。

这句话,放在计算机、互联网、移动互联网的开局时期,都是一样的道理。

我在一线互联网企业工作十余年里,指导过不少同行后辈。帮助很多人得到了学习和成长。

我意识到有很多经验和知识值得分享给大家,也可以通过我们的能力和经验解答大家在人工智能学习中的很多困惑,所以在工作繁忙的情况下还是坚持各种整理和分享。但苦于知识传播途径有限,很多互联网行业朋友无法获得正确的资料得到学习提升,故此将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。
在这里插入图片描述

2025最新大模型学习路线

明确的学习路线至关重要。它能指引新人起点、规划学习顺序、明确核心知识点。大模型领域涉及的知识点非常广泛,没有明确的学习路线可能会导致新人感到迷茫,不知道应该专注于哪些内容。

对于从来没有接触过AI大模型的同学,我帮大家准备了从零基础到精通学习成长路线图以及学习规划。可以说是最科学最系统的学习路线。

在这里插入图片描述

针对以上大模型的学习路线我们也整理了对应的学习视频教程,和配套的学习资料。

大模型经典PDF书籍

新手必备的大模型学习PDF书单来了!全是硬核知识,帮你少走弯路!
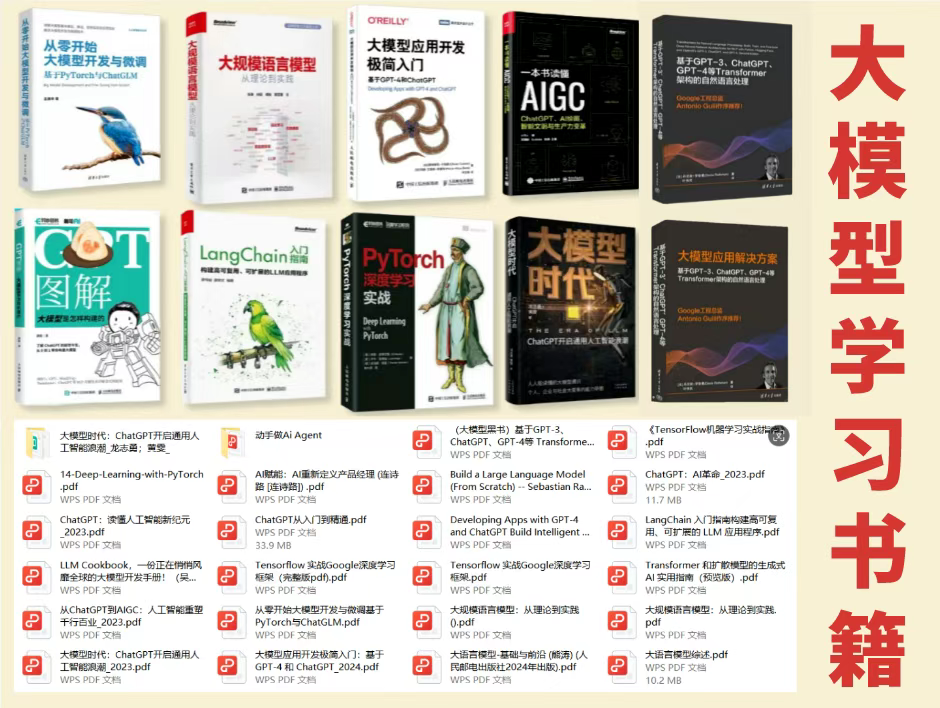
在这里插入图片描述

配套大模型项目实战

所有视频教程所涉及的实战项目和项目源码等
在这里插入图片描述

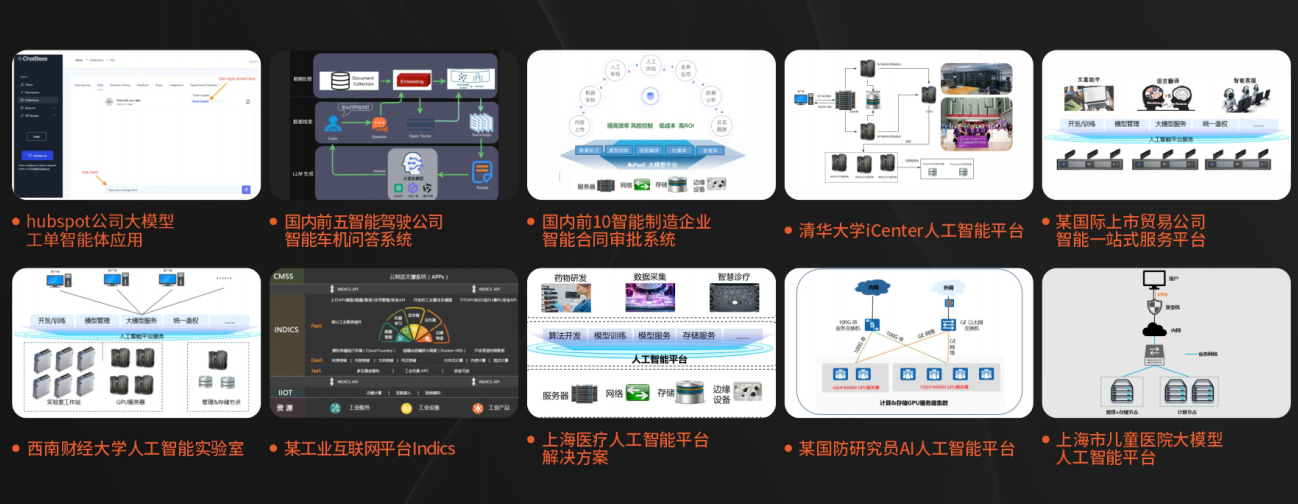
博主介绍+AI项目案例集锦

MoPaaS专注于Al技术能力建设与应用场景开发,与智学优课联合孵化,培养适合未来发展需求的技术性人才和应用型领袖。
在这里插入图片描述

在这里插入图片描述

这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】

在这里插入图片描述

为什么要学习大模型?

2025人工智能大模型的技术岗位与能力培养随着人工智能技术的迅速发展和应用 , 大模型作为其中的重要组成部分 , 正逐渐成为推动人工智能发展的重要引擎 。大模型以其强大的数据处理和模式识别能力, 广泛应用于自然语言处理 、计算机视觉 、 智能推荐等领域 ,为各行各业带来了革命性的改变和机遇 。
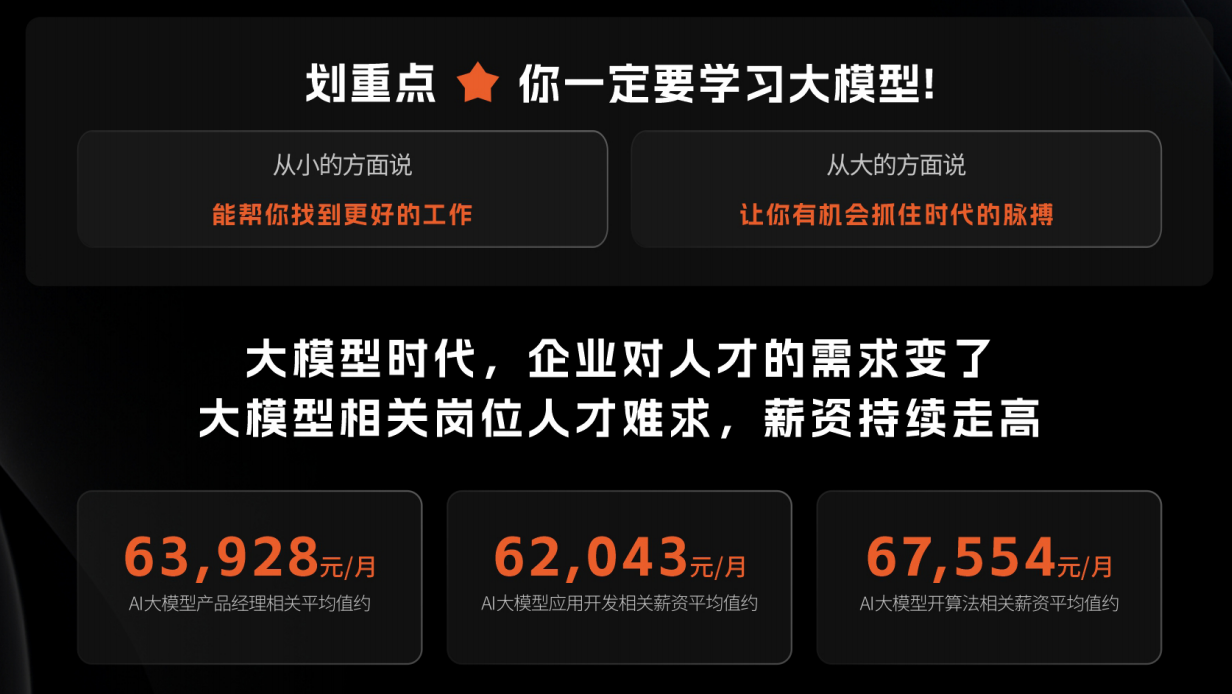
在这里插入图片描述

适合人群

  • 在校学生:包括专科、本科、硕士和博士研究生。学生应具备扎实的编程基础和一定的数学基础,有志于深入AGI大模型行业,希望开展相关的研究和开发工作。
  • IT行业从业人员:包括在职或失业者,涵盖开发、测试、运维、产品经理等职务。拥有一定的IT从业经验,至少1年以上的编程工作经验,对大模型技术感兴趣或有业务需求,希望通过课程提升自身在IT领域的竞争力。
  • IT管理及技术研究领域人员:包括技术经理、技术负责人、CTO、架构师、研究员等角色。这些人员需要跟随技术发展趋势,主导技术创新,推动大模型技术在企业业务中的应用与改造。
  • 传统AI从业人员:包括算法工程师、机器视觉工程师、深度学习工程师等。这些AI技术人才原先从事机器视觉、自然语言处理、推荐系统等领域工作,现需要快速补充大模型技术能力,获得大模型训练微调的实操技能,以适应新的技术发展趋势。
    在这里插入图片描述

课程精彩瞬间

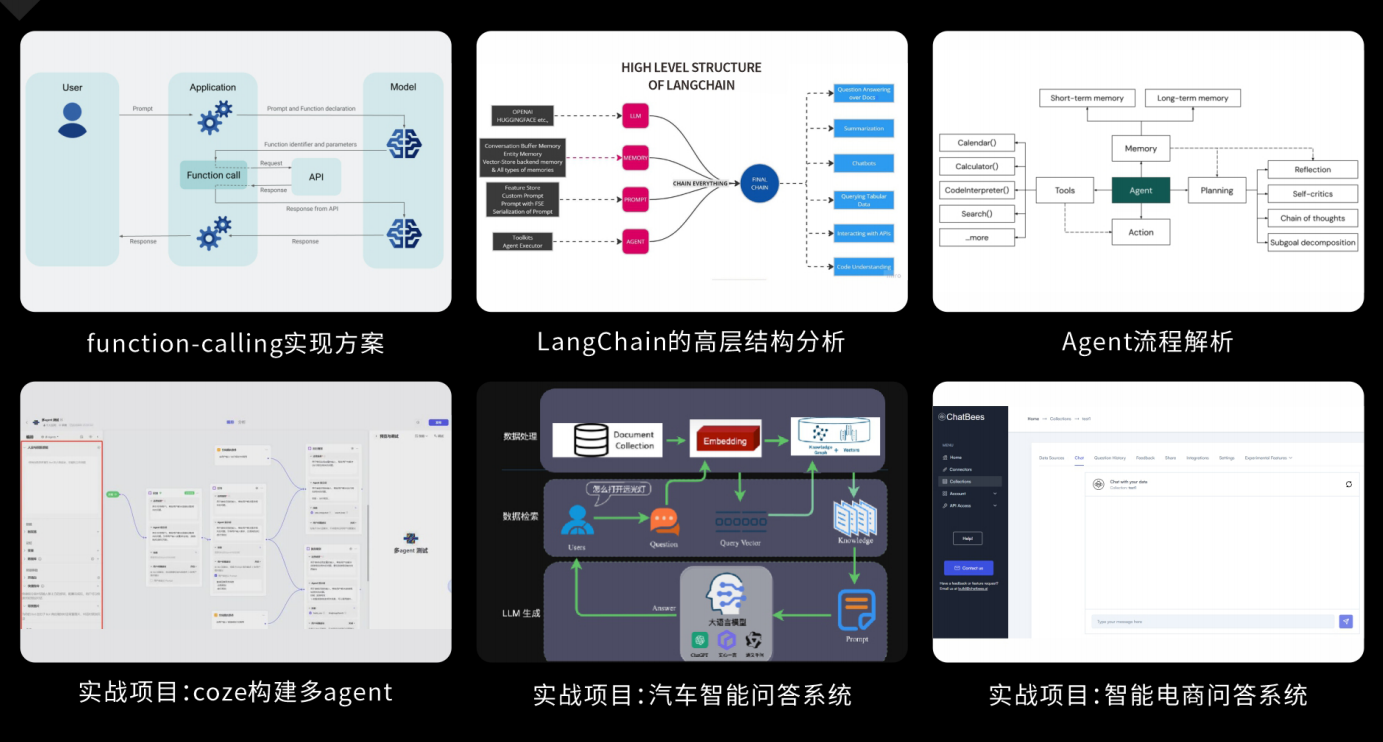
大模型核心原理与Prompt:掌握大语言模型的核心知识,了解行业应用与趋势;熟练Python编程,提升提示工程技能,为Al应用开发打下坚实基础。

在这里插入图片描述

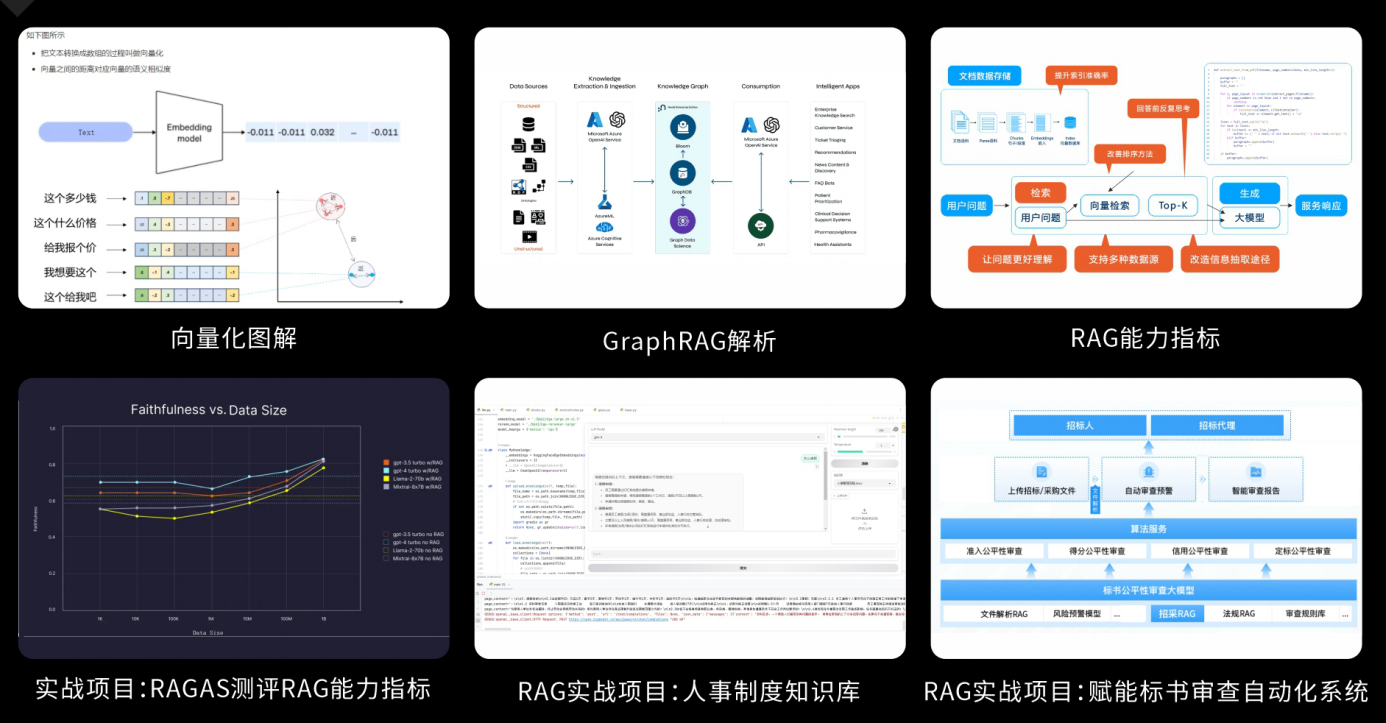
RAG应用开发工程:掌握RAG应用开发全流程,理解前沿技术,提升商业化分析与优化能力,通过实战项目加深理解与应用。 在这里插入图片描述

Agent应用架构进阶实践:掌握大模型Agent技术的核心原理与实践应用,能够独立完成Agent系统的设计与开发,提升多智能体协同与复杂任务处理的能力,为AI产品的创新与优化提供有力支持。
在这里插入图片描述

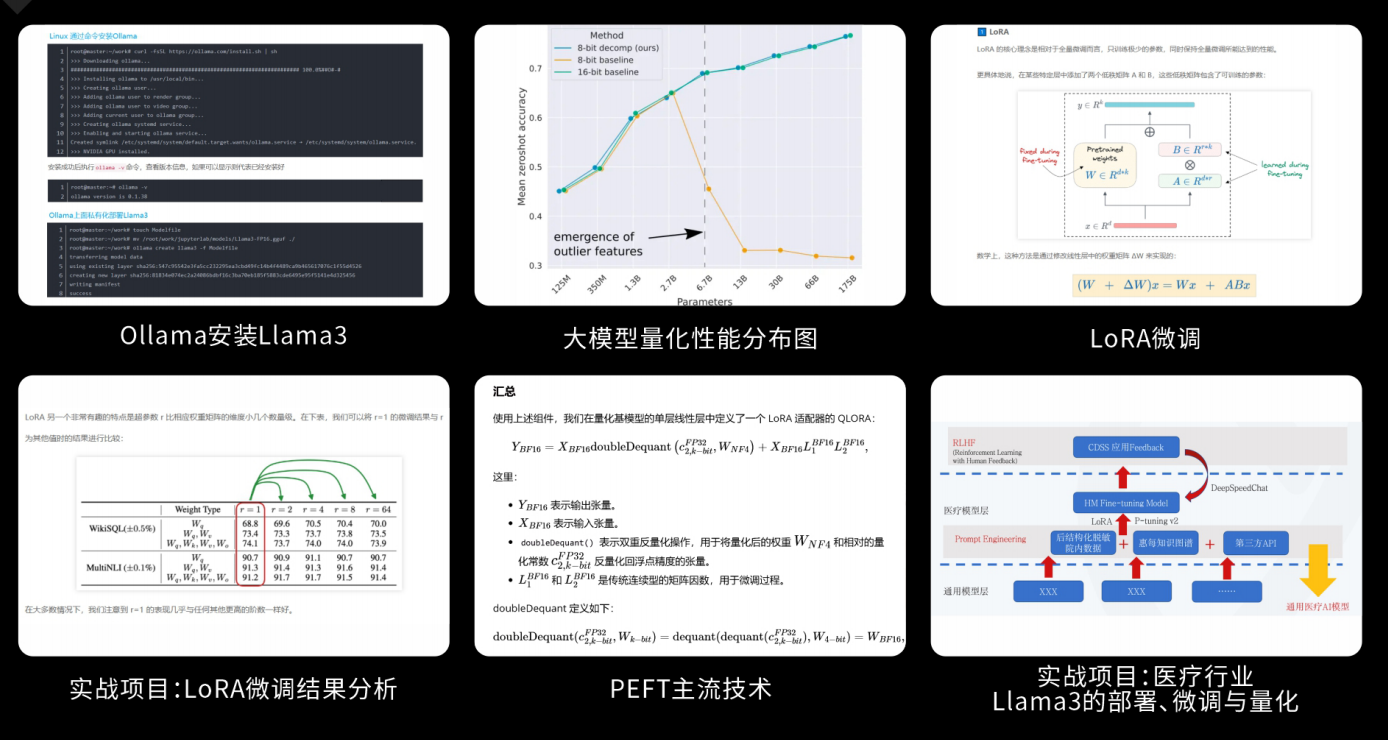
模型微调与私有化大模型:掌握大模型微调与私有化部署技能,提升模型优化与部署能力,为大模型项目落地打下坚实基础。 在这里插入图片描述
顶尖师资,深耕AI大模型前沿技术

实战专家亲授,让你少走弯路
在这里插入图片描述

一对一学习规划,职业生涯指导

  • 真实商业项目实训
  • 大厂绿色直通车

人才库优秀学员参与真实商业项目实训

以商业交付标准作为学习标准,具备真实大模型项目实践操作经验可写入简历,支持项目背调

在这里插入图片描述
大厂绿色直通车,冲击行业高薪岗位
在这里插入图片描述

文中涉及到的完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】

在这里插入图片描述

从拧螺丝到精密装配:三菱伺服电机扭矩控制在工业自动化中的实战解析 本文深入解析三菱伺服电机扭矩控制在工业自动化中的实战应用,重点介绍MR-J4系列伺服系统的高精度扭矩响应技术。从螺丝紧固到精密装配,详细讲解扭矩控制模式的选择、硬件配置、参数设置及典型故障排查方案,帮助工程师提升生产效率和产品质量。 阅读详情

相关推荐

qt下使用grpc编程(2) —— 练手!自己改的一个简单小例子!1

(1)在研究了grpc官方提供的helloworld例程后,自己试着写了个小程序。 (2)编写proto文件。 proto文件用于定义服务和消息,用protobuf的语法编写,protobuf是一种通信协议,详细请百度。下面附上源码: syntax = "proto3"; option java_multiple_files = true; option java_pac

u011099079的博客 3926

AudioSeal一文详解:Meta音频水印技术原理与Gradio交互逻辑拆解

本文介绍了AudioSeal音频水印系统的技术原理与Gradio交互逻辑。该镜像可在星图GPU平台上实现自动化部署,为AI生成的音频内容添加不可感知的数字水印,核心应用于音频内容的版权认证与溯源,有效识别和追踪AI合成音频的来源。

weixin_35578748的博客 634

EPS+ArcGIS+CASS三剑客:等高线裁剪的完整工作流与避坑指南

本文详细介绍了EPS、ArcGIS和CASS三款软件在等高线裁剪中的协同工作流程与避坑指南。通过发挥各软件优势,解决数据完整性、拓扑准确性和流程可靠性等核心挑战,提升40%以上的工作效率。特别适合大型测绘项目中复杂地形的处理,涵盖数据准备、核心处理到后期优化的全流程。

weixin_30352645的博客 620

人工智能在音频、视觉、多模态领域的应用

人工智能在音频、视觉以及多模态领域的应用将各种技术协调地构建在一起。AI可以通过音频处理、图像识别和多模态学习,将声音和视觉信息结合,开辟出丰富的应用场景。从智能音箱到深度学习模型,AI不断创造出前所未有的用户体验。

ceshiren_com的博客 1777

半桥LLC谐振变换器及同步整流MATLAB仿真(一)

LLC工作原理详细解析,工作过程详细拆解

qq_55203246的博客 3万+

字节跳动扣子AI应用开发平台之实战

推出背景:扣子平台由字节跳动推出,旨在让非开发者也能快速创建、调试和优化聊天机器人。上线时间:扣子平台于2024年2月1日正式上线。功能定位:扣子是一个AI聊天机器人和应用程序编辑开发平台,可以理解为字节跳动版的GPTs。

恩爸编程 5899

音频水印——PerTh Watermarker

最近出现的新一波 AI 生成模型几乎可以以假乱真,并且使用门槛较低。许多研究人员和公司声称可以生成与真实内容没有区别的图像、语音和视频内容。通常,使用这些工具需要一些技术专业知识。但是,许多公司都努力使它们尽可能易于使用,从而减少或消除对任何特定技术知识的需求。如果没有适当的验证,这可能会导致虚假和误导性内容的扩散,这些内容甚至可能进入善意和信誉良好的新闻机构的页面。解决这一新问题的一种方法是将 AI 用作检测内容是否真实的工具。

qq_42019881的博客 1837

DBeaver配置本地mysql-connector驱动文件

本文摘要:介绍了数据库驱动管理的基本操作步骤:1)新建驱动管理器,填写MySQL驱动名称、类名和类型;2)添加本地MySQL驱动文件;3)创建数据库连接并测试。适用于MySQL5.x和8.x版本,帮助用户快速配置数据库连接。

litlit023的专栏 1700

ai声音模仿_该AI只需聆听5秒钟即可克隆您的声音

ai声音模仿This post is about some fairly recent improvements in the field of AI-based voice cloning. If we have hours and hours of footage of a particular voice at our disposal then that voice can be clon...

weixin_26752075的博客 1万+

小论文/大论文必备 | YOLO多模态目标检测、绘制曲线对比图 | 引入多种绘制曲线对比图,包括mAP0.5,mAP0.5:0.95,Loss损失变化的曲线对比

本文通过可视化方法分析YOLO多模态模型的训练过程,对比不同实验的检测精度和损失函数变化。主要内容包括:1)绘制mAP@0.5和mAP@0.5:0.95曲线评估检测精度;2)分析边界框回归损失(box_loss)、分类损失(cls_loss)和分布式损失(dfl_loss)的收敛趋势;3)提供完整的Python代码实现,支持多实验对比,可生成高清曲线图。该方法能直观展示模型训练效果,便于优化策略评估和参数调优。

Ai缝合怪、助力小伙伴高效发论文 263

VS中的C#项目怎样引入另一个项目

场景 在C#项目A中需要引用项目B。 实现 将项目B手动复制到A所在的项目目录下的同一个解决方案中,即与项目A同级的目录下。 在VS中打开项目B,打开解决方案资源管理器--右击解决方案--添加--现有项目 然后找到项目B的.csproj文件打开。 然后看到资源管理器中已经将B添加进来了 点击项目A的引用-右键-添加 将项目下的解决方...

BADAO_LIUMANG_QIZHI的博客 9322

2023.05.09-使用AI克隆孙燕姿的声音来进行唱歌

如果我们想要克隆孙燕姿的声音,整体的思路很简单,首先找一些孙燕姿唱歌时没有伴奏的人声,然后把这个声音放到模型中进行训练拟合,让AI学习说话的这种声线风格,最后使用这个训练出来的模型进行推理和风格迁移,这样一首孙燕姿唱其他人歌曲的音频就制作出来了。

u014723479的博客 5154

甲基化生物信息学分析及批次效应校正全流程

本文系统阐述了DNA甲基化数据分析中的批次效应问题及解决方案。甲基化数据(β值和M值)对实验批次差异高度敏感,可能导致假阳性结果。文章详细介绍了批次效应检测方法(PCA可视化、BEclear定量评分)和校正流程,包括数据预处理、参数化(ComBat-met)与非参数化(BEclear)校正方法,并提供了完整的R代码实现。重点解决了β值有界分布与统计模型假设冲突的问题,为甲基化研究的可靠性提供技术保障。

huanghm88的专栏 111

AI软件克隆你的声音,全球诈骗案件已屡次得逞!

在2月28号刚于旧金山结束的RSA大会上,一家名为Pindrop的专门检测语音诈骗的初创公司再次向业内发出警告:网络诈骗份子已经开始借助AI软件克隆声音进行诈骗了!Pindrop的CEO...

网易智能 1857

visio安装包

Microsoft Office Visio 是一款专业的制图软件。利用经过更新的形状、协作工具和数据链接图表,创建专业级图表以简化复杂的信息。

迈瑞BS系列全自动生化分析仪LIS协议接口手册(内含HL7和ASTM)

迈瑞BS系列全自动生化分析仪LIS协议接口手册,内含HL7和ASTM)

AI生成音频(克隆声音)

AI生成语音

bxd_xyz的博客 1026

STM32F407中文手册

STM32f407中文手册 本参考手册面向应用开发人员,提供有关使用 STM32F405xx/07xx、STM32F415xx/17xx、 STM32F42xxx 和 STM32F43xxx 微控制器存储器与外设的完整信息。STM32F405xx/07xx、STM32F415xx/17xx、STM32F42xxx 和 STM32F43xxx 构成一个微 控制器系列,各产品具有不同的存储器大小、封装和外设。有关订购信息以及器件的机械与电气特性,请参见数据手册。有关 ARM Cortex™-M4F 内核的信息,请参见《Cortex™-M4F 技术参考手册》。

“你的声音可能被克隆了”——一文讲清 AI 换声技术的原理与风险

AI换声技术能精准复制任意人的声音,生成几乎无法辨别的假音频。本文详细介绍了声音克隆的技术原理、真实诈骗案例及风险,并分享实用的防范方法,帮助你守护声音隐私和信息安全。

moppol的博客 4007

jre9下载 jdk9

(Java SE Runtime Environment 9.0) 9.0u175 官方最新版 【x86|x64】

Chatterbox 声音克隆 TTS 完整指南:10 秒参考音频克隆任何声音

Chatterbox 是 Resemble AI 开源的 SoTA 文本转语音(TTS)模型,核心能力是零样本声音克隆:你给一段 10 秒参考音频,它就能用这个声音朗读任意文本。适合做低延迟语音代理、有声内容和多语言本地化。 [![Chatterbox Turbo 声音克隆低延迟语音合成](https://raw.gitcode.com/GitHub_Trending/chatterbox7/c

gitblog_00412的博客 755

如何克隆“甲亢哥”的声音制作同款视频

AI工具的进化速度远超想象!评论区留下“

chuangke2025的博客 1737

Fish Speech 1.5声音克隆:用5秒音频复制任何人的声音

本文介绍了如何在星图GPU平台上自动化部署fish-speech-1.5镜像,快速体验先进的声音克隆技术。该工具仅需5-10秒的音频样本,即可克隆出高度相似的声音,并生成新的语音内容,可广泛应用于视频配音、有声读物制作等创意场景,极大提升内容创作效率。

weixin_42509507的博客 634

测评:永久使用的克隆声音配音AI工具:上传一段音频,就能一直用自己的声音配音

源声音的质量真的很重要。想得到高保真的克隆效果,建议你找一个安静的环境,用稍微好一点的麦克风(手机自带也行,但要离嘴近一点),录一段清晰、无杂音、情绪平稳的语音。你给它什么,它就还你什么。

lankanxi的博客 413

危!我用python克隆了女朋友的声音!

Enjoy it!喜欢的话,来个再看喽~如果人多的话,后面我再出个详细的算法原理剖析和训练教程。我是 七七,我们下期见~

2401_84205765的博客 915

百度语音系统Deep Voice新突破 可在几秒内克隆你的声音

文章来源:ATYUN AI平台 百度的AI研究部门近日宣布,其文本到语音(TTS)系统“Deep Voice”已经学会了如何使用仅三秒钟的语音样本数据来模仿人类的声音。 这项技术被称为“语音克隆”,可以用来个性化虚拟助手,比如苹果的Siri、Google Assistant、Amazon Alexa;百度的DuerOS(对话式人工智能系统,在中国支持5000万部设备)。 在医疗保健领域...

whale52hertz的博客 9653

AI声音克隆的“冰与火之歌“:你的声音正在被谁盗用?

上传你自己的声音样本,AI复刻专属音色后,你就能用"自己的声音"讲英语、日语、西班牙语等超过100种语言——不是别人的声音套你的话,而是你的声音说全世界的话。"配音演员山新也坦言,技术层面的"混合侵权"让界定极为困难——"用了你的声音,但吐字习惯用了另一位老师,甚至把声线稍微变一下再用,防不胜防。更夸张的是,克隆后的声音还能设置"愤怒""悲伤""惊讶"等不同情感效果,甚至翻译成英日韩等多种语言。毕竟,在AI能复制一切的年代,最值钱的恰恰是那些无法被替代的东西——你的观点、你的表达、你独特的声音印记。

ruhilong的博客 408

OpenVoice语音克隆实战:如何用30秒音频复制任何人声音

OpenVoice是一款强大的语音克隆工具,能够让你仅用30秒音频就能精准复制任何人的声音。无论是制作个性化语音助手、创建有声内容,还是进行语音合成实验,OpenVoice都能为你提供简单高效的解决方案。 ## 🎯 什么是OpenVoice语音克隆 语音克隆技术正迅速改变我们与音频内容的交互方式。OpenVoice作为其中的佼佼者,采用先进的AI算法,能够分析少量音频样本中的声音特征,并生成

gitblog_01037的博客 1067

声音克隆与情感合成:IndexTTS2让AI语音会“演戏”

B站开源IndexTTS2语音合成模型,支持5秒克隆声音并精准控制情感。该模型解决了传统语音合成的两大难题:情感表达缺失和时长控制不精准,实现了音色与情感的分离建模。本地部署需要Ubuntu系统、CUDA环境和22G显存,通过UV工具安装依赖,从ModelScope下载模型权重。启动后可在网页界面选择声音样本、调整情感参数并生成语音。IndexTTS2将专业语音合成技术变为易用工具,大幅降低了高质量语音内容的制作门槛,未来或将广泛应用于各类内容创作场景。

paopao_wu的专栏 1362

首例“AI声音侵权案”宣判!聊聊怎么调用API接入百度内容审核平台

去年的“AI孙燕姿”活跃至今,最近,比如昆仑万维发布「天工Sky Music」,Open AI发布能用15秒克隆任何语音的Voice Engine,网易云面向专业音乐人内测「网易天音」,Stable Audio 2.0支持用户通过文本或音频生成3分钟的高质量音乐。在全球风险投资的低潮期,生成式AI(GenAI)逆市而起,融资额增长了400%,但GenAI的商业化还处在探索阶段。越来越多的公司加入AI生成音频的浪潮,试图借此打通一条AI变现的新路径。

ZNNRZNNR的博客 2174
上一篇: LLM幻觉入门到精通,有中科院这篇300+论文的综述就够了!
下一篇: 零样本指代分割再破纪录!REFAM的“注意力磁铁”到底有多神?看这篇就够了!
Python_金钱豹
博客等级 码龄5年 1万+粉丝 2841原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值