(保姆级教程)语义端点检测入门:Phoenix-VAD从原理到实战,收藏这篇就够了!

Phoenix-VAD:流式语义VAD 在人机语音交互领域,以GPT-4为代表的大型语言模型(LLM)极大地提升了对话系统的智能水平,使其能够进行更自然、更富有上下文的交流。然而,一个长期存在的瓶颈——交互的流畅性——依然阻碍着我们迈向真正无缝的人机对话。目前大多数语音助手仍采用半双工(half-duplex)的“对讲机”模式,用户和系统无法同时说话,导致了延迟和僵硬的交互体验。实现全双工(full-duplex)交互,即系统能够边听边说边思考,是下一代语音交互的必然趋势。这其中的核心技术难题之一,便是:系统如何实时判断用户是否已经“说完了” 阅读详情

现在人机语音交互确实挺火的,像GPT-4o这种能跟人聊的口语模型确实厉害,但一直有个问题——缺个“拿来就能用、还能支持双向实时聊”的语义端点检测模块。简单说就是,没法灵活判断用户啥时候真说完了、能不能随时打断,导致聊起来总有点不顺畅。

之前的方案都有坑:传统的VAD(语音活动检测)只知道“有没有人声”,根本不懂用户想表达啥,交互自然不起来;Semantic VAD倒是懂点语义,但得额外装个ASR(语音识别)模块,又慢还容易丢音频里的信息;像RTTL-DG、Moshi这些模型更麻烦,不能“拆下来随便换地方用”,换个对话模型就得重新训练一遍,所以团队才搞出了Phoenix-VAD这个模型:

一、模型咋设计的?3个核心部件+1个滑动窗口 trick

Phoenix-VAD是靠大语言模型(LLM)搭的,目标很明确:既要懂语义,又能实时处理,还能随便插在不同对话模型上用。具体分两部分设计:

三大核心部件:解决“音频转语义”的适配问题

音频编码器:用的是150M参数的Zipformer,之前还在10万多组内部ASR数据上训练过,能把原始语音波形转换成25Hz的“帧级特征”——简单说就是先把语音里的关键信息抽出来,方便后续处理。

适配器:就是两个线性层加个ReLU激活函数,专门解决“音频特征和文本特征对不上”的问题。它先把编码器输出的音频特征,按几帧拼一块做下采样,再转成LLM能“看懂”的文本embedding,最后输出适配好的特征。

LLM:用的是Qwen2.5-0.5B-Instruct,给它喂两样东西:一是适配器处理好的音频特征,二是文本提示(比如告诉它“你是个VAD,要判断用户是不是还在说”),最后让它输出两个结果:要么是“Continue Speaking”(用户还在说),要么是“Stop Speaking”(用户说完了)。

滑动窗口训练:解决“实时处理”的延迟问题

要做到实时交互,总不能等用户把话全说完再判断,所以用了“滑动窗口”策略:

针对100Hz的语音特征序列,窗口设成256帧(对应2560ms),每次往前挪32帧(320ms);

训练的时候,只盯着每个窗口“最后一个chunk”做监督——不用等整段语音,就能一块一块增量预测,既保留了局部的语义上下文,又能减少延迟,刚好满足实时交互的需求。

二、训练数据咋来的?3步造“像真实聊天”的数据

要让模型学会判断“语义完整不完整”,得有对应的训练数据,分3步搞定:

造文本:结合内部的文本资源和ChatGPT API,生成两种文本:一种是“语义完整”的(比如“帮我查一下最新的订单信息”),一种是“语义不完整”的(比如“帮我查<停顿>最新的订单信息”);

合成音频:用Index-TTS工具把文本合成语音,为了模拟不同人的声音,还从库里随机选了1007个英语、1010个中文说话人的声音模板;另外还故意插点静音段,还原真实聊天里的“犹豫、中断”场景;

标标签:用Paraformer工具给每个字标上时间戳,再根据“用户停止说话”的时间点,标两种训练标签:“Continue”(还在说)和“Stop”(说完了)。还特别设置了不同的超时阈值:语义完整的话,等400毫秒就判断“说完了”;不完整的话,等1000毫秒,避免提前打断用户。

三、实验结果咋样?性能能打,还比别人灵活

用40万条音频(总共570小时)训练,然后拿2000条“语义完整”+2000条“语义不完整”的音频做测试:

3.1 基础性能够稳

语义不完整的场景里,准确率98.5%,“说完了”的F1分数0.918,“还在说”的F1分数0.992

语义完整的场景更稳,准确率98.6%,“说完了”F1 0.905,“还在说”F1 0.993

简单说就是,判断“用户还在说”几乎不会错,判断“说完了”也很靠谱。

3.2 对比别人有优势

现在其他模型都有短板,只有Phoenix-VAD能同时做到4件事:不用ASR模块、拿来就能用(即插即用)、实时推理、懂语义。比如Semantic VAD得靠ASR还不能实时,RTTL-DG不能随便插着用,传统VAD不懂语义,这些坑它都避开了。

3.3 消融实验

如果把滑动窗口的步长从320毫秒缩到160毫秒(更细的粒度),性能会下降——因为太细的粒度会让判断更犹豫,还会放大时间戳标注的误差;如果适配器只在ASR数据上训练,也不如“联合训练”效果好,因为ASR数据只关注“语音转文字对不对”,缺了“判断说话边界”需要的时间线索。

四、总结和以后的计划

Phoenix-VAD最核心的价值就是:靠LLM的语义理解能力,加上滑动窗口的实时 trick,弄出了一个“靠谱、实时、能随便用”的语义端点检测模块,刚好补上了全双工语音交互的短板。

以后优化方向:一是让模型能过滤“没用的声音”(比如背景噪音、无意义的嘟囔);二是用真实场景的录音再训练,让它在实际聊天里更好用;最后打算把它装到端到端的对话系统里,让整个交互更顺畅。

如何学习大模型 AI ?

我国在AI大模型领域面临人才短缺,数量与质量均落后于发达国家。2023年,人才缺口已超百万,凸显培养不足。随着Al技术飞速发展,预计到2025年,这一缺口将急剧扩大至400万,严重制约我国Al产业的创新步伐。加强人才培养,优化教育体系,国际合作并进,是破解困局、推动AI发展的关键。

但是具体到个人,只能说是:

“最先掌握AI的人,将会比较晚掌握AI的人有竞争优势”。

这句话,放在计算机、互联网、移动互联网的开局时期,都是一样的道理。

我在一线互联网企业工作十余年里,指导过不少同行后辈。帮助很多人得到了学习和成长。

我意识到有很多经验和知识值得分享给大家,也可以通过我们的能力和经验解答大家在人工智能学习中的很多困惑,所以在工作繁忙的情况下还是坚持各种整理和分享。但苦于知识传播途径有限,很多互联网行业朋友无法获得正确的资料得到学习提升,故此将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。
在这里插入图片描述

2025最新大模型学习路线

明确的学习路线至关重要。它能指引新人起点、规划学习顺序、明确核心知识点。大模型领域涉及的知识点非常广泛,没有明确的学习路线可能会导致新人感到迷茫,不知道应该专注于哪些内容。

对于从来没有接触过AI大模型的同学,我帮大家准备了从零基础到精通学习成长路线图以及学习规划。可以说是最科学最系统的学习路线。

在这里插入图片描述

针对以上大模型的学习路线我们也整理了对应的学习视频教程,和配套的学习资料。

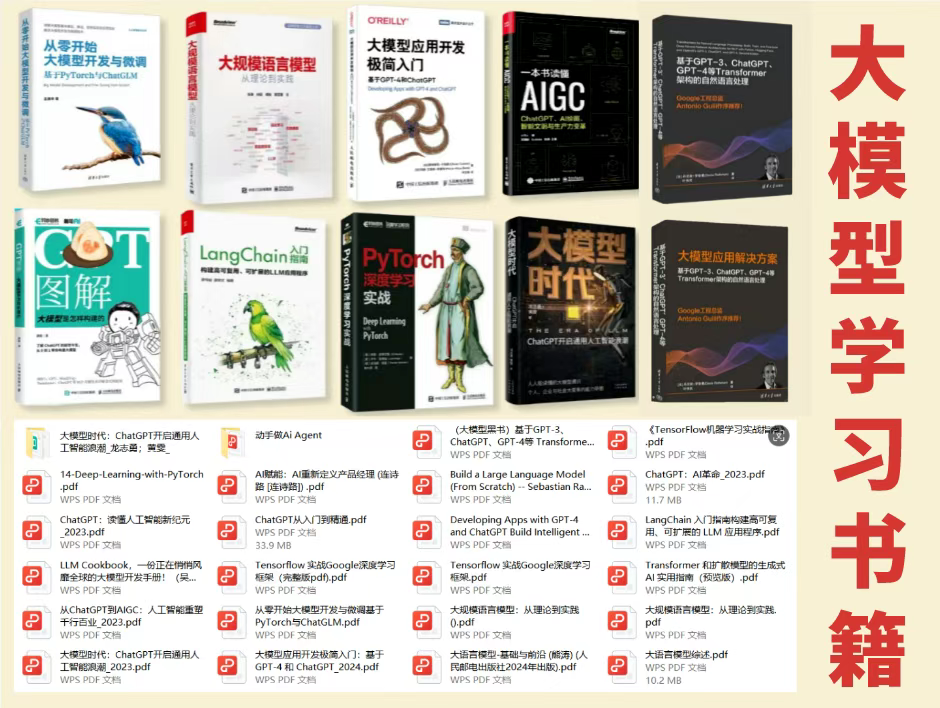
大模型经典PDF书籍

新手必备的大模型学习PDF书单来了!全是硬核知识,帮你少走弯路!
在这里插入图片描述

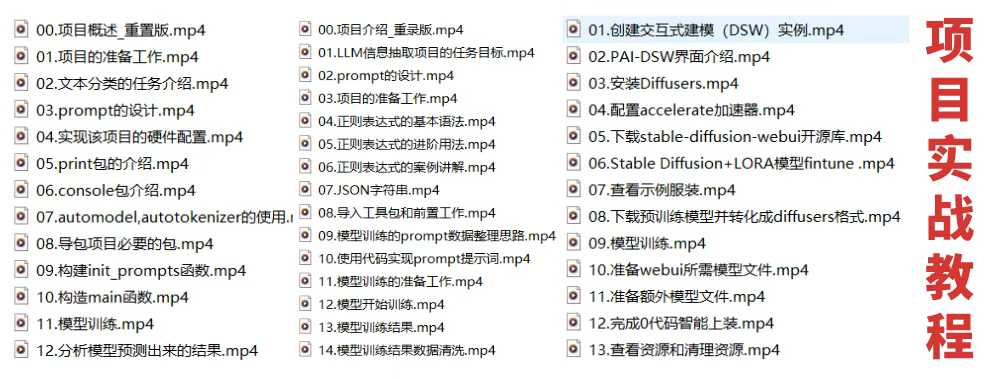
配套大模型项目实战

所有视频教程所涉及的实战项目和项目源码等
在这里插入图片描述

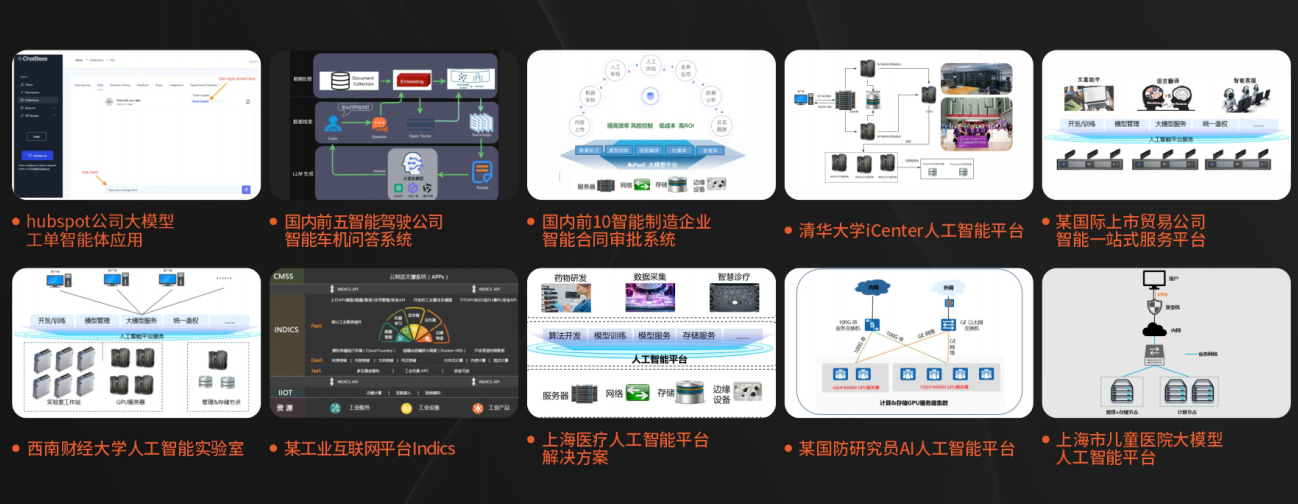
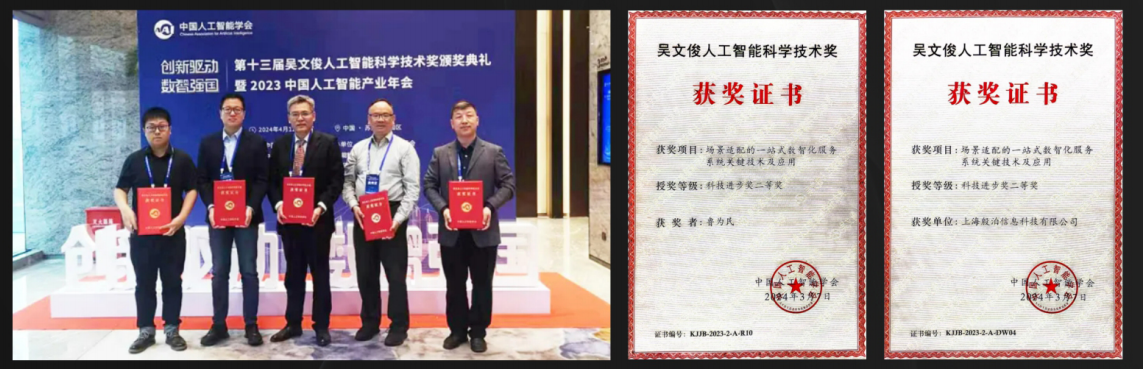
博主介绍+AI项目案例集锦

MoPaaS专注于Al技术能力建设与应用场景开发,与智学优课联合孵化,培养适合未来发展需求的技术性人才和应用型领袖。
在这里插入图片描述

在这里插入图片描述

这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】

在这里插入图片描述

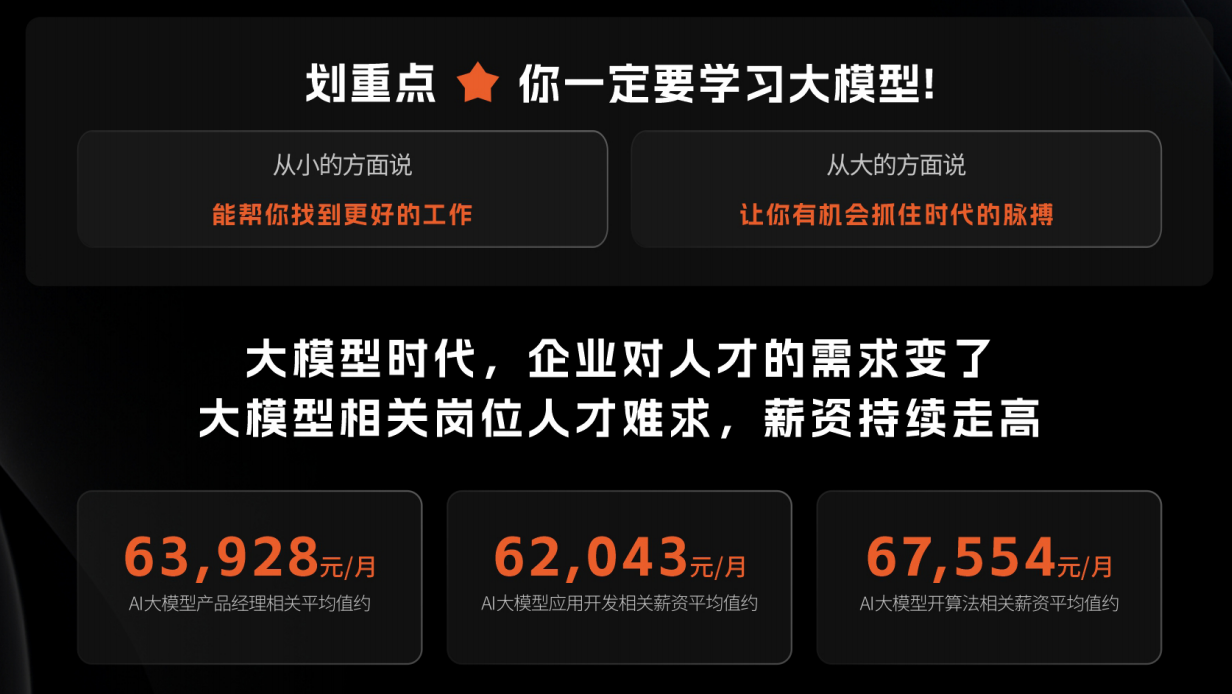
为什么要学习大模型?

2025人工智能大模型的技术岗位与能力培养随着人工智能技术的迅速发展和应用 , 大模型作为其中的重要组成部分 , 正逐渐成为推动人工智能发展的重要引擎 。大模型以其强大的数据处理和模式识别能力, 广泛应用于自然语言处理 、计算机视觉 、 智能推荐等领域 ,为各行各业带来了革命性的改变和机遇 。
在这里插入图片描述

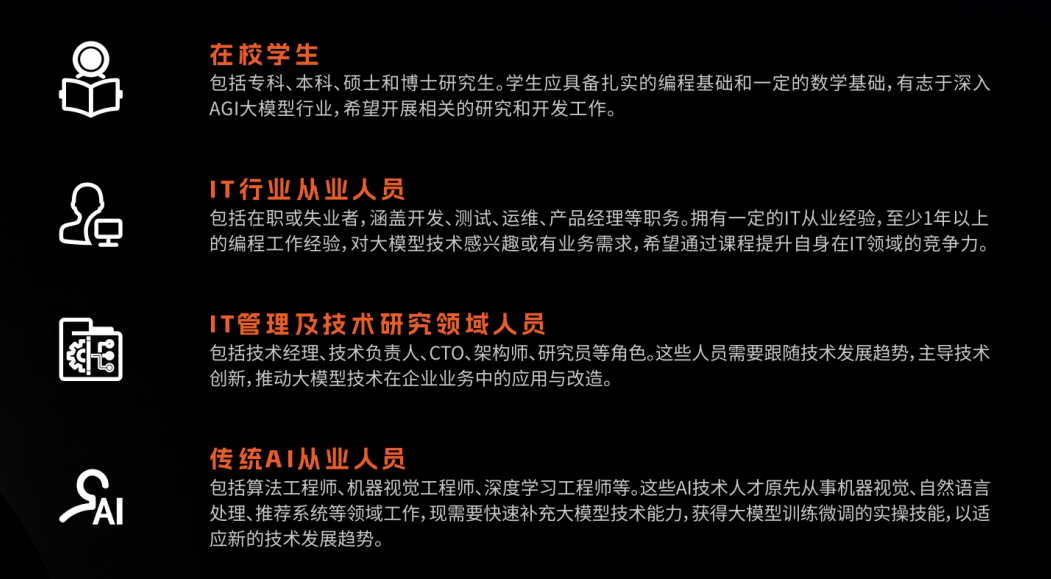
适合人群

  • 在校学生:包括专科、本科、硕士和博士研究生。学生应具备扎实的编程基础和一定的数学基础,有志于深入AGI大模型行业,希望开展相关的研究和开发工作。
  • IT行业从业人员:包括在职或失业者,涵盖开发、测试、运维、产品经理等职务。拥有一定的IT从业经验,至少1年以上的编程工作经验,对大模型技术感兴趣或有业务需求,希望通过课程提升自身在IT领域的竞争力。
  • IT管理及技术研究领域人员:包括技术经理、技术负责人、CTO、架构师、研究员等角色。这些人员需要跟随技术发展趋势,主导技术创新,推动大模型技术在企业业务中的应用与改造。
  • 传统AI从业人员:包括算法工程师、机器视觉工程师、深度学习工程师等。这些AI技术人才原先从事机器视觉、自然语言处理、推荐系统等领域工作,现需要快速补充大模型技术能力,获得大模型训练微调的实操技能,以适应新的技术发展趋势。
    在这里插入图片描述

课程精彩瞬间

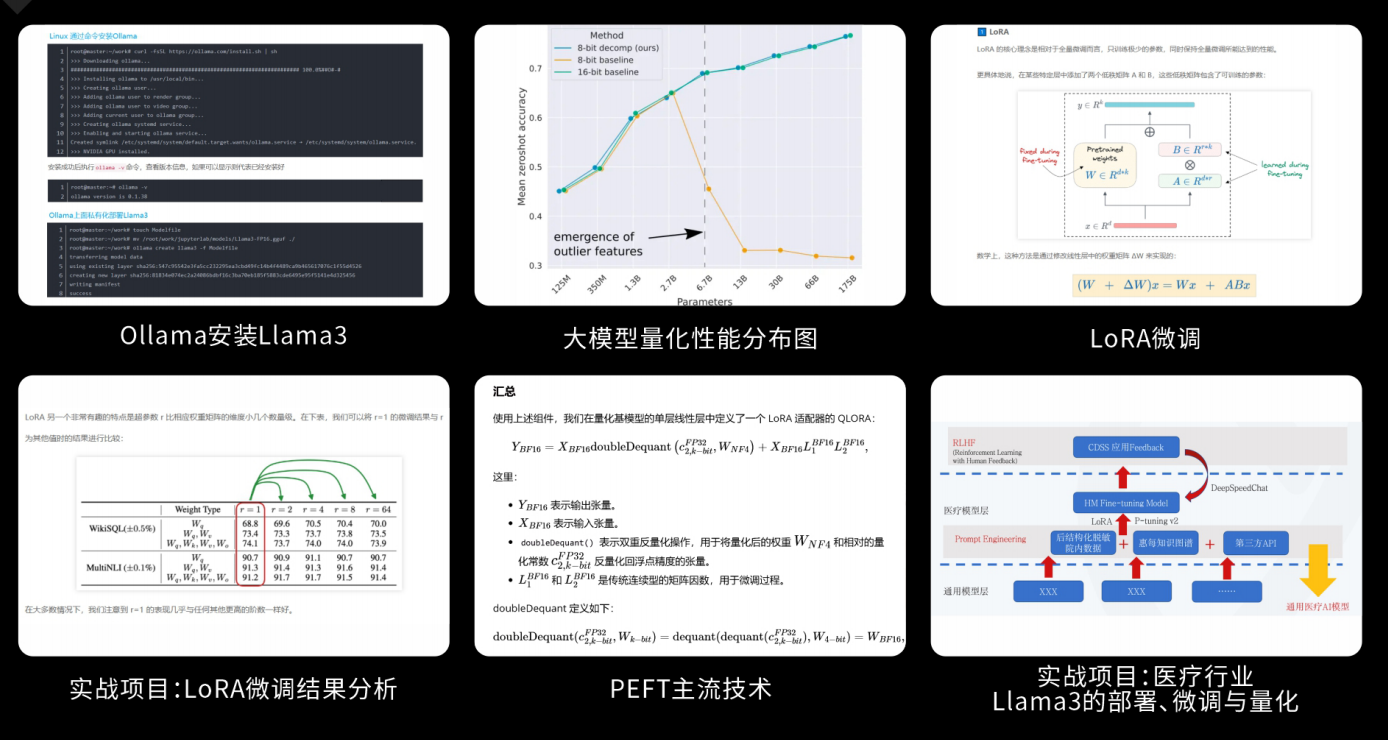
大模型核心原理与Prompt:掌握大语言模型的核心知识,了解行业应用与趋势;熟练Python编程,提升提示工程技能,为Al应用开发打下坚实基础。

在这里插入图片描述

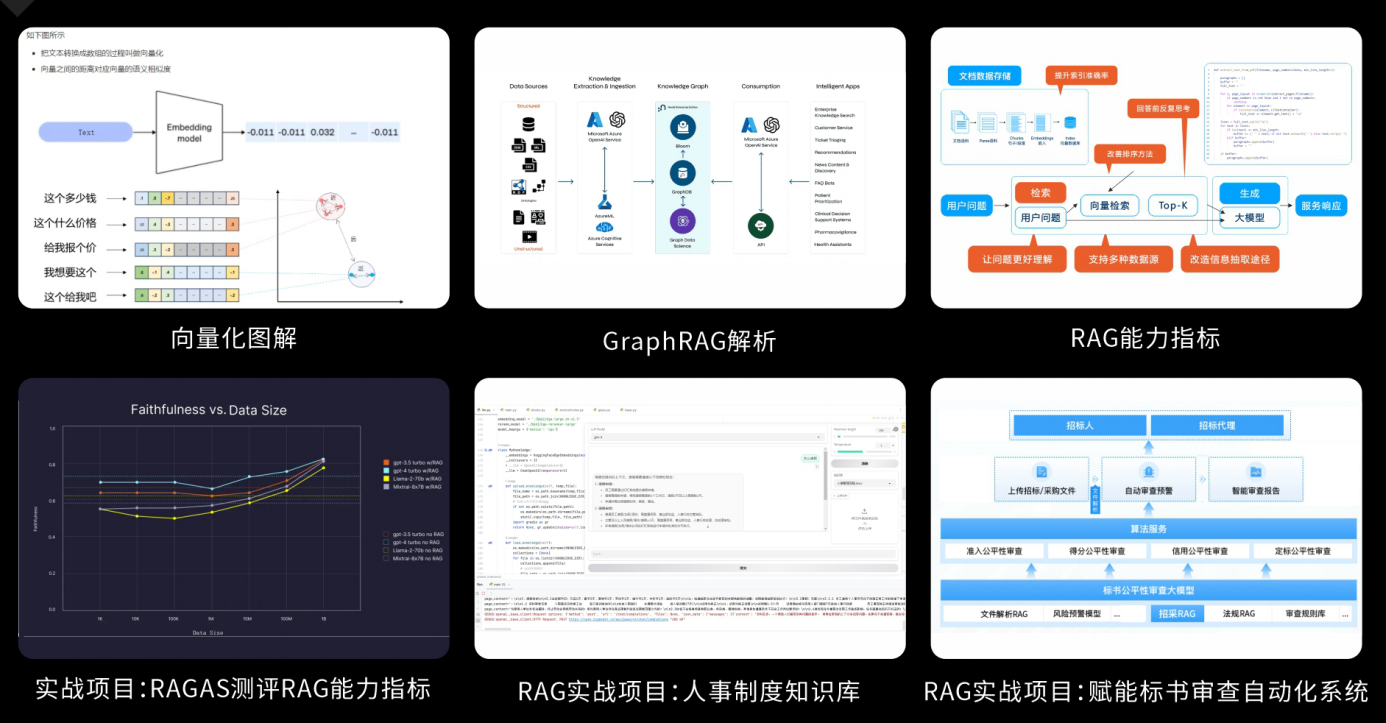
RAG应用开发工程:掌握RAG应用开发全流程,理解前沿技术,提升商业化分析与优化能力,通过实战项目加深理解与应用。 在这里插入图片描述

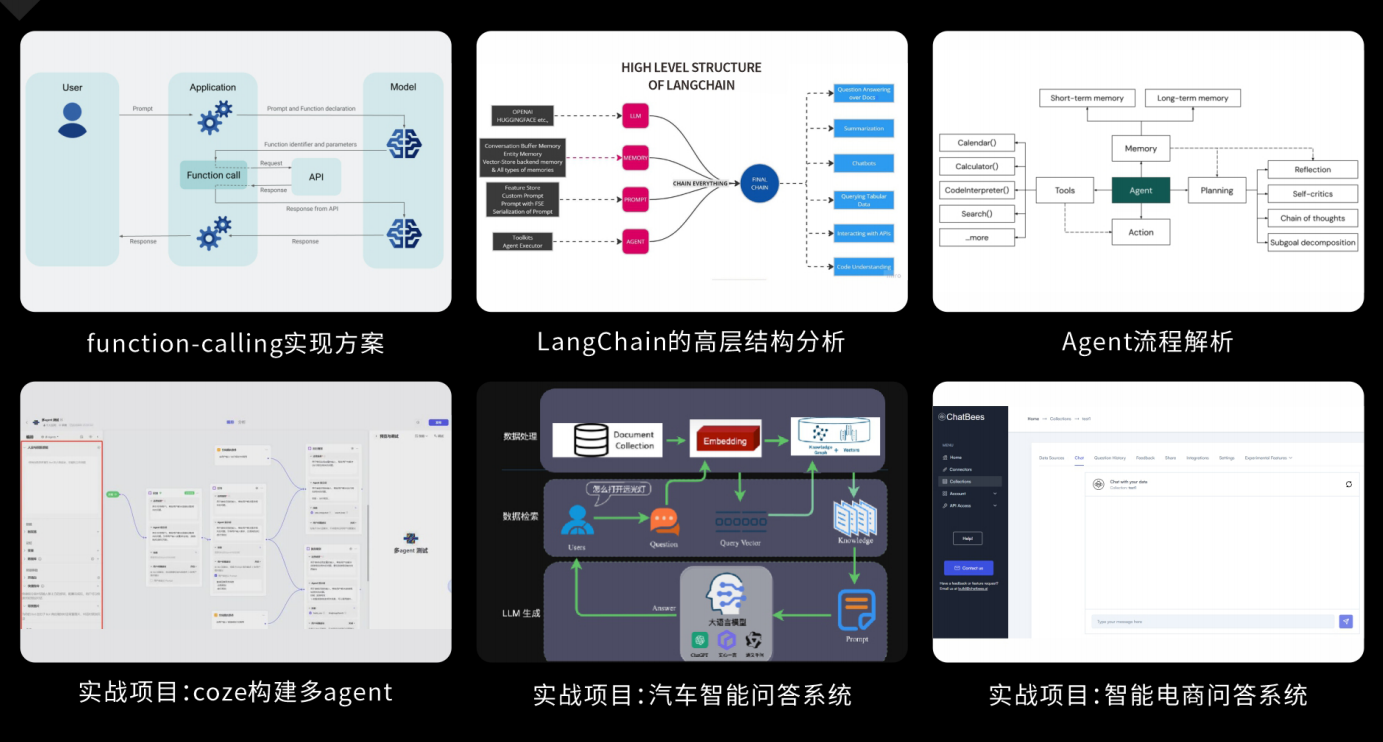
Agent应用架构进阶实践:掌握大模型Agent技术的核心原理与实践应用,能够独立完成Agent系统的设计与开发,提升多智能体协同与复杂任务处理的能力,为AI产品的创新与优化提供有力支持。
在这里插入图片描述

模型微调与私有化大模型:掌握大模型微调与私有化部署技能,提升模型优化与部署能力,为大模型项目落地打下坚实基础。 在这里插入图片描述
顶尖师资,深耕AI大模型前沿技术

实战专家亲授,让你少走弯路
在这里插入图片描述

一对一学习规划,职业生涯指导

  • 真实商业项目实训
  • 大厂绿色直通车

人才库优秀学员参与真实商业项目实训

以商业交付标准作为学习标准,具备真实大模型项目实践操作经验可写入简历,支持项目背调

在这里插入图片描述
大厂绿色直通车,冲击行业高薪岗位
在这里插入图片描述

文中涉及到的完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】

在这里插入图片描述

智能语音测试简述 语音VAD的全称是Voice Activity Detection,即语音活性检测或语音活动检测,也称为speech activity detection或speech detection。这是一项用于语音处理的技术,主要目的是检测语音信号是否存在。VAD系统通常包括特征提取和语音/非语音判决两个主要部分。在特征提取阶段,常用的方法包括基于能量的检测、倒谱特征等。基于能量的检测是通过检测信号的强度来判断是否有语音存在,假设语音能量大于背景噪声能量。当能量大于某一门限时,可以认为有语音存在。 阅读详情

相关推荐

audio语音相关的基础知识-VAD,ASR,AEC,AGC,BF等

有音素之间的间隙,也有静音和语音本身的间隙,为了对数据从时间上进行相对的校准,语音端点检测技术就应运而生了,因此端点检测技术可以决定这种校准的相对精度,使得同一内容的特征更趋于相同,当然,一般情况下是不可能完全相同的。盲源分离的目的是求得源信号的最佳估计,盲辨识的目的是求得传输通道的。这个技术的主要任务是从带有噪声的语音中准确的定位出语音的开始和结束点,因为语音中含有很长的静音,也就是把静音和实际语音分离开来,因为是语音数据的原始处理,所以VAD是语音信号处理过程的关键技术之一。呈现出与会者清晰的声音。

u013250861的博客 1034

一文告诉你智能语音中的VAD模块为什么这么重要

计算机交互技术通过 几年 连续开发,语音信号中包含的情感信息越来越受到关注。通常,语音信号的感情特征多通过语音韵律的变化来表现。例如,当人们生气或惊讶时,演讲速度会增加,音量会增加,音调也会改变,而当...

2356

WebRTC 语音激活检测(VAD)算法

检测原理是根据人声的频谱范围,把输入的频谱分成六个子带(80Hz~250Hz,250Hz~500Hz,500Hz~1K,1K~2K,2K~3K,3K~4K), 分别计算这六个子带的能量。对数似然比分为全局和局部,全局是六个子带之加权之和,而局部是指每一个子带则是局部,所以语音判决会先判断子带,子带判断没有时会判断全局,只要有一方过了,就算有语音。由于实际应用中,单纯依靠能量检测特征检测等方法很难判断人声说话的起始点,所以市面上大多数的语音产品都是使用唤醒词判断语音起始,另外加上声音回路,还可以做语音打断。

u013250861的博客 967

基于大语言模型(LLM)增强的全双工语音对话系统的对话管理

实现语音对话系统(SDS)中的全双工通信,需要在听、说、思考之间进行实时协调。本文提出了一种语义语音活动检测(VAD)模块,作为对话管理器(DM),以高效管理全双工SDS中的轮次切换。该语义VAD模块是一个轻量级(5亿参数)的大语言模型(LLM),在全双工对话数据上进行微调,能够预测四种控制标记以调节轮次切换和保持状态,区分有意和无意的插话,同时检测查询完成,以处理用户的暂停和犹豫。通过在短时间间隔内处理输入语音,语义VAD实现了实时决策,而核心对话引擎(CDE)仅在生成回复时被激活,从而降低了计算开销。

comli_cn的博客 2100

端点检测VAD代码

很好啊!!基于MATLAB的端点检测代码,直接调用就可以啦!!

PLC编程进阶:结构体(UDT)与功能块(FB)的模块化实践指南

本文深入探讨了PLC编程中实现模块化的核心方法,重点解析了结构体(UDT)与功能块(FB)的协同应用。通过将零散数据封装为UDT,并将控制逻辑打包为可复用的FB,能够构建出结构清晰、易于维护和调试的PLC程序。文章结合拧紧枪、电机控制等实战案例,提供了从设计原则到分层架构的完整实践指南,旨在帮助工程师将混乱的‘面条式’代码改造为高效的‘正规军’。

s3t4u的博客 221

大模型的风还是吹到了语音前端

截至2026年6月,语音前端处理算法领域经历了由传统数字信号处理(DSP)与早期判别式深度学习模型向生成式人工智能(Generative AI)、大型语言模模型(LLMs)以及高效状态空间模型(State-Space Models)深度融合的根本性范式转移。语音前端处理不仅涵盖了降噪与单通道语音增强(Speech Enhancement, SE)、声学回声消除(Acoustic Echo Cancellation, AEC)、波束形成与多通道源分离(Beamforming & Source Separati

weixin_48827824的博客 445

【亲测有效】OpenClaw Gateway 出现 “(no output)“ 卡死问题完整解决指南:从手动重启到 systemd Watchdog 自动恢复

最近在使用 OpenClaw(自托管 AI 助手框架,前身 Clawdbot/Moltbot)时,遇到了一个非常常见的顽疾:TUI(终端界面)或 Telegram 等通道经常显示 "(no output)",消息发出去后机器人完全没反应,看起来像是卡死了。

hampeter的博客 8609

Open-XiaoAI Flash Tool:macOS 下小爱音箱 Pro 刷机全流程实战指南

本指南围绕 open-xiaoai 仓库中的 [packages/flash-tool](https://link.gitcode.com/i/d893ac85348cba1c3ac9929a04594d52) 工具,系统讲解如何在 macOS 上通过命令行完成小爱音箱 Pro(LX06)与 Xiaomi 智能音箱 Pro(OH2P)的固件刷写:从依赖安装、设备连接、启动参数设置到分区刷写与系统恢

gitblog_00289的博客 491

手把手教你用ADS优化肖特基二极管检波电路(附RC参数避坑指南)

本文详细介绍了如何使用ADS软件优化肖特基二极管检波电路,包括RC参数设置、常见失真问题分析与解决方案。通过实战案例和参数优化技巧,帮助射频工程师避免设计陷阱,提升电路性能。特别附有RC参数避坑指南,适用于调幅解调、功率检测等应用场景。

m2n3o4p5的博客 198

2025年下半年网络工程师案例分析真题及答案解析

2025年下半年网络工程师案例分析真题及答案解析

鹿鸣天涯 1089

Spicetify CLI 完整指南:5 步给 Spotify 客户端换主题、加扩展、装歌词面板

想边听歌边看逐词滚动的同步歌词,或者把界面绿色换成配得上你桌面的颜色?Spicetify CLI 就是一个在本地改造官方 Spotify 桌面客户端的命令行工具:改 UI 配色、注入功能扩展、挂载自定义应用,都不动官方安装本体。这篇文章带你从零走到「自定义配色 + 快捷键扩展 + 歌词面板」的状态。 [![Spicetify 歌词面板卡拉OK同步歌词效果](https://raw.gitcode

gitblog_00304的博客 860

1.5 RAG技术栈全景图:LangChain vs LlamaIndex深度对比,选错框架后悔3年,一文帮你选对

摘要:LangChain与LlamaIndex框架深度对比 本文全面对比了RAG领域两大主流框架LangChain和LlamaIndex。LangChain是通用AI应用框架,具有模块化设计和丰富生态;LlamaIndex专为RAG优化,提供开箱即用解决方案。功能对比显示,LangChain在文档加载和Agent支持方面更强,而LlamaIndex在检索策略、向量存储和多模态处理上表现更优。代码示例展示了二者实现RAG的不同方式:LangChain需要更多配置但灵活性高,LlamaIndex则提供更简洁的A

yonggeit的博客 3239

基于 AAS 技能库使用 Azure AI VoiceLive Java SDK 构建实时双向语音会话

本技术指南以 agentic-awesome-skills(AAS)仓库中的 [azure-ai-voicelive-java 技能文档](https://pre-link.gitcode.com/i/b6b2bc4476ea0683a40d7e303a2db2a8) 为核心,系统讲解如何使用 `azure-ai-voicelive` Java SDK 通过 WebSocket 实现与 AI 助手

gitblog_00216的博客 155

【Unity】【Photon】Photon Fusion2 的核心Unity组件 NetworkRunner 学习笔记

本文是学习Photon Fusion2 的核心Unity组件 NetworkRunner的学习笔记。

O青草O的博客 Unity和游戏制作知识分享 1271

YOLOv8多传感器融合技术——毫米波雷达融合技术详解

本文介绍了YOLOv8与毫米波雷达融合技术在自动驾驶系统中的应用。毫米波雷达具有全天候工作、测距测速精准等优势,但存在分辨率低等局限。通过融合YOLOv8的视觉检测能力,可显著提升系统在恶劣环境下的感知性能。文章详细阐述了融合实现方法,包括雷达数据处理、目标投影匹配、置信度融合等关键技术,并提供了评估指标和应用场景分析。这种多传感器融合方案能有效弥补单一传感器的不足,为自动驾驶提供更可靠的环境感知能力,是实现高级别自动驾驶的重要技术支撑。

u010117029的博客 175

Kyutai语义VAD技术揭秘:智能语音活动检测的完整实现

在当今智能语音交互的浪潮中,语音活动检测(VAD)技术扮演着至关重要的角色。Kyutai基于Delayed Streams Modeling框架开发的语义VAD技术,为语音处理领域带来了突破性的解决方案。本文将深入剖析这一技术的核心原理、实现方式以及在实际应用中的价值,帮助开发者和技术爱好者全面了解智能语音活动检测的奥秘。 ## 什么是语义VAD技术? 语音活动检测(VAD),也称为语音端点检

gitblog_00387的博客 458

【WRFDA教程第四期】雷达数据同化(Radar Data Assimilation)

雷达数据同化(Radar Data Assimilation)

WW、forever的博客 1759

智能语音信息处理团队14篇论文被语音技术顶会Interspeech 2023接收

近日,Interspeech 2023会议发出了审稿结果通知,语音及语言信息处理国家工程研究中心智能语音信息处理团队共14篇论文被会议接收,论文方向涵盖语音识别、语音合成、话者识别、语音增强、情感识别、声音事件检测等,各接收论文简介见后文。

weixin_48827824的博客 1741

visio安装包

Microsoft Office Visio 是一款专业的制图软件。利用经过更新的形状、协作工具和数据链接图表,创建专业级图表以简化复杂的信息。

数学建模模型总结

这是本人在两年内准备参加数学建模竞赛搜集到的模型资料,已经经过了本人的筛选和整理,希望能够对准备参加数学建模竞赛的学弟学妹们提供一些帮助!

语音识别功能集成总结

一、场景 业务需求,需要集成语音识别功能,供移动端使用。 二、调研 经过初步了解,决定集成国内主流的三家厂商,科大讯飞、百度、腾讯。 讯飞不用说,在语音识别这块之前被评为全球最聪明的50家公司之一,后面两个都是传统的大厂。 三、基本技术概念 VADVoice Activity Detection, 语音端点检测技术。 这个技术的主要任务是从带有噪声的语音中准确的定位出语音的开始和结束点,因为语音中含有很长的静音,也就是把静音和实际语音分离开来,因为是语音数据的原始处理,所以VAD是语音信号处..

yangwubolwg的博客 1976

OV9734 DATASHEET,完整规格书

OV9734完整规格书,包括电气参数,尺寸规格,寄存器配置表等

Delayed-Streams-Modeling项目中的语义VAD输出解析

在语音处理领域,实时语音活动检测(VAD)是一个关键技术,而Delayed-Streams-Modeling项目提供了先进的语义VAD功能。本文将深入解析该项目中语义VAD的输出机制及其技术细节。 ## 语义VAD的输出机制 Delayed-Streams-Modeling项目通过WebSocket协议实时传输语音处理结果,其中包含三种关键消息类型: 1. **Step消息**:这是最频繁出

gitblog_07251的博客 411

复分析 阿尔福斯(Ahlfors) 第三版答案 英文

答案分为十章,有部分习题没有答案,全英文复分析阿尔福斯(Ahlfors) 第三版答案

固定语音指令识别:从唤醒词到语义理解

完成固定语音指令识别的方法通常包括以下几个步骤:

old_power的博客 2177

【编译原理】语义检查

SDD是CFG的扩展将每个语法符号与语义属性相关将每个产生式与一组语义规则相关联,这些规则用于计算产品中每个符号的属性值如果X是一个符号,a是X的一个属性,则用X.a表示。

qq_46130027的博客 1217

c语言实现语音检测vad_黑科技!揭秘能被插嘴打断的智慧语音背后的技术

华为EMUI的小艺长大了?看下图,这一次小艺又进化了什么能力?你想插嘴打断就打断了?嘈杂环境下,怎么不被噪声干扰?本文来揭秘下,能被插嘴打断的智慧语音背后的技术。过滤掉噪声,扫除基础障碍实现插嘴打断的第一步,是让小艺在嘈杂环境下,清楚地识别出人声。声音本质是携带信息的能量波,为了把你的声音从茫茫的噪声海中pick出来,小艺通过音频降噪和语音识别降噪,共同抑制噪声能量、增强人声能量。如果说在嘈杂的背...

weixin_39820177的博客 949

简单叙述智能语音中最重要的VAD模块

计算机交互技术通过几年连续开发,语音信号中包含的情感信息越来越受到关注。通常,语音信号的感情特征多通过语音韵律的变化来表现。例如,当人们生气或惊讶时,演讲速度会增加,音量会增加,音调也会改变,而当你忧郁或伤心时,声音往往很低。因此,振幅的结构、发音的持续时间、说话速度等语音信号的特征是所有重要的研究特征。 在进行语音识别的过程中,系统的处理对象是有效语音信号。尤其在在多人说话的情况下,如果不对输入...

FaGuangFZJ的博客 1094

[深度学习]语义分割、分类定位与目标检测

语义分割 定义:输入图像,并对图像中的每个像素做分类。 以第一幅图像为例,图像中是一只可爱的猫在草地上散步。输出结果应该是,对于每个像素,确定它属于猫、草地或者天空,或者背景亦或其他分类。语义分割并不区分同类目标。也就是说,不会区分第二幅图的这两头牛,这是语义分割的缺点。 语义分割的方法: 滑动窗口:从图像中提取各个图像块,并且分类。缺点:计算繁琐,效率低。 全卷积神经网络: ...

北望花村 2万+
上一篇: 还在手写Agent代码?别傻了!主流开发框架横评,让你效率提升10倍!
下一篇: 下一个AI风口已定:口语语音大模型(SLM)!再不跟上,你将错过整个人机交互的未来!
Python_金钱豹
博客等级 码龄5年 1万+粉丝 2835原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值