


本节我们将重点探讨 LangGraph 中的流程控制机制,特别是如何利用 LangGraph 实现并行分支 (Parallel Branching),构建能够并发执行多个任务、提高系统效率的智能体系统。
在最简单的 LangGraph 流程中,我们使用普通边将节点串联起来,形成一条线性的执行路径。
但线性流程有其局限性:
- 无法处理条件判断:线性流程无法根据状态或外部条件,动态地选择不同的执行路径
- 无法实现并行执行:线性流程只能串行地执行节点,无法同时执行多个独立的任务
- 效率较低:对于一些可以并行处理的任务,线性流程的串行执行方式会浪费计算资源
为了克服这些局限性,LangGraph 提供了强大的流程控制机制,其中分支 (Branching) 和 并发 (Concurrency) 是核心要素。
1. 并行分支:扇出 (Fan-out) 与扇入 (Fan-in)
LangGraph 实现并行分支的核心机制是扇出 (Fan-out) 和 扇入 (Fan-in)。
- 扇出 (Fan-out):从一个节点出发,同时触发多个下游节点,使得流程并行地向多个方向分支
- 扇入 (Fan-in):将多个并行分支的流程汇聚到一个共同的下游节点,实现并行流程的同步和汇合
要实现扇出,最简单的方式是为一个节点添加多个出边,将该节点同时连接到多个下游节点。当 LangGraph 执行到该节点时,会同时、并发地触发所有出边指向的下游节点。
示例 1-1:扇出和扇入的完整并行分支流程
import operatorfrom typing import Annotated, Anyfrom typing_extensions import TypedDictfrom langgraph.graph import StateGraph, START, END# 定义状态,使用 operator.add Reducer 处理并行分支的状态更新class ParallelState(TypedDict): aggregate: Annotated[list, operator.add]def node_a(state: ParallelState): print(f'Adding "A" to {state["aggregate"]}') return {"aggregate": ["A"]}def node_b(state: ParallelState): print(f'Adding "B" to {state["aggregate"]}') return {"aggregate": ["B"]}def node_c(state: ParallelState): print(f'Adding "C" to {state["aggregate"]}') return {"aggregate": ["C"]}def node_d(state: ParallelState): print(f'Adding "D" to {state["aggregate"]}') return {"aggregate": ["D"]}# 构建并行分支图builder = StateGraph(ParallelState)# 添加节点builder.add_node("node_a", node_a)builder.add_node("node_b", node_b)builder.add_node("node_c", node_c)builder.add_node("node_d", node_d)# 添加边:实现扇出和扇入builder.add_edge(START, "node_a") # 从 START 到 node_abuilder.add_edge("node_a", "node_b") # node_a 扇出到 node_bbuilder.add_edge("node_a", "node_c") # node_a 扇出到 node_c (实现扇出)builder.add_edge("node_b", "node_d") # node_b 扇入到 node_dbuilder.add_edge("node_c", "node_d") # node_c 扇入到 node_d (实现扇入)builder.add_edge("node_d", END) # node_d 到 END# 编译图parallel_graph = builder.compile()print("并行分支图构建完成")print("流程: START -> node_a -> (node_b, node_c 并行) -> node_d -> END")# 执行并行分支流程print("\n执行并行分支流程:")result = parallel_graph.invoke({"aggregate": []})print(f"\n最终结果: {result}")并行分支图构建完成流程: START -> node_a -> (node_b, node_c 并行) -> node_d -> END执行并行分支流程:Adding "A" to []Adding "B" to ['A']Adding "C" to ['A']Adding "D" to ['A', 'B', 'C']最终结果: {'aggregate': ['A', 'B', 'C', 'D']}
💡 并行分支核心概念解析:
- • 扇出效果:节点 A 执行完后,同时触发节点 B 和 C,两个节点并发执行
- • 扇入同步:节点 D 必须等待节点 B 和 C 都执行完成后才开始执行,起到同步点作用
- • 状态 Reducer:使用
operator.addReducer 确保并行分支的状态更新能正确合并 - • 执行效率:并行执行比串行执行节省时间,如果 B 需要 3 秒,C 需要 5 秒,并行执行总共只需 5 秒
可以看到执行结果中,节点 B 和 C 是并发执行的,然后节点 D 汇聚了两个分支的结果。
2. 并发 (Concurrency) 而非并行 (Parallelism)
需要明确的是,LangGraph 实现的并非真正的并行 (Parallelism),而是并发 (Concurrency)。理解这个区别对于正确使用 LangGraph 非常重要:
并发 vs 并行的本质区别
- 并行 (Parallelism):同时执行多个独立的任务,需要多个物理计算资源(多核 CPU、多台机器)真正地同时运行不同的代码
- 并发 (Concurrency):在单计算资源上,"看似同时"执行多个任务,通过时间片轮转或异步 IO,CPU 在多个任务之间快速切换
LangGraph 的 Superstep 执行模型
LangGraph 借鉴了 Apache Pregel 分布式图计算框架的 Superstep (超步) 概念:
- Superstep:图执行的基本迭代单元,代表 LangGraph 图执行过程中的一个"步骤"
- 并发执行:在每个 Superstep 中,LangGraph 会尽可能地并发执行所有"就绪"的节点
- 同步屏障:当 Superstep 内的所有节点都执行完成后,进行全局同步,应用状态更新,进入下一个 Superstep
示例 2-1:Superstep 执行模式演示
import timefrom typing import Annotatedfrom typing_extensions import TypedDictfrom langgraph.graph import StateGraph, START, ENDimport operatorclass SuperstepState(TypedDict): superstep_log: Annotated[list, operator.add] timestamp: strdef superstep_node_a(state: SuperstepState): print(f"Superstep 1: 执行节点 A") time.sleep(0.1) # 模拟处理时间 return {"superstep_log": ["Superstep 1: Node A executed"]}def superstep_node_b(state: SuperstepState): print(f"Superstep 2: 执行节点 B (并发)") time.sleep(0.2) # 模拟处理时间 return {"superstep_log": ["Superstep 2: Node B executed"]}def superstep_node_c(state: SuperstepState): print(f"Superstep 2: 执行节点 C (并发)") time.sleep(0.15) # 模拟处理时间 return {"superstep_log": ["Superstep 2: Node C executed"]}def superstep_node_d(state: SuperstepState): print(f"Superstep 3: 执行节点 D (同步后)") time.sleep(0.1) # 模拟处理时间 return {"superstep_log": ["Superstep 3: Node D executed"]}# 构建 Superstep 演示图builder = StateGraph(SuperstepState)# 添加节点builder.add_node("superstep_a", superstep_node_a)builder.add_node("superstep_b", superstep_node_b) builder.add_node("superstep_c", superstep_node_c)builder.add_node("superstep_d", superstep_node_d)# 添加边:演示 Superstep 执行builder.add_edge(START, "superstep_a") # Superstep 1: A 执行builder.add_edge("superstep_a", "superstep_b") # Superstep 2: A -> B (并发)builder.add_edge("superstep_a", "superstep_c") # Superstep 2: A -> C (并发) builder.add_edge("superstep_b", "superstep_d") # Superstep 3: B -> D (同步)builder.add_edge("superstep_c", "superstep_d") # Superstep 3: C -> D (同步)builder.add_edge("superstep_d", END)superstep_graph = builder.compile()print("Superstep 执行模式演示:")print("Superstep 1: 执行 A")print("Superstep 2: 并发执行 B 和 C (等待同步)") print("Superstep 3: 同步后执行 D")print()# 执行并记录时间start_time = time.time()result = superstep_graph.invoke({"superstep_log": []})end_time = time.time()print(f"\\n执行完成,总时间: {end_time - start_time:.3f} 秒")print("执行日志:")for log in result["superstep_log"]: print(f" - {log}")Superstep 执行模式演示:Superstep 1: 执行 ASuperstep 2: 并发执行 B 和 C (等待同步)Superstep 3: 同步后执行 DSuperstep 1: 执行节点 ASuperstep 2: 执行节点 B (并发)Superstep 2: 执行节点 C (并发)Superstep 3: 执行节点 D (同步后)\n执行完成,总时间: 0.422 秒执行日志: - Superstep 1: Node A executed - Superstep 2: Node B executed - Superstep 2: Node C executed - Superstep 3: Node D executed
💡 Superstep 核心特性:
- 并发性:同一个 Superstep 内的多个节点可以并发执行,提高执行效率
- • 同步性:每个 Superstep 结束时有全局同步点,保证状态更新的原子性和一致性
- 迭代性:图执行是 Superstep 的迭代过程,每个 Superstep 在前一个基础上计算
从上面的例子可以看到:
- • Superstep 1: 只有节点 A 执行
- • Superstep 2: 节点 B 和 C 并发执行(等待较慢的任务完成)
- • Superstep 3: 同步后节点 D 执行
总执行时间约等于每个 Superstep 中最慢节点的时间之和,而非所有节点时间的总和。
3. 递归限制与并行分支
递归限制(Recursion Limit)用于限制 LangGraph 图执行过程中的最大 Superstep 迭代次数,防止图无限循环执行。
重要特性
- 计数单位:递归限制的计数单位是 Superstep,而不是节点
- 并行不影响计数:无论一个 Superstep 内部并发执行了多少个节点,都只计为一次 Superstep 迭代
- 防止无限循环:有效防止图陷入无限循环,保护计算资源
示例 3-1:递归限制是对并行分支流程的限制
import operatorfrom typing import Annotated, Anyfrom typing_extensions import TypedDictfrom langgraph.graph import StateGraph, START, ENDfrom langgraph.errors import GraphRecursionError # 导入 GraphRecursionErrorclass State(TypedDict): # operator.add 是状态归约器,确保状态键 aggregate 为 append-only 列表 aggregate: Annotated[list, operator.add]def node_a(state): print("🔄 执行节点 A") return {"aggregate": ["I'm A"]}def node_b(state): print("🔄 执行节点 B") return {"aggregate": ["I'm B"]}def node_c(state): print("🔄 执行节点 C") return {"aggregate": ["I'm C"]}def node_d(state): print("🔄 执行节点 D") return {"aggregate": ["I'm D"]}# 构建图print("🏗️ 构建并行分支图...")builder = StateGraph(State)builder.add_node("a", node_a)builder.add_node("b", node_b)builder.add_node("c", node_c)builder.add_node("d", node_d)# 添加边 - 创建并行分支结构builder.add_edge(START, "a")builder.add_edge("a", "b")builder.add_edge("a", "c") # 从 a 扇出到 b 和 cbuilder.add_edge("b", "d")builder.add_edge("c", "d") # b 和 c 扇入到 dbuilder.add_edge("d", END)graph = builder.compile()print("✅ 图构建完成!")print("\n=== 递归限制和并行分支流程的限制 ===\n")# 测试 1: 正常执行(在递归限制内)print("📊 测试 1: 正常执行 (recursion_limit=10)")try: result = graph.invoke({"aggregate": []}, {"recursion_limit": 10}) print(f"✅ 执行成功,最终结果: {result}")except Exception as e: print(f"❌ 执行失败: {e}")print("\n" + "="*60)# 测试 2: 设置较低的递归限制来触发 GraphRecursionErrorprint("📊 测试 2: 递归限制过低 (recursion_limit=3)")try: # 设置 recursion_limit=3,少于完整流程所需的 Superstep 数量 result = graph.invoke({"aggregate": []}, {"recursion_limit": 3}) print(f"✅ 执行成功,结果: {result}")except GraphRecursionError as e: print(f"⚠️ 捕获 GraphRecursionError 异常: {e}") print("📝 说明: 递归限制过低,无法完成完整的并行分支流程")🏗️ 构建并行分支图...✅ 图构建完成!=== 递归限制和并行分支流程的限制 ===📊 测试 1: 正常执行 (recursion_limit=10)🔄 执行节点 A🔄 执行节点 C🔄 执行节点 B🔄 执行节点 D✅ 执行成功,最终结果: {'aggregate': ["I'm A", "I'm B", "I'm C", "I'm D"]}============================================================📊 测试 2: 递归限制过低 (recursion_limit=3)🔄 执行节点 A🔄 执行节点 B🔄 执行节点 C🔄 执行节点 D⚠️ 捕获 GraphRecursionError 异常: Recursion limit of 3 reached without hitting a stop condition. You can increase the limit by setting the `recursion_limit` config key.For troubleshooting, visit: https://python.langchain.com/docs/troubleshooting/errors/GRAPH_RECURSION_LIMIT📝 说明: 递归限制过低,无法完成完整的并行分支流程
在设计包含并行分支的 LangGraph 流程时,需要根据流程的复杂度合理地设置 recursion_limit 参数。
- 如果设置得过低,则可能导致流程在并行分支执行完成前就因为达到限制而中止,抛出
GraphRecursionError异常。 - 如果设置得过高,则可能无法有效防止流程陷入无限循环,造成不必要的计算资源消耗。
- 建议通过实验和调优,根据流程的实际迭代次数和复杂度选择一个合适的
recursion_limit值。
总结
通过本章的介绍,用户可以了解到如何在LangGraph中创建并行节点执行的分支,利用fan-out和fan-in机制、条件分支以及稳定排序的技术来实现高效的工作流。通过示例代码,用户能够深入理解这些概念,并将在实际应用中得到有效的运用。
如何学习大模型 AI ?
我国在AI大模型领域面临人才短缺,数量与质量均落后于发达国家。2023年,人才缺口已超百万,凸显培养不足。随着Al技术飞速发展,预计到2025年,这一缺口将急剧扩大至400万,严重制约我国Al产业的创新步伐。加强人才培养,优化教育体系,国际合作并进,是破解困局、推动AI发展的关键。
但是具体到个人,只能说是:
“最先掌握AI的人,将会比较晚掌握AI的人有竞争优势”。
这句话,放在计算机、互联网、移动互联网的开局时期,都是一样的道理。
我在一线互联网企业工作十余年里,指导过不少同行后辈。帮助很多人得到了学习和成长。
我意识到有很多经验和知识值得分享给大家,也可以通过我们的能力和经验解答大家在人工智能学习中的很多困惑,所以在工作繁忙的情况下还是坚持各种整理和分享。但苦于知识传播途径有限,很多互联网行业朋友无法获得正确的资料得到学习提升,故此将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。
2025最新大模型学习路线
明确的学习路线至关重要。它能指引新人起点、规划学习顺序、明确核心知识点。大模型领域涉及的知识点非常广泛,没有明确的学习路线可能会导致新人感到迷茫,不知道应该专注于哪些内容。
对于从来没有接触过AI大模型的同学,我帮大家准备了从零基础到精通学习成长路线图以及学习规划。可以说是最科学最系统的学习路线。

针对以上大模型的学习路线我们也整理了对应的学习视频教程,和配套的学习资料。
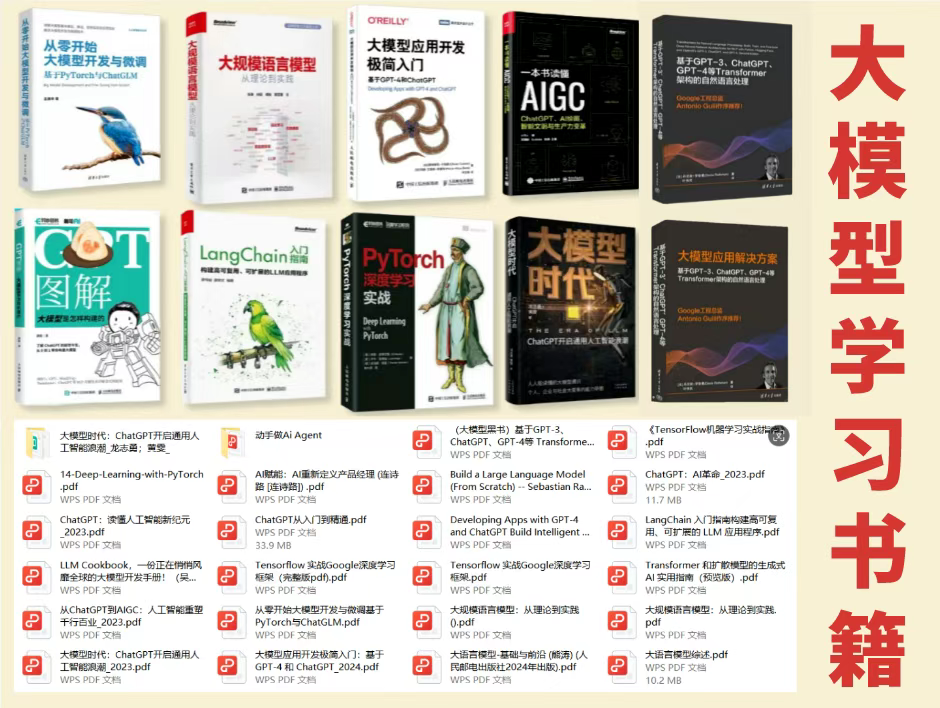
大模型经典PDF书籍
新手必备的大模型学习PDF书单来了!全是硬核知识,帮你少走弯路!
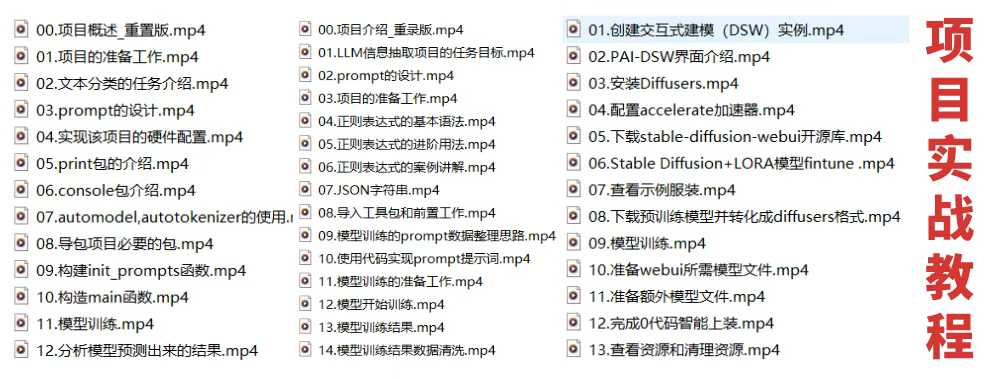
配套大模型项目实战
所有视频教程所涉及的实战项目和项目源码等
博主介绍+AI项目案例集锦
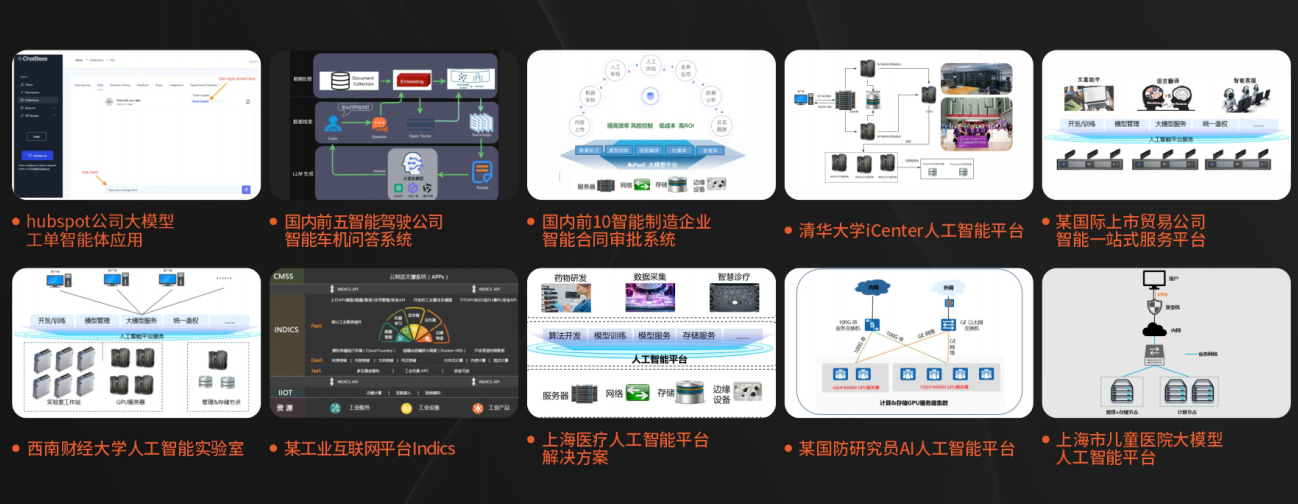
MoPaaS专注于Al技术能力建设与应用场景开发,与智学优课联合孵化,培养适合未来发展需求的技术性人才和应用型领袖。
这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】

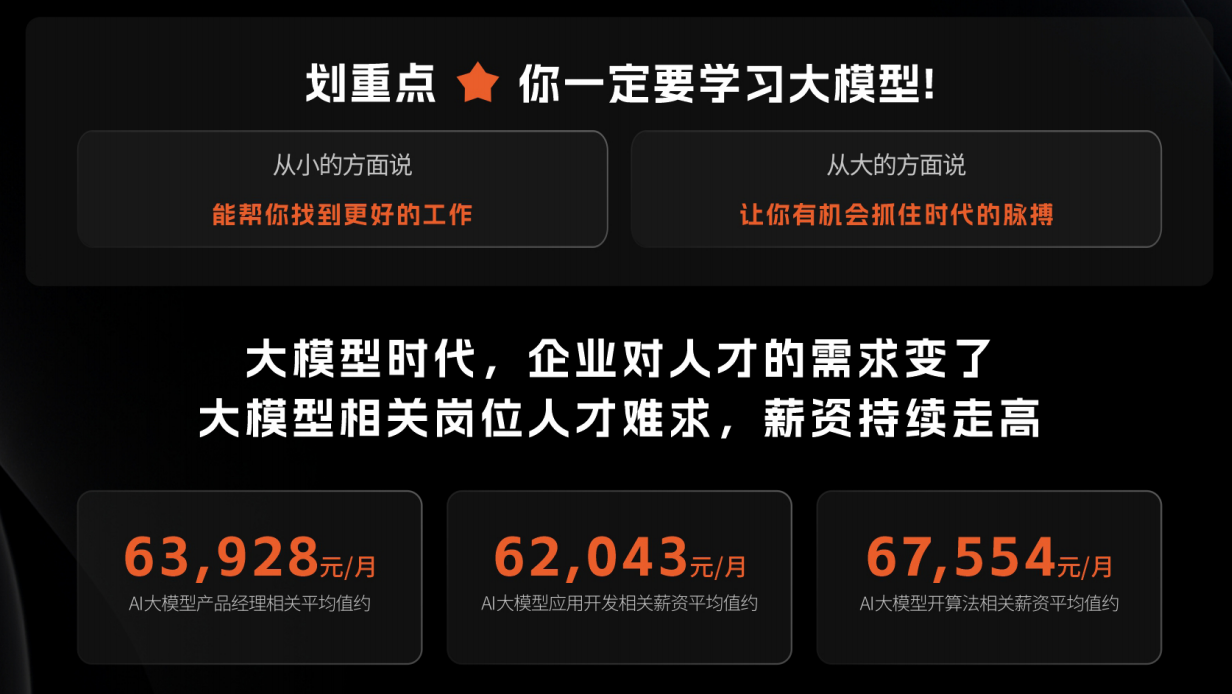
为什么要学习大模型?
2025人工智能大模型的技术岗位与能力培养随着人工智能技术的迅速发展和应用 , 大模型作为其中的重要组成部分 , 正逐渐成为推动人工智能发展的重要引擎 。大模型以其强大的数据处理和模式识别能力, 广泛应用于自然语言处理 、计算机视觉 、 智能推荐等领域 ,为各行各业带来了革命性的改变和机遇 。
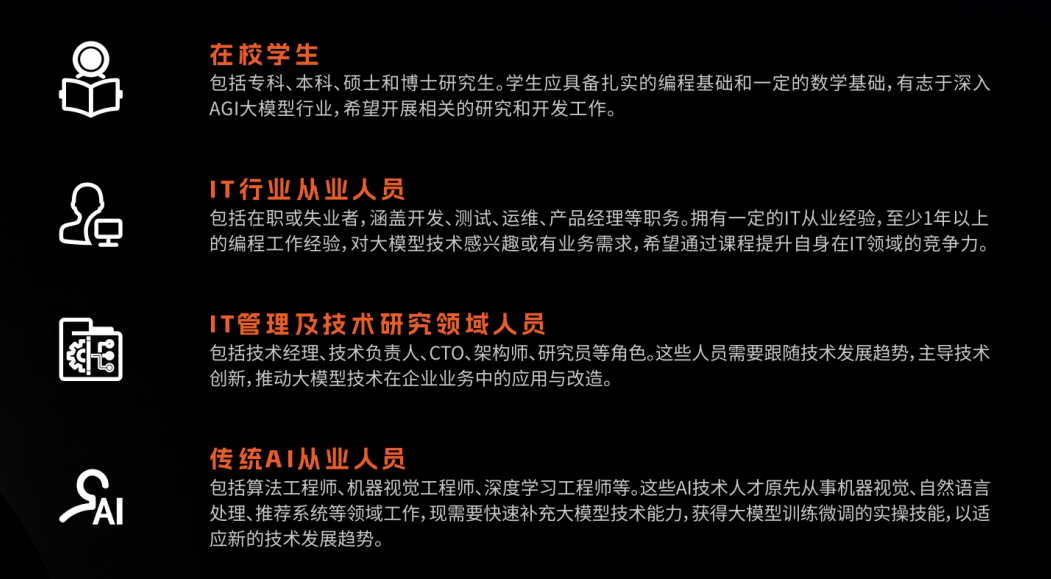
适合人群
- 在校学生:包括专科、本科、硕士和博士研究生。学生应具备扎实的编程基础和一定的数学基础,有志于深入AGI大模型行业,希望开展相关的研究和开发工作。
- IT行业从业人员:包括在职或失业者,涵盖开发、测试、运维、产品经理等职务。拥有一定的IT从业经验,至少1年以上的编程工作经验,对大模型技术感兴趣或有业务需求,希望通过课程提升自身在IT领域的竞争力。
- IT管理及技术研究领域人员:包括技术经理、技术负责人、CTO、架构师、研究员等角色。这些人员需要跟随技术发展趋势,主导技术创新,推动大模型技术在企业业务中的应用与改造。
- 传统AI从业人员:包括算法工程师、机器视觉工程师、深度学习工程师等。这些AI技术人才原先从事机器视觉、自然语言处理、推荐系统等领域工作,现需要快速补充大模型技术能力,获得大模型训练微调的实操技能,以适应新的技术发展趋势。
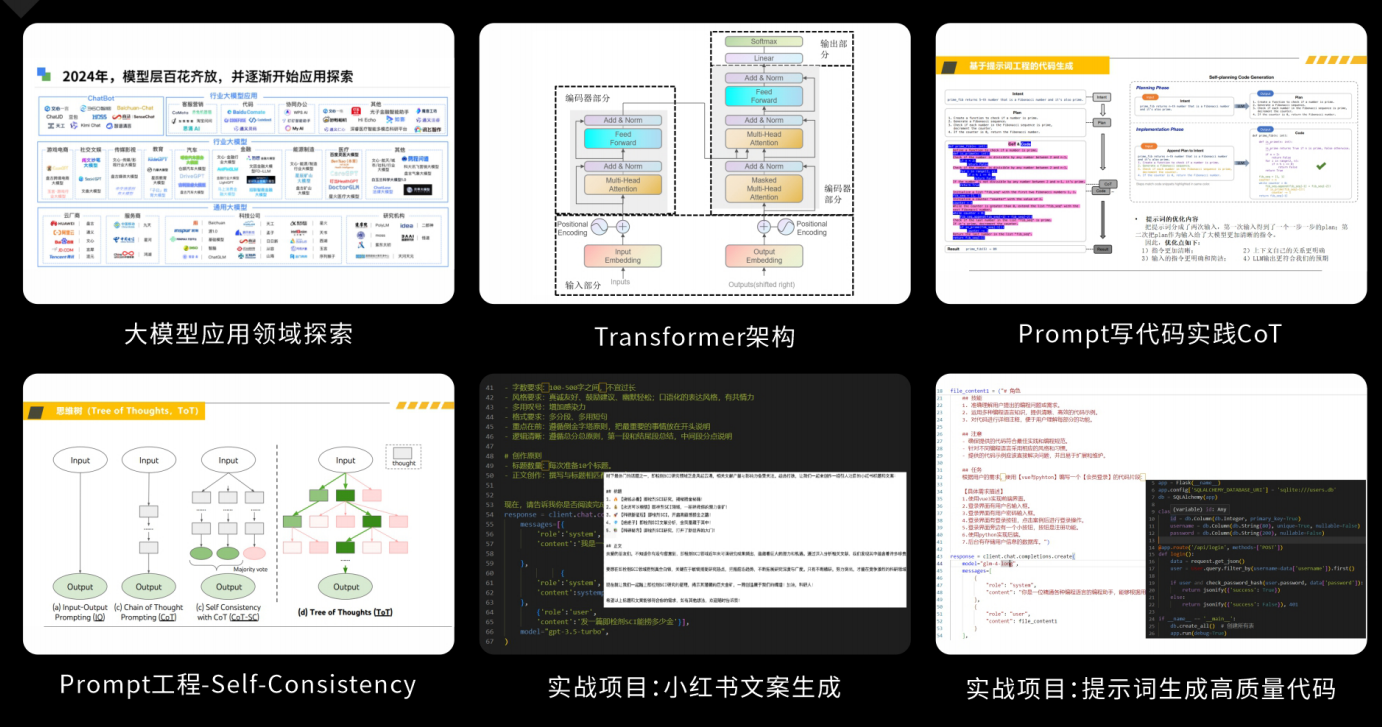
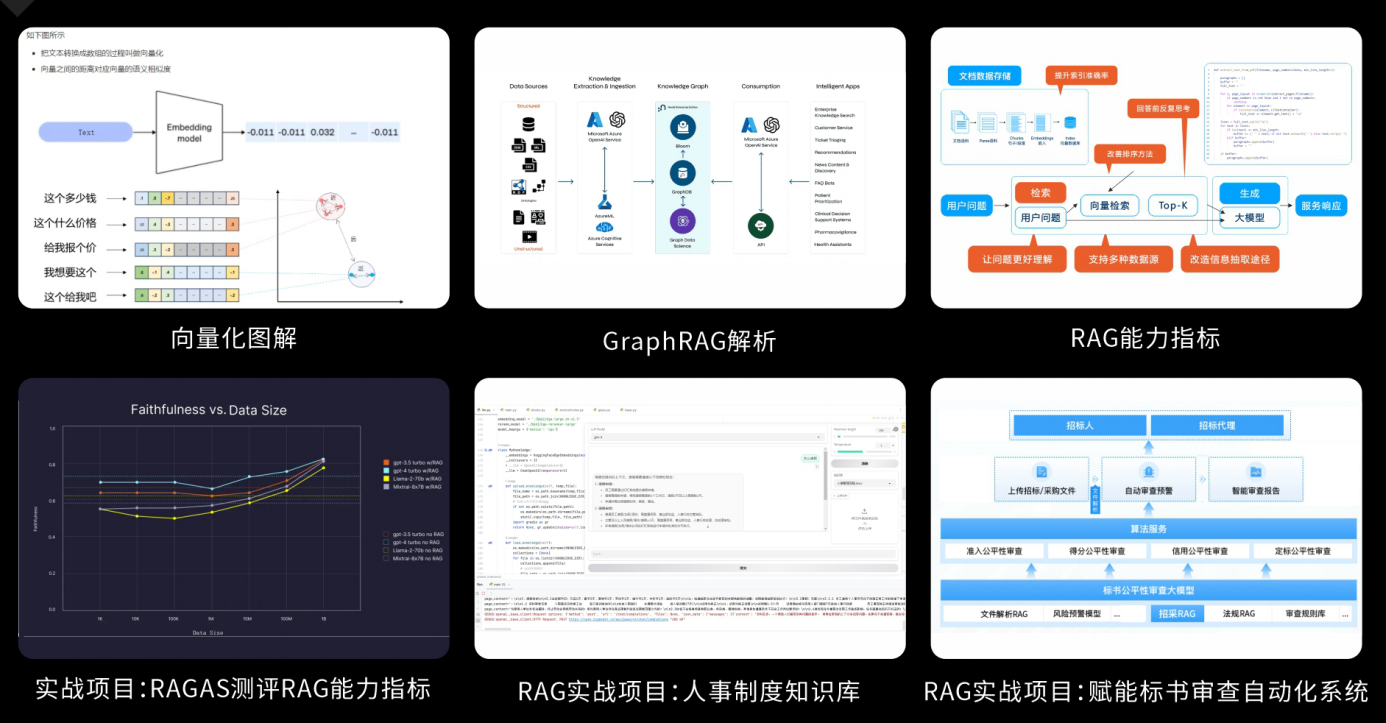
课程精彩瞬间
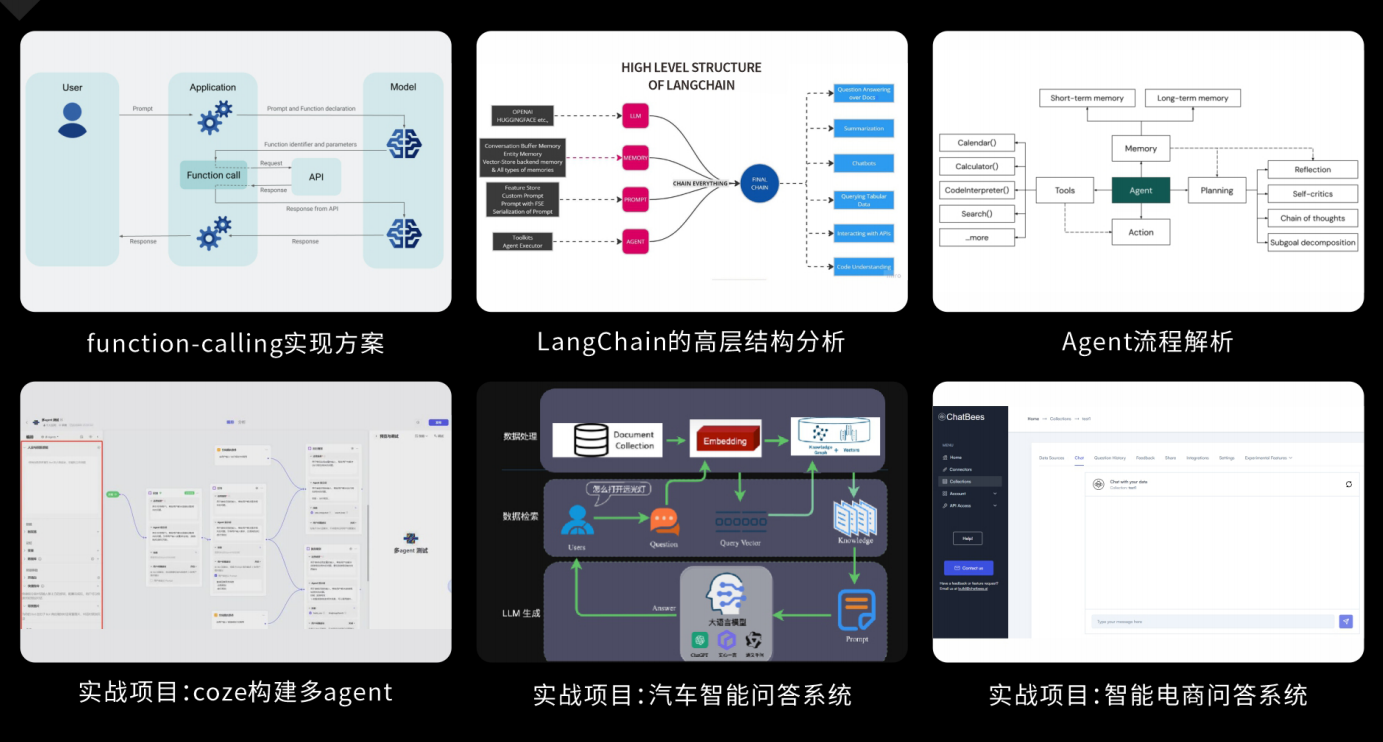
大模型核心原理与Prompt:掌握大语言模型的核心知识,了解行业应用与趋势;熟练Python编程,提升提示工程技能,为Al应用开发打下坚实基础。
RAG应用开发工程:掌握RAG应用开发全流程,理解前沿技术,提升商业化分析与优化能力,通过实战项目加深理解与应用。
Agent应用架构进阶实践:掌握大模型Agent技术的核心原理与实践应用,能够独立完成Agent系统的设计与开发,提升多智能体协同与复杂任务处理的能力,为AI产品的创新与优化提供有力支持。
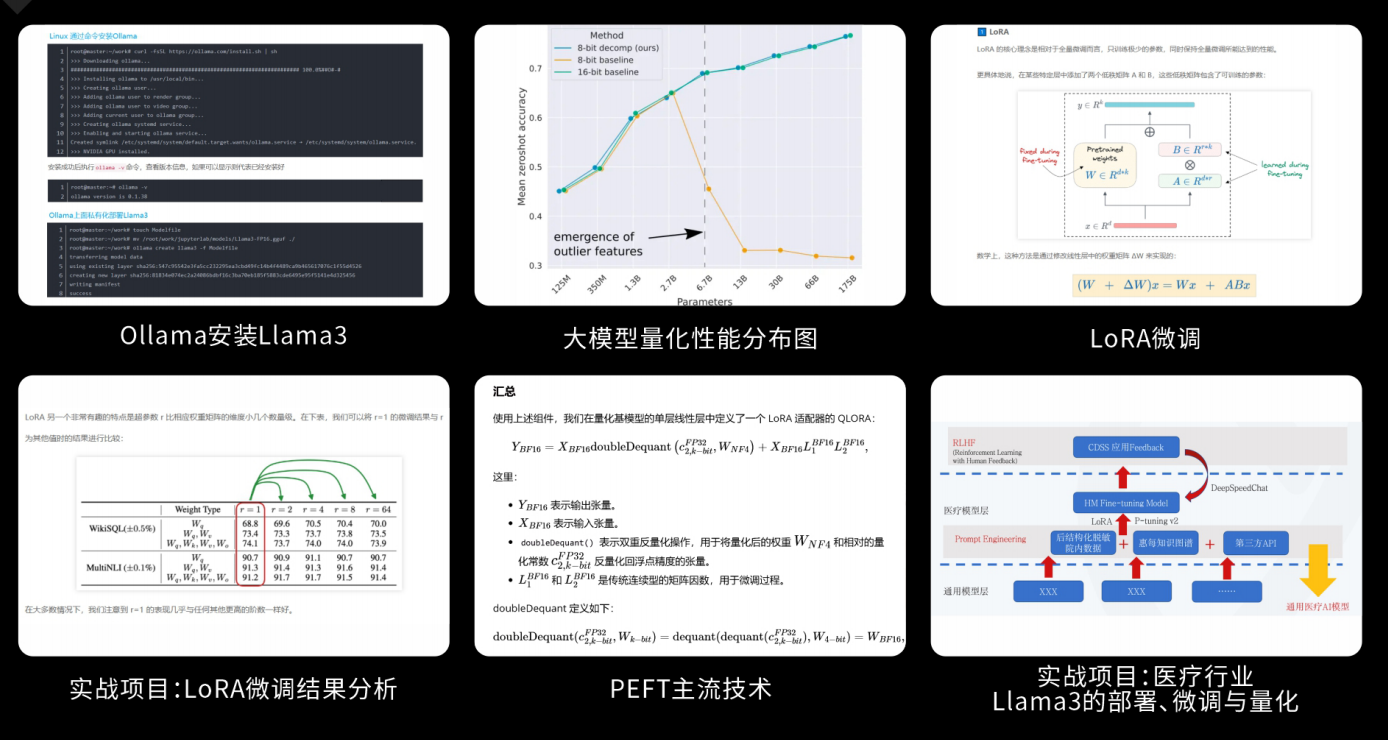
模型微调与私有化大模型:掌握大模型微调与私有化部署技能,提升模型优化与部署能力,为大模型项目落地打下坚实基础。
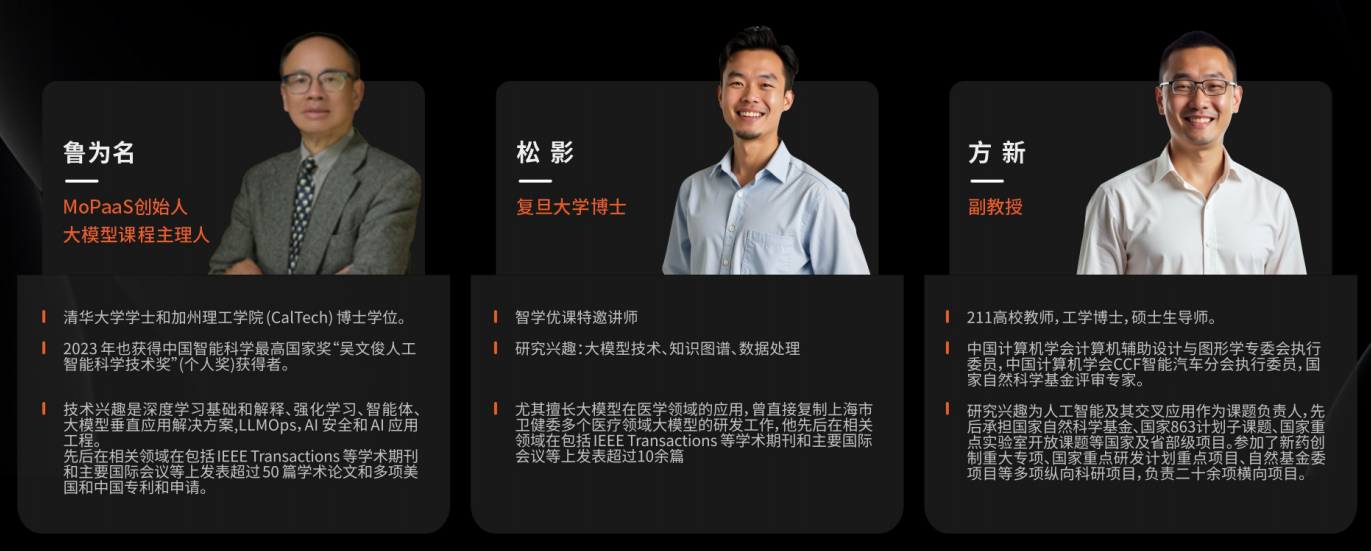
顶尖师资,深耕AI大模型前沿技术
实战专家亲授,让你少走弯路
一对一学习规划,职业生涯指导
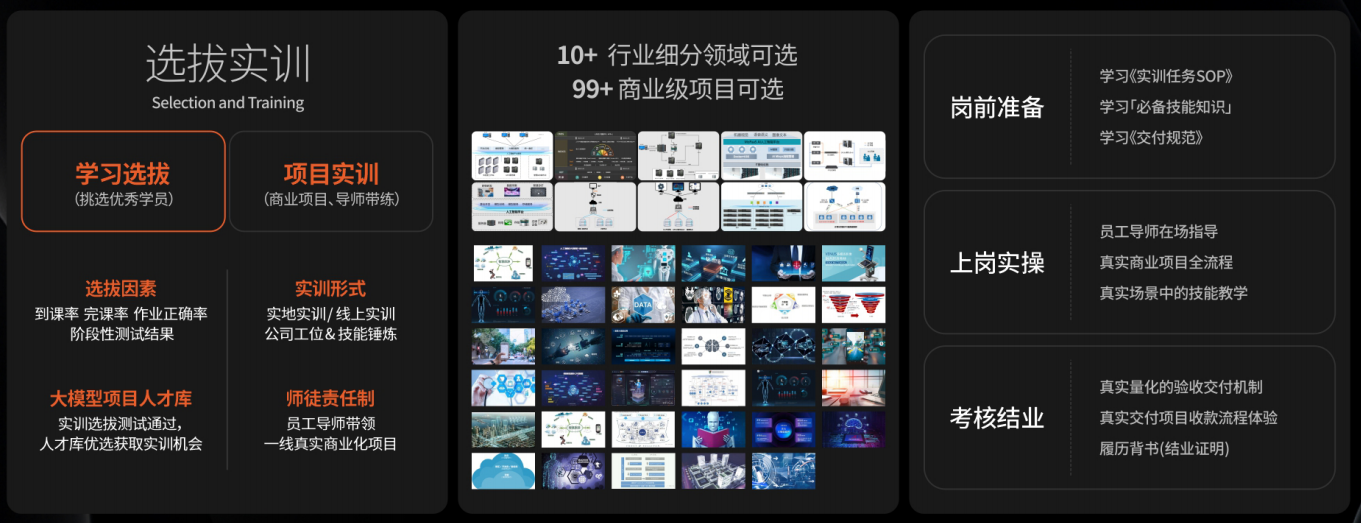
- 真实商业项目实训
- 大厂绿色直通车
人才库优秀学员参与真实商业项目实训
以商业交付标准作为学习标准,具备真实大模型项目实践操作经验可写入简历,支持项目背调
大厂绿色直通车,冲击行业高薪岗位
文中涉及到的完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】
 6766


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


