收藏这篇就够了!多模态RAG超详细教程:MMGraphRAG让AI看得懂说得清(避坑指南)

打造高效多模态RAG系统:原理与评测方法详解 检索:从大规模文本数据库中查找与用户问题相关的片段。生成:将检索到的文本输入大语言模型(LLM),生成最终答案。忽略非文本信息:无法处理图像、表格等非结构化数据。上下文理解受限:仅依赖文本可能导致信息缺失或歧义。多模态RAG系统的评测是确保其有效性和可靠性的重要环节。通过EvalScope等框架,测试工程师可以全面评估系统的忠实度相关性和正确性,并针对性优化。本文提供了从文档解析、向量存储到生成评测的完整实践流程,结合代码示例与评测结果分析,帮助工程师快速构建高效的多模态RAG系统。 阅读详情
AI摘要

本文介绍了MMGraphRAG,一种创新的多模态检索增强生成框架,通过构建多模态知识图谱(MMKG)实现跨模态推理。该方法结合图像场景图与文本知识图,采用谱聚类进行跨模态实体链接,在DocBench和MMLongBench数据集上表现优异,具备良好的领域适应性和推理可解释性。

摘要

检索增强生成(RAG)通过从外部知识库检索相关信息来提升语言模型的生成能力。然而,传统的RAG方法面临丢失多模态信息的问题。多模态RAG方法通过将图像和文本映射到共享嵌入空间来融合二者,但未能捕捉知识和模态间逻辑链的结构。此外,它们还需要针对特定任务进行大规模训练,导致泛化能力有限。为了解决这些限制,我们提出了MMGraphRAG,该方法通过场景图精细化视觉内容,并结合基于文本的知识图谱构建多模态知识图谱(MMKG)。它采用谱聚类来实现跨模态实体链接,并沿推理路径检索上下文以指导生成过程。实验结果显示,MMGraphRAG在DocBench和MMLongBench数据集上达到了最先进的性能,展现了强大的领域适应性和清晰的推理路径。

我们的主要贡献如下:

  1. 首款多模态GraphRAG框架:我们提出了MMGraphRAG,它将图像细化为场景图,并与基于文本的知识图谱结合,构建统一的多模态知识图谱用于跨模态推理。
  2. 中英文实体对齐数据集(CMEL):我们构建并发布了CMEL数据集,该数据集专为视觉与文本实体之间的对齐设计,解决了该领域缺乏基准测试的问题。
  3. 基于谱聚类的CMEL方法:我们设计了一个跨模态实体对齐流程,通过利用谱聚类整合语义和结构信息,高效生成候选实体,从而提升CMEL任务的准确性。

核心速览

研究背景

  1. 研究问题

    :这篇文章要解决的问题是传统检索增强生成(RAG)方法在处理多模态信息时存在的缺失和不足。具体来说,现有的多模态RAG方法虽然能够通过将图像和文本映射到共享嵌入空间来实现跨模态检索,但无法捕捉模态间的知识和逻辑链,并且需要大规模特定任务的训练,导致泛化能力有限。

  2. 研究难点

    :该问题的研究难点包括:如何有效地融合图像和文本信息以捕捉模态间的结构和逻辑链;如何在不需要大规模特定任务训练的情况下提高模型的泛化能力;如何在多模态推理过程中提供可解释的推理路径。

  3. 相关工作

    :该问题的研究相关工作有:GraphRAG系列方法通过构建实体知识图和社区摘要来增强RAG系统的推理能力和可解释性;HM-RAG方法提出了一种分层多代理多模态RAG框架,但依赖于将多模态内容转换为文本;Mel方法扩展了传统的实体链接(EL)方法,将视觉信息作为辅助属性来增强实体与知识库实体的对齐;CMEL方法则进一步将视觉内容视为实体,与文本实体进行对齐,构建多模态知识图(MMKG)。

研究方法

这篇论文提出了MMGraphRAG,用于解决多模态RAG方法在捕捉模态间知识和逻辑链方面的不足。具体来说,

  1. 图像到图的转换

    :首先,使用LLM对图像进行语义分割和推理,生成细粒度的场景图。这个过程包括以下步骤:

  • 使用YOLO进行语义分割,将图像划分为多个语义独立的区域(称为图像特征块)。

  • 使用LLM为每个特征块生成文本描述。

  • 从图像中提取实体及其关系。

  • 将分割的特征块与提取的实体进行对齐。

  • 构建全局实体以描述整个图像,并与局部实体建立连接。

  1. 跨模态融合

    :然后,通过光谱聚类算法生成候选实体对,并进行跨模态实体链接(CMEL),将文本知识图和图像知识图融合为统一的多模态知识图(MMKG)。具体步骤如下:

  • 设计了一个光谱聚类算法,重新设计了加权邻接矩阵A和度矩阵D,以捕捉实体之间的语义和结构信息。
  • 通过标准的光谱聚类程序,构建拉普拉斯矩阵并进行特征分解,形成矩阵Q并使用DBSCAN进行聚类。
  • 对于每个图像实体,选择与其嵌入向量最相关的簇,并将其作为候选实体集。
  • 使用LLM进行实体对齐,确保它们在知识图中共享统一的表示。
  1. 增强剩余图像实体

    :此外,增强未在CMEL中对齐的剩余图像实体的描述,通过整合原始文本中的相关信息来提高图像知识图的完整性。

  2. 全局图像实体与相关文本实体的对齐

    :将对齐每个图像的全局实体与相关文本实体进行对齐,如果没有找到直接匹配项,则在文本知识图中创建一个新实体以表示图像的整体语义内容。

  3. 实体融合

    :对所有对齐的实体进行语义融合,确保在MMKG中具有一致的表示,促进下游推理和检索。

实验设计

  1. 数据集:构建了CMEL数据集,包含来自新闻、学术和小说三个领域的文档,确保广泛的领域多样性。CMEL数据集共包含1114个对齐实例,其中87个来自新闻文章,475个来自学术论文,552个来自小说。

  2. 实验设置:在DocBench和MMLongBench两个多模态文档问答(DocQA)基准上进行实验。DocBench包含229个PDF文档,涵盖五个领域:学术、金融、政府、法律和新闻。MMLongBench包含135个长PDF文档,来自七个不同领域:研究、教程、学术论文、指南手册、宣传册、行政/行业文件和财务报告。

  3. 评估指标:采用微观准确率和宏观准确率作为评估指标。微观准确率按实体计算,反映整体预测的正确性;宏观准确率按文档计算,减轻由于文档间实体分布不平衡引起的评估偏差。

结果与分析

  1. CMEL实验结果

    :光谱聚类方法在CMEL任务中显著优于基于嵌入和LLM的方法,微观准确率提高了约15%,宏观准确率提高了约30%。

  2. 多模态文档问答实验结果

    :在DocBench数据集上,MMGraphRAG在文本和多模态问题上的表现均优于GraphRAG,81.2对71.7,88.7对26.0。在MMLongBench数据集上,MMGraphRAG在准确性和F1分数上也显著优于其他方法,特别是在涉及图表、表格和图形的查询中表现尤为突出。

  3. 跨领域适应性

    :与所有纯文本RAG方法相比,MMGraphRAG在高视觉结构复杂度的领域(如学术和金融)表现出显著的增益,显示出其在专业领域的强大适应能力,同时保持跨领域的泛化能力。

  4. 与MRAG方法的对比

    :MMGraphRAG在多模态信息理解方面显著优于M3DOCRAG,特别是在涉及图表、表格和图形的查询中,MMGraphRAG的准确率为48.2,而M3DOCRAG为39.0。

总体结论

这篇论文提出了MMGraphRAG,一种基于知识图的多模态RAG框架,通过构建细粒度的图像知识图和跨模态融合实现了深度跨模态融合和推理。实验结果表明,MMGraphRAG在多模态文档问答任务中显著优于现有的RAG方法,展现出强大的领域适应能力和清晰的推理路径。该研究为跨模态实体链接和基于图的多模态推理框架的发展提供了新的思路。

如何学习大模型 AI ?

我国在AI大模型领域面临人才短缺,数量与质量均落后于发达国家。2023年,人才缺口已超百万,凸显培养不足。随着Al技术飞速发展,预计到2025年,这一缺口将急剧扩大至400万,严重制约我国Al产业的创新步伐。加强人才培养,优化教育体系,国际合作并进,是破解困局、推动AI发展的关键。

但是具体到个人,只能说是:

“最先掌握AI的人,将会比较晚掌握AI的人有竞争优势”。

这句话,放在计算机、互联网、移动互联网的开局时期,都是一样的道理。

我在一线互联网企业工作十余年里,指导过不少同行后辈。帮助很多人得到了学习和成长。

我意识到有很多经验和知识值得分享给大家,也可以通过我们的能力和经验解答大家在人工智能学习中的很多困惑,所以在工作繁忙的情况下还是坚持各种整理和分享。但苦于知识传播途径有限,很多互联网行业朋友无法获得正确的资料得到学习提升,故此将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。
在这里插入图片描述

2025最新大模型学习路线

明确的学习路线至关重要。它能指引新人起点、规划学习顺序、明确核心知识点。大模型领域涉及的知识点非常广泛,没有明确的学习路线可能会导致新人感到迷茫,不知道应该专注于哪些内容。

对于从来没有接触过AI大模型的同学,我帮大家准备了从零基础到精通学习成长路线图以及学习规划。可以说是最科学最系统的学习路线。
在这里插入图片描述

针对以上大模型的学习路线我们也整理了对应的学习视频教程,和配套的学习资料。

大模型经典PDF书籍

新手必备的大模型学习PDF书单来了!全是硬核知识,帮你少走弯路!
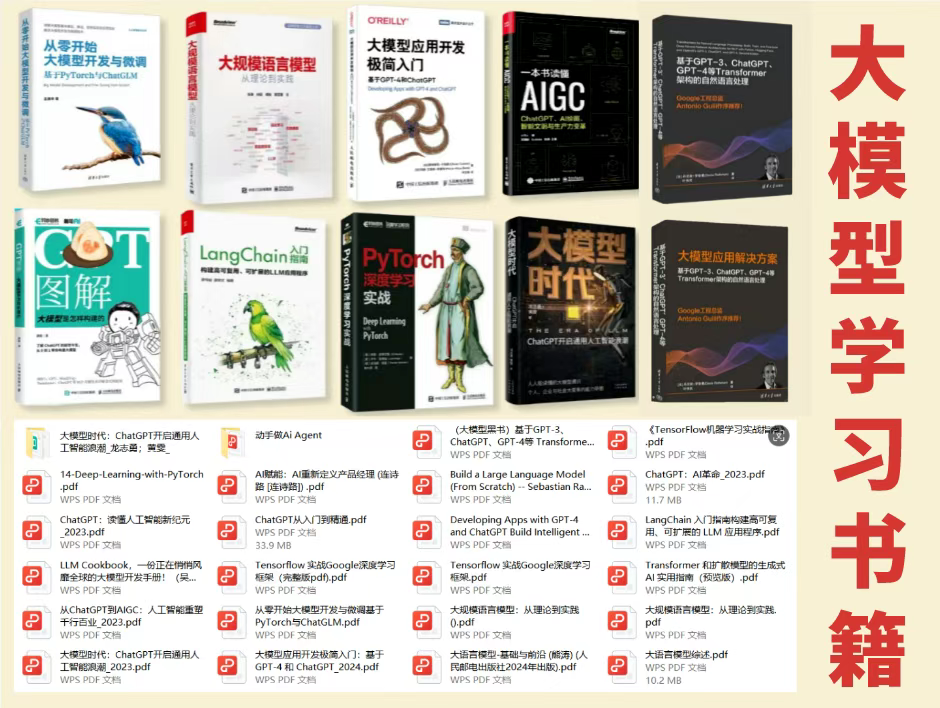
在这里插入图片描述

配套大模型项目实战

所有视频教程所涉及的实战项目和项目源码等
在这里插入图片描述

博主介绍+AI项目案例集锦

MoPaaS专注于Al技术能力建设与应用场景开发,与智学优课联合孵化,培养适合未来发展需求的技术性人才和应用型领袖。
在这里插入图片描述

在这里插入图片描述

这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】

在这里插入图片描述

为什么要学习大模型?

2025人工智能大模型的技术岗位与能力培养随着人工智能技术的迅速发展和应用 , 大模型作为其中的重要组成部分 , 正逐渐成为推动人工智能发展的重要引擎 。大模型以其强大的数据处理和模式识别能力, 广泛应用于自然语言处理 、计算机视觉 、 智能推荐等领域 ,为各行各业带来了革命性的改变和机遇 。
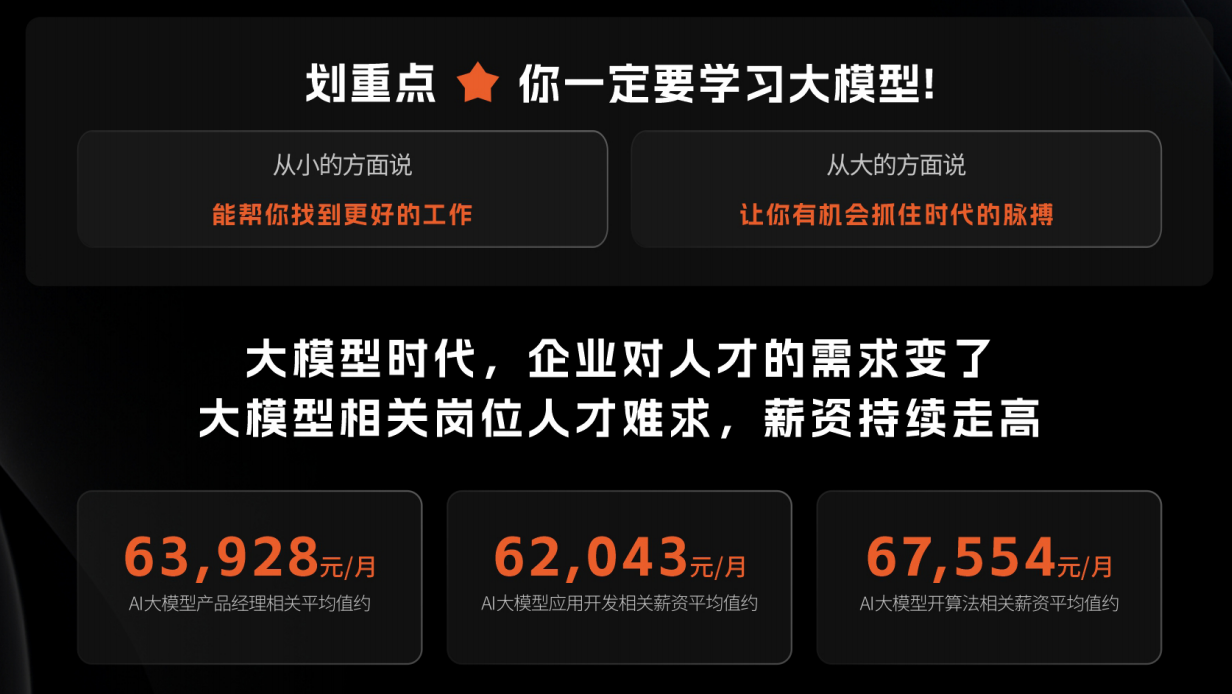
在这里插入图片描述

适合人群

  • 在校学生:包括专科、本科、硕士和博士研究生。学生应具备扎实的编程基础和一定的数学基础,有志于深入AGI大模型行业,希望开展相关的研究和开发工作。
  • IT行业从业人员:包括在职或失业者,涵盖开发、测试、运维、产品经理等职务。拥有一定的IT从业经验,至少1年以上的编程工作经验,对大模型技术感兴趣或有业务需求,希望通过课程提升自身在IT领域的竞争力。
  • IT管理及技术研究领域人员:包括技术经理、技术负责人、CTO、架构师、研究员等角色。这些人员需要跟随技术发展趋势,主导技术创新,推动大模型技术在企业业务中的应用与改造。
  • 传统AI从业人员:包括算法工程师、机器视觉工程师、深度学习工程师等。这些AI技术人才原先从事机器视觉、自然语言处理、推荐系统等领域工作,现需要快速补充大模型技术能力,获得大模型训练微调的实操技能,以适应新的技术发展趋势。
    在这里插入图片描述

课程精彩瞬间

大模型核心原理与Prompt:掌握大语言模型的核心知识,了解行业应用与趋势;熟练Python编程,提升提示工程技能,为Al应用开发打下坚实基础。

在这里插入图片描述

RAG应用开发工程:掌握RAG应用开发全流程,理解前沿技术,提升商业化分析与优化能力,通过实战项目加深理解与应用。 在这里插入图片描述

Agent应用架构进阶实践:掌握大模型Agent技术的核心原理与实践应用,能够独立完成Agent系统的设计与开发,提升多智能体协同与复杂任务处理的能力,为AI产品的创新与优化提供有力支持。
在这里插入图片描述

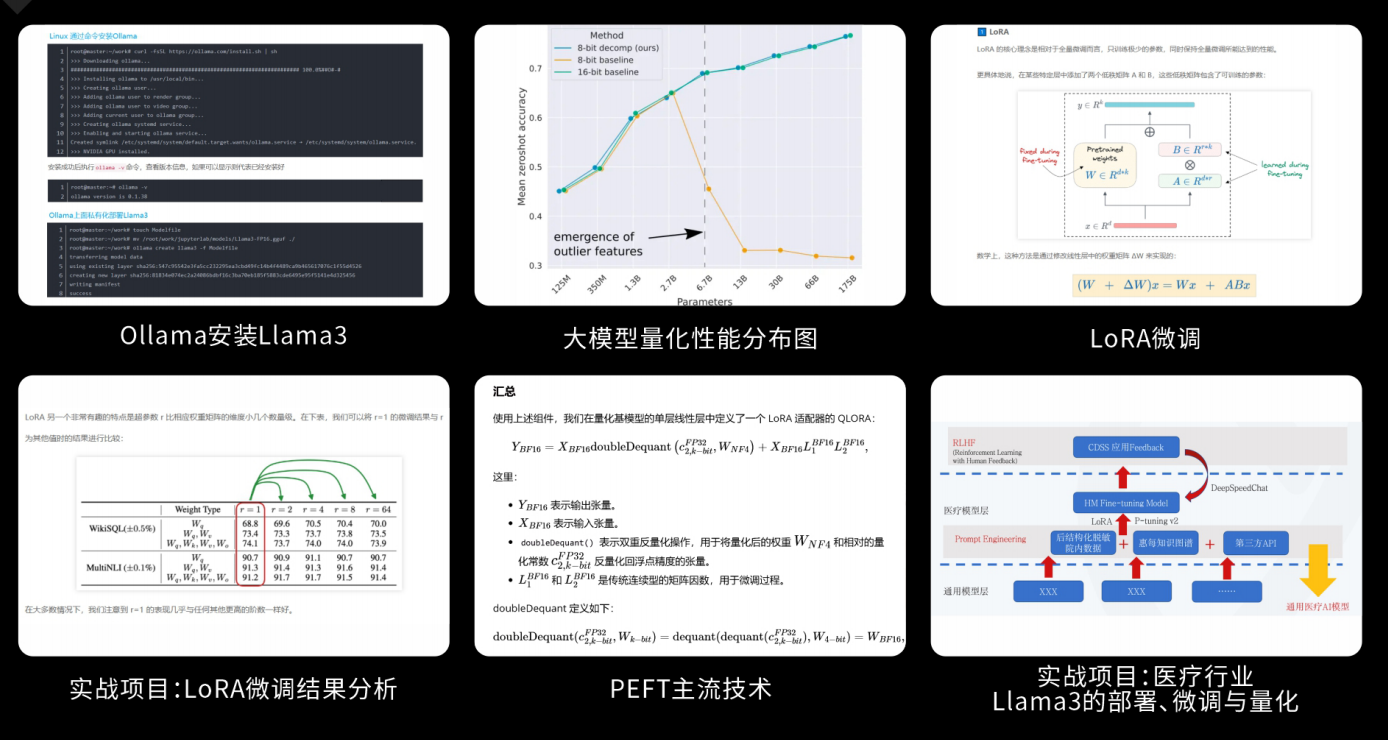
模型微调与私有化大模型:掌握大模型微调与私有化部署技能,提升模型优化与部署能力,为大模型项目落地打下坚实基础。 在这里插入图片描述
顶尖师资,深耕AI大模型前沿技术

实战专家亲授,让你少走弯路
在这里插入图片描述

一对一学习规划,职业生涯指导

  • 真实商业项目实训
  • 大厂绿色直通车

人才库优秀学员参与真实商业项目实训

以商业交付标准作为学习标准,具备真实大模型项目实践操作经验可写入简历,支持项目背调

在这里插入图片描述
大厂绿色直通车,冲击行业高薪岗位
在这里插入图片描述

文中涉及到的完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】

在这里插入图片描述

多模态RAG 与单模态RAG(仅处理文本)相比,多模态RAG的关键挑战是「模态异构性」(不同模态数据格式、语义逻辑差异大),解决方案围绕「统一表征、跨模态检索、多模态融合」三大核心环节展开。 阅读详情

相关推荐

多模态GraphRAG代码及论文

代码已在github开源:https://github.com/wanxueyao/MMGraphRAG 这里补充了相同的代码和论文。 内容概要:本文介绍了一种新颖的多模态图增强检索生成方法(MMGraphRAG),该方法结合了结构化的知识图谱与多模态数据(文本和图像),以提升复杂生成任务中的推理能力和解释性。具体来说,MMGraphRAG通过场景图细化图像数据,显著增强了模型的推理能力并提供了更强的响应解释性。此外,跨模态融合模块采用基于谱聚类的方法生成候选实体,提高了融合精度并减少了计算开销。实验表明,该方法在多模态文档问答任务上优于现有方法,在多领域和多页推理方面表现出色。 适合人群:从事自然语言处理、计算机视觉或知识图谱研究的学者和技术人员,尤其是对多模态数据处理和复杂推理任务感兴趣的科研人员。 使用场景及目标:①需要处理包含文本和图像的多模态文档并进行复杂推理的任务;②提高多模态数据融合的准确性,特别是涉及细粒度实体对齐的情况;③增强生成任务的解释性和逻辑连贯性。

AI新风口:GraphRAG多模态杀疯了!小白也能秒会的黑科技,一张图搞定文本+图像+音频,优快云首发干货!

多模态GraphRAG(mmGraphRAG)突破传统RAG局限,整合文本、图像和音频数据,通过CLIP模型将视觉数据转换为语义向量,利用图结构表示多模态元素间关系。该技术支持复杂条件搜索、场景理解、精准对象识别和可解释AI分析,适用于医学成像、电商、监控等领域。基于超维计算和图数据库,mmGraphRAG实现多模态数据的统一语义推理,为AI应用提供更全面、准确且可解释的解决方案。

m0_59235245的博客 723

别再只跑Demo了!用MovieLens数据集完整复现一个电影推荐系统(Python/Pandas实战)

本文详细介绍了如何利用MovieLens数据集从零构建一个完整的电影推荐系统,涵盖数据清洗、特征工程、推荐算法实现(协同过滤和矩阵分解)以及Web服务部署的全流程。通过Python和Pandas实战,读者可以掌握推荐系统的核心技术和生产环境部署技巧,不再局限于简单的Demo运行。

weixin_29062865的博客 151

十大时间序列模型最强总结(三)季节性自回归积分滑动平均模型(SARIMA)

AI大模型作为人工智能领域的重要技术突破,正成为推动各行各业创新和转型的关键力量。抓住AI大模型的风口,掌握AI大模型的知识和技能将变得越来越重要。学习AI大模型是一个系统的过程,需要从基础开始,逐步深入到更高级的技术。这里给大家精心整理了一份全面的AI大模型学习资源,包括:AI大模型全套学习路线图(从入门到实战)、精品AI大模型学习书籍手册、视频教程、实战学习、面试题等,资料免费分享!

老皮的博客 2782

A股历史数据免费下载终极指南:4000+个股数据一键打包获取

本文提供了获取A股历史数据的完整免费方案,重点介绍了Tushare Pro、AkShare等开源金融数据API的使用方法。通过详细的Python脚本示例,指导读者如何自动化批量抓取、清洗、存储4000多只个股的历史行情数据,并分享数据质量校验与性能优化技巧,助力量化研究与市场分析。

ooo22的博客 2257

FPGA实战 —— 基于UART的多设备串口通信系统设计

本文深入探讨了基于FPGA的多设备UART串口通信系统设计。针对工业控制与物联网应用中一对多通信的需求,文章对比了共享总线式、多路独立式等硬件连接方案,并详细阐述了可配置UART IP核、波特率自适应算法以及多路数据仲裁与分发逻辑等核心设计要点。最后,通过一个四传感器采集节点的实战案例,展示了从硬件连接到Verilog代码实现的完整系统构建过程。

weixin_29172963的博客 235

【RAG系列】多模态RAG的三种实现思路和代码

介绍多模态RAG的三种主流实现思路,附有代码示例。

m0_68116052的博客 7053

1.1 了解Spring框架 -《SSM深入解析与项目实战》

文章目录第1篇 基础概念第1章 谈谈SSM框架和Redis1.1 了解Spring框架1.1.1 如何学习Spring1.1.2 IoC(Inversion of Control 控制反转)1.1.3 AOP(Aspect Oriented Programing面向切面编程) 项目中所有的源码都可以在此链接的仓库中找到:https://github.com/chenhaoxiang/uifuture-ssm 本章非常形象的介绍了Springn中最核心的两个概念,IoC和AOP,使用了现实中的例子

谙忆-陈浩翔 2137

多模态GraphRAG:探索结合视觉与语言的前沿技术,开启智能交互新纪元

多模态GraphRAG将GraphRAG技术扩展到文本、图片、语音、视频等数据,通过统一知识图谱和语义嵌入空间实现跨模态检索与推理。其核心包括多模态数据预处理、知识图谱构建、混合检索和LLM生成。该技术可应用于智能搜索、事件分析、客服等场景,优势在于跨模态统一性和关系推理能力。当前面临数据对齐、图谱复杂性等挑战,未来将向自适应图谱、因果推理等方向发展。

m0_65555479的博客 1382

风电光伏功率预测竞赛精华总结:技术解析与实战经验

本文深度解析新能源功率预测竞赛的技术要点与实战经验。首先介绍了风电、光伏功率预测对电网调度优化、降低运营风险的重要性,以及多个竞赛的基本概况。在数据特征分析部分,详细探讨了气象预报数据和功率数据的特征,包括时间周期性、数据质量问题及处理方法。针对异常值检测、数据标准化和特征工程(如时间特征、统计聚合特征、风速风向特征和滞后特征)提供了具体的技术实现方案。文章为新能源功率预测提供了实用的技术指导,对相关竞赛和实际应用具有重要参考价值。

算法工程师 207

7、基于机器学习的生产效率估计方法解析

本文探讨了基于机器学习的生产效率估计方法,重点介绍了效率分析树(EAT)和凸效率分析树(CEAT)算法的原理及其与传统自由处置壳(FDH)和数据包络分析(DEA)方法的对比。通过剪枝优化、生产可能性集构建及方向距离函数(DDF)估计,EAT和CEAT在避免过拟合、提升估计稳定性与处理凸性假设方面展现出优势。结合PISA教育数据的实证研究,采用箱线图、核密度图和非参数检验方法验证了不同模型效率得分分布的显著差异。研究表明,EAT与CEAT为生产效率评估提供了更准确、灵活的工具,适用于教育、企业生产和医疗等多个

milk5的博客 94

多模态 GraphRAG 初探:文档智能+知识图谱+大模型结合范式

摘要:本文系统介绍了多模态GraphRAG技术在文档智能解析中的应用。重点分析了OCR-PIPELINE、OCR-Free和PDF-Parse三种技术方案的特点及优劣势,详细探讨了版式分析、表格解析、公式识别等关键技术环节。文章还对比了传统CV方法与新兴多模态大模型在文档处理中的表现,展示了当前技术进展与挑战。最后,强调文档解析的质量直接影响RAG系统效果,需要根据具体场景选择合适方案。全文为文档智能与知识图谱的结合提供了实用参考框架。(149字)

2401_85373396的博客 1216

vue2/3 - element表格组件el-table实现懒加载树型(上下级)数据、默认展开和隐藏层级,支持对表格进行修改|新增|删除,解决完成操作后树节点不刷新问题(提供示例代码,一键复制开箱即用

vue2,vue3,elementui,elementPlus,el-table,Table表格组件,表格懒加载数据,element table表格数中的树形结构懒加载,增加后数据不同步更新问题,el-table树形与el-tree树形结构的一键折叠与展开,elementui中el-tree懒加载数据 默认展开最外层节点,Element-plus Table组件树表结构默认展开一级目录,vue实现element table表格树形结构-使用懒加载时-解决子节点增删改后,不刷新子节点数据问题,解决el-tre

✅ 精选推荐文章 1万+

MMGraphRAG输了,ACM 2026北航DualG-MRAG新作牛了

今天分享北航出品的ACM MM 2026论文--DualG-MRAG,它把多模态RAG的"细粒度视觉vs检索噪声"困境解了。

m0_59235245的博客 160

使用R包PreMSIm预测微卫星不稳定的标题:基于基因表达量的微卫星不稳定性预测

在本文中,我们将介绍如何使用R语言中的PreMSIm包来根据基因表达量进行微卫星不稳定性的预测。需要注意的是,本文仅介绍了使用PreMSIm包进行微卫星不稳定性预测的基本流程和代码示例。在实际应用中,还需要考虑数据的质量控制、模型优化以及结果的解释和验证等因素,以确保预测结果的准确性和可靠性。预测结果将返回一个包含微卫星不稳定性指数的向量,其中每个元素对应一个样本的预测结果。在有了输入数据后,我们可以使用PreMSIm包中的函数进行微卫星不稳定性的预测。函数生成一个包含所有样本的微卫星不稳定性信息的表格。

2301_79330511的博客 383

ET2012新版免狗免安装绿色软件

ET2012新版免狗免安祖昂绿色软件。,新界面,新视觉,

多模态GraphRAG革命:让AI同时理解文本、图像和音频的强大技术

摘要: mmGraphRAG是一种创新的多模态检索增强生成技术,通过整合文本、图像和音频数据,结合CLIP模型和图结构推理,实现跨模态语义搜索与复杂场景理解。其核心优势包括高精度对象识别、空间关系推理、可解释性分析及离线隐私保护,适用于医疗、安防、电商等领域。技术架构融合超维计算与图数据库,支持多条件组合查询和跨模态联想。未来将扩展音频处理、时间序列分析及医学图像体素建模,推动AI向更集成化、专业化方向发展。

libaiup的博客 767

Devexpress16.2.6破解工具

Devexpress16.2.6破解工具Devexpress16.2.6破解工具Devexpress16.2.6破解工具Devexpress16.2.6破解工具

多模态文档类“GraphRAG”框架实现思路-LAD-RAG

前期多模态RAG的多个相关方案都提到:文档的布局结构对文档多模态RAG的性能有增益。》、《》、《》、也在讲解了pipline的多模态GraphRAG实现思路。下面再看一个思路,围绕解决在。

余俊晖,NLP炼丹师,目前专注自然语言处理领域研究。曾获得国内外自然语言处理算法竞赛TOP奖项近二十项。 757

efm32 入门.pdf

本PDF共计22页,介绍的是操作驱动API,下载与否自己斟酌。

LinePhone3.2.7(android端最新版本) sip客户端

SIP客户端For android:LinePhone3.2.7(最新版本),官网地址:http://www.linphone.org/

干货|RAG,大模型的‘记忆神器’?基础知识补全!

RAG(检索增强生成)技术结合检索系统与大语言模型,通过"检索+生成"模式提升AI回答的准确性和时效性。该技术首先从专业数据源检索相关信息,再将这些可靠资料作为提示输入给大模型进行内容生成,有效解决大模型的"幻觉"问题。RAG具有灵活可扩展、领域适应性强等特点,已在客服、教育、医疗等多个场景实现商业化应用。学习大模型技术需系统掌握模型设计、提示工程、应用开发等七大阶段,通过实际项目训练微调能力。现提供包含学习路线、视频教程、面试题库等资源的免费大礼包,助力开发者快速掌

2401_85390073的博客 329

GraphRAG进阶:高级功能与优化

通过以上高级功能和优化策略,GraphRAG可以在多种复杂的应用场景中发挥强大的作用,为用户提供更智能、更高效的服务。在传统的文本检索中,模型只能处理文本信息,而多模态检索允许模型结合文本和图像等多种模态的数据,从而更全面地理解用户查询的意图。智能推荐系统通常需要处理用户的历史行为数据,提取用户的偏好,并结合知识图谱中的信息生成推荐。通过结合图数据库中的知识,模型可以更准确地回答用户的问题,提供更优质的客户服务。通过分析用户的行为和偏好,结合图数据库中的知识,模型可以为用户提供个性化的推荐。

加入“Super Entity”,与全能开发团队共探AI智能体与数字人项目,开启前沿技术之旅。 1255

一文看懂GraphRAG:蚂蚁集团联合各所名校出品GraphRAG综述

GraphRAG 是借助外部结构化知识图谱来增进语言模型的上下文理解,并生成更具洞见响应的框架。GraphRAG 的目标在于从数据库中检索出最为相关的知识,进而提升下游任务的答案质量。鉴于候选子图的数量会随着图的规模呈指数增长,故而需要有效的近似方法。由此,运用图检索器提取最优子图 ,而后生成器依据检索到的子图生成答案。所以,将 GraphRAG 的整个流程拆解为三个主要阶段:基于图的索引、图引导检索和图增强生成。

AIBigModel的博客 2765

【RAG 进阶】多模态 RAG 的三种巧妙实现思路,附带完整代码示例

多模态RAG的难点和多模态本身类似,还是如何对其不同模态数据的表示,以保证和用户查询的相似度计算的正确率。好在目前有很多开源的Audio to Text模型、Image to Text模型和 Image-Text双模态模型,效果也都很不错。如果需要针对具体场景的多模态模型,可以根据数据进行进一步微调。

kaka0722ww的博客 2250

LazyLLM教程 | 第13讲:RAG+多模态:图片、表格通吃的问答系统

通过共享的向量空间,文本和图像可以在相同的语义空间中进行比较和排序,从而提高多模态检索和生成的效率和准确性。然而,利用视觉多模态大模型对其进行嵌入和检索的相关方法有DSE、ColPali,M3DocRAG等,下文以ColPali为例,讲解与基于文档解析的方法之间的不同之处(图源ColPali论文)。因此,为了让普通 RAG 在更多真实场景下保持高效、智能的表现,我们亟需引入多模态能力,结合 OCR、图像理解等技术,让模型具备“读图识意” 的能力,从而真正实现对多模态信息的智能问答与生成。

SenseCore的博客 957

一文读懂:从RAG到多模态RAG

如果说2023年见证了大语言模型的“寒武纪大爆发”,那么2024年则是多模态大模型“元年”。GPT-4o的出现让大家见识到多模态能力引入,给下游应用生态带来的巨大改变。随之而来的,RAG技术也将逐渐从单语言模态的RAG进化到多模态RAG。本文将带大家速览多模态RAG技术的原理及实现。

2401_85325726的博客 1416

多模态RAG架构:融合文本、图像与音频以提升AI生成能力

随着大模型在文本生成任务中取得显著成果,企业和研究者逐渐将目光转向更复杂的多模态任务场景,如图文问答、语音搜索、视频分析等,传统基于文本的检索增强生成(RAG)系统已经无法满足这些多样化需求,因此为了实现对图像、音频等非结构化数据的统一理解与利用,多模态RAG应运而生。RAG将检索器与生成器组合起来:在文本领域,RAG有效缓解了大模型的“幻觉”(Hallucination)问题,弥补了模型内部知识更新的不足,但在更复杂的实际业务中,用户提出的问题可能涉及图像内容、语音输入等,仅依赖文本检索已难以胜任,因此引

youmaob的博客 2833

多模态RAG深度解析:揭秘AI新技术

多模态检索增强生成(Multimodal Retrieval Augmented Generation,简称RAG)是一种新兴的设计范式,允许AI模型与文本、图像、视频等多种信息存储接口进行交互。 在探讨这个主题时,我们首先会介绍什么是检索增强生成(RAG),多模态的概念,以及如何将两者结合以构建现代多模态RAG系统。在理解了多模态RAG的基本概念后,我们将使用Google Gemini和一种类似CLIP的编码模型来构建一个多模态RAG系统。

bugyinyin的博客 3147
上一篇: 革命性突破!GraphRAG技术全解析:从原理到实战重新定义智能问答(附医疗案例)
下一篇: 收藏这篇就够了!Agent流派选择终极指南:万亿市场避坑指南+企业级落地全攻略
Python_金钱豹
博客等级 码龄5年 1万+粉丝 2841原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值