2025 GraphRAG终极进化!FrOG框架深度解析:从图谱推理到多跳问答,一篇讲透企业级智能问答系统

Apache Answer,最好的开源问答系统 Apache Answer是一款适合任何团队的问答平台软件。无论是社区论坛、帮助中心还是知识管理平台,你可以永远信赖 Answer。目前在github超过10K星,系统采用go语言开发,安装配置简单,界面清洁易用,且开源免费。 阅读详情

引言:开放知识与可信AI的融合

Wikimedia Indonesia于2024年推出Wikidata Research Fund,以推动知识图谱如Wikidata在人工智能及科研领域中的创新应用。由印尼大学与维也纳经济大学合作的FrOG团队,围绕“AI幻觉”这一难题,提出了将大型语言模型(LLM)与结构性知识图谱(KG)深度结合的技术路线,并研发出FrOG开源RAG问答系统。

https://github.com/Framework-of-Open-GraphRAG/FROG

项目团队

课题组长: Fariz Darari(印尼大学)
成员:

  • Jaycent Gunawan Ongris(印尼大学)
  • Eduardus Tjitrahardja(印尼大学)
  • Fajar Juang Ekaputra(维也纳WU)

一、研究背景

近年来,大型语言模型(LLM, 如ChatGPT、Gemini、Copilot等)在信息检索与自然语言理解领域取得了重大突破,实现了问答、摘要等多项复杂任务。然而,LLM 仍然存在三大核心挑战:

  1. 知识更新难度大

    ——模型知识难以动态追踪现实世界变化。

  2. 推理过程不透明

    ——“黑盒”操作难以解释答案来源。

  3. 幻觉问题

    ——有时输出存在不准确或虚假内容。LLM如ChatGPT、Gemini善于生成流畅自然的语言,但在面对事实性问题时,常出现自信但错误的回答,即“幻觉”。这在教育、法律、科研等领域尤为严重。

为应对上述问题,Retrieval-Augmented Generation(RAG)成为主流办法,通过外部知识检索辅助LLM生成答案,减少对参数记忆的依赖。然而,RAG主流方法一般采用Dense Retriever(如DPR),其向量表达方式使检索过程缺乏可解释性,并易导致上下文片段化,影响复杂查询的整体理解。

知识图谱(Knowledge Graph, KG)则通过实体及其属性与关系将真实世界结构化,能为LLM输出提供精准可查证的支撑,成为Retrieval-Augmented Generation(RAG)技术的理想基础。


二、核心创新

1. 引入知识图谱(KG)驱动RAG

本研究提出以知识图谱(KG)为信息基础,开发了名为FrOG(Framework of Open GraphRAG)的开源RAG系统,通过KG节点关系透明组织事实信息,使推理、溯源更加易于追溯。

KG优点示意

  • 以实体为节点、关系为边,高度结构化,便于显性追踪和多跳推理。
  • 支持SPARQL等结构化查询语言,易于控制、集成。
  • 支持大规模、开放协作(如Wikidata)。

2. 主要研究问题

研究针对以下问题展开:

  • 如何高效用开源组件实现GraphRAG架构?
  • 哪种大模型最适合该框架?
  • GraphRAG架构中哪些组件对答案准确率提升作用最大?

3. 研究范围

  • 核心聚焦于事实型问答(factoid QA)。
  • 所有系统(含LLM)与依赖均选用开源组件,确保透明复现。
  • 评估数据涵盖开放KG(Wikidata、DBpedia)与本地KG(Curriculum KG)。
  • LLM实验限定在Qwen2.5 7B、Mistral 7B/NeMo 12B、LLaMA 3.1 8B等主流开源模型。
  • 不进行高消耗的模型微调(fine-tune),而利用上下文学习(in-context learning)。
  • 评价采用SPARQL查询结果Jaccard相似度(见后文表格与评估图)。
  • 多语言能力在Pipeline v2上初步验证,重点为印尼语。

三、技术方案和系统架构

1. 相关背景

  • KG技术快速回顾

    借助RDF三元组(主语-谓语-宾语)、SPARQL、Semantic Web理念构建结构化实体网络。

  • LLM分类

    Encoder-only(如BERT)、Decoder-only(如GPT)、Encoder-Decoder(如T5)等。

  • RAG机制

    结合LLM内部知识与外部知识库,辅助问答准确性。传统RAG用文本语料+DPR检索,GraphRAG用KG,实现复杂语义关系可视推理。


2. Pipeline系统详细设计

Pipeline v1: 初始原型
  • 通过prompt工程指导基础LLM把自然语言问题转为SPARQL查询,实现对Wikidata的自动检索与应答。
  • 局限:复杂句式、跨语言支持较弱,迁移到其它KG难度较大。
Pipeline v2: 多语言·多知识库能力升级
  • 引入多语言LLM(如Qwen2.5 7B)、多轮prompt链,综合矢量(向量)本体检索工具,理解不同KG结构和术语,大幅提升复杂任务対応与多领域应用能力。
  • 支持自建学科课程知识图谱(Curriculum KG)等场景,落地性强。

(1)Pipeline v1:全LLM-驱动初步问答流程

  • 步骤一:实体抽取

    ——LLM定位用户提问中的核心实体。

  • 步骤二:实体ID检索

    ——依据关键词对Wikidata API进行检索,返回Top5候选。

  • 步骤三:实体消歧与选择

    ——基于问题和实体描述让LLM判定最相关实体。

  • 步骤四:SPARQL生成

    ——用LLM生成SPARQL查询,辅助参考Wikidata常用属性Top100表。

  • 步骤五:查询执行与自然语言生成

    ——SPARQL拉取数据,最后由LLM生成可读答案。
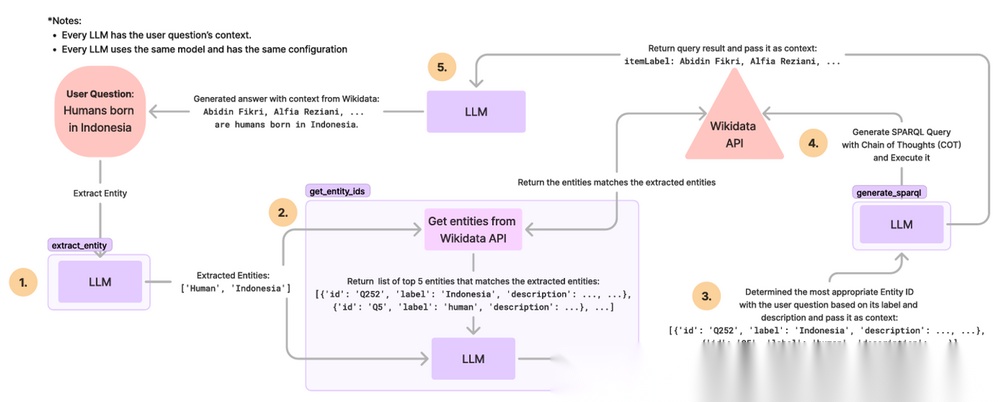
Pipeline v1系统架构图(Gambar 1)


(2)Pipeline v2:多语言/多KG升级流程

在v2架构中,系统不仅支持多语言,还引入矢量数据库辅助属性、类别检索,解决大规模资源prompt膨胀问题,并提升“单跳问答”场景的准确性。

  • 问题翻译管理

    非英文自动转英文,保证与KG的兼容性。

  • 实体链接

    综合实体抽取、KG检索和消歧。用few-shot prompting辅助多轮判别。

  • 检索流程

  • 单跳问题

    先用KG实体邻居Verbalisaton检索(如“{实体}的{属性}是{值}”),如未达标再转为LLM驱动SPARQL生成。

  • 复杂/多跳问题

    切分问题,先用语义检索筛选合适属性和类别,再用few-shot+CoT方式生成SPARQL。

  • 答案自然化

    取回结果ID/URI后补充为可理解标签,用LLM生成符合用户原语言的流畅答案。
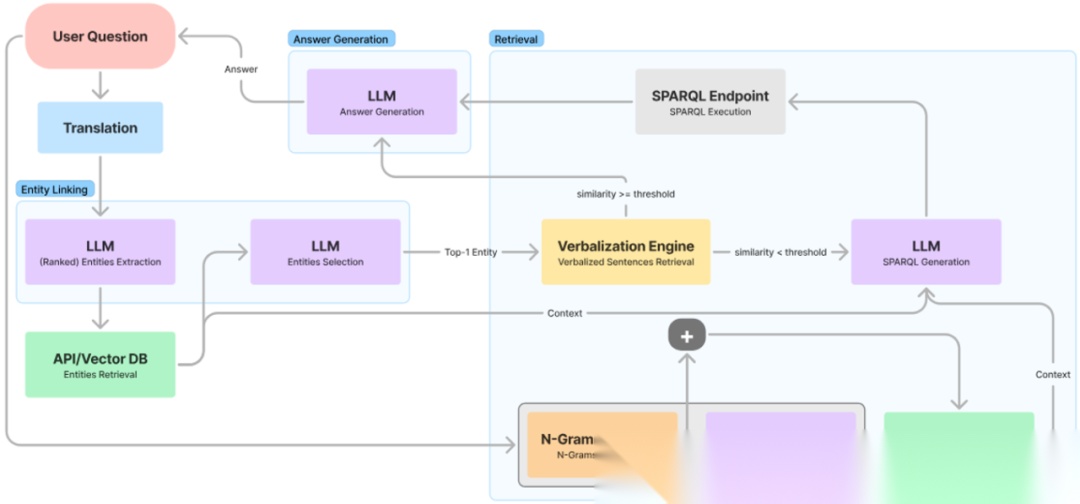
Pipeline v2系统架构图(Gambar 2)


3. 支持的知识库(KGs)

  • Wikidata

    :结构RDF,SPARQL接口,实体与属性支持批量矢量检索。

  • DBpedia

    :Wikipedia结构化衍生KG,主要用其T-Box本体。

  • Curriculum KG

    (本地企业KG示例):信息来源于印尼大学课程规划材料,涵盖课程/先修/能力等多个实体,通过半自动脚本从教材生成三元组数据。


4. 数据集与问答生成

  • QALD-9-Plus

    :多语言KG-QA基准(10种语言),用于Wikidata、DBpedia评测,含训练/测试两部分。

  • KG自生成问答数据

    :通过实体采样、KG随机游走、资源标签补充、SPARQL模版和LLM自动改写自然语言,半自动产生面向本地KG的数据集。

[表格引用:问答模板类型表(Tabel 1)]

类别三元组模式
Simple 1{ s p ?o }
Simple 2{ ?s p o }
Complex 1{ ?s p1 o1 . ?s p2 o2 }
Complex 2{ ?s p1 ?o1 . ?o1 p2 o2}

5. 评价方法

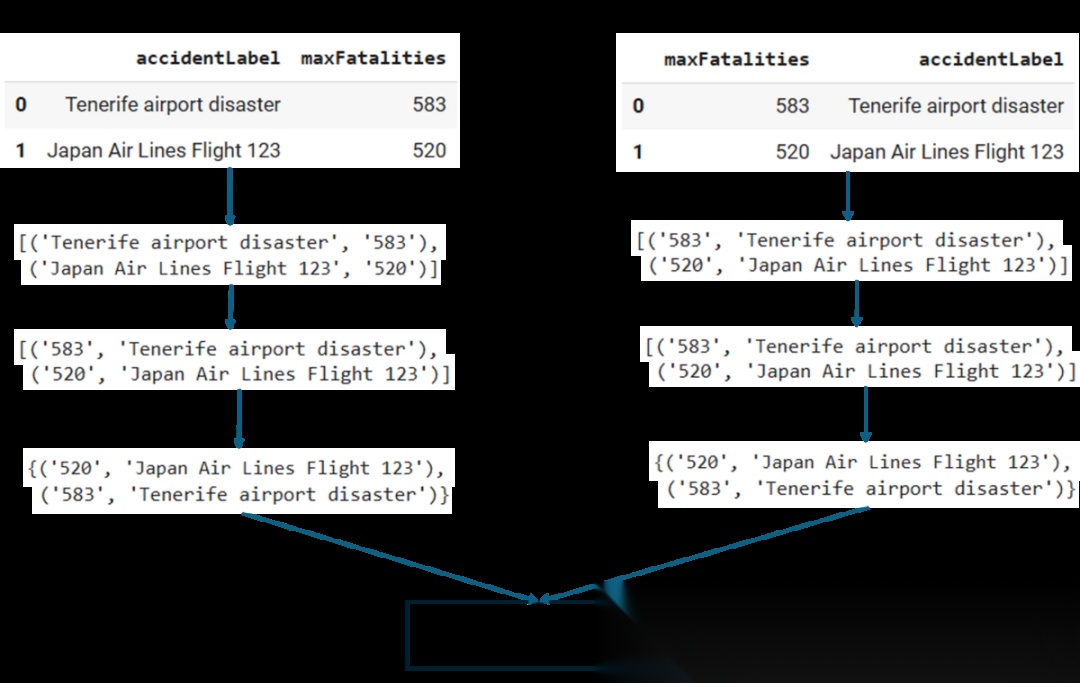
  • 主指标:Jaccard相似度

    ——考察Pipeline生成SPARQL和“标准答案”结果的集合重叠程度,不受返回条目顺序影响。

  • 执行SPARQL后对元组排序统一化处理,确保公平比对。

Jaccard相似度评测流程图(Gambar 3)


四、关键实验与结果分析

1. 不同Pipeline与模型对比

  • 实验比较了两版Pipeline结合三种主流模型的表现:
  • Pipeline v1+Mistral 7B(API):0.473
  • Pipeline v1+Mistral 7B(本地):0.554
  • Pipeline v1+Mistral NeMo 12B(本地):0.581
  • Pipeline v2+Mistral NeMo 12B(本地):0.677
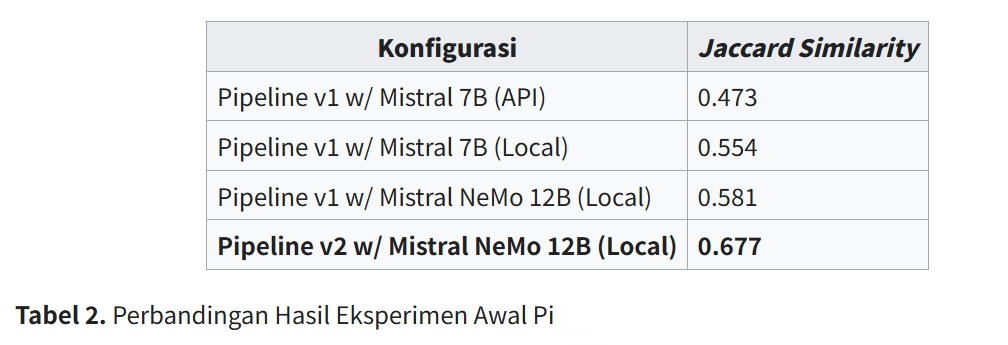
相关表格引用:Pipeline v1/v2性能对比表(Tabel 2)

Pipeline v2明显优于v1,证明了升级后的检索和属性识别机制对准确率提升意义重大。


2. 多KG/多模型综合评估

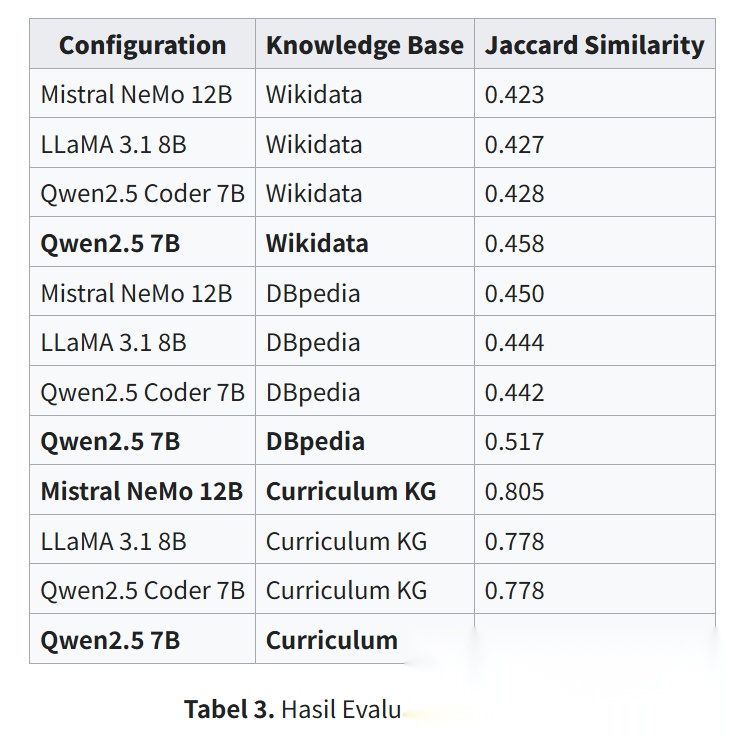
  • Wikidata/DBpedia/本地KG(Curriculum KG)上四大模型评测:
  • Wikidata: 0.458

  • DBpedia: 0.517

  • Curriculum KG: 0.805(与Mistral NeMo 12B持平)

  • Qwen2.5 7B 在所有数据集表现最好,如:

各模型各KG表现(Tabel 3)

  • 多语言初测(印尼语):存在准确率下降(0.362),归因于机器翻译导致的语义偏移,但系统多语言能力得到基本验证。
  • Qwen2.5 7B表现优异,得益于预训练语料规模达18万亿token,对语言和事实理解更深,而Qwen2.5 Coder 7B(面向代码任务)表现偏低。

3. Ablation Study(组件贡献消融分析)

  • Ontology Retrieval

    (本体属性检索):影响最大,删除后准确率大幅滑坡。Curriculum KG从0.805→0.183,若再去verbalisaiton降为0。

  • Few-Shot Examples

    (小样本示例):删除后Wikidata/DBpedia/Curriculum KG分别下降显著,需保留以辅助LLM跨领域迁移。

  • Verbalization

    (属性三元组口语化):复杂KG(Wikidata)上提升大,简洁KG(Curriculum KG)反而影响负向(甚至去除提升到0.949)。

  • Chain-of-Thought(CoT)

    :复杂KG效果好,在单纯KG场景益处有限,甚至略降。

如何学习大模型 AI ?

我国在AI大模型领域面临人才短缺,数量与质量均落后于发达国家。2023年,人才缺口已超百万,凸显培养不足。随着Al技术飞速发展,预计到2025年,这一缺口将急剧扩大至400万,严重制约我国Al产业的创新步伐。加强人才培养,优化教育体系,国际合作并进,是破解困局、推动AI发展的关键。

但是具体到个人,只能说是:

“最先掌握AI的人,将会比较晚掌握AI的人有竞争优势”。

这句话,放在计算机、互联网、移动互联网的开局时期,都是一样的道理。

我在一线互联网企业工作十余年里,指导过不少同行后辈。帮助很多人得到了学习和成长。

我意识到有很多经验和知识值得分享给大家,也可以通过我们的能力和经验解答大家在人工智能学习中的很多困惑,所以在工作繁忙的情况下还是坚持各种整理和分享。但苦于知识传播途径有限,很多互联网行业朋友无法获得正确的资料得到学习提升,故此将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。
在这里插入图片描述

2025最新大模型学习路线

明确的学习路线至关重要。它能指引新人起点、规划学习顺序、明确核心知识点。大模型领域涉及的知识点非常广泛,没有明确的学习路线可能会导致新人感到迷茫,不知道应该专注于哪些内容。

对于从来没有接触过AI大模型的同学,我帮大家准备了从零基础到精通学习成长路线图以及学习规划。可以说是最科学最系统的学习路线。

在这里插入图片描述

针对以上大模型的学习路线我们也整理了对应的学习视频教程,和配套的学习资料。

大模型经典PDF书籍

新手必备的大模型学习PDF书单来了!全是硬核知识,帮你少走弯路!
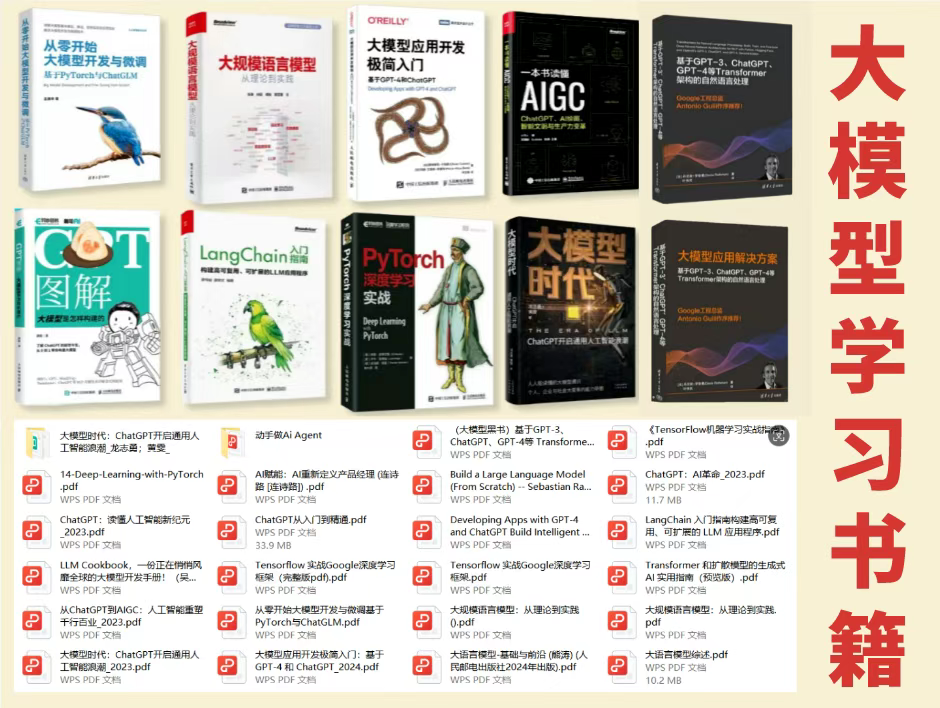
在这里插入图片描述

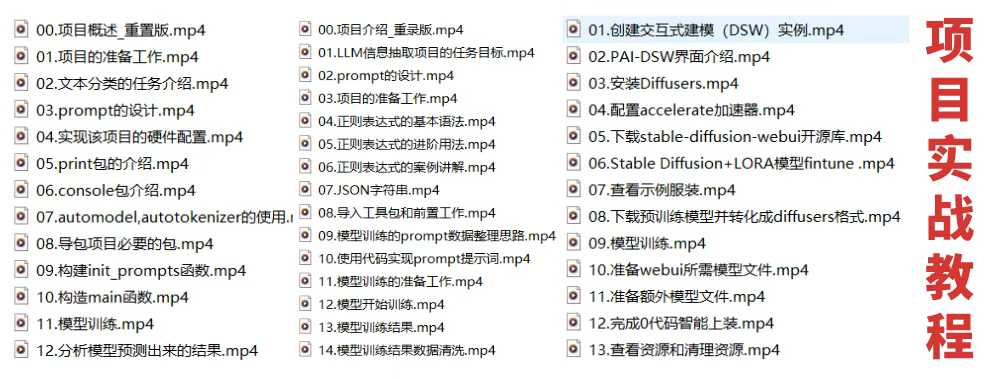
配套大模型项目实战

所有视频教程所涉及的实战项目和项目源码等
在这里插入图片描述

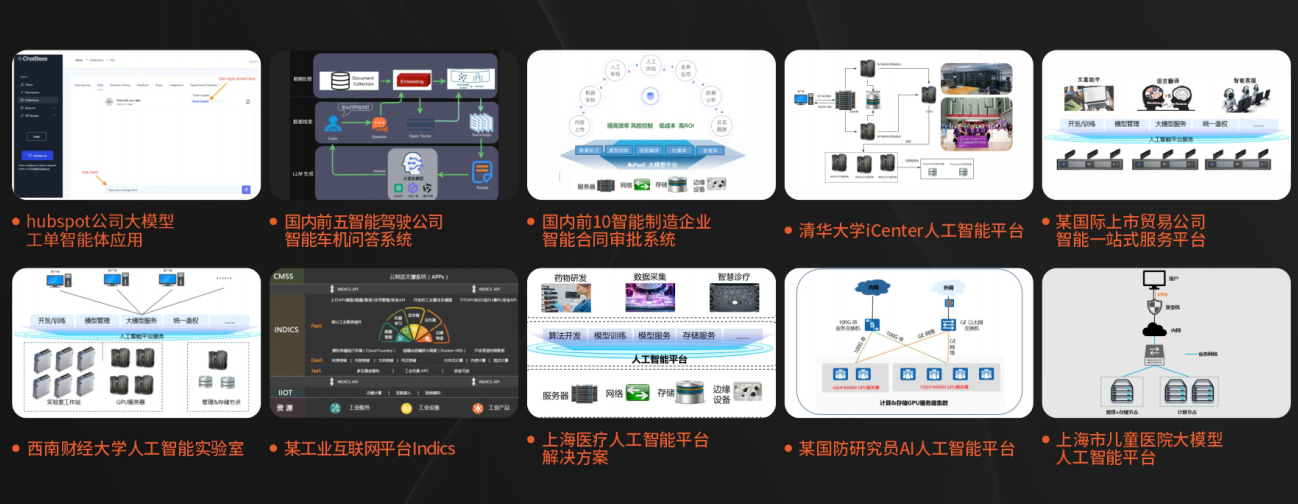
博主介绍+AI项目案例集锦

MoPaaS专注于Al技术能力建设与应用场景开发,与智学优课联合孵化,培养适合未来发展需求的技术性人才和应用型领袖。
在这里插入图片描述

在这里插入图片描述

这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】

在这里插入图片描述

为什么要学习大模型?

2025人工智能大模型的技术岗位与能力培养随着人工智能技术的迅速发展和应用 , 大模型作为其中的重要组成部分 , 正逐渐成为推动人工智能发展的重要引擎 。大模型以其强大的数据处理和模式识别能力, 广泛应用于自然语言处理 、计算机视觉 、 智能推荐等领域 ,为各行各业带来了革命性的改变和机遇 。
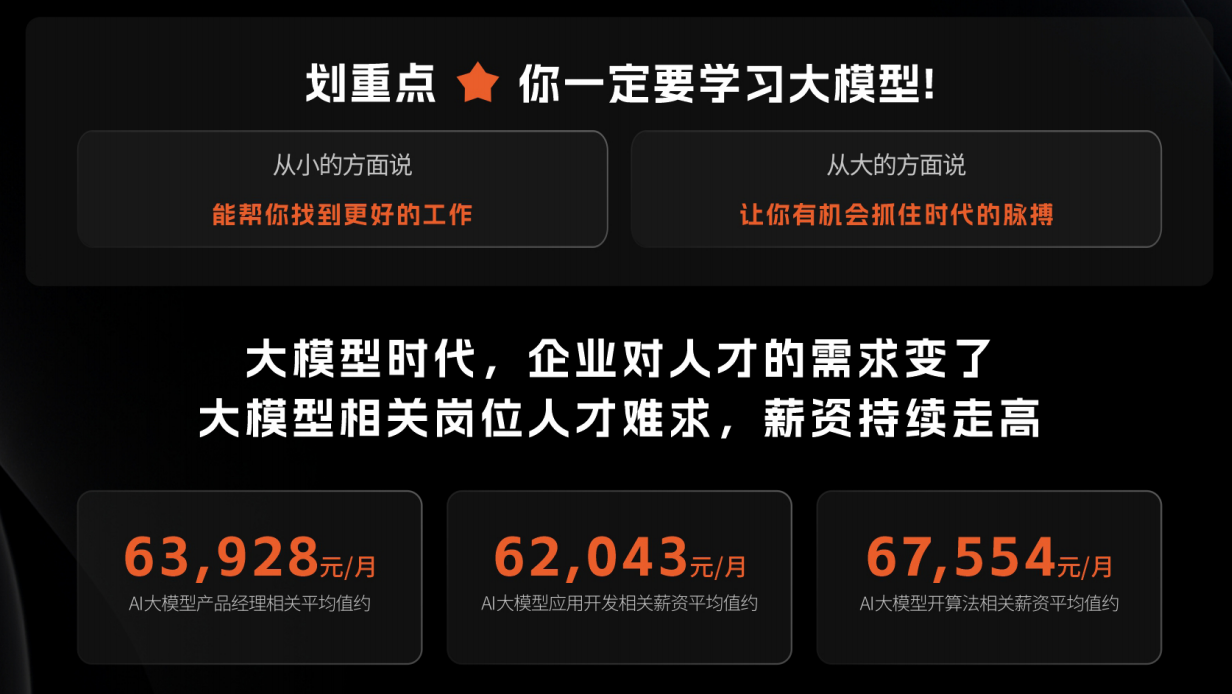
在这里插入图片描述

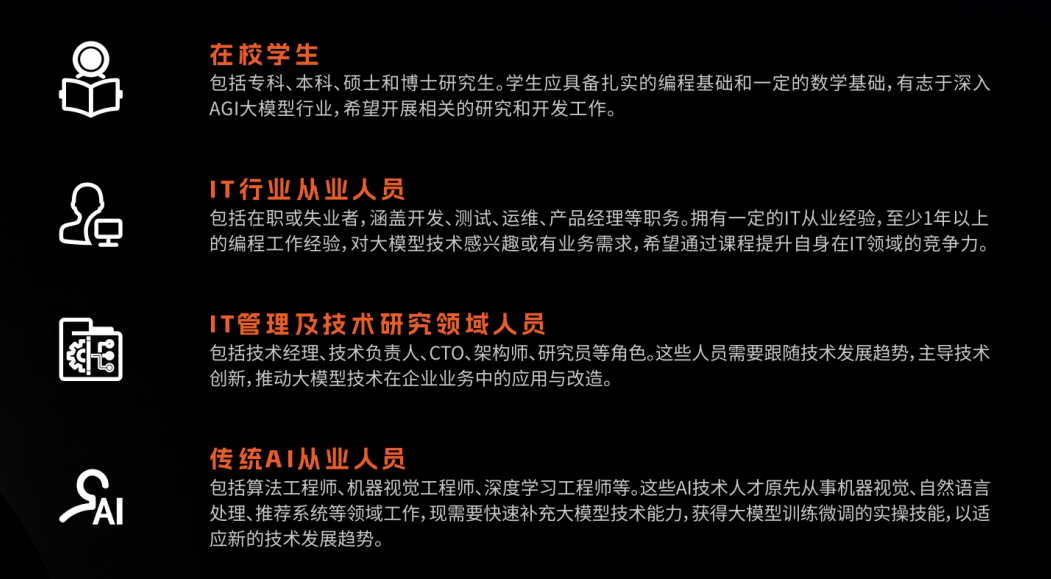
适合人群

  • 在校学生:包括专科、本科、硕士和博士研究生。学生应具备扎实的编程基础和一定的数学基础,有志于深入AGI大模型行业,希望开展相关的研究和开发工作。
  • IT行业从业人员:包括在职或失业者,涵盖开发、测试、运维、产品经理等职务。拥有一定的IT从业经验,至少1年以上的编程工作经验,对大模型技术感兴趣或有业务需求,希望通过课程提升自身在IT领域的竞争力。
  • IT管理及技术研究领域人员:包括技术经理、技术负责人、CTO、架构师、研究员等角色。这些人员需要跟随技术发展趋势,主导技术创新,推动大模型技术在企业业务中的应用与改造。
  • 传统AI从业人员:包括算法工程师、机器视觉工程师、深度学习工程师等。这些AI技术人才原先从事机器视觉、自然语言处理、推荐系统等领域工作,现需要快速补充大模型技术能力,获得大模型训练微调的实操技能,以适应新的技术发展趋势。
    在这里插入图片描述

课程精彩瞬间

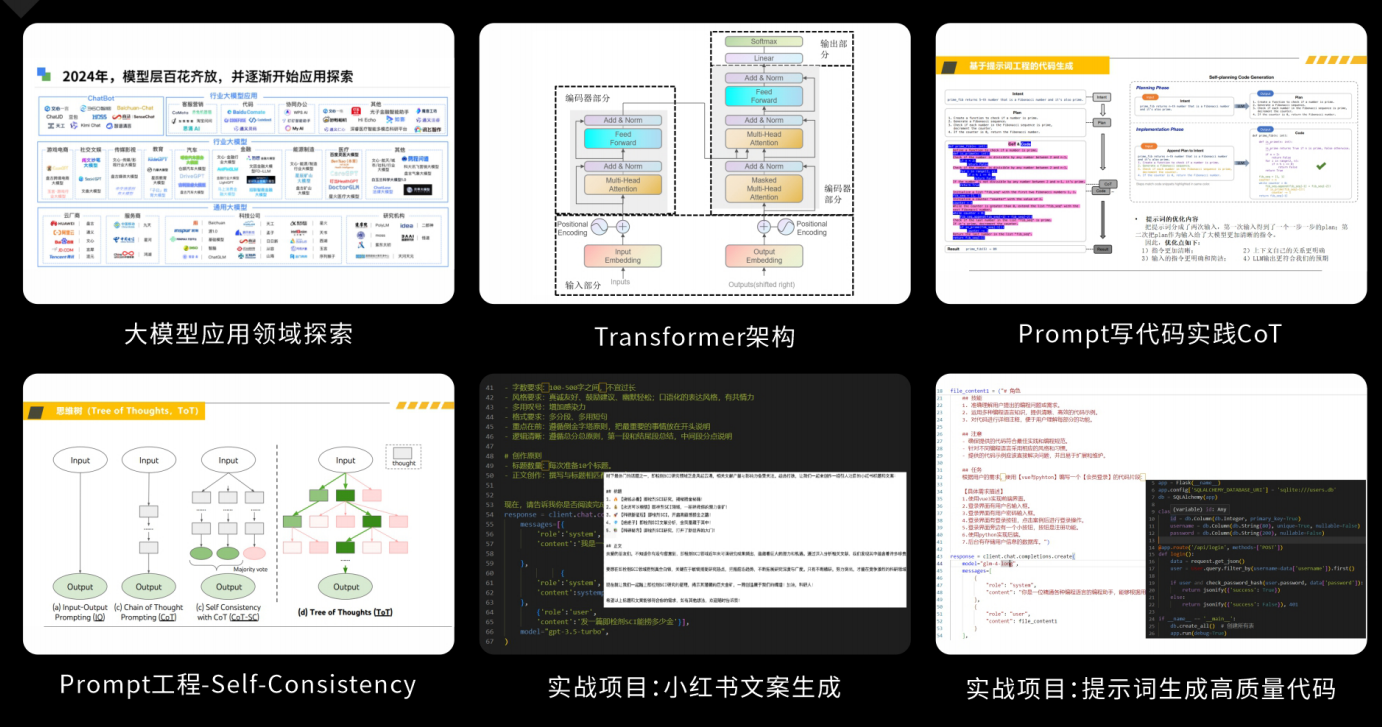
大模型核心原理与Prompt:掌握大语言模型的核心知识,了解行业应用与趋势;熟练Python编程,提升提示工程技能,为Al应用开发打下坚实基础。

在这里插入图片描述

RAG应用开发工程:掌握RAG应用开发全流程,理解前沿技术,提升商业化分析与优化能力,通过实战项目加深理解与应用。 在这里插入图片描述

Agent应用架构进阶实践:掌握大模型Agent技术的核心原理与实践应用,能够独立完成Agent系统的设计与开发,提升多智能体协同与复杂任务处理的能力,为AI产品的创新与优化提供有力支持。
在这里插入图片描述

模型微调与私有化大模型:掌握大模型微调与私有化部署技能,提升模型优化与部署能力,为大模型项目落地打下坚实基础。 在这里插入图片描述
顶尖师资,深耕AI大模型前沿技术

实战专家亲授,让你少走弯路
在这里插入图片描述

一对一学习规划,职业生涯指导

  • 真实商业项目实训
  • 大厂绿色直通车

人才库优秀学员参与真实商业项目实训

以商业交付标准作为学习标准,具备真实大模型项目实践操作经验可写入简历,支持项目背调

在这里插入图片描述
大厂绿色直通车,冲击行业高薪岗位
在这里插入图片描述

文中涉及到的完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】

在这里插入图片描述

开源项目QAnything:全能型本地知识库问答系统 在当今信息爆炸的时代,如何高效地管理和检索大量数据成为了一个重要课题。网易有道推出的开源项目QAnything,正是为了解决这一问题而生。QAnything是一个本地知识库问答系统,支持多种文件格式和数据库,允许用户在离线状态下进行安装和使用。用户只需将任何格式的本地存储文件放入系统,即可获得准确、快速且可靠的答案。 阅读详情

相关推荐

开源问答社区whatsns搭建(windows系统)

一直在找一个开源的问答社区,找了好久找到了whatsns这个开源软件,这个有免费版和商用版。 之前搭建php开源软件,环境很复杂,这次发现使用phpstudy很简单,建议小伙伴们可以用这种方式部署。 phpStudy是一个PHP调试环境的程序集成包。该程序包集成最新的Apache+PHP+MySQL+phpMyAdmin+ZendOptimizer,一次性安装,无须配置即可使用,是非常方便、好用的PHP调试环境。该程序不仅包括PHP调试环境,还包括了开发工具、开发手册等。 一、phpStudy v8.

jiangwei3052的博客 1266

共有18款 开源问答系统开源软件

威客平台,可以参考 http://www.taskcn.com/   http://www.oschina.net/project/tag/299/qa 开源问答系统 OSQA OSQA是一款免费且开源的问答系统,采用Python的Django开发框架,基于中国优秀的问答系统CNProg,非常类似国外著名的技术问答网站http://stackoverflow.com。 更...

guoyiqi 1万+

CTFShow萌新区全攻略:从密码破解到Web渗透的实战解析

本文为CTFShow萌新区新手提供从密码破解到Web渗透的完整实战攻略。文章深入解析了密码学、隐写术、杂项和Web安全四大核心方向,分享了实用的解题工具、思维方法和绕过技巧,旨在帮助初学者建立系统的安全竞赛解题体系,而不仅仅是提供一份题解(WP)。

weixin_29216957的博客 299

「开源项目」开源企业级问答系统-Danswer

开源企业级问答系统,可以对内部文档进行自然语言提问,并返回可靠的答案、引用和参考资料,可以连接到多种常见工具,如Slack、GitHub和Confluence。

qq_36765367的博客 1382

从零开始使用CubeMX配置STM32使用lwip实现httpd服务器以及使用vscode编辑阅读keil代码(三)

使用stm32搭载lwip实现HTTPd服务器

qq_30623327的博客 5933

Claude Code与Vibe Coding:2026年AI编程实战指南

AI编程助手是基于大语言模型的智能代码生成工具,通过理解编程上下文提供精准的代码补全和重构建议。其核心原理是利用深度学习技术分析代码语义,将自然语言指令转化为可执行代码。这种技术能显著提升开发效率,减少重复性编码工作,特别适用于快速原型开发和复杂问题求解。在实际应用场景中,AI编程助手可与Vibe Coding方法论结合,建立流畅的人机协作工作流。Claude Code作为先进的AI编程工具,支持多语言开发和智能错误检测,而Vibe Coding则强调自然交互和迭代优化,两者协同为开发者提供完整的AI编程解

weixin_29057695的博客 343

【开源】SpringBoot框架开发知识图谱构建系统

基于JAVA+Vue+SpringBoot+MySQL的知识图谱构建系统,包含了知识图谱模块、知识点模块、学生测评模块、学生成绩模块,还包含系统自带的用户管理、部门管理、角色管理、菜单管理、日志管理、数据字典管理、文件管理、图表展示等基础模块,知识图谱构建系统基于角色的访问控制,给教师、学生使用,可将权限精确到按钮级别,您可以自定义角色并分配权限,系统适合设计精确的权限约束需求。

askf01的博客 5344

用Arduino和MAX30102做个心率血氧仪,从硬件连线到算法调试全流程避坑

本文详细介绍了如何使用Arduino和MAX30102传感器构建高精度心率血氧仪,涵盖硬件连线、软件配置、信号处理及算法优化全流程。通过实战案例和避坑指南,帮助开发者快速实现临床级精度的健康监测设备,适用于可穿戴设备和医疗健康领域。

weixin_26897585的博客 385

【亲测免费】 开源项目 `questionAnswerSystem` 使用教程

开源项目 questionAnswerSystem 使用教程 1. 项目介绍 questionAnswerSystem 是一个基于自然语言处理(NLP)的开源问答系统项目。该项目旨在帮助开发者构建一个能够从给定文本中提取答案的问答系统。通过使用该系统,用户可以快速构建一个能够回答特定领域问题的智能助手。 2. 项目快速启动 2.1 环境准备 在开始之前,请确保您的开发环境已经安装了以下依赖: P...

gitblog_01040的博客 1037

Doris副本修复实战:从状态机到手动修复的完整指南

在分布式数据库系统中,多副本机制是实现高可用与数据一致性的核心技术。其原理是通过在不同节点存储数据的多个拷贝,确保部分节点故障时服务仍可继续。这项技术的核心价值在于保障数据可靠性,并支撑在线分析处理(OLAP)等对数据一致性要求高的应用场景。当副本出现损坏、丢失或版本不一致时,系统通常依赖自动修复机制,但在元数据损坏、多副本同时故障等复杂场景下,自动修复可能失效,需要深入理解副本状态机并借助手动工具介入。本文将聚焦Doris数据库,解析Tablet副本状态流转(如BAD、VERSION_ERROR),并详细

weixin_32288959的博客 465

计算机视觉教程1-1:透视空间与透视变换

在生活中,透视现象很常见,其物理本质是光的直线传播。由于人眼与相机在捕获图像时均存在透视现象,因此计算机几何基于透视空间进行研究。本节介绍透视变换原理

FRIGIDWINTER的博客 3092

如何搭建一套免费开源的微信群机器人问答系统?

群消息不停弹出,整理统计信息和回复消耗你大量精力,还可能发生错乱,功亏一篑。 但这些如果借助自动消息回复和机器人,也许很快就能解决。vika维格表的用户@choogoo 就有同样的场景需求。身为国内某大厂的产品经理,他日常就喜欢做一点小程序或者网站去解决自己实际应用中的问题。 于是,一个名为「微信智能问答机器人系统」的开源项目诞生了,繁杂的群信息对接管理可以轻松搞定。

vikadata的博客 6288

YOLOv11旋转目标检测详解:从原理到实战的全面指南

本文介绍了YOLOv11旋转目标检测技术的核心概念、架构设计与应用场景。传统目标检测使用水平边界框(AABB)存在背景噪声大、定位精度低等问题,而旋转边界框(OBB)通过引入角度参数显著提升了检测精度,在遥感、OCR、工业质检等领域具有独特优势。YOLOv11-OBB采用改进的多尺度检测层、CSPDarknet53骨干网络和双通道角度输出机制,在保持实时性的同时实现精确的旋转目标检测。实验表明,该方法在DOTA数据集上达到81.3%的mAP,相比传统方法提升显著,特别适合处理具有旋转特性或高宽比悬殊的目标。

本博客聚焦 YOLOv11 全流程落地,涵盖架构优化、数据集处理、训练技巧与多场景部署,兼及国产数据库、Java 开发与 AI 模型应用,内容兼顾理论与工程实践,为开发者提供系统干货,助力高效提升技术能力。 302

QAnything:网易开源本地知识库问答系统

QAAnything(QAnything) 是一个本地知识库问答系统,旨在支持各种文件格式和数据库,允许离线安装和使用。用户只需将任何本地存储的任何格式的文件拖放到系统中,即可获得准确、快速和可靠的答案。PDF(pdf)Word(docx)PPT(pptx)Eml(eml)TXT(txt)XLS(xlsx)CSV(csv)图像(jpg,jpeg,png)网页链接(html)数据安全,支持在整个过程中插拔网线的安装和使用。跨语言问答支持,可以自由切换中英文问答,

老皮的博客 4064

LLaMA Factory多卡微调的实战教程(持续更新)

本文主要介绍了LLaMA Factory多卡微调的实战教程(持续更新),希望对学习大语言模型的同学们有所帮助。 文章目录 1. 前言 2. 配置环境 2.1 安装虚拟环境 2.2 安装依赖库 2.3 模型选型与下载 2.4 配置多卡环境 3. 运行代码 3.1 构建训练数据 3.2 修改配置文件 3.3 微调 3.3.1 zero3微调 3.3.2 启动API 3.3.3 模型测试

herosunly的博客 25万+

蓝牙模块HM-10手册

蓝牙模块HM-10手册,该手册对蓝牙模块HM-10进行了详细的介绍和使用方法以及一些AT指令。

OpenUE - 轻量级开源知识图谱抽取开源工具

在这个notebook中我们将使用openue库代码来训练我们自己的三元组联合抽取,使用的基础模型是,训练分为两步,首先训练关系分类模型,其次训练实体抽取模型。之后联合验证。

AI工程化、开源分享、文档翻译、代码笔记 1512

jre9下载 jdk9

(Java SE Runtime Environment 9.0) 9.0u175 官方最新版 【x86|x64】

开源问答系统调研

开源问答系统调研1. QABasedOnMedicaKnowledgeGraph 3.5k stars2. haystack: 2.7k stars3. KBQA-BERT: 998 stars4. KGQA-Based-On-medicine 822 stars5. CrimeKgAssitant: 752 stars6. QASystemOnMedicalGraph: 706 stars7. QAonMilitaryKG: 393 stars 各类关于CQA,KBQA,KGQA问答系统的研究层出不穷,本

qq_27844739的博客 2657

锂电池充电器电路设计 里面有电路

锂电池充电器电路设计 里面有电路 3.7V升压到5V电路设计。

廖雪峰Python教程[完整版]

廖雪峰的python教程整理的,已经排好版了,而且还是完整的,适合小白

FrOG:基于知识图谱的开源GraphRAG问答系统研究综述来了

本研究提出FrOG开源框架,通过知识图谱(KG)增强大语言模型(LLM)的问答能力,解决知识更新延迟、推理不透明和幻觉问题。系统采用两阶段Pipeline设计:v1实现基础SPARQL查询生成,v2引入多语言支持与矢量检索,支持Wikidata、DBpedia及本地CurriculumKG。实验表明,Pipelinev2+Qwen2.57B在Wikidata/DBpedia/CurriculumKG上分别达到0.458/0.517/0.976的Jaccard相似度,验证了本体检索和小样本提示的关键作用。

2401_84204413的博客 1168

【开源项目】MaxKB+Ollama:构建私有化知识库问答系统

MaxKB 是一款基于 LLM 大语言模型的知识库问答系统。MaxKB = Max Knowledge Base,旨在成为企业的最强大脑。:支持直接上传文档、自动爬取在线文档,支持文本自动拆分、向量化,智能问答交互体验好;:支持零编码快速嵌入到第三方业务系统;:支持对接主流的大模型,包括 Ollama 本地私有大模型(如 Llama 2、Llama 3、qwen)、通义千问、OpenAI、Azure OpenAI、Kimi、智谱 AI、讯飞星火和百度千帆大模型等。

m0_59235245的博客 5608

开源 python 问答系统_开源 FAQ 问答系统 AnyQ

软件介绍AnyQ(ANswer Your Questions)AnyQ(ANswer Your Questions)开源项目主要包含面向FAQ集合的问答系统框架、文本语义匹配工具SimNet。问答系统框架采用了配置化、插件化的设计,各功能均通过插件形式加入,当前共开放了20+种插件。开发者可以使用AnyQ系统快速构建和定制适用于特定业务场景的FAQ问答系统,并加速迭代和升级。SimNet是百度自...

weixin_39648824的博客 1089

公司内网知识问答库系统源码 完全开源可二次开发 带完整搭建教程

知识问答库系统可以成为一个动态的学习平台,员工可以在其中寻找答案,也可以分享他们的知识和经验。通过创建一个内部的知识问答平台,可以鼓励员工之间的互动和合作,增进彼此之间的了解和信任。1.用户管理:系统提供完善的用户管理功能,可以创建和管理用户账户,设置不同的权限级别,确保系统的安全性和访问控制。4.知识搜索:系统提供强大的搜索功能,员工可以通过关键词搜索相关的问题和答案,快速找到他们需要的信息。5.知识推荐:根据用户的行为和兴趣,系统可以推荐相关的知识和话题,帮助员工扩展他们的知识面。

codeji的博客 800

Knowledge-QA-LLM: 基于本地知识库+LLM的开源问答系统

Knowledge-QA-LLM: 基于本地知识库+LLM的问答系统。

有问题请直接说问题就好 2541

一款开源、适合任何团队的问答平台系统,助力开始构建社区论坛、帮助中心、知识管理平台!

它支持团队成员发布问题、回答问题、进行互动,并通过强大的搜索功能和分类标签系统帮助用户快速找到所需信息。无论你的团队规模如何,Answer 都能帮助你轻松构建社区论坛、帮助中心或知识管理平台,促进团队内部的知识分享和沟通。:开发者可以创建自定义插件,扩展 Answer 的功能,如集成第三方服务、添加新的展示样式等。:遵循开源协议,允许任何人查看、修改和分发代码,促进社区合作与发展。:提供强大的搜索功能,支持按关键词、标签、用户等维度筛选问题。

dotNET跨平台 444

[开源]知识图谱体系在企业级应用中的落地:可落地的知识管理系统

千知平台(qKnow)是一个面向企业级应用的开源知识平台。平台深度融合了知识抽取、知识融合、知识推理与知识图谱等核心功能模块,支持从非结构化和结构化数据中高效提取知识,助力企业快速构建可落地的知识图谱体系。

m0_63171455的博客 1951

基于JAVA语言的知识图谱构建系统 开源项目

基于JAVA+Vue+SpringBoot+MySQL的知识图谱构建系统,包含了知识图谱模块、知识点模块、学生测评模块、学生成绩模块,还包含系统自带的用户管理、部门管理、角色管理、菜单管理、日志管理、数据字典管理、文件管理、图表展示等基础模块,知识图谱构建系统基于角色的访问控制,给教师、学生使用,可将权限精确到按钮级别,您可以自定义角色并分配权限,系统适合设计精确的权限约束需求。

胡晗靓的Java学习博客 2114
上一篇: 大厂都在抢的OS Agents救命手册!浙大团队亲授:MLLM技术栈+智能体进化论,这篇能省下百万研发成本!
下一篇: 北大清华联合重磅成果:异步强化学习让Agent搜索跳出十轮限制,入门到精通这一篇就够了
Python_金钱豹
博客等级 码龄5年 1万+粉丝 2839原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值