收藏级GraphRAG宝典:手把手拆解微软开源黑科技,知识图谱增强生成一篇通!

Cursor赋能Qt C++:从环境配置到项目构建的AI开发新范式 本文详细介绍了如何利用Cursor工具链提升Qt C++开发效率,从智能环境配置到CMake项目构建的全流程实践。通过AI辅助编程、Qt生态优化及高级调试技巧,开发者可快速完成从传统开发到AI驱动的新范式转换,显著缩短项目搭建时间并提升代码质量。 阅读详情

一、处理流程图

二、数据处理流程

  1. 将文档内容进行分块

    a. chunk 策略:滑动窗口的策略

  2. 每个分块送入 LLM 进行解析,得到三元组

    a. LLM 将首先被提示提取文本中的实体,为实体生成简洁的描述性文本

    b. 根据当前文本块中的实体,LLM 被提示从文本中提取这些实体之间的关系,同样生成简介的描述性文本

  3. 将三元组导入到 Neo4j

2.1LLM生成 entity

input:

"In the latest study, we explored the potential of using machine learning algorithms for disease prediction. We used support vector machines (SVM) and random forest algorithms to analyze medical data. The results showed that these models performed well in predicting disease risk through feature selection and cross-validation. In particular, the random forest model showed better performance in dealing with overfitting problems. In addition, we discussed the application of deep learning in medical image analysis."

output:

<concept>

2.2 LLM 生成三元组

input:

[

output:

  1. Subject: The first entity from the given entities.

  2. Predicate: The action or relationship linking the subject to the object.

  3. Object: The second entity from the given entities.

<triplet>

2.3 LLM 实体消歧

input:

[

output:

<transformation>

2.4 导入Neo4j

导入语句

query = (

三、社区聚类 2.1 社区聚类

社区检测算法有很多种:选择使用分层的 Leiden 社区检测算法,以递归方式构建社区层级结构

  1. 首先在全图中识别出初始社区

  2. 然后在每个社区内继续执行子社区检测,直到无法进一步划分为止,形成叶级社区。

使用 Neo4j 的 GDS 库提供的分层Leiden算法包对提取出的知识图谱进行社区检测,得到包含节点和关系的社区信息。

摘要的生成采用模板方法,逐步将图中节点、边及其声明的摘要填充到社区摘要模板中。较低层级的社区摘要将作为上层社区摘要生成的基础。具体步骤如下:

  1. 对于叶级社区,从图中提取的节点和边的摘要被按优先级排序加入到 LLM 上下文窗口中。排序标准是:依据边的源节点和目标节点的整体度量(即显著性)降序排列。依次添加源节点描述、目标节点描述、边的描述。

  2. 对于高级社区,若所有元素摘要在上下文窗口的 token 限制内可容纳,则按叶级社区的方法汇总所有元素摘要;否则,将子社区按摘要的 token 数量降序排序,逐步用更短的子社区摘要替换较长的元素摘要,直到整体摘要符合上下文窗口限制。

3.2 社区检测算法

分层 Leiden 算法流程主要包括以下三个阶段:

(1) 节点聚合:在固定社区划分的前提下,尝试将每个节点移动到邻居节点所属社区,以提升总体模块度。

(2) 社区细化:对每个社区进行局部划分,确保每个社区子图中的所有节点之间是连通的,防止出现不连通的社区。

(3) 图聚合:构建新的超图,将每个社区作为一个超级节点,重复第一步,形成递归的社区层级结构。

模块化用于衡量当前社区划分相较于随机划分的“好坏”,定义如下:
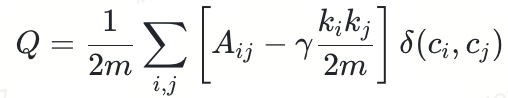
完成社区检测后,我们会为每个节点增加它们所属的社区属性,很明显,同一个节点有可能属于不同社区,所以这里的 communityIds 实际上是一个列表。

3.3 LLM 生成 社区摘要

根据社区内节点的内容生成该社区的摘要,反馈这个社区内的核心内容,这一步相当易懂,我们只需要使用 LLM 读取社区内节点与关系的描述,最后总结即可

本文在处理摘要时使用了比较直接的思路,即每个社区的信息都导入 LLM 让其生成摘要。

生成社区摘要:更优的做法是我们在撰写社区摘要时,需要从下往上生成,因为过大的社区可能造成超过 LLM 的 token 限制,而从下而上的处理方式使得我们可以跳过一些已经生成过摘要的子社区,直接将子社区的摘要作为一部分节点的描述,从而最大程度减小 token 消耗。

我们读取每个社区内节点与边的描述,然后将他们整理之后导入 LLM 中,让其生成社区摘要,

社区摘要内容主要包括:

  1. 社区名称
  2. 社区总结
  3. 社区内需要关注的要点信息
- TITLE: community's name that represents its key entities - title should be short but specific. When possible, include representative named entities in the title.

input:

Entities:

output:

{

四、检索算法

4.1 局部查询算法

主要用于回答那些聚焦于单一或少数几个实体的问题,比如“孙悟空的生平”或“矢车菊的治疗特性”。这种方法通过一系列步骤,从知识图谱和原始语料中提取与查询密切相关的信息,以构建精准的上下文,并最终生成高质量的回答。

查询步骤:

  1. **生成query的embedding:**将用户query转化为向量
  2. **按向量相似度查询:**计算知识图谱中实体节点向量与query向量的相似度,筛选出相似度超过阈值的相关实体
  3. **提取实体及内容片段:**系统提取这些实体的邻居节点和边,在原始文本中查找相关内容片段
  4. **生成局部上下文:**将相关实体、邻居节点和文本片段组合成局部上下文窗口,对外输出,给到LLM,用于回答用户 query

4.2 全局查询算法

全局查询方法适用于更复杂的问题,尤其是那些需要跨越多个知识图谱社区、结构性较强的查询,比如“曹操与大乔之间的联系”。这种类型的问题通常难以通过关注单一实体来解决,因此需要更宏观的视角和层级化的信息整合。

查询步骤:

  1. **生成query的embedding:**将用户query转换为一个 embedding向量
  2. **按向量相似度查询:**将embedding向量与所有社区摘要的embedding向量进行比较,筛选出与查询最相关的一组社区。这一筛选基于相似度阈值,确保只保留与查询密切相关的区域。
  3. **社区摘要生成chunk:**系统会把2中社区摘要,进一步切分成较小的chunk文本块,
  4. **相关性计算:**通过 LLM 对3中chunk做处理(别出若干关键信息点,并为每个信息点打分,以反映其对回答问题的贡献度)
  5. **相关性过滤:**系统会根据评分,从所有中间响应中挑选出最重要的若干信息点,组成一个高质量的全局上下文。这些信息点跨越不同的社区,构成了一个面向复杂查询的知识核心。
  6. **生成全部上下文:**将 5 中上下文连和原始query一起被输入到LLM中,生成最终的答案

若干关键信息点,并为每个信息点打分,以反映其对回答问题的贡献度)
5. **相关性过滤:**系统会根据评分,从所有中间响应中挑选出最重要的若干信息点,组成一个高质量的全局上下文。这些信息点跨越不同的社区,构成了一个面向复杂查询的知识核心。
6. **生成全部上下文:**将 5 中上下文连和原始query一起被输入到LLM中,生成最终的答案

如何学习大模型 AI ?

我国在AI大模型领域面临人才短缺,数量与质量均落后于发达国家。2023年,人才缺口已超百万,凸显培养不足。随着Al技术飞速发展,预计到2025年,这一缺口将急剧扩大至400万,严重制约我国Al产业的创新步伐。加强人才培养,优化教育体系,国际合作并进,是破解困局、推动AI发展的关键。

但是具体到个人,只能说是:

“最先掌握AI的人,将会比较晚掌握AI的人有竞争优势”。

这句话,放在计算机、互联网、移动互联网的开局时期,都是一样的道理。

我在一线互联网企业工作十余年里,指导过不少同行后辈。帮助很多人得到了学习和成长。

我意识到有很多经验和知识值得分享给大家,也可以通过我们的能力和经验解答大家在人工智能学习中的很多困惑,所以在工作繁忙的情况下还是坚持各种整理和分享。但苦于知识传播途径有限,很多互联网行业朋友无法获得正确的资料得到学习提升,故此将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。
在这里插入图片描述

2025最新大模型学习路线

明确的学习路线至关重要。它能指引新人起点、规划学习顺序、明确核心知识点。大模型领域涉及的知识点非常广泛,没有明确的学习路线可能会导致新人感到迷茫,不知道应该专注于哪些内容。

对于从来没有接触过AI大模型的同学,我帮大家准备了从零基础到精通学习成长路线图以及学习规划。可以说是最科学最系统的学习路线。

在这里插入图片描述

针对以上大模型的学习路线我们也整理了对应的学习视频教程,和配套的学习资料。

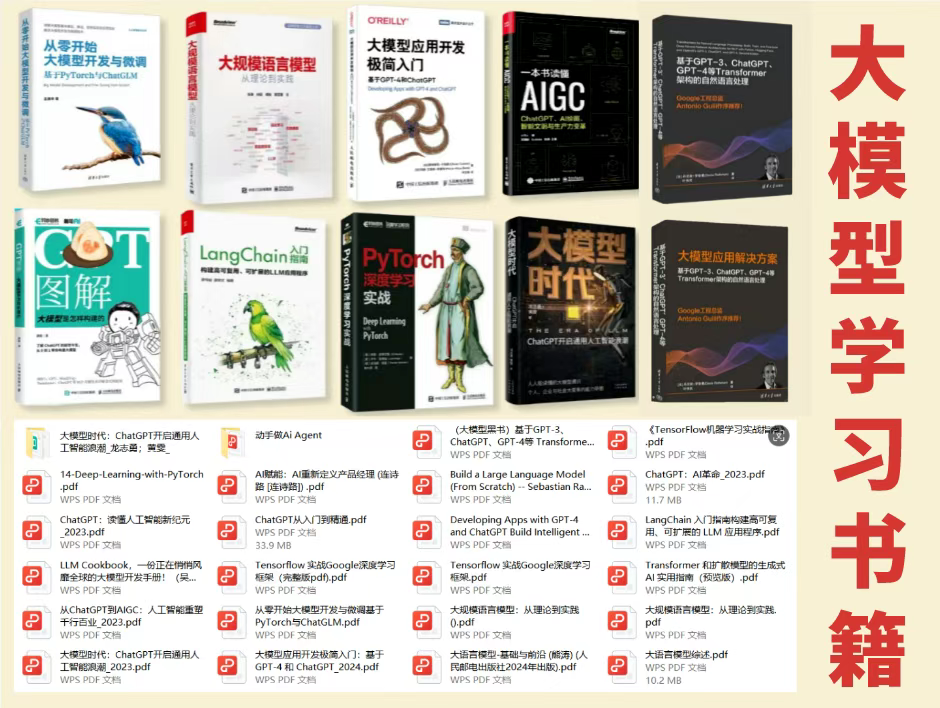
大模型经典PDF书籍

新手必备的大模型学习PDF书单来了!全是硬核知识,帮你少走弯路!
在这里插入图片描述

配套大模型项目实战

所有视频教程所涉及的实战项目和项目源码等
在这里插入图片描述

博主介绍+AI项目案例集锦

MoPaaS专注于Al技术能力建设与应用场景开发,与智学优课联合孵化,培养适合未来发展需求的技术性人才和应用型领袖。
在这里插入图片描述

在这里插入图片描述

这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】

在这里插入图片描述

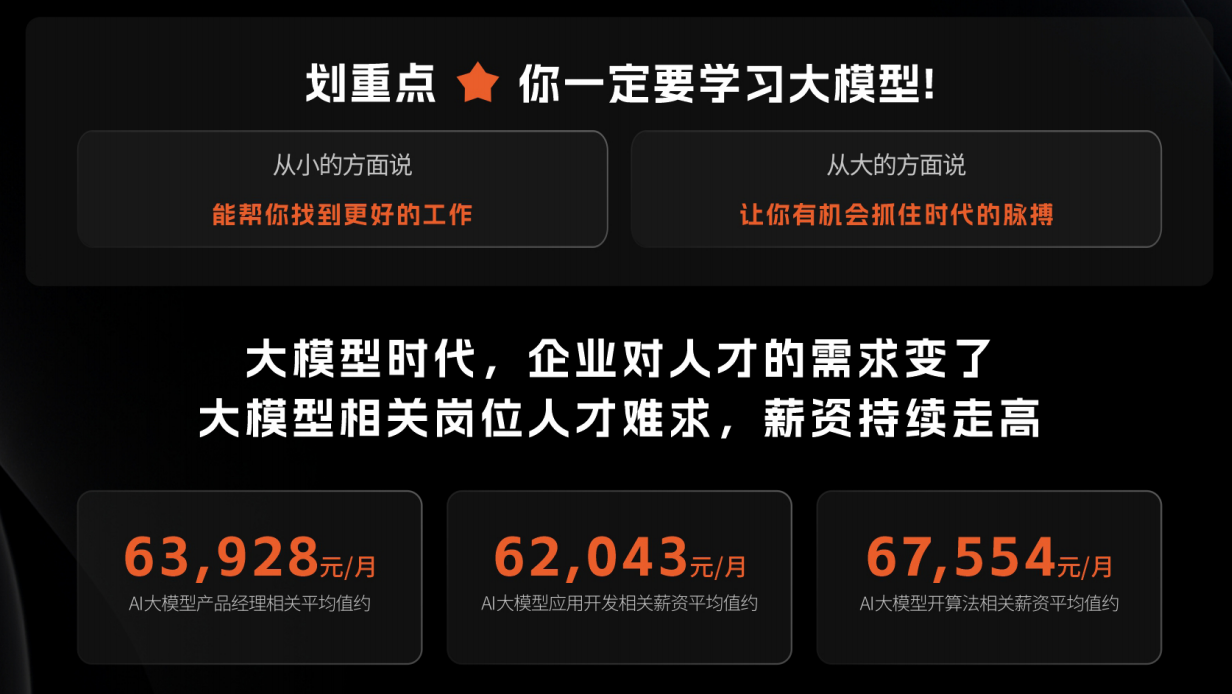
为什么要学习大模型?

2025人工智能大模型的技术岗位与能力培养随着人工智能技术的迅速发展和应用 , 大模型作为其中的重要组成部分 , 正逐渐成为推动人工智能发展的重要引擎 。大模型以其强大的数据处理和模式识别能力, 广泛应用于自然语言处理 、计算机视觉 、 智能推荐等领域 ,为各行各业带来了革命性的改变和机遇 。
在这里插入图片描述

适合人群

  • 在校学生:包括专科、本科、硕士和博士研究生。学生应具备扎实的编程基础和一定的数学基础,有志于深入AGI大模型行业,希望开展相关的研究和开发工作。
  • IT行业从业人员:包括在职或失业者,涵盖开发、测试、运维、产品经理等职务。拥有一定的IT从业经验,至少1年以上的编程工作经验,对大模型技术感兴趣或有业务需求,希望通过课程提升自身在IT领域的竞争力。
  • IT管理及技术研究领域人员:包括技术经理、技术负责人、CTO、架构师、研究员等角色。这些人员需要跟随技术发展趋势,主导技术创新,推动大模型技术在企业业务中的应用与改造。
  • 传统AI从业人员:包括算法工程师、机器视觉工程师、深度学习工程师等。这些AI技术人才原先从事机器视觉、自然语言处理、推荐系统等领域工作,现需要快速补充大模型技术能力,获得大模型训练微调的实操技能,以适应新的技术发展趋势。
    在这里插入图片描述

课程精彩瞬间

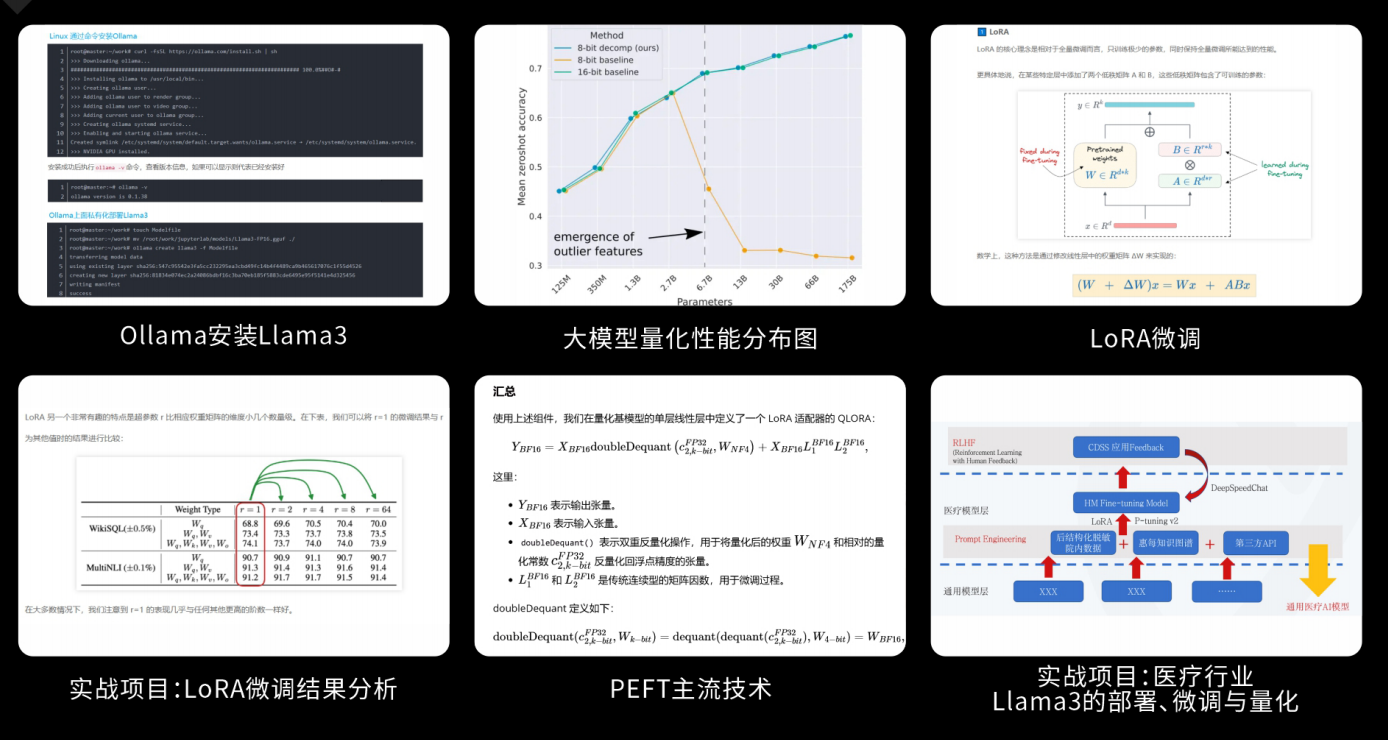
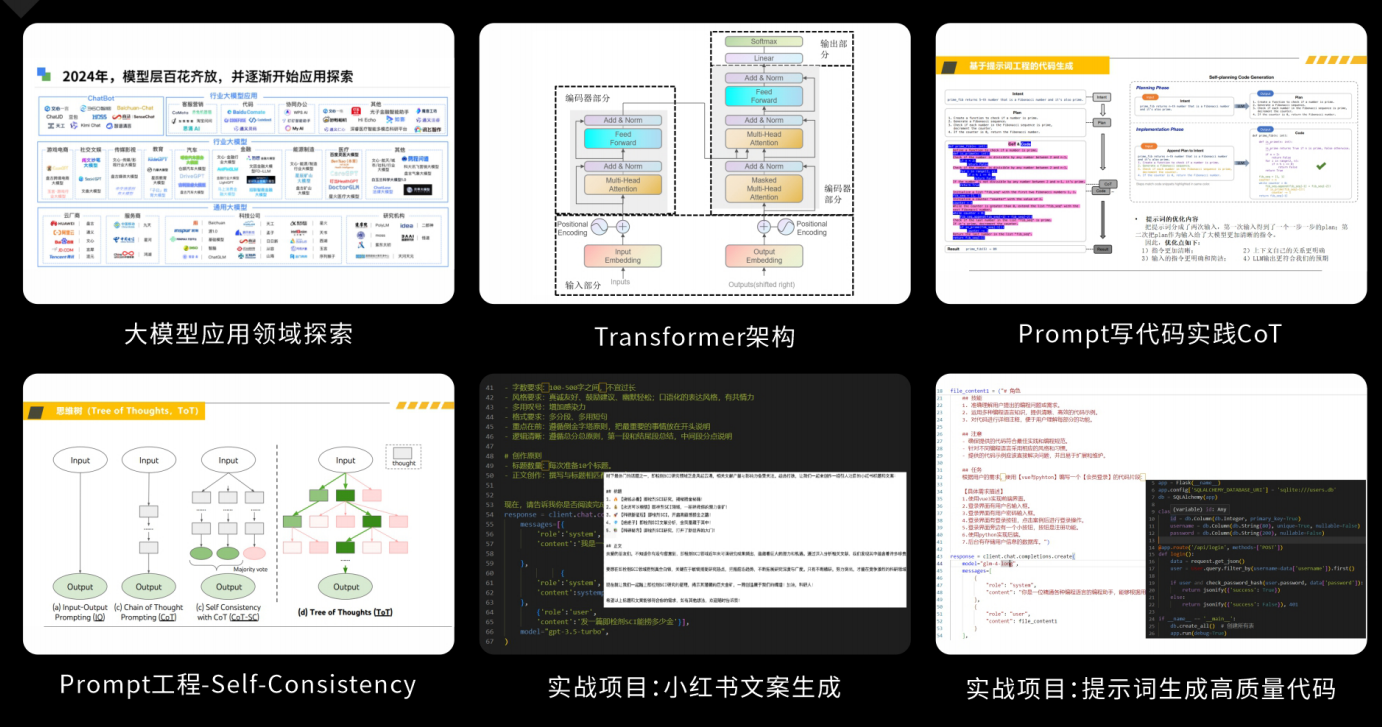
大模型核心原理与Prompt:掌握大语言模型的核心知识,了解行业应用与趋势;熟练Python编程,提升提示工程技能,为Al应用开发打下坚实基础。

在这里插入图片描述

RAG应用开发工程:掌握RAG应用开发全流程,理解前沿技术,提升商业化分析与优化能力,通过实战项目加深理解与应用。 在这里插入图片描述

Agent应用架构进阶实践:掌握大模型Agent技术的核心原理与实践应用,能够独立完成Agent系统的设计与开发,提升多智能体协同与复杂任务处理的能力,为AI产品的创新与优化提供有力支持。
在这里插入图片描述

模型微调与私有化大模型:掌握大模型微调与私有化部署技能,提升模型优化与部署能力,为大模型项目落地打下坚实基础。 在这里插入图片描述
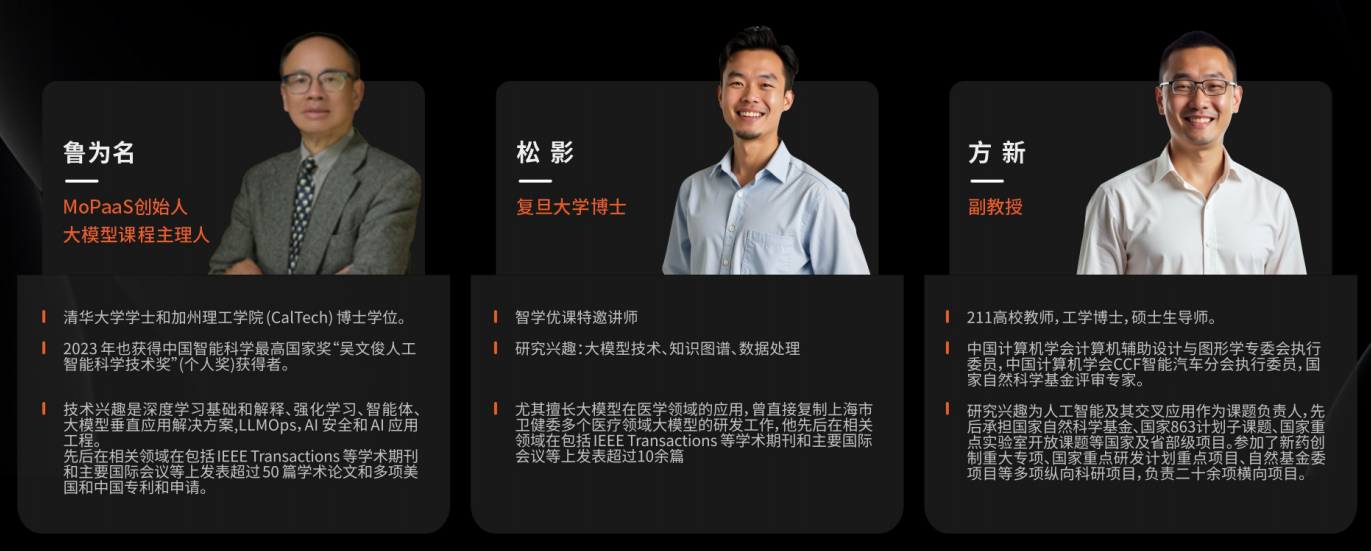
顶尖师资,深耕AI大模型前沿技术

实战专家亲授,让你少走弯路
在这里插入图片描述

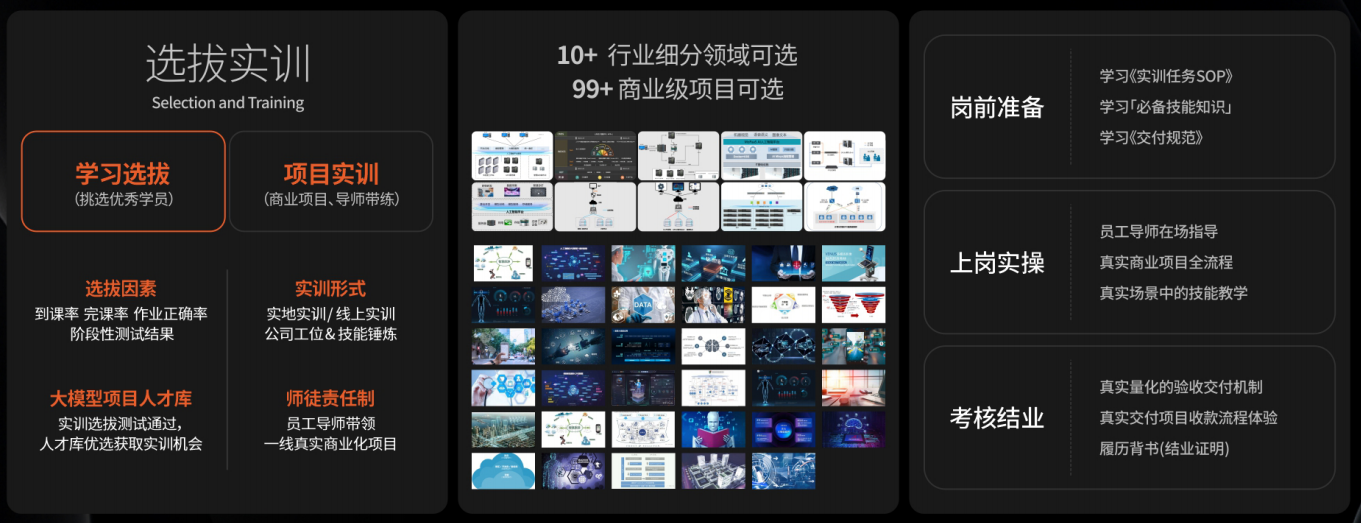
一对一学习规划,职业生涯指导

  • 真实商业项目实训
  • 大厂绿色直通车

人才库优秀学员参与真实商业项目实训

以商业交付标准作为学习标准,具备真实大模型项目实践操作经验可写入简历,支持项目背调

在这里插入图片描述
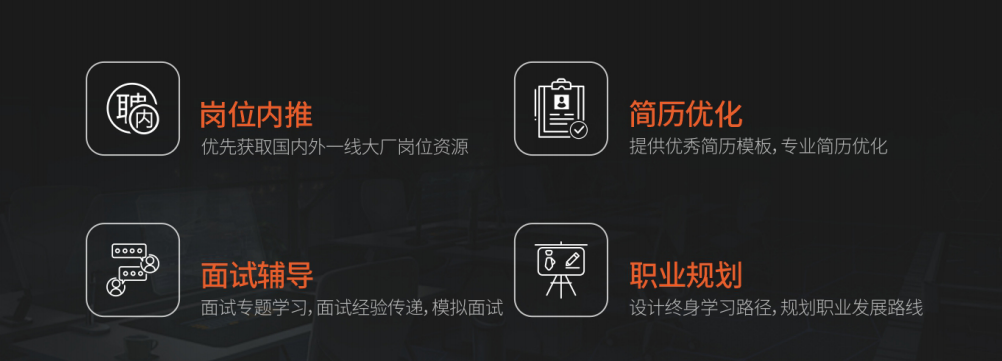
大厂绿色直通车,冲击行业高薪岗位
在这里插入图片描述

文中涉及到的完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】

在这里插入图片描述

点到面点云配准(Point To Plane)算法知识详解和详细推导,C++代码实现 点到面 ICP (Iterative Closest Point) 是在 3D 点云配准中常见的一种变体,通过最小化点到对应面(由法向量定义的局部平面)的距离来提高收敛速度和精度。 阅读详情

相关推荐

告别商业软件?实测用gnina(CNN打分版)做分子对接:从安装到跑通第一个案例

本文详细介绍了基于卷积神经网络(CNN)的开源分子对接工具gnina的安装与实战应用。从环境配置、编译安装到运行第一个COVID-19主蛋白酶抑制剂对接案例,全面解析了这款替代商业软件的强大功能,特别适合预算有限的研究团队进行药物发现和虚拟筛选。

weixin_42522320的博客 256

【LLM大模型】GraphRAG入门学习流程

GraphRAG 是一种基于图的检索增强方法,由微软开发并开源。它通过结合LLM和图机器学习的技术,从非结构化的文本中提取结构化的数据,构建知识图谱,以支持问答、摘要等多种应用场景。GraphRAG的特色在于利用图机器学习算法进行语意聚合和层次化分析,从而能够回答一些高层次的抽象或总结性问题,这是常规RAG系统的短板。

Langchain的博客 1850

解放双手!利用海康VM全局脚本+通讯管理打造自动化视觉控制系统

本文深入探讨了如何利用海康VisionMaster(VM)的全局脚本和通讯管理功能,打造高效自动化视觉控制系统。通过全局变量实现数据共享与动态调整,结合多协议通讯管理,提升系统响应速度与智能化水平,适用于工业4.0环境下的复杂视觉检测与决策场景。

weixin_28720573的博客 425

从零理解 GraphRAG:从数据处理到检索查询的 GraphRAG 全流程拆解

本文介绍了基于TinyGraphRAG的轻量级知识图谱构建与检索全流程。通过滑动窗口分块文档,利用LLM提取实体和三元组后导入Neo4j构建知识图谱。采用分层Leiden算法进行社区聚类,并从叶节点向上生成结构化社区摘要。最后实现两种查询模式:局部查询聚焦单一实体,全局查询跨越多个社区。每步均提供输入输出示例和关键代码,帮助读者无需复杂前置知识即可理解如何将无序文本转化为结构化知识,实现精准智能检索。

qq_46094651的博客 919

ROS2 Nav2实战:解决rviz2显示no map received的3种实用方法(附详细步骤)

本文针对ROS2 Nav2导航栈中rviz2显示“no map received”的常见问题,提供了三种核心解决方案。深入剖析了问题根源在于ROS2生命周期节点管理、QoS策略不匹配及坐标系设置错误,并分别通过手动配置流程、集成生命周期管理器以及调优QoS策略与固化rviz2配置,给出了详细的实战步骤,确保地图数据可靠显示。

j0k1l2m3n的博客 422

如何优雅地进行频谱分析—— 一行代码实现绘制MATLAB频谱、功率谱图

之前的文章里讲了关于信号频谱、能量谱的相关理论和MATLAB编程实现方法: Mr.看海:信号频域分析方法的理解(频谱、能量谱、功率谱、倒频谱、小波分析) Mr.看海:频域特征值提取的MATLAB代码实现(频谱、功率谱、倒频谱) 不过对于刚刚开始进行这方面研究,或者对MATLAB不甚熟悉,抑或者不想花太多时间用在编程这件事上的同学,目前缺少一种足够便捷、高效、可靠的代码。 所以笔者想做这样一件事:编写一个函数,同学们只需要导入自己要分析的数据,并按照自己的需求设置部分选项,调用一行代码就可以实现绘制频

fengzhuqiaoqiu的博客 2万+

GraphRAG查询(Query)流程实现原理分析

GraphRAG查询(Query)流程实现原理分析

缘友一世的博客 1335

IS-IS协议深度解析(二):LSDB同步机制与骨干网实战部署

本文深度解析IS-IS协议的LSDB同步机制与骨干网实战部署。详细阐述了DIS角色如何通过CSNP/PSNP报文高效管理链路状态数据库同步,并与OSPF DR机制进行对比。重点介绍了Level-2骨干网作为逻辑高速公路系统的工作原理,以及通过ATT比特位实现跨区域路由的自动化。最后提供了高可靠性骨干网的实战配置要点与验证方法。

kite3的博客 644

全网首发!GraphRAG知识图谱全流程解析,小白也能轻松读懂

当GraphRAG完成索引过程后,它默认会将构建知识图谱所需的所有数据持久化。这些数据被存储在输出目录中,并采用Parquet文件格式。Parquet是一种列式压缩存储格式,专为高效的数据存储和分析而设计。你可以将其视为DataFrame的一种持久化方式。在查询阶段,这些Parquet文件会被加载到内存和向量数据库中。这样做的好处在于,我们可以直接从内存和数据库中检索信息,而无需再次从原始数据源抽取和处理数据。这大大提高了查询的效率和速度。

2401_84495872的博客 1985

LeRobot 官方论文:一个用于端到端机器人学习的开源库

本文介绍了一个名为LeRobot的开源库,旨在解决机器人学习领域的碎片化问题。该库提供了端到端的技术栈,包括统一的机器人中间件API、标准化的数据集格式(LeRobotDataset)、优化的推理栈以及多种最先进机器人学习算法的实现。LeRobot支持多种低成本开源机器人平台(如SO-10X、ALOHA-2等),通过共享中间件实现便捷的遥操作和数据收集。其数据集格式已广泛应用于社区,截至2025年9月已有16,000多个数据集公开共享。该库还支持流式处理大规模数据,降低了研究门槛。在模型方面,LeRobot

2506_90492529的博客 907

什么是 SAPGUI 里的 Logon Group/Server

这意味着,不同的用户连接可以被分配到不同的应用服务器,以实现均衡的资源利用和降低某一服务器的负载压力。在这种配置下,欧洲的用户登录时选择“EUROPE_GROUP”,系统将自动选择一个位于欧洲的数据中心的服务器进行连接,这样不仅减少了网络延迟,还实现了服务器间的负载均衡。用户在 SAPGUI 中登录时,只需选择相应的 Logon Group(例如“FIN_GROUP”),系统就会自动将他们的连接请求分配到当前负载最小的应用服务器上,这种动态分配大大提升了系统的响应速度和稳定性。

2007 年 ~ 2025 年,深耕 SAP 技术 18 年 1069

【全网首发】小白友好!GraphRAG知识图谱全流程解析,多图详解!

当GraphRAG完成索引过程后,它默认会将构建知识图谱所需的所有数据持久化。这些数据被存储在输出目录中,并采用Parquet文件格式。Parquet是一种列式压缩存储格式,专为高效的数据存储和分析而设计。你可以将其视为DataFrame的一种持久化方式。在查询阶段,这些Parquet文件会被加载到内存和向量数据库中。这样做的好处在于,我们可以直接从内存和数据库中检索信息,而无需再次从原始数据源抽取和处理数据。这大大提高了查询的效率和速度。

2401_84494441的博客 2476

win10 跳过U8环境检测的IE WebControls.rar

win10 安装u8的时候 提示IE WebControls 不通过,这个工具可以欺骗u8的检查。 跳过U8环境检测的IE WebControls。提示导入失败后,重新检测通过。

AI产品经理学习宝典:飞书文档与GraphRAG中文站打造的大模型全方位学习路径!

本文精选了多个AI产品经理学习资源平台,包括入门指南、实操手册、GraphRAG技术详解和行业资料库。GraphRAG作为微软开源的RAG系统,结合知识图谱技术,能显著提升LLM对私有数据的推理能力。针对不同水平学习者,文章提供了从基础知识到技术深化的学习路径,帮助AI产品经理系统掌握大模型相关知识,持续跟踪行业动态。

2301_80239908的博客 2465

霍尼韦尔SoftMaster使用说明

霍尼韦尔SoftMaster使用说明

假人有限元模型

假人模型,车辆碰撞假人有限元模型,适合做乘员安全的研究者利用

一文搞懂GraphRAG、LightRAG、AgenticRAG,看这一篇就够了!

一文搞懂GraphRAG、LightRAG、AgenticRAG,看这一篇就够了!

xxue345678的博客 1万+

大模型入门到精通之GraphRAG、LightRAG、AgenticRAG,如何选择?

如果你真的想学习大模型,请不要去网上找那些零零碎碎的教程,真的很难学懂!你可以根据我这个学习路线和系统资料,制定一套学习计划,只要你肯花时间沉下心去学习,它们一定能帮到你!

2401_85375186的博客 1848

全网首发!小白也能读懂的GraphRAG知识图谱全流程解析,多图预警!_ragflow 知识图谱

今天,我要和你分享的是如何用GraphRAG从一个普通的txt文件中创建知识图谱,准备好了吗?那就让我们开始吧!当GraphRAG完成索引过程后,它默认会将构建知识图谱所需的所有数据持久化。这些数据被存储在输出目录中,并采用Parquet文件格式。Parquet是一种列式压缩存储格式,专为高效的数据存储和分析而设计。你可以将其视为DataFrame的一种持久化方式。在查询阶段,这些Parquet文件会被加载到内存和向量数据库中。

HUANGXIN9898的博客 2086

技术动态 | 微软发表GraphRAG论文并即将开源项目

全文摘要:微软发表GraphRAG论文"From Local to Global: A Graph RAG Approach to Query-Focused Summarization"并即将开源项目,论文讨论GraphRAG方法,用于对文本语料库进行问题回答,结合了检索增强生成和图形索引,以提高答案的全面性和多样性。主要观点:- GraphRAG将检索增强生成与知识图谱索引相结合,用于问题回答...

开放知识图谱 2138

全网首发!小白也能读懂的GraphRAG知识图谱全流程解析,多图预警!

当GraphRAG完成索引过程后,它默认会将构建知识图谱所需的所有数据持久化。这些数据被存储在输出目录中,并采用Parquet文件格式。Parquet是一种列式压缩存储格式,专为高效的数据存储和分析而设计。你可以将其视为DataFrame的一种持久化方式。在查询阶段,这些Parquet文件会被加载到内存和向量数据库中。这样做的好处在于,我们可以直接从内存和数据库中检索信息,而无需再次从原始数据源抽取和处理数据。这大大提高了查询的效率和速度。

m0_59164304的博客 1万+

GraphRAG:知识图谱+RAG技术

由于RAG的一些缺陷,最近工作中用到了GraphRAG,可以简单理解为知识图谱+RAG工作,在进行QFS与深度推理上表现良好。老板希望,在类似于库存管理、预测上面,可以结合更多的上下文信息和逻辑关系,进行推理和结果的输出。(下图为RAG简单示意图)

2401_84208172的博客 2万+

实战微软新一代RAG:GraphRAG强大的全局理解能力,碾压朴素RAG?

大语言模型(LLM)是在大量数据上训练,但他们并不是在我们私有数据上训练,因此要想让LLM能够回答我们私有数据集上的问题,我们就得使用一种叫做检索增强生成(RAG)的技术。它的基本原理是加载我们的文档,然后将每个文档按照一定的规则,比如Token数量、字符数量、语义和层次分割等,将每个文档拆分为一个一个小片段(chunk)。然后使用嵌入技术对这些chunk生成embeding,存储到高维向量数据库中,生成索引Index。

Python_cocola的博客 5226

【RAG & KG】GraphRAG开源:查询聚焦摘要的图RAG方法

传统的 RAG 方法在处理针对整个文本语料库的全局性问题时存在不足,例如查询:“数据中的前 5 个主题是什么?对于此类问题,是因为这类问题本质上是查询聚焦的摘要(Query-Focused Summarization, QFS)任务,而不是传统的显式检索任务。Graph RAG 通过使用 LLM 构建基于图的文本索引,从源文档构建知识图谱。通过构建知识图谱,能够将复杂的、大规模文本数据集转化为易于理解和操作的知识结构,以便更好地理解实体(如人物、地点、机构等)之间的相互关系。使用 LLM。

余俊晖,NLP炼丹师,目前专注自然语言处理领域研究。曾获得国内外自然语言处理算法竞赛TOP奖项近二十项。 2518

使用Graph RAG进行知识图谱查询的示例

Graph RAG是一种基于知识图谱的RAG方法,它通过从知识图谱中检索与任务相关的子图,构建上下文来完成任务。通常情况下,这是基于与任务相关的实体子图来构建上下文。

ppoojjj的博客 682

GraphRAG:复杂查询的知识图谱新框架

微软最近发布了名为 GraphRAG(Graphs + Retrieval Augmented Generation)的创新 RAG 框架,这是一个将文本提取、语义网络分析,与大语言模型(LLM)的提示和总结功能结合在一起的端到端系统,用于深入理解文本数据集。在对私有数据中的复杂文本信息进行文档分析时,GrahRAG 使用...

weixin_35733586的博客 929

收藏!Graph RAG 工作原理与完整流程详解(小白&程序员友好)

将图算法应用于知识图谱来识别紧密连接的节点集群。对于每个检测到的节点集群,LLM都会生成一个简洁的摘要,其中包含关键实体、关系和主题。高级别摘要描述总体主题,而低级别摘要则突出细节。这种层次结构确保用户可以根据查询、探索到不同粒度级别的信息。

weixin_72959097的博客 775

7 种查询策略教你用好 Graph RAG 探索知识图谱

我们在这篇文章中探讨了知识图谱,特别是图数据库 NebulaGraph,是如何结合 LlamaIndex 和 GPT-3.5 为 Philadelphia Phillies 队构建了一个 RAG。 此外,我们还探讨了 7 种查询引擎,研究了它们的内部工作,并观察了它们对三个问题的回答。我们比较了每个查询引擎的优点和缺点,以便更好地理解了每个查询引擎设计的用例。

weixin_44324814的博客 1581

GraphRAG 与 RAG 的比较分析

检索增强生成(Retrieval-Augmented Generation,简称 RAG)是一种旨在提升大型语言模型(Large Language Models,LLMs)性能的技术方法。其核心思想是通过整合外部可靠知识库的信息来增强模型的输出质量。RAG 的工作原理可以概括如下:当 LLM 接收到查询时,它不仅依赖于自身的预训练知识,还会主动从指定的知识源检索相关信息。这种方法确保了生成的输出能够参考大量上下文丰富的数据,并得到最新、最相关可用信息的支持。

deephub 6734
上一篇: 万字拆解MemTool黑科技:LLM智能体记忆管理避坑指南,企业级落地必备手册!
下一篇: 2025年最全知识库工具测评!AnythingLLM/Cherry Studio个人首选,RAGflow/Dify企业必选,一篇搞懂AI时代第二大脑!
Python_金钱豹
博客等级 码龄5年 1万+粉丝 2839原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值