


如果 LLM 大语言模型不只是用 JSON 描述操作,而是可以编写代码来执行操作,结果会怎样?如果它可以在其行动过程中直接利用 Python 等编程语言的全部功能(包括其循环、条件、变量和庞大的库生态系统),结果会怎样?
***这是CodeAct*背后的核心思想,CodeAct 是研究人员提出的一种突破性架构,被用作人工智能助手 Manus.im 的核心技术。CodeAct 代表了一种范式转变,将 LLM Agent从简单的工具用户转变为动态微型程序员,能够以更大的灵活性和效率处理更为复杂的任务。
*摘要*
大型语言模型 (LLM) 代理能够执行广泛的操作,例如调用工具和控制机器人,在应对现实世界的挑战方面表现出巨大的潜力。LLM 代理通常通过生成 JSON 或预定义格式的文本来提示执行操作,这通常受到受限的操作空间(例如,预定义工具的范围)和受限的灵活性(例如,无法组合多个工具)的限制。这项工作提出使用可执行的 Python代码将 LLM 代理的操作合并到统一的操作空间 (CodeAct) 中。与 Python 解释器集成后,CodeAct可以执行代码操作并动态修改先前的操作或通过多轮交互根据新的观察发出新操作。我们对 API-Bank 上的 17 个 LLM 和新策划的基准进行了广泛的分析,结果表明CodeAct优于广泛使用的替代方案**(成功率高出 20%)。CodeAct令人鼓舞的性能促使我们构建一个开源 LLM 代理,它通过执行可解释的代码与环境交互并使用自然语言与用户协作**。为此,我们使用CodeAct收集了一个由 7k 次多轮交互组成的指令调整数据集CodeActInstruct 。我们表明,它可以与现有数据一起使用,以改进面向代理任务中的模型,而不会损害其一般能力。CodeActAgent是从Llama2和Mistral 微调而来的,与Python 解释器集成,并且经过独特定制,可以使用现有库执行复杂任务(例如模型训练)并自主进行自我调试。
1介绍
大型语言模型 (LLM) 已成为自然语言处理 (NLP) 领域的关键突破。当添加允许访问 API 的操作模块时,其操作空间将扩展到传统文本处理之外,从而使 LLM 能够获得工具调用和内存管理等功能并涉足现实世界的任务,例如控制机器人并进行科学实验。
我们探究:如何有效扩展 LLM 代理的行动空间以解决复杂的现实问题? 许多现有研究使用文本进行研究或JSON来产生动作(例如,图1左上角的工具使用)。然而,这两种方法通常都受到动作空间范围的限制(动作通常针对特定任务量身定制)和灵活性受限(例如,无法在单个动作中组合多个工具)。作为替代方法,有几项工作展示了使用 LLM 生成代码来控制机器人或游戏角色的潜力。然而,它们通常依赖于预先指定的控制原语和手工设计的提示,更重要的是,很难根据新的环境观察和反馈动态调整或发出动作。
这项研究提出了CodeAct,这是一个通用框架,允许LLM生成可执行 Python代码作为****动作(图1右上)。CodeAct旨在处理各种应用程序,并具有独特的优势:
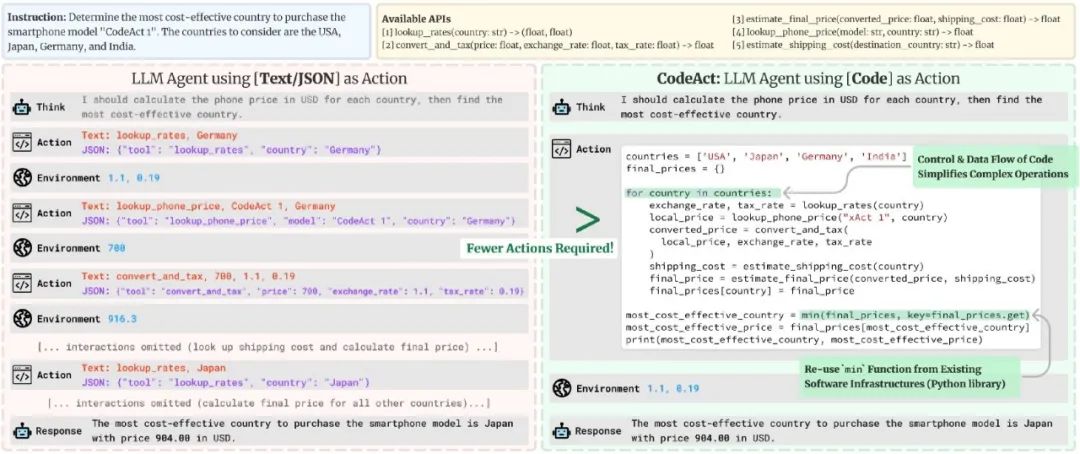
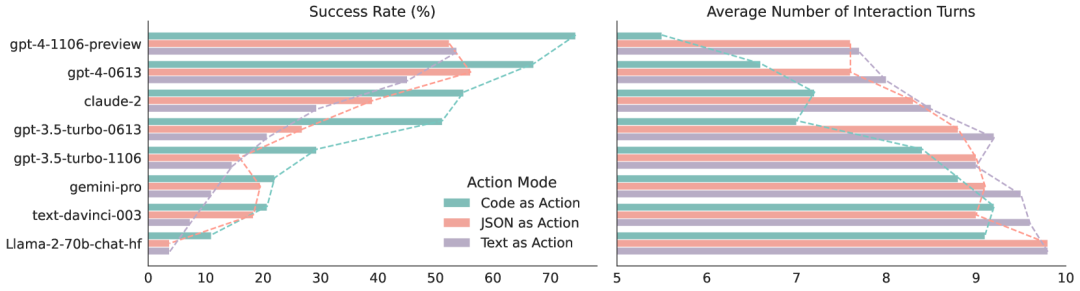
图1:CodeAct和 Text / JSON 操作之间的比较。
- (1)CodeAct****与 Python 解释器集成,可以执行代码操作并根据通过多轮交互收到的观察结果(例如,代码执行结果)动态调整先前的操作或发出新的操作。
- **(2)代码操作允许 LLM 利用现有的软件包。**CodeAct可以使用现成的Python包来扩展操作空间,而不是手工制作特定于任务的工具。它还允许 LLM 使用大多数软件中实现的自动反馈(例如错误消息),通过自我调试其生成的代码来改进任务解决。
- **(3)代码数据在当今的 LLM 预训练中被广泛使用。**这些模型已经熟悉结构化编程语言,从而可以经济高效地采用CodeAct。
- (4)与JSON 和具有预定义格式的文本相比,代码天生支持控制和数据流,允许将中间结果存储为变量以供重复使用,并允许组合多个工具以使用一段代码执行复杂的逻辑运算(例如,if语句、for循环),从而释放 LLM 利用其预先训练的编程知识来解决复杂任务的潜力。在图 1中,使用CodeAct的 LLM(右上)可以通过for循环(即控制流功能)将相同的工具序列(例如,使用数据流功能将一个工具的输出作为输入传递给另一个工具)应用于所有输入,只需一个操作;而文本或JSON必须对每个输入采取行动(左上)。
我们对 17 个 LLM(包括开源和专有 LLM)进行了广泛的实验,证实了CodeAct的上述优势(3和4)。为了证明优势(3),我们的第一个实验将CodeAct与基线在涉及原子工具使用(即每个操作只使用一个工具)的基本任务上进行了比较,消除了CodeAct提供的控制和数据流优势。结果表明,对于大多数LLM,CodeAct实现了与基线相当或更好的性能。 正如我们的第二个实验(优势4)所证明的那样, CodeAct****在复杂任务上的性能提升更为显著。我们策划了一个新的基准,由82 个人工策划的任务组成,这些任务通常需要在多轮交互中多次调用多个工具。这个基准中的问题通常需要复杂的协调和组合多种工具。凭借其在控制和数据流方面的优势,CodeAct在解决问题的成功率上实现了高达20%的绝对提升**,同时所需的****操作减少了30%**。随着 LLM 功能的增强,这些性能提升也越来越大(图1底部)。
CodeAct的出色性能促使我们开发一个开源LLM代理,该代理可以通过CodeAct有效行动,并通过自然语言与人类协作。为此,我们收集了一个指令调整数据集CodeActInstruct,该数据集包含7k 条高质量CodeAct多轮交互轨迹。CodeActInstruct受代理、用户和环境组成的通用代理框架(图 2)的启发,并专注于代理与计算机(信息查找、软件包使用、外部存储器)和物理世界(机器人规划)的交互。在 CodeActInstruct 上,我们进行仔细的数据选择,以提高从多轮交互中改进的能力(例如,自我调试)。
我们表明,CodeActInstruct可以与常用的指令调整数据一起使用,以提高模型在代理任务中的性能,而不会损害其一般能力(例如,基于知识的QA、编码、指令遵循)。我们的模型称为CodeActAgent,是根据 LLaMA-2和Mistral-7B并不仅使用CodeAct改进了out-of-domain代理任务,还使用预定义格式的文本操作。
CodeAct****还可以从多轮交互和现有软件中受益。如图3所示 ,CodeActAgent专为与Python无缝集成而设计,可以使用现有的 Python 包执行复杂的任务(例如模型训练、数据可视化)。来自环境的错误消息进一步使其能够通过多轮交互中的自我调试自主纠正错误。得益于 LLM 在预训练期间获得的丰富编程知识,这些无需上下文演示即可实现,从而减少了将CodeActAgent适应不同任务所需的人力。
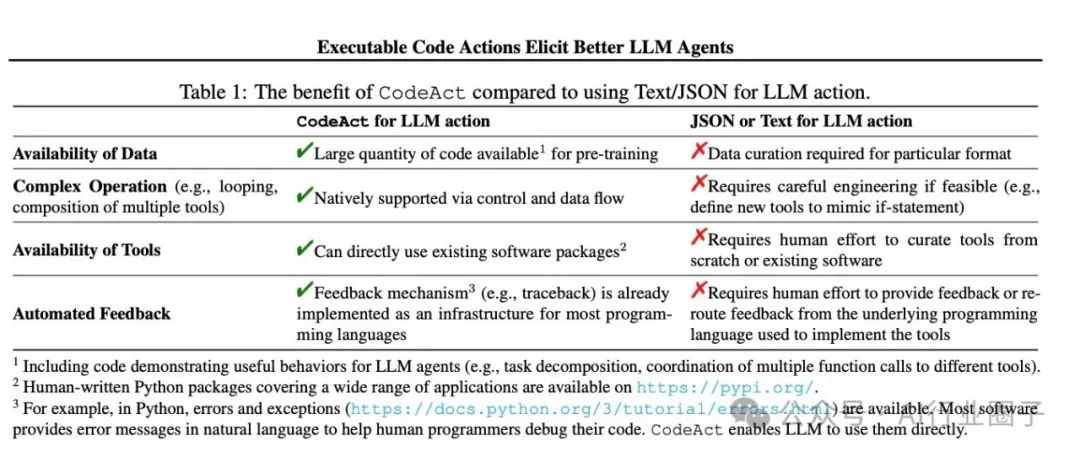
图1:CodeAct和 Text / JSON 操作之间的比较。
2CodeAct让法学硕士成为更好的Agent
在本节中,我们首先描述CodeAct框架,并提供支持选择CodeAct的经验证据。我们专注于使用Python作为CodeAct的编程语言,因为它很受欢迎(在TIOBE指数中排名第一,2024)和众多开源软件包。我们旨在使用17个现成的LLM 来回答几个研究问题 (RQ)。在2.2中,我们研究了RQ1:由于大量代码预训练数据,LLM对代码的熟悉程度是否会使CodeAct比文本和JSON更具优势?我们将在2.3中讨论RQ2 :CodeAct是否受益于Python在复杂问题中的先天控制和数据流功能?最后,作为额外的好处,我们将在2.4和图 3中讨论如何使用CodeAct通过实现多轮交互并允许它们访问现有软件来进一步增强LLM代理。
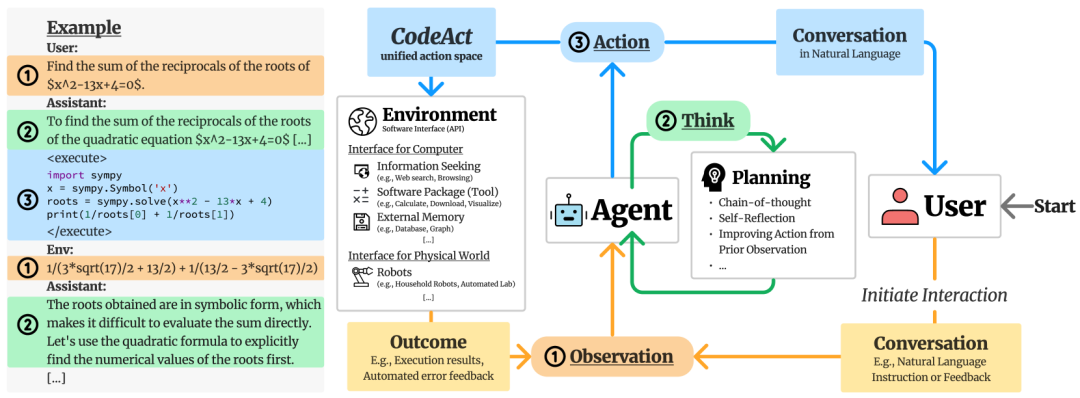
图2:通用代理多轮交互框架,描述CodeAct的作用并激励我们构建数据混合。CodeActInstruct 专注于代理与环境的交互,并专门过滤自我改进的规划行为,而我们包含的一般对话数据则专注于代理与用户的交互(3.1)。
2.1什么是CodeAct**?**
在图 2中,我们首先介绍了一个适用于LLM代理在实际应用中的通用多轮交互框架,该框架考虑了三种角色:代理**、用户和环境**。我们将交互定义为代理与外部实体(用户或环境)之间的信息交换。对于每次交互,代理都会从用户(例如自然语言指令)或环境(例如代码执行结果)接收观察(输入),并可选择通过CoT思维链来规划其行动,并以自然语言或环境向用户发出动作(输出)。**CodeAct使用Python代码来整合代理与环境交互的所有动作**。在CodeAct中,每个向环境发出的动作都是一段Python代码,代理将接收代码执行的输出(例如结果、错误)作为观察结果。
<|im_start|>systemA chat between a curious user and an artificial intelligence assistant. The assistant gives helpful, detailed, and polite answers to the user’s questions.The assistant can interact with an interactive Python (Jupyter Notebook) environment and receive the corresponding output when needed. The code should be enclosed using "<execute>" tag, for example: <execute> print("Hello World!") </execute>.The assistant should attempt fewer things at a time instead of putting too much code in one <execute> block. The assistant can install packages through PIP by <execute> !pip install [package needed] </execute> and should always import packages and define variables before starting to use them.The assistant should stop <execute> and provide an answer when they have already obtained the answer from the execution result. Whenever possible, execute the code for the user using <execute> instead of providing it.The assistant’s response should be concise, but do express their thoughts.<|im_end|>
2.2CodeAct展现出作为强大工具使用框架的潜力
在本节中,我们进行了一项受控实验,以了解哪种格式(文本、JSON、CodeAct)更有可能使 LLM 生成正确的原子工具调用。此实验中的表现反映了LLM对相应格式的熟悉程度。我们假设使用CodeAct调用工具是使用模型的工具的更自然的方式,因为模型通常在训练期间会大量接触代码数据。
**设置。**我们重新利用API-Bank并测试LLM的API调用性能,比较CodeAct、JSON和文本操作。对于每个评估实例,我们指示LLM以预定义格式的Python函数调用、JSON对象或文本表达式的格式生成一个原子工具调用。具体示例如下表所示。我们使用 API-Bank 的1级指令和提供的工具集。为了评估API 调用,我们遵循它们的正确性指标,将真实的API输出与实际模型生成的 API 的执行输出进行匹配。
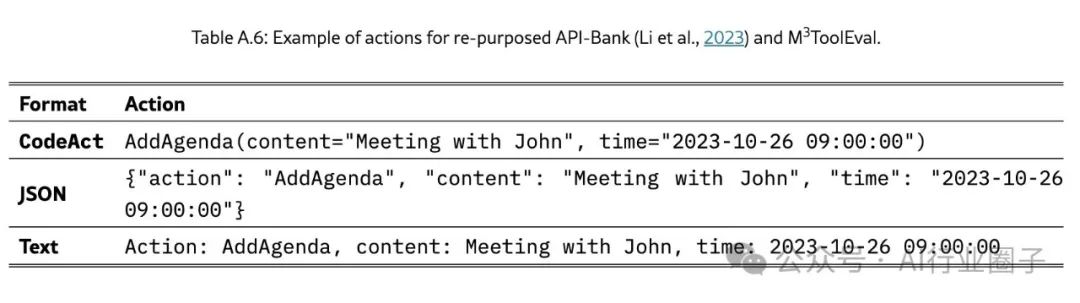
结果。我们在表3中展示了结果。对于大多数LLM,即使在原子操作(简单的工具使用场景)中,CodeAct也能实现相当或更好的性能,此时其控制和数据流的优势被削弱。与闭源LLM相比,CodeAct在开源模型中的改进更为突出。此外,与专门的JSON或文本工具调用格式相比,代码数据通常更易于访问,可用于微调开源LLM。尽管JSON对于开源模型来说始终弱于其他方法,但它在闭源 LLM 中实现了不错的性能,这表明这些闭源模型可能已经针对其JSON 功能进行了有针对性的微调。这些结果表明,与其他方法相比,针对CodeAct进行优化是开源LLM 提高其工具使用能力的更好途径,因为它们已经表现出良好的初始CodeAct能力,这是由于在预训练期间大量接触代码数据所致。
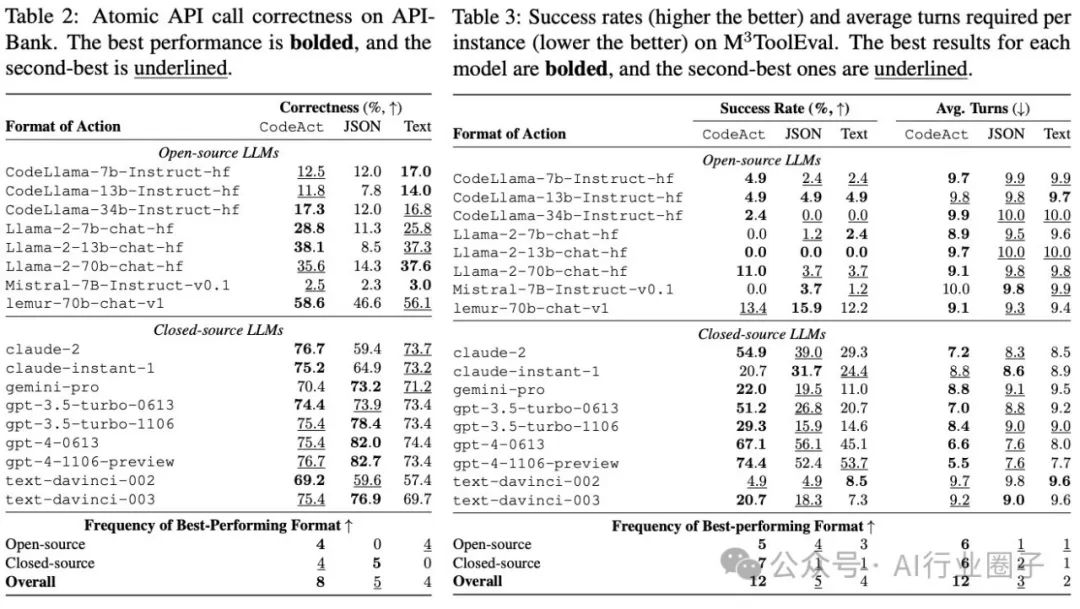
表 2: API-Bank 上的原子 API 调用正确性。
2.3CodeAct通过更少的交互完成更多工作
在本节中,我们研究LLM代理是否可以从需要复杂工具使用模式的问题的代码控制和数据流中受益。
**M3ToolEval。**如表A.7所示,据我们所知,现有的工具使用基准测试中没有一个包含需要组合多种工具的复杂任务,同时支持评估不同的操作格式。因此,我们策划了一个基准测试M3ToolEval来填补这一空白,它评估了LLM 解决复杂任务的能力,这些任务通常需要在多轮交互中多次调用多个工具。它包含82个人工策划的实例,涵盖网页浏览、金融、旅行行程规划、科学和信息处理等任务。每个领域都伴随着一组独特的手工制作的工具。我们有意保持提示简单,并避免提供任何演示来测试LLM使用工具的零样本能力,类似于不了解小样本提示的新手用户使用该模型的方式。
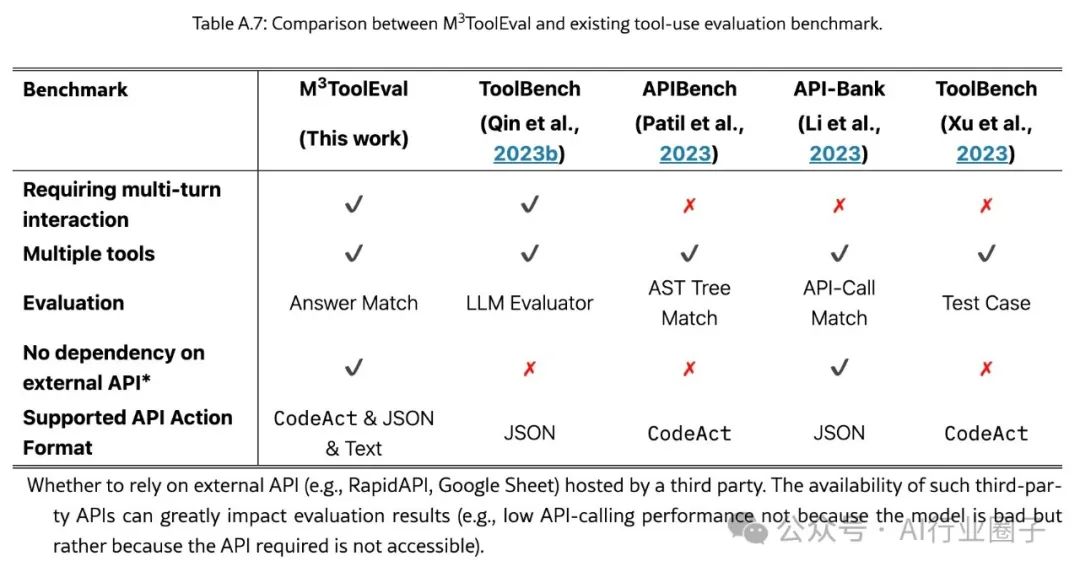
**设置。**我们允许模型生成功能齐全的Python代码,以支持控制和数据流(例如if语句、for循环)。我们遵循下表中描述的JSON和文本的操作格式。在每个回合中,模型可以发出一个操作或提出一个答案,通过与地面实况解决方案的精确匹配进行验证。当达到最多10个交互回合或提交了正确的解决方案时,交互将终止。
**指标。**我们通过计算模型提出的答案与真实解决方案相匹配的百分比来衡量成功率。我们还包括平均Turn(转弯)指标:所有评估实例的平均Turn(转弯)次数。
M3ToolEval的定量结果。 我们在表3中包含了完整结果,并在图1中包含了可视化结果的子集。CodeAct通常具有更高的任务成功率(在评估的 17个LLM 中12个),类似于2.2中的趋势。此外,使用CodeAct需要的平均Turn(转弯)次数较低(在评估的17 个LLM 中12 个)。例如,最佳模型gpt-4-1106-preview实现了20.7与下一个最佳行动格式(文本)相比,绝对改进百分比,同时要求2.1平均交互次数更少。然而,开源和闭源 LLM 的绝对CodeAct性能之间仍然存在显著差距,最佳开源模型达到13.4%,而最佳闭源模型gpt-4-1106-preview达到 74.4%。这可能是由于开源模型的任务解决能力较弱,无法在没有演示的情况下遵循复杂的指令,这表明迫切需要改进开源 LLM 以适应零样本设置下的实际现实任务。
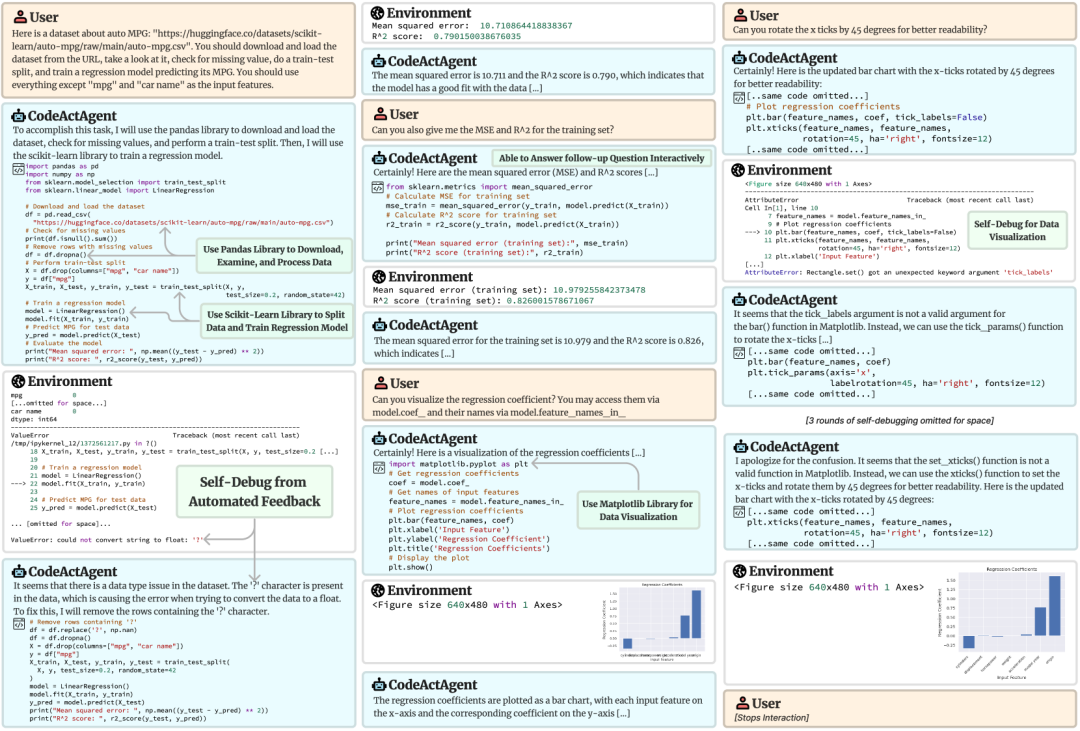
图3:使用 CodeActAgent (Mistral-7b) 与 Python 包进行多轮交互的示例。模型中没有提供上下文演示。为节省空间,省略了一些消息。有关完整交互, 请参阅https://chat.xwang.dev/r/Vqn108G 。
2.4CodeAct受益于多轮交互和现有软件包
在图 3中,我们展示了LLM代理如何与 Python 集成(即我们3.2中训练的CodeActAgent),并使用现有软件在多轮交互中执行复杂任务。得益于在预训练期间学习到的丰富Python知识,LLM代理可以自动导入正确的Python库来解决任务,而无需用户提供的工具或演示。如图3所示,CodeActAgent可以使Pandas下载和处理表格数据,使用 Scikit-Learn进行机器学习训练测试数据拆分和回归模型训练,并使用 Matplotlib进行数据可视化。此外,使用交互式Python解释器执行代码可以自动显示错误消息,帮助 LLM 代理在多轮交互中“自我调试”其操作,并最终正确完成人类用户的请求。
3赋能开源 LLM Agent 更好地服务CodeAct
CodeAct取得的良好结果激励我们构建一个开源LLM代理,它既可以通过CodeAct与环境交互,也可以使用语言与人类交流。为了提高开源 LLM 的CodeAct能力,在3.1中,我们引入了CodeActInstruct,这是一个包含代理-环境交互轨迹的指令微调数据集。我们在3.1中讨论了数据选择程序,以促进交互行为的改进。此外,我们表明CodeAct可以与现有的代理-用户对话数据(4)一起使用,以平衡生成的 LLM 的对话能力。我们的模型CodeActAgent是从LLaMA-2和Mistral-7B在 CodeActInstruct和一般对话的混合上运行,提高了CodeAct 的性能,同时又不损害 LLM 在多种任务上的总体性能 (3.2)。
3.1CodeActInstruct:代理与环境交互
我们考虑了代理与环境交互中的四个主要用例,并重新利用不同领域的五个现有数据集来生成轨迹:
-
**信息搜索:**我们使用HotpotQA的训练子集生成信息搜索轨迹,其中LLM使用wikipedia_search API(作为Python函数提供)来搜索信息来回答问题。
-
**软件包(工具)使用:**我们使用APPS中的代码生成问题训练集和数学问题。代码生成任务已经涉及导入包和/或通过定义新的Python 函数创建新工具。对于MATH,我们提供了导入Python包(例如用于符号数学的sympy)以解决问题的上下文演示。
-
**外部记忆:**我们重新利用了WikiTableQuestion的训练子集并将其调整为两种需要访问外部存储器的表格推理任务: (1) 基于SQL,要求 LLM 通过sqlite3包与SQL数据库交互,通过SQL执行来回答问题; (2) 基于Pandas,要求模型与pandas表交互以执行数据操作(例如,选择、过滤)。
-
**机器人规划:**我们使用 ALFWorld,一个纯文本的具身环境模拟器,用于生成使用机器人控制API(重新用作Python函数)完成家务的轨迹。遵循 MINT, 我们提供了上下文演示,以鼓励使用for循环和if语句代码块来自动执行重复操作(例如,通过访问不同的位置来搜索项目)。
数据下采样。 我们通过仅保留最具挑战性的实例来对每个数据集进行下采样,旨在使轨迹生成更加高效和经济高效。此外,它还有助于删除现有 LLM 已经可以解决的简单实例。过滤后的数据集的统计数据可以在下表中找到。
有关下采样过程的详细信息如下。
• APPS 中的代码生成任务: 我们删除没有任何可用测试用例的实例。
• WikiTableQuestion 中的表格推理任务: 我们从原始数据集(14149个实例)中选取表格大小最大的3000个实例子集(即按行数和列数排序),并随机分配其中1500个作为基于pandas的问题,其余1500个作为基于SQL的问题。
• HotpotQA 中的网页搜索任务: 我们从原始数据集(有 90447 个实例)中选择了 15661 个标记为“难”的问题,然后随机将它们下采样为 3000 个问题。
• 数学推理: 我们删除了注释难度低于3的问题,得到5586个实例,如下表所示。
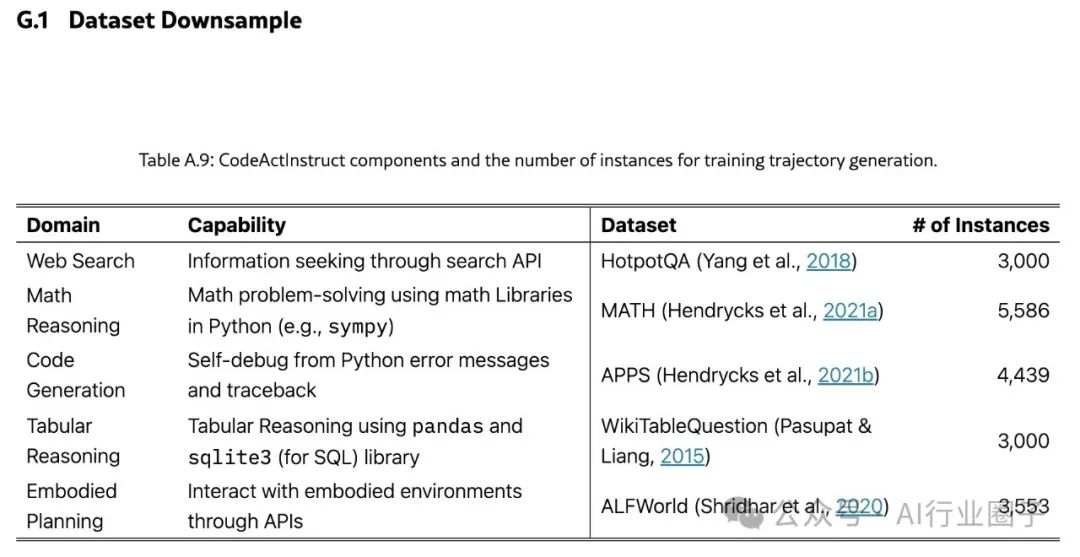
• ALFWorld 中的具体规划: 我们没有对AlfWorld进行下采样。
**重新利用数据进行多轮交互。**一些数据集(APPS、MATH、WikiTableQuestions)最初是单轮问题,每个指令需要一个解决方案,而在实际的代理用例中,我们通常需要多轮交互来完成每个任务(图1顶部)。遵循 MINT,我们将单轮问题重新设计为多轮问题,允许 LLM与环境交互多轮,然后再决定提交一个解决方案进行评估。具体来说,对于代码生成问题,我们提供了一个上下文示例,以指导LLM在提交解决方案之前在提供的测试用例上测试他们的解决方案。来自原始数据的指标将评估提交的解决方案以确定其正确性。
轨迹生成。 我们使用MINT的评估框架为上述数据集生成交互轨迹并确定每条轨迹的正确性。我们在下采样数据上运行来自OpenAI的GPT-3.5-turbo-0613、来自Anthropic的claude-1-instant和claude-2,除了代码生成之外,我们使用GPT-3.5的更长上下文版本 (GPT-3.5-turbo-0613-16k),因为自调试过程需要长上下文。在这些模型都无法解决的一组问题上,我们使用GPT-4-0613来生成轨迹。
**增强代理通过交互进行改进的能力。**我们从CodeActInstruct中挑选出所有生成轨迹的高质量子集,以提升代理基于先前观察改进下一步行动的能力(例如,从代码执行错误消息中进行自我调试,这是图2中的规划能力)。为了实现这一点,我们有选择地保留那些模型最初遇到错误但在以后的交互中纠正这些不准确的轨迹。对于这些情况,LLM 通常会在初始错误之后进行自我反思,从而主动增强其未来的行动。
给定具有超过2个回合的成功任务解决轨迹,我们应用以下启发式方法来选择可以促进LLM代理的代码即动作、自我完善和指令遵循能力的实例:
• 代码即操作: 我们排除LLM代理不遵守代码即操作框架的轨迹,这可能是由于API调用不正确或生成的操作格式不适合解析和执行。
• **自我改进:**我们选择性地保留那些模型最初遇到错误但随后在后续交互中纠正这些不准确的轨迹。此外,我们消除了在所有代码执行中都只产生错误的成功轨迹。这些被视为无效的演示,因为我们的目标是防止模型学习持续执行错误代码,同时仍设法提供正确答案。
• **遵循指令:**我们删除了LLM代理无法遵循指令并响应用户的罕见情况,通过奇数个交互轮次来识别。
在所有生成的轨迹中,我们保留了来自gpt-4-0613的411 条轨迹和来自gpt-3.5 和claude 的 6728 条轨迹。结果数据集CodeActInstruct 的统计数据如表4所示 。
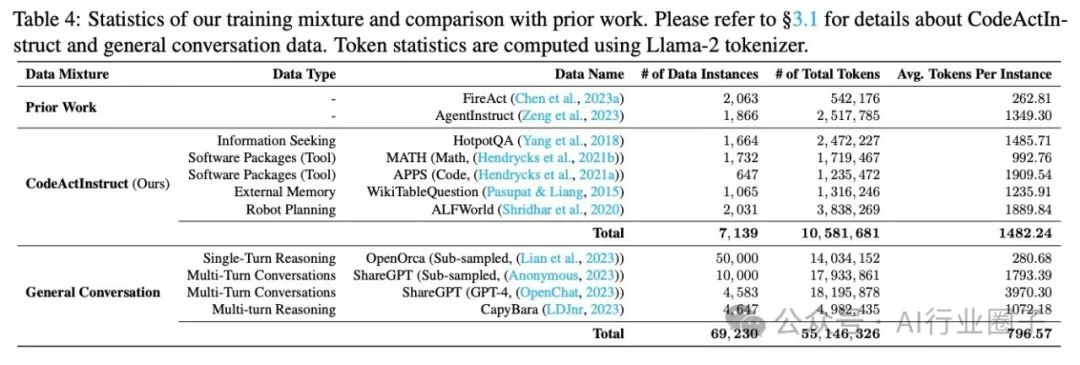
表4:我们的训练混合统计数据以及与之前工作的比较。
**将CodeActInstruct与先前的工作进行比较。**与先前的工作 AgentInstruct相比主要关注使用文本作为动作,而CodeActInstruct 产生的模型在实际实现中更实用,因为使用CodeAct的模型可以直接与 Python解释器和开源工具包交互(图3),减少了动作解析和工具创建的开发工作量。CodeActInstruct是按照通用代理框架(图 2)系统地构建的。它涵盖了不同的领域(例如,与仅考虑QA任务和搜索 API 的 FireAct相比),包含高质量数据(例如,提升代理的自我调试能力)并且规模更大(与表4中的AgentInstruct/FireAct相比,数据轨迹多3.8 倍/3.5倍,标记多5倍/19倍)。正如我们在表5中通过经验显示的那样,与AgentInstruct和FireAct相比,CodeActInstruct的结果模型(相同主干)实现了24%和119%的相对改进。
CodeActInstruct可与现有的代理-用户对话数据一起使用。 我们使用 OpenOrca的子采样集专注于单轮思维链 (CoT) 推理,ShareGPT来自两个包含人类与 LLM 之间的多轮对话的来源,以及 CapyBara专注于多轮对话中的推理。统计数据和以下采样细节可在下列信息中找到。
• ShareGPT: 我们删除所有单轮对话,然后进行随机子采样以获得所需的最终数字。
• ShareGPT (GPT-4) (OpenChat) : 我们不对该数据集进行子采样。
• OpenOrca: 我们选择 OpenOrca 的 CoT 子集,然后执行随机子采样以得到所需的最终数字。
• CapyBara: 我们不对该数据集进行子采样。
3.2****CodeActAgent
我们微调 Llama-2 7B和 Mistral7B在CodeActInstruct 和一般对话的混合体上(表4)得到 CodeActAgent。
**训练设置。**我们对 Llama-2 的序列长度为 4,096 个标记,对 Mistral 的序列长度为 16,384 个标记,进行全参数监督微调。
实验细节如下:
所有SFT实验均在一个4xA100 40GB SXM节点上使用 Megatron-LLM 的一个分支训练吞吐量约为每秒9k个token。我们对所有多轮数据使用chatML格式,并且只计算和优化助手响应的损失。我们将短实例打包成较长的实例,并应用flash注意力来提高训练效率。
我们训练 LLaMA-2 和 Mistral LLM,张量并行度为4,学习率为1e-5,warmup步骤为 50,余弦衰减(最终学习率为1e-6)。我们训练 5 个 epoch,批处理大小为 32。我们对所有实验都使用第 3 个 epoch 检查点。
评估设置。 我们使用 MINT评估LLM与CodeAct在各种代理任务上的表现。CodeActAgent有一些训练领域与MINT的评估重叠(即 MINT 包括ALFWorld和MATH),因此我们分别报告MINT在域内和域外的表现。除非另有说明,否则我们用交互回合来衡量 MINT 任务的成功率钾=5我们还使用MiniWob++中的文本操作来评估域外代理任务(计算机任务) 和ScienceWorld (基于文本的小学科学课程模拟器) 来测试 CodeActAgent是否可以推广到不同的动作格式。最后,我们包括一套通用的 LLM 评估任务来评估通用能力:MMLU用于基于知识的问答,HumanEval用于单圈代码生成,GSM8K用于单转免工具数学推理,以及 MTBench来遵循指令。
CodeActAgent在CodeAct任务中表现出色。如下表5所示,CodeActAgent(两种变体)在 MINT 的域内和域外子集上的表现均优于所有评估过的开源LLM。在M3ToolEval上,我们发现 CodeActAgent (Mistral) 的表现优于类似规模(7B和13B)的开源 LLM,甚至达到与70B 模型相近的性能(表3)。令人惊讶的是,Llama-2 变体没有出现任何改进(有可能是训练数据潜在的影响)。
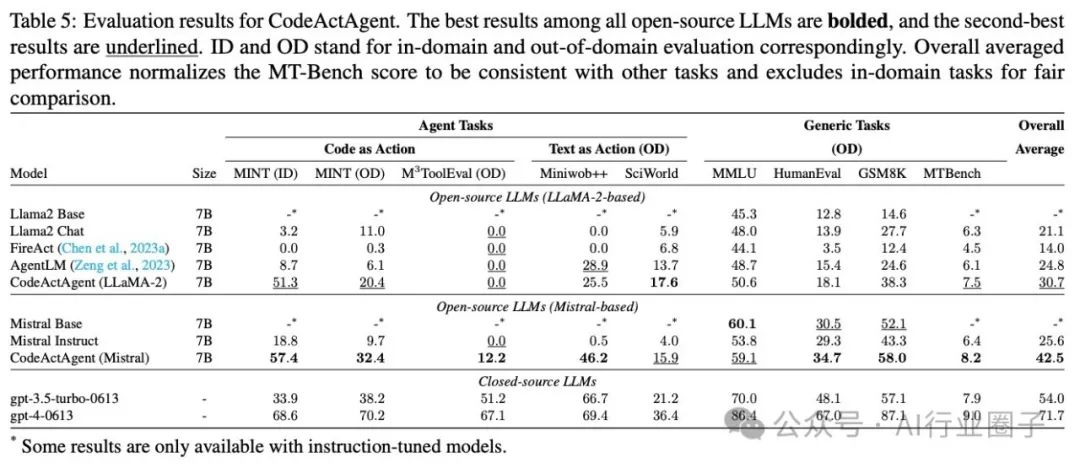
CodeActAgent 泛化至文本操作。 在对域外文本操作进行评估时,从未针对文本操作进行优化的CodeActAgent (LLaMA2, 7B) 实现了与 AgentLM-7B对文本操作进行了明确的调整。
CodeActAgent 保持或提高了一般LLM任务的性能。 在表5中,我们发现CodeActAgent(两种变体)在我们测试的一般LLM任务上表现更好,但CodeActAgent(Mistral7B)在MMLU上略有下降。
**消融研究(**Ablation Study)。 表A.8展示了消融实验,以确定 CodeActInstruct 和一般对话的重要性。CodeActInstruct和一般对话都有助于代理任务,而一般对话对于维持一般任务的性能至关重要。
4相关工作
4.1LLM 代理中的动作模块
基于 LLM 的自主代理通常围绕四个组件构建:定制配置文件**、长期记忆能力****、推理和规划算法****,以及最重要的行动模块**。行动模块在环境中是促进 LLM 代理与外部实体(包括人类)有效交互的关键和工具。在本研究中,我们解决了标准化LLM代理动作空间的关键问题。CodeAct与先前研究之间的根本区别促使 LLM 生成用于解决问题的代码。现有研究已经探索了在不同领域使用代码生成来解决任务,例如 Code4Struct进行结构化预测,PaL进行数学推理,Meta-GPT用于多智能体协作、代码即策略用于机器人控制,ViperGPT用于视觉问答,Voyager用于玩游戏,Data Interpreter用于数据科学任务等。
我们注意到一项同时进行的研究 TaskWeaver同样赞同使用代码。(TaskWeaver 值得表扬,因为它首次将代码集成到 LLM 代理的动作空间中,而CodeAct明确量化了 LLM 代理内代码操作的好处,引入了一个独特的指令调整数据集CodeActInstruct,专门用于增强代理执行基于代码的操作的能力,以及一个开源 LLM 代理CodeActAgent重新定义了 LLM 代理在实际应用中的潜力。)
4.2改进 LLM 代理
增强 LLM 代理的两种主要方法是快速工程和指令调整,正如下图中的论文快速工程, 已经引入了许多策略来改进Cot思维链推理,包括基于自我一致性的推理和基于树的方法。此外,LLM可以策略性地反思以前的计划,使他们能够通过反复试验来改进初始操作。与快速工程相比,指令调整本质上增强了LLM,特别是在其代理能力方面,为了进行有效的训练,人类注释者可以为特定的代理任务策划专家演示。为了最大限度地减少人工注释工作,先前的研究使用更强大的 LLM 创建合成数据集,将代理功能提炼到本地模型中,重点关注工具的使用、相互作用和社交技能。CodeActInstruct与后一种方法一致,并使用更强大的 LLM 创建数据集。
5结论
本研究引入了CodeAct,它使用可执行Python代码执行LLM代理的操作,这比使用文本或JSON操作更具优势,尤其是在复杂场景中。我们收集以CodeAct为中心的多轮交互轨迹 CodeActInstruct以进行指令调整,并训练专门设计用于与Python无缝集成的CodeActAgent,它可以利用现有的Python包执行复杂的任务(例如模型训练)并通过自我调试自动纠正错误。
如何学习大模型 AI ?
由于新岗位的生产效率,要优于被取代岗位的生产效率,所以实际上整个社会的生产效率是提升的。
但是具体到个人,只能说是:
“最先掌握AI的人,将会比较晚掌握AI的人有竞争优势”。
这句话,放在计算机、互联网、移动互联网的开局时期,都是一样的道理。
我在一线互联网企业工作十余年里,指导过不少同行后辈。帮助很多人得到了学习和成长。
我意识到有很多经验和知识值得分享给大家,也可以通过我们的能力和经验解答大家在人工智能学习中的很多困惑,所以在工作繁忙的情况下还是坚持各种整理和分享。但苦于知识传播途径有限,很多互联网行业朋友无法获得正确的资料得到学习提升,故此将并将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。

第一阶段(10天):初阶应用
该阶段让大家对大模型 AI有一个最前沿的认识,对大模型 AI 的理解超过 95% 的人,可以在相关讨论时发表高级、不跟风、又接地气的见解,别人只会和 AI 聊天,而你能调教 AI,并能用代码将大模型和业务衔接。
- 大模型 AI 能干什么?
- 大模型是怎样获得「智能」的?
- 用好 AI 的核心心法
- 大模型应用业务架构
- 大模型应用技术架构
- 代码示例:向 GPT-3.5 灌入新知识
- 提示工程的意义和核心思想
- Prompt 典型构成
- 指令调优方法论
- 思维链和思维树
- Prompt 攻击和防范
- …
第二阶段(30天):高阶应用
该阶段我们正式进入大模型 AI 进阶实战学习,学会构造私有知识库,扩展 AI 的能力。快速开发一个完整的基于 agent 对话机器人。掌握功能最强的大模型开发框架,抓住最新的技术进展,适合 Python 和 JavaScript 程序员。
- 为什么要做 RAG
- 搭建一个简单的 ChatPDF
- 检索的基础概念
- 什么是向量表示(Embeddings)
- 向量数据库与向量检索
- 基于向量检索的 RAG
- 搭建 RAG 系统的扩展知识
- 混合检索与 RAG-Fusion 简介
- 向量模型本地部署
- …
第三阶段(30天):模型训练
恭喜你,如果学到这里,你基本可以找到一份大模型 AI相关的工作,自己也能训练 GPT 了!通过微调,训练自己的垂直大模型,能独立训练开源多模态大模型,掌握更多技术方案。
到此为止,大概2个月的时间。你已经成为了一名“AI小子”。那么你还想往下探索吗?
- 为什么要做 RAG
- 什么是模型
- 什么是模型训练
- 求解器 & 损失函数简介
- 小实验2:手写一个简单的神经网络并训练它
- 什么是训练/预训练/微调/轻量化微调
- Transformer结构简介
- 轻量化微调
- 实验数据集的构建
- …
第四阶段(20天):商业闭环
对全球大模型从性能、吞吐量、成本等方面有一定的认知,可以在云端和本地等多种环境下部署大模型,找到适合自己的项目/创业方向,做一名被 AI 武装的产品经理。
- 硬件选型
- 带你了解全球大模型
- 使用国产大模型服务
- 搭建 OpenAI 代理
- 热身:基于阿里云 PAI 部署 Stable Diffusion
- 在本地计算机运行大模型
- 大模型的私有化部署
- 基于 vLLM 部署大模型
- 案例:如何优雅地在阿里云私有部署开源大模型
- 部署一套开源 LLM 项目
- 内容安全
- 互联网信息服务算法备案
- …
学习是一个过程,只要学习就会有挑战。天道酬勤,你越努力,就会成为越优秀的自己。
如果你能在15天内完成所有的任务,那你堪称天才。然而,如果你能完成 60-70% 的内容,你就已经开始具备成为一名大模型 AI 的正确特征了。
这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】

 1174


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


