Vision-Language Models(VLM)在机器人导航中的应用:近期佳文赏析

51c自动驾驶~合集57 多目标多头蒸馏模块:我们看到轨迹模仿学习之后的轨迹还过了其他的MLP,这就是其他头,它的目标也是不一样的,第一个是跟碰撞相关的,第二个是跟行驶区域相关的,第三个是跟舒适度相关的,也就是说不同的评判指标都有一个teacher,之前的模仿学习就是人类的teacher,那么这些teacher是怎么来的呢?本文作者提出的新的范式,就是规划模块是多模的输出,同时,目标也是多样性的,即不仅是GT的轨迹也同时引入了更多的正样本,由不同的专家给出的。还是那句话,小米汽车的成功,是小米价值观,小米模式,和小米方法论的成功。 阅读详情

摘要

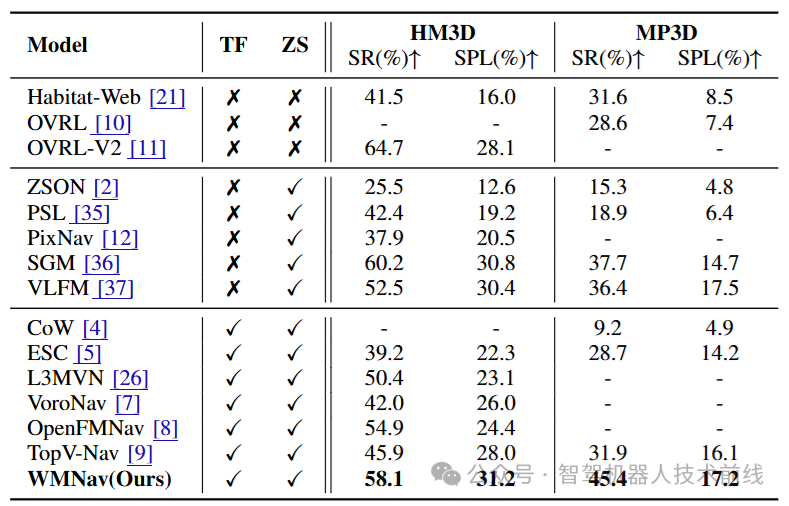
​ 目标导向导航要求智能体在陌生环境中定位特定对象,这始终是具身AI的核心挑战。尽管基于视觉语言模型(VLM)的智能体通过提示机制展现出优异的感知与决策能力,但尚未出现能通过预测世界未来状态来减少环境交互风险与成本的模块化世界模型设计。我们提出WMNav——一个由视觉语言模型驱动的创新型世界模型导航框架,它能预测决策可能结果并构建记忆反馈给策略模块。为保持环境预测状态,WMNav创新性地提出在线维护的好奇价值地图作为世界模型记忆组件,为导航策略提供动态配置。通过类人思维过程的分解决策,基于世界模型规划与观测反馈的差异有效缓解了模型幻觉的影响。为提升效率,我们采用两阶段动作提议策略:先广泛探索后精确定位。在HM3D和MP3D数据集上的大量实验表明,WMNav在成功率和探索效率上均超越现有零样本基准(绝对提升:HM3D上+3.2%SR和+3.2%SPL,MP3D上+13.5%SR和+1.1%SPL)。

算法框架与部分实验

  • 算法框架

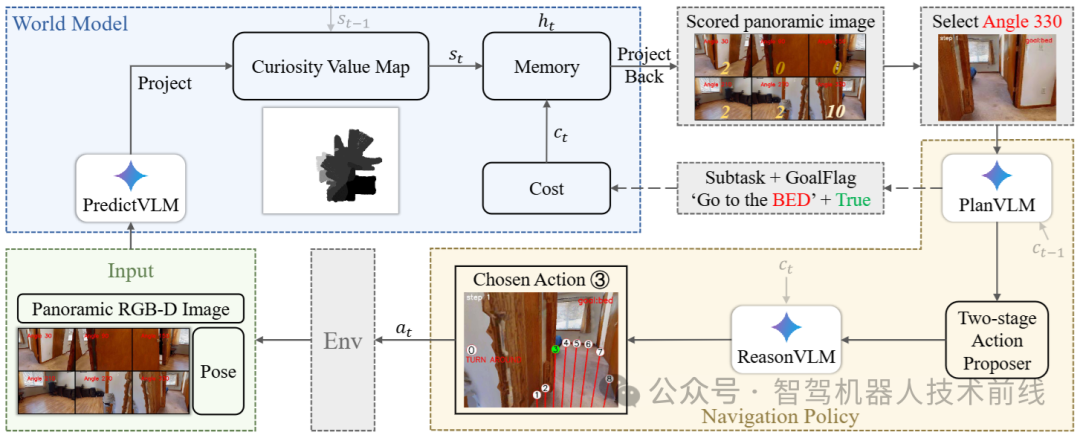
​ WMNav框架如图所示。全景理解是实现全面感知的关键。为此,智能体进行一系列旋转****并捕获六张不同的RGB-D图像,这些图像被转换为全景图像 。在我们的框架中,世界模型由PredictVLM和由好奇心价值图与成本构建的记忆组成。该世界模型不接收来自环境的实际奖励信号,这意味着它仅用于预测和简化环境的未来状态。PredictVLM定量预测目标出现在各个方向的概率,并将分数从全景图像投影到俯视地图上。该地图随后与上一步的好奇心价值图融合并存入记忆。之后,好奇心分数被重新投影到全景图像上,选择得分最高的方向并发送至导航策略模块。导航策略模块可获取环境提供的奖励信息。对于策略模块中的PlanVLM和ReasonVLM,使用成本(上一步的子任务和目标标志)来配置其提示,从而优化整个策略模块的动作输出,无需对VLMs进行任何微调。
img

The WMNav framework.

  • 部分实验结果

img

HM3D v0.1[34]与MP3D[18]基准测试中的零样本物体导航结果。TF表示免训练,ZS表示零样本
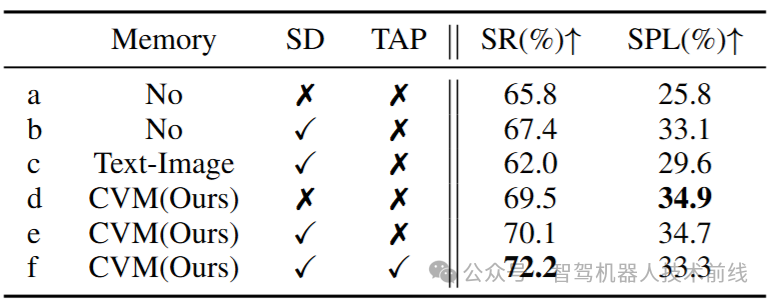
img

HM3D v0.2[34]上不同模块与记忆策略的消融研究。SD表示子任务分解,TAP表示两阶段动作提议策略,No表示无记忆模块,Text-Image表示文本-图像记忆,CVM表示好奇心价值地图。

总结

​ 我们提出的WMNav系统为未知环境中的目标导航开辟了新方向,通过在世界模型框架中运用视觉语言模型(VLM),显著提升了零样本目标导航(ZSON)性能。该方法采用在线好奇心价值地图定量预测目标存在概率,解决了往返冗余移动导致的效率低下问题。子任务分解模块为基于提示的策略优化提供了更密集的奖励。此外,两阶段动作提议策略实现了更具目的性的导航和高效探索。通过构建基于VLM的世界模型架构、简洁的记忆地图和任务分解机制,WMNav为ZSON任务指明了新的优化方向,为具身机器人与环境交互开辟了新途径。

Vi-LAD:面向动态环境社会感知机器人导航的视觉-语言注意力蒸馏方法

论文信息

  • **标题******:Vi-LAD: Vision-Language Attention Distillation for Socially-Aware Robot Navigation in Dynamic Environments**
  • **作者******:Mohamed Elnoor, Kasun Weerakoon, Gershom Seneviratne, Jing Liang, Vignesh Rajagopal, and Dinesh Manocha**
  • **单位******:马里兰大学帕克分校**
  • **项目地址******:https://gamma.umd.edu/researchdirections/crowdmultiagent/vilad/**

摘要

​ **本文提出视觉-语言注意力蒸馏(Vi-LAD),这是一种从大型视觉语言模型(VLM)中提取社会合规导航知识,并将其蒸馏到轻量级Transformer模型中以实现实时机器人导航的新方法。与传统依赖专家示范或人工标注数据集的方法不同,Vi-LAD通过利用预训练视觉动作模型的主干网络,在中间层表示(即注意力图)层面进行知识蒸馏与微调。这些注意力图能突出场景中的关键导航区域,为社会感知运动规划提供隐式指导。Vi-LAD通过融合从预训练视觉动作模型提取的中间注意力图与大型VLM构建的类注意力语义图,对基于Transformer的模型进行微调。为此,我们提出新型注意力级蒸馏损失函数,融合双源知识生成具有增强社会感知能力的强化注意力图。这些优化后的注意力图随后被用作社会感知模型预测控制器(MPC)**中的可通行性代价地图进行导航。我们在Husky轮式机器人上的真实实验验证了该方法,相较最先进(SOTA)导航方法取得显著提升,成功率最高提升14.2%−50%,彰显了Vi-LAD在实现社会合规且高效机器人导航方面的有效性。

算法框架与部分实验

  • 算法框架

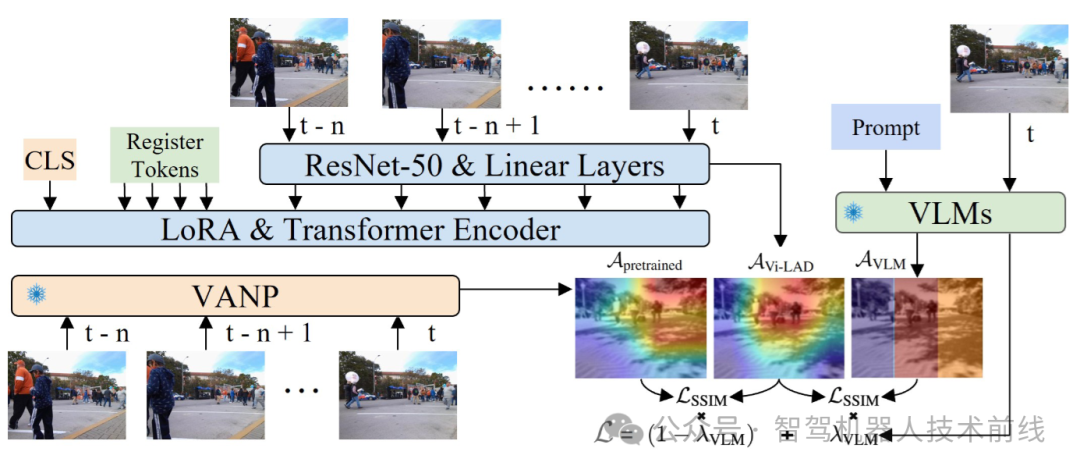
​ 我们通过提取VANP[13]和大型视觉语言模型(VLM)的注意力图(而非端到端蒸馏或微调)来提炼社会导航知识。这些从图像编码器中间层提取的注意力图突出社会合规导航的关键区域。Vi-LAD采用结构相似性指数损失(SSIL),有效蒸馏VANP中间注意力层和大型VLM预测注意力图的信息,确保导航感知对齐增强。
img

System architecture of Vi-LAD.

  • 部分实验结果

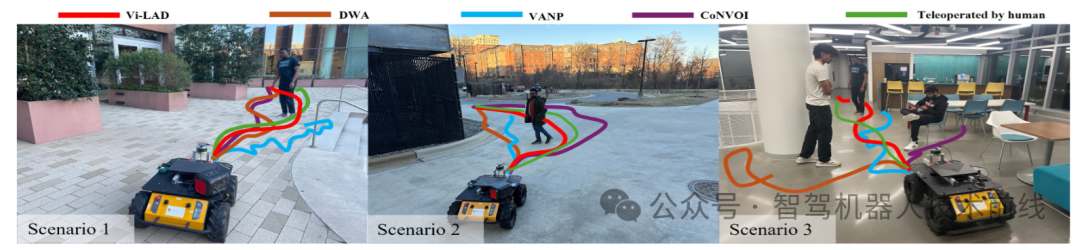
img

需考虑行人运动方向的复杂社交导航场景中的机器人轨迹。本方法基于蒸馏注意力图识别环境中智能体的动态运动与导航意图,从而规划出更符合社会规范且不干扰其他智能体的行进路线。例如场景1中DWA和CoNVOI未能预判运动趋势,场景2中VANP和DWA同样存在此缺陷。
img

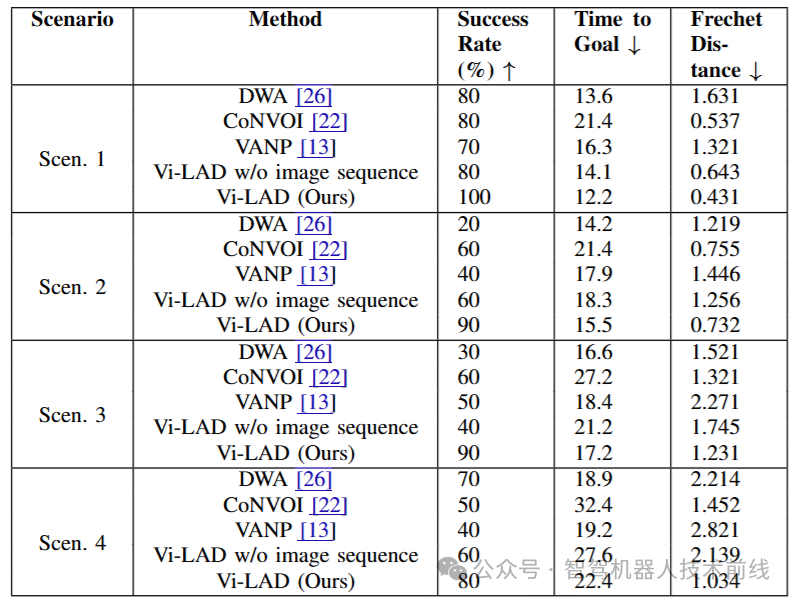
本表呈现了10次试验中各种导航方法的量化结果。为评估性能,我们采用四项导航指标,这些指标按成功与失败试验(无论是否到达目标点)的平均值计算。

总结

​ 我们提出Vi-LAD,一种新颖的视觉语言注意力蒸馏方法,通过将大型视觉语言模型(VLMs)的知识蒸馏到轻量级基于transformer的模型中,实现符合社会规范且实时的机器人导航。借助注意力图级别的蒸馏,Vi-LAD有效整合了预训练视觉动作模型和VLM的社会导航推理能力,确保高效自适应的运动规划。在Husky机器人上的实际实验表明,我们的方法相较前沿技术(SOTA)有显著提升,成功率更高且轨迹更接近人类遥控操作。然而,虽然我们的注意力引导MPC规划器增强了社会合规性,但在高度拥挤场景可能需要进一步调参。未来工作将探索融合深度和激光雷达等多模态信息的预训练模型以增强空间感知与鲁棒性,研究实时优化的在线适应策略,并扩展至复杂环境中的长程导航。

如何学习大模型 AI ?

由于新岗位的生产效率,要优于被取代岗位的生产效率,所以实际上整个社会的生产效率是提升的。

但是具体到个人,只能说是:

“最先掌握AI的人,将会比较晚掌握AI的人有竞争优势”。

这句话,放在计算机、互联网、移动互联网的开局时期,都是一样的道理。

我在一线互联网企业工作十余年里,指导过不少同行后辈。帮助很多人得到了学习和成长。

我意识到有很多经验和知识值得分享给大家,也可以通过我们的能力和经验解答大家在人工智能学习中的很多困惑,所以在工作繁忙的情况下还是坚持各种整理和分享。但苦于知识传播途径有限,很多互联网行业朋友无法获得正确的资料得到学习提升,故此将并将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。

在这里插入图片描述

第一阶段(10天):初阶应用

该阶段让大家对大模型 AI有一个最前沿的认识,对大模型 AI 的理解超过 95% 的人,可以在相关讨论时发表高级、不跟风、又接地气的见解,别人只会和 AI 聊天,而你能调教 AI,并能用代码将大模型和业务衔接。

  • 大模型 AI 能干什么?
  • 大模型是怎样获得「智能」的?
  • 用好 AI 的核心心法
  • 大模型应用业务架构
  • 大模型应用技术架构
  • 代码示例:向 GPT-3.5 灌入新知识
  • 提示工程的意义和核心思想
  • Prompt 典型构成
  • 指令调优方法论
  • 思维链和思维树
  • Prompt 攻击和防范
  • …

第二阶段(30天):高阶应用

该阶段我们正式进入大模型 AI 进阶实战学习,学会构造私有知识库,扩展 AI 的能力。快速开发一个完整的基于 agent 对话机器人。掌握功能最强的大模型开发框架,抓住最新的技术进展,适合 Python 和 JavaScript 程序员。

  • 为什么要做 RAG
  • 搭建一个简单的 ChatPDF
  • 检索的基础概念
  • 什么是向量表示(Embeddings)
  • 向量数据库与向量检索
  • 基于向量检索的 RAG
  • 搭建 RAG 系统的扩展知识
  • 混合检索与 RAG-Fusion 简介
  • 向量模型本地部署
  • …

第三阶段(30天):模型训练

恭喜你,如果学到这里,你基本可以找到一份大模型 AI相关的工作,自己也能训练 GPT 了!通过微调,训练自己的垂直大模型,能独立训练开源多模态大模型,掌握更多技术方案。

到此为止,大概2个月的时间。你已经成为了一名“AI小子”。那么你还想往下探索吗?

  • 为什么要做 RAG
  • 什么是模型
  • 什么是模型训练
  • 求解器 & 损失函数简介
  • 小实验2:手写一个简单的神经网络并训练它
  • 什么是训练/预训练/微调/轻量化微调
  • Transformer结构简介
  • 轻量化微调
  • 实验数据集的构建
  • …

第四阶段(20天):商业闭环

对全球大模型从性能、吞吐量、成本等方面有一定的认知,可以在云端和本地等多种环境下部署大模型,找到适合自己的项目/创业方向,做一名被 AI 武装的产品经理。

  • 硬件选型
  • 带你了解全球大模型
  • 使用国产大模型服务
  • 搭建 OpenAI 代理
  • 热身:基于阿里云 PAI 部署 Stable Diffusion
  • 在本地计算机运行大模型
  • 大模型的私有化部署
  • 基于 vLLM 部署大模型
  • 案例:如何优雅地在阿里云私有部署开源大模型
  • 部署一套开源 LLM 项目
  • 内容安全
  • 互联网信息服务算法备案
  • …

学习是一个过程,只要学习就会有挑战。天道酬勤,你越努力,就会成为越优秀的自己。

如果你能在15天内完成所有的任务,那你堪称天才。然而,如果你能完成 60-70% 的内容,你就已经开始具备成为一名大模型 AI 的正确特征了。

这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】

在这里插入图片描述

【具身智能】RT-2:视觉-语言-动作模型(VLA) Robotic Transformer 2(RT-2)是由谷歌 DeepMind 新推出的大语言模型,它为人类提供了通过纯语言命令来优化机器人控制的能力。与此前的大模型不同,RT-2是一种新型的视觉-语言-动作(VLA)模型,它可以从网络和机器人数据中学习,并将这些知识转化为机器人控制的通用指令,帮助机器人在现实环境中完成各种复杂任务,同时提高机器人的适应性和判断推理能力。高容量的视觉-语言模型(VLM)是在网络规模的数据集上训练的,使得这些系统在识别视觉或语言模式并跨越不同语言方面表现出色。 阅读详情

相关推荐

激光条纹中心提取——Steger

激光条纹中心提取-Steger 好久没有记录了,记录一下今天学习的内容,据说Steger在激光条纹中心提取上神一般的存在。文章和代码都分享给大家了哈,其中有四个文件,3个C++,一个python,python一个抠图文件,3个c++包含背景图+原图, 单张图提取, 多张图提取。 分享代码 #include <opencv2\core.hpp> #include <opencv2\highgui.hpp> #include <opencv2\imgproc.hpp> #i

CharmsLUO的博客 5380

让VLM充当机器的指路人——VLM规划下加约束:从SayCan、VoxPoser到ViLA、CoPa、ReKep

Figure 的创始人 Brett Adcock 和 AI 团队的负责人 Corey Lynch 在 X 上解释了此次视频中机器人互动背后的原理此次的突破,由 OpenAI 与 Figure 共同做出。OpenAI 提供负责提供视觉推理和语言理解,而 Figure 的神经网络提供快速、低水平、灵巧的机器人动作机器人所做出的所有行为都是出于已经学习过,内化了的能力,而不是来自远程操作,具体则如下Figure 的机载摄像头以 10hz 的频率拍摄图像。

结构之法 算法之道 1万+

QT串口通信控制LED上位机开发教程

串口通信是嵌入式系统与PC端交互的基础技术,通过UART协议实现设备间的数据传输。QT框架提供了跨平台的串口编程支持,结合其GUI模块可以快速开发上位机控制程序。在工业自动化和物联网领域,这种上下位机架构广泛应用于设备监控和控制场景。本案例展示了如何使用QT的SerialPort模块实现LED控制功能,包含串口参数配置、指令发送等核心功能实现,为嵌入式GUI开发提供实践参考。

weixin_42598278的博客 582

机器人早期VLA大脑的发展史——从微调VLM起步:详解RoboFlamingo、Octo、TinyVLA

许多研究使用从机器人收集的大量轨迹数据集来训练策略这些工作主要集中在单一的embodiment上,而Octo则在跨多个体现组装的机器人数据集上训练策略,增加了训练数据集的有效规模,并允许对多种机器人设置进行微调最近,论文集中于扩展机器人策略的泛化能力。多项研究利用多样的非机器人数据或预训练的视觉-语言基础模型来提升策略对新场景和任务的泛化能力[86,103,96,16,38,11,84,36,4,37,7,3,46,15,23]

结构之法 算法之道 1万+

[华为ensp]双核心的园区网

(给部分只会emm......借鉴的朋友提个醒,在group-member e0/0/2 to e0/0/20是所选,所以到了p l t那会给2-20端口都配置上trunk,别紧张,不是你问题)完成上述配置后,PC1可以ping通HTTP2服务器,Client1可以访问HTTP2服务器的HTTP站点,如果不能就要检查上述是否正确。本次实验主要目的是采用双核心的冗余网络,采用MSTP和VRRP技术,在核心层交换机上配置SC1上配置OSPF协议。SC1交换机上配置VRRP。在SC1上配置DHCP。

2301_78859499的博客 1416

私有云平台搭建——OpenStack

私有云平台搭建——OpenStack 搭建过程

2301_79739036的博客 3091

你的VLM竟是潜在的世界模型?颠覆传统!WMNav突破室内导航瓶颈

传统的Object Goal Navigation任务要求智能体探索未知的室内环境,并导航至给定类别(例如床、沙发、马桶)中的任意实例。智能体从指定的初始位置开始。在每个时刻,智能体获取周围环境的RGB-D观测值及其实时姿态。然后,智能体选择动作以寻找目标。如果智能体在距离目标的预定义距离阈值内停止,则任务视为成功。

m0_59235245的博客 1503

Chapter 5 Gate Drivers and Level Shifters

Gate driver如下图所示, 包括功率管(带保护), Gate driver, Level shifter, Gate Supply 和Dead-time control.

2304_76736886的博客 2237

目标导航到底是什么?自驾有没有落地的点?

在医疗、酒店及餐饮场景,嘉楠科技、云迹科技、擎朗智能的商用服务机器人,以及美国Aethon公司的TUG系列,已实现药品、文件和餐食的自主配送,有效提升服务响应效率。与传统视觉语言导航(VLN)依赖显式指令不同,目标驱动导航系统需要实现从"听懂指令走对路"到"看懂世界自己找路"的跃迁:当人类下达"去厨房拿可乐"的指令时,机器人需自主完成语义解析(识别厨房空间特征与可乐视觉属性)、环境建模(构建家居场景的空间拓扑)以及动态决策(避开移动的人类或宠物),这背后凝聚着计算机视觉、强化学习与3D语义理解的交叉突破。

CV_Autobot的博客 504

【Apache Paimon】-- 13 -- 利用 paimon-flink-action 同步 mysql 表数据

在Paimon 诞生以前,若 mysql/pg 等数据源的表结构发生变化时,我们有几种处理方式(1)人工通知(比如常规的使用邮件),然后运维人员手动同步到数据仓库中(2)使用 flink 消费 DDL binlog ,然后自动更新 Hive 的外部表和内部表 schema那么现在,有了 Paimon ,我们可以利用其特性,自动识别并同步 DDL 这些变化,并同步至 hive 的 paimon 格式表中。

欢迎来到我的博客,一起探索代码里的世界! 1250

基于Simulink的占空比调制DTC降低转矩脉动

修改传统SVPWM模块,输入占空比d和有效矢量索引,计算Ton​=d∗Tc​、Toff​=(1−d)∗Tc​,生成对称PWM波形(替代开关表直接输出)。:低速时(n<500rpm)减小dmax​=0.6(避免磁链畸变),高速时(n>2000rpm)增大dmax​=0.8(提升动态响应);kT​/kψ​:转矩/磁链误差增益(需整定,如kT​=0.02/(N⋅m),kψ​=0.1/Wb);(θ为电压矢量与磁链夹角)。② SVM-DTC(占空比计算模块启用,d0​=0.5,kT​=0.02,kψ​=0.1)。

amy_mhd的博客 87

Being-0——集操作、导航、运动为一体的机器人Agent框架:GPT4o高层感知并推理规划、中层VLM导航适配,最终低层执行技能库

为了实现让类人机器人自主执行类似人类任务的最终目标当前的研究主要集中在改进单项技能上,包括运动能力locomotion(Radosavovic等,2024;Zhuang等,2024)、双手操作manipulation(Ze等,2024a;Li等,2024a;Zhou等,2024)以及全身控制whole-bodycontrol(He等,2024a;Fu等,2024a)最近的研究(Firoozi等,2023;

结构之法 算法之道 7468

协方差矩阵自适应进化策略(CMA-ES)详解:从基础原理到优化算法

CMA-ES是一种先进的无导数优化算法,基于生物进化原理解决连续域非线性优化问题。该算法通过自适应调整多元正态分布的均值、协方差矩阵和步长参数,自动学习搜索空间结构,无需梯度信息即可高效优化。核心创新包括协方差矩阵的秩1和秩μ更新策略,以及基于进化路径的步长控制机制。CMA-ES具有旋转不变性、标度不变性和全局探索能力,特别适合3-300维的黑盒优化问题,在复杂系统仿真、超参数调优等领域表现优异。算法实现中关键参数如种群大小、学习率等均有自适应设置规则,使其成为连续优化领域的基准算法之一。

qq_42212808的博客 524

VLA 论文精读(三十六)Efficient Vision-Language-Action Models for Embodied Manipulation: A Systematic Survey

这篇论文是一篇有关高效 VLA 的综述,介绍了当前一些想要提升 VLA 训练和推理效率的方法,只在点出学界对加速 VLA 推理做出的努力。最后点出了该领域中存在的问题以及攻坚方向。

nenchoumi3119的博客 2218

VC中sqlite的使用

在VC中对sqlite的使用,实现数据库大批数据的快速插入,读取数据库中的数据在ListCtrl中显示

VB摄像头监控

该VB模块可对摄像头捕获的画面进行录像等,可在创建的窗口进行控制

VITAL——结合“带语义增强的ResNet视觉、触觉、RL残差”的适用于「电源插拔」的可泛化策略:先VLM定位、后执行在线残差RL以微调离线基础BC策略(MLP作为动作头)

摘要:VITAL框架通过两阶段策略(全局视觉定位+局部触觉操作)解决精密操作任务泛化难题。第一阶段利用视觉语言模型进行目标定位,第二阶段复用自中心视觉与触觉的局部策略完成毫米级操作。该方案结合模仿学习(32次演示)与强化学习微调(45分钟),通过语义数据增强保持泛化性,显著降低对场景变化的敏感性。实验显示,该方法在USB插入等任务中兼顾精度与跨环境适应性,为机器人精细操作提供新思路。(149字)

结构之法 算法之道 5087

最新的sdio 4.0 spec 协议标准 带书签 高清完整PDF版

Part-E1-SDIO-Specification-Ver4.00-Final-120220.pdf:最新的sdio 4.0 spec 协议标准 带书签 高清完整PDF版,包括SDIO 接口的外设,SDIO 接口官方协议等。

《ELEMENTAL: Interactive Learning from Demonstrations and Vision-Language Models for Reward...》译读笔记

强化学习(Reinforcement Learning, RL)在机器人任务中展现了出色的性能,但其成功往往取决于复杂的、特定的奖励函数的设计。研究人员已经探索了大型语言模型(Large Language Models, LLMs)如何能够让非专家用户更容易地指定奖励函数。然而,LLMs很难平衡不同功能的重要性,对分布外的机器人任务泛化性能较差,且仅依靠基于文本的描述无法恰当地表示(represent)问题。

墨门 892

STM32F407中文手册

STM32f407中文手册 本参考手册面向应用开发人员,提供有关使用 STM32F405xx/07xx、STM32F415xx/17xx、 STM32F42xxx 和 STM32F43xxx 微控制器存储器与外设的完整信息。STM32F405xx/07xx、STM32F415xx/17xx、STM32F42xxx 和 STM32F43xxx 构成一个微 控制器系列,各产品具有不同的存储器大小、封装和外设。有关订购信息以及器件的机械与电气特性,请参见数据手册。有关 ARM Cortex™-M4F 内核的信息,请参见《Cortex™-M4F 技术参考手册》。

Manual2Skill——让VLM从装配手册中提取装配步骤,随后做姿态估计,最终完成IKEA家具的自动组装(含IKEA-Manuals的详解)

Manual2Skill:基于视觉语言模型的家具自动装配框架 摘要:新加坡国立大学等机构提出的Manual2Skill框架,通过视觉语言模型(VLM)理解家具装配手册,实现自主机器人装配。该框架首先利用GPT-4o解析手册中的抽象示意图,生成分层装配图;然后结合部件点云和手册图像预测6D装配位姿;最后通过运动规划生成无碰撞装配轨迹。实验表明,该方法能有效处理复杂的长时序装配任务,显著减少对示范数据的依赖。相比传统方法局限于简单桌面任务,Manual2Skill突破了复杂家具装配的挑战,为智能制造提供了新思路

结构之法 算法之道 4689

π0:面向通用机器人控制的视觉-语言-动作流模型

Physical IntelligenceKevin Black, Noah Brown, Danny Driess, Adnan Esmail, Michael Equi, Chelsea Finn, Niccolo Fusai, Lachy Groom, Karol Hausman, Brian Ichter, Szymon Jakubczak, Tim Jones, Liyiming Ke, Sergey Levine, Adrian Li-Bell, Mohith Mothukuri, Suraj

u013250861的博客 55

π0.5——推理加强的统一模型:先高层预训练离散化token自回归预测子任务、后低层执行子任务(实时去噪生成连续动作)

今天一早,朋友圈刷到π0出0.5版本了,之后,我组建的「七月具身:π0复现微调交流群」群中,也在讨论这事,并说:七月老师要更新博客了这不就来了现在具身模型的发展 还不如大语言模型那样成熟π0 发新版了,意味着和Google的RT(大概率是不更了),以及figure(没开源过)等等——还有别的一些模型 没列举全,进入了少数迭代型的具身模型的行列。

结构之法 算法之道 1万+

RDT2——基于UMI数据实现零样本且跨本体的泛化:先训练VLM、后训练扩散动作专家、最后将扩散策略蒸馏为一步生成器(挑战叠衣服)

本文探讨了视觉-语言-动作(VLA)模型在机器人领域的应用挑战与创新解决方案。当前VLA模型面临泛化能力不足、数据获取成本高、跨平台迁移困难等问题。研究团队提出RDT2模型,基于7B规模的Qwen2.5-VL预训练模型,采用三阶段训练策略:离散动作编码、连续概率建模和高效蒸馏。同时,通过改进UMI硬件系统收集了10,000+小时的多样化真实环境数据。这些创新旨在解决机器人学习中的关键难题,包括数据稀缺、模型效率和多平台适配问题,为构建具有广泛泛化能力的机器人基础模型提供了新思路。

结构之法 算法之道 4650

τ0-VLA——具有世界模型“引导测试时计算”的分层机器人模型:首先生成多个子任务候选,然后世界模型预演,最后价值模型评估

本文摘要:τ0-VLA提出了一种分层机器人基础模型,通过世界模型引导的测试时计算来提升长时程任务中的决策质量。该系统采用高层策略生成候选子任务,结合世界模型预测视觉结果和价值模型评估候选方案,形成"提案-预测-评估"的推理循环。低层策略则在统一动作空间上执行生成的子任务,支持多种机器人形态操作。实验表明,这种分层推理机制显著提高了任务成功率和子任务预测准确率。该方法创新性地将语言子任务搜索与视觉预测相结合,在执行前评估候选方案,从而优化决策过程。

结构之法 算法之道 874

ABot-AgentOS——具备多模态记忆的通用智能体操作系统:Agent Harness层(含上下文管理和验证系统)、LLM、记忆作为大脑,自主调用下层导航、操作、运控相关的技能

本文介绍了ABot-AgentOS,一个通用机器人智能体操作系统,旨在连接高层语义推理与物理执行。该系统整合了多模态感知、记忆、推理和技能执行功能,支持跨不同机器人平台的运行。ABot-AgentOS采用边缘-云协同架构,包含验证感知的ReAct框架、分层LLM智能体(主LLM、SkillRunner和Verifier)以及多模态记忆系统。其创新点在于将认知层与硬件解耦,通过场景条件驱动的任务规划、过程执行隔离和多阶段验证机制,解决了具身智能中执行不确定性、长期记忆和跨平台泛化等关键挑战。该系统为构建可扩展

结构之法 算法之道 1249

ω-0——用于人形行走-操作的隐空间预测世界动作模型(全身VLA没有的未来视镜):抛弃像素级视频生成,以轻量“未来视觉latent预测”驱动全身动作扩散生成,实现边走边干活

本文提出了一种名为ω-0的新型潜在预测世界动作模型,用于实现人形机器人行走与操作(loco-manipulation)的协同控制。该模型通过联合学习未来视觉潜在表示和全身动作生成,避免了传统方法对视频预测和模块化任务分解的依赖。ω-0采用轻量级未来预测作为辅助监督,直接生成控制器兼容的全身动作潜变量,并通过大规模人类数据迁移学习提升机器人动作能力。实验在40小时真实世界数据集ω-HOME上进行,展示了在多种家庭任务中的协调控制能力。创新点包括:(1)首个将未来预测作为紧凑信号而非视频目标的全身动作模型;(2

结构之法 算法之道 1048

PointWorld: 动作条件的全场景3D点flow 预测(用同一种3D物理空间模态来表示状态和动作)

PointWorld: Scaling 3D World Models for In-The-Wild Robotic Manipulation

u013250861的博客 324

LAAP-EB:面向AGI的环境自感知,源码级RSI 自我进化的具身智能的认知架构系统

当前具身智能机器人技术——以视觉-语言-动作模型(VLA)、世界模型(World Model)和强化学习运动控制为代表——在"感知至动作"的映射上取得了显著进展。内在动机(intrinsic motivation)——机器人只能响应外部指令,无法自发产生目标;自我模型(self-model)——系统无法评估自身能力的边界,不能判断"我能否做到";安全边界内的自我改进(safe self-improvement)——新技能的习得完全依赖离线训练,无运行时自动合成-验证-部署能力。本文提出。

2601_95417945的博客 719
上一篇: 一文读懂大模型蒸馏技术:从原理到应用
下一篇: AI开发界的“瑞士军刀”!LangChain深度解析:从入门到实战全攻略
Python_金钱豹
博客等级 码龄5年 1万+粉丝 2835原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值