


概述
在当今的电商环境中,内容化已经成为淘宝的一大战略。无论是在站内通过图文和视频形式,作为商品的展示载体,促进用户的消费转化;还是在站外投放的广告内容,吸引用户进入淘宝,实现用户增长,内容的力量都不可忽视。
然而,许多内容创作者——包括KOL、商家、甚至是专业的广告设计师,亦或是AIGC内容生产方,在创作过程中,常常不确定什么样的内容能更有效地吸引用户,或者成为爆款。他们可能偶尔能创作出爆款内容,但却不清楚为什么会爆,也不明确哪些内容要素能提升内容质量,更好地吸引用户。面对这其中的“流量玄学”,他们难以复现爆款内容的生产。
举几个典型的例子。
- 商品主图制作:淘宝商家在为商品生产主图时,希望知道什么样的图片能够更好地吸引用户点击。到底哪些要素会影响用户的点击意愿?模特形象是否会有影响?是选用中国模特还是外国模特?商品拍摄的地点和背景是否重要?是选择室内还是室外?
- 站外广告设计:淘宝在站外投放广告内容时,广告设计师希望知道,什么样的内容更容易吸引用户点击广告并进入站内。是以奇幻美景类的画面开头,比如冰川、海洋,还是一开始就突出红包、满减、购物节等优惠权益,或者展示用户近期在淘宝站内感兴趣的商品画面?
- AIGC内容生产:在AIGC蓬勃发展的时代,我们拥有了更多的内容生产技术和工具,如图像生成、视频生成、TTS生成等。如何更好地利用这些工具,针对不同用户在不同场景下的需求,生产出用户乐于消费的内容,成为AIGC内容生产需要深入研究的课题。
要解决这些问题,通过科学的数据挖掘,了解哪些要素会影响用户的点击和消费意愿,显得尤为重要。此外,复杂性还在于,不同的投放渠道(如抖音、小红书)、不同的用户画像(如年龄段、性别等),对内容的消费偏好可能存在较大差异。这需要我们进行多维度、细粒度的拆解,才能洞察这些差异。
传统上,创作者主要依赖于个体层面的创作经验,通过反馈形成闭环,指导后续的内容创作。但这种方式的问题在于,个体经验的反馈往往有限,难以系统化。在大模型时代,如果我们能够基于大规模的内容特征和用户消费反馈数据,对多模态的素材内容进行细粒度的特征拆解与分析,结合内容的用户消费数据,进行科学的数据分析,在内容分析与内容生产之间建立起桥梁,为商家、设计师和AIGC等多类内容生产方的创作与生产形成一套系统、科学的指导,将具有重要的现实意义和应用价值。
方案介绍
针对上述背景和业务痛点,我们致力于将内容分析到指导内容生产的过程实现自动化、高效化、科学化,构建了一个基于内容细粒度分析的、可指导内容生产的内容分析Agent。
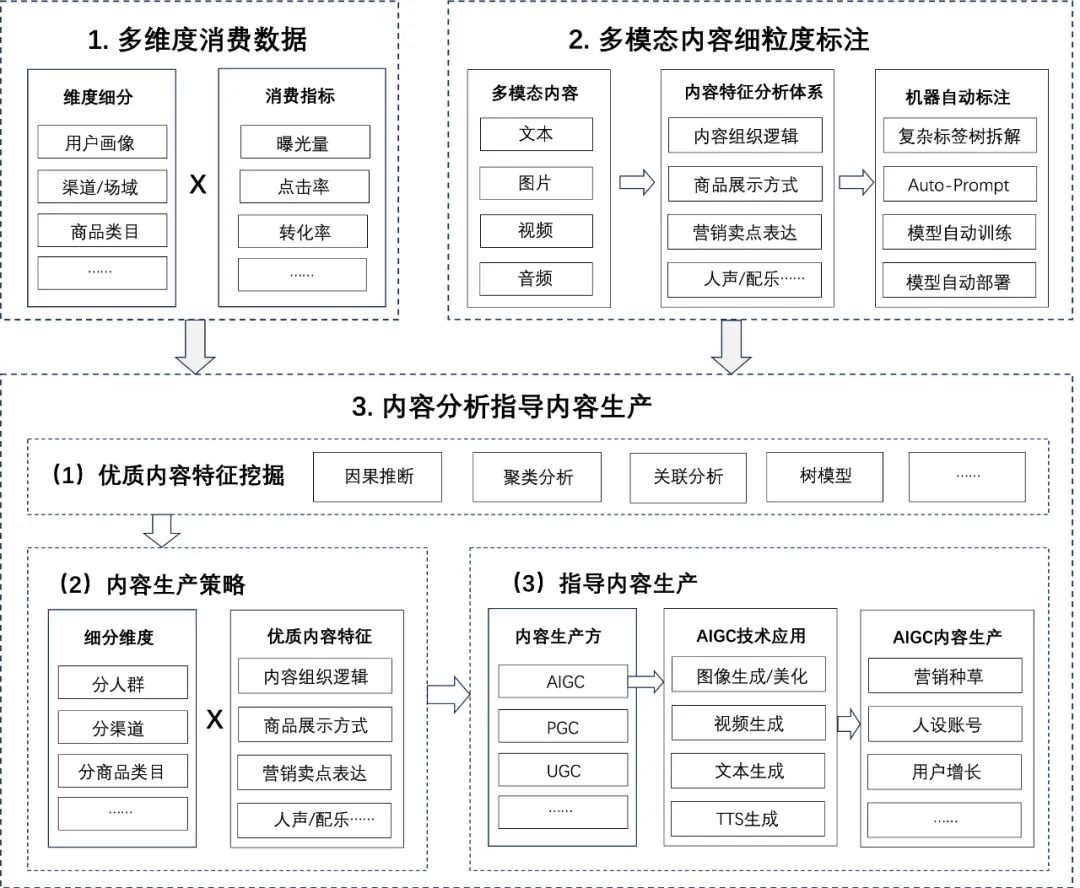
我们的内容分析Agent包括以下模块:
- 内容特征体系生成:面向用户的内容生产目标(如希望为淘宝搜索域生产一批优质的AIGC视频),Agent自动拆解分析维度(如画面、配乐、文案等),构建完善、清晰的内容特征分析体系。
- 内容特征细粒度标注:结合内容的用户消费数据,提取需要分析的多模态内容,通过机器自动标注,实现准确、高效、细粒度地拆解多模态素材的多维度特征。
- 优质内容特征挖掘:利用因果推断等统计学方法,挖掘并归因得到优质内容的细粒度特征,指导内容生产者制定分渠道、分人群、分商品类目的内容生产策略。
▐ 内容特征体系生成
背景
在多数情况下,内容生产者可能只明确内容生产的目标(如想生产一批爆款视频),但并不知道如何拆解和实现这一目标,或者无法构建一套完善、合理、清晰的标签体系。
方案设计
针对以上痛点,我们设计了一个内容特征分析体系生成Agent。该Agent能够基于用户的内容生产目标,自动生成维度完善、定义清晰、格式标准的内容细粒度分析体系,可实现以下效果:
- 分析体系完善化:根据用户需求,自动生成多层级的标签树,涵盖内容的各个维度。
- 标签定义清晰化:为每个标签提供明确的定义,确保含义易于理解。
- 体系格式标准化:生成的分析体系按照统一的格式,方便后续解析和处理。
内容特征分析体系生成Agent包括以下模块:
( 1 ) Planning
利用大语言模型强大的任务拆解和规划能力,针对用户的多种输入,拆解任务,并自动路由调用工具。
用户仅输入需求描述:
- 调用标签树生成功能,分步生成标签树。例如,用户想知道如何拆解分析爆款视频脚本的特征,Agent会先从画面、音频、文字等角度进行分析,再逐步深入探索和拆解,每个维度分别生成对应的标签树,最后汇总形成完整的标签体系。
用户输入了初步的分析体系:
- 判断输入内容的模态(文本、图片)和形式(表格、脑图等),然后调用大语言模型或多模态模型,将用户输入的分析体系解析为统一的文本格式。
- 自动判定分析体系的维度完整性,判断其是否足以支持分析和生产目标,如不完整,则会调用分析体系自动补全功能。具体实现方法是:依据分析需求,基于大语言模型的基础能力,结合业务样本输入,添加域外知识,自动补充相关标签,实现标签树的生成与扩展。这里举个例子,比如手淘外投业务输入了视频的分析体系和一批视频素材,系统会自动调用MLLM生成视频的Dense Caption,自动总结视频内包含的一些内容要素,作为大语言模型域外知识的补充,结合大语言模型的世界知识,生成视频分析的完整的标签体系。
- 自动定位抽象或模糊的标签,基于大模型的世界知识,结合用户输入的样本,自动总结并清晰化标签定义。
- 自动定位选项不完整的标签,对其进行补充,确保选项遵循MECE原则(Mutually Exclusive Collectively Exhaustive),即选项之间相互独立、完全穷尽,不重叠、不遗漏。
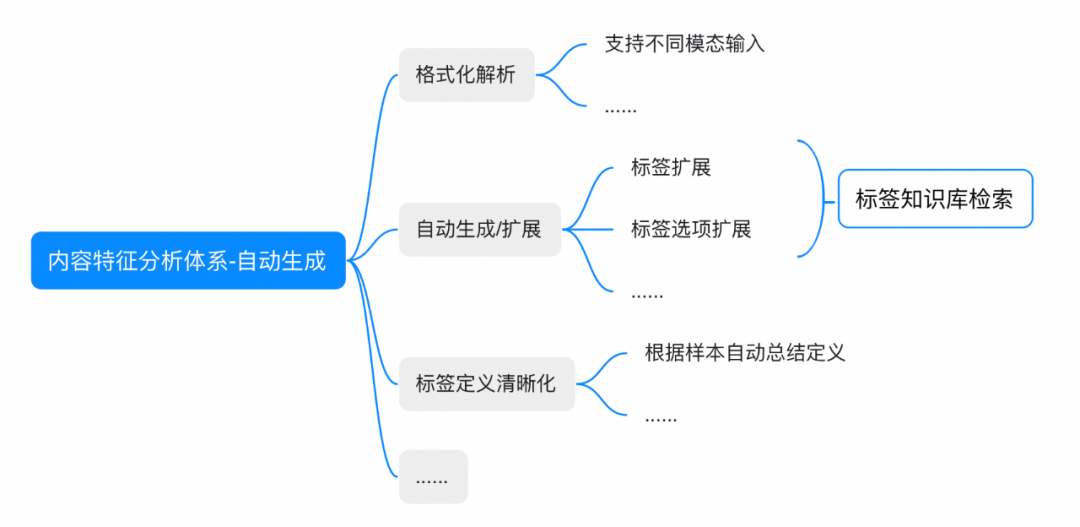
*( 2 )* Action
Action模块内集成了一系列子能力,包括标签格式化解析、标签树自动生成与扩展、标签定义清晰化等。
*( 3 )* Memory
Memory模块存储历史生成的分析体系和一些域内知识。当面对新的内容生产需求时,Agent会先在Memory中检索,查看是否有可复用的分析标签体系结果。同时,对于某些定位到的模糊标签,会先在Memory中检索是否有相关的定义,增强标签体系的专业性和准确性,提高内容分析体系生成和构建的效率。
应用效果
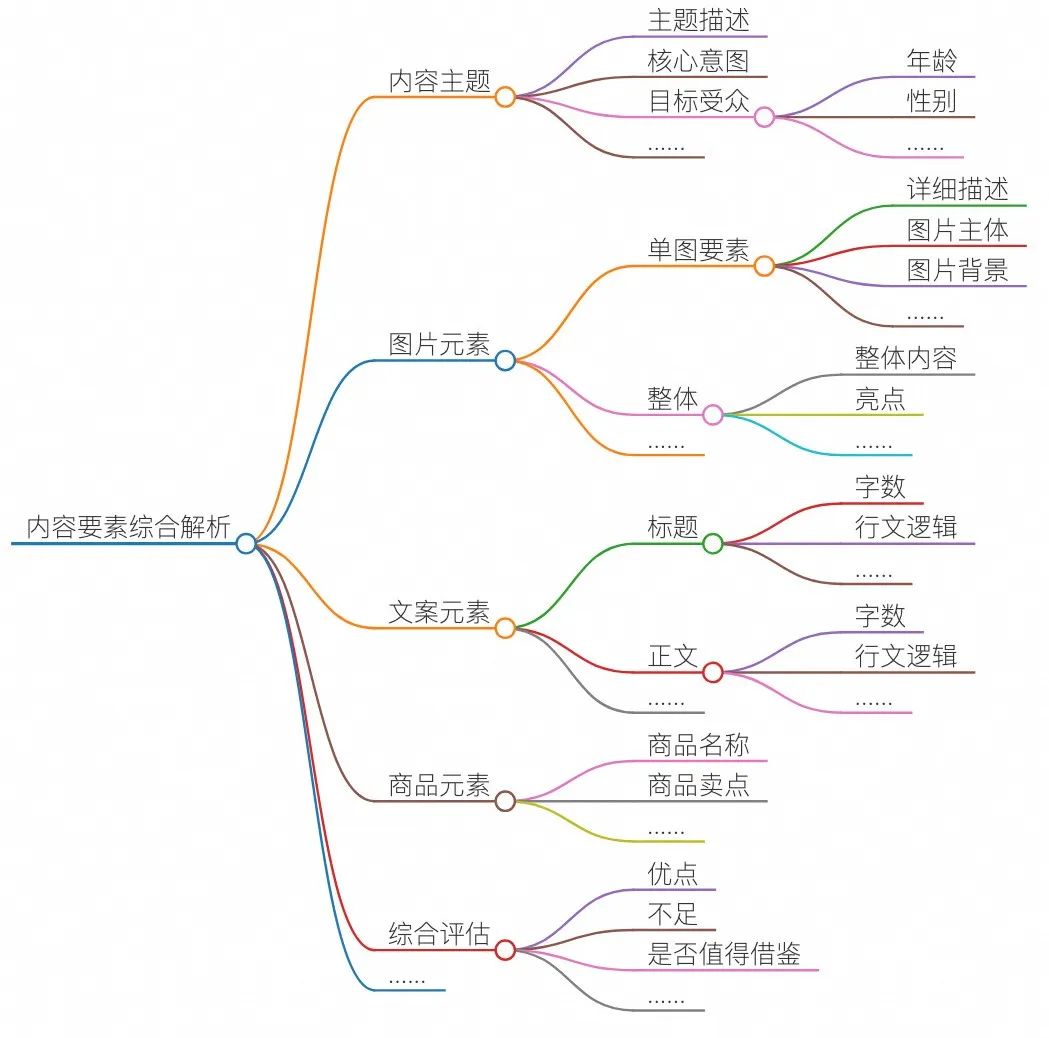
针对图文内容生产的需求,Agent自动生成并构建了完善的标签体系,为后续的内容分析和生产提供了有力支持。
▐ 内容特征细粒度标注
背景
传统的人工标注过程需要大量的人力和时间,面对多模态素材和复杂的标签体系,人工标注还容易受主观因素影响,难以保证一致性和准确性。
随着多模态大模型的涌现与发展,机器自动标注的方法也不断进步。然而,直接使用大模型进行标注仍存在一些挑战:
- 复杂标签体系的标注困难:面对庞大的标签树,想通过多模态大模型一次性实现标注,准确率难以保证;而逐个维度进行标注,成本又过高。
- 需要域外知识的标签标注困难:一些含义复杂的标签,直接通过zero-shot或few-shot方法,难以达到预期效果。采用微调方式需要一定量的标注数据,训练和部署成本较高。
方案设计
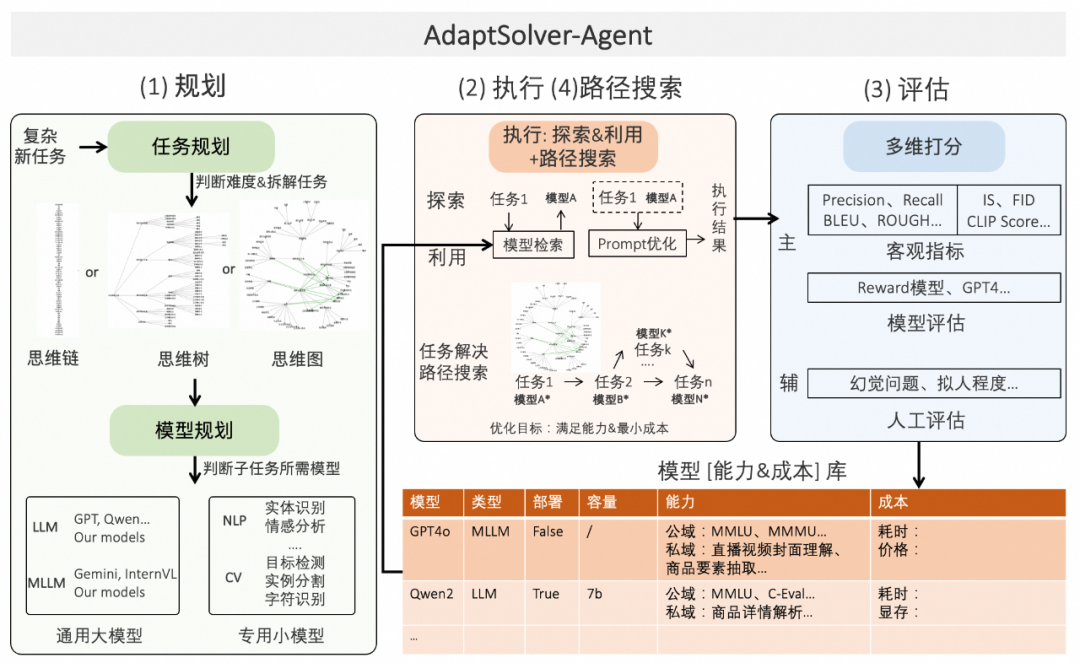
针对层出不穷的业务场域新任务,我们搭建了一套多模态内容自动标注Agent,能自动拆解任务并调用模型和工具解决,实现满足性能的条件下,尽可能降低耗时和资源。
多模态内容自动标注Agent内集成不同模态、不同尺寸的模型和各类工具。其中,规划模块可针对复杂任务,进行标签体系的自动拆解,并路由至对应类型的模型;执行模块通过Auto-Prompt能力推理优化,最大程度发挥模型能力,降低推理和部署的成本;针对部分仅通过推理优化无法良好解决的复杂理解任务,我们还建立起了模型的自动训练和部署能力。此外,记忆模块会记录模型面向不同任务的能力与特性,整套系统随着执行任务不断增多,积累的任务-模型性能库不断丰富,在新任务来临时,可以通过最适配模型检索,进一步提升标注的效率。
应用效果
面向手淘外投业务的图片素材,自动打标系统在30+个标签上的平均打标准确度90%+,累计标注百万量级的素材,降低人力标注成本80%+。
我们利用大语言模型的复杂任务拆解与规划能力,将大规模、多维度的标签树自动拆解,构建形成思维树或者思维图。实验证明,通过标签树的拆解和思维图的构建,我们在多模态细粒度理解任务上(约100个子任务),可实现以25%成本与60%耗时达到近90%GPT4o性能。
- 思维树:将复杂任务从上到下,逐层拆解,形成树状结构,分块解决问题。
- 思维图:在树状结构的基础上,考虑标签节点之间更为复杂的依赖关系,形成网状结构,更全面地解决问题。
| baseline | 思维树 | 思维图 |
|---|---|---|
 | 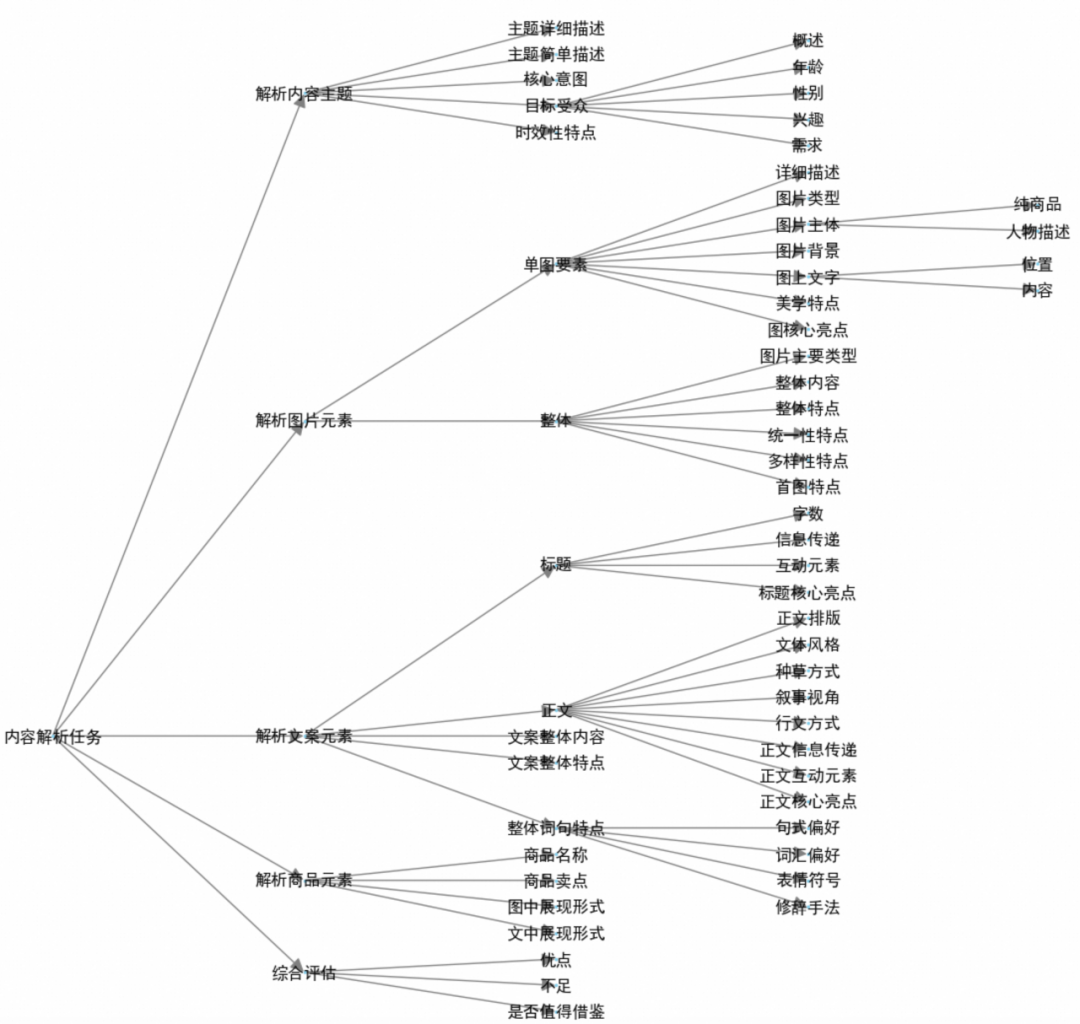 | 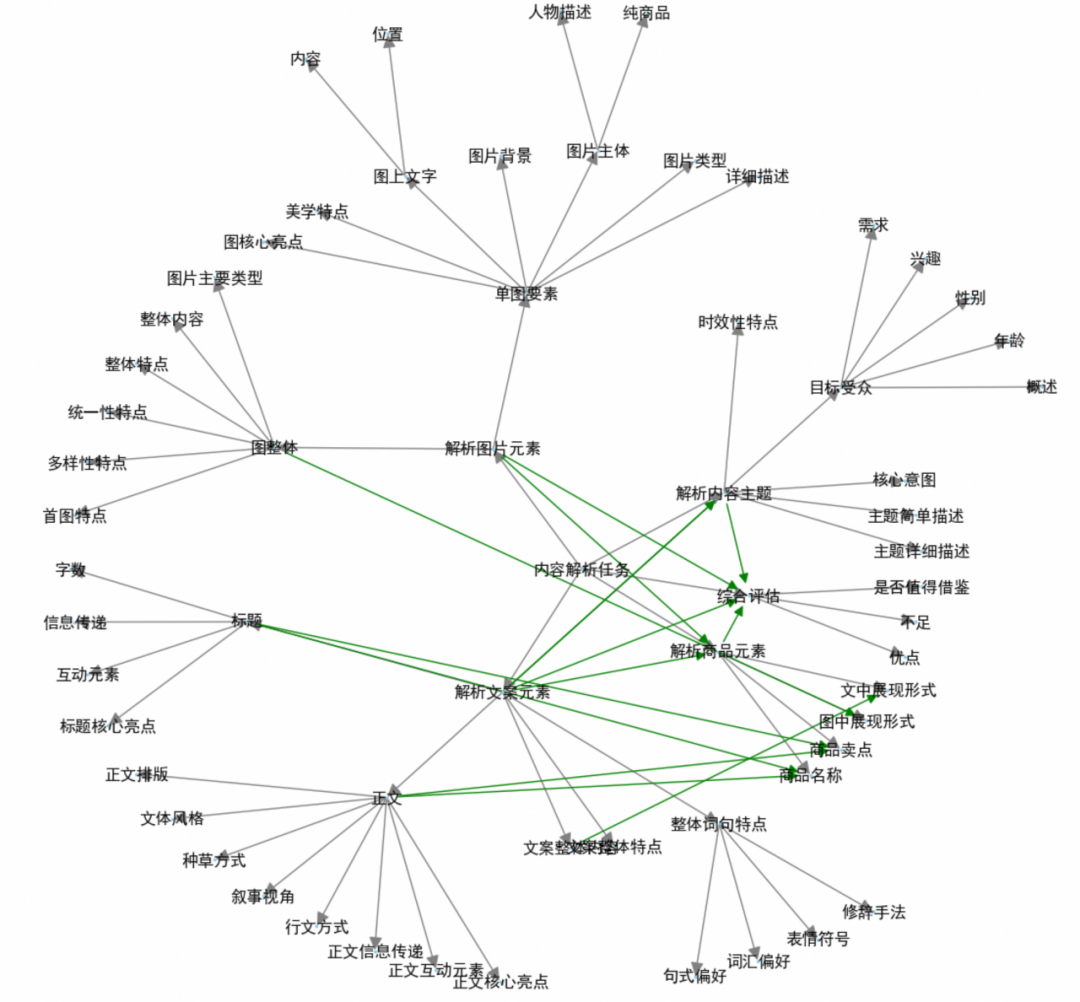 |
| 代表大语言模型解决复杂标签树的基本链路,从上而下,逐个链式推理 | 面向一些任务,可考虑拆解为树形结构分块解决 | 从树形结构衍生而来,标签节点之间存在更为复杂的依赖关系,成为思维图。以本图为例,从最中间的内容解析任务节点出发,绿色代表图之间的节点依赖关系,灰色代表树形结构。 |
背景
面对一些含义复杂的标签,直接利用预训练的多模态大模型,无法满足精度要求。人工调试提示词(prompt)需要多轮实验,耗时耗力。通过微调模型,又需要大量的标注数据和计算资源。
方案设计
我们基于强化学习技术,构建了一套Auto-Prompt的技术框架,产出一篇paper《Boosting Private Domain Understanding of Efficient MLLMs: A Tuning-free, Adaptive, Universal Prompt Optimization Framework》(IDEALPrompt),在投ACL2025。arxiv链接:https://arxiv.org/abs/2412.19684。
我们提出的Prompt Optimizer整体分为两个阶段。
第一阶段类似“预训练”,通过高效的策略树搜索和探索利用,得到较为有效的初始prompt,之所以称之为“预训练”,是因为策略结果在不同任务与模型间具备一定的可迁移性;
第二阶段类似“模型微调”,会结合具体的bad case进行反思和优化,从而生成一个面向具体任务较优的prompt。
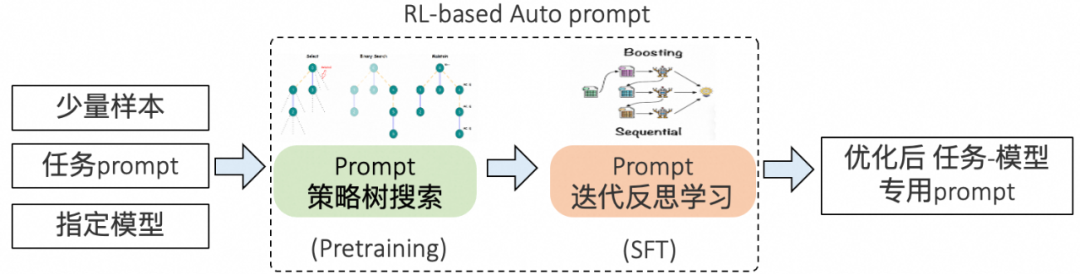
我们提出的该方法面向多模态任务,支持用户输入待处理的任务定义和标签定义,依赖较少的标注样本,以白盒化training-free的方式高效搜索最优的prompt,发挥模型的最大性能,实现推理优化。
该方法的优势:
\1. 低样本需求:只需少量标注样本即可进行Prompt优化。
\2. 高效搜索:快速找到最优的Prompt,提高模型性能。
\3. 过程透明:白盒化操作,方便调试和理解优化过程。
\4. 可迁移性:搜索得到的prompt在不同模型、不同任务间具备一定的可迁移性。
应用效果
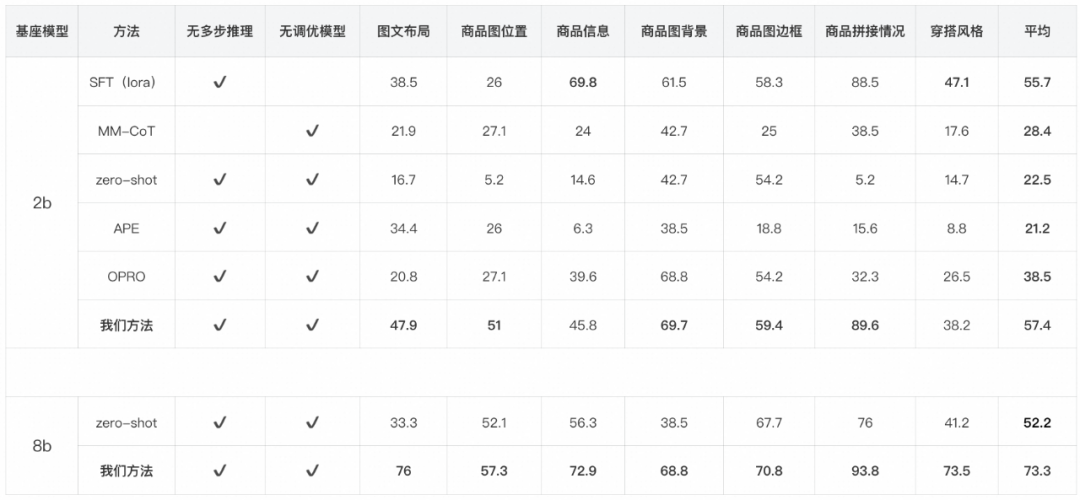
在手淘外投图片素材理解的7个任务实验,以InternVL2-2B为基模,较zero-shot性能提升34.9pt,准确率持平SFT效果,且优于其他经典Auto-Prompt方法和InternVL2-8B zero-shot结果;以InternVL2-8B为基模,较zero-shot性能提升21.1pt。整套系统仅依赖约20条训练样本,且无需微调模型,能以轻量的方式挖掘出基础模型处理私域任务的能力。
背景
对于复杂任务,仅通过Auto-Prompt等推理优化手段,可能无法满足精度要求,需要微调模型才能达到要求。此外,使用大模型得到理想效果后,也可以通过标注数据蒸馏小模型,进一步降低推理成本。
以往我们都是人工进行模型的训练和部署,为了降低人力成本,我们构建起了一套模型自动训练与部署的pipeline,实现链路的高度自动化。
方案设计
我们构建了一套自动训练与部署的pipeline:
- 数据准备:自动获取和处理训练数据,主要有两种渠道:一是从素材池中多路召回,二是利用生成模型,通过Prompt泛化,扩充数据。
- 模型训练:根据任务需求,选择合适的预训练模型(图分类模型、语言模型、多模态模型),自动进行训练。
- 模型评估:自动评估模型性能,确保达到预期要求。
- 模型部署:训练完成并通过评估后进入模型库,服务无需重新发布,模型自动部署到推理环境中。
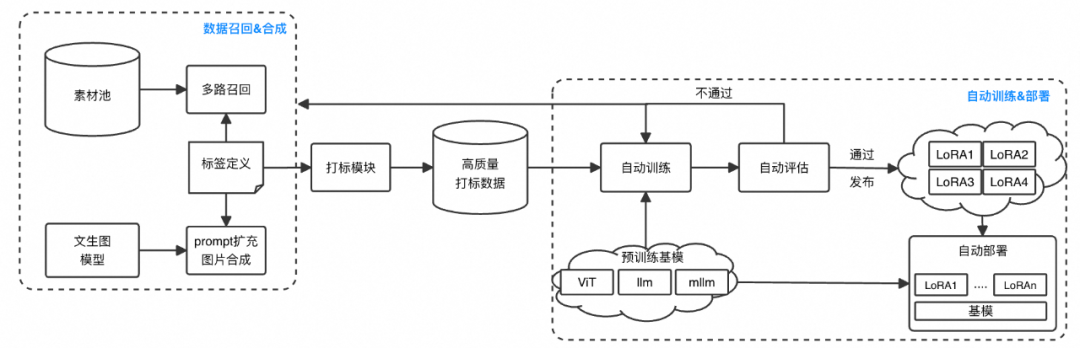
该方案具备以下优势:
- 全流程自动化:提供模型的自动训练和部署能力,降低人力操作成本。
- 支持多模型类型:图分类模型、大语言模型、跨模态模型等。
- 高准确率,低成本:训练的小模型,准确率可达90%以上,推理成本降低至原来的20%。
应用效果
完成图分类、LLM和MLLM的自动训练部署能力,支持LoRA的快速训练&部署,小模型准确率可达90%+,产出专家小模型5个(服饰展示分类、人脸完整度、背景分类、标题颜色词提取等),推理成本降为20%左右,素材池累计打标1亿+。
▐ 优质内容特征挖掘
背景
内容生产的复杂点在于,不同人群、不同场域下的人群消费偏好可能会存在较大的差异。如何才能够从海量的多模态标注素材和标签中挖掘出有价值的信息,形成明确的创意指导,是我们需要解决的关键问题。
方案设计
在对多模态内容进行细粒度的标注后,我们需要进一步挖掘和分析,拆解不同的人群、渠道、商品等维度,分析这些标签中的哪些要素出现或者某几个要素组合出现时,会对内容消费效率产生关键影响。从而在内容分析与内容生产之间建立桥梁,通过内容分析为内容生产形成明确的创意指导,提升内容生产的效率和效果。
具体而言,我们的内容分析指导内容生产过程,根据抽象程度的不同,分为两个层次:
-
直接参考:挑选出面向某个商品、某个渠道下表现出色的优秀样本(Golden Sample),直接分析其内容特征,对生产形成强指导。
-
间接参考:通过大量的数据分析,进行抽象层面的知识总结和挖掘,了解具有某些要素特征的内容可以取得更优的消费效率,在生产过程中提供知识层面的“白盒化”的指导,提升整体内容生产质量的下限。整体分为以下两步:
-
人工构造“AB实验”:控制除最关注的消费指标外,其他特征均保持一致,通过分析内容特征的差异,与消费指标的差异之间建立关联。如在优化信息流场景下的商品主图时,控制品牌、价格段、商品品类一致,找到点击率差距大的主图,分析优质素材与劣质素材的特征差异。
-
优质内容特征挖掘:利用关联分析、相关性分析、机器学习方法建模后的特征重要度分析(包括Shap Value、Permutation Importance等),分析各要素对内容效率的影响,识别关键影响因素。通过卡方检验等显著性检验方法,判断要素的不同取值是否对内容效率有显著影响。
注:此部分工作与数科老师合作完成。
应用效果
我们对手淘外部投放业务中的图片和视频素材进行了分析,并据此提出了优化建议。出于业务数据隐私的考虑,我们在此仅做部分结论展示:
- 对于图片素材,推荐展示多种商品款式及直接展示优惠信息,能有效提高用户点击率与转化率;
- 对于视频素材,推荐采用吸引人的开场场景以及突出价格优势的开头文案,能有效增加用户吸引力;
目前图片的分析结论已应用于指导设计师制作内容,为外投素材的CTR带来了两位数的正向提升。视频的分析结论建议正被用来改进面向不同渠道的内容创作流程,旨在提升视频质量和广告效果,促进用户参与度。
总结与展望
针对内容创作者在生产优质内容过程中面临的挑战,我们提出了一套基于细粒度内容分析的内容分析Agent。通过自动生成内容特征体系、对多模态内容进行细粒度的自动标注,以及深入挖掘优质内容特征,该Agent在内容分析与内容生产之间建立了有效的桥梁。它帮助内容生产者明确哪些内容要素能够更好地吸引用户,提高点击和消费意愿,从而在创作时更有针对性,提升内容的吸引力和传播效果。
在内容特征分析体系生成方面,Agent能够根据内容生产目标,自动拆解分析维度,构建完整、清晰的标签体系,解决了创作者对内容特征认知不全面的问题。
在多模态内容自动标注方面,我们利用大模型的能力,实现了对大量内容的高效、准确、细粒度标注,降低了人工标注的成本和误差。
通过优质内容特征的挖掘,我们运用统计学和因果推断的方法,识别出影响内容效率的关键要素,为内容生产者提供了科学的数据支持。
实践证明,内容分析Agent在实际应用中取得了良好的效果。以手淘外投业务用于用户增长的图片素材为例,自动标注系统在多个标签上的准确度超过90%,累计标注了百万级的素材,降低了80%以上的人力标注成本。标注与分析结果用于指导设计师进行素材生产,使图片大盘CTR环比提升12%。除此之外,视频的标注分析结论也在指导设计师生产和AIGC生产落地的过程中。这些成果表明,内容分析Agent能够有效提升内容生产的效率和质量,为内容创作者提供了有价值的支持。
未来,我们将继续优化内容分析Agent,在提高自动标注的精确度、减少人力介入以及增强对生产的指导方面深入推进。随着技术的不断发展,我们有望进一步提升自动标注的性能,使多模态内容的细粒度标签更加丰富和精准,为更深入的内容分析奠定基础。
通过强化算法和数据分析,我们将更有效地挖掘影响内容效率的关键要素,为内容生产者提供更具价值的指导。我们也将持续完善从内容分析到生产指导的全流程,形成更高效、科学的闭环,帮助商家、设计师和AIGC内容生产者在不同场景下创作出更受用户欢迎的内容。
如何学习大模型 AI ?
由于新岗位的生产效率,要优于被取代岗位的生产效率,所以实际上整个社会的生产效率是提升的。
但是具体到个人,只能说是:
“最先掌握AI的人,将会比较晚掌握AI的人有竞争优势”。
这句话,放在计算机、互联网、移动互联网的开局时期,都是一样的道理。
我在一线互联网企业工作十余年里,指导过不少同行后辈。帮助很多人得到了学习和成长。
我意识到有很多经验和知识值得分享给大家,也可以通过我们的能力和经验解答大家在人工智能学习中的很多困惑,所以在工作繁忙的情况下还是坚持各种整理和分享。但苦于知识传播途径有限,很多互联网行业朋友无法获得正确的资料得到学习提升,故此将并将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。

第一阶段(10天):初阶应用
该阶段让大家对大模型 AI有一个最前沿的认识,对大模型 AI 的理解超过 95% 的人,可以在相关讨论时发表高级、不跟风、又接地气的见解,别人只会和 AI 聊天,而你能调教 AI,并能用代码将大模型和业务衔接。
- 大模型 AI 能干什么?
- 大模型是怎样获得「智能」的?
- 用好 AI 的核心心法
- 大模型应用业务架构
- 大模型应用技术架构
- 代码示例:向 GPT-3.5 灌入新知识
- 提示工程的意义和核心思想
- Prompt 典型构成
- 指令调优方法论
- 思维链和思维树
- Prompt 攻击和防范
- …
第二阶段(30天):高阶应用
该阶段我们正式进入大模型 AI 进阶实战学习,学会构造私有知识库,扩展 AI 的能力。快速开发一个完整的基于 agent 对话机器人。掌握功能最强的大模型开发框架,抓住最新的技术进展,适合 Python 和 JavaScript 程序员。
- 为什么要做 RAG
- 搭建一个简单的 ChatPDF
- 检索的基础概念
- 什么是向量表示(Embeddings)
- 向量数据库与向量检索
- 基于向量检索的 RAG
- 搭建 RAG 系统的扩展知识
- 混合检索与 RAG-Fusion 简介
- 向量模型本地部署
- …
第三阶段(30天):模型训练
恭喜你,如果学到这里,你基本可以找到一份大模型 AI相关的工作,自己也能训练 GPT 了!通过微调,训练自己的垂直大模型,能独立训练开源多模态大模型,掌握更多技术方案。
到此为止,大概2个月的时间。你已经成为了一名“AI小子”。那么你还想往下探索吗?
- 为什么要做 RAG
- 什么是模型
- 什么是模型训练
- 求解器 & 损失函数简介
- 小实验2:手写一个简单的神经网络并训练它
- 什么是训练/预训练/微调/轻量化微调
- Transformer结构简介
- 轻量化微调
- 实验数据集的构建
- …
第四阶段(20天):商业闭环
对全球大模型从性能、吞吐量、成本等方面有一定的认知,可以在云端和本地等多种环境下部署大模型,找到适合自己的项目/创业方向,做一名被 AI 武装的产品经理。
- 硬件选型
- 带你了解全球大模型
- 使用国产大模型服务
- 搭建 OpenAI 代理
- 热身:基于阿里云 PAI 部署 Stable Diffusion
- 在本地计算机运行大模型
- 大模型的私有化部署
- 基于 vLLM 部署大模型
- 案例:如何优雅地在阿里云私有部署开源大模型
- 部署一套开源 LLM 项目
- 内容安全
- 互联网信息服务算法备案
- …
学习是一个过程,只要学习就会有挑战。天道酬勤,你越努力,就会成为越优秀的自己。
如果你能在15天内完成所有的任务,那你堪称天才。然而,如果你能完成 60-70% 的内容,你就已经开始具备成为一名大模型 AI 的正确特征了。
这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】

 420


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


