用Ollama+RAGflow打造私有知识库

纯小白用Ollama+RagFlow 部署本地知识库 什么是WSL?WSL(Windows Subsystem for Linux)是微软开发的一项技术,允许用户在Windows系统中直接运行完整的Linux环境,无需虚拟机。通过操作系统级虚拟化,WSL将Linux子系统无缝嵌入Windows,提供原生Linux命令行工具、软件包管理器及应用程序支持。它具有轻量化、文件系统集成、良好的交互性及开发效率提升等优点,消除了Windows与Linux之间的隔阂,尤其适合开发者和需在Windows平台上使用Linux工具的用户。 阅读详情
AI摘要

本文介绍了如何使用Ollama和RAGFlow构建私有知识库。首先,介绍了Ollama平台,一个本地运行的大语言模型工具,支持多种开源模型。接着,详细说明了RAGFlow的安装、部署以及如何创建和管理知识库。最后,提供了一个大模型AI学习的四阶段计划,从初阶应用到商业闭环,帮助读者逐步掌握大模型AI的应用和开发。

1. Ollama 简介 https://ollama.com

Ollama 是一个本地运行的大语言模型(LLM)工具平台,允许用户在本地设备上运行和管理大模型,而无需依赖云服务。它支持多种开源模型,并提供了用户友好的接口,非常适合开发者和企业使用。

安装 Ollama

首先,从 Ollama 官网 下载安装包,并按照提示完成安装。
启动Ollama

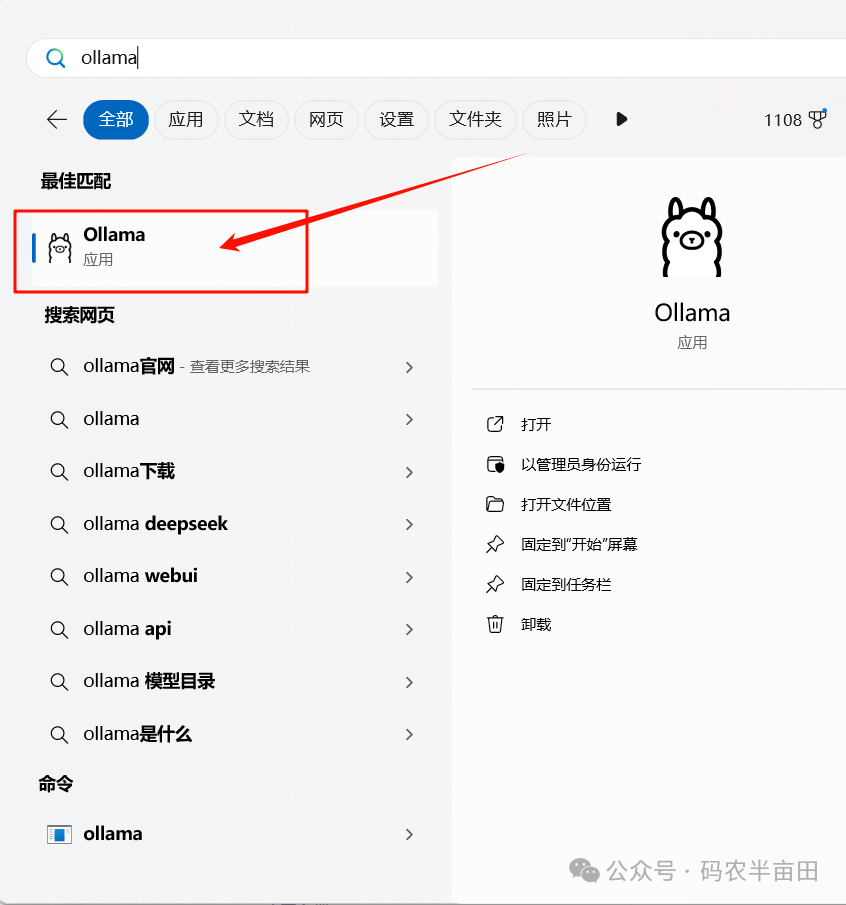
Windows下搜索ollama,然后点击启动
Ollama 命令介绍

Ollama 提供了几个简单易用的命令,基本功能如下:

Usage:  
  ollama [flags]  
  ollama [command]  
  
Available Commands:  
  serve       启动 Ollama 服务  
  create      从 Modelfile 创建一个模型  
  show        查看模型详细信息  
  run         运行一个模型  
  stop        停止正在运行的模型  
  pull        从注册表拉取一个模型  
  push        将一个模型推送到注册表  
  list        列出所有可用的模型  
  ps          列出当前正在运行的模型  
cp          复制一个模型  
rm          删除一个模型  
help        获取关于任何命令的帮助信息  
  
Flags:  
  -h, --help      helpfor ollama  
  -v, --version   Show version information  

拉取模型并运行

ollama pull 具体的模型,这里以deepseek为例
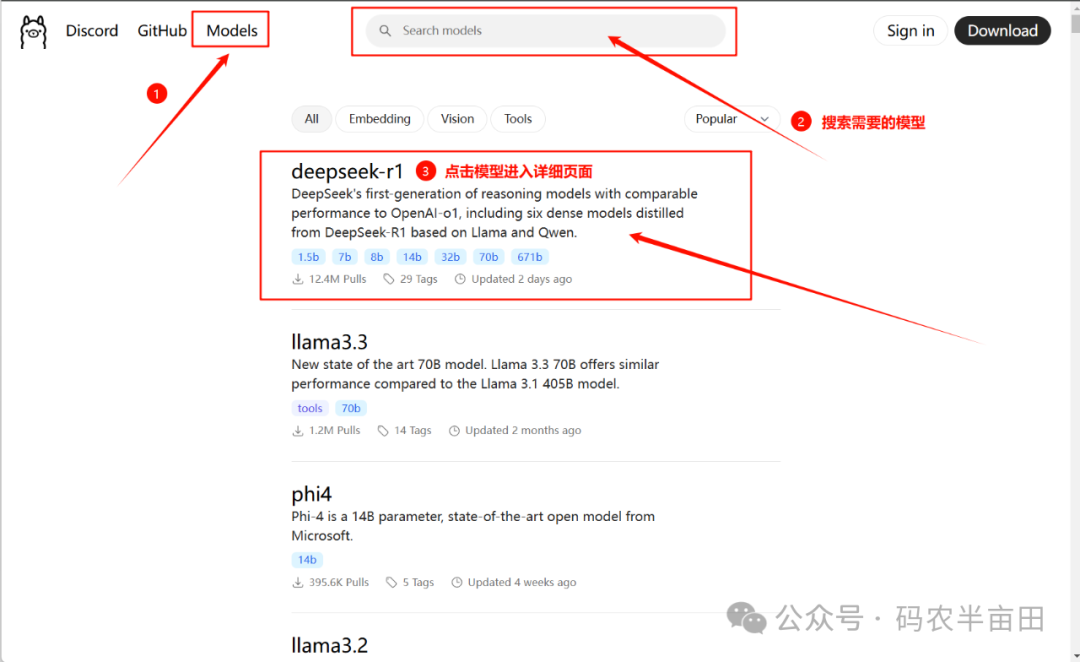
1. 选择模型

2. 搜索你想要的模型:比如 deepseek,qwen

3. 选择你的模型
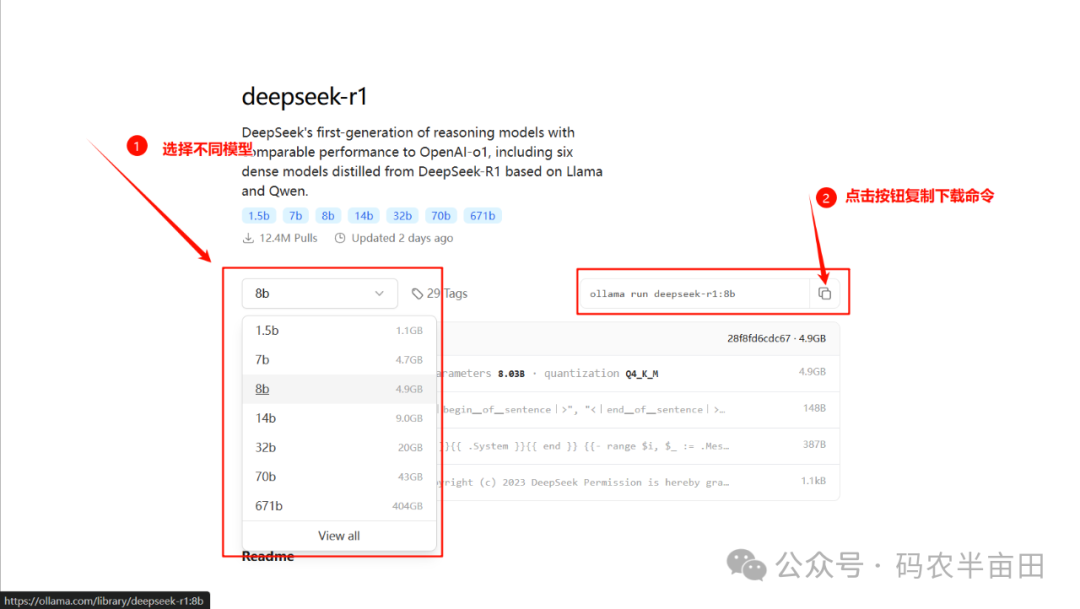
1. 选择模型大小

2. 复制下载指令,替换为下面,并在终端中执行

ollama pull  deepseek-r1:14b  
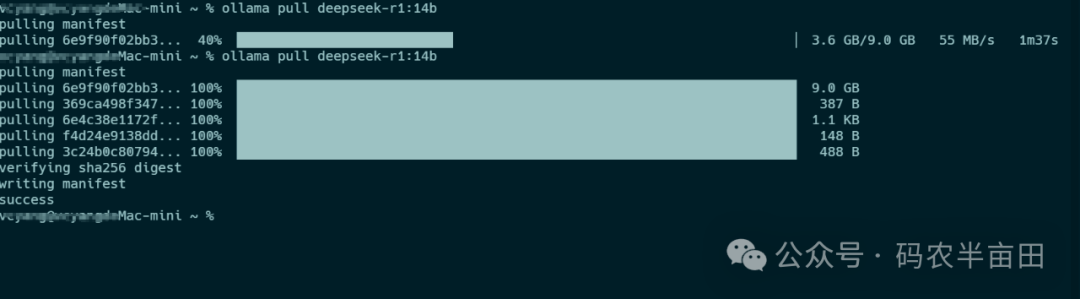
运行模型并对话,–verbose参数可以显示token信息

ollama run deepseek-r1:14b --verbose

信息如下:
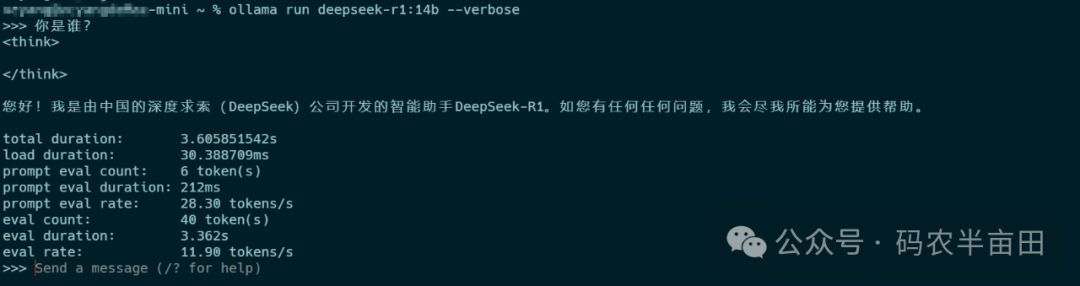
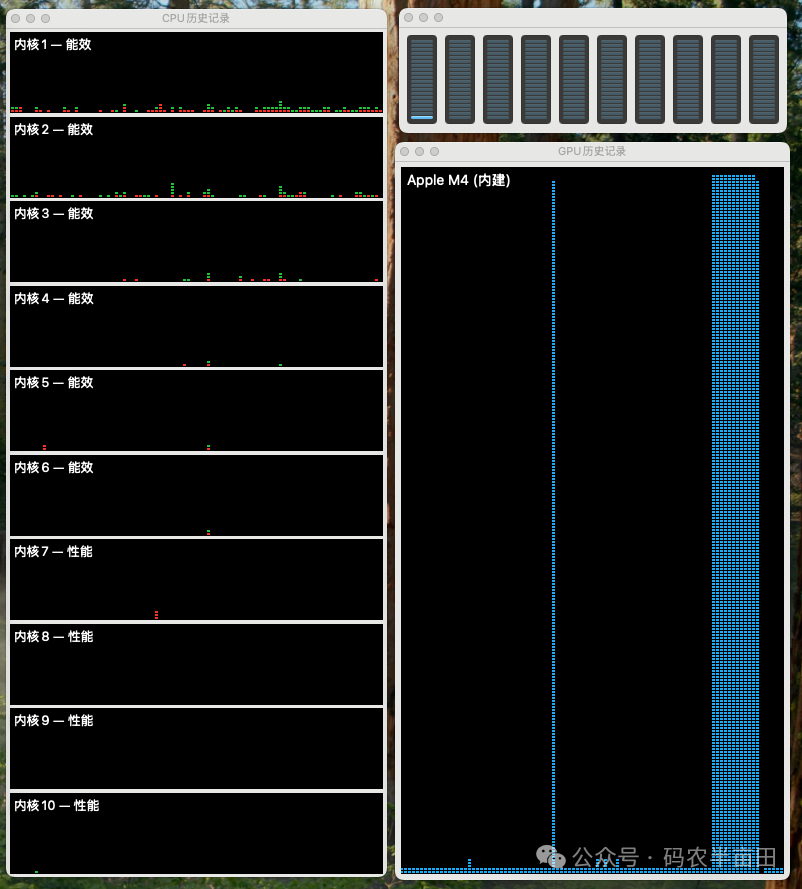
资源占用情况:
退出对话

/bye

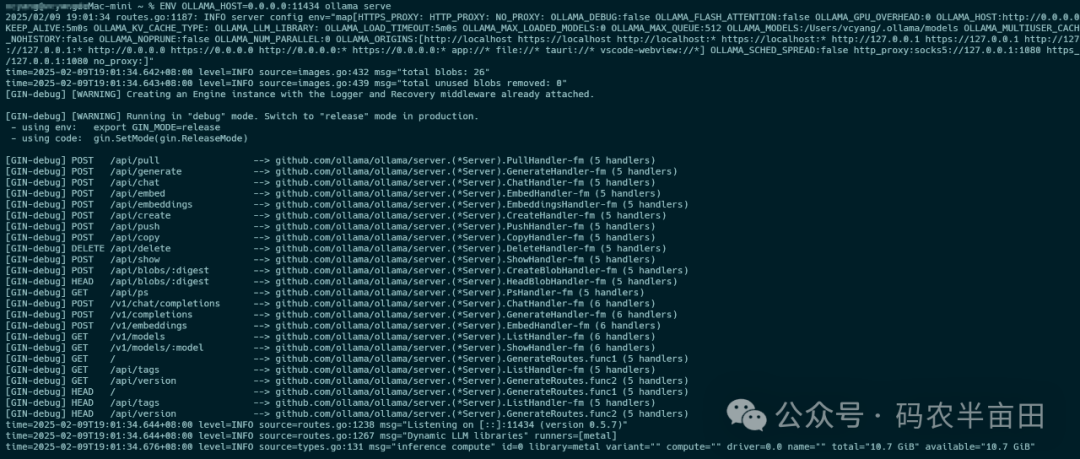
运行ollama远程服务

ENV OLLAMA_HOST=0.0.0.0:11434 ollama serve
2 RAGFlowj简介 https://ragflow.io

RAGFlow 是一款基于深度文档理解构建的开源 RAG(Retrieval-Augmented Generation)引擎。RAGFlow 可以为各种规模的企业及个人提供一套精简的 RAG 工作流程,结合大语言模型(LLM)针对用户各类不同的复杂格式数据提供可靠的问答以及有理有据的引用。它主要适用于需要动态生成内容且依赖外部知识库的场景,例如智能客服、文档生成、数据分析等。
RAGFlow的安装和部署

📝前置条件

  • CPU ≥ 4 cores (x86);

  • RAM ≥ 16 GB;

  • Disk ≥ 50 GB;

  • Docker ≥ 24.0.0 & Docker Compose ≥ v2.26.1.

    如果你并没有在本机安装 Docker(Windows、Mac,或者 Linux), 可以参考文档 Install Docker Engine 自行安装。

🚀 启动服务器

  1. 确保 vm.max_map_count 不小于 262144:

    如需确认 vm.max_map_count 的大小:

    $ sysctl vm.max_map_count  


    如果 vm.max_map_count 的值小于 262144,可以进行重置:

    # 这里我们设为 262144:  
    $ sudo sysctl -w vm.max_map_count=262144  


    你的改动会在下次系统重启时被重置。如果希望做永久改动,还需要在 /etc/sysctl.conf 文件里把 vm.max_map_count 的值再相应更新一遍:

    vm.max_map_count=262144  
    
    
  2. 克隆仓库:

    $ git clone https://github.com/infiniflow/ragflow.git  
    
    
  3. 进入 docker 文件夹,利用提前编译好的 Docker 镜像启动服务器:

请在运行 docker compose 启动服务之前先更新 docker/.env 文件内的 RAGFLOW_IMAGE 变量。比如,你可以通过设置 RAGFLOW_IMAGE=infiniflow/ragflow:v0.16.0 来下载 RAGFlow 镜像的 v0.16.0 完整发行版。

镜像比较大,需要留足磁盘空间,另外docker下载需要自备科学上网方式,否则有些镜像拉取不下来

$ cd ragflow  
$ docker compose -f docker/docker-compose-CN.yml up -d  

服务器启动成功后再次确认服务器状态:

$ docker logs -f ragflow-server  

出现以下界面提示说明服务器启动成功:

     ____   ___    ______ ______ __  
    / __ \ /   |  / ____// ____// /____  _      __  
   / /_/ // /| | / / __ / /_   / // __ \| | /| / /  
  / _, _// ___ |/ /_/ // __/  / // /_/ /| |/ |/ /  
 /_/ |_|/_/  |_|\____//_/    /_/ \____/ |__/|__/  
  
 * Running on all addresses (0.0.0.0)  
 * Running on http://127.0.0.1:9380  
 * Running on http://x.x.x.x:9380  
 INFO:werkzeug:Press CTRL+C to quit

如果您跳过这一步系统确认步骤就登录 RAGFlow,你的浏览器有可能会提示 network anormal 或 网络异常,因为 RAGFlow 可能并未完全启动成功。

  1. 在你的浏览器中输入你的服务器对应的 IP 地址并登录 RAGFlow。

    上面这个例子中,您只需输入 http://IP_OF_YOUR_MACHINE 即可:未改动过配置则无需输入端口(默认的 HTTP 服务端口 80)。

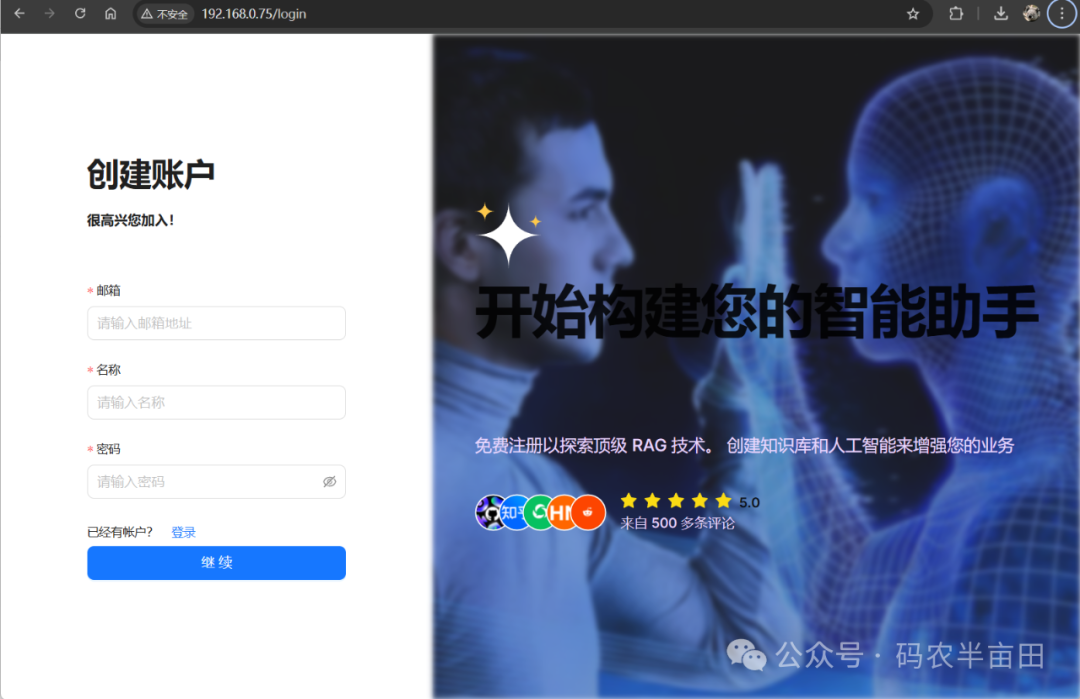
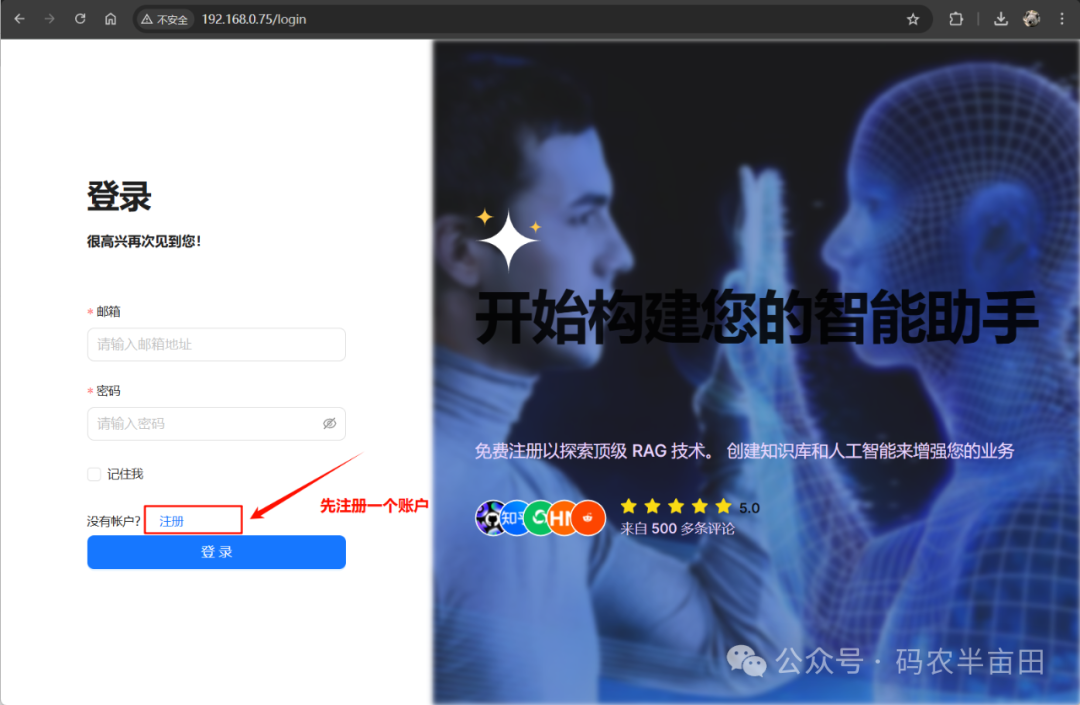
注册登录

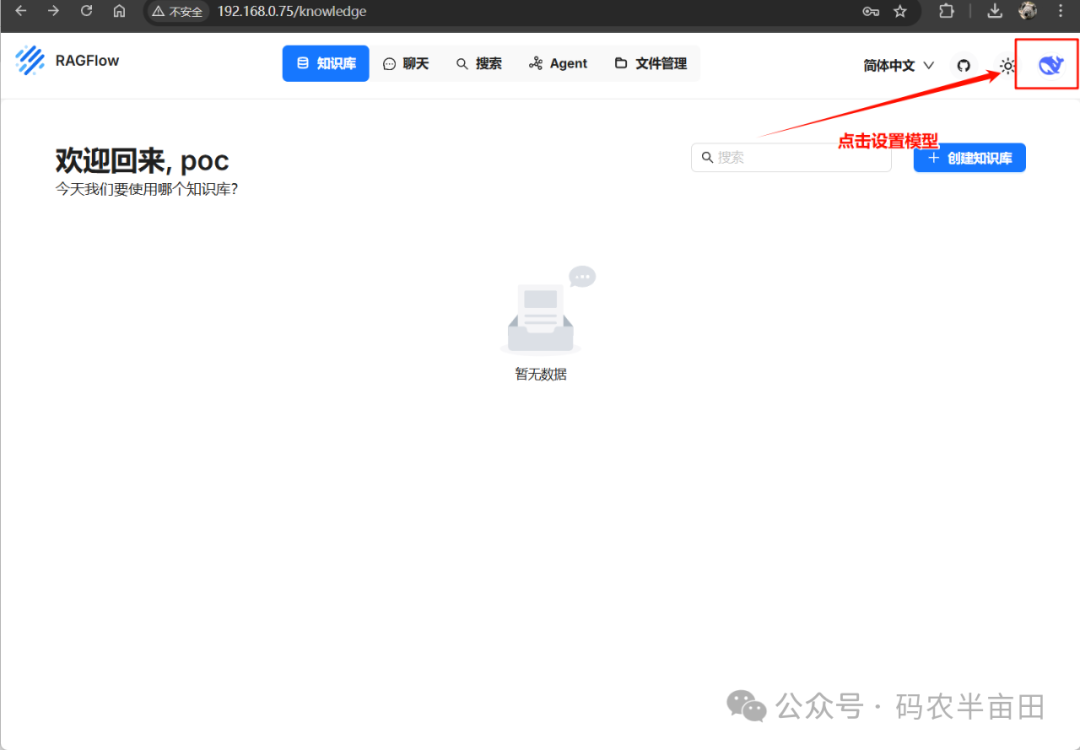
在上图的界面中注册,然后登录就来到下面这个页面了
配置 Ollama 连接大模型

  1. 如下图我们先配置模型,点击右上角头像,再点击模型提供商

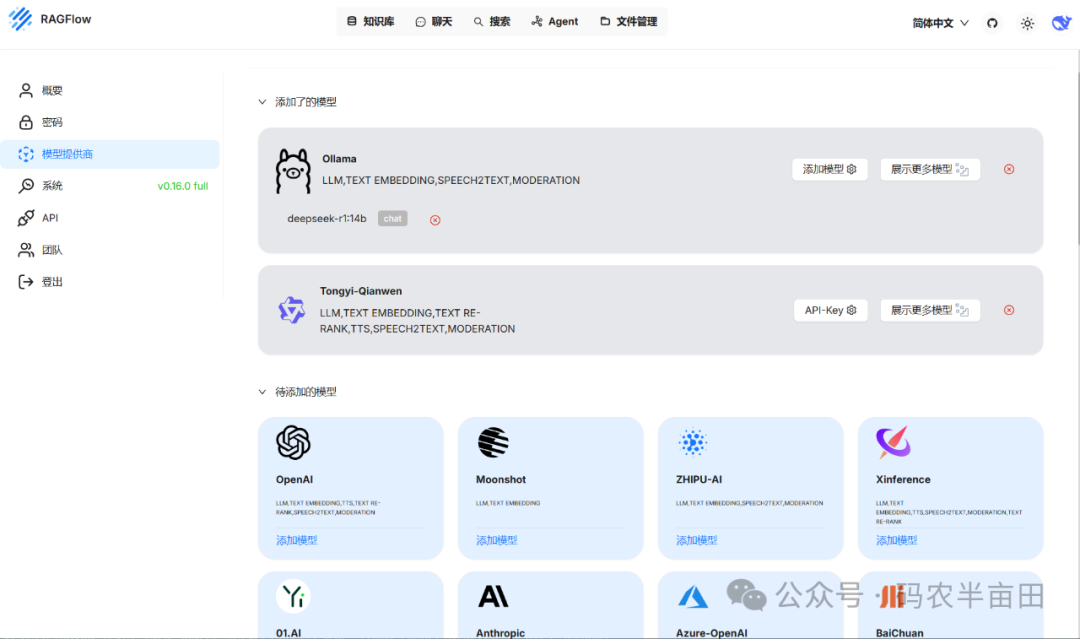
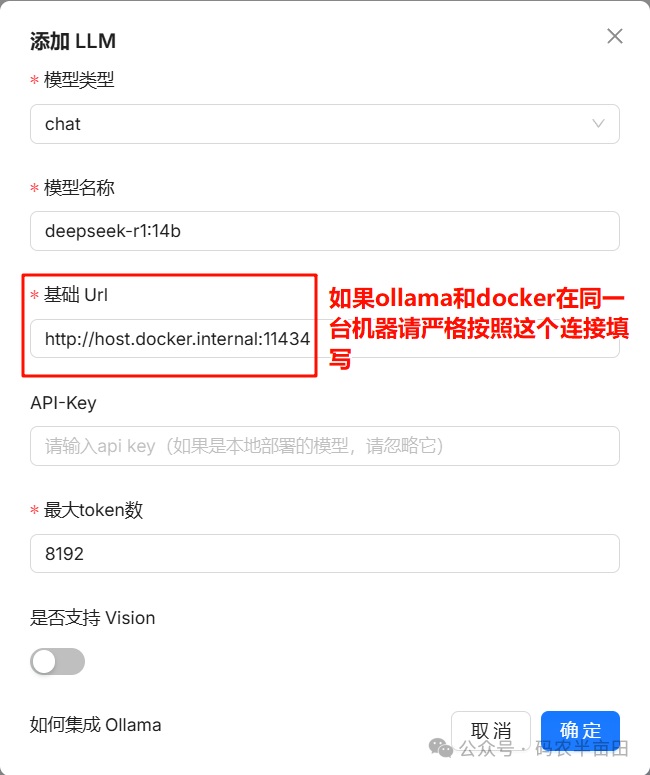
  2. 接着我们在 RagFlow 中配置模型,注意由于 RagFlow 是在 docker 中安装的,所以请求本地部署的 Ollama 地址要用 :host.docker.internal:11434,如果docker在局域网其他服务器上,则直接填写局域网http://局域网ip:11434
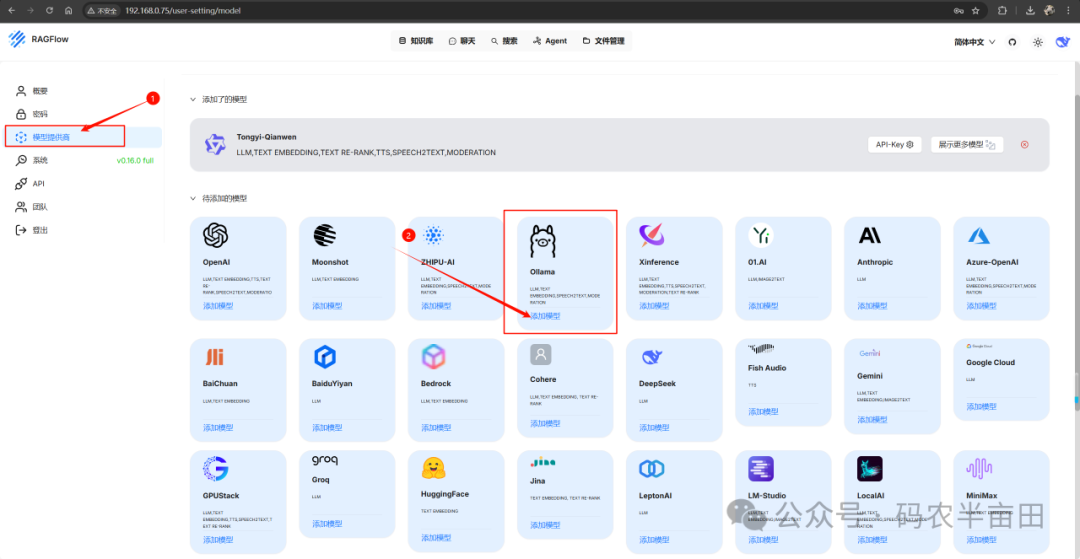
1. 选择模型提供商

2. 选择ollama
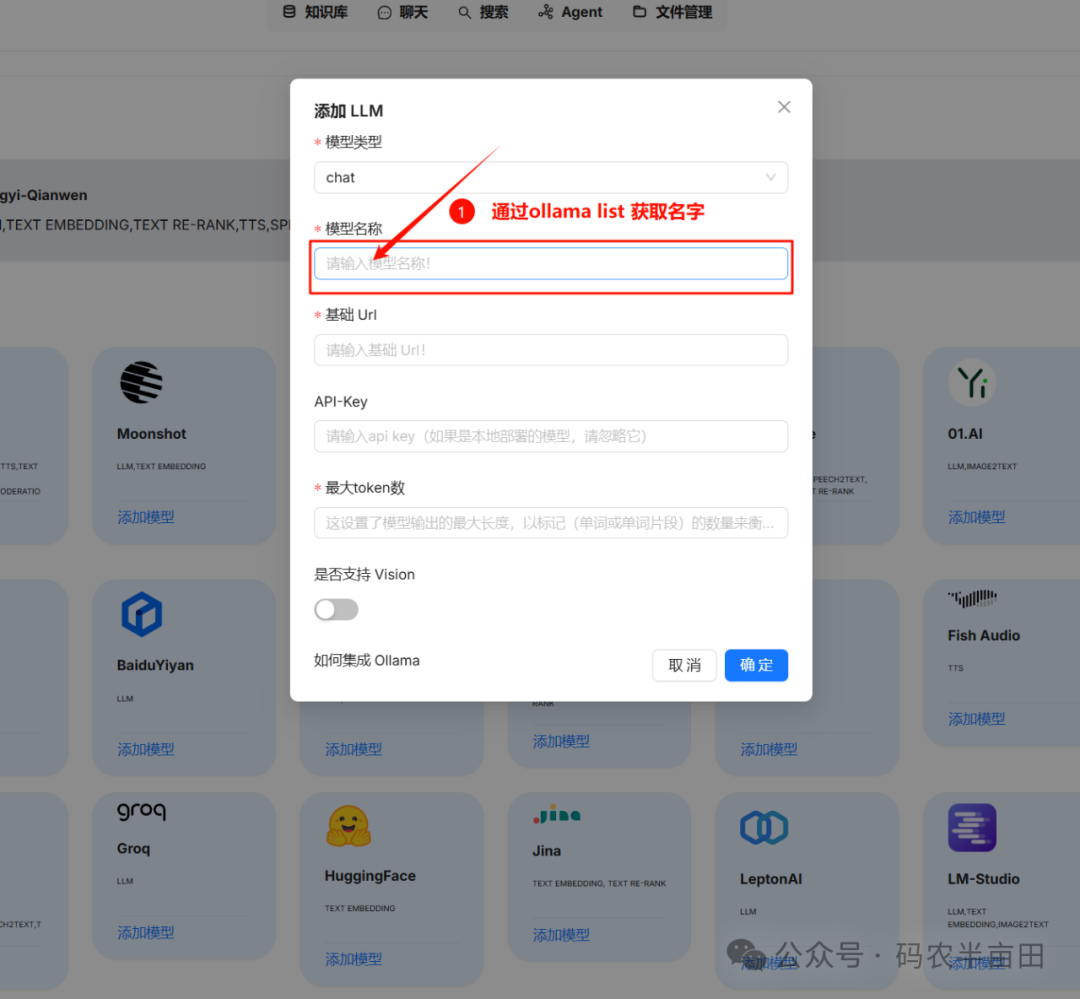
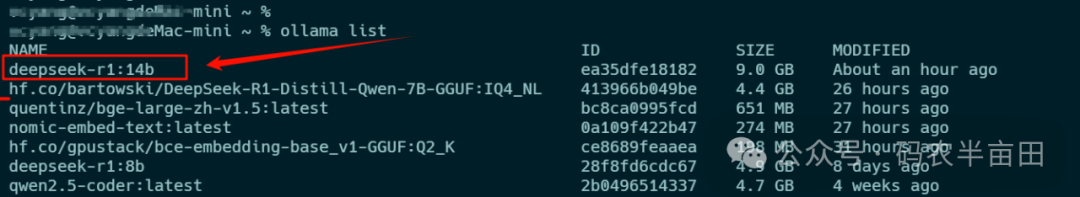
通过命令获取ollama模型列表

ollama list
最终信息填写如下:
创建知识库

接下来我们就可以创建知识库了
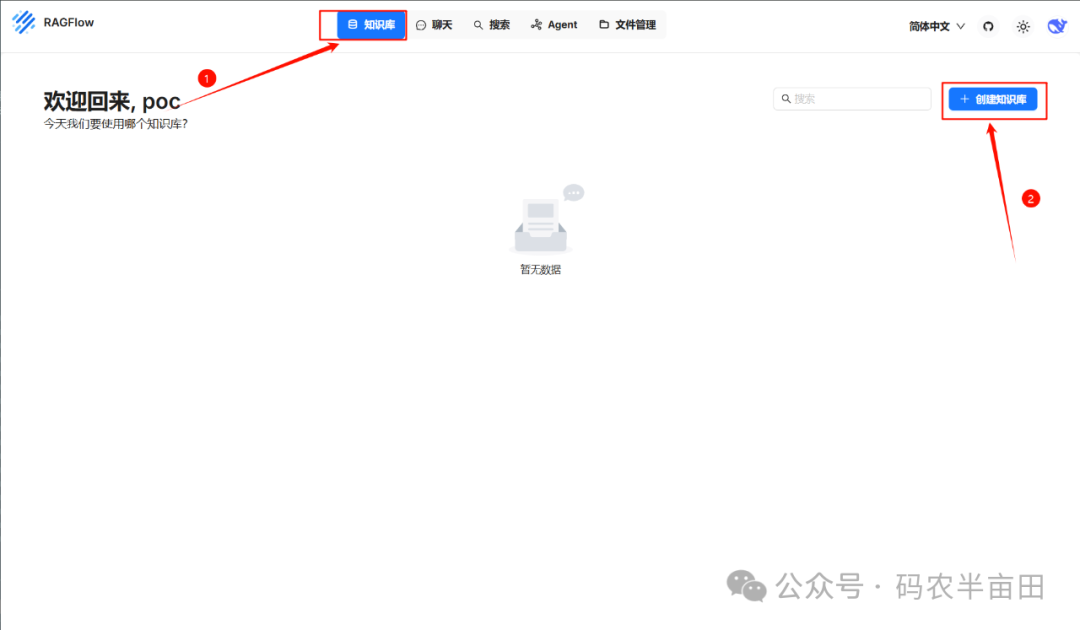
1. 选择知识库

2. 创建知识库

输入知识库名字
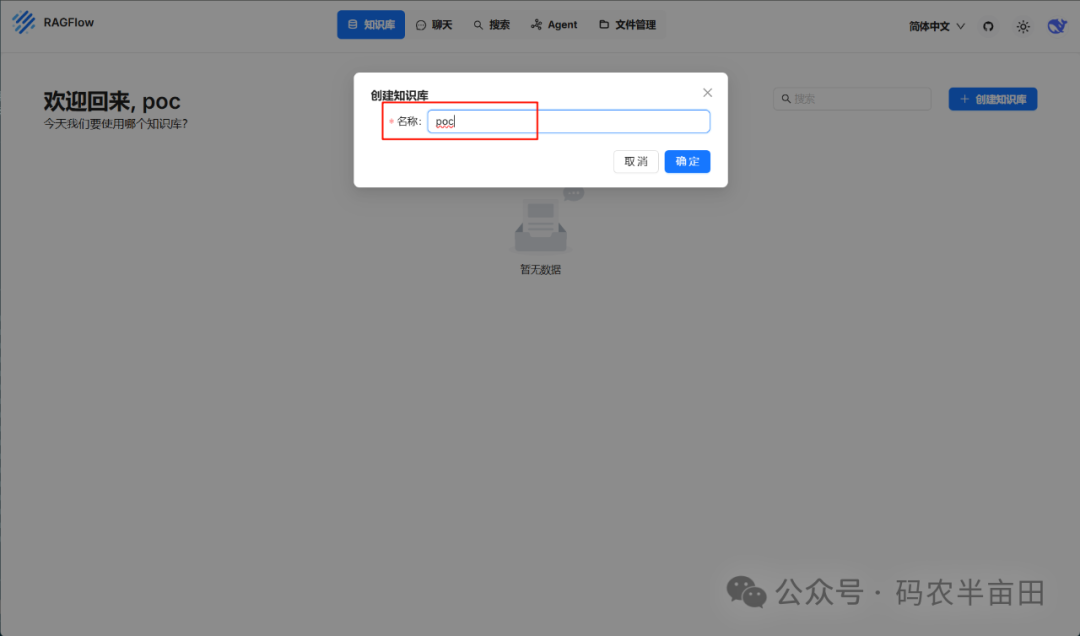
配置知识库属性
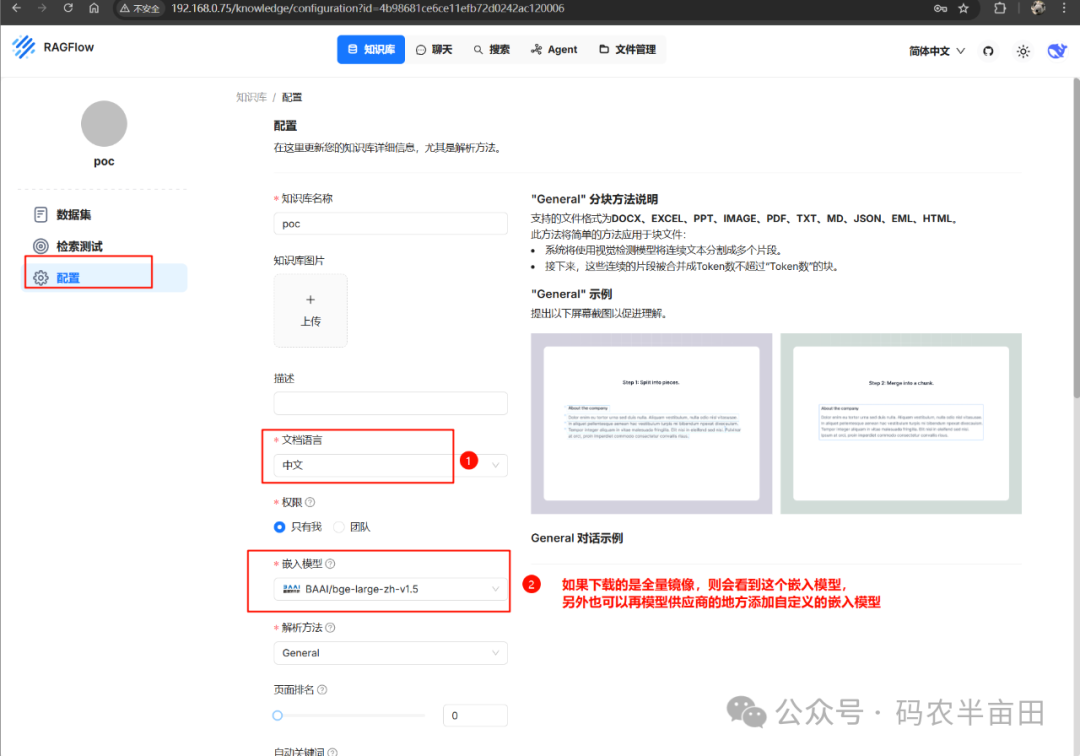
1 选择文档语言

2 如果下载是全量的RAGFlow镜像,会带有嵌入模型,可以按图中选择;另外也可以添加自定的嵌入模型,方法同前面的模型提供商设置

其他的选项,根据你的情况自行设置就好,很简单

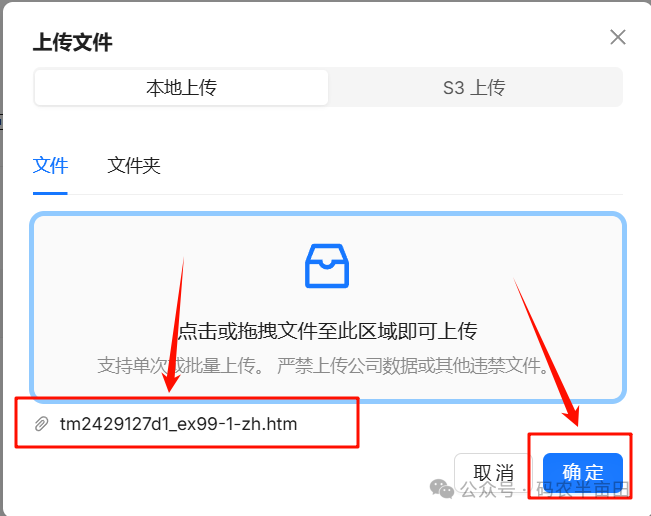
添加私有文档
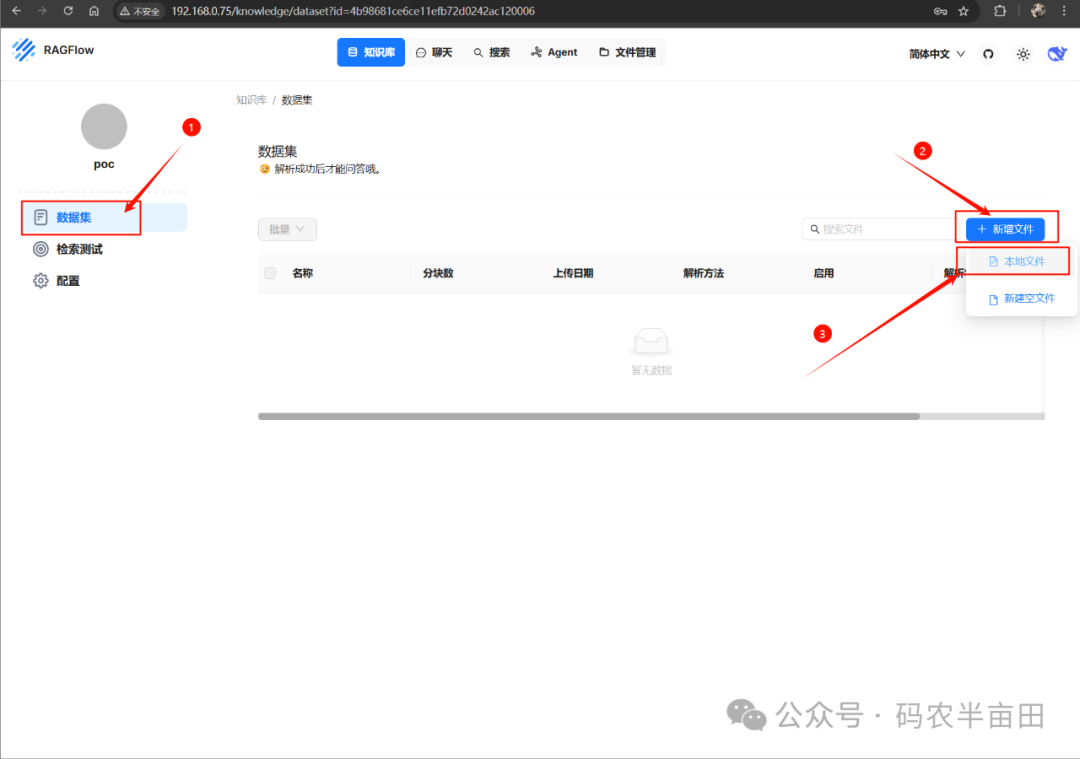
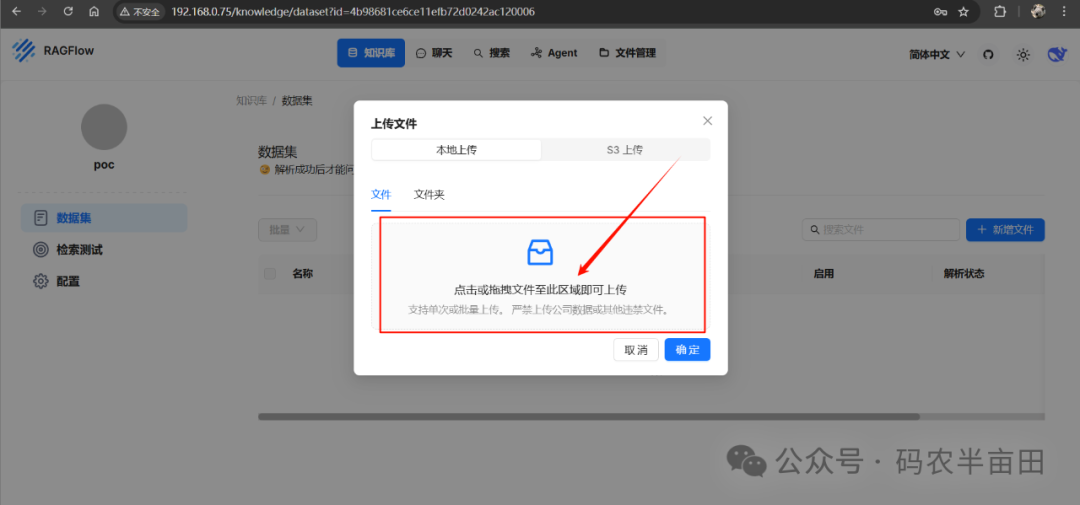
1. 选择数据集

2. 点击新建文件

3. 上传本地文档
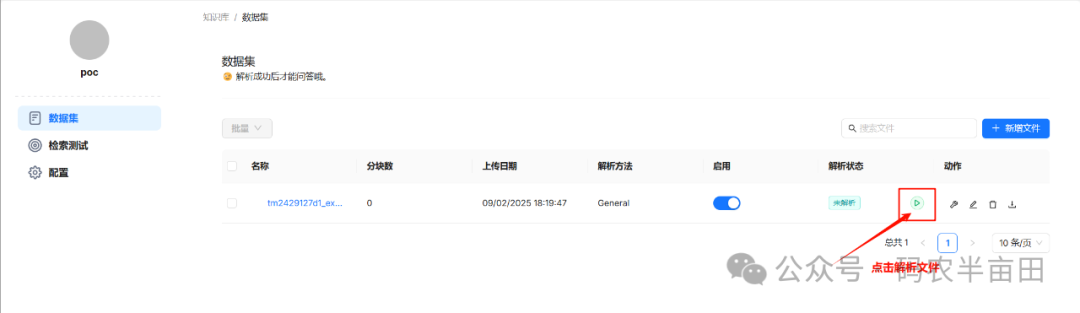
解析文档
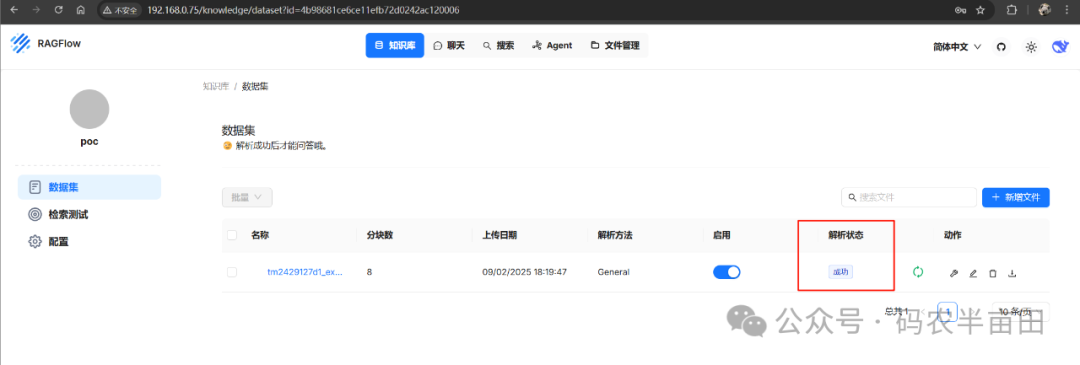
看下下面状态,说明文档解析完成
开启聊天

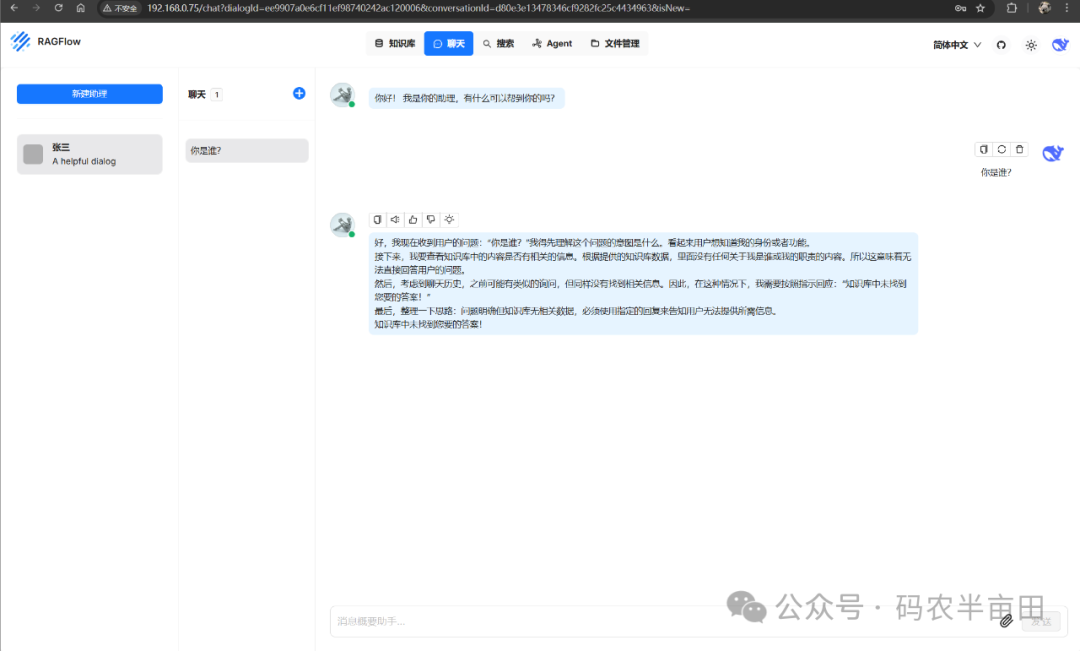
接着就到了展示成果的时候了,我们可以根据自己的知识库与模型进行自然语言交互了。

1. 选择聊天

2. 创建聊天助理

3. 填写助理名字:比如 张三

4. 选择刚才创建的知识库

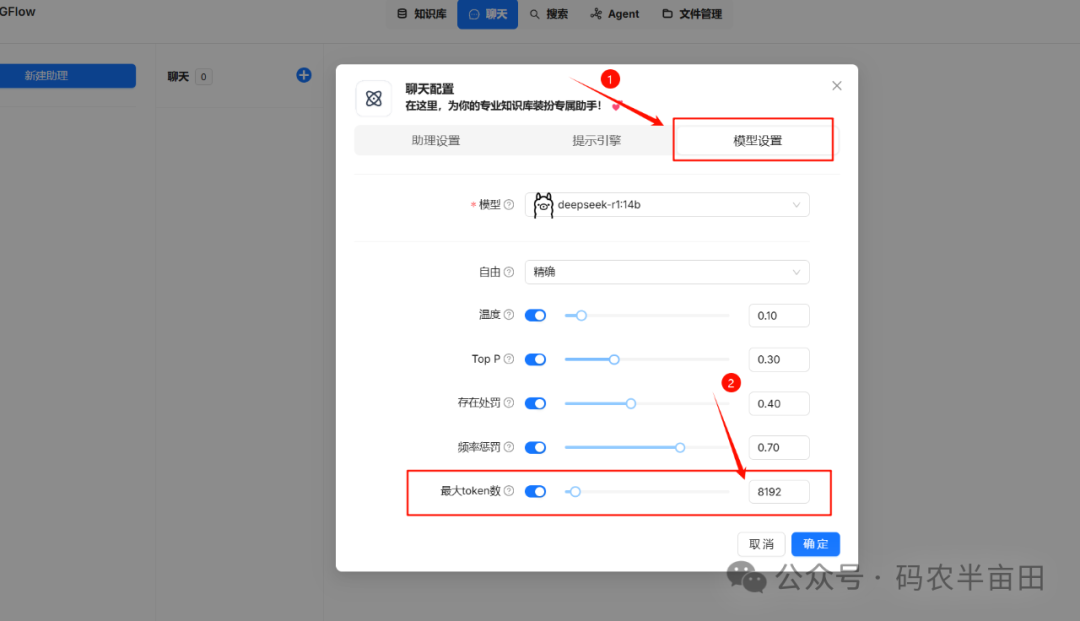
配置聊天模型,如下:

首先注意,在聊天配置中要把 token 设置大一些,不然回复的内容会很少!我这里把它拉到最大值了。
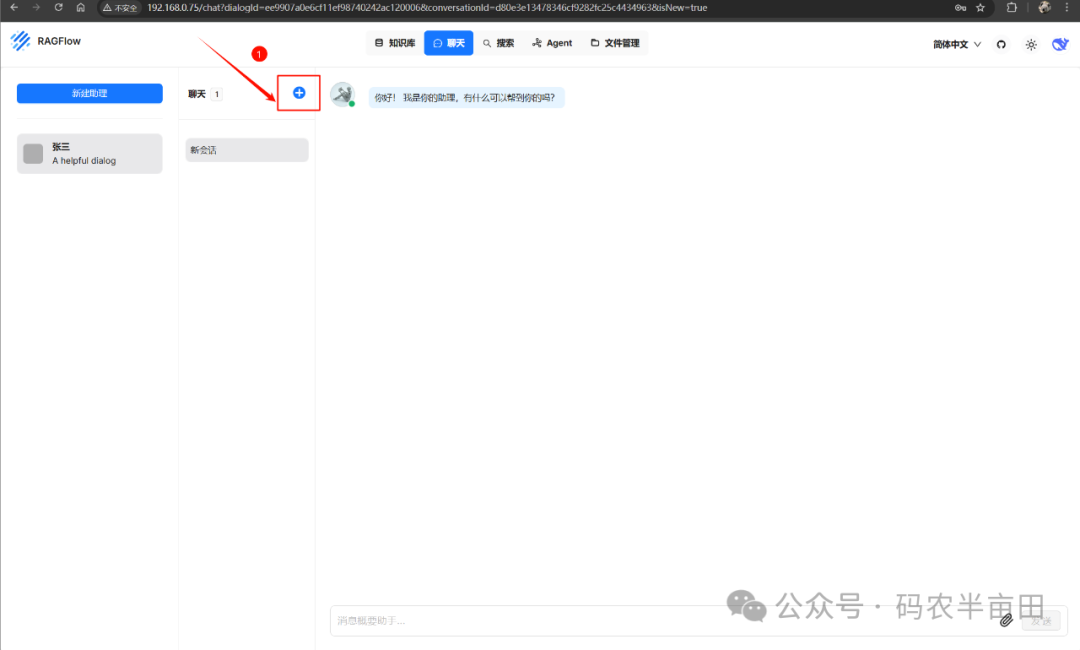
新建一个对话
数据验证
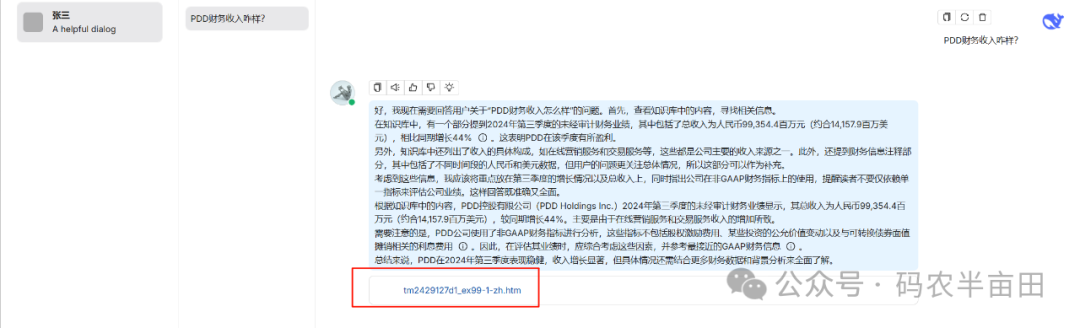
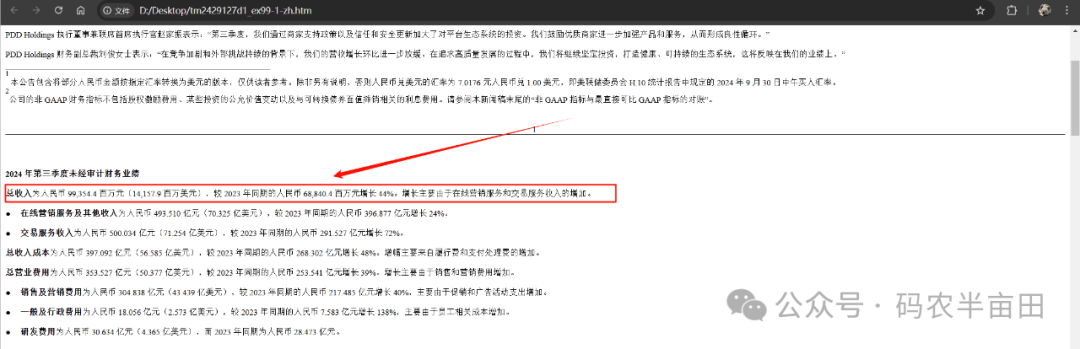
上面上传的文档是PDD的财务报表,截图中可以看到聊天内容召回了文档中的内容。

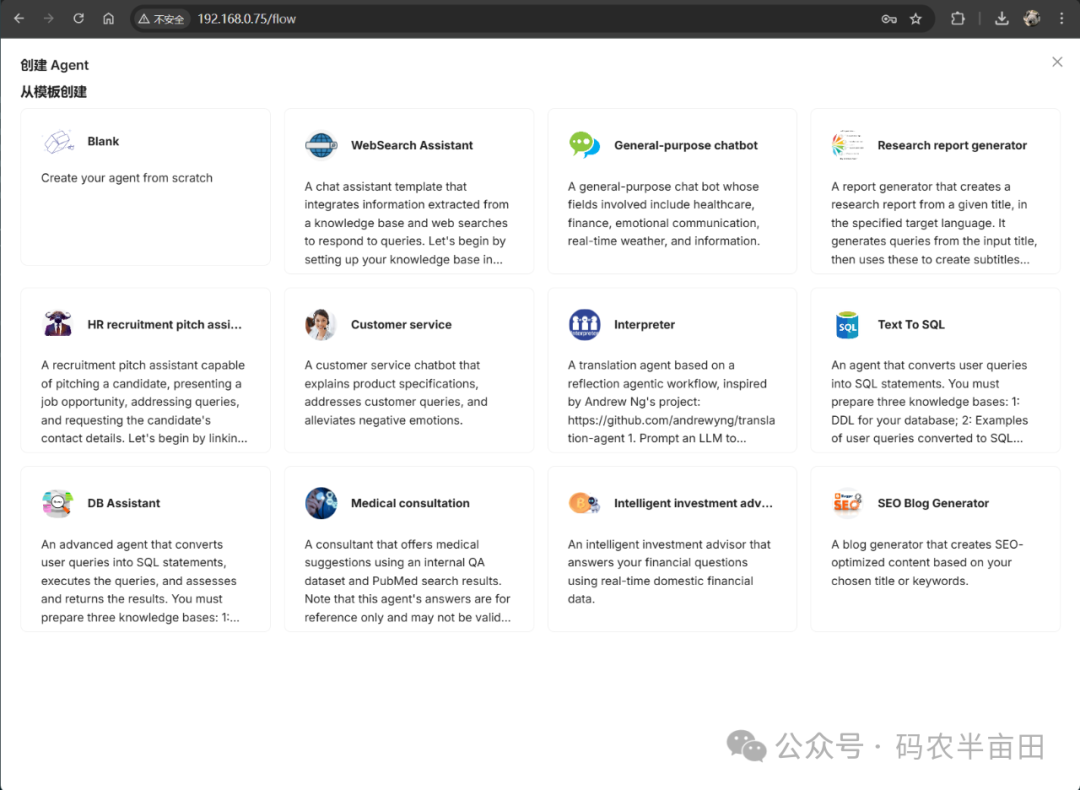
Agent功能

RAGFlow也支持agent功能,后面再进行探索
如何学习大模型 AI ?

由于新岗位的生产效率,要优于被取代岗位的生产效率,所以实际上整个社会的生产效率是提升的。

但是具体到个人,只能说是:

“最先掌握AI的人,将会比较晚掌握AI的人有竞争优势”。

这句话,放在计算机、互联网、移动互联网的开局时期,都是一样的道理。

我在一线互联网企业工作十余年里,指导过不少同行后辈。帮助很多人得到了学习和成长。

我意识到有很多经验和知识值得分享给大家,也可以通过我们的能力和经验解答大家在人工智能学习中的很多困惑,所以在工作繁忙的情况下还是坚持各种整理和分享。但苦于知识传播途径有限,很多互联网行业朋友无法获得正确的资料得到学习提升,故此将并将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。

在这里插入图片描述

第一阶段(10天):初阶应用

该阶段让大家对大模型 AI有一个最前沿的认识,对大模型 AI 的理解超过 95% 的人,可以在相关讨论时发表高级、不跟风、又接地气的见解,别人只会和 AI 聊天,而你能调教 AI,并能用代码将大模型和业务衔接。

  • 大模型 AI 能干什么?
  • 大模型是怎样获得「智能」的?
  • 用好 AI 的核心心法
  • 大模型应用业务架构
  • 大模型应用技术架构
  • 代码示例:向 GPT-3.5 灌入新知识
  • 提示工程的意义和核心思想
  • Prompt 典型构成
  • 指令调优方法论
  • 思维链和思维树
  • Prompt 攻击和防范
  • …

第二阶段(30天):高阶应用

该阶段我们正式进入大模型 AI 进阶实战学习,学会构造私有知识库,扩展 AI 的能力。快速开发一个完整的基于 agent 对话机器人。掌握功能最强的大模型开发框架,抓住最新的技术进展,适合 Python 和 JavaScript 程序员。

  • 为什么要做 RAG
  • 搭建一个简单的 ChatPDF
  • 检索的基础概念
  • 什么是向量表示(Embeddings)
  • 向量数据库与向量检索
  • 基于向量检索的 RAG
  • 搭建 RAG 系统的扩展知识
  • 混合检索与 RAG-Fusion 简介
  • 向量模型本地部署
  • …

第三阶段(30天):模型训练

恭喜你,如果学到这里,你基本可以找到一份大模型 AI相关的工作,自己也能训练 GPT 了!通过微调,训练自己的垂直大模型,能独立训练开源多模态大模型,掌握更多技术方案。

到此为止,大概2个月的时间。你已经成为了一名“AI小子”。那么你还想往下探索吗?

  • 为什么要做 RAG
  • 什么是模型
  • 什么是模型训练
  • 求解器 & 损失函数简介
  • 小实验2:手写一个简单的神经网络并训练它
  • 什么是训练/预训练/微调/轻量化微调
  • Transformer结构简介
  • 轻量化微调
  • 实验数据集的构建
  • …

第四阶段(20天):商业闭环

对全球大模型从性能、吞吐量、成本等方面有一定的认知,可以在云端和本地等多种环境下部署大模型,找到适合自己的项目/创业方向,做一名被 AI 武装的产品经理。

  • 硬件选型
  • 带你了解全球大模型
  • 使用国产大模型服务
  • 搭建 OpenAI 代理
  • 热身:基于阿里云 PAI 部署 Stable Diffusion
  • 在本地计算机运行大模型
  • 大模型的私有化部署
  • 基于 vLLM 部署大模型
  • 案例:如何优雅地在阿里云私有部署开源大模型
  • 部署一套开源 LLM 项目
  • 内容安全
  • 互联网信息服务算法备案
  • …

学习是一个过程,只要学习就会有挑战。天道酬勤,你越努力,就会成为越优秀的自己。

如果你能在15天内完成所有的任务,那你堪称天才。然而,如果你能完成 60-70% 的内容,你就已经开始具备成为一名大模型 AI 的正确特征了。

这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】

在这里插入图片描述

RagFlow 完全指南(一):从零搭建开源大模型应用平台(Ollama、VLLM本地模型接入实战) RagFlow 是一个基于深度文档理解的自动化 RAG(Retrieval-Augmented Generation)工作流工具,支持从多种复杂格式的非结构化数据中提取信息。其核心特性包括基于模板的文本切片、降低幻觉、兼容异构数据源以及支持大语言模型和向量模型的配置。RagFlow 提供了易用的 API,可轻松集成到企业系统中。安装与部署过程依赖于 Docker 和 Docker Compose,支持 CPU 和 GPU 环境。用户可以通过本地模型(如 Ollama 和 VLLM)进行接入,并提供了详细的配 阅读详情

相关推荐

RAGFlow+Dify:打造智能知识库搜索系统(windows版本)

本文介绍了windows将RAGflow与Dify平台深度集成的方案,打造高效知识库搜索系统。通过API对接实现文档解析、智能分片和混合检索功能,在Dify中创建工作流应用节点。该方案结合RAGflow的多模态处理能力和Dify的流程编排优势,实现了知识检索与LLM的协同增效。

applehunqiu的博客 2945

RAG 实践- Ollama+RagFlow 部署本地知识库

本文我们介绍另一种实现方式:利用 Ollama+RagFlow 来实现,其中 Ollama 中使用的模型仍然是Qwen2我们再来回顾一下 RAG 常见的应用架构。

python123456_的博客 6287

大模型系列17-RAGFlow搭建本地知识库

这里我们做的机器学习论文库,因此可以将“解析方法”从“General”调整为“Paper”模式,对论文进行解析。列出所有的模型,有两个Embedding模型以及一个qwen2:7b的模型。文件中,可以修改 端口号、ragflow的镜像版本等。参考写的安装open-webui的文章。将刚才添加的模型设置到系统默认配置中。新建一个论文助理,用于后续的聊天对话。ragflow使用的各种环境变量在。论文上传完毕后,执行论文内容的解析。论文解析过程,花了10几分钟。参考写的ollama的文档。

字节跳动 内推找我 2036

【开源大模型】一篇文章快速了解Ollama+本地知识库创建

Ollama是一个便于用户在本地部署和管理开源大语言模型的应用框架,极大简化了开源大语言模型的安装和配置细节。

pythonhy的博客 6831

基于RAGFlow构建私有知识库:从原理到部署的完整实践指南

检索增强生成(RAG)是一种将信息检索与大型语言模型生成能力相结合的技术范式。其核心原理是通过向量化技术将文档转换为语义向量,并利用向量数据库进行高效相似性检索,将检索到的相关上下文作为增强信息输入给大模型,从而生成精准、可溯源的答案。这项技术的核心价值在于有效解决了大模型的“幻觉”问题和知识更新滞后难题,实现了外部知识的高效利用。在应用场景上,RAG技术广泛应用于构建企业级智能客服、个人知识管理助手以及内部文档问答系统等。本文聚焦于如何利用开源RAG引擎RAGFlow,实战构建一个安全、可控的私有知识库,

446

知识库搭建实战二十、Ollama+RagFlow 部署本地知识库

通过以上步骤,你已经成功在 Windows 系统上通过 Docker 部署了一个本地化的大模型知识库,结合 RagFlow 和 Ollama,安装了通义千问2 7B 模型和中文 Embedding 模型,构建了一个支持中文问答的系统。这种设置适用于企业内部知识管理、自动化客服、智能问答等场景。

xiaoqi270620903的专栏 9839

用Ollama+RAGflow打造私有知识库,全程干货,零基础小白也能轻松掌握!

Ollama 是一个本地运行的大语言模型(LLM)工具平台,允许用户在本地设备上运行和管理大模型,而无需依赖云服务。它支持多种开源模型,并提供了用户友好的接口,非常适合开发者和企业使用。

嘴巴吃糖了 2811

Quartz定时任务调度框架中的Misfire策略实战解析

本文深入解析了Quartz定时任务调度框架中的Misfire(失火)处理策略。针对SimpleTrigger和CronTrigger两种常用触发器,详细对比了其各自的Misfire指令(如NowWithExistingCount、FireAndProceed等)的核心行为与适用场景,并提供了基于不同业务需求(如数据补跑、时间点敏感度)的实战选型指南,帮助开发者构建更健壮可靠的任务调度系统。

weixin_29250573的博客 78

大模型喂饭教程:用Ollama+RAGflow打造私有知识库

Ollama 是一个本地运行的大语言模型(LLM)工具平台,允许用户在本地设备上运行和管理大模型,而无需依赖云服务。它支持多种开源模型,并提供了用户友好的接口,非常适合开发者和企业使用。首先,从 Ollama 官网 下载安装包,并按照提示完成安装。Windows下搜索ollama,然后点击启动Ollama 提供了几个简单易用的命令,基本功能如下: 拉取模型并运行 llama pull 具体的模型,这里以deepseek为例 运行模型并对话,–verbose参数可以显示token信息 信息如下:资源占用情况:

2401_85375186的博客 1063

微生物16S数据上传NCBI的SRA库

本篇内容仅包括:俺自己的实验收集了淡水、淡水沉积物、海水、海草附着微生物样品,测序所得的Fastq格式数据,在文章投稿发表时被要求数据需上传NCBI的SRA库,得到一个PRJNA2347899这样子的IDs。仅解决了这个上传过程!

Xf_Niu的博客 7436

Arcgis空间分布方向性分析

Arcgis空间分布方向性分析 一、标准差椭圆方法概述 空间分布方向性分析是指区域经济属性在空间分布上的轮廓和主导方向。 标准差椭圆法是分析空间分布方向性特征的经典方法之一,使用标准差椭圆可 从全局的、空间的角度定量解释经济要素空间分布的中心性、展布性、方向性和 空间形态等整体性特征,因其直观性与有效性已得到广泛应用,已成为 Arc GIS 空间统计模块的常规统计工具。SDE 方法生成的结果为一个椭圆,从其生 成算法来看,首先用平均中心来确定椭圆的圆心,然后由平均中心作为起点 对 X 坐标

端木宛白的博客家园 4万+

【2025版】用Ollama+RAGflow打造私有知识库,从零基础到精通,精通收藏这篇就够了!

Ollama 是一个本地运行的大语言模型(LLM)工具平台,允许用户在本地设备上运行和管理大模型,而无需依赖云服务。它支持多种开源模型,并提供了用户友好的接口,非常适合开发者和企业使用。Usage:serve 启动 Ollama 服务create 从 Modelfile 创建一个模型show 查看模型详细信息run 运行一个模型stop 停止正在运行的模型pull 从注册表拉取一个模型push 将一个模型推送到注册表list 列出所有可用的模型ps 列出当前正在运行的模型。

Libra1313的博客 2093

Centos7安装NVIDIA驱动并在docker容器中使用GPU

Centos7安装NVIDIA驱动并在docker容器中使用GPU

运维giao的博客 2085

Ollama + RAGFlow 打造本地私有知识库问答

基于Ollama和RAGFlow搭建本地智能问答系统 摘要:本文介绍如何利用开源工具Ollama和RAGFlow构建完全本地化的智能问答系统,支持PDF、Word等文档解析,确保数据不出内网。通过Docker部署RAGFlow,配置Ollama运行Llama3等本地大模型,实现私有文档的知识库转化。系统支持中文问答,提供精准答案并标注来源,适用于企业知识管理。包含环境配置、模型部署、知识库创建等完整流程,以及高级定制技巧,如本地Embedding模型和Prompt模板优化。(149字)

huangfuyk.的博客 2047

.ipynb文件深度解析:从JSON结构到Jupyter Notebook高效使用指南

在Python开发与数据处理领域,交互式编程正成为探索数据与验证思路的高效方式。Jupyter Notebook作为最流行的交互式环境之一,其默认文件格式.ipynb本质是一个基于JSON的文本文件,内部通过单元格组织代码、说明文字与运行结果。理解其JSON结构,不仅有助于掌握Notebook的存储原理,更能为文件损坏修复、版本控制与自动化转换提供基础。依托对单元格类型、魔法命令及输出可视化的熟练运用,数据分析和数据可视化流程可以变得更为流畅。同时,借助VS Code、nbconvert等工具,开发者能将.

weixin_28839629的博客 353

硬核技术组合!用 DeepSeek R1、Ollama、Docker、RAGFlow 打造专属本地知识库

本地部署DeepSeek R1 + Ollama + RAGFlow构建个人知识库,通过将数据完全存储在本地硬盘,彻底杜绝隐私泄露风险,规避云端服务不稳定导致的延迟或中断问题;借助RAGFlow的自定义知识库能力,可精准解析专业文档(如法律、医疗资料),突破通用大模型的领域局限,实现高效检索与智能问答,打造安全、稳定且持续进化的专属知识中枢。

笃行其道的博客 1万+

下水管道损坏检测数据集总结

下水管道损坏检测数据集包含 6708 张图像,为下水管道损坏情况的检测提供了丰富的数据基础。该数据集提供了 YOLO 和 VOC 两种常见的标注方式,方便不同需求的使用者进行模型训练和研究。

crz1336768325的博客 870

win11+deepseek+ollama+ragflow+docker打造个人知识库

建立关于一个类别的知识库,然后上床相关的资料文档,切记一定要解析成功才可使用,过程并无大多问题,但在知识库建立后聊天问答时可能会遇到一些问题,这里总结两条我遇到了的。导入模型时间比较长,可尝试科学上网,模型导完后可用以下命令测试模式是否导入成功,也可直接用上一步代码运行导入的大模型,输入hello测试大模型是否正常回答。设置环境变量,这个很重要很重要,模型存放位置最好放在非系统盘中,否则后期模型会引爆C盘,设置完后一定先重启系统在导入大模型.url中的ip地址要选择wsl中的虚拟地址,而不是本机ip地址。

wxsgyf的博客 1980

一张图看懂 ABAP CDS 两大子语言:CDS DDL 与 CDS DCL 以及缺席的 DML

ABAP CDS 的核心设计思想围绕语义数据模型(DDL)与数据访问控制(DCL)展开,而非单纯作为SQL查询工具。其DDL通过声明式语法定义业务导向的数据视图,强调模型稳定性与复用性;DCL则将访问控制逻辑下沉到模型层,实现行级权限过滤。ABAP CDS刻意剥离DML功能,交由ABAP SQL处理数据变更,形成清晰的分层架构。这种设计使数据定义、访问控制与应用逻辑解耦,为现代ABAP应用提供更安全、可维护的数据治理方案。

2007 年 ~ 2025 年,深耕 SAP 技术 18 年 976

怀旧版电脑GBC模拟器

再现原版GBC掌机的界面,电脑运行连游戏界面都一样大小,很怀旧,很真实,(英文版)强烈推荐,很小的文件,很难才找到的。

手把手教你DeepSeek-R1本地部署和企业知识库搭建(Ollama+DeepSeek+RAGFlow)【保姆级教学】

手把手教你如何搭建企业知识库!速来

**My Coding Family** 23万+

Data-Structures-and-Algorithm-Analysis-in-Java.pdf

作者: Weiss, Mark A. 出版社: Addison Wesley Data Structures and Algorithm Analysis in Java is an “advanced algorithms” book that fits between traditional CS2 and Algorithms Analysis courses. In the old ACM Curriculum Guidelines, this course was known as CS7. This text is for readers who want to learn good programming and algorithm analysis skills simultaneously so that they can develop such programs with the maximum amo...

Windows下部署本地知识库全教程:RAGFlow+Ollama打造专属AI助手

本文详细介绍了在Windows系统下使用RAGFlow和Ollama部署本地知识库的全过程,包括系统环境配置、模型下载与管理、知识库创建与参数设置、对话助手开发与分享等步骤。通过本教程,读者可以搭建完全本地化或半本地化的知识库系统,实现基于自有数据的智能问答,无需依赖云端API即可享受大模型带来的便利,同时保护数据隐私。文章提供了详细的操作指导和参数配置建议,适合有一定编程基础的开发者学习实践。

程序员鑫港的博客 1759

数学建模模型总结

这是本人在两年内准备参加数学建模竞赛搜集到的模型资料,已经经过了本人的筛选和整理,希望能够对准备参加数学建模竞赛的学弟学妹们提供一些帮助!

精雕软件(JDpaint) 5.5 绿色版

精雕软件(JDpaint) 5.5 绿色版精雕软件(JDpaint) 5.5 绿色版精雕软件(JDpaint) 5.5 绿色版

RagFlow本地部署使用

开源RAGFlow引擎:打造无幻觉、高精度的文档理解与生成体验RAGflow,这个新兴的开源RAG(Retrieval-Augmented Generation)引擎,正以其独特的深度文档理解能力,为大型语言模型的应用带来了革命性的变革。在处理PDF文件时,我们经常面临提取干净数据的挑战,而RAGFlow的出现,恰恰解决了这一问题,它能够提供准确无误且无幻觉的生成结果。

qq_43548590的博客 4万+

从零开始:利用DeepSeek与RAGFlow打造企业级私有知识库

本文详细指导如何利用DeepSeek与RAGFlow构建企业级私有知识库,实现数据本地化部署与安全管控。文章从RAG与Embedding技术原理讲起,逐步拆解环境配置、系统部署、知识库创建及智能问答全流程,并深入探讨了生产环境下的性能优化、安全集成等进阶议题,为企业打造专属、可控的AI知识中枢提供完整方案。

whisky的博客 1020
上一篇: 最全 Ollama 大模型部署指南
下一篇: 从 AI Agents 到 Agentic Workflows 的 AI 进化阶梯:技术演进的底层逻辑与商业价值
Python_金钱豹
博客等级 码龄5年 1万+粉丝 2841原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值