构建企业私有RAG大模型: DeepSeek-R1干翻OpenAI-o1-mini,开源部署走起(可商用)

Ollama本地部署DeepSeek-R1实战:开源模型高效运行指南 大语言模型(LLM)本地化运行已成为AI工程落地的关键路径,其核心在于构建轻量、兼容、可控的模型运行时环境。Ollama作为主流开源模型运行框架,通过抽象CUDA兼容层、内置GGUF量化支持与OpenAI API网关,显著降低了本地大模型部署门槛。结合DeepSeek-R1在中文理解、代码生成与低显存推理上的工程优势,用户可在RTX3060等主流消费级GPU上实现首token延迟<0.7秒的交互体验。该方案不仅规避网络依赖与数据外泄风险,更支撑RAG文档分析、Dify低代码集成、VSCode智能编程等真实场 阅读详情
AI摘要

DeepSeek-R1模型以低成本实现与OpenAI o1模型相当或更优性能,开源部署推动大模型AI发展。DeepSeek团队开源了基于R1的多个精简模型,其中DeepSeek-R1-Distill-Qwen-32B在基准测试中超越o1-mini。DeepSeek-R1的训练和部署方法被详细说明,同时提供了从初阶到商业闭环的AI大模型学习路径。

DeepSeek-R1模型以仅占OpenAI o1模型3%-5%的成本,便实现了与o1相当或甚至超越的性能,这一创新成果令人震惊,标志着DeepSeek-R1的诞生可能正在重新定义大模型发展的战略。

在数学、编程及推理任务方面,DeepSeek-R1已成功达到了与OpenAI o1相媲美的性能。为了支持研究社区的发展,DeepSeek团队开源了DeepSeek-R1-Zero、DeepSeek-R1及基于Llama和Qwen从DeepSeek-R1衍生出的六个精简模型。其中,DeepSeek-R1-Distill-Qwen-32B在多个基准测试中超越了OpenAI-o1-mini,为密集型模型带来了全新的最先进成果。

DeepSeek-R1-Zero与DeepSeek-R1均基于DeepSeek-V3-Base进行训练,而DeepSeek-R1-Distill模型则经过Llama和Qwen的微调,使用DeepSeek-R1生成的样本进行配置,并对分词器做了轻微调整。

DeepSeek-R1及其衍生的六个精简模型在性能评估上表现出了极为出色的结果,在许多方面,R1的表现都超越了V3,成为了行业的标杆。

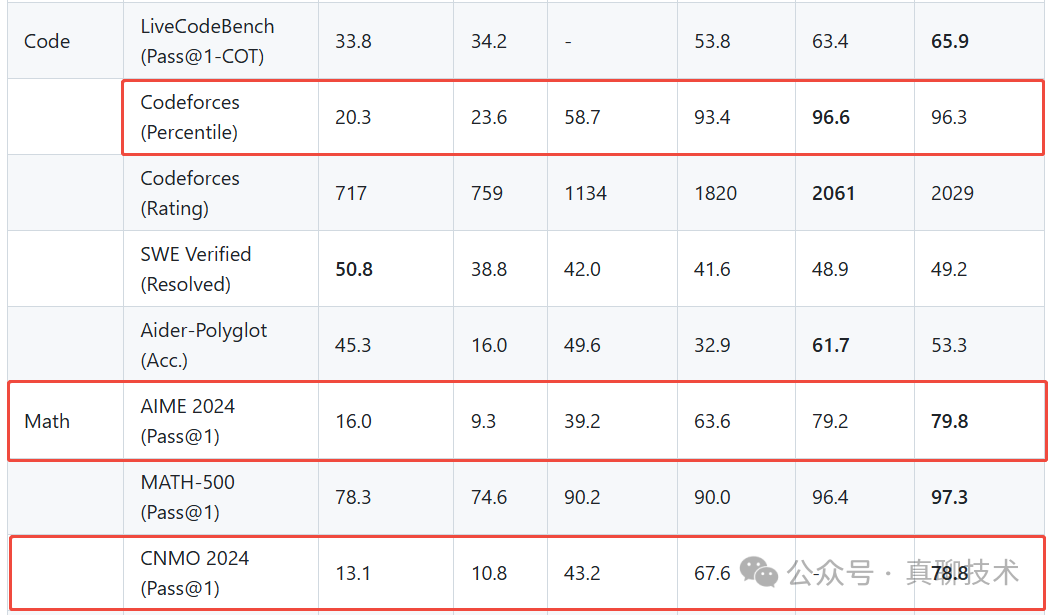
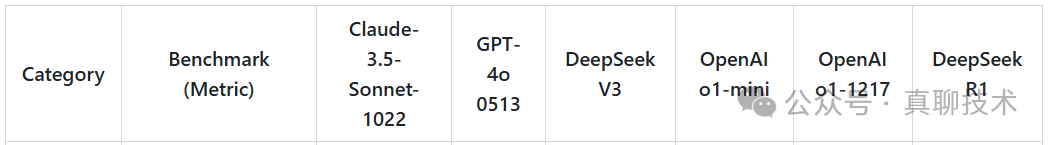
下表是DeepSeek-R1官网给出评估报告:
官网评估部分截取

从这份测试报告中可以看出,DeepSeek-R1在代码(Code)和数学(Math)领域的表现全面超越了几款闭源模型,特别是OpenAI的o1-mini。报告显示,DeepSeek-R1的性能不仅超越了o1-mini,还全面超过了V3。R1的问世,不仅在国内引起了广泛的关注,也对国际大模型市场产生了巨大冲击,迅速引起了OpenAI等科技巨头的高度关注。
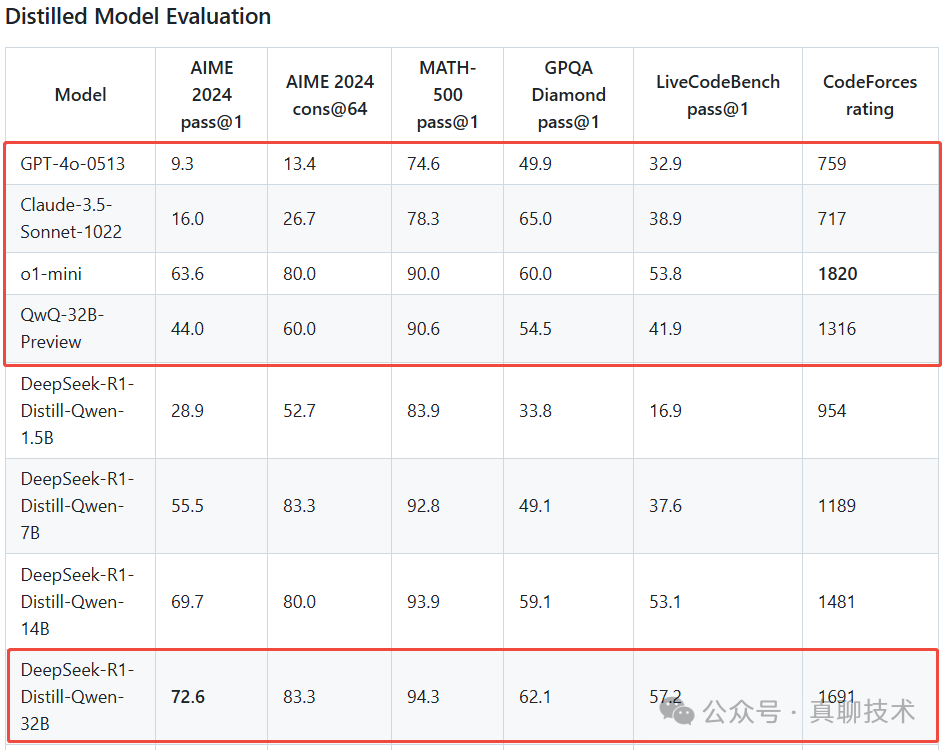
官网评估部分截取

上表是基于Llama和Qwen从DeepSeek-R1衍生出的六个精简模型的测试报告,性能同样亮眼。尤其是DeepSeek-R1-Distill-Qwen-32B模型,各项指标均高于GPT-4o0513、Claude-3.5-Sonnet-1022、o1-mini等三个最受关注的闭源模型。

那么DeepSeek-R1是如何产生的?

DeepSeek-R1的诞生

DeepSeek在推出第一代推理模型 DeepSeek-R1-Zero 和 DeepSeek-R1。DeepSeek-R1-Zero 是一种通过大规模强化学习 (RL) 训练的模型,无需监督微调 (SFT) 作为初步步骤,在推理方面表现出色。在 RL 的帮助下,DeepSeek-R1-Zero 自然而然地出现了许多强大而有趣的推理行为。然而,DeepSeek-R1-Zero 面临着诸如无休止重复、可读性差和语言混合等挑战。为了解决这些问题并进一步提高推理性能,他们引入了 DeepSeek-R1,它在 RL 之前整合了冷启动数据。DeepSeek-R1 在数学、代码和推理任务中实现了与 OpenAI-o1 相当的性能。同时公司还从DeepSeek-R1 以及基于 Llama 和 Qwen 从 DeepSeek-R1 中提炼出的六个密集模型。 其中DeepSeek-R1-Distill-Qwen-32B 在各种基准测试中均优于 OpenAI-o1-mini。

训练后:基础模型上的大规模强化学习(说明来自DeepSeek-R1)

  • 我们直接将强化学习 (RL) 应用于基础模型,而无需依赖监督微调 (SFT) 作为初步步骤。这种方法允许模型探索解决复杂问题的思路 (CoT),从而开发出 DeepSeek-R1-Zero。DeepSeek-R1-Zero 展示了自我验证、反思和生成长 CoT 等功能,标志着研究界的一个重要里程碑。值得注意的是,这是第一个公开研究,验证了 LLM 的推理能力可以纯粹通过 RL 来激励,而无需 SFT。这一突破为该领域的未来发展铺平了道路。

  • 我们引入了用于开发 DeepSeek-R1 的流水线。该流水线包含两个 RL 阶段,旨在发现改进的推理模式并与人类偏好保持一致,以及两个 SFT 阶段,作为模型推理和非推理能力的种子。我们相信该流水线将通过创建更好的模型使行业受益。

DeepSeek-R1部署

DeepSeek-R1 基于 DeepSeek-V3-Base 进行训练。所以R1的部署可以参考V3的部署。

DeepSeek-R1-Distill 模型部署

DeepSeek-R1-Distill 模型可以与 Qwen 或 Llama 模型相同的方式使用。我们以DeepSeek-R1-Distill-Qwen-32B为例,讲讲如何使用开源加速工具部署。

模型下载,使用hf-mirror实现下载

cd deepseek-ai``git clone https://hf-mirror.com/deepseek-ai/DeepSeek-R1-Distill-Qwen-32B

使用vLLM部署,请执行以下命令:

export CUDA_VISIBLE_DEVICES=0,1``vllm serve deepseek-ai/DeepSeek-R1-Distill-Qwen-32B --tensor-parallel-size 2 --max-model-len 32768 --enforce-eager

使用SGLang部署,请执行以下命令:

export CUDA_VISIBLE_DEVICES=0,1``python3 -m sglang.launch_server --model deepseek-ai/DeepSeek-R1-Distill-Qwen-32B --trust-remote-code --tp 2

以vLLM为例进行命令解析:

  • vllm serve: 这是启动 vLLM 服务的命令,vLLM 用于优化大型语言模型(LLM)的推理效率。

  • deepseek-ai/DeepSeek-R1-Distill-Qwen-32B: 这是所要加载的模型名称。在这里,指定了 DeepSeek-R1-Distill-Qwen-32B 这个模型,属于 DeepSeek 系列,且经过蒸馏(Distill)处理的版本,适合大规模推理任务。

  • --tensor-parallel-size 2: 这是设置模型分布式并行的参数,具体指定了分布式计算时的 tensor parallel 大小。值 2 表示将模型分割成两个部分,使用两块 GPU 来共同处理模型的计算,适用于大模型的高效推理。

  • --max-model-len 32768: 该参数指定了模型最大处理的输入长度,这里设置为 32,768。这个参数决定了模型在处理文本时,能够一次性处理的最大 token 数量。较大的模型长度有助于处理较长的上下文。

  • --enforce-eager: 这个参数启用 eager execution 模式,意味着模型的推理将在计算时立即进行,而不等待所有操作被构建好后再进行。这种方式可以在某些情况下提高推理的灵活性和效率,但也可能增加内存开销。

DeepSeek-R1-Distill-Qwen-32B模型较大,如果是A100、H100的卡,2张可以启动,但是4090卡2张就不能启动了,会报GPU内存溢出,所以如果你使用4090至少设置4张卡。

写在最后

DeepSeek-R1 的诞生将对大模型领域产生深远影响。首先,它在数学推理和代码理解方面的突破,推动了这些领域的技术进步。其次,DeepSeek-R1的成功应用将激励更多行业定制化大模型的需求,促使企业在特定领域开发适应性更强的模型。此外,凭借其高效的推理能力和低成本优势,DeepSeek-R1将推动开源大模型的普及,降低技术门槛,促进更多中小企业的应用。而其在推理效率、内存管理和分布式计算等方面的创新,也将激发大模型领域的进一步优化,推动技术的持续进步。

如何学习大模型 AI ?

由于新岗位的生产效率,要优于被取代岗位的生产效率,所以实际上整个社会的生产效率是提升的。

但是具体到个人,只能说是:

“最先掌握AI的人,将会比较晚掌握AI的人有竞争优势”。

这句话,放在计算机、互联网、移动互联网的开局时期,都是一样的道理。

我在一线互联网企业工作十余年里,指导过不少同行后辈。帮助很多人得到了学习和成长。

我意识到有很多经验和知识值得分享给大家,也可以通过我们的能力和经验解答大家在人工智能学习中的很多困惑,所以在工作繁忙的情况下还是坚持各种整理和分享。但苦于知识传播途径有限,很多互联网行业朋友无法获得正确的资料得到学习提升,故此将并将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。

在这里插入图片描述

第一阶段(10天):初阶应用

该阶段让大家对大模型 AI有一个最前沿的认识,对大模型 AI 的理解超过 95% 的人,可以在相关讨论时发表高级、不跟风、又接地气的见解,别人只会和 AI 聊天,而你能调教 AI,并能用代码将大模型和业务衔接。

  • 大模型 AI 能干什么?
  • 大模型是怎样获得「智能」的?
  • 用好 AI 的核心心法
  • 大模型应用业务架构
  • 大模型应用技术架构
  • 代码示例:向 GPT-3.5 灌入新知识
  • 提示工程的意义和核心思想
  • Prompt 典型构成
  • 指令调优方法论
  • 思维链和思维树
  • Prompt 攻击和防范
  • …

第二阶段(30天):高阶应用

该阶段我们正式进入大模型 AI 进阶实战学习,学会构造私有知识库,扩展 AI 的能力。快速开发一个完整的基于 agent 对话机器人。掌握功能最强的大模型开发框架,抓住最新的技术进展,适合 Python 和 JavaScript 程序员。

  • 为什么要做 RAG
  • 搭建一个简单的 ChatPDF
  • 检索的基础概念
  • 什么是向量表示(Embeddings)
  • 向量数据库与向量检索
  • 基于向量检索的 RAG
  • 搭建 RAG 系统的扩展知识
  • 混合检索与 RAG-Fusion 简介
  • 向量模型本地部署
  • …

第三阶段(30天):模型训练

恭喜你,如果学到这里,你基本可以找到一份大模型 AI相关的工作,自己也能训练 GPT 了!通过微调,训练自己的垂直大模型,能独立训练开源多模态大模型,掌握更多技术方案。

到此为止,大概2个月的时间。你已经成为了一名“AI小子”。那么你还想往下探索吗?

  • 为什么要做 RAG
  • 什么是模型
  • 什么是模型训练
  • 求解器 & 损失函数简介
  • 小实验2:手写一个简单的神经网络并训练它
  • 什么是训练/预训练/微调/轻量化微调
  • Transformer结构简介
  • 轻量化微调
  • 实验数据集的构建
  • …

第四阶段(20天):商业闭环

对全球大模型从性能、吞吐量、成本等方面有一定的认知,可以在云端和本地等多种环境下部署大模型,找到适合自己的项目/创业方向,做一名被 AI 武装的产品经理。

  • 硬件选型
  • 带你了解全球大模型
  • 使用国产大模型服务
  • 搭建 OpenAI 代理
  • 热身:基于阿里云 PAI 部署 Stable Diffusion
  • 在本地计算机运行大模型
  • 大模型的私有化部署
  • 基于 vLLM 部署大模型
  • 案例:如何优雅地在阿里云私有部署开源大模型
  • 部署一套开源 LLM 项目
  • 内容安全
  • 互联网信息服务算法备案
  • …

学习是一个过程,只要学习就会有挑战。天道酬勤,你越努力,就会成为越优秀的自己。

如果你能在15天内完成所有的任务,那你堪称天才。然而,如果你能完成 60-70% 的内容,你就已经开始具备成为一名大模型 AI 的正确特征了。

这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】

在这里插入图片描述

企业内部使用 DeepSeek 进行私有化数据的垂直训练 通过垂直训练,企业可以将 DeepSeek 的基础模型与私有数据结合,构建适合自身业务场景的定制化模型。在实施过程中,需重点关注数据隐私保护和训练效率优化,确保模型的安全性和性能。 阅读详情

相关推荐

DeepSeek R1 Ollama本地化部署全攻略:三步实现企业级私有化大模型部署

Ollama作为当前最受欢迎的本地大模型运行框架,为DeepSeek R1的私有化部署提供了便捷高效的解决方案。本文将深入讲解如何将Hugging Face格式的DeepSeek R1模型转换为Ollama支持的GGUF格式,并实现企业级的高可用部署方案。文章包含完整的量化配置、API服务集成和性能优化技巧。

理论都是虚的,代码才是王道。 1万+

DeepSeek R1模型解读与使用

下面有个图表,这里可以重点关注DeepSeek-R1-Distill-Qwen-32B这个模型,这也是他们官方标注的,基座采用了Qwen32B的模型,在数学,代码,复杂问题的测试集中跟o1-mini一个水准,远高于GPT4o,Claude3.5-Sonnet,DeepSeek-V3。相比国内的推理模型,价格不算便宜,但性能目前确实最好的,通义千问QWQ预览版输入价格3.5元/百万tokens,输出7元/百万tokens,智谱GLM-ZERO预览版,输入输出10元/百万tokens。这是官方的性能评测图。

2401_85549225的博客 1万+

DeepSeek-R1与Kimi k1.5实战对比:国产大模型推理架构与多模态落地指南

大语言模型(LLM)推理能力与多模态理解正从学术指标走向工程可用性。推理链优化、长上下文处理、跨模态语义对齐等核心技术,已成开发者选型关键。DeepSeek-R1通过强化学习重写隐状态激活路径,显著提升数学与代码逻辑推演稳定性;Kimi k1.5则以语义锚点对齐技术打通图像与文本表征,在架构图-代码映射等真实场景中实现高精度关联。二者均深度适配OpenAI API协议,支持低门槛集成至VSCode、LangChain等主流开发管线。当‘codex接入deepseek’与‘claude code kimi’成

weixin_30596023的博客 308

全网唯一!手把手教你 DeepSeek-R1-Distill-Qwen-32B 云端部署 + Dify 配置全攻略

Deepseek最近太火了,关于 Deepseek 的文章虽多,但大多局限于 Ollama 部署 Deepseek 这类“玩具”场景,难以满足企业级应用的复杂需求。这些低质量内容往往缺乏深度与实用性,对于追求高效、稳定解决方案的企业而言,犹如隔靴搔痒。而我们的专业团队,始终关注行业前沿动态,凭借对技术趋势的精准把握和深厚的技术积累,迅速捕捉到企业在 Deepseek 应用中的痛点与需求。在极短的时间内,精心打造出这篇文章。

star_nwe的博客 6165

GPT-5是假消息?真相核查与o3-mini实战替代方案

大语言模型(LLM)作为当前AI应用的核心技术,其演进逻辑遵循能力验证、小步迭代与工程落地三阶段规律。所谓‘GPT-5’并不存在,OpenAI官方模型列表截至2025年8月仍止步于gpt-4o、o1系列及o3-mini等真实可验证型号。该现象折射出行业对‘下一代模型’的普遍误读:技术价值不在于命名代际,而在于推理架构升级(如o3-mini的轻量化长链思考)与场景适配能力。在医疗、法律、金融等高确定性领域,真正可用的方案是混合编排(GPT-4o + o3-mini)、领域微调与RAG+Agent工作流。本文基

weixin_33853827的博客 402

从零到一:Dify本地部署全攻略与私有化AI应用构建

既然已经有了像“扣子”这样的在线AI应用开发平台,为什么还要费劲去本地部署Dify?这个问题背后,其实是在问: 一个开源的、能完全私有化部署的AI工作流平台,到底能解决哪些在线平台解决不了的实际问题? 对于开发者、小团队或者对数据隐私、流程定制有更高要求的用户来说,Dify的核心价值在于 控制权 和 灵活性 。它让你能把整个AI应用的“大脑”——包括工作流编排、知识库(RAG)、模型调用和业务逻辑——都部署在自己的服务器上。这意味着数据不出域、可以深度定制工作流节点、对接任何内部系统,并且不受在线服务的功能

weixin_34214500的博客 323

【Reading Notes】(8.2)Favorite Articles from 2025 February

2025年2月28日:2022年7月花费8万多购入一辆哪吒V(2022款 潮 400 Lite),官方宣称纯电续航400公里。来自上海的贺先生在2023年11月预订了一辆奇瑞舒享家,12月12日提车当天,竟发现这辆车像是被“动过手脚”,引擎盖有拆装过的痕迹,螺丝生锈,车头部位多处漆面异常。大多数人的春节假期,都是法定节假日(1月28日至2月4日),而张雪峰公司放假23天(1月18日至2月10日),真的是非常慷慨的假期了。2025年2月27日:【315专题】十几万买了辆奇瑞“瑕疵车”,售后却装死?

bryant_meng 2103

告别云端依赖:构建自主可控的本地AI开发工作流实战指南

在AI技术快速发展的今天,大语言模型已成为提升开发效率的重要工具。其核心原理是基于海量数据训练,通过Transformer架构实现代码生成、逻辑推理等智能辅助能力。这项技术的价值在于将开发者从重复性劳动中解放出来,聚焦于更高层次的架构设计与创新。然而,过度依赖云端AI服务(如Claude、GPT)会带来服务中断、成本波动和数据安全等风险。因此,将AI能力本地化部署,构建自主可控的开发环境,成为保障研发流程稳定性的关键。本文聚焦于**本地大模型部署**与**IDE集成**,通过Ollama、DeepSeek-

weixin_33868027的博客 461

如何选择大模型(不同业务场景选择相应的大模型)

任务类型:是文本生成、对话、代码编写、信息抽取、复杂推理还是多模态理解?性能要求:需要“最好”的效果,还是“足够好”即可?对响应速度(延迟)和吞吐量有何要求?成本预算:是按调用次数付费(API)还是一次性投入(私有化部署)?预算是多少?数据敏感性:处理的数据是否涉及商业秘密、个人隐私?是否需要私有化部署?技术能力:团队是否有能力进行模型的微调、部署和运维?

usa_washington的博客 1125

Dify实战指南:从零部署到构建企业级AI应用与工作流

如果你正在寻找一个能快速将 AI 想法落地、无需复杂编码就能构建生产级 AI 应用和智能体工作流的平台,那么 Dify 绝对值得你花时间深入了解。它不是一个简单的提示词工具,而是一个开源的、企业级的 AI 应用开发平台,由 LangGenius 团队打造。简单来说,Dify 让你能像搭积木一样,通过可视化拖拽的方式,连接大模型、知识库、工具和逻辑判断,构建出复杂的 AI 应用。 这篇文章不是泛泛而谈的概念介绍,而是直接切入实战。我们会从 Dify 的核心能力、部署方式讲起,手把手带你完成从零部署到构建第一个

weixin_30312563的博客 436

大模型版本号失效:DeepSeek V4与GPT-5.5背后的范式分叉

在大模型技术演进中,‘版本号’正从工程里程碑蜕变为市场信号与范式标识——它不再指向确定的模型实体,而是隐含特定SLO(如长上下文稳定性、多模态一致性)的技术承诺。这种转变源于开源与闭源两条路径的根本差异:前者强调模块化、可解释、渐进优化,后者追求端到端黑箱跃迁与服务确定性。其技术影响已下沉至token处理逻辑、推理成本结构与RAG系统设计等工程细节。当开发者面对‘context_length_exceeded’报错或API成本异常激增时,真正需要诊断的并非模型本身,而是所选路径对应的底层工作方式分叉。本文聚

anjichan4261的博客 404

51c大模型~合集111

OpenAI 的某发言人表示:「为了提高清晰度和安全性,我们增加了一个额外的后处理步骤,其中模型会审查原始的思维链,删除任何不安全的内容,然后简化某些复杂的思维。可以看到,虽然 ChatGPT 确实完成了任务并展示了总结版的思维链,但似乎并未如 OpenAI 发言人说的那样给出与提示词语言同样语言的总结版。北大-灵初联合实验室表示,Align-DS-V的多模态强推理能力是VLA模型大脑端的核心,接下来的研究训练计划,是利用多模态推理模型的跨模态穿透能力,实现action穿透,最终实现真正高效的VLA模型。

whaosoft~aiotの开发板商城 2312

DeepSeek-R1-Distill-Qwen-1.5B:最佳小型LLM?

DeepSeek-R1-Distill-Qwen-1.5B,这款紧凑高效的模型在数学和推理任务中表现出色,在关键基准测试中超越了GPT-4o和Claude 3.5。

独立开发,substack顶级编辑 1万+

牛马型or全能型?你最想用哪款LLM?

选择LLM需根据具体任务和需求。OpenAI和Claude适合技术任务和代码生成,DeepSeek和Llama在开放性和定制化上占优,而OLMo则为研究LLM内部机制提供了透明平台。随着AI工具的不断进化,科研人员将有更多选择,但也要综合考虑法律和伦理风险。

EnjoyEDU的博客 1291

智能车竞赛疯狂电路组:Altium Designer赛道设计与计分策略全解析

本文全面解析智能车竞赛疯狂电路组中,如何利用Altium Designer进行专业赛道设计。从软件基础操作、图层管理与封装库调用,到赛道拓扑绘制、核心尺寸规范,详细拆解设计全流程。文章深入结合计分策略,指导如何在设计阶段植入策略点,优化路径与元器件布局,以在比赛中获得时间优势,并提供了从图纸输出到实地测试的完整避坑指南。

beta5的博客 583

基于Meteoinfo与TrajStat的后向轨迹聚类分析实战:从数据准备到可视化制图

本文详细介绍了基于Meteoinfo与TrajStat进行后向轨迹聚类分析的完整实战流程。从Java环境配置、Meteoinfo软件与TrajStat插件安装,到精准获取NOAA气象数据、设置参数进行批量轨迹计算,再到利用聚类分析提炼主要气流路径,并最终完成专业地图可视化与制图。文章旨在帮助环境与气象研究者快速掌握从数据准备到成果输出的全链路操作。

p4q5r6s7t的博客 804

构建企业级智能知识库:ChatWiki架构设计与部署指南

在数字化转型浪潮中,企业面临知识碎片化、信息检索效率低下、客服响应滞后等核心挑战。传统知识管理系统往往难以整合多源异构数据,缺乏智能化的检索与问答能力,导致知识资产无法有效转化为业务价值。ChatWiki作为开源知识库系统,通过微服务架构和RAG技术栈,为企业提供从知识沉淀到智能问答的完整解决方案。 ## 技术挑战与架构设计 企业级知识管理面临三大技术挑战:多格式文档处理、大规模向量检索、实时

gitblog_00174的博客 969

栅格数据空间叠置分析题目步骤讲解

题目: 准备工作: ①新建数据库,将实验数据导入(利于后期矢量转栅格操作,未建数据库此步骤会一直出错); ②在工具条自定义窗口勾选spacial analyst模块,在菜单栏→扩展模块,勾选spacial analyst;确保实验后面的操作可以成功。 详细操作步骤: 1.对三个方案的规划路线(line.shp)建立50m缓冲区;打开ArcMap,在ArcToolBox→分析工具→邻域分析→缓冲区,打开缓冲区工具窗口,界面设置如图:线性单位填写50米,其余默认,单击“确定”。 ...

m0_57139844的博客 8893

从Jeff Dean转身看AI基础设施:大模型应用开发与RAG实战指南

人工智能的演进正从模型能力的单点突破转向系统化工程落地。在大模型应用开发中,真正构成竞争壁垒的往往不是底层参数规模,而是围绕数据、检索、推理与部署构建的基础设施能力。RAG(检索增强生成)作为连接私域知识与通用模型的核心范式,通过文档切分、向量化存储和语义检索,让模型能够基于可信上下文生成答案,从而显著降低幻觉风险。Agent机制则借助Function Calling赋予模型调用外部工具的能力,使AI从被动问答走向主动任务执行。与此同时,推理成本控制、流式输出优化、向量数据库选型等工程实践,直接决定了应用能

weixin_34037515的博客 457

阿里云天池大数据长期赛:金融风控-贷款违约预测(含代码)

本次比赛让自己在大数据的处理流程上有了更明确的认知,从数据清洗、特征工程、数据建模,每一个过程都能学到很多经验和知识,值得去历练。

weixin_46685991的博客 1万+

YOLOv8实战:用Labelme标注自定义数据集并训练分割模型(附完整代码)

本文详细介绍了使用Labelme标注自定义数据集并训练YOLOv8实例分割模型的完整流程。从环境搭建、数据标注与格式转换,到模型训练、调优、验证及部署,提供了实战代码和调优建议。文章还探讨了如何结合追踪目标技术,实现视频流中的实例分割与目标追踪,为计算机视觉应用提供了一套可复制的解决方案。

552
上一篇: AI Agent不能缺少的基本能力之一 :反思(Reflection)之基于外部知识的增强反思
下一篇: 具身智能体俯视全局的导航策略!TopV-Nav: 解锁多模态语言模型在零样本目标导航中的顶视空间推理潜力
Python_金钱豹
博客等级 码龄5年 1万+粉丝 2826原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值